面对 400+页的企业年报如何快速分析?我用 WorkBuddy + TextIn xParse 搭建了一套 AI 财报分析助手
前言
很多企业在进行市场研究、竞品分析或战略规划时,都会参考竞争企业公开披露的年度报告。
一份完整的年报往往包含了大量数据,但是,对于企业分析人员来说,如何从一份数百页的年度报告中快速提取有效信息,并进一步形成分析结论,并不是一件容易的事情。
一份完整的企业年报往往包含着大量文字、表格以及图表内容,除了基础财务数据外,还涉及管理层讨论与分析、业务板块介绍、风险因素等多个章节。
以本次实践将使用的某科技企业年度报告为例:
- PDF 大小约 4.2 mb
- 文档页数超 400 页
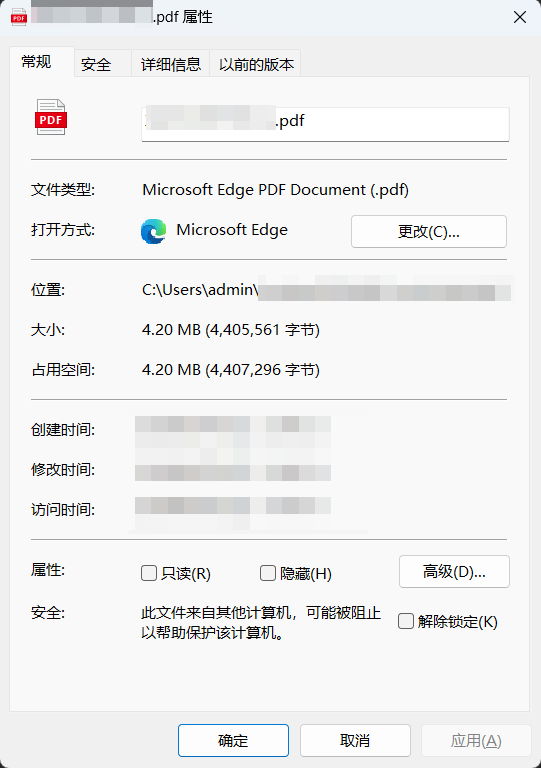
如果完全依靠人工阅读和整理,不仅非常耗时,且容易遗漏关键信息,还需要手动整理复杂表格中的数据,最终再形成业务分析报告。
且在这个过程中,传统文档处理方式面临着几个问题:
- 长文档信息获取效率低
- 复杂表格容易出现结构丢失
- 图文混排内容难以直接被 AI 理解
- 从数据提取到分析仍需要大量人工参与
随着现在 AI agent 技术不断发展,ai 的应用场景也逐渐从简单的问答聊天,扩展到生产中的文档处理、业务分析等复杂场景。
越来越多企业都开始尝试将 ai 应用在真实的业务数据处理和分析流程中。
那我们能否利用 AI agent 自动完成财报解析与经营分析
本次实践选取了一份大型科技企业年度报告作为案例。为了保护企业及相关业务信息,文中对企业名称、部分金额及敏感数据进行了脱敏处理,但整体分析流程和文档结构保持不变。
企业财报分析中的文档处理难点
在实际的企业分析工作中,年度报告并不是简单的文本资料。
相比普通文档,企业年报通常具有内容复杂、结构多样、信息密度高等特点。
如果只是简单提取文字内容,可能无法满足后续的分析需求。
篇幅导致的信息获取困难
首先,企业年度报告的篇幅都较长
一份完整的年度报告可能有数百页内容,其中不仅包含财务数据,还有业务分析、企业介绍等大量章节
复杂的表格结构容易丢失
其次,财报中的复杂表格也是传统文档处理的一大难点。
企业年度报告中会包含大量的财务数据和业务数据,例如
- 收入结构表
- 利润表
- 资产负债表
- …
这些表格不仅包含文字和数据,还可能存在:
- 多级表头
- 合并单元格
- …
如果只是简单的进行文字识别,虽然可能能够识别出表中文字,但那样会很容易丢失原有结构。
比如
原本表示不同业务的板块收入数据,在解析后可能变成无序文本或数据错乱,导致后续 ai 无法准确理解和分析数据。
图文混排难以被 ai 直接理解
再其次,企业报告中还包含着大量非纯文本内容
例如
- 数据图表
- 业务流程图
- 注释信息
- …
这些内容通常和正文捆绑结合
如果缺少有效的多模态解析能力,ai 很难完整理解文档中的信息
这些问题最终都会指向同一个问题:如果只是将 PDF 中的文字简单提取出来,AI 虽然能够“看到”部分内容,却未必能够理解原始文档中的结构关系。
对于财报这类高度依赖表格和上下文关系的文档来说,真正有价值的并不是单纯提取文字,而是尽可能保留原始文档中的结构,让解析后的内容能够继续参与后续 AI 分析。
WorkBuddy + TextIn xParse:构建 AI 财报分析助手
面对企业年度报告这类复杂业务数据,单纯依靠传统的文本提取方式,很难让 ai 真正理解其中包含的信息。
对于企业来说,ai 不仅需要能够“读取”文档,更需要能解理解文档,理解文档中的结构,数据关系等,并进一步基于这些信息完成分析任务。
因此,在 AI agent 应用的过程中,文档解析能力 成为连接企业数据与 ai 能力的重要环节。
本次实际,我选择使用 WorkBuddy + TextIn xParse 搭建一套简易的 ai 财报分析助手,模拟企业战略分析人员处理年度报告的实际工作流程
WorkBuddy 作为 AI 工作平台,负责接收用户任务,并基于用户需求完成后续分析流程。
TextIn xParse 则负责处理复杂企业文档,将 PDF 等非结构化文件解析为 AI 更容易理解和处理的结构化数据。
通过这两者结合,可以实现:
企业年度报告 PDF
↓
TextIn xParse 文档解析
↓
结构化数据(Markdown)
↓
WorkBuddy AI分析
↓
经营分析报告
在这套流程中,两者承担的任务并不相同。
TextIn xParse 主要负责解决“如何让 AI 读懂企业年报”的问题,将原始 PDF 中的文字、表格、图片等内容转换为结构化数据;WorkBuddy 则进一步基于这些解析后的内容完成信息整理、经营分析和报告生成。
因此,整个流程并不是简单的“上传 PDF -> AI 写报告”,而是先完成文档解析,再进入后续的业务分析。
接下来,我将通过一份超过 400 页的企业年度报告作为案例(案例中的企业名称、具体金额及其相关敏感信息均进行脱敏处理),展示从文档上传、内容解析到最终生成结果的完整过程。
实际使用:从 0 开始利用 WorkBuddy + TextIn xParse 分析 400+页企业年报
正式使用 xParse 之前
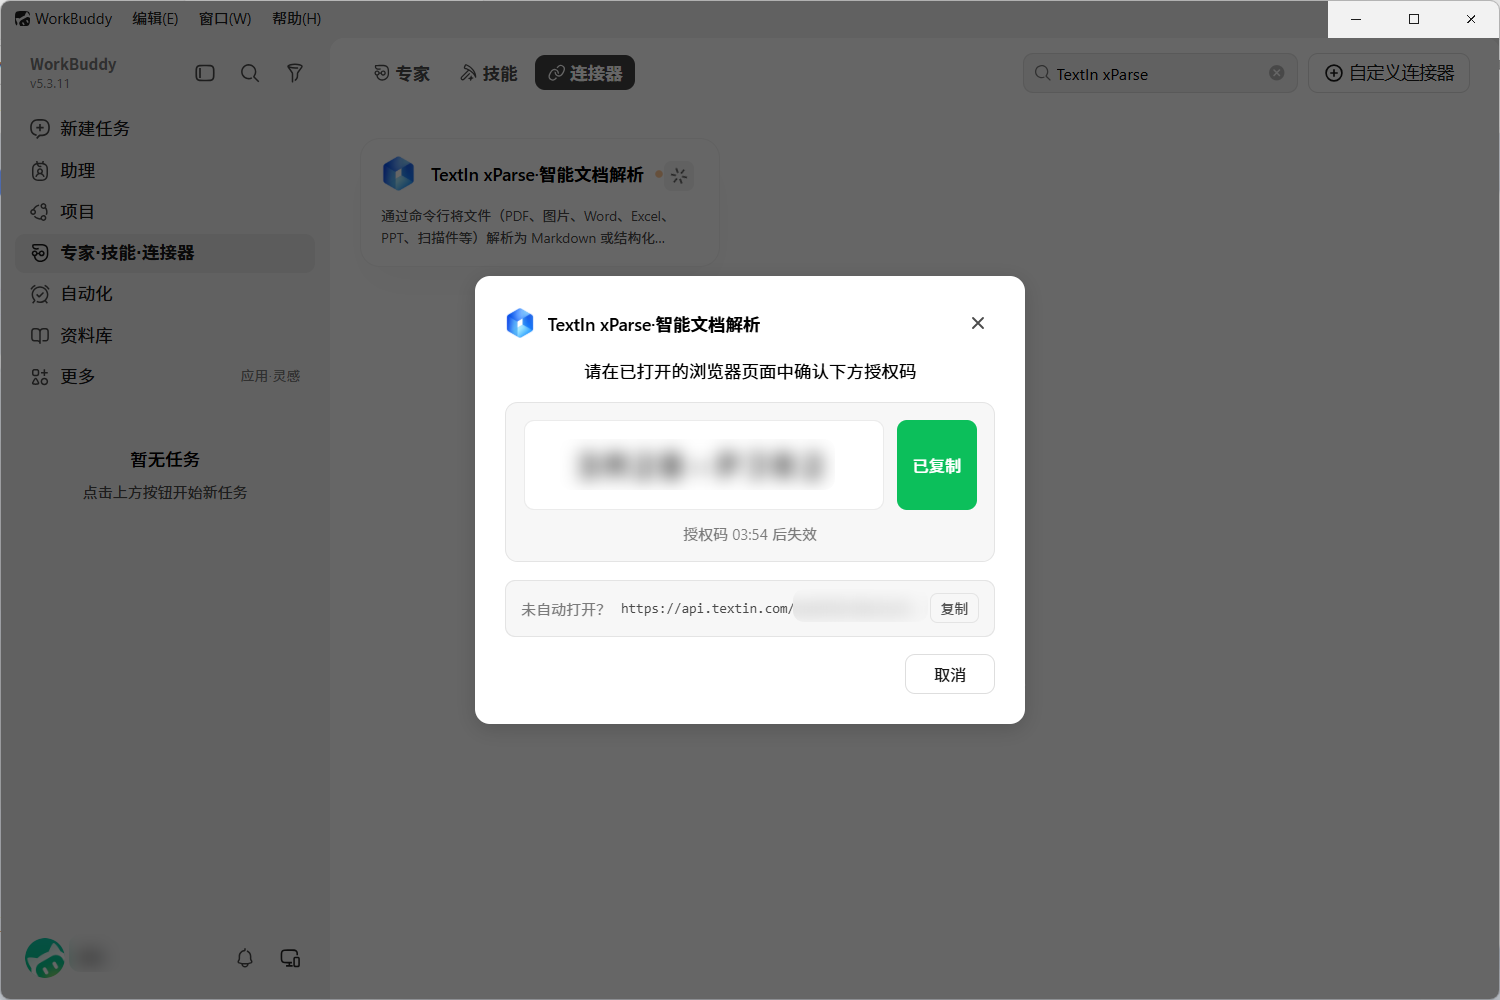
- 首先在 WorkBuddy 中找到 TextIn xParse 并添加
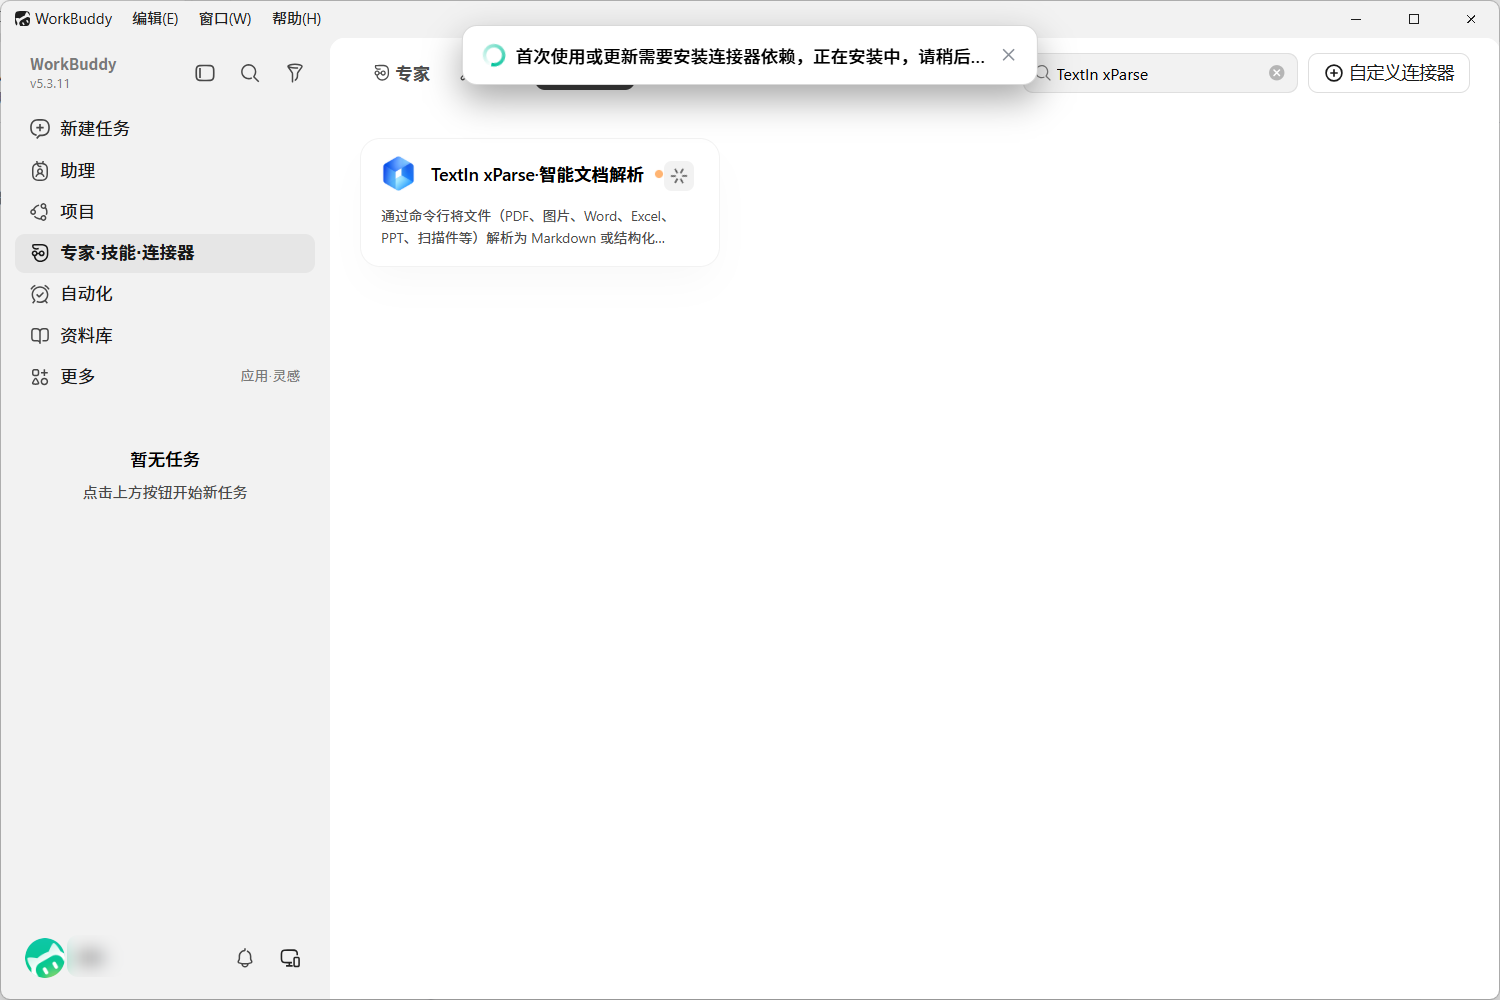
- 然后在弹出的授权窗口中,跳转浏览器授权(首次使用需要完成账号授权,授权完成后,才可将 xparse 接入对话)
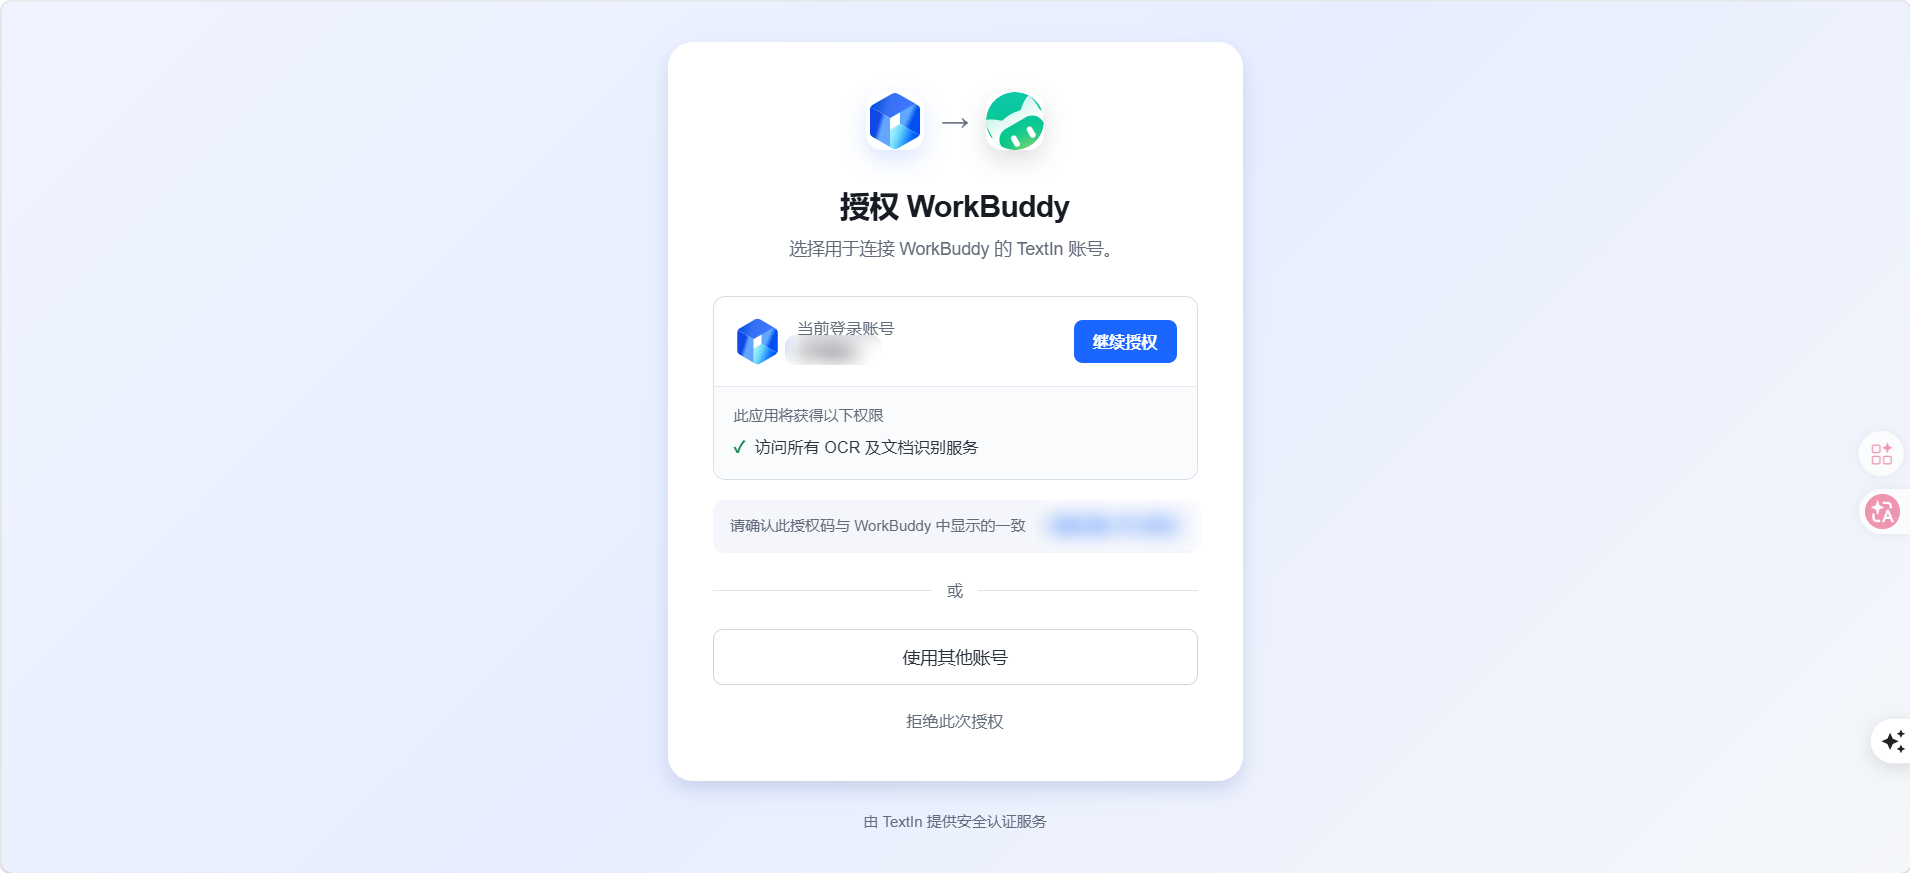
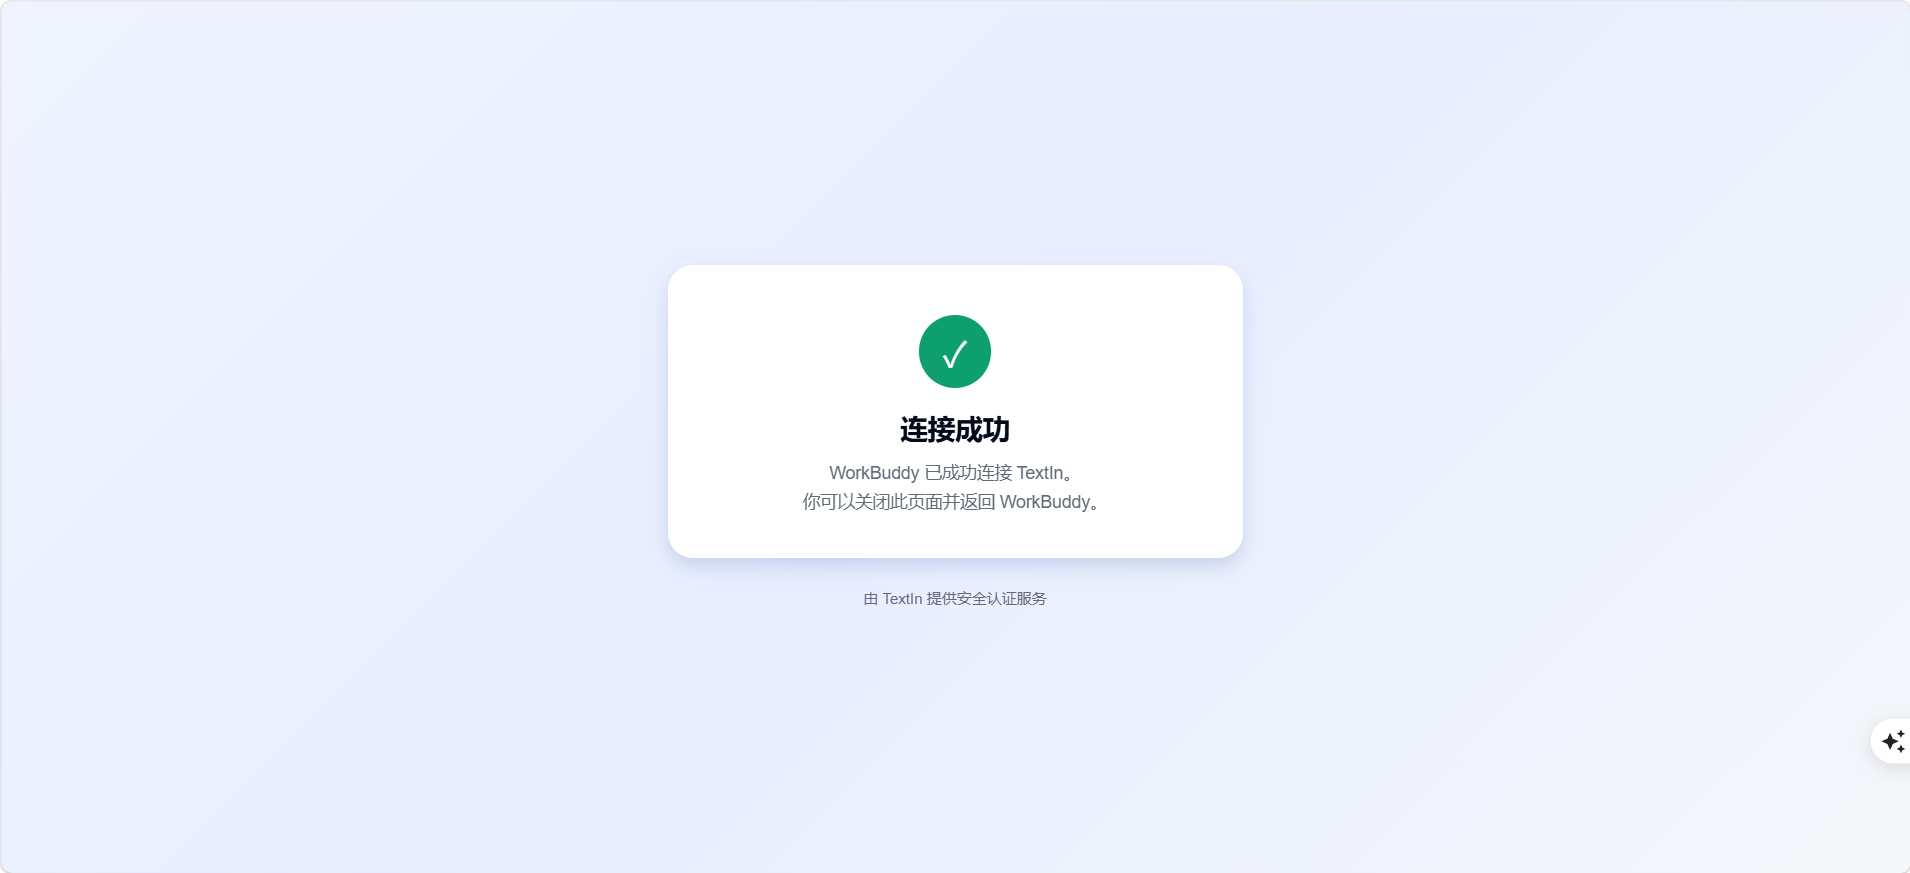
- 授权登录完成后回到 WorkBuddy 将 xParse 接入对话
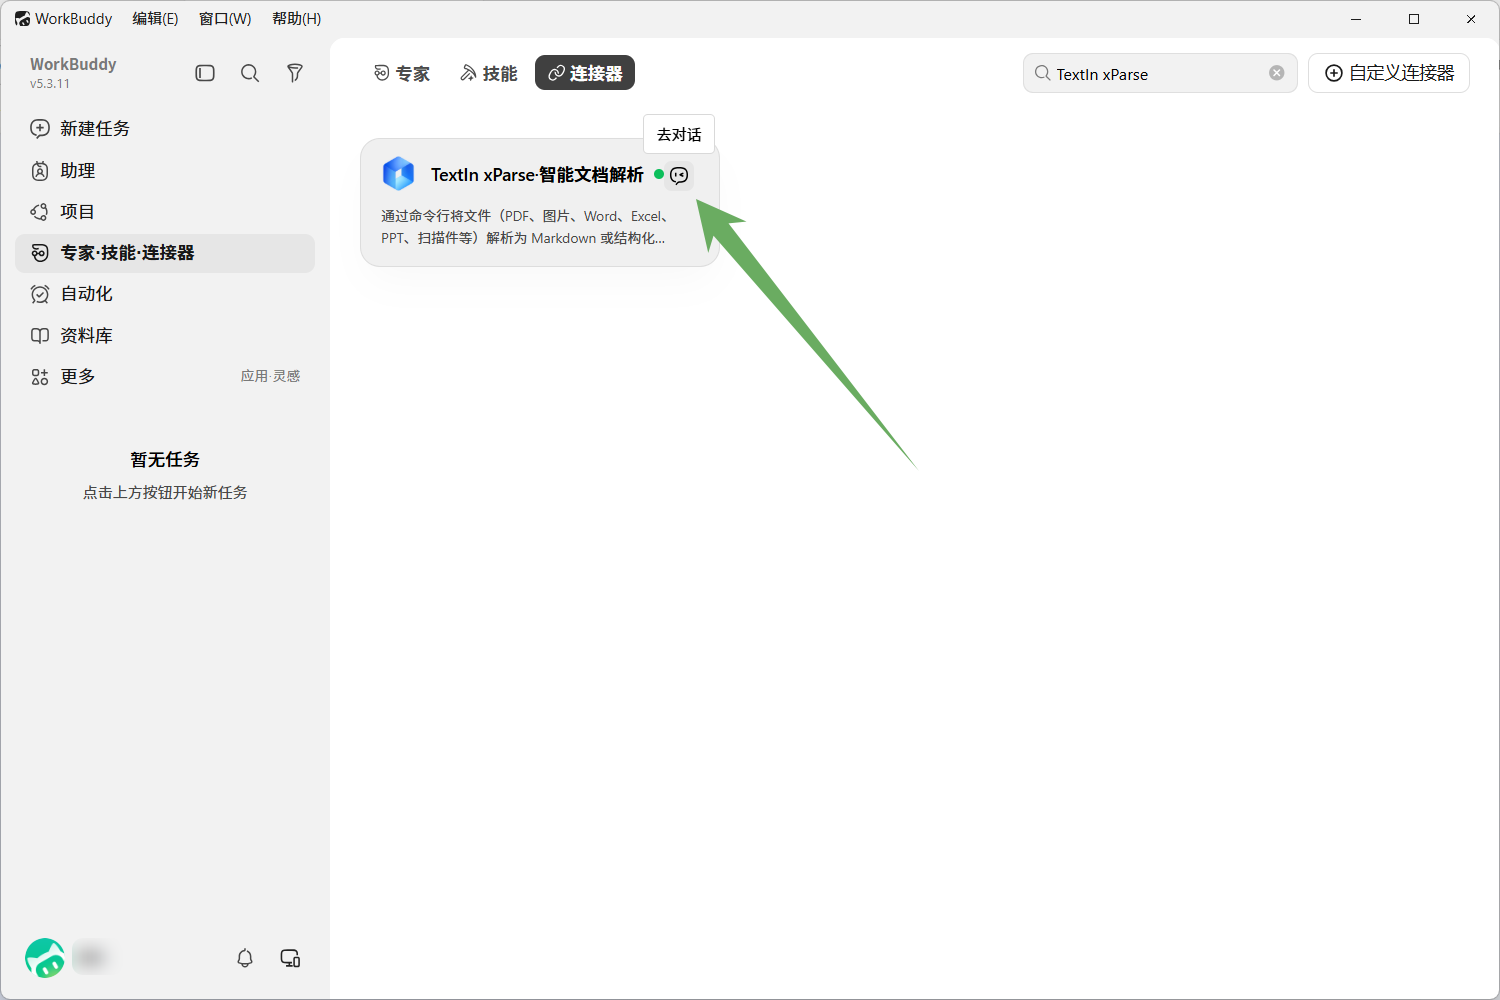 或
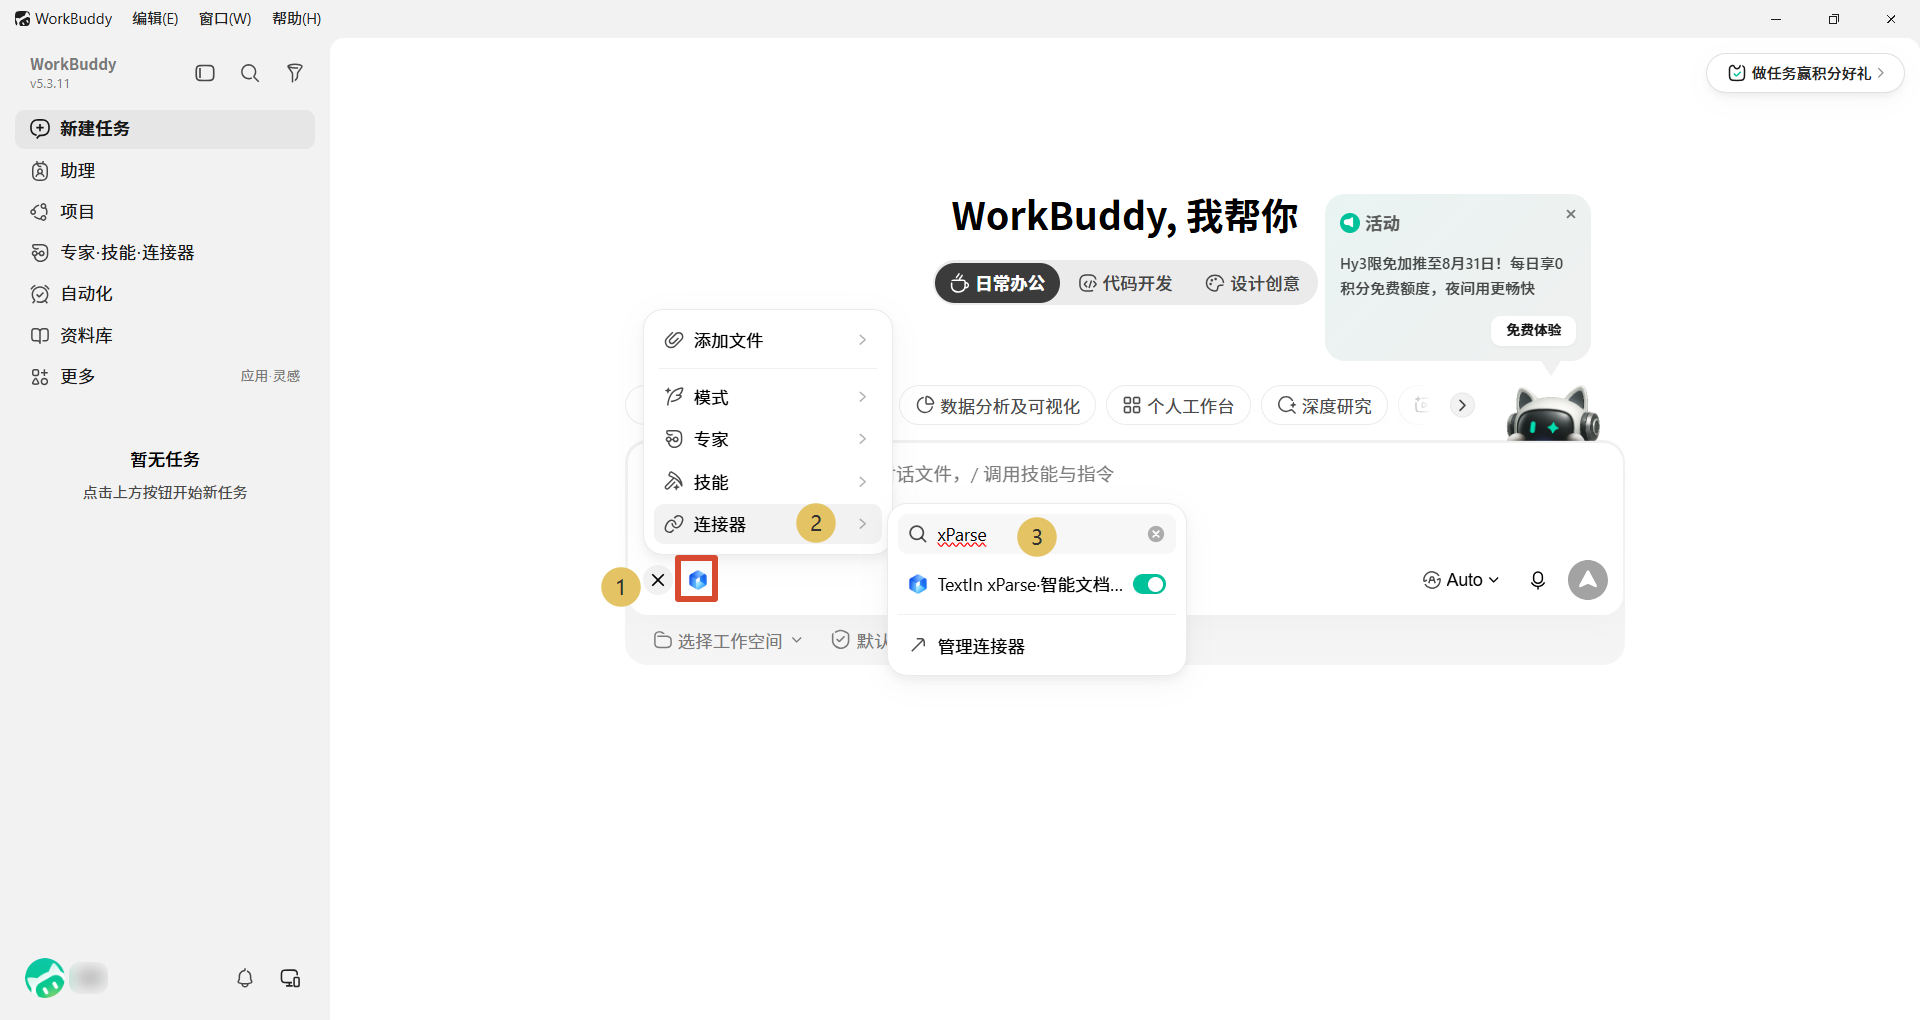
使用 xParse + WorkBuddy
-
上传年度报告文件并输入其需求 本次测试使用的是一份超 400 页的大型科技企业的年度报告,PDF 约 4.2mb,上传文件后,接下来让 xparse 对原始文档进行解析
例如:
请使用 TextIn xParse 对这份年度报告进行完整解析。
重点保留:
1. 正文内容
2. 表格结构
3. 多级表头
4. 合并单元格关系
5. 图表中的关键信息
6. 页码及章节层级请尽可能保留原始文档的信息结构,
并输出适合后续 AI 分析使用的结构化 Markdown。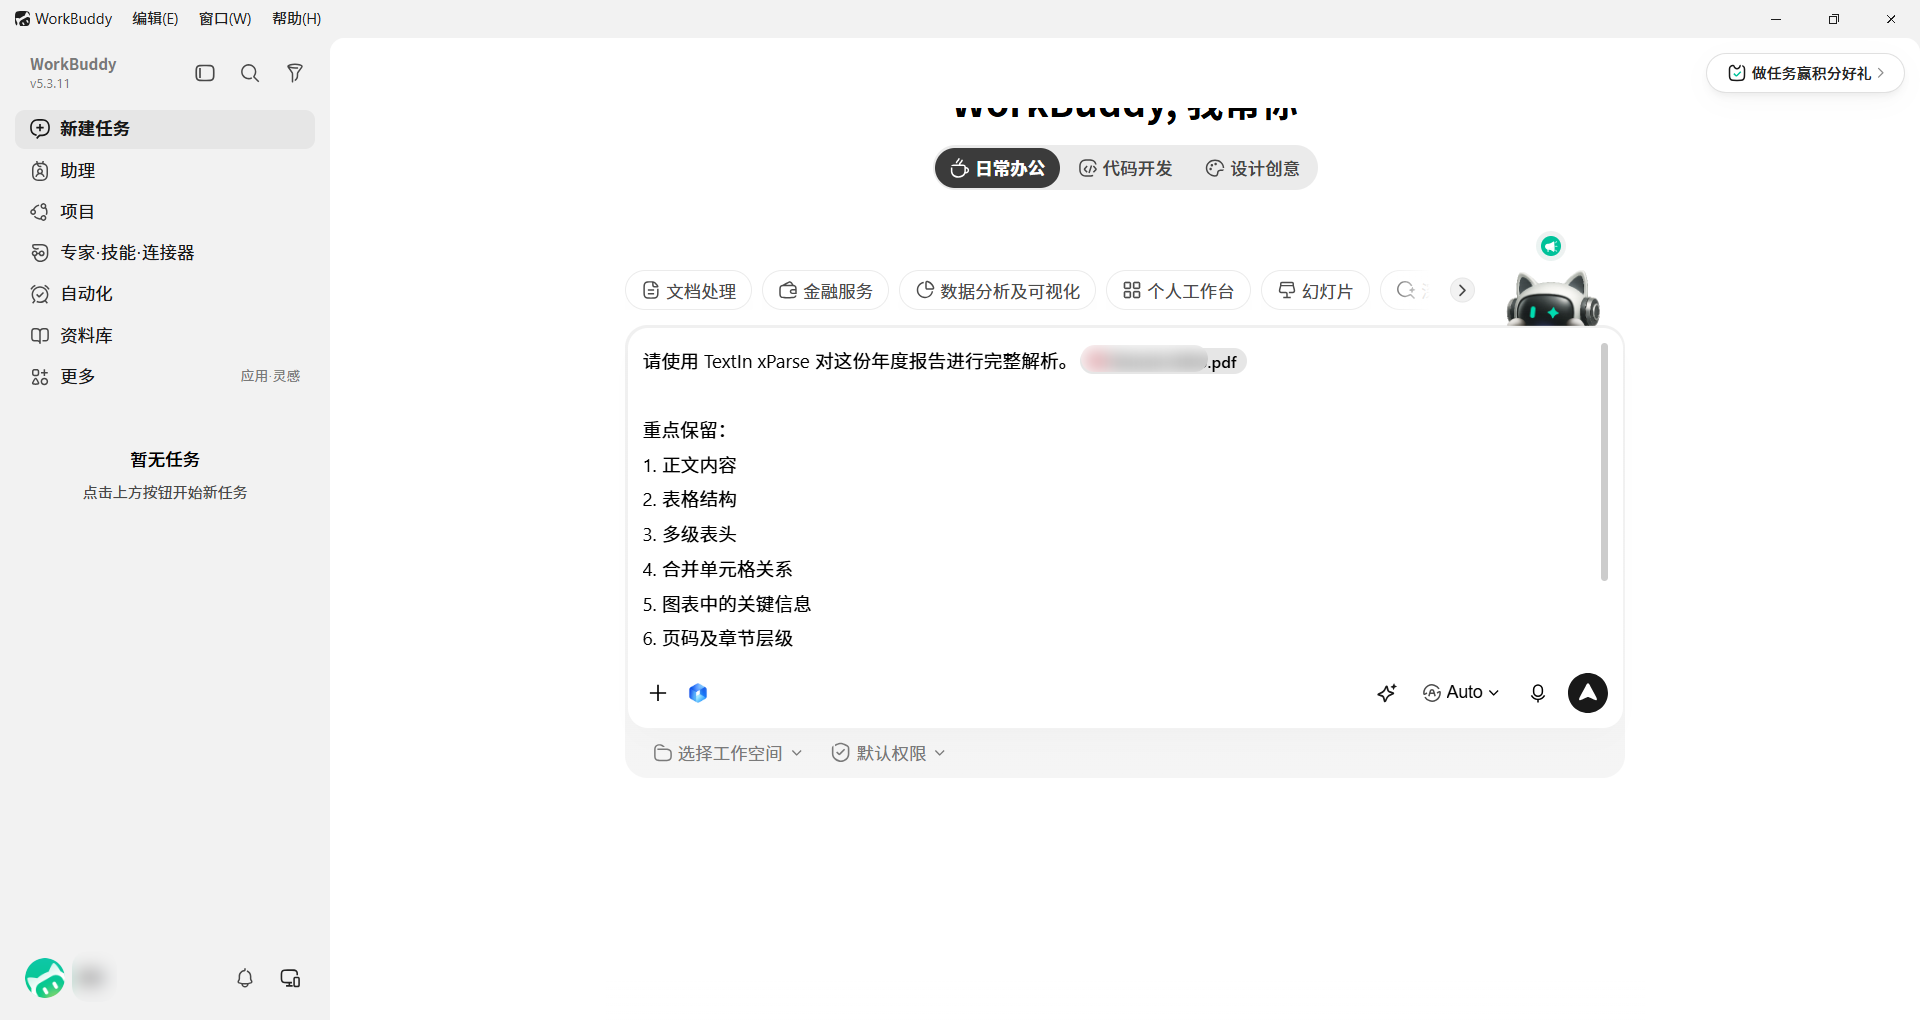
-
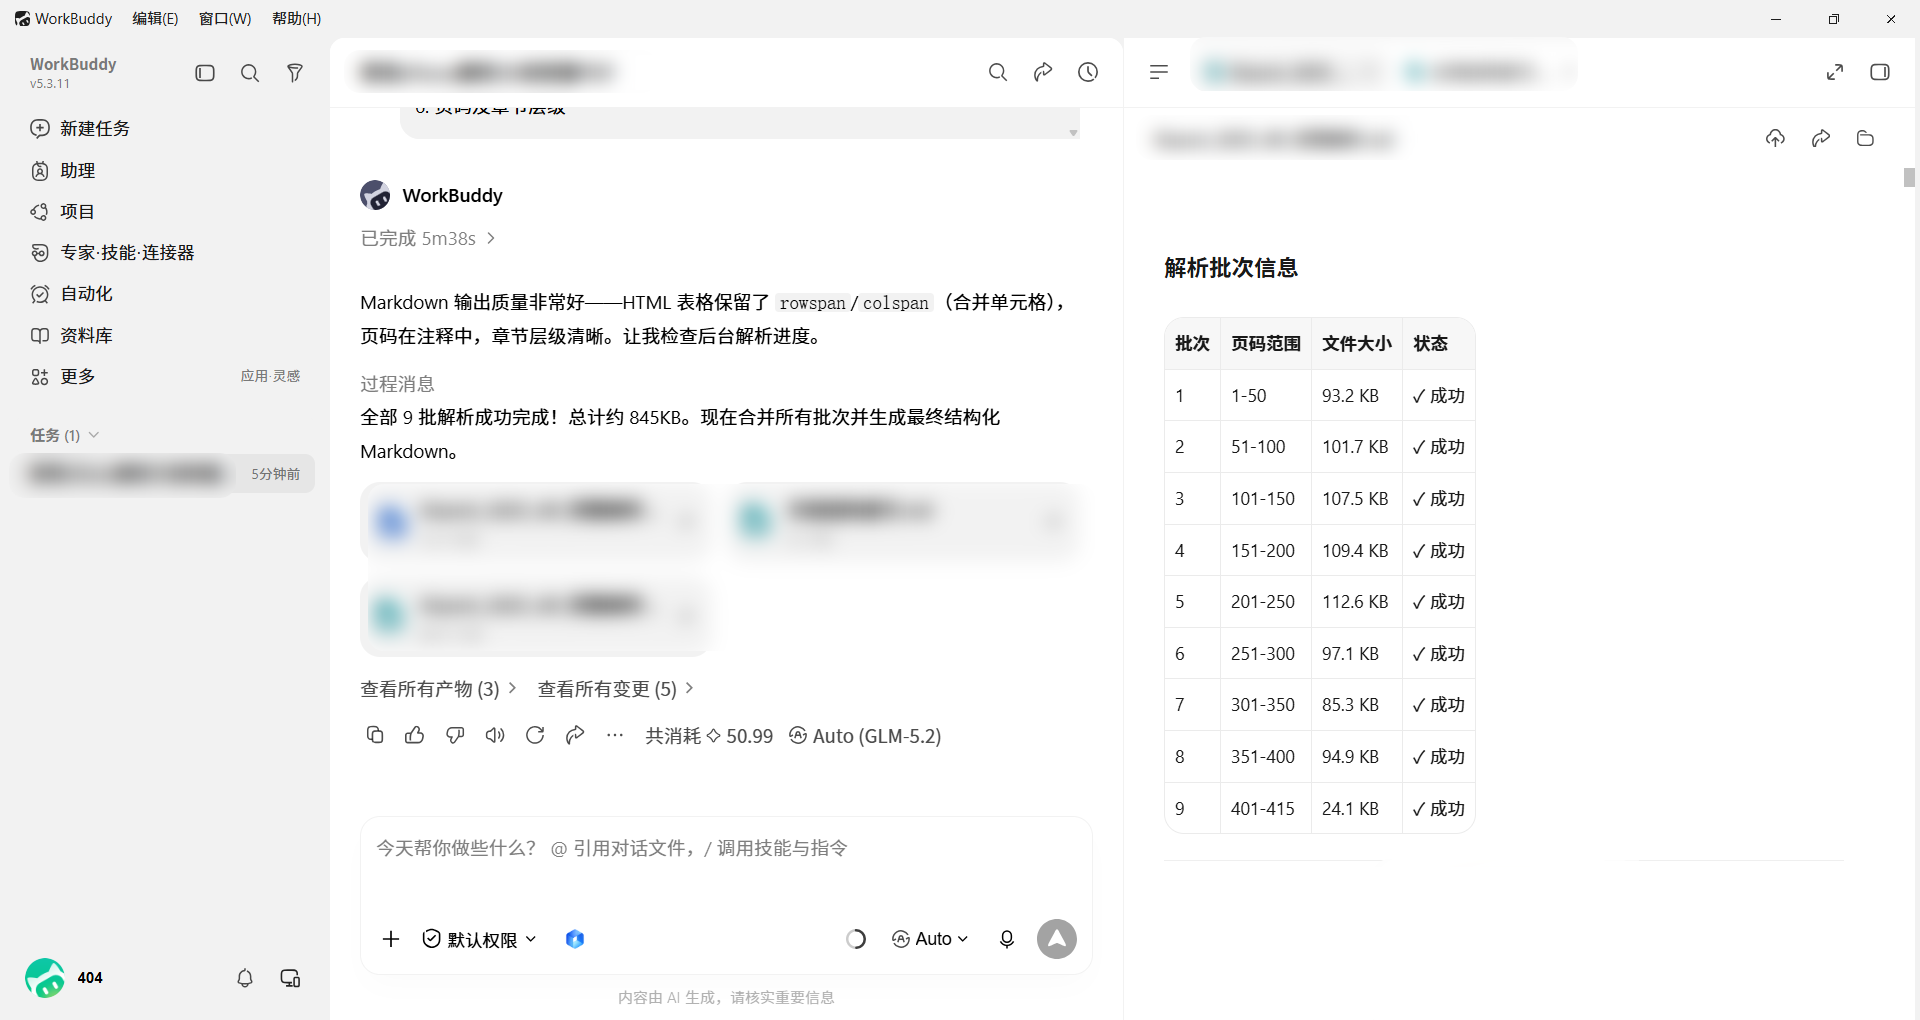
展示 xParse 解析结果
-
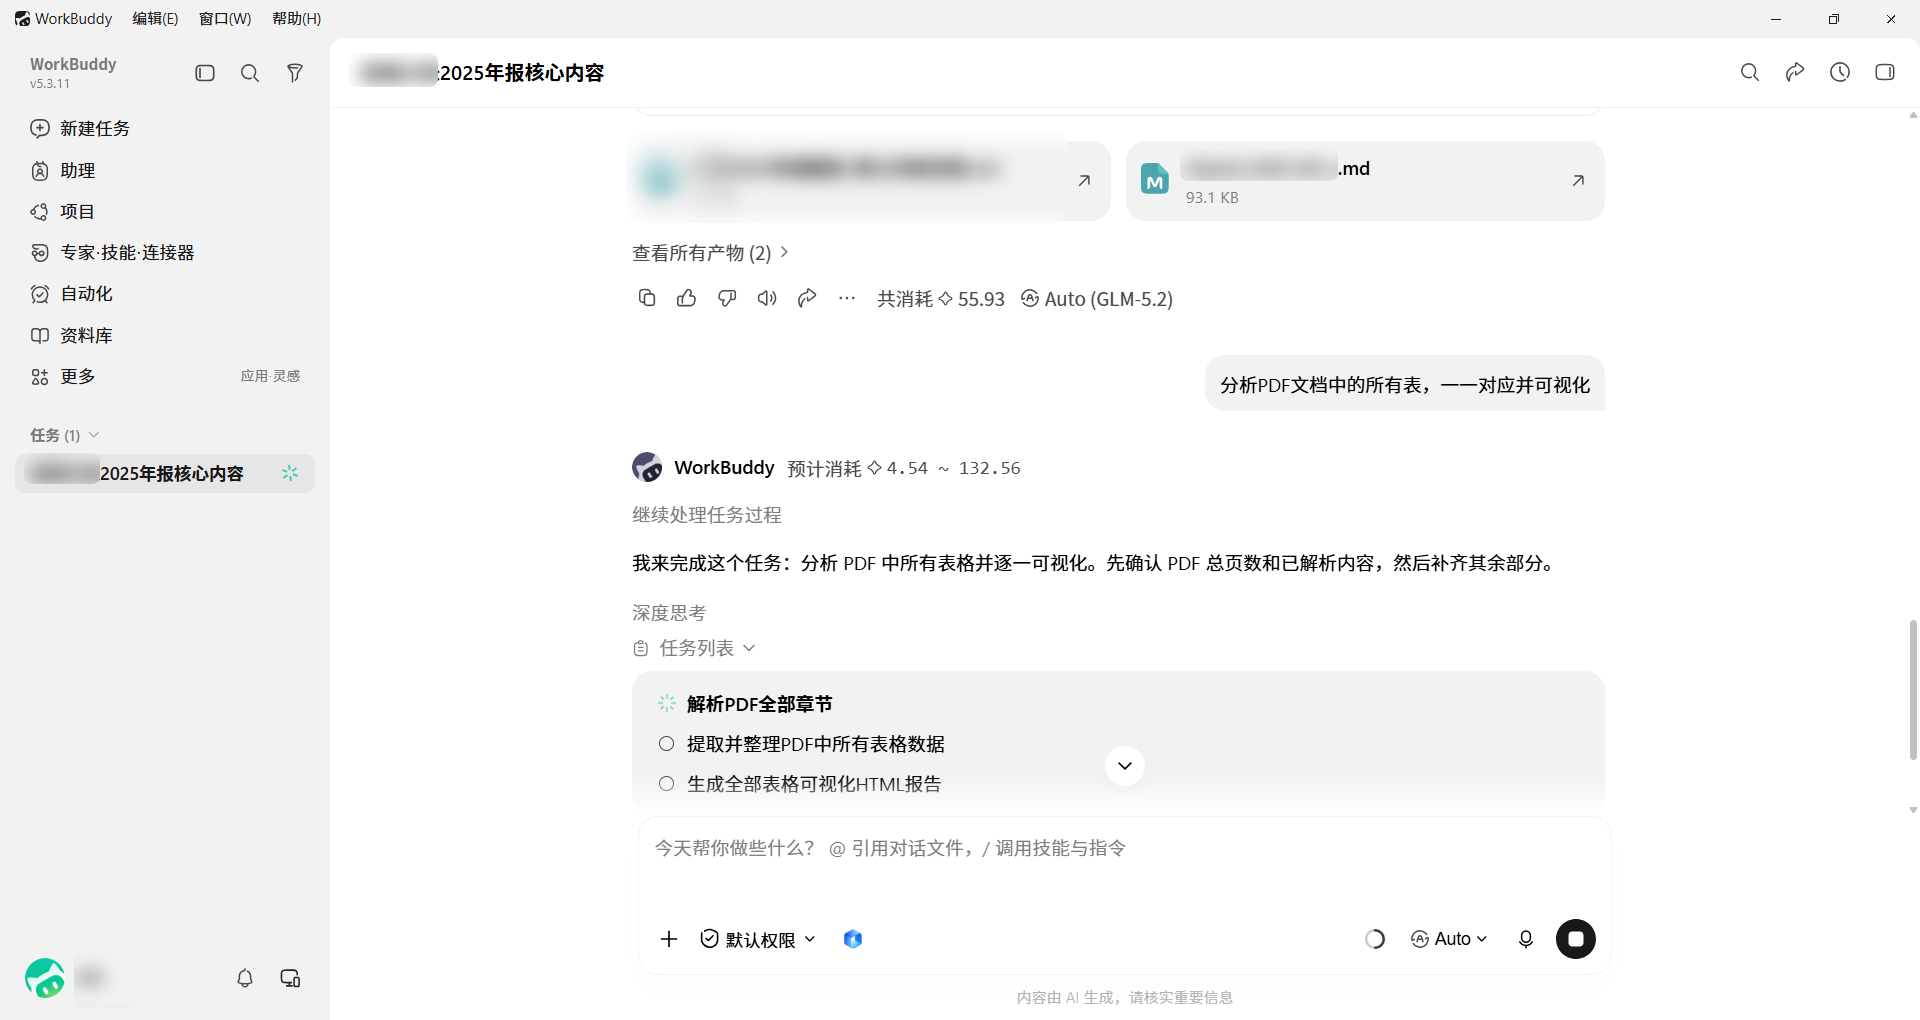
添加需求 – 复杂表格解析
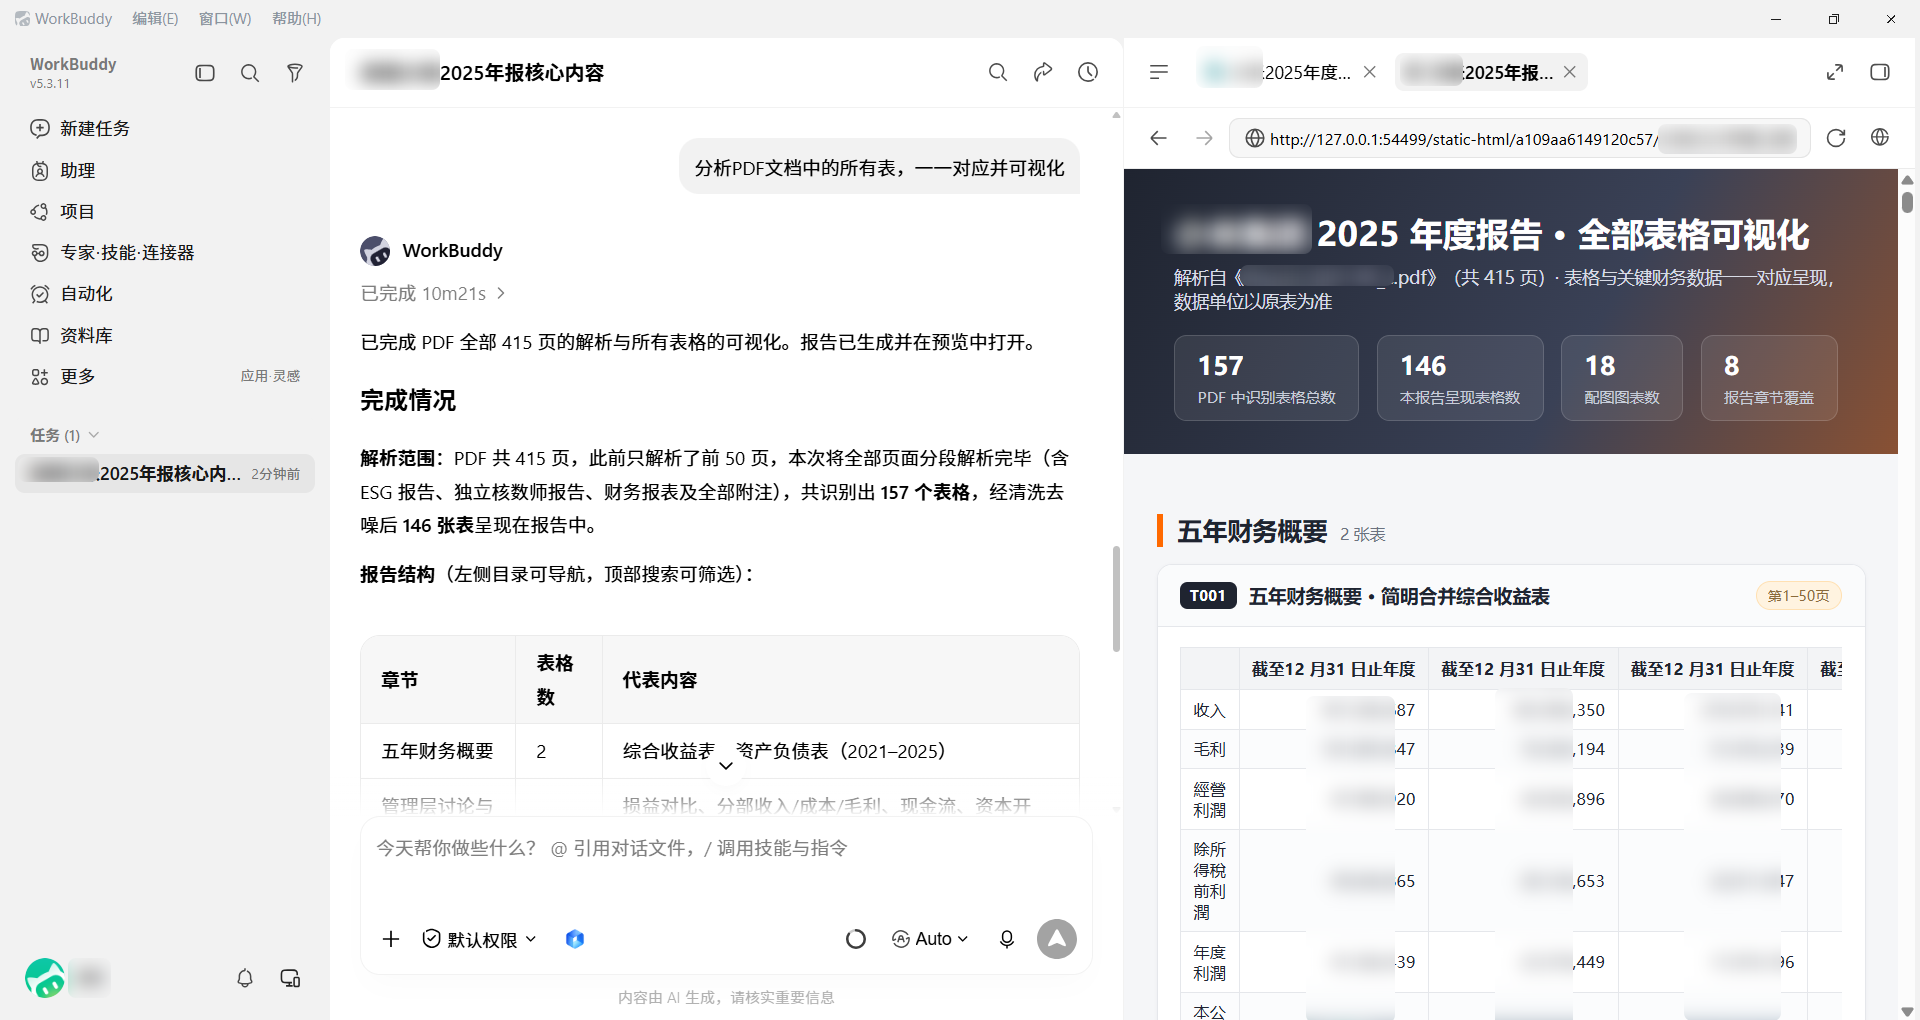
-
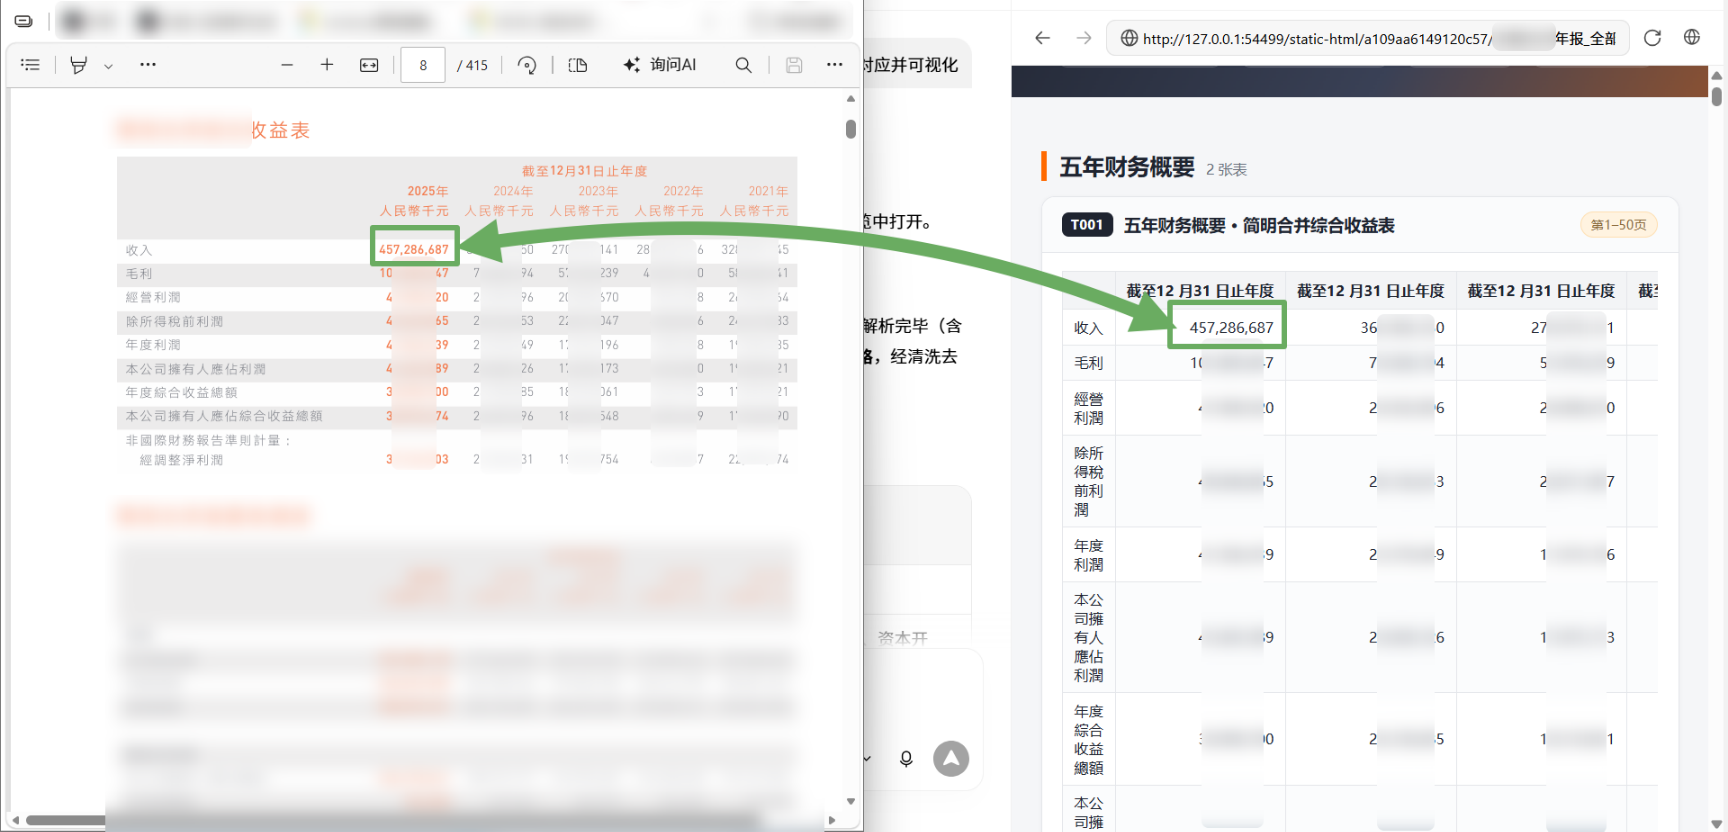
解析后数据和源数据对比(为了验证解析结果的可用性,我将使用原始财报页面与输出结果进行对照,重点观察表格中的行列关系、数据对应关系,具体的金额等敏感数据保留一个作为对照组其余进行脱敏操作)
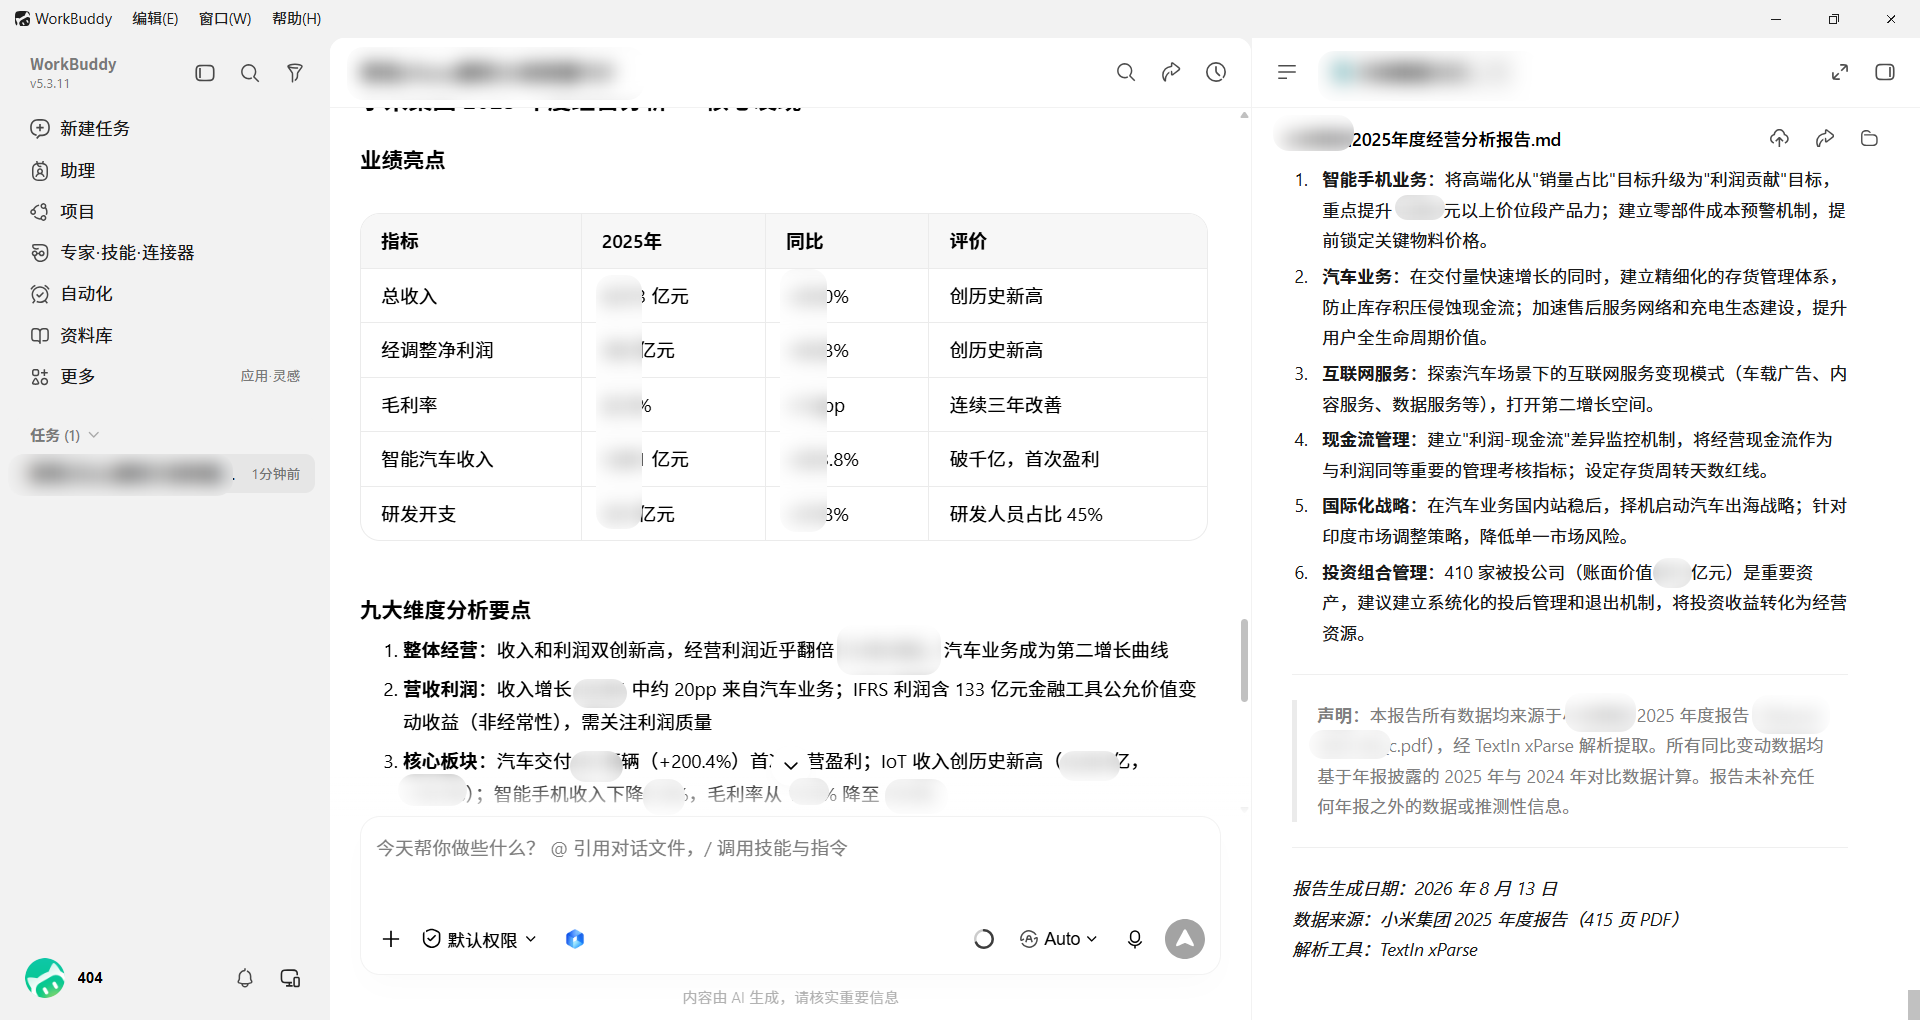
总结分析经营报告
请基于刚刚解析完成的年度报告,
生成一份企业经营分析报告。
重点分析:
1. 企业整体经营情况
2. 营业收入及利润变化
3. 核心业务板块变化
4. 各业务收入结构
5. 毛利率及盈利能力
6. 研发投入情况
7. 资产、负债及现金流变化
8. 主要经营风险
9. 未来经营趋势
要求:
– 所有结论必须基于年报中的实际数据;
– 不得自行补充原文不存在的数据;
– 涉及同比变化时给出具体数据;
– 对异常变化进行原因分析;
– 最后输出一份面向企业管理人员阅读的经营分析总结。
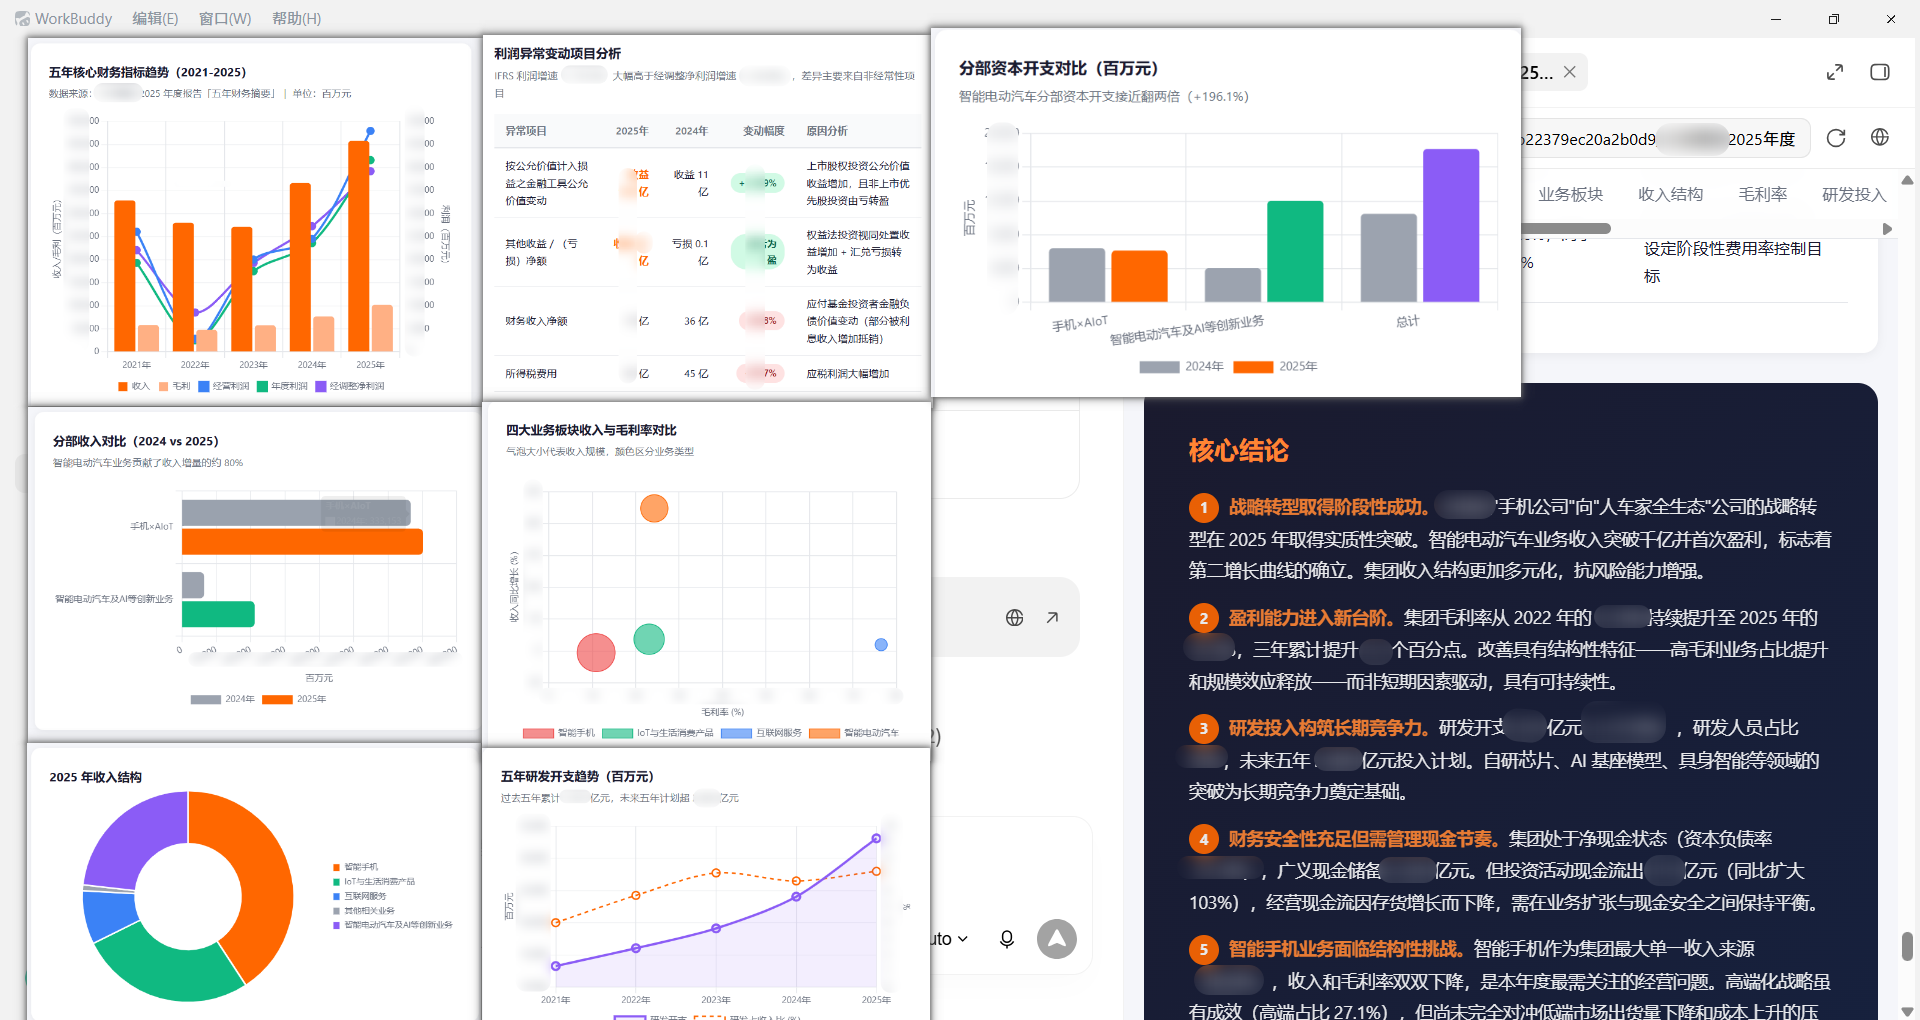
或可视化版本
请基于刚刚解析完成的年度报告,
生成一份可视化的企业经营分析报告(html)。
重点分析:
1. 企业整体经营情况
2. 营业收入及利润变化
3. 核心业务板块变化
4. 各业务收入结构
5. 毛利率及盈利能力
6. 研发投入情况
7. 资产、负债及现金流变化
8. 主要经营风险
9. 未来经营趋势
要求:
– 所有结论必须基于年报中的实际数据;
– 不得自行补充原文不存在的数据;
– 涉及同比变化时给出具体数据;
– 对异常变化进行原因分析;
– 最后输出一份面向企业管理人员阅读的经营分析总结。
同一页财报对比测试
为了验证解析结果的可用性,我将使用原始财报页面与输出结果进行对照,重点观察表格中的行列关系、数据对应关系,具体的金额等敏感数据保留一些内容其余进行脱敏操作
普通文本提取 vs xParse
普通 ocr 识别和直接提取在复杂场景下可能无法得到正确的结构化的数据,原始的行列关系可能无法保留。但通过 Xparse 解析能够得到更清晰的结构化数据且能快速的拿到数据。根据官方宣传【百页文档约 2 秒完成解析,精准识别表格、图片、公式、公章等元素,解析结果可直接导出为 Markdown、JSON 等智能体更易“读懂”的格式。】
普通提取: 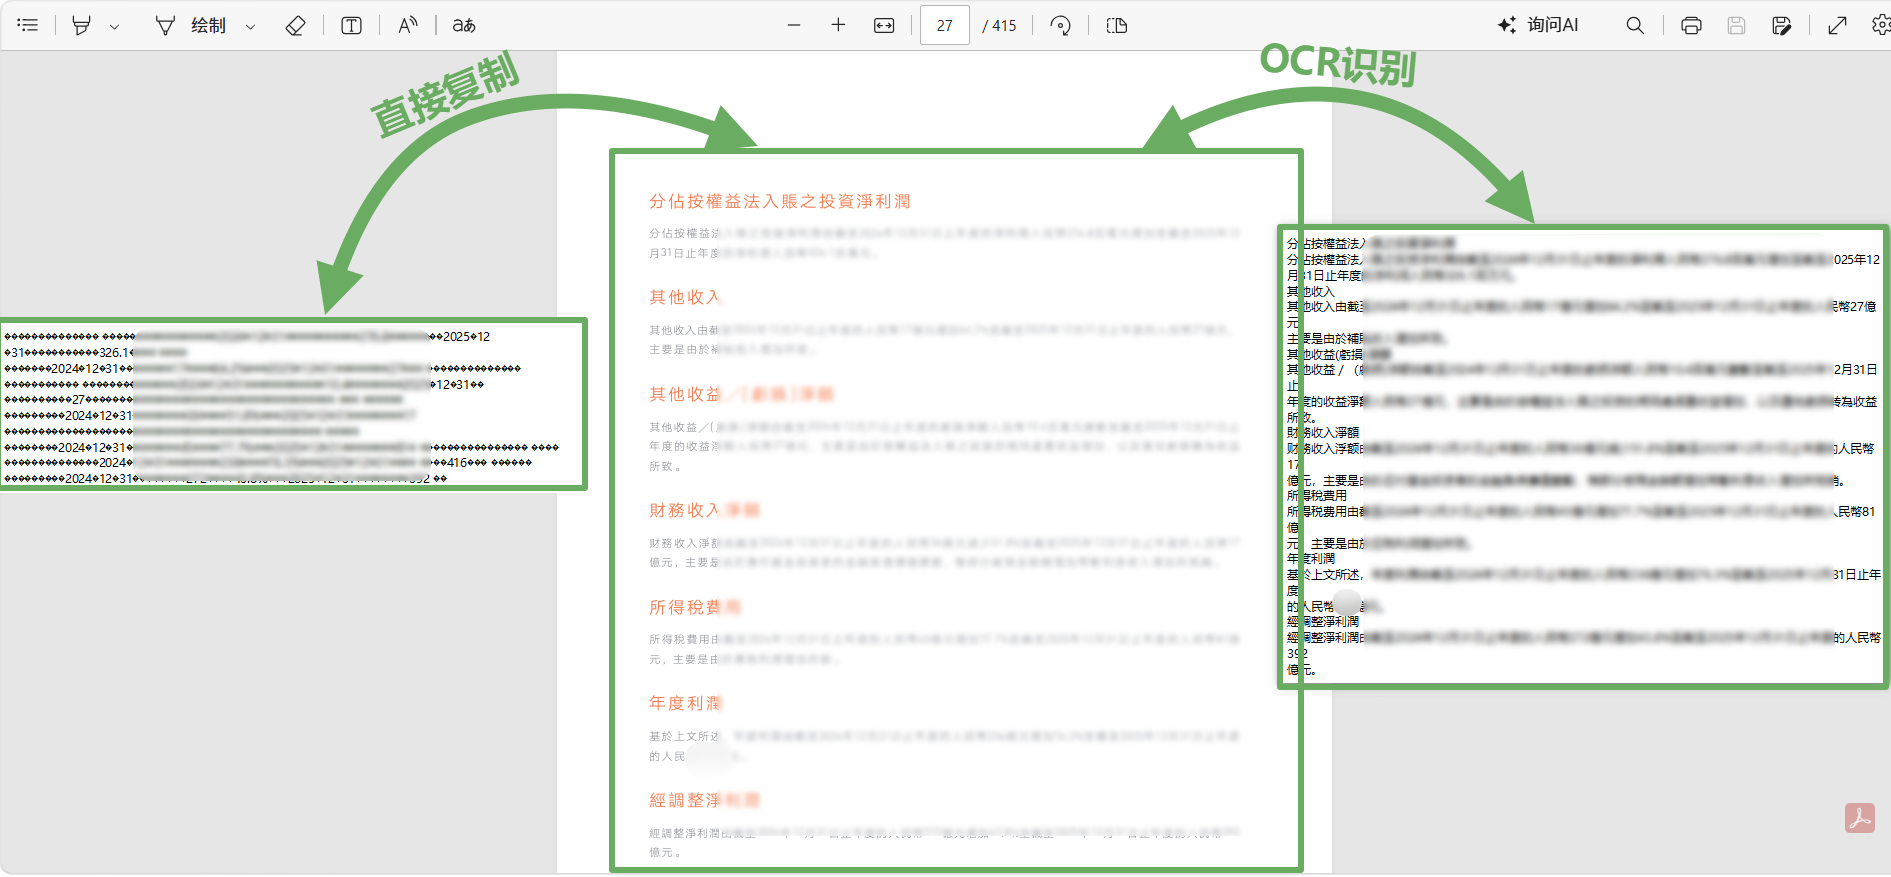
xParse 解析后:
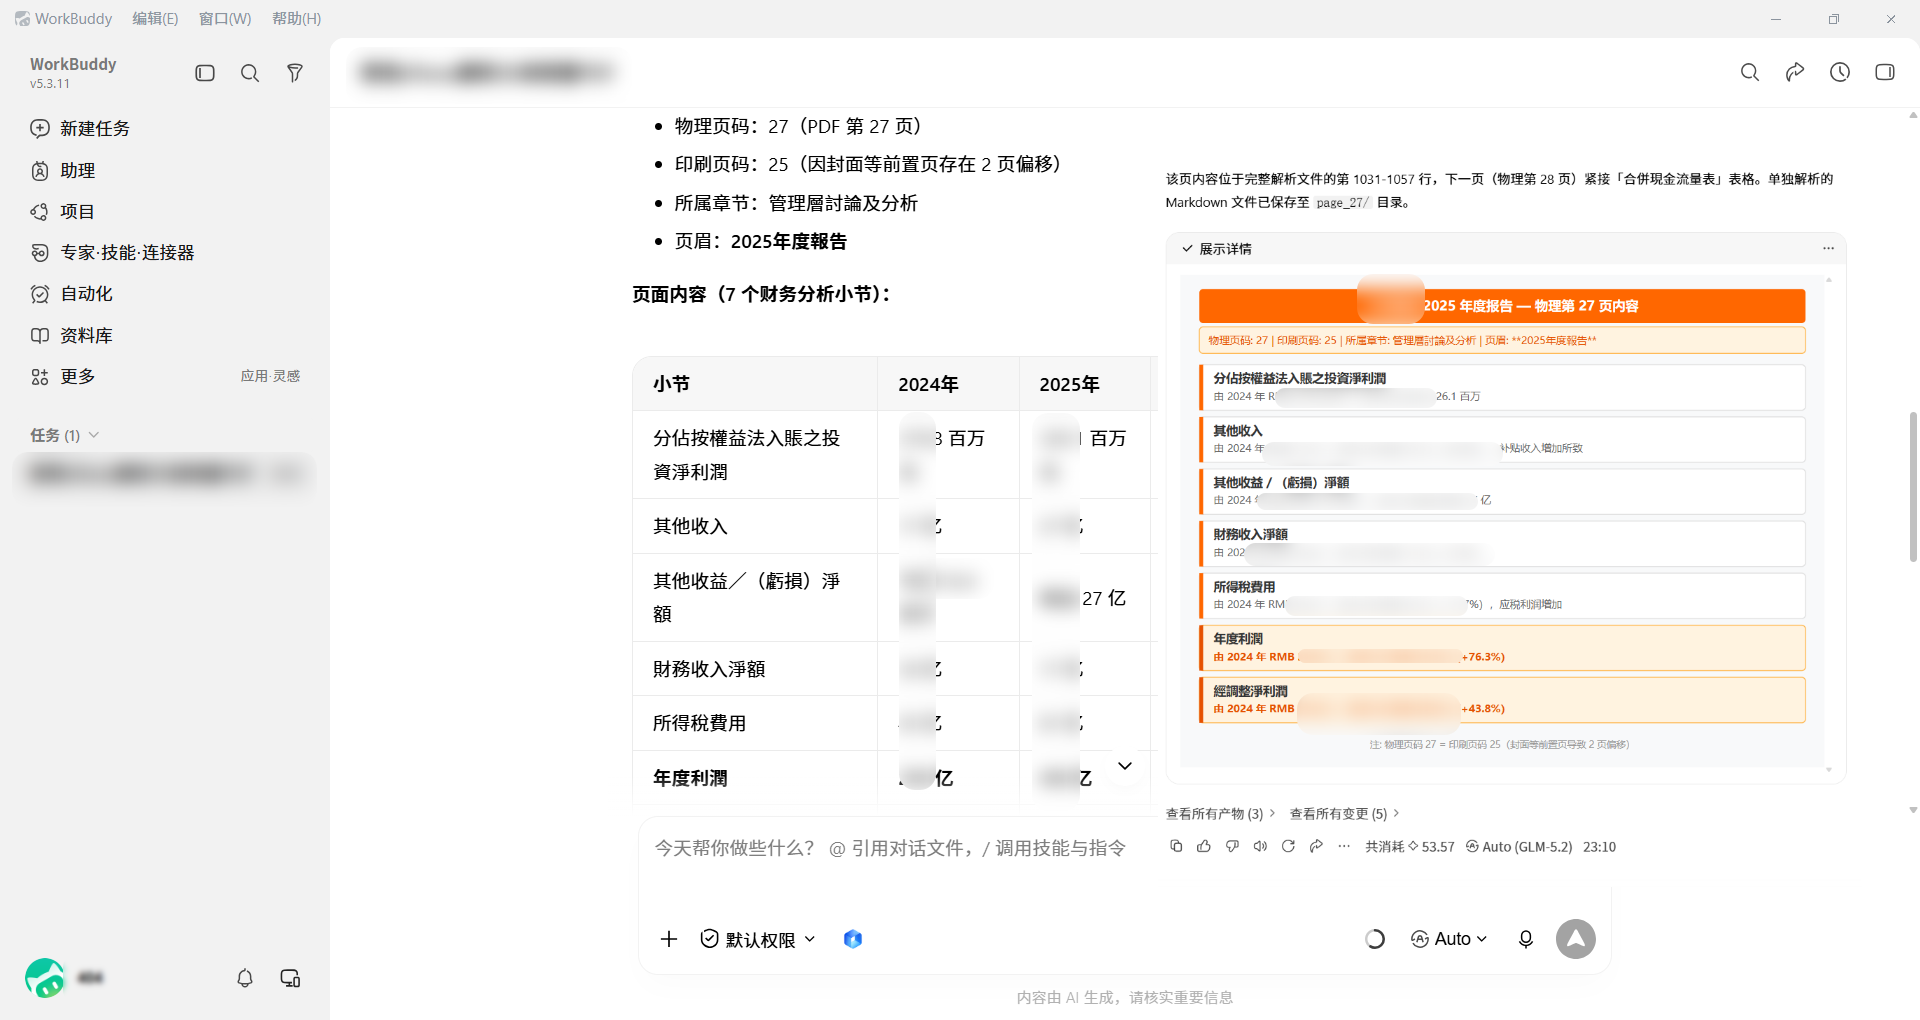
源财报 -> xParse 解析后
多级表头表格
财报中的收入结构、成本构成、地区收入等表格,经常会把“本期金额 / 本期占比 / 上期金额 / 上期占比”放在多级表头下。但 xParse 解析后是清晰的表格结构
源文档部分页面: 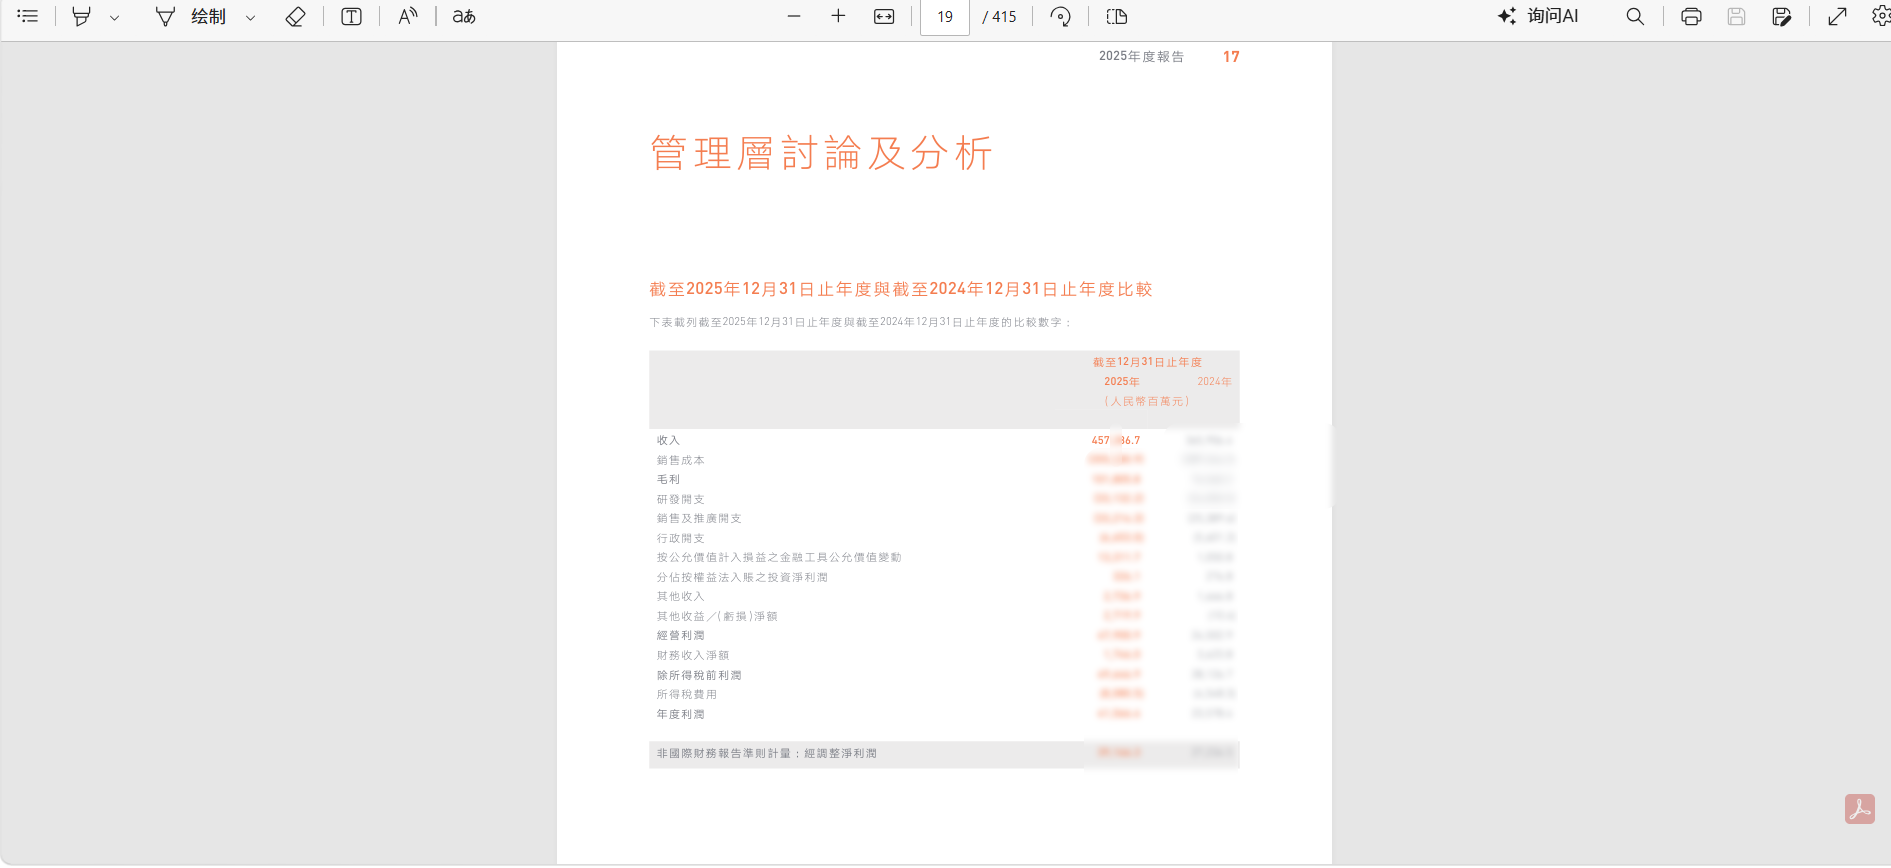 workbuddy 页面
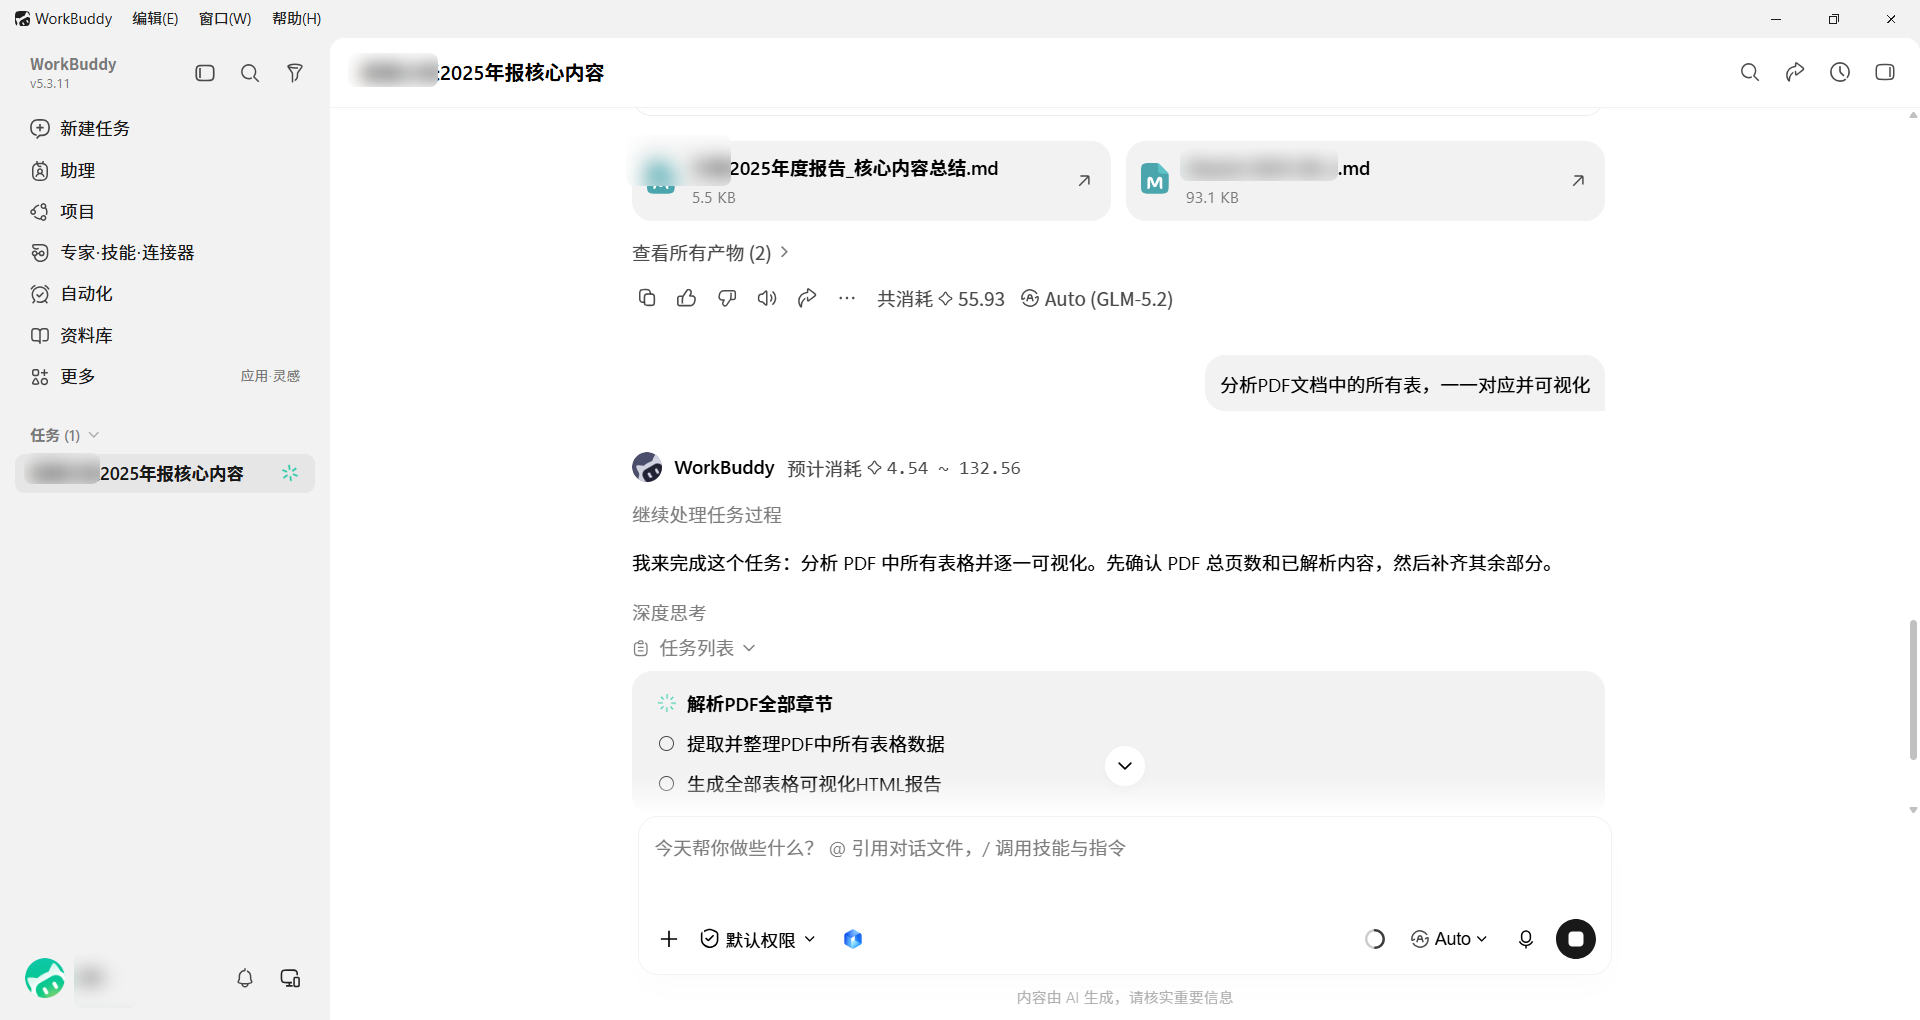
解析结果:
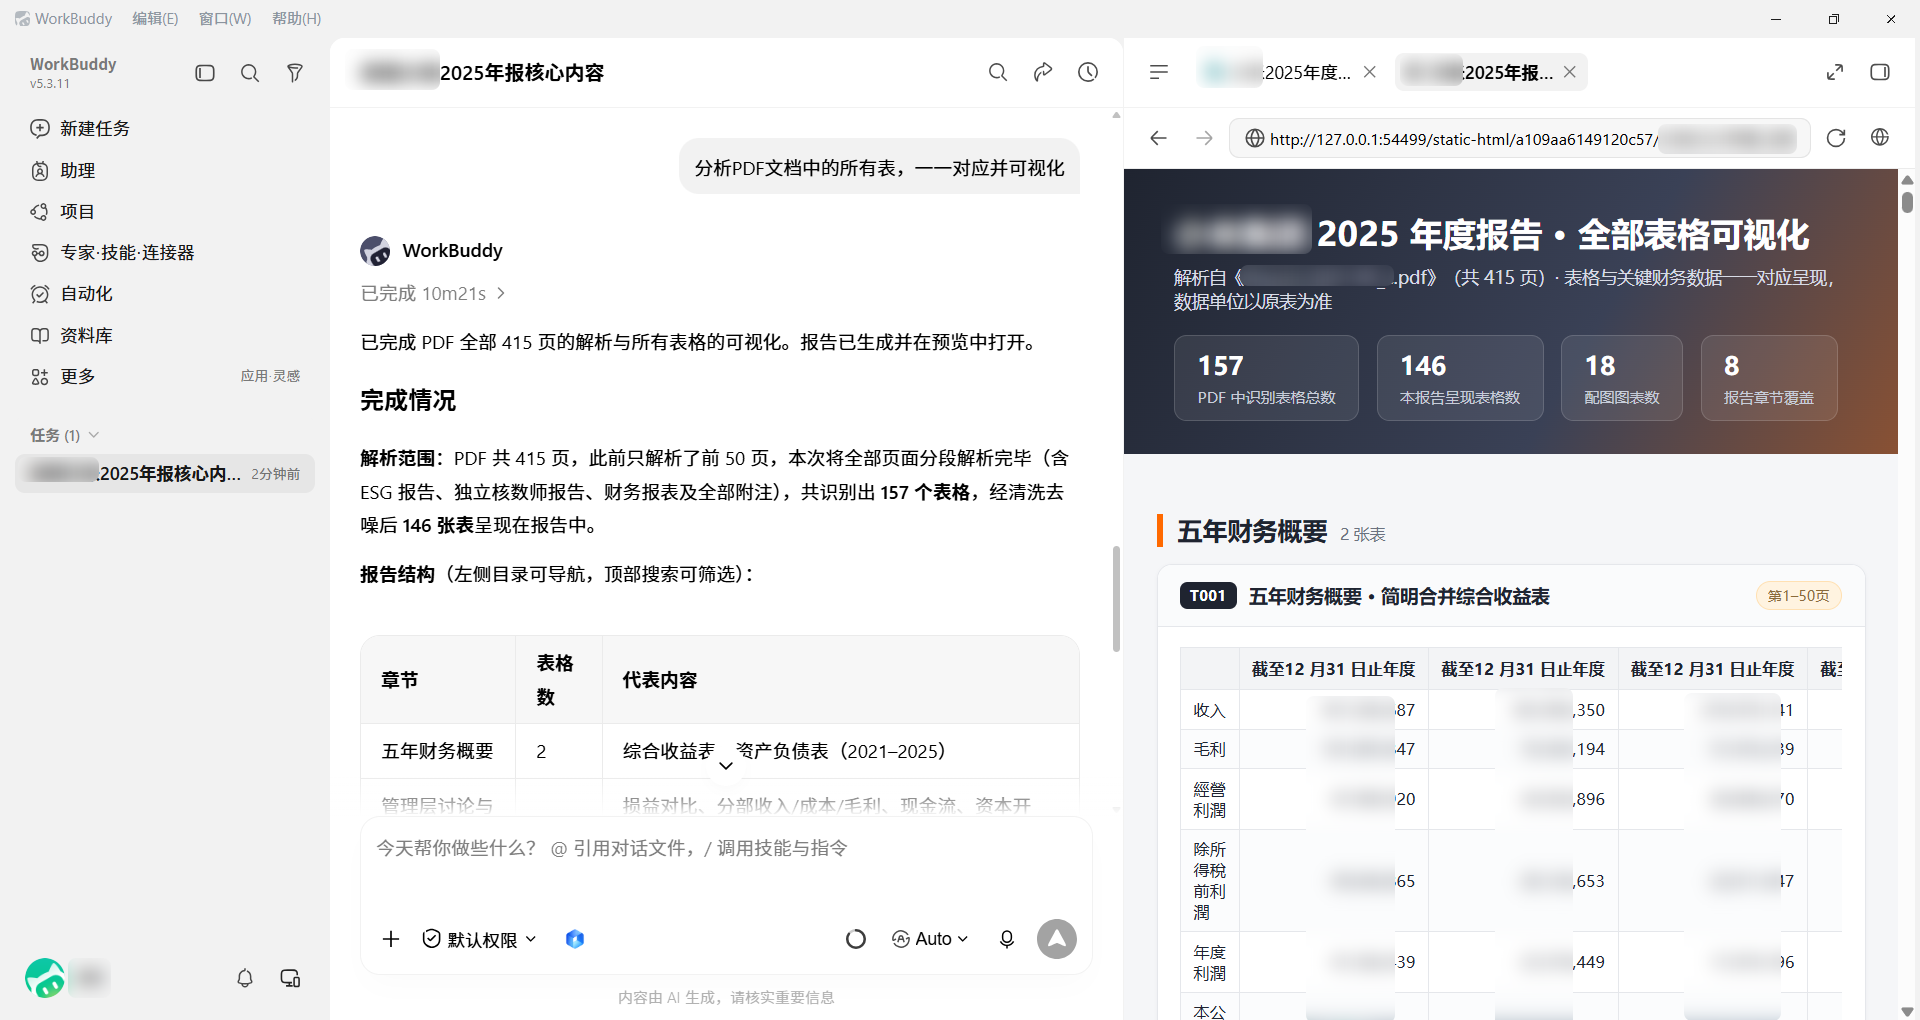
这类表格如果只识别文字,很容易把表头和数据混在一起。xParse 的价值在于保留表头层级和行列对应关系,使 AI 后续能够基于表格继续做收入结构、成本结构和同比变化分析。
图文混排页面
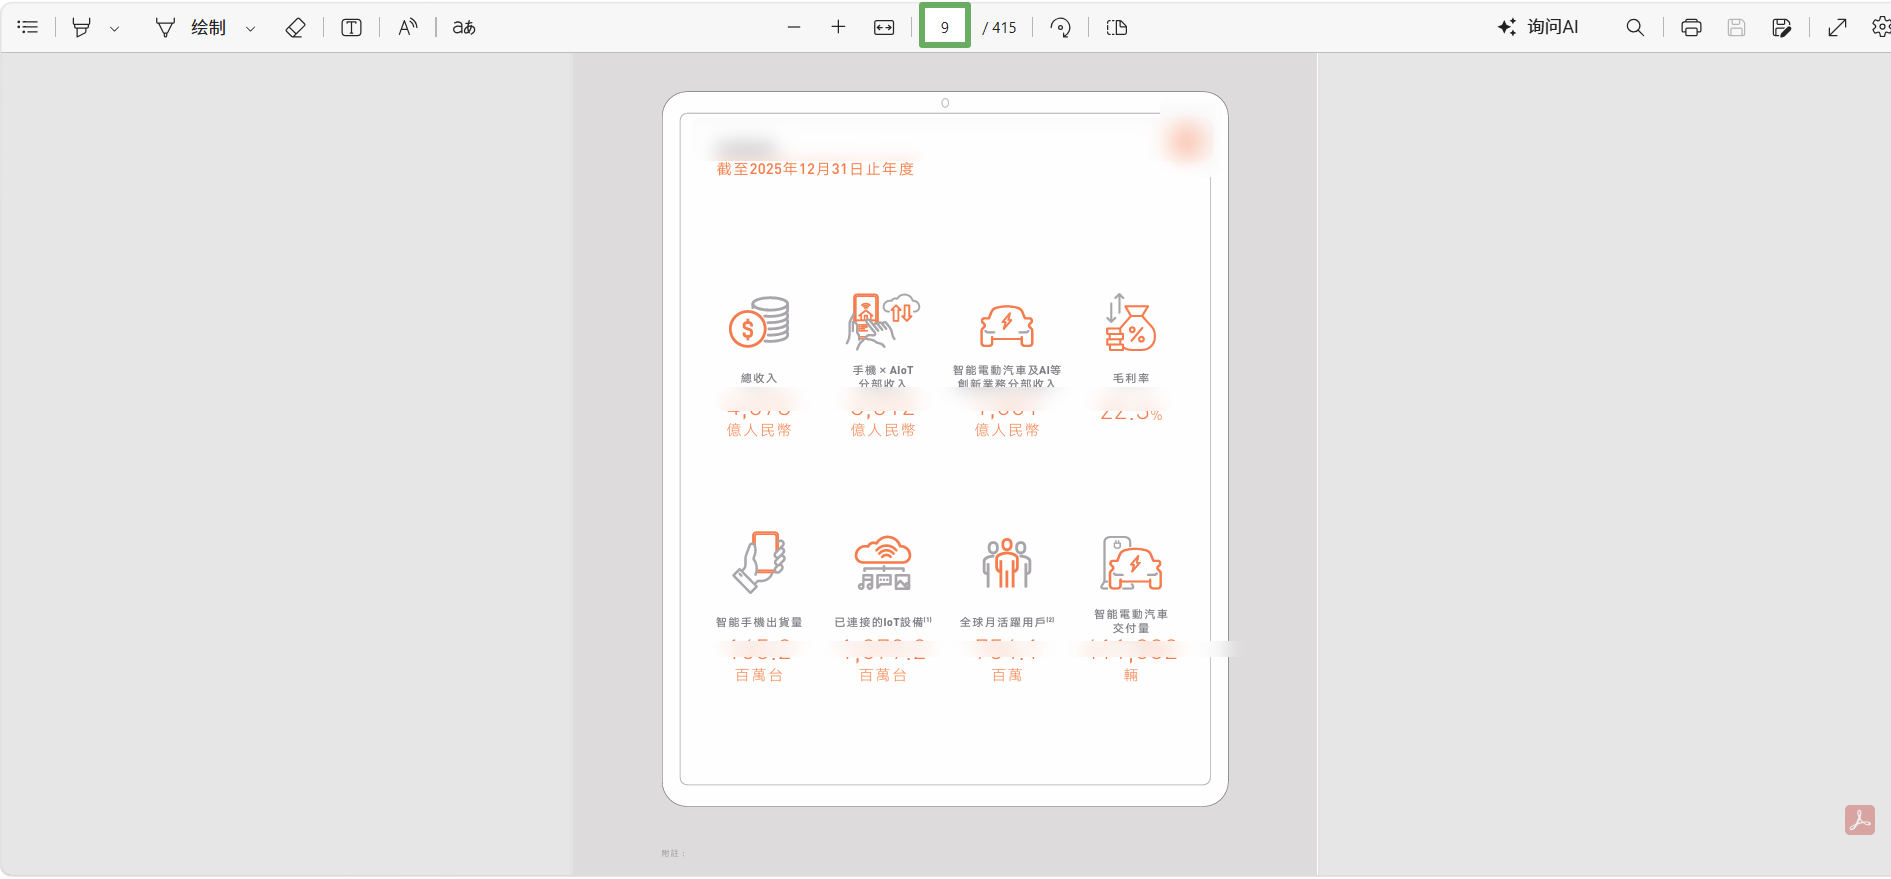
年报里经常会出现“数据图表 + 图下注释”的混排页面。普通文本提取容易只拿到正文,忽略图表本身和说明之间的关系。
源文档:
结果展示:

对于经营分析来说,图表并不是装饰信息。图表往往承载了业务趋势、产品结构、市场区域或研发投入变化。如果解析时能保留图文关系,AI 在生成报告时就更容易把正文解释和图表信息结合起来。
跨页表格
财报附注里常见跨页表格,例如资产明细、应收账款账龄、前五大客户或供应商、长期股权投资等。
源文档:

解析结果示例:

跨页表格的关键不是识别某一页,而是尽量保持连续表格的上下文关系。否则 AI 可能只分析了第一页,漏掉后续行,或者把下一页表头当成新表格处理。
密集数字与脚注说明
财务报表附注里经常出现大量数字、括号、脚注和单位说明。对经营分析而言,单位、口径、备注都很重要。
原文档:

解析结果示例:


如果单位和备注丢失,后续分析可能会把“万元”和“元”混用,或者忽略“合并口径”“母公司口径”等关键限制条件。xParse 对这些版面元素的保留,可以减少后续 AI 分析中的误读。
经过这一套流程之后,现在那些原本散落再复杂文档中的信息能够继续参与后续的 ai 分析和业务处理
那么,AI 财报分析助手究竟解决了那些实际问题?与传统的人工处理方式相比,又带来了怎样的效率提升?下面我将继续从实际使用的角度进行分析
从文档解析到业务结果:AI 财报分析助手带来了什么
通过前面的实际操作,可以看到,整个流程并不是简单的将一份 PDF 文档转换成文本、markdown,而是完成了从原始文档到结果的一个处理过程
对于企业分析人员来说,它将原本需要人工完成的部分重复性工作交给 AI,让文档中的信息能够更进一步的参与后续的分析等工作
在本次的分析过程中,一份超 400 页的年度报告,在经过 xParse 对文档解析后,将原本大量复杂的文字、表格等内容,转换成结构化结果,后续就可以继续交给 WorkBuddy 进行分析
这意味着分析人员不再需要从头开始人工整理文档,现在可以先让 xParse 解析后交给 ai 进行后续处理
这次还有一点值得关注就是:复杂的表格处理能力
对于企业的财报来说,单纯的识别出表格中的文字和数字这不意味着完成了文档解析。大家可以试一下使用 ocr 识别,识别一下表格,识别出的结构是错乱的,那么这种数据在后续处理中是不可用的。但是通过 xParse 处理后的结果它保留了对应表格的结构,它的数据是可用的
我认为文档解析能力对于 AI agent 来说
AI 不只是需要“读到”文档中的内容,它更需要“读懂”这里面的内容
当然,文档解析只是其中一个,咱解析后还需要进行后续的业务处理
就比如上面实践,让 WorkBuddy 基于解析后的内容去生成“经营分析报告”,将财报中的各个信息进行整理,并形成更适合业务人员阅读的分析内容
当然,这样并不意味着 AI 可以完全取代专业人员,它只是将大量重复性的资料整理工作交给 ai 完成,这样能给让分析人员更快的进入需要判断和决策的环节。
结语
通过这次对 400+页企业年度报告的实际处理,我更加直观的感受到,AI 在企业中的落地,并不只是让 AI 帮助我们生成一段文字或者回答一个问题。
对于财报这类复杂业务文档,AI 真正需要解决的不只是“生成报告”,而是从原始文档中准确获取信息、保留结构,再进一步完成分析。
本次通过 WorkBuddy & xParse 的组合,实现 400+页的年报上传、文档解析、复杂表格识别,再到经营分析报告生成的完整流程。
TextIn xParse 是合合信息旗下面向 LLM 与 Agent 的文档智能基础设施,可以将复杂文档转化为干净、一致、可用于 AI 的结构化数据,适用于知识库、RAG、或其他 AI 工作流下游应用。
让 AI 帮助我们生成一段文字或者回答一个问题。
对于财报这类复杂业务文档,AI 真正需要解决的不只是“生成报告”,而是从原始文档中准确获取信息、保留结构,再进一步完成分析。
本次通过 WorkBuddy & xParse 的组合(workbuddy 专家·技能· 连接器 搜索TextIn Xparse),实现 400+页的年报上传、文档解析、复杂表格识别,再到经营分析报告生成的完整流程。
TextIn xParse 是合合信息旗下面向 LLM 与 Agent 的文档智能基础设施,可以将复杂文档转化为干净、一致、可用于 AI 的结构化数据,适用于知识库、RAG、或其他 AI 工作流下游应用。
此外依托 WorkBuddy 连接器生态,xParse 还可帮助用户打破办公系统“信息孤岛”。通过联动腾讯文档、QQ 邮箱等应用,xParse 助力 AI 精准读取邮箱文件、周报,实现跨平台互通。