用 AI 五分钟写完口播稿,我拍了 17 遍
用 AI 写一条 5 分钟的口播稿,现在只要五分钟。上个月我就这么干,然后把稿子拍了 17 遍。
卡住我的不是内容,是我念不出来。
在整条视频生产链上,AI 已经把写和剪都大幅降本了,只有"对着镜头把稿子讲出来"这一步还是纯人力 —— 而且它是唯一一步废了救不回来的。剪坏了能重剪,字幕错了能改,但你讲漏的那句话,不在素材里就是不在素材里。
一条 8 分钟的片子,如果平均每条重来 6–8 次,真实投入就是 50 分钟以上,而且全是站着重新讲一遍。
念不出来,只有两个原因
- 忘了下一句要说什么 → 停下重讲,而且通常得从段落开头接回去
- 记得内容、记不住措辞 → 要么绕成自己的口语(语义漂了),要么就得看稿
- 看稿 → 眼神离开镜头、语调变平,观众不一定说得出哪里怪,但会划走
这是个死结:背稿不现实(800 字的稿子背下来,比录一遍还慢),看稿又不自然。
所以解法不是"记得更牢",而是让稿子出现在你视线的正确位置。这件事的关键从来不是记忆力,是眼神。
提词的难点不是"显示稿子",是"放在哪"
传统提词器是给演播室做的:镜头前挂一块半透镜,稿子从下往上滚,主播眼睛看稿、镜头拍到的却是"他在看镜头"。代价是要硬件、要位置、要有人操作,而且只服务出镜这一种场景。
搬到手机上,多数做法是把稿子贴在屏幕边缘、或者另开一个窗口 —— 眼神偏了,那个窗口本身还可能被录进画面。
真正的难点在这里:提词得浮在画面上,但"它会不会被拍到"取决于你怎么拍。
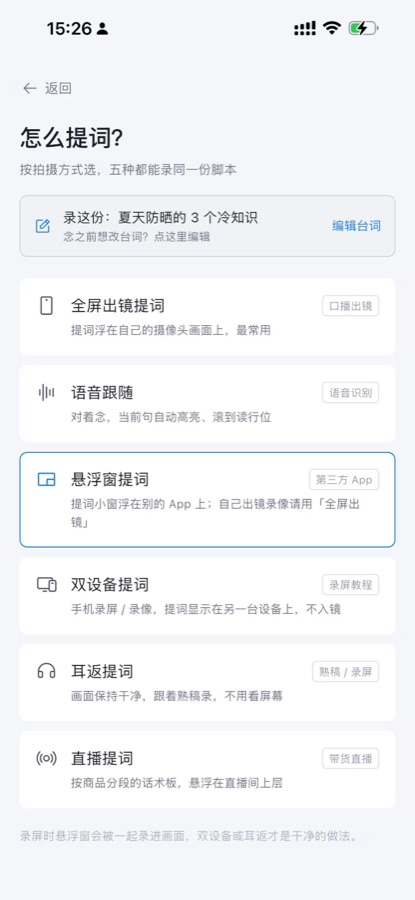
讲笔手机版是按拍法切模式的:
| 出镜口播 | 全屏提词,浮在自己的摄像头画面上 |
| 用系统相机、抖音等第三方 App 拍 | 悬浮小窗浮在最上层,自拍时不入镜 |
| 手机录屏 / 录像 | 改双设备(提词放另一台机器)或耳返 |
最后一行是个硬边界:录屏抓的是"合成之后的显示输出",悬浮层就在那一层里,系统层面排不掉 —— 这不是某个 App 没做好,是机制本身如此。官网把这条限制直接写出来了,没有把悬浮窗吹成万能,这一点我比较认可。
真正救"重录"的是两个小动作
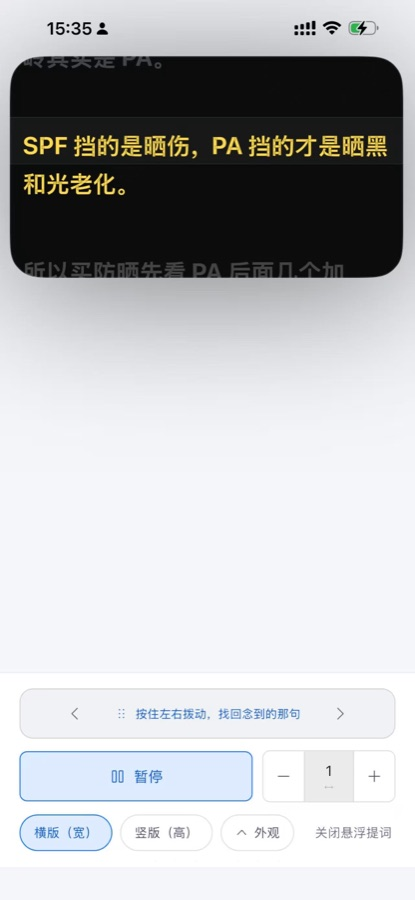
- 念漏了拨回去 —— 按住提词区左右滑动,把提词拨回你正在念的那句,不用停机重来。这一下省掉的往往是一整段
- 录制中随手改 —— 字号、滚动速度、美颜、画中画,录着就能改,不用退出重录;稿子在录制前、录制中都能直接编辑
把"重录"从"重来一遍"降级成"拨一下",比让你一次就成功更有价值。
两个限制也顺便说清楚:手机版不做剪辑,只做提词和拍摄,修片还得回桌面端;语音跟随走的是实时识别服务,断网时不可用。
顺序别搞反
如果你正准备做口播或教程视频:
很多人是反过来的:肯花一下午研究剪辑软件的分割和关键帧,却不肯花十分钟解决"我念不出来"这件事。前者最多省你十分钟,后者能省你一个小时。