当你还在排队等 GPT-5 的 API 额度时,有一群人已经在自己的手机上跑起了完全离线、不花一分钱的小模型——聊天、翻译、写代码、分析文档,全在本地完成,连网都不用开。
这不是科幻。2026 年,以 Qwen2.5-0.5B、Phi-3 Mini、Llama 3.2 1B 为代表的「极小参数大模型」已经成熟到可以塞进一部手机、一个树莓派、甚至一台 4GB 内存的古董笔记本里。
今天就聊聊:这些小模型能做什么、怎么选、怎么跑。
我们常说的「大模型」,动辄几百亿甚至上千亿参数。GPT-4 据传超过 1.8 万亿参数,需要成百上千张 GPU 才能跑起来。
而「小模型」是指参数量在 5 亿(0.5B)到 40 亿(4B)之间 的语言模型。量化压缩后,它们的内存占用只有 300MB~2GB,可以在消费级设备上运行。
换句话说:大模型是云端超级计算机在跑,小模型是你口袋里那部手机就能跑。
一张图看懂大小模型差距:
| 参数量 | 数千亿~万亿 | 5亿~40亿 |
| 硬件要求 | 数十张 A100/H100 | 手机 / 笔记本电脑 / 树莓派 |
| 内存占用 | 100GB+ | 0.3GB~4GB(量化后) |
| 是否联网 | 必须联网 | 完全离线可用 |
| 费用 | 按 token 计费 | 零成本 |
| 隐私 | 数据上传云端 | 数据不出设备 |
| 响应速度 | 受网络影响 | 毫秒级本地响应 |
二、2026 年最值得关注的 5 款小模型
经过社区的广泛测试,下面这 5 款是公认能打的小模型:
1. Qwen2.5-0.5B-Instruct(阿里)
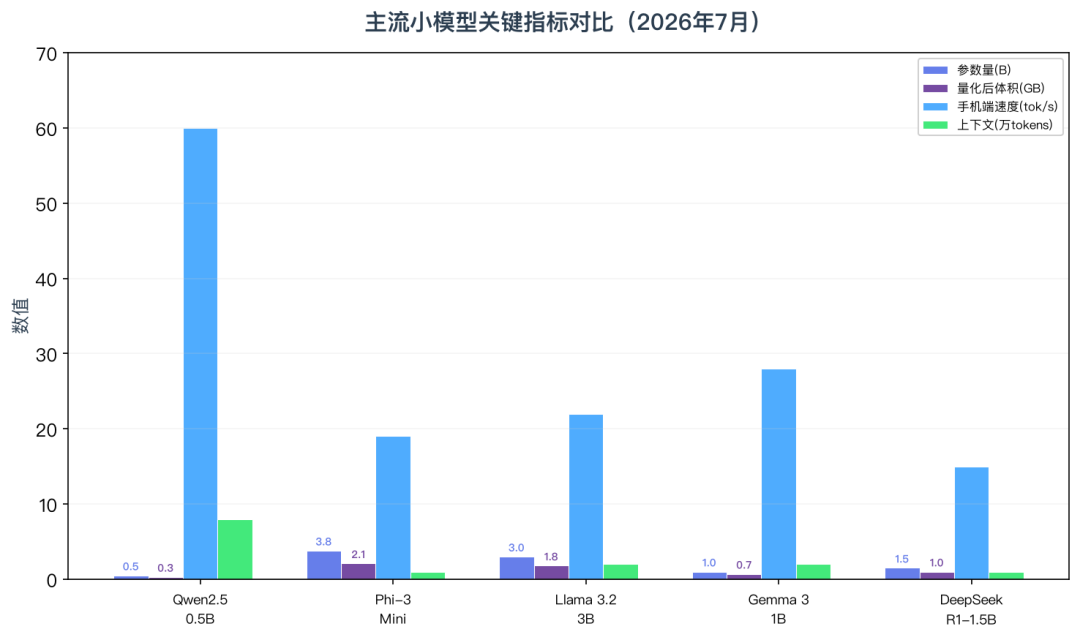
- 参数量:5 亿,量化后仅 0.3GB
- 亮点:极限轻量,32K 上下文,支持 29 种语言,可输出 JSON 结构化数据
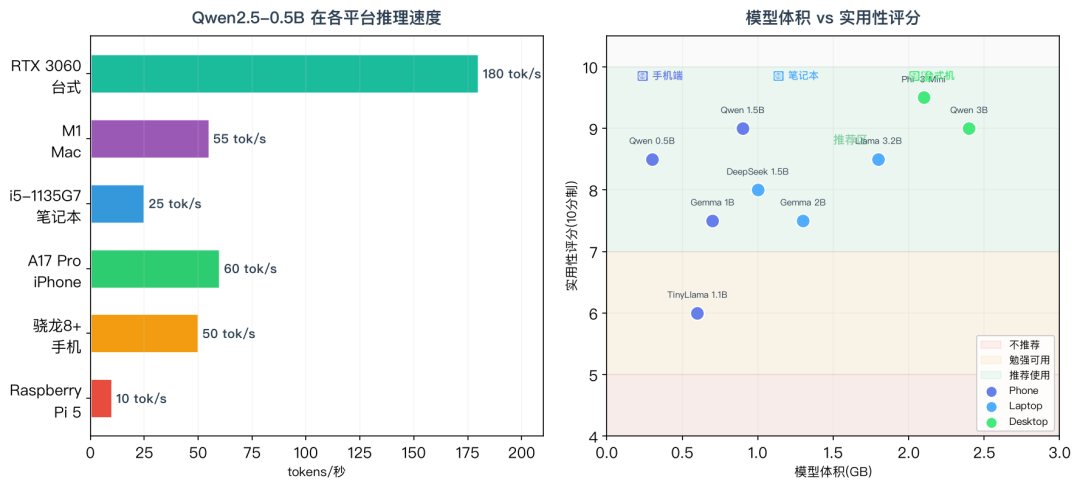
- 实测:iPhone A17 Pro 上跑 Q4 量化版,速度可达 60 tokens/s
- 适合:手机端日常对话、结构化数据提取、嵌入式设备
2. Phi-3 Mini 3.8B(微软)
- 参数量:38 亿,量化后约 2.1GB
- 亮点:小体积中推理能力最强,代码生成和逻辑推理出色
- 实测:4GB 笔记本 CPU 推理首响 8 秒,持续生成稳定
- 适合:代码辅助、文档分析、离线问答
3. Llama 3.2 1B/3B(Meta)
- 参数量:10 亿 / 30 亿,量化后 0.8GB~1.8GB
- 亮点:多模态 + 函数调用,适合本地 Agent
- 实测:iPhone 16 Pro 跑 3B Q4,15 tokens/s,续航每小时耗电约 6%
- 适合:本地智能体、图像识别+文本生成
4. Gemma 3 1B(Google)
- 参数量:10 亿,量化后约 0.7GB
- 亮点:Google 专为移动端优化,NPU 友好
- 实测:骁龙 8 Gen 3 手机上跑 1B,速度 25~30 tokens/s
- 适合:安卓手机端高频问答
5. DeepSeek-R1-Distill-Qwen-1.5B
- 参数量:15 亿,量化后约 1.0GB
- 亮点:蒸馏自 DeepSeek-R1,保留推理能力,小体积也能「思考」
- 适合:需要一定推理能力的场景,如数学题、逻辑问题
三、手机端实战:三步跑起你自己的小模型
别以为这只是极客的玩具。2026 年,在手机上跑模型已经简单到「下载 App → 选模型 → 开聊」。
方案 A:傻瓜式(推荐 99% 的人)
Android 用户 → 下载 MLC Chat(Google Play 直接搜)
- 打开 App,模型商店里直接选 Qwen3 1.7B 或 Phi-4 Mini
- 下载模型(约 1.5~3GB)→ 加载 → 对话
- 骁龙 8 Elite 上跑 Qwen3 1.7B,速度可达 40 tokens/s
- 全程离线,飞行模式也能用
iPhone 用户 → 下载 PocketPal AI 或 LLM Farm(App Store 搜)
- 内置模型列表,一键下载 Llama 3.2 1B 或 Phi-3 Mini
- iPhone 16 Pro 实测:Llama 3.2 3B Q4 跑 ~15 tokens/s
- 苹果 Neural Engine 自动加速,无需任何配置
方案 B:动手派(Android + Termux + Ollama)
如果你想自己掌控每一步:
# 1. 安装 Termux(从 F-Droid 下载,不要用 Play 商店旧版)
pkg update && pkg upgrade -y
pkg install wget curl git python -y
# 2. 安装 Ollama
curl -fsSL https://ollama.com/install.sh | sh
# 3. 拉取并运行小模型(Qwen2.5-0.5B,仅300MB)
ollama pull qwen:0.5b-instruct
ollama run qwen:0.5b-instruct
# 现在可以直接对话了!
>>> 请用JSON格式列出三个城市及其人口
实测:骁龙 8+ 手机上跑 Qwen2.5-0.5B,推理速度 40~60 tokens/s,日常聊天完全流畅。
方案 C:iPhone 进阶(PocketPal + 自定义 GGUF)
# 从 Hugging Face 下载 GGUF 模型文件
# 推荐:Llama-3.2-3B-Instruct-Q4_K_M.gguf(约1.8GB)
# 用 Files App 保存到手机,PocketPal 里导入即可
重要提示:iPhone 做推理时建议保持屏幕常亮,iOS 会限制后台应用的 CPU 资源。连续推理 15-20 分钟后可能有轻微发热降频,但短对话完全没问题。
四、不止手机:低配电脑也能跑
我见过最极致的案例:一台 2015 年的戴尔笔记本(i3-4005U + 4GB 内存 + 集成显卡),照样能跑 Phi-3 3.8B。
关键技巧:
1. 量化是灵魂——原始 FP16 模型 3GB,Q4_K_M 量化后仅 1.1GB,精度损失几乎不可感知
2. Ollama 自动选最优量化版本,你只需 ollama run qwen2.5:1.5b,它自动拉取 4-bit 版
3. 关掉快速启动——Windows 快速启动会锁定内存页,导致 Ollama 启动失败率高达 67%,关掉后降至 3%
4. 虚拟内存设为物理内存的 11.5 倍——4GB 电脑设 4096MB6144MB
4GB 电脑实测数据:
| Qwen2.5:1.5b | Q4_K_M | 1.1GB | 2s | 日常聊天、中文写作 |
| Phi-3:3.8b | Q4_K_M | 3.2GB | 8s | 代码辅助、文档分析 |
| Gemma-2:2b | Q4_K_M | 1.6GB | 4s | 高频问答、英文任务 |
避坑提醒:不要盲目追求 7B!在 4GB 电脑上跑 Llama 3.2:3b 会导致启动耗时 2 分钟、首响 42 秒、最终内存溢出。参数量不是标尺,模型架构 + 量化方式 + 框架适配度才是真实门槛。
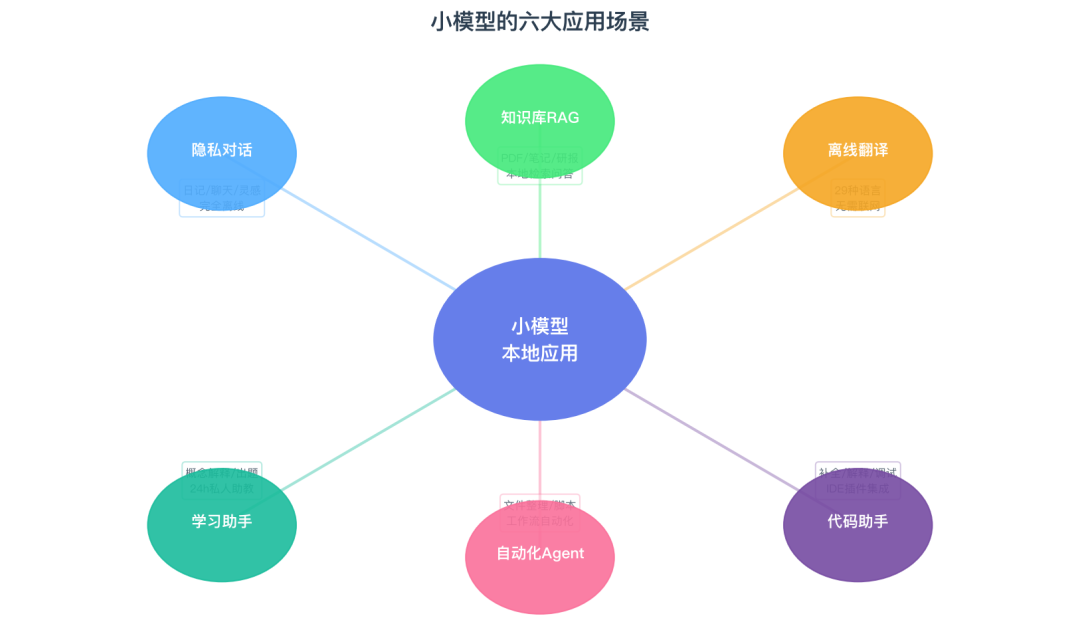
五、小模型能帮你做什么?6 个真实场景
很多人觉得小模型「能力不行」。但实际上,在很多场景下,它完全够用——甚至比云端模型更合适:
1. 隐私对话助手
你的聊天记录、日记、个人想法,不用上传到任何服务器。飞机上、地铁里、深山中没有信号的角落,照样有一个 AI 陪你聊。
2. 私人知识库问答(RAG)
把你的 PDF、笔记、研报、代码文档丢进本地向量库(Chroma/FAISS),用小模型做检索问答。「帮我总结 2025 年新能源行业研报」「解释这段 Python 代码」——全程离线,数据永远不出你的设备。
3. 离线翻译助手
出国旅行没网?小模型 + 离线翻译,Qwen2.5 支持 29 种语言,完全在本地完成。
4. 本地自动化 Agent
用 Dify.AI 或 Flowise 搭建本地工作流,小模型做决策 + 调用本地工具(文件整理、脚本执行、浏览器操作)。例如:监控下载文件夹 → 按类型自动分类 → 生成整理日报。
5. 写作辅助
润色邮件、改写文章、生成摘要、头脑风暴。虽然不如 GPT-4 那么强,但应付日常工作完全够用,而且不用为每个 token 付费。
6. 学习助手
解释概念、出题测试、代码讲解。学生党用一台旧电脑就能拥有 24 小时私人助教。
六、选型指南:一句话帮你决策
| 手机党,想零门槛体验 | Qwen3 1.7B / Phi-4 Mini | MLC Chat App 一键下载 |
| iPhone 用户 | Llama 3.2 3B Q4 | PocketPal AI |
| 4GB 老爷机 | Qwen2.5:1.5b | Ollama 命令行 |
| 8GB 笔记本 | Phi-3 Mini 3.8B | Ollama + Open WebUI |
| 树莓派 / 嵌入式 | Qwen2.5-0.5B | llama.cpp 编译运行 |
| 需要推理能力 | DeepSeek-R1-1.5B | Ollama |
| 需要代码能力 | Phi-3 Mini / Qwen2.5-Coder 3B | Ollama / LM Studio |
| 想做本地 Agent | Llama 3.2 3B(支持 function calling) | Ollama + Dify |
七、未来已来:小模型的三个趋势
趋势一:越做越小,越做越强。 2024 年 7B 模型的水平,2026 年的 1B~3B 模型已经达到了。模型蒸馏和架构优化让小型化的天花板不断抬高。
趋势二:NPU 普及,老电脑「复活」。 2027 年主流笔记本将标配 NPU(5-10 TOPS),甚至已经有 USB 便携 NPU 棒(几百元)可以让旧设备推理速度提升 3-5 倍。
趋势三:个人专属模型。 用你的聊天记录、笔记、工作文档在本地微调一个属于自己的 3B 模型——它懂你的说话风格、知识结构、习惯偏好,而且完全私有,不被任何公司监控。
总结
大模型和小模型不是替代关系,而是互补关系。
联网时,你可以用 GPT/Claude 处理复杂推理和长文档分析。断网时、需要隐私时、高频低成本场景下——把小模型切成主力,零成本、零延迟、零泄露。
AI 的未来,不只在云端的数据中心,也在你口袋里那部手机里。
附录:一键部署命令
# 安装 Ollama(全平台)
curl -fsSL https://ollama.com/install.sh | sh
# 跑起来(选一个)
ollama run qwen2.5:1.5b # 中文最强、最快
ollama run phi3:mini # 逻辑推理最强小模型
ollama run gemma3:1b # Google 移动端优化
ollama run deepseek-r1:1.5b # 带思考能力的小模型
这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!
👇👇扫码免费领取全部内容👇👇
1. 成长路线图&学习规划
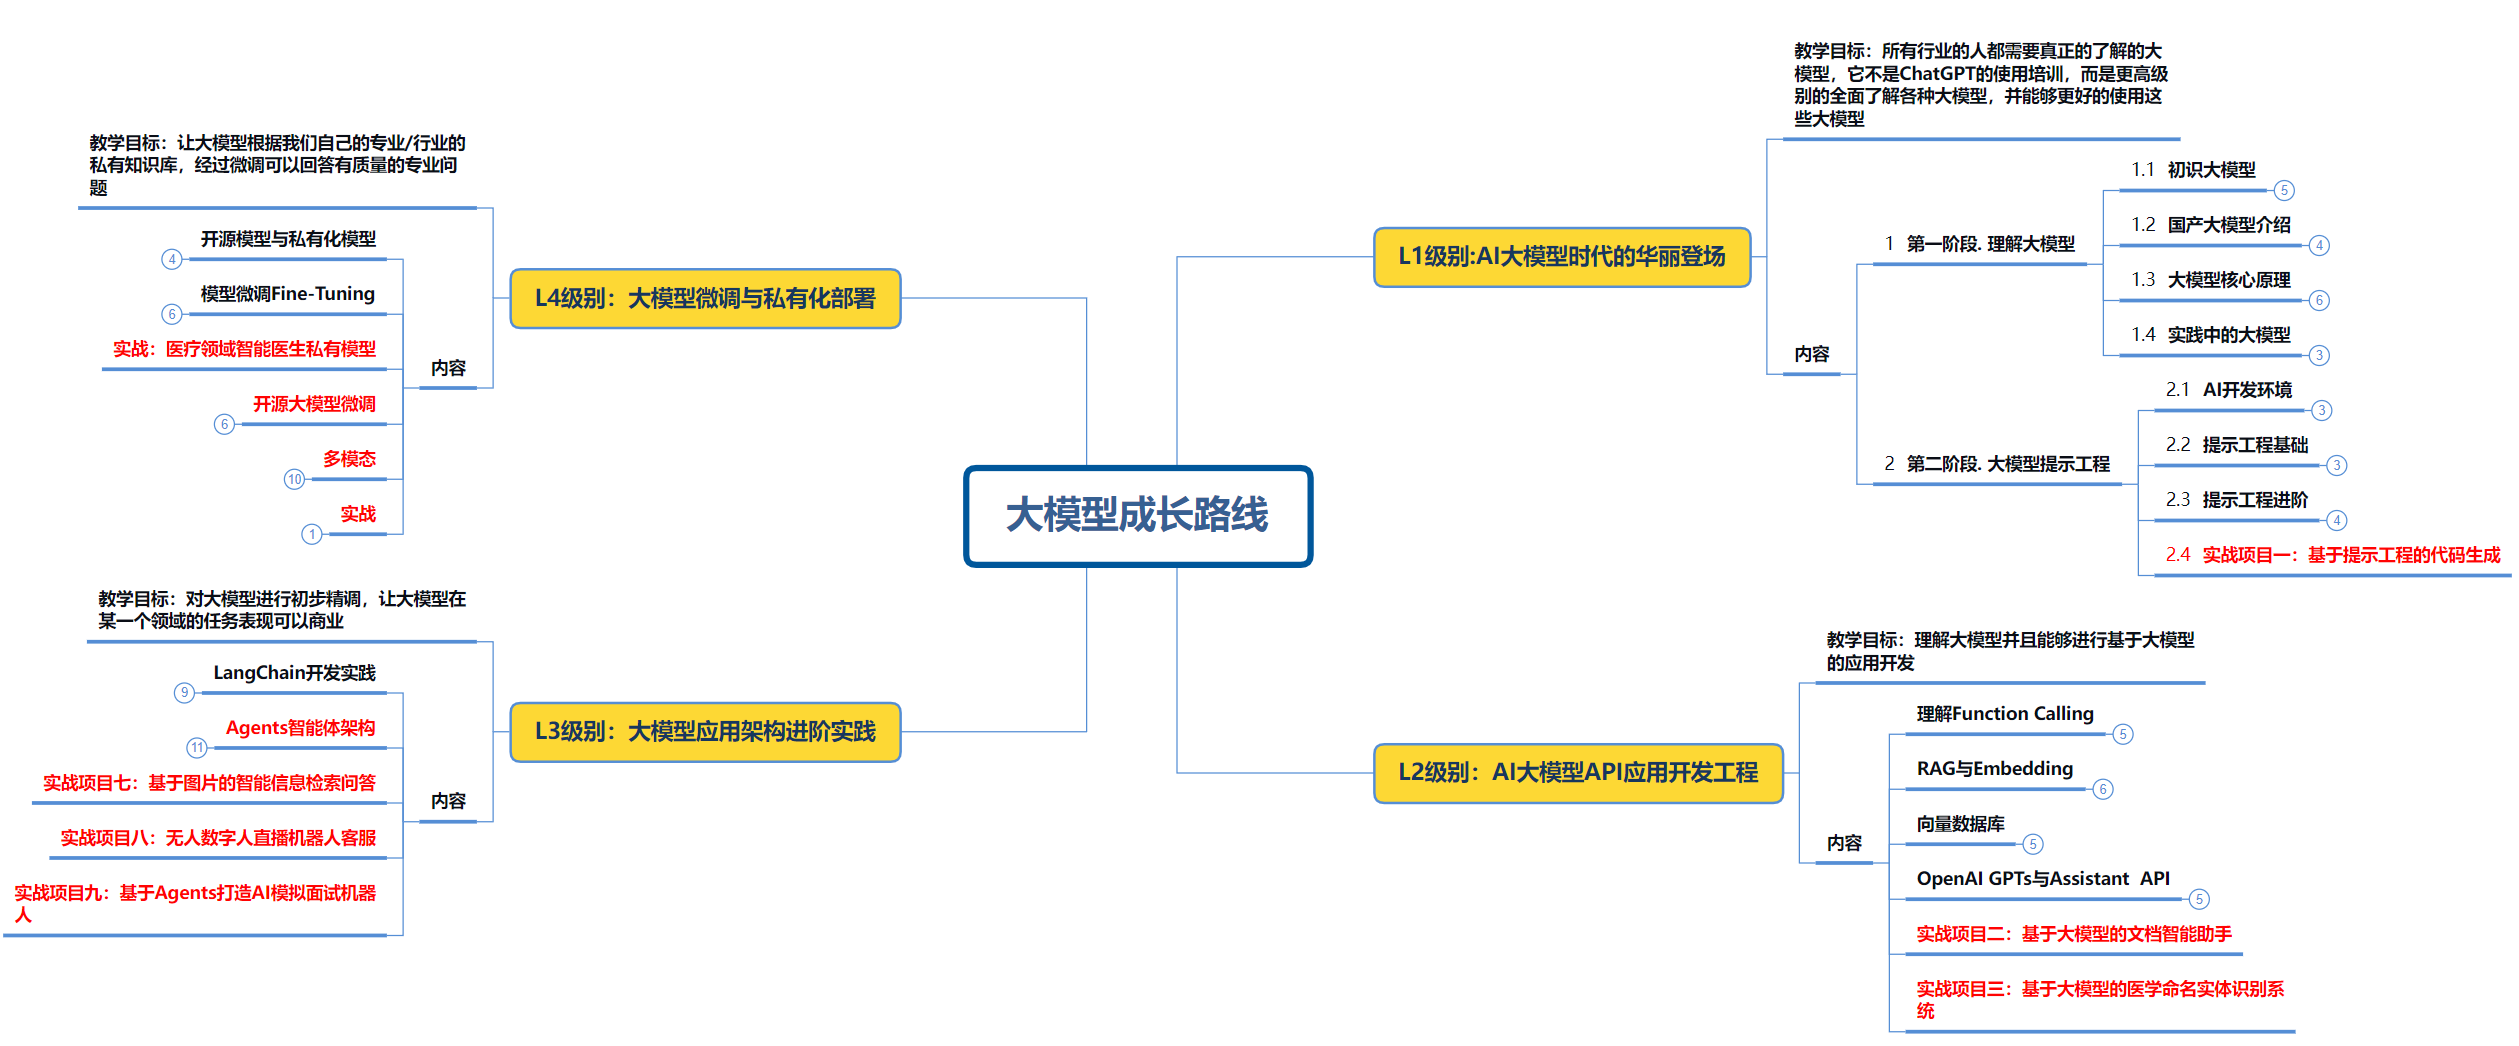
要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。
这里,我们为新手和想要进一步提升的专业人士准备了一份详细的学习成长路线图和规划。可以说是最科学最系统的学习成长路线。
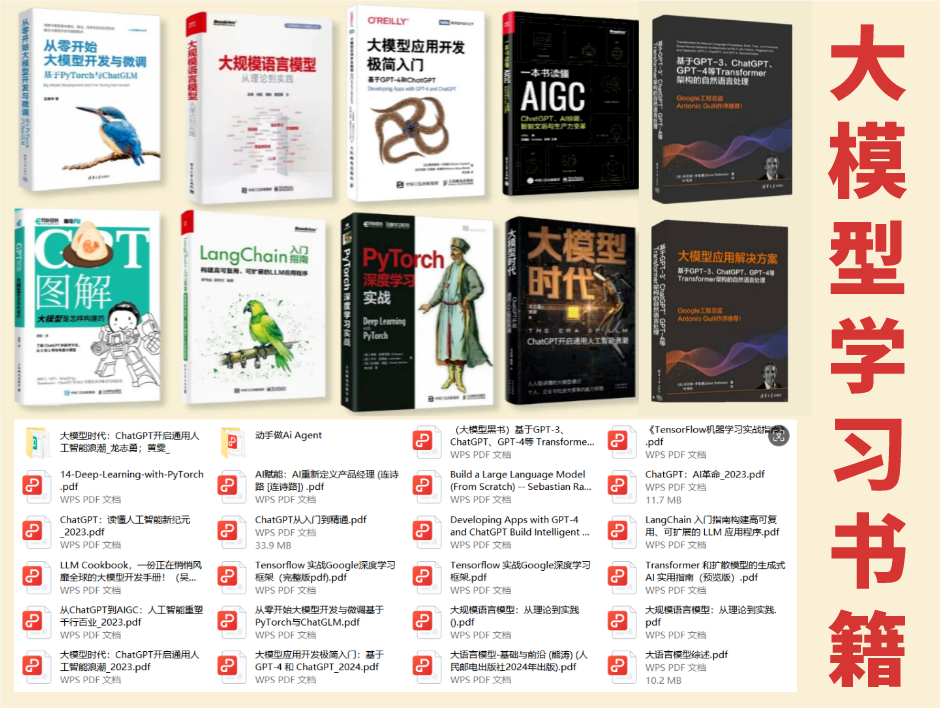
2. 大模型经典PDF书籍
书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)
3. 大模型视频教程
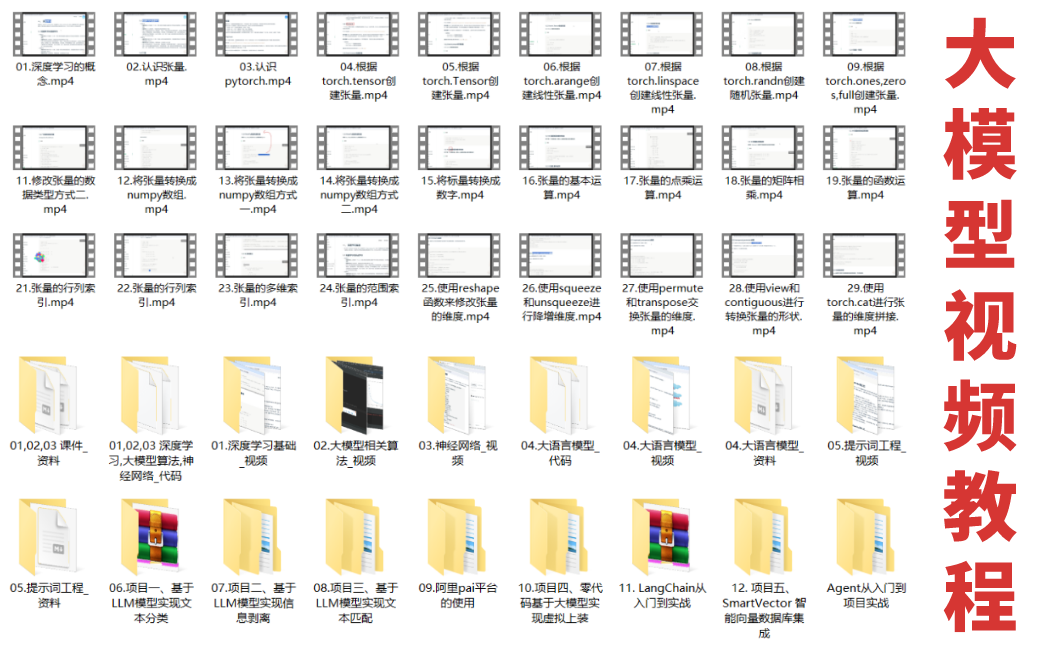
对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。
4. 2026行业报告
行业分析主要包括对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
5. 大模型项目实战
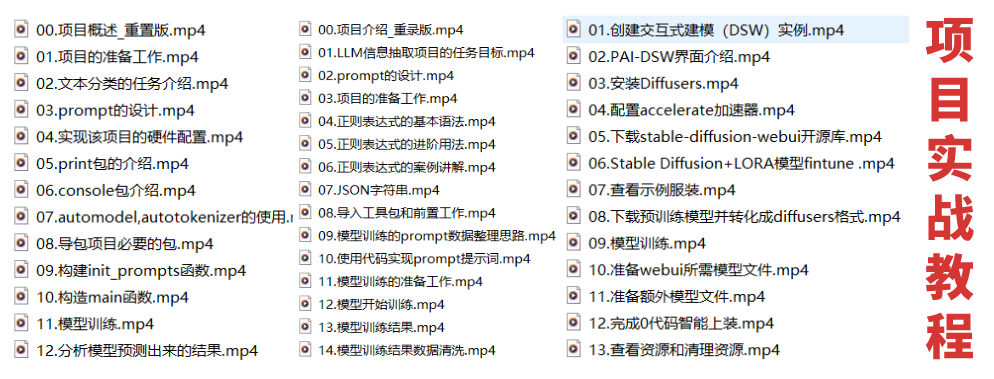
学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。
6. 大模型面试题
面试不仅是技术的较量,更需要充分的准备。
在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
7. 资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇