💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 基于大数据的游戏化 x 视觉搜索实验分析与可视化介绍
- 基于大数据的游戏化 x 视觉搜索实验分析与可视化演示视频
- 基于大数据的游戏化 x 视觉搜索实验分析与可视化演示图片
- 基于大数据的游戏化 x 视觉搜索实验分析与可视化代码展示
- 基于大数据的游戏化 x 视觉搜索实验分析与可视化文档展示
基于大数据的游戏化 x 视觉搜索实验分析与可视化介绍
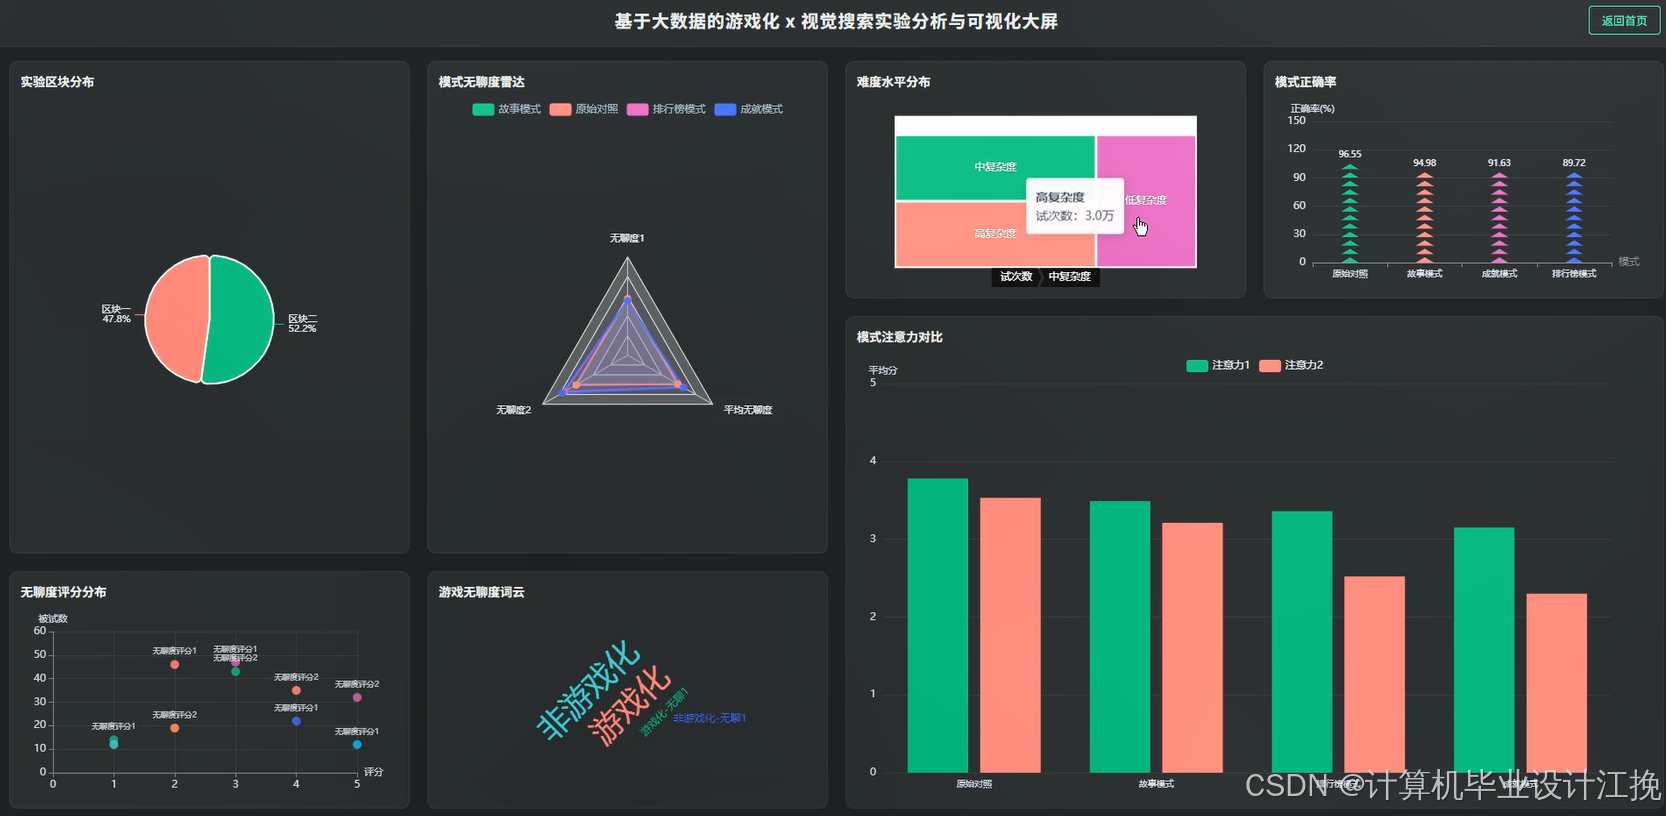
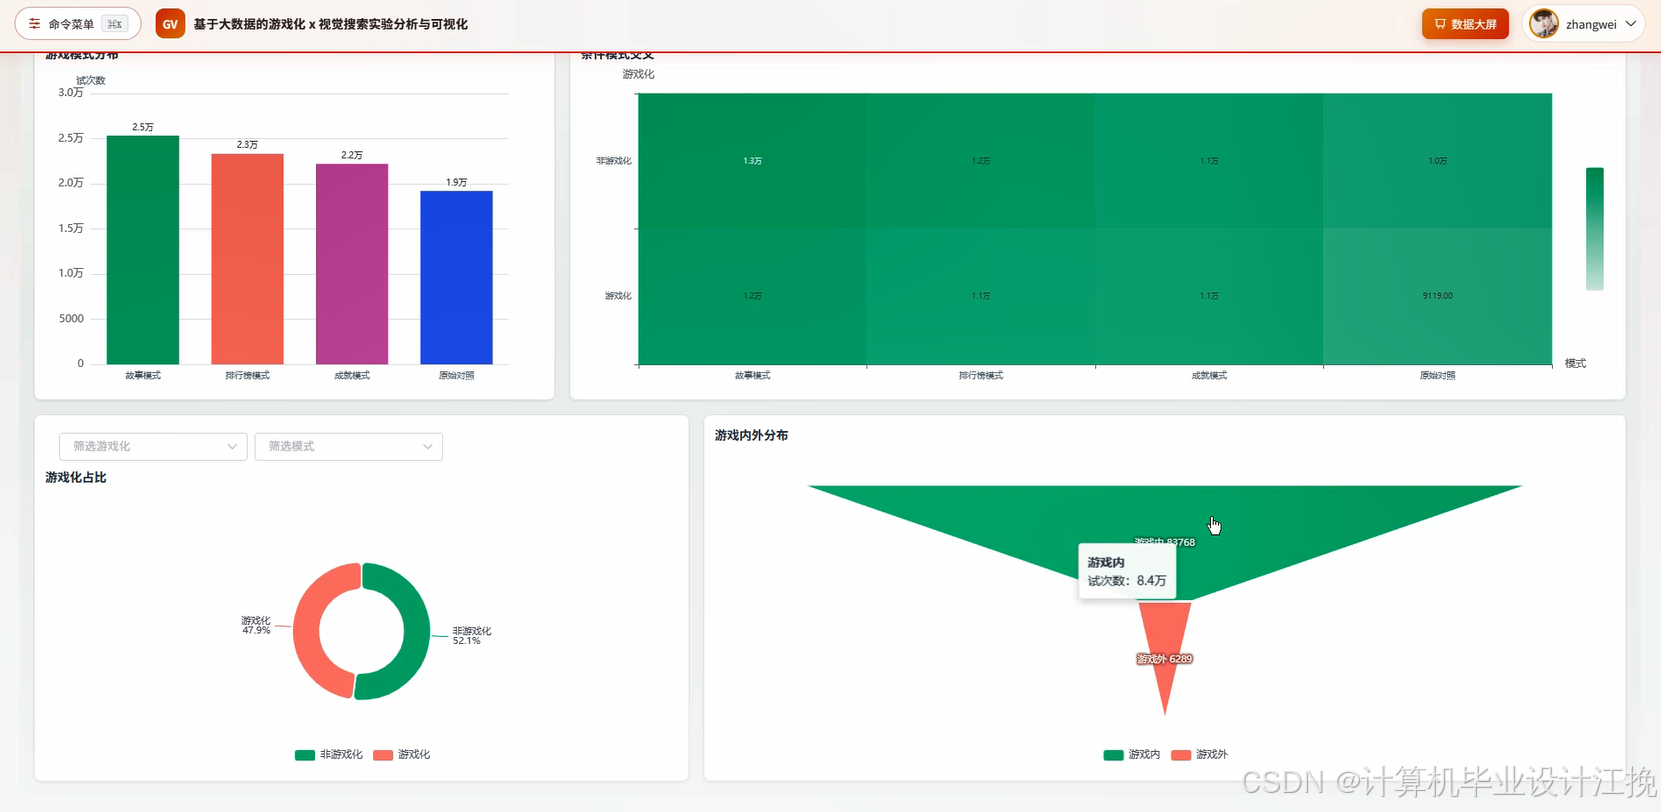
本系统名为《基于大数据的游戏化 x 视觉搜索实验分析与可视化》,面向计算机专业毕业设计场景,围绕游戏化条件下视觉搜索实验所产生的多维度数据展开分析与展示。系统以 Hadoop 与 Spark 作为大数据处理核心,借助 HDFS 完成实验数据的分布式存储,通过 Spark SQL 与 Pandas、NumPy 对视觉搜索信息、搜索绩效、主观体验、游戏条件、时间感知、任务难度、模式效应以及行为分群等数据进行清洗、统计与建模,并在此基础上构建可视化大屏。后端提供 Django 与 Spring Boot 两套实现版本,前者基于 Python 技术栈,后者基于 Java 技术栈,二者均负责实验数据管理、指标计算调度与结果接口输出。前端采用 Vue、ElementUI、Echarts 并结合 HTML、CSS、JavaScript、jQuery 完成页面交互与图表渲染,数据库使用 MySQL 存储实验元数据与用户信息。系统功能覆盖视觉搜索信息管理、搜索绩效分析、主观体验分析、游戏条件分析、时间感知分析、任务难度分析、模式效应分析与行为分群分析,能够将原始实验记录转化为可解释的统计指标与可视化结果,帮助使用者直观理解游戏化机制对视觉搜索行为的影响。
基于大数据的游戏化 x 视觉搜索实验分析与可视化演示视频
演示视频
基于大数据的游戏化 x 视觉搜索实验分析与可视化演示图片
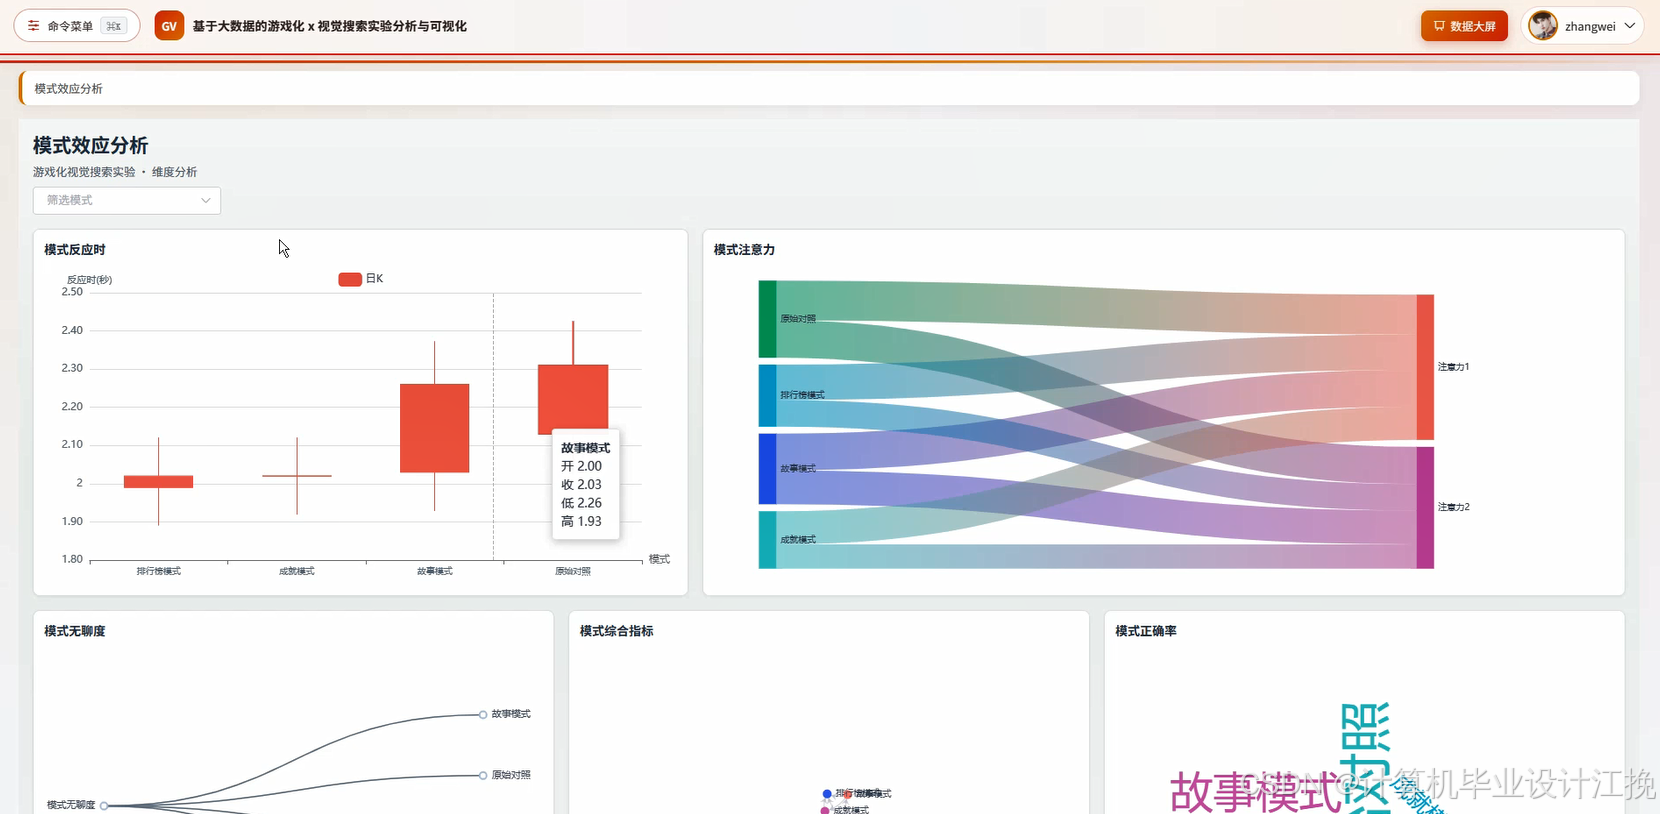

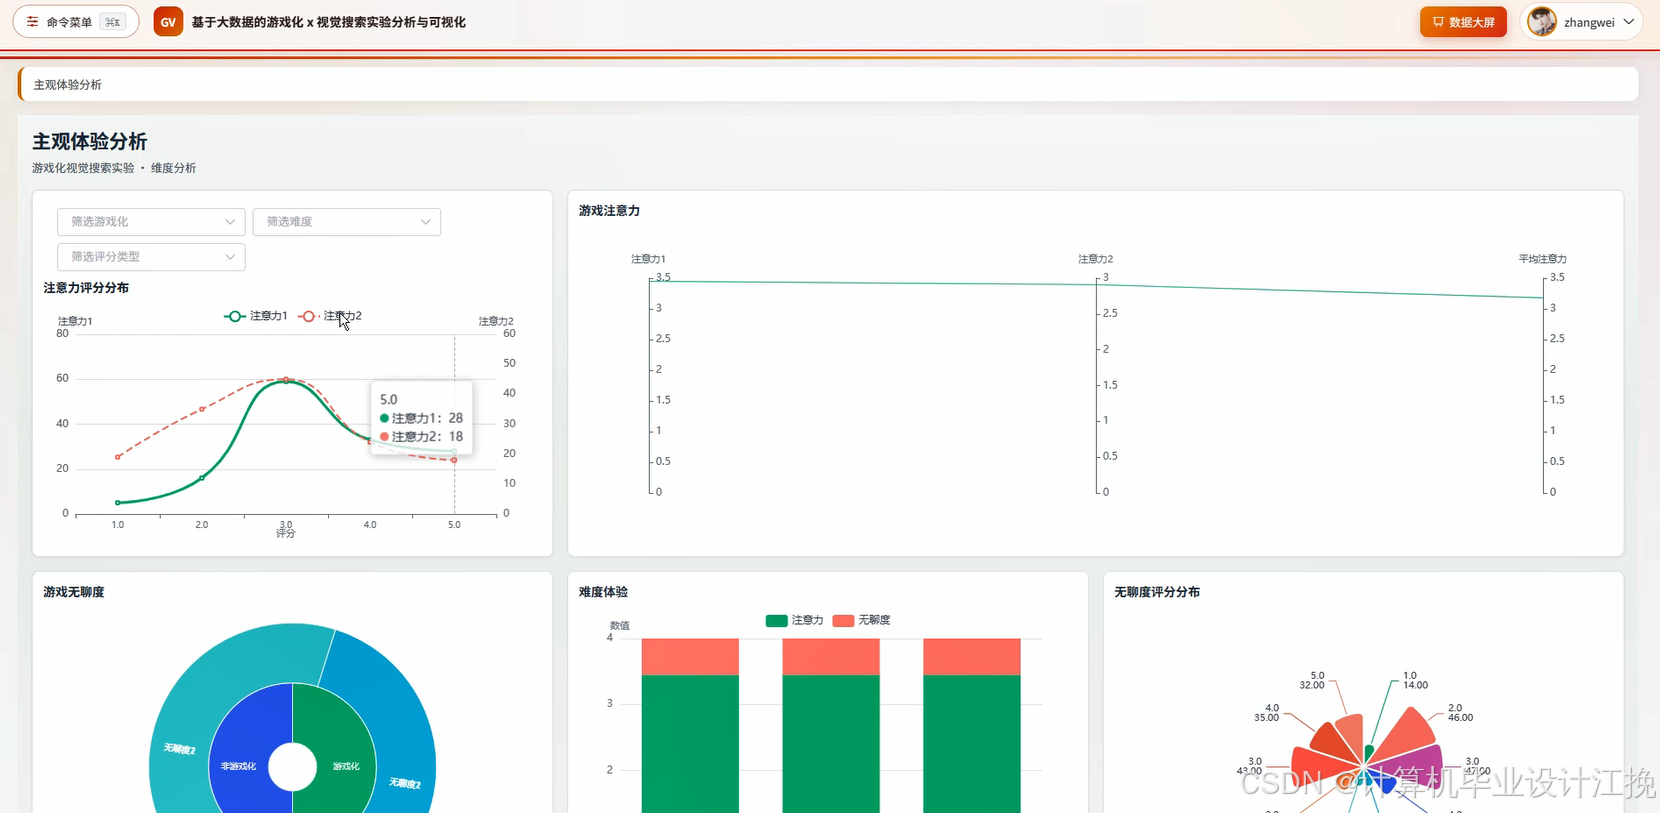

基于大数据的游戏化 x 视觉搜索实验分析与可视化代码展示
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, avg, count, when, desc, sum as _sum
import pandas as pd
import numpy as np
spark = SparkSession.builder.appName("GameVisualSearchAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").enableHiveSupport().getOrCreate()
def analyze_search_performance():
df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/visual_search/experiment_logs.csv")
df_clean = df.filter(col("search_time").isNotNull() & col("task_difficulty").isNotNull()).withColumn("search_efficiency", col("correct_count") / col("search_time"))
df_group = df_clean.groupBy("game_condition", "task_difficulty").agg(avg("search_time").alias("avg_search_time"), avg("search_efficiency").alias("avg_efficiency"), count("user_id").alias("user_count"), _sum("correct_count").alias("total_correct"))
df_result = df_group.withColumn("efficiency_level", when(col("avg_efficiency") >= 0.8, "high").when(col("avg_efficiency") >= 0.5, "medium").otherwise("low"))
df_result = df_result.orderBy(desc("avg_efficiency"))
df_result.write.mode("overwrite").option("header", "true").csv("hdfs://localhost:9000/visual_search/result/search_performance")
pdf = df_result.toPandas()
pdf["avg_search_time"] = pdf["avg_search_time"].round(3)
pdf["avg_efficiency"] = pdf["avg_efficiency"].round(3)
summary = {"total_users": int(pdf["user_count"].sum()), "avg_time": float(pdf["avg_search_time"].mean()), "avg_efficiency": float(pdf["avg_efficiency"].mean()), "high_level_count": int((pdf["efficiency_level"] == "high").sum())}
return summary
def analyze_subjective_experience():
df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/visual_search/subjective_scores.csv")
df_clean = df.filter(col("satisfaction_score").isNotNull() & col("fatigue_score").isNotNull()).withColumn("experience_gap", col("satisfaction_score") – col("fatigue_score"))
df_group = df_clean.groupBy("game_condition", "time_perception").agg(avg("satisfaction_score").alias("avg_satisfaction"), avg("fatigue_score").alias("avg_fatigue"), avg("experience_gap").alias("avg_gap"), count("user_id").alias("sample_count"))
df_result = df_group.withColumn("experience_type", when(col("avg_gap") >= 2, "positive").when(col("avg_gap") >= 0, "neutral").otherwise("negative"))
df_result = df_result.orderBy(desc("avg_satisfaction"))
df_result.write.mode("overwrite").option("header", "true").csv("hdfs://localhost:9000/visual_search/result/subjective_experience")
pdf = df_result.toPandas()
pdf["avg_satisfaction"] = pdf["avg_satisfaction"].round(2)
pdf["avg_fatigue"] = pdf["avg_fatigue"].round(2)
pdf["avg_gap"] = pdf["avg_gap"].round(2)
summary = {"total_samples": int(pdf["sample_count"].sum()), "avg_satisfaction": float(pdf["avg_satisfaction"].mean()), "avg_fatigue": float(pdf["avg_fatigue"].mean()), "positive_count": int((pdf["experience_type"] == "positive").sum())}
return summary
def analyze_behavior_clustering():
df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/visual_search/behavior_logs.csv")
df_clean = df.filter(col("search_time").isNotNull() & col("click_count").isNotNull()).withColumn("click_speed", col("click_count") / col("search_time")).withColumn("accuracy_rate", col("correct_count") / col("total_count"))
df_features = df_clean.select("user_id", "search_time", "click_count", "click_speed", "accuracy_rate").na.drop()
pdf_features = df_features.toPandas()
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler
feature_cols = ["search_time", "click_count", "click_speed", "accuracy_rate"]
scaler = StandardScaler()
X_scaled = scaler.fit_transform(pdf_features[feature_cols])
kmeans = KMeans(n_clusters=3, random_state=42, n_init=10)
pdf_features["cluster"] = kmeans.fit_predict(X_scaled)
cluster_summary = pdf_features.groupby("cluster").agg(avg_search_time=("search_time", "mean"), avg_click_count=("click_count", "mean"), avg_click_speed=("click_speed", "mean"), avg_accuracy=("accuracy_rate", "mean"), user_count=("user_id", "count")).reset_index()
cluster_summary["cluster_label"] = cluster_summary["cluster"].apply(lambda x: "fast_accurate" if x == 0 else ("slow_explore" if x == 1 else "impulsive_click"))
cluster_summary["avg_search_time"] = cluster_summary["avg_search_time"].round(3)
cluster_summary["avg_click_speed"] = cluster_summary["avg_click_speed"].round(3)
cluster_summary["avg_accuracy"] = cluster_summary["avg_accuracy"].round(3)
result_df = spark.createDataFrame(cluster_summary)
result_df.write.mode("overwrite").option("header", "true").csv("hdfs://localhost:9000/visual_search/result/behavior_clustering")
summary = {"total_users": int(cluster_summary["user_count"].sum()), "cluster_count": int(cluster_summary["cluster"].nunique()), "fast_accurate_count": int(cluster_summary[cluster_summary["cluster_label"] == "fast_accurate"]["user_count"].sum()), "slow_explore_count": int(cluster_summary[cluster_summary["cluster_label"] == "slow_explore"]["user_count"].sum())}
return summary
基于大数据的游戏化 x 视觉搜索实验分析与可视化文档展示
💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目