🏆 本文收录于 《YOLOv10实战:从入门到深度优化》 专栏。
该专栏系统复现并深度梳理全网主流 YOLOv10 改进方法与工程实战案例,覆盖分类、目标检测、实例分割、多目标追踪、关键点检测、旋转目标检测等多个方向,坚持 持续更新 + 深度解析 + 工程验证。
专栏将围绕 YOLOv10 的网络结构、训练策略、标签分配、损失函数、数据增强、模型压缩、推理加速与部署落地等内容展开,重点分析 Consistent Dual Assignments(一致性双重标签分配)、NMS-Free End-to-End Detection(无 NMS 端到端检测)、Holistic Efficiency-Accuracy Driven Model Design(整体效率-精度驱动模型设计) 等核心设计思想,并结合实际项目讲解其改进方式与应用价值。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对主流改进方案进行重构与再设计,使内容更加贴近真实业务场景,适合希望深入研究 YOLOv10 或具有工程落地需求的开发者学习与参考。
🎯限时特惠:当前活动一折秒杀,一次订阅,终身有效,后续所有更新章节全部免费解锁 👉 传送门 👈️
🎉 本专栏还不够过瘾?别急,好戏才刚刚开始!我已经为你准备了一整套 YOLO 进阶实战大礼包🎁:
👉 《YOLOv8实战》 👉 《YOLOv9实战》 👉 《YOLOv10实战》 👉 《YOLOv11实战》 👉 《YOLOv12实战》 👉 以及最新上线的 《YOLOv26实战》
想一次搞定所有版本?直接冲 《YOLO全栈实战合集》,一站式涵盖 YOLO 各版本实战教学!
🚀 想学哪个版本?直接找 bug 菌“许愿”,安排!必须安排!🚀
🎯 本文定位:计算机视觉 × YOLOv10 训练调参与实验管理篇 📅 预计阅读时间:约 45~60 分钟 🏷️ 难度等级:⭐⭐⭐☆☆(进阶级) 🔧 技术栈:Python 3.9+ · PyTorch 2.0+ · YOLOv10 · ByteTrack · OpenCV · NumPy
全文目录:
-
- 上期回顾
- 本节主题:类别不均衡训练——采样、增强与损失权重策略
-
- 引言:那些"被淹没"的类别
- 一、理解类别不均衡的本质
-
- 1.1 不均衡如何影响梯度
- 1.2 不均衡的类型
- 1.3 量化你的不均衡程度
- 二、策略一:数据层面的采样方法
-
- 2.1 图像级别的过采样
- 2.2 WeightedRandomSampler:在 DataLoader 层面控制采样
- 2.3 欠采样:什么时候反而更好?
- 三、策略二:针对性数据增强
-
- 3.1 Mosaic 增强与类别均衡
- 3.2 Copy-Paste 增强:让少数类"搬家"
- 3.3 MixUp 与针对性增强策略
- 四、策略三:损失函数加权——从根本上纠正梯度偏差
-
- 4.1 类别权重(Class Weights)
- 4.2 Focal Loss:让模型聚焦困难样本
- 4.3 GHM Loss:梯度均衡化
- 五、策略四:配置层面的参数调整
-
- 5.1 `cls` 参数:分类损失的全局权重
- 5.2 `label_smoothing`:对少数类更友好
- 5.3 验证集的正确配置
- 六、综合实战:一个完整的类别不均衡处理 Pipeline
- 七、实验对比:不同策略的效果评估
- 八、进阶话题:OHEM 与动态采样
-
- 8.1 在线困难样本挖掘(OHEM)
- 8.2 动态采样:训练中期自动调整
- 九、常见问题与调试指南
- 十、一份实用的决策清单
- 下期预告:WandB、TensorBoard、MLflow 实验追踪实战
- 📌 附录
- 👨💻 About Me · 关于作者
上期回顾
在上期《YOLOv10【第四章:训练调参与实验管理篇·第16节】大数据集训练 YOLOv10——缓存、workers、I/O 优化》内容中,我们深入探讨了在大数据集场景下如何让 YOLOv10 跑得更快、更稳。核心内容围绕三个维度展开:
缓存策略方面,我们详细对比了 cache='ram'、cache='disk' 与不缓存三种模式的适用场景。RAM 缓存虽然速度最快,但对内存容量要求极高;磁盘缓存则是在内存受限时的折中方案,把解码后的图像以 .npy 格式预存到本地,避免每个 epoch 重复解码的开销。对于真正的大数据集(百万级图片),往往两种缓存都不现实,这时候需要依赖高效的数据 Pipeline。
workers 参数方面,我们讨论了多进程数据加载的原理——DataLoader 的子进程负责在主进程进行前向传播时并行预取数据,理想情况下 GPU 永远不会等待数据。workers 不是越大越好,受限于 CPU 核心数、I/O 带宽以及共享内存(/dev/shm)的大小,通常设置为物理 CPU 核心数的一半到等量之间效果最佳。
I/O 优化方面,我们介绍了 SSD vs HDD 的读取速度差异、数据集打包为 LMDB/WebDataset 格式的优势,以及在 Docker 容器或云服务器中扩大共享内存的方法。
如果说上一节解决的是"数据怎么快速送进去"的问题,那么本节要解决的,是一个更根本、也更容易被忽视的训练难题——当你的数据本身就不均衡时,模型该如何学习。
本节主题:类别不均衡训练——采样、增强与损失权重策略
引言:那些"被淹没"的类别
我在做一个工业缺陷检测项目时,第一次深刻体会到类别不均衡的恐怖。数据集里有 10 个类别,其中"正常"样本占了 92%,而最稀有的缺陷类型"微裂纹"只有不到 200 张。
训练完之后,mAP 看起来还不错,大概 0.81。但一看各类的 AP,“微裂纹"这个类的 AP 只有可怜的 0.12。模型基本上学会了对所有东西说"这是正常的”,因为这样大多数时候都是对的——从 loss 下降的角度看,这是最省力的路。
这种现象在目标检测领域极为普遍。自动驾驶数据集里行人远多于自行车;医疗影像里病变区域远少于正常组织;野生动物监测里常见物种的数量是珍稀物种的几十倍。
类别不均衡不是一个边缘问题,而是工业落地中几乎必然遭遇的核心挑战。
一、理解类别不均衡的本质
在正式进入解决方案之前,我觉得有必要先把问题想清楚——不均衡到底在"伤害"什么?
1.1 不均衡如何影响梯度
YOLOv10 的总 loss 由三部分组成:
L
∗
t
o
t
a
l
=
λ
∗
b
o
x
⋅
L
∗
b
o
x
+
λ
∗
c
l
s
⋅
L
∗
c
l
s
+
λ
∗
d
f
l
⋅
L
d
f
l
\\mathcal{L}*{total} = \\lambda*{box} \\cdot \\mathcal{L}*{box} + \\lambda*{cls} \\cdot \\mathcal{L}*{cls} + \\lambda*{dfl} \\cdot \\mathcal{L}_{dfl}
L∗total=λ∗box⋅L∗box+λ∗cls⋅L∗cls+λ∗dfl⋅Ldfl
其中
L
c
l
s
\\mathcal{L}_{cls}
Lcls 是分类损失,在 YOLOv10 中采用的是 Binary Cross-Entropy(BCE):
L
∗
c
l
s
=
−
∑
∗
i
[
y
i
log
(
p
^
i
)
+
(
1
−
y
i
)
log
(
1
−
p
^
i
)
]
\\mathcal{L}*{cls} = -\\sum*{i} [y_i \\log(\\hat{p}_i) + (1-y_i)\\log(1-\\hat{p}_i)]
L∗cls=−∑∗i[yilog(p^i)+(1−yi)log(1−p^i)]
当数据严重不均衡时,假设负样本(背景或多数类)占 99%,正样本(少数类)占 1%。那么:
- 梯度方向:绝大多数梯度来自多数类,少数类的梯度信号在总 loss 中"淹没";
- 模型偏置:模型的输出层偏置(bias)会朝着多数类的方向初始化收敛;
- 置信度分布:模型对少数类的置信度预测普遍偏低,导致召回率极差。
这就像一个班级里有 99 个成绩优秀的学生和 1 个需要特别关注的学生,老师如果只看班级平均分,很可能永远不会注意到那 1 个落后的孩子。
1.2 不均衡的类型
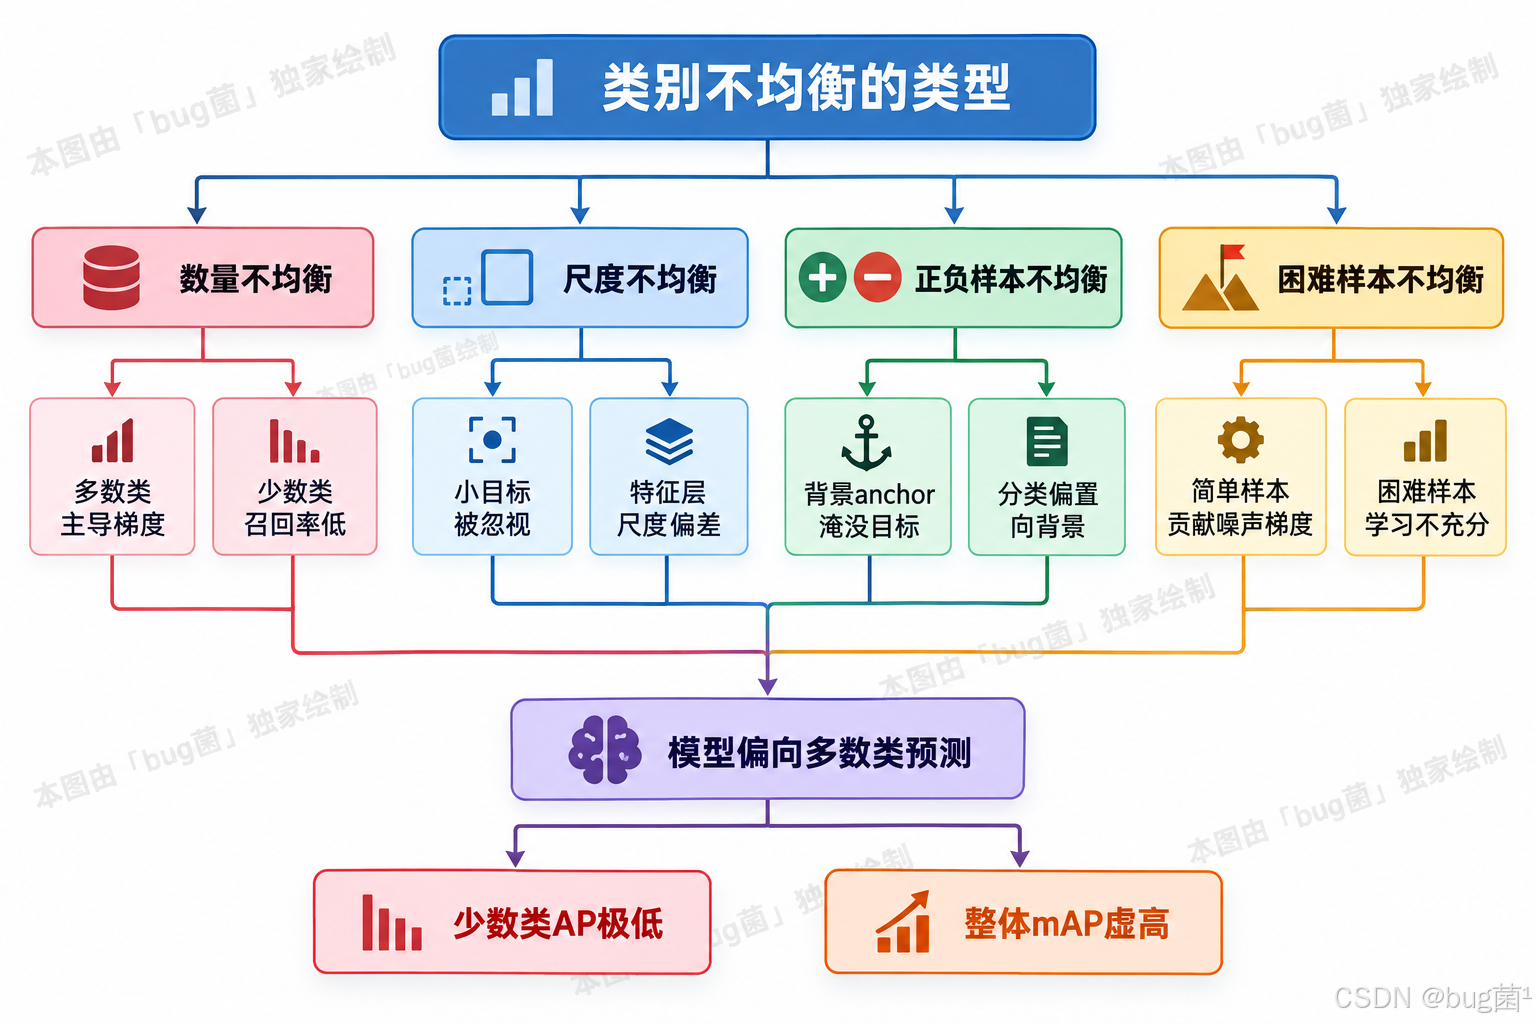
在目标检测任务中,不均衡有几种不同的表现形式:
数量不均衡(Quantity Imbalance):最直接的形式,某些类别的实例数量远少于其他类别。这是最常见的情况。
尺度不均衡(Scale Imbalance):某些类别的目标尺寸极小(如遥感图像中的车辆),另一些则很大。虽然不是严格意义上的"类别"不均衡,但对检测器的影响类似。
正负样本不均衡(Foreground-Background Imbalance):这是目标检测中固有的问题。一张图片中,目标框(正样本 anchor)的数量远远少于背景框(负样本 anchor)。YOLOv10 通过 NMS-free 的双重标签分配机制在一定程度上缓解了这个问题,但并没有彻底消除。
困难样本不均衡(Easy-Hard Imbalance):大量容易分类的样本(背景、典型目标)与少量困难样本(遮挡、小目标、边缘情况)之间的不均衡。
相关示意图绘制如下,仅供参考:
1.3 量化你的不均衡程度
在动手解决之前,先要知道自己的数据有多不均衡。一个常用的指标是不均衡比(Imbalance Ratio, IR):
I
R
=
N
m
a
x
N
m
i
n
IR = \\frac{N_{max}}{N_{min}}
IR=NminNmax
其中
N
m
a
x
N_{max}
Nmax 和
N
m
i
n
N_{min}
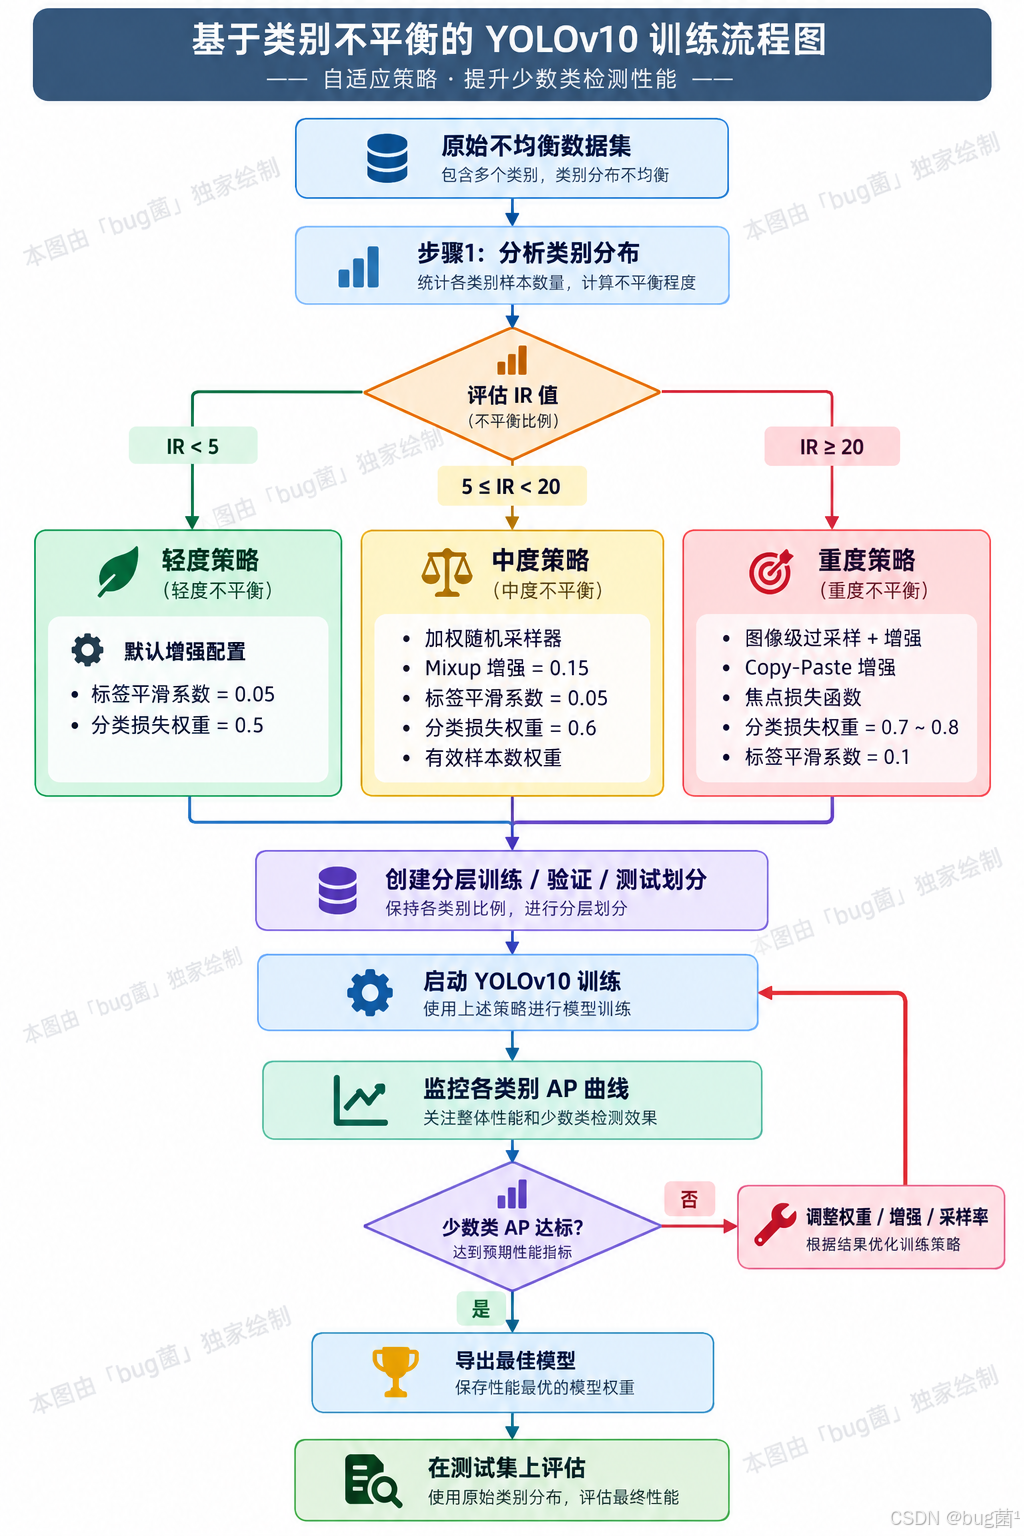
Nmin 分别是最多类和最少类的样本数。IR < 5 通常认为轻度不均衡,可能不需要特别处理;IR 在 5~20 之间是中度不均衡;IR > 20 则是严重不均衡,必须采取措施。
import os
import yaml
from pathlib import Path
from collections import Counter
import matplotlib.pyplot as plt
import numpy as np
def analyze_class_distribution(data_yaml_path: str) –> dict:
"""
分析 YOLO 格式数据集的类别分布情况
参数:
data_yaml_path: data.yaml 文件路径
返回:
包含类别统计信息的字典
"""
# 读取数据集配置
with open(data_yaml_path, 'r', encoding='utf-8') as f:
data_cfg = yaml.safe_load(f)
class_names = data_cfg.get('names', [])
train_path = data_cfg.get('train', '')
# 如果 train 是相对路径,转为绝对路径
base_dir = Path(data_yaml_path).parent
if not Path(train_path).is_absolute():
train_path = base_dir / train_path
# 统计各类别的标注数量
class_counter = Counter()
label_dir = Path(str(train_path).replace('images', 'labels'))
# 兼容直接指定 labels 目录的情况
if not label_dir.exists():
label_dir = Path(train_path)
total_instances = 0
total_images = 0
for label_file in label_dir.rglob('*.txt'):
total_images += 1
with open(label_file, 'r') as f:
lines = f.readlines()
for line in lines:
parts = line.strip().split()
if len(parts) >= 5:
class_id = int(parts[0])
class_counter[class_id] += 1
total_instances += 1
# 计算统计指标
counts = [class_counter.get(i, 0) for i in range(len(class_names))]
max_count = max(counts) if counts else 1
min_count = min(c for c in counts if c > 0) if any(c > 0 for c in counts) else 1
imbalance_ratio = max_count / min_count
# 打印分析报告
print("=" * 60)
print("📊 类别分布分析报告")
print("=" * 60)
print(f"总图片数: {total_images}")
print(f"总实例数: {total_instances}")
print(f"类别数量: {len(class_names)}")
print(f"不均衡比 (IR): {imbalance_ratio:.2f}")
print()
if imbalance_ratio < 5:
level = "✅ 轻度不均衡(可能无需特殊处理)"
elif imbalance_ratio < 20:
level = "⚠️ 中度不均衡(建议采取措施)"
else:
level = "🚨 严重不均衡(必须采取措施)"
print(f"不均衡程度: {level}")
print()
print(f"{'类别':<20} {'数量':>10} {'占比':>10} {'状态':>15}")
print("-" * 60)
for i, (name, count) in enumerate(zip(class_names, counts)):
ratio = count / total_instances * 100 if total_instances > 0 else 0
if count == max_count:
status = "🔴 最多"
elif count == min_count:
status = "🔵 最少"
elif count < total_instances / len(class_names) * 0.5:
status = "⚠️ 偏少"
else:
status = "✅ 正常"
print(f"{name:<20} {count:>10,} {ratio:>9.2f}% {status:>15}")
# 可视化分布
_plot_distribution(class_names, counts, imbalance_ratio)
return {
'class_names': class_names,
'counts': counts,
'imbalance_ratio': imbalance_ratio,
'total_instances': total_instances,
'total_images': total_images,
}
def _plot_distribution(class_names: list, counts: list, ir: float):
"""绘制类别分布可视化图"""
fig, axes = plt.subplots(1, 2, figsize=(16, 6))
# 左图:柱状图
colors = ['#e74c3c' if c == max(counts) else
'#3498db' if c == min(c2 for c2 in counts if c2 > 0) else
'#2ecc71' for c in counts]
bars = axes[0].bar(range(len(class_names)), counts, color=colors,
edgecolor='white', linewidth=0.5)
axes[0].set_xticks(range(len(class_names)))
axes[0].set_xticklabels(class_names, rotation=45, ha='right', fontsize=9)
axes[0].set_ylabel('Instance Count', fontsize=12)
axes[0].set_title(f'Class Distribution (IR={ir:.1f})', fontsize=13, fontweight='bold')
axes[0].grid(axis='y', alpha=0.3)
# 在柱子上方标注数值
for bar, count in zip(bars, counts):
axes[0].text(bar.get_x() + bar.get_width()/2., bar.get_height(),
f'{count:,}', ha='center', va='bottom', fontsize=8)
# 右图:对数坐标柱状图(更直观地展示差距)
counts_safe = [max(c, 1) for c in counts] # 防止 log(0)
axes[1].bar(range(len(class_names)), counts_safe, color=colors,
edgecolor='white', linewidth=0.5)
axes[1].set_xticks(range(len(class_names)))
axes[1].set_xticklabels(class_names, rotation=45, ha='right', fontsize=9)
axes[1].set_yscale('log')
axes[1].set_ylabel('Instance Count (Log Scale)', fontsize=12)
axes[1].set_title('Class Distribution (Log Scale)', fontsize=13, fontweight='bold')
axes[1].grid(axis='y', alpha=0.3)
# 添加平均线
avg = sum(counts) / len(counts)
for ax in axes:
if ax == axes[1]:
ax.axhline(y=avg, color='orange', linestyle='–', linewidth=1.5,
label=f'Average: {avg:.0f}')
else:
ax.axhline(y=avg, color='orange', linestyle='–', linewidth=1.5,
label=f'Average: {avg:.0f}')
ax.legend(fontsize=9)
plt.tight_layout()
plt.savefig('class_distribution.png', dpi=150, bbox_inches='tight')
plt.show()
print("✅ 分布图已保存至 class_distribution.png")
# 使用示例
# stats = analyze_class_distribution('./data/my_dataset/data.yaml')
二、策略一:数据层面的采样方法
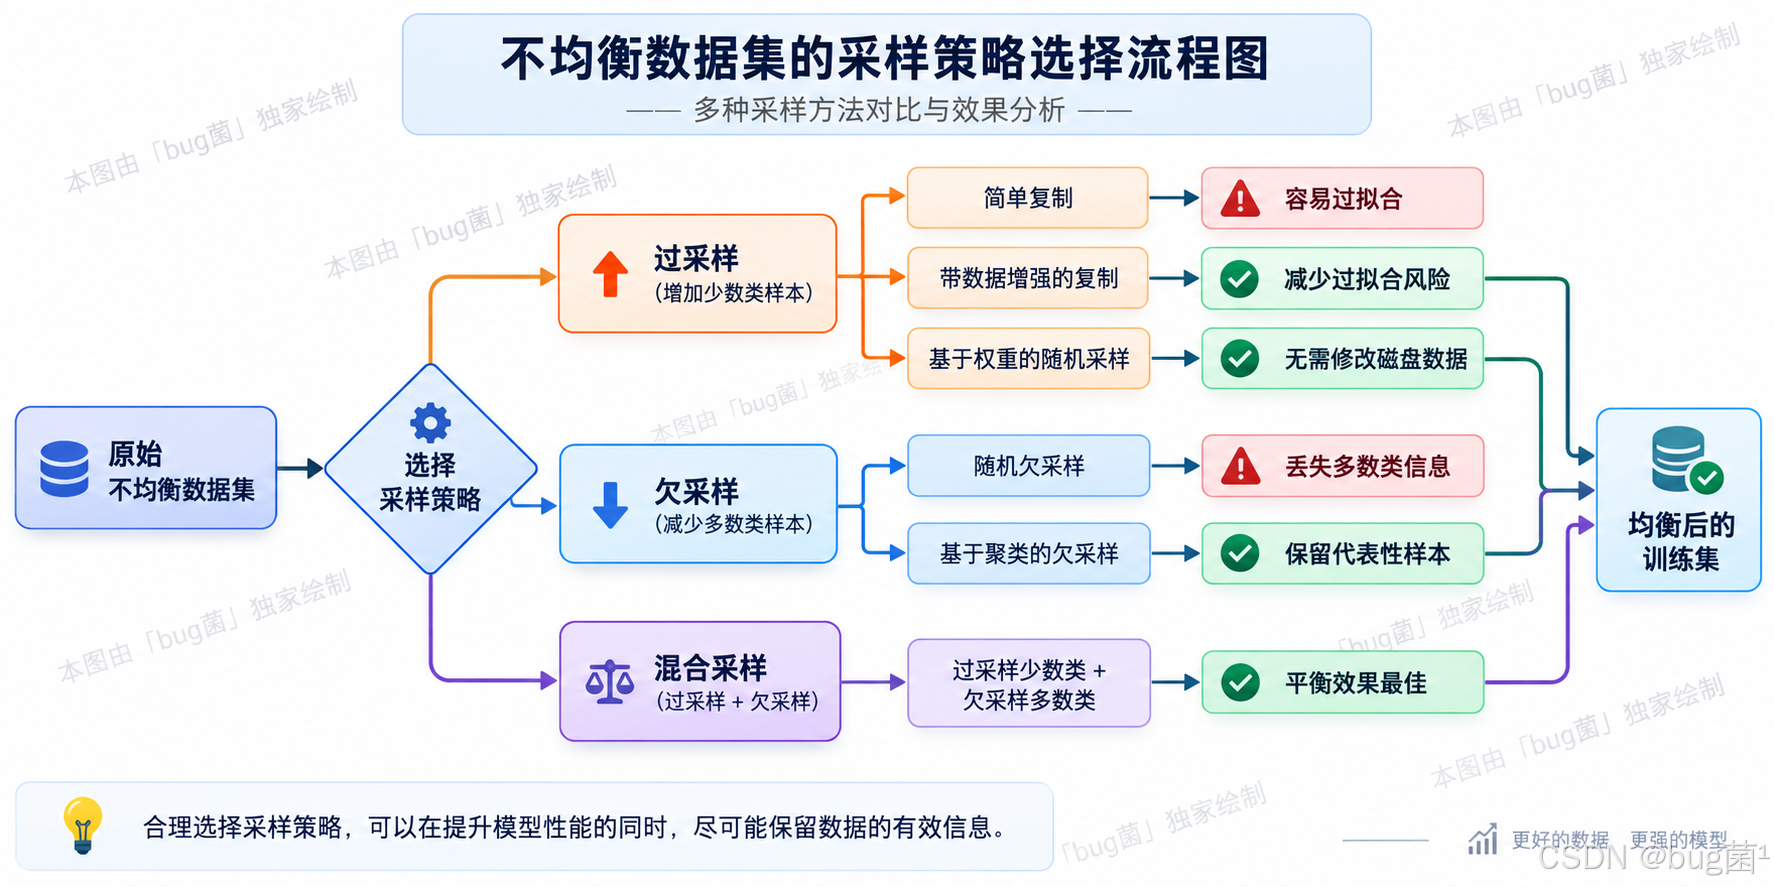
采样是解决类别不均衡最直观的思路:既然数据本身就不均衡,那就在数据层面人为地把它"变均衡"。采样分为两个方向:过采样(Oversampling) 少数类,或者欠采样(Undersampling) 多数类。
2.1 图像级别的过采样
最简单的过采样就是直接复制少数类的图片,让它们在每个 epoch 中出现更多次。但这种做法会导致严重的过拟合——模型把少数类的几张图记住了,而不是学到真正的特征。
更科学的做法是在复制的同时引入变换,让每次"见到"的少数类图片都略有不同。
import os
import shutil
import random
import cv2
import numpy as np
from pathlib import Path
from typing import List, Tuple, Optional
class YOLOOversampler:
"""
针对 YOLO 格式数据集的少数类过采样工具
支持随机翻转、色彩抖动、随机裁剪等增强方式
"""
def __init__(self,
dataset_dir: str,
target_ratio: float = 0.5,
min_samples: Optional[int] = None):
"""
参数:
dataset_dir: 数据集根目录(包含 images/ 和 labels/ 子目录)
target_ratio: 过采样后少数类占多数类的最小比例(0~1)
min_samples: 每类最小样本数(与 target_ratio 取较大值)
"""
self.dataset_dir = Path(dataset_dir)
self.target_ratio = target_ratio
self.min_samples = min_samples
self.images_dir = self.dataset_dir / 'images' / 'train'
self.labels_dir = self.dataset_dir / 'labels' / 'train'
# 统计每个类别包含该类标注的图片列表
self.class_to_images = self._build_class_index()
def _build_class_index(self) –> dict:
"""构建类别 -> 图片路径的索引"""
class_to_images = {}
for label_file in self.labels_dir.glob('*.txt'):
with open(label_file, 'r') as f:
lines = f.readlines()
classes_in_image = set()
for line in lines:
parts = line.strip().split()
if len(parts) >= 5:
classes_in_image.add(int(parts[0]))
for cls_id in classes_in_image:
if cls_id not in class_to_images:
class_to_images[cls_id] = []
# 找对应的图片文件
img_stem = label_file.stem
for ext in ['.jpg', '.jpeg', '.png', '.bmp']:
img_path = self.images_dir / (img_stem + ext)
if img_path.exists():
class_to_images[cls_id].append(img_path)
break
return class_to_images
def _augment_image_and_label(self,
img_path: Path,
label_path: Path,
aug_suffix: str) –> Tuple[np.ndarray, List[str]]:
"""
对图片和标签同步做数据增强
注意:bbox 需要随图片变换同步调整
"""
img = cv2.imread(str(img_path))
if img is None:
return None, None
h, w = img.shape[:2]
with open(label_path, 'r') as f:
labels = f.readlines()
# 随机选择增强方式
aug_type = random.choice(['hflip', 'vflip', 'color_jitter',
'rotate_small', 'combined'])
if aug_type == 'hflip':
# 水平翻转:x_center -> 1 – x_center
img = cv2.flip(img, 1)
new_labels = []
for line in labels:
parts = line.strip().split()
if len(parts) >= 5:
cls_id = parts[0]
x_c, y_c, bw, bh = float(parts[1]), float(parts[2]), \\
float(parts[3]), float(parts[4])
x_c = 1.0 – x_c # 水平翻转
new_labels.append(f"{cls_id} {x_c:.6f} {y_c:.6f} {bw:.6f} {bh:.6f}\\n")
else:
new_labels.append(line)
elif aug_type == 'vflip':
# 垂直翻转:y_center -> 1 – y_center
img = cv2.flip(img, 0)
new_labels = []
for line in labels:
parts = line.strip().split()
if len(parts) >= 5:
cls_id = parts[0]
x_c, y_c, bw, bh = float(parts[1]), float(parts[2]), \\
float(parts[3]), float(parts[4])
y_c = 1.0 – y_c # 垂直翻转
new_labels.append(f"{cls_id} {x_c:.6f} {y_c:.6f} {bw:.6f} {bh:.6f}\\n")
else:
new_labels.append(line)
elif aug_type == 'color_jitter':
# 色彩抖动:不改变标签
img = img.astype(np.float32)
# 亮度随机调整 ±30%
brightness = random.uniform(0.7, 1.3)
img = img * brightness
# 色调随机偏移(在 HSV 空间)
img_hsv = cv2.cvtColor(np.clip(img, 0, 255).astype(np.uint8),
cv2.COLOR_BGR2HSV).astype(np.float32)
img_hsv[:, :, 0] = (img_hsv[:, :, 0] + random.uniform(–15, 15)) % 180
img_hsv[:, :, 1] = np.clip(img_hsv[:, :, 1] * random.uniform(0.8, 1.2), 0, 255)
img = cv2.cvtColor(np.clip(img_hsv, 0, 255).astype(np.uint8),
cv2.COLOR_HSV2BGR)
new_labels = labels
elif aug_type == 'rotate_small':
# 小角度旋转(±15度)
angle = random.uniform(–15, 15)
center = (w // 2, h // 2)
M = cv2.getRotationMatrix2D(center, angle, 1.0)
img = cv2.warpAffine(img, M, (w, h),
borderMode=cv2.BORDER_REFLECT_101)
# 旋转矩阵变换 bbox(近似处理:小角度旋转后 bbox 仍用原值)
# 精确处理需要对角点做矩阵变换后重新计算外接矩形
new_labels = labels # 小角度旋转的 bbox 误差在可接受范围内
else: # combined
# 组合:水平翻转 + 色彩抖动
img = cv2.flip(img, 1)
brightness = random.uniform(0.8, 1.2)
img = np.clip(img.astype(np.float32) * brightness, 0, 255).astype(np.uint8)
new_labels = []
for line in labels:
parts = line.strip().split()
if len(parts) >= 5:
cls_id = parts[0]
x_c, y_c, bw, bh = float(parts[1]), float(parts[2]), \\
float(parts[3]), float(parts[4])
x_c = 1.0 – x_c
new_labels.append(f"{cls_id} {x_c:.6f} {y_c:.6f} {bw:.6f} {bh:.6f}\\n")
else:
new_labels.append(line)
return img, new_labels
def oversample(self, output_dir: Optional[str] = None) –> dict:
"""
执行过采样,生成增强后的少数类图片
参数:
output_dir: 输出目录,None 则在原数据集中就地添加
"""
if output_dir is None:
out_images = self.images_dir
out_labels = self.labels_dir
else:
out_images = Path(output_dir) / 'images' / 'train'
out_labels = Path(output_dir) / 'labels' / 'train'
out_images.mkdir(parents=True, exist_ok=True)
out_labels.mkdir(parents=True, exist_ok=True)
# 先复制原始文件
print("📁 复制原始数据集…")
for f in self.images_dir.glob('*'):
shutil.copy2(f, out_images)
for f in self.labels_dir.glob('*.txt'):
shutil.copy2(f, out_labels)
# 计算各类需要增加多少样本
counts = {cls: len(imgs) for cls, imgs in self.class_to_images.items()}
max_count = max(counts.values())
stats = {'original': counts.copy(), 'added': {}}
for cls_id, imgs in self.class_to_images.items():
current_count = len(imgs)
# 计算目标数量
target_count = max(
int(max_count * self.target_ratio),
self.min_samples or 0
)
if current_count >= target_count:
print(f" 类别 {cls_id}: {current_count} 样本,无需过采样")
stats['added'][cls_id] = 0
continue
n_to_add = target_count – current_count
print(f" 类别 {cls_id}: {current_count} → {target_count} "
f"(需新增 {n_to_add} 张)")
added = 0
attempts = 0
max_attempts = n_to_add * 3 # 避免死循环
while added < n_to_add and attempts < max_attempts:
# 随机选一张该类的图片进行增强
src_img_path = random.choice(imgs)
src_label_path = (self.labels_dir /
src_img_path.stem).with_suffix('.txt')
if not src_label_path.exists():
attempts += 1
continue
# 执行增强
suffix = f"_os{added:04d}"
aug_img, aug_labels = self._augment_image_and_label(
src_img_path, src_label_path, suffix)
if aug_img is None:
attempts += 1
continue
# 保存增强后的图片和标签
new_img_name = src_img_path.stem + suffix + src_img_path.suffix
new_label_name = src_img_path.stem + suffix + '.txt'
cv2.imwrite(str(out_images / new_img_name), aug_img)
with open(out_labels / new_label_name, 'w') as f:
f.writelines(aug_labels)
added += 1
attempts += 1
stats['added'][cls_id] = added
print(f" ✅ 成功新增 {added} 张")
print(f"\\n✅ 过采样完成!")
return stats
# 使用示例
# oversampler = YOLOOversampler(
# dataset_dir='./data/my_dataset',
# target_ratio=0.5, # 少数类至少达到多数类的50%
# min_samples=500 # 每类至少500张
# )
# stats = oversampler.oversample(output_dir='./data/balanced_dataset')
2.2 WeightedRandomSampler:在 DataLoader 层面控制采样
YOLOv10 基于 Ultralytics 框架,其数据加载底层使用 PyTorch 的 DataLoader。PyTorch 原生支持 WeightedRandomSampler,可以在不修改磁盘数据的情况下,在每个 epoch 内调整各类样本被抽到的概率。
这种方法的核心思想是:给每张图片分配一个权重,权重与其包含的稀有类别成正比,这样每个 mini-batch 中各类别的分布就会更均匀。
import torch
from torch.utils.data import WeightedRandomSampler
import numpy as np
from pathlib import Path
from collections import Counter
from typing import List, Optional
def compute_sample_weights(
labels_dir: str,
num_classes: int,
strategy: str = 'sqrt'
) –> torch.Tensor:
"""
计算每个样本的采样权重,用于 WeightedRandomSampler
策略说明:
'uniform' – 每类等权重,少数类图片权重高
'sqrt' – 类别权重为频率的平方根倒数(温和版)
'inverse' – 类别权重为频率的倒数(激进版)
参数:
labels_dir: YOLO 标签目录
num_classes: 总类别数
strategy: 权重计算策略
返回:
每个样本的权重 tensor
"""
labels_dir = Path(labels_dir)
label_files = sorted(labels_dir.glob('*.txt'))
# 统计全局类别频率
global_class_count = Counter()
sample_classes = [] # 每个样本包含的类别集合
for label_file in label_files:
classes_in_sample = set()
with open(label_file, 'r') as f:
for line in f:
parts = line.strip().split()
if len(parts) >= 5:
cls_id = int(parts[0])
classes_in_sample.add(cls_id)
sample_classes.append(classes_in_sample)
for cls_id in classes_in_sample:
global_class_count[cls_id] += 1
# 计算每个类别的权重
total_samples = len(label_files)
class_weights = {}
for cls_id in range(num_classes):
freq = global_class_count.get(cls_id, 1) / total_samples
if strategy == 'uniform':
class_weights[cls_id] = 1.0 / max(global_class_count.get(cls_id, 1), 1)
elif strategy == 'sqrt':
# 平方根策略:比 inverse 更温和,防止少数类权重过大
class_weights[cls_id] = 1.0 / (freq ** 0.5)
elif strategy == 'inverse':
class_weights[cls_id] = 1.0 / max(freq, 1e-6)
else:
raise ValueError(f"未知策略: {strategy}")
# 计算每个样本的权重(取该样本中最稀有类别的权重)
sample_weights = []
for classes in sample_classes:
if not classes:
sample_weights.append(1.0)
continue
# 取样本中权重最高的类别的权重(最稀有的类别决定这张图片的重要性)
max_weight = max(class_weights.get(cls_id, 1.0) for cls_id in classes)
sample_weights.append(max_weight)
weights_tensor = torch.FloatTensor(sample_weights)
# 归一化权重(可选,但有助于理解数值含义)
weights_tensor = weights_tensor / weights_tensor.sum() * len(weights_tensor)
print(f"📊 采样权重统计(策略: {strategy})")
print(f" 样本数: {len(sample_weights)}")
print(f" 权重范围: {weights_tensor.min():.4f} ~ {weights_tensor.max():.4f}")
print(f" 权重均值: {weights_tensor.mean():.4f}")
print(f" 权重方差: {weights_tensor.std():.4f}")
return weights_tensor
def create_weighted_sampler(
labels_dir: str,
num_classes: int,
strategy: str = 'sqrt',
replacement: bool = True
) –> WeightedRandomSampler:
"""
创建用于 DataLoader 的 WeightedRandomSampler
参数:
labels_dir: 标签目录
num_classes: 类别数
strategy: 权重策略
replacement: 是否有放回采样(True 适合过采样少数类)
"""
weights = compute_sample_weights(labels_dir, num_classes, strategy)
sampler = WeightedRandomSampler(
weights=weights,
num_samples=len(weights), # 每个 epoch 采样的总样本数
replacement=replacement
)
return sampler
# ============================================================
# 将 WeightedRandomSampler 集成到 Ultralytics 训练流程
# ============================================================
# 注意:Ultralytics 的 train() 接口不直接暴露 sampler 参数,
# 需要通过继承 Trainer 类来注入自定义 sampler。
from ultralytics.models.yolo.detect import DetectionTrainer
from ultralytics.data import build_dataloader
from ultralytics.data.dataset import YOLODataset
from torch.utils.data import DataLoader
class BalancedDetectionTrainer(DetectionTrainer):
"""
支持类别均衡采样的 YOLOv10 训练器
通过重写 get_dataloader 方法注入 WeightedRandomSampler
"""
def get_dataloader(self, dataset_path, batch_size, rank=0, mode='train'):
"""重写数据加载器,在训练阶段启用均衡采样"""
# 先调用父类方法获取数据集对象
dataset = self.build_dataset(dataset_path, mode, batch_size)
if mode == 'train' and self.args.use_weighted_sampler:
print("🎯 启用 WeightedRandomSampler 均衡采样…")
# 获取标签目录
labels_dir = Path(dataset_path).parent / 'labels' / 'train'
if not labels_dir.exists():
labels_dir = Path(str(dataset_path).replace('images', 'labels'))
# 创建加权采样器
sampler = create_weighted_sampler(
labels_dir=str(labels_dir),
num_classes=self.data['nc'],
strategy=getattr(self.args, 'sampler_strategy', 'sqrt')
)
# 创建带有自定义 sampler 的 DataLoader
loader = DataLoader(
dataset=dataset,
batch_size=batch_size,
sampler=sampler,
num_workers=self.args.workers,
pin_memory=True,
collate_fn=getattr(dataset, 'collate_fn', None),
persistent_workers=self.args.workers > 0
)
return loader
# 非训练模式或未启用时,使用默认加载器
return build_dataloader(dataset, batch_size, self.args.workers,
shuffle=(mode == 'train'), rank=rank)
# 使用示例
# from ultralytics import YOLO
#
# # 方法1:直接使用训练器
# trainer = BalancedDetectionTrainer(
# overrides={
# 'model': 'yolov10s.pt',
# 'data': './data/my_dataset/data.yaml',
# 'epochs': 100,
# 'use_weighted_sampler': True,
# 'sampler_strategy': 'sqrt',
# }
# )
# trainer.train()
2.3 欠采样:什么时候反而更好?
欠采样的逻辑与过采样相反:减少多数类的样本数量,使总体分布趋向均衡。它的优点是训练速度快(数据量减少了),缺点是可能丢失多数类的有效信息。
在实践中,欠采样更适合以下场景:
import random
import shutil
from pathlib import Path
from collections import defaultdict
def undersample_majority_classes(
dataset_dir: str,
max_per_class: int,
output_dir: str,
class_names: list,
seed: int = 42
):
"""
对多数类进行欠采样,将各类别样本数上限设为 max_per_class
注意:一张图片可能包含多个类别,删除时需谨慎,
本函数以"图片包含的主要类别"来决定是否采样
参数:
dataset_dir: 原始数据集目录
max_per_class: 每类最多保留的图片数
output_dir: 输出目录
class_names: 类别名称列表
seed: 随机种子,保证可复现
"""
random.seed(seed)
dataset_dir = Path(dataset_dir)
output_dir = Path(output_dir)
images_src = dataset_dir / 'images' / 'train'
labels_src = dataset_dir / 'labels' / 'train'
images_dst = output_dir / 'images' / 'train'
labels_dst = output_dir / 'labels' / 'train'
for d in [images_dst, labels_dst]:
d.mkdir(parents=True, exist_ok=True)
# 按主类别(实例数最多的类)组织图片
class_to_imgs = defaultdict(list)
for label_file in labels_src.glob('*.txt'):
class_counter = Counter()
with open(label_file, 'r') as f:
for line in f:
parts = line.strip().split()
if len(parts) >= 5:
class_counter[int(parts[0])] += 1
if class_counter:
# 以实例数最多的类别作为该图片的"主类别"
primary_class = class_counter.most_common(1)[0][0]
class_to_imgs[primary_class].append(label_file.stem)
# 对每个多数类进行采样
selected_stems = set()
for cls_id, img_stems in class_to_imgs.items():
cls_name = class_names[cls_id] if cls_id < len(class_names) else str(cls_id)
original_count = len(img_stems)
if original_count > max_per_class:
sampled = random.sample(img_stems, max_per_class)
print(f" 类别 {cls_name}: {original_count} → {max_per_class} (欠采样)")
else:
sampled = img_stems
print(f" 类别 {cls_name}: {original_count} (保留全部)")
selected_stems.update(sampled)
# 复制选中的文件
copied = 0
for stem in selected_stems:
# 复制标签
src_label = labels_src / (stem + '.txt')
if src_label.exists():
shutil.copy2(src_label, labels_dst / (stem + '.txt'))
# 复制图片(尝试常见扩展名)
for ext in ['.jpg', '.jpeg', '.png', '.bmp']:
src_img = images_src / (stem + ext)
if src_img.exists():
shutil.copy2(src_img, images_dst / (stem + ext))
copied += 1
break
print(f"\\n✅ 欠采样完成!保留 {copied} 张图片(原始 "
f"{sum(len(v) for v in class_to_imgs.values())} 张)")
相关示意图绘制如下,仅供参考:
三、策略二:针对性数据增强
如果说采样是在"量"上做文章,那么针对性数据增强就是在"质"上下功夫——让少数类的样本变得更多样、更丰富,而不仅仅是简单地多看几遍同样的图片。
3.1 Mosaic 增强与类别均衡
YOLOv10(通过 Ultralytics 框架)默认使用 Mosaic 数据增强:把 4 张图片拼接成一张,同时保留各自的标注。这对类别均衡其实有一定的天然作用——如果拼接时刻意从少数类中多选图片,就能在不增加磁盘数据的前提下提高少数类在训练中出现的比例。
但默认的 Mosaic 是随机选图,并不关心类别均衡。我们可以修改 Mosaic 的图片选择逻辑:
# 这段代码展示了如何在 Mosaic 增强中引入类别感知的选图策略
# 实际集成到 Ultralytics 需要覆写 LoadImagesAndLabels 类
import numpy as np
import random
from typing import List, Tuple
class ClassAwareMosaicMixer:
"""
类别感知的 Mosaic 混合器
在生成 Mosaic 时,优先从少数类中选取图片以提高其出现频率
"""
def __init__(self,
class_to_images: dict,
class_frequencies: dict,
minority_boost: float = 2.0):
"""
参数:
class_to_images: {class_id: [image_paths]}
class_frequencies: {class_id: frequency}
minority_boost: 少数类的选中概率倍数
"""
self.class_to_images = class_to_images
self.class_frequencies = class_frequencies
self.minority_boost = minority_boost
# 计算每个类别的选择权重(频率越低,权重越高)
max_freq = max(class_frequencies.values())
self.class_selection_weights = {
cls_id: (max_freq / freq) ** 0.5 * minority_boost
if freq < max_freq else 1.0
for cls_id, freq in class_frequencies.items()
}
def select_mosaic_images(self, anchor_image_path: str, n: int = 3) –> List[str]:
"""
为 Mosaic 增强选择 n 张辅助图片
锚图(anchor)是已知图片,为其选择 n 张拼接图
策略:
1. 如果锚图包含少数类,则额外选取更多同类图片
2. 否则按类别权重随机选取
"""
# 找出锚图对应标签中的类别
label_path = anchor_image_path.replace('/images/', '/labels/')
label_path = label_path.rsplit('.', 1)[0] + '.txt'
anchor_classes = set()
try:
with open(label_path, 'r') as f:
for line in f:
parts = line.strip().split()
if len(parts) >= 5:
anchor_classes.add(int(parts[0]))
except FileNotFoundError:
pass
# 确定锚图的"稀有度"
anchor_rarity = max(
[self.class_selection_weights.get(cls, 1.0) for cls in anchor_classes],
default=1.0
)
# 选择辅助图片
selected = []
all_images = []
all_weights = []
for cls_id, images in self.class_to_images.items():
weight = self.class_selection_weights.get(cls_id, 1.0)
for img in images:
all_images.append(img)
all_weights.append(weight)
if not all_images:
return []
# 加权随机选择(不重复)
all_weights = np.array(all_weights, dtype=np.float32)
all_weights /= all_weights.sum()
try:
indices = np.random.choice(
len(all_images),
size=min(n, len(all_images)),
replace=False,
p=all_weights
)
selected = [all_images[i] for i in indices]
except ValueError:
selected = random.choices(all_images, weights=all_weights.tolist(), k=n)
return selected
3.2 Copy-Paste 增强:让少数类"搬家"
Copy-Paste 是一种非常有创意的增强策略,思路是:从含有少数类的图片中裁剪出目标区域,然后粘贴到其他图片上,同时生成对应的标注。这样可以在不需要额外采集数据的情况下,人工"合成"出更多包含少数类的训练样本。
这个方法在 Google 的研究论文《Simple Copy-Paste is a Strong Data Augmentation Method for Instance Segmentation》中被证明效果显著,后来被各种目标检测框架广泛采纳。
import cv2
import numpy as np
import random
from pathlib import Path
from typing import List, Tuple, Optional
class CopyPasteAugmentor:
"""
Copy-Paste 数据增强
专门用于提升少数类的多样性
原理:从源图中裁剪少数类目标实例,
将其粘贴到目标图片的随机位置,
并更新目标图的标注信息
"""
def __init__(self,
source_images_dir: str,
source_labels_dir: str,
minority_classes: List[int],
min_instance_area: float = 0.001, # 占图片面积的最小比例
max_paste_per_image: int = 3,
alpha_blend: bool = True):
"""
参数:
source_images_dir: 源图片目录
source_labels_dir: 源标签目录
minority_classes: 需要增强的少数类 ID 列表
min_instance_area: 有效实例的最小面积比
max_paste_per_image: 每张目标图最多粘贴的实例数
alpha_blend: 是否使用 alpha 混合(而非硬粘贴)
"""
self.source_images_dir = Path(source_images_dir)
self.source_labels_dir = Path(source_labels_dir)
self.minority_classes = set(minority_classes)
self.min_instance_area = min_instance_area
self.max_paste_per_image = max_paste_per_image
self.alpha_blend = alpha_blend
# 预构建少数类实例库
self.instance_bank = self._build_instance_bank()
print(f"✅ 实例库构建完成,共收录 "
f"{sum(len(v) for v in self.instance_bank.values())} 个少数类实例")
def _build_instance_bank(self) –> dict:
"""
从源数据集中提取所有少数类的实例(裁剪后的图片块 + mask)
返回: {class_id: [(cropped_img, mask, original_bbox_wh_ratio)]}
"""
instance_bank = {cls_id: [] for cls_id in self.minority_classes}
for label_file in self.source_labels_dir.glob('*.txt'):
# 读取标签,检查是否包含少数类
instances = []
with open(label_file, 'r') as f:
for line in f:
parts = line.strip().split()
if len(parts) >= 5:
cls_id = int(parts[0])
if cls_id in self.minority_classes:
instances.append({
'cls_id': cls_id,
'x_c': float(parts[1]),
'y_c': float(parts[2]),
'w': float(parts[3]),
'h': float(parts[4])
})
if not instances:
continue
# 找对应图片
img_path = None
for ext in ['.jpg', '.jpeg', '.png', '.bmp']:
candidate = self.source_images_dir / (label_file.stem + ext)
if candidate.exists():
img_path = candidate
break
if img_path is None:
continue
img = cv2.imread(str(img_path))
if img is None:
continue
img_h, img_w = img.shape[:2]
# 裁剪每个实例
for inst in instances:
# 转换归一化坐标到像素坐标
cx = int(inst['x_c'] * img_w)
cy = int(inst['y_c'] * img_h)
bw = int(inst['w'] * img_w)
bh = int(inst['h'] * img_h)
# 检查实例尺寸
area_ratio = (bw * bh) / (img_w * img_h)
if area_ratio < self.min_instance_area:
continue
# 裁剪实例区域(稍微扩大边界以包含上下文)
margin = 0.1
x1 = max(0, int(cx – bw * (0.5 + margin)))
y1 = max(0, int(cy – bh * (0.5 + margin)))
x2 = min(img_w, int(cx + bw * (0.5 + margin)))
y2 = min(img_h, int(cy + bh * (0.5 + margin)))
cropped = img[y1:y2, x1:x2].copy()
# 生成简单的 mask(椭圆形,中心权重高)
mask = np.zeros(cropped.shape[:2], dtype=np.float32)
center = (cropped.shape[1] // 2, cropped.shape[0] // 2)
axes = (int(bw * 0.5 * 0.9), int(bh * 0.5 * 0.9))
cv2.ellipse(mask, center, axes, 0, 0, 360, 1.0, –1)
# 高斯模糊 mask 边缘,使混合更自然
mask = cv2.GaussianBlur(mask, (21, 21), 7)
instance_bank[inst['cls_id']].append({
'img': cropped,
'mask': mask,
'aspect_ratio': bw / max(bh, 1),
'size_ratio': (bw * bh) / (img_w * img_h)
})
return instance_bank
def augment(self,
target_img: np.ndarray,
target_labels: List[str],
n_paste: Optional[int] = None) –> Tuple[np.ndarray, List[str]]:
"""
对目标图片执行 Copy-Paste 增强
参数:
target_img: 目标图片 (H, W, C)
target_labels: 目标图的 YOLO 格式标签列表
n_paste: 粘贴的实例数,None 则随机
返回:
增强后的图片和更新后的标签
"""
if n_paste is None:
n_paste = random.randint(1, self.max_paste_per_image)
img_h, img_w = target_img.shape[:2]
result_img = target_img.copy()
result_labels = list(target_labels)
# 解析现有标签,获取已占据的区域(避免粘贴重叠)
existing_boxes = []
for label in target_labels:
parts = label.strip().split()
if len(parts) >= 5:
x_c, y_c, bw, bh = float(parts[1]), float(parts[2]), \\
float(parts[3]), float(parts[4])
existing_boxes.append((x_c, y_c, bw, bh))
# 从实例库中随机选择并粘贴
available_classes = [cls_id for cls_id, instances in self.instance_bank.items()
if instances]
if not available_classes:
return result_img, result_labels
for _ in range(n_paste):
# 随机选择一个少数类
cls_id = random.choice(available_classes)
instance = random.choice(self.instance_bank[cls_id])
inst_img = instance['img']
inst_mask = instance['mask']
# 随机缩放实例(保持宽高比)
scale = random.uniform(0.5, 1.5)
new_h = int(inst_img.shape[0] * scale)
new_w = int(inst_img.shape[1] * scale)
# 确保不超过目标图的一半
new_h = min(new_h, img_h // 2)
new_w = min(new_w, img_w // 2)
if new_h < 8 or new_w < 8:
continue
inst_resized = cv2.resize(inst_img, (new_w, new_h))
mask_resized = cv2.resize(inst_mask, (new_w, new_h))
# 随机选择粘贴位置
max_attempts = 10
pasted = False
for attempt in range(max_attempts):
# 随机位置(确保实例在图片范围内)
paste_x = random.randint(0, max(0, img_w – new_w))
paste_y = random.randint(0, max(0, img_h – new_h))
# 计算粘贴后的归一化 bbox
new_cx = (paste_x + new_w / 2) / img_w
new_cy = (paste_y + new_h / 2) / img_h
new_bw = new_w / img_w
new_bh = new_h / img_h
# 检查是否与现有框重叠过多
overlap_ok = True
for ex_cx, ex_cy, ex_bw, ex_bh in existing_boxes:
# 计算 IoU
iou = _compute_iou_normalized(
(new_cx, new_cy, new_bw, new_bh),
(ex_cx, ex_cy, ex_bw, ex_bh)
)
if iou > 0.3: # 重叠超过 30% 则跳过
overlap_ok = False
break
if not overlap_ok:
continue
# 执行粘贴
if self.alpha_blend:
# Alpha 混合
roi = result_img[paste_y:paste_y+new_h, paste_x:paste_x+new_w]
mask_3ch = np.stack([mask_resized] * 3, axis=–1)
result_img[paste_y:paste_y+new_h, paste_x:paste_x+new_w] = (
inst_resized * mask_3ch + roi * (1 – mask_3ch)
).astype(np.uint8)
else:
result_img[paste_y:paste_y+new_h, paste_x:paste_x+new_w] = inst_resized
# 添加新标签
result_labels.append(
f"{cls_id} {new_cx:.6f} {new_cy:.6f} {new_bw:.6f} {new_bh:.6f}\\n"
)
existing_boxes.append((new_cx, new_cy, new_bw, new_bh))
pasted = True
break
# 即使没找到合适位置也继续,不报错
return result_img, result_labels
def _compute_iou_normalized(box1: tuple, box2: tuple) –> float:
"""计算两个归一化 bbox 的 IoU(输入格式:cx, cy, w, h)"""
x1_1, y1_1 = box1[0] – box1[2]/2, box1[1] – box1[3]/2
x2_1, y2_1 = box1[0] + box1[2]/2, box1[1] + box1[3]/2
x1_2, y1_2 = box2[0] – box2[2]/2, box2[1] – box2[3]/2
x2_2, y2_2 = box2[0] + box2[2]/2, box2[1] + box2[3]/2
inter_x1 = max(x1_1, x1_2)
inter_y1 = max(y1_1, y1_2)
inter_x2 = min(x2_1, x2_2)
inter_y2 = min(y2_1, y2_2)
if inter_x2 <= inter_x1 or inter_y2 <= inter_y1:
return 0.0
inter_area = (inter_x2 – inter_x1) * (inter_y2 – inter_y1)
area1 = box1[2] * box1[3]
area2 = box2[2] * box2[3]
union_area = area1 + area2 – inter_area
return inter_area / max(union_area, 1e-6)
3.3 MixUp 与针对性增强策略
除了 Copy-Paste,MixUp 也是一种常用的增强策略。它将两张图片按比例混合:
x
~
=
λ
⋅
x
i
+
(
1
−
λ
)
⋅
x
j
\\tilde{x} = \\lambda \\cdot x_i + (1 – \\lambda) \\cdot x_j
x~=λ⋅xi+(1−λ)⋅xj
在类别不均衡场景下,可以让 MixUp 优先混合"包含少数类的图片"与其他图片,既增加了少数类的曝光次数,又通过混合增加了样本多样性。
import numpy as np
import cv2
import random
from typing import List, Tuple
def class_aware_mixup(
img1: np.ndarray,
labels1: List[str],
img2: np.ndarray,
labels2: List[str],
alpha: float = 0.4
) –> Tuple[np.ndarray, List[str]]:
"""
类别感知的 MixUp 增强
YOLOv10 的 MixUp 实现方式:
– 图片按 lambda 比例线性混合
– 标签直接合并(两张图的所有标注都保留)
参数:
img1, labels1: 第一张图及其标签(通常是少数类图片)
img2, labels2: 第二张图及其标签
alpha: Beta 分布参数,控制混合比例的随机性
"""
# 从 Beta 分布采样混合比例(alpha 越小,越接近 0/1,即越不混合)
lam = np.random.beta(alpha, alpha)
# 统一尺寸(以 img1 为基准)
h, w = img1.shape[:2]
img2_resized = cv2.resize(img2, (w, h))
# 线性混合图片
mixed_img = (lam * img1.astype(np.float32) +
(1 – lam) * img2_resized.astype(np.float32)).astype(np.uint8)
# 合并标签(两张图的标注都保留,这是目标检测 MixUp 的标准做法)
mixed_labels = list(labels1) + list(labels2)
return mixed_img, mixed_labels
# ============================================================
# Ultralytics 中启用 MixUp 的配置方式
# ============================================================
def get_balanced_augmentation_config(imbalance_ratio: float) –> dict:
"""
根据不均衡程度返回推荐的增强配置
注意:这些值直接对应 YOLOv10/Ultralytics 的 train() 参数
IR < 5: 轻度不均衡,使用默认增强
IR 5~20: 中度,加强 mosaic 和 mixup
IR > 20: 严重,同时启用 copy-paste
"""
if imbalance_ratio < 5:
# 轻度不均衡:默认增强即可
return {
'mosaic': 1.0, # mosaic 概率
'mixup': 0.0, # mixup 概率(默认关闭)
'copy_paste': 0.0, # copy-paste 概率
'flipud': 0.0,
'fliplr': 0.5,
'degrees': 0.0,
'translate': 0.1,
'scale': 0.5,
'shear': 0.0,
'hsv_h': 0.015,
'hsv_s': 0.7,
'hsv_v': 0.4,
}
elif imbalance_ratio < 20:
# 中度不均衡:开启 mixup,加强色彩增强
return {
'mosaic': 1.0,
'mixup': 0.15, # 开启 15% 概率的 mixup
'copy_paste': 0.0,
'flipud': 0.1,
'fliplr': 0.5,
'degrees': 5.0,
'translate': 0.1,
'scale': 0.5,
'shear': 2.0,
'hsv_h': 0.02,
'hsv_s': 0.8, # 加强饱和度增强
'hsv_v': 0.5,
}
else:
# 严重不均衡:开启所有增强,包括 copy-paste
return {
'mosaic': 1.0,
'mixup': 0.2, # 20% mixup
'copy_paste': 0.3, # 30% copy-paste(需要分割标注,目标检测中效果有限)
'flipud': 0.2,
'fliplr': 0.5,
'degrees': 10.0,
'translate': 0.15,
'scale': 0.6,
'shear': 3.0,
'perspective': 0.0001,
'hsv_h': 0.025,
'hsv_s': 0.9,
'hsv_v': 0.5,
}
# 实际训练时的使用方式
def train_with_balanced_augmentation(
model_path: str,
data_yaml: str,
imbalance_ratio: float,
**kwargs
):
"""
根据不均衡程度自动配置增强参数并启动训练
"""
from ultralytics import YOLO
aug_config = get_balanced_augmentation_config(imbalance_ratio)
# 合并用户自定义参数
train_config = {
'data': data_yaml,
'epochs': 100,
'imgsz': 640,
'batch': 16,
**aug_config,
**kwargs # 用户参数优先级更高
}
print(f"🚀 启动训练(IR={imbalance_ratio:.1f},增强配置已自动调整)")
print(f" mosaic={train_config['mosaic']}, mixup={train_config['mixup']}, "
f"copy_paste={train_config['copy_paste']}")
model = YOLO(model_path)
results = model.train(**train_config)
return results
四、策略三:损失函数加权——从根本上纠正梯度偏差
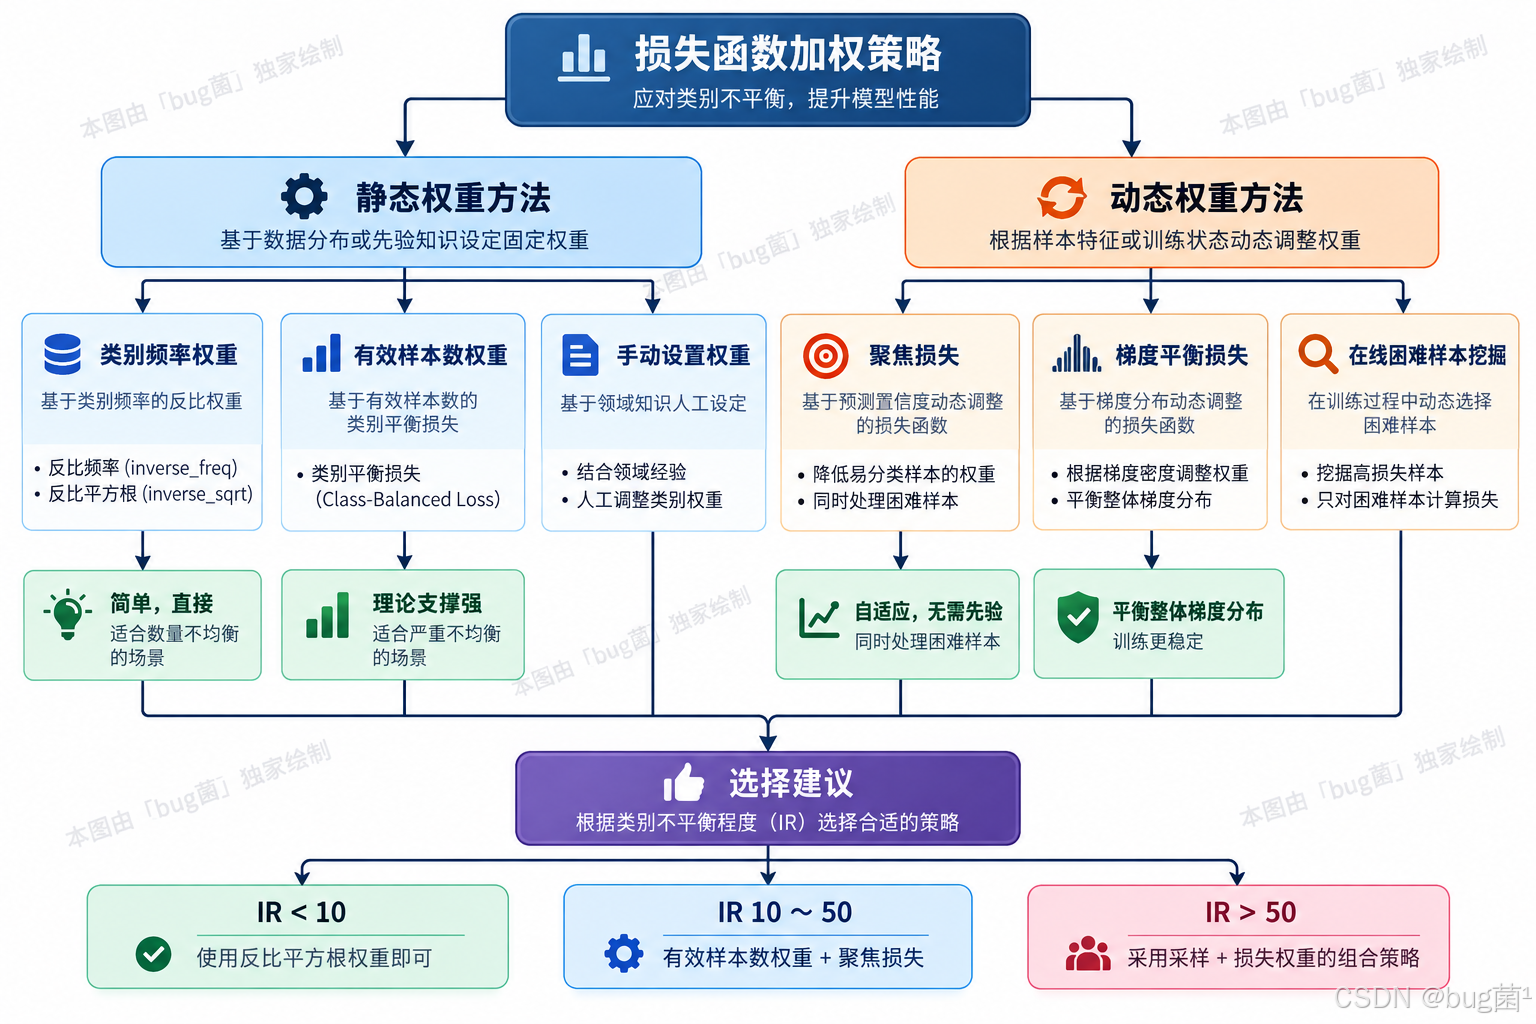
采样和增强解决的是"让少数类多出现"的问题,而损失权重策略解决的是"让模型更重视少数类"的问题。这两种思路可以同时使用,效果是互补而非替代的。
4.1 类别权重(Class Weights)
最直接的损失权重策略:给每个类别的分类 loss 乘以一个权重系数,少数类的权重更高,这样即使它们出现频率低,也能产生足够强的梯度。
在 Ultralytics/YOLOv10 中,通过 cls_pw(分类正样本权重)参数可以实现简单的权重调整。但更灵活的做法是直接修改损失函数:
import torch
import torch.nn as nn
import torch.nn.functional as F
from typing import List, Optional, Dict
import numpy as np
class WeightedBCELoss(nn.Module):
"""
带类别权重的二元交叉熵损失
用于替换 YOLOv10 中的分类损失
YOLOv10 的分类分支输出:每个位置输出 num_classes 个 logit
每个 logit 对应一个二分类问题(是/不是该类)
"""
def __init__(self,
class_weights: Optional[torch.Tensor] = None,
reduction: str = 'mean',
pos_weight: Optional[torch.Tensor] = None):
"""
参数:
class_weights: 形状 (num_classes,) 的权重 tensor
少数类对应较大的权重值
reduction: 'mean', 'sum', 'none'
pos_weight: 正样本权重(控制 recall/precision 平衡)
"""
super().__init__()
self.class_weights = class_weights
self.reduction = reduction
self.pos_weight = pos_weight
def forward(self,
pred: torch.Tensor,
target: torch.Tensor) –> torch.Tensor:
"""
参数:
pred: (B, num_classes) 或 (B, H, W, num_classes) 的预测 logit
target: 与 pred 形状相同的目标值(0 或 1)
"""
# 基础 BCE loss
loss = F.binary_cross_entropy_with_logits(
pred, target,
reduction='none',
pos_weight=self.pos_weight
)
# 应用类别权重
if self.class_weights is not None:
# class_weights: (num_classes,) -> 需要广播到与 loss 相同的形状
weight = self.class_weights.to(pred.device)
# 根据 target 确定每个位置属于哪个类别
# 对于多类别检测,权重由目标类别决定
# 这里做简化:对有目标存在的位置(target=1)施加类别权重
weighted_loss = loss * (1 + (weight – 1).unsqueeze(0) * target)
loss = weighted_loss
if self.reduction == 'mean':
return loss.mean()
elif self.reduction == 'sum':
return loss.sum()
return loss
def compute_class_weights_for_loss(
class_counts: List[int],
strategy: str = 'effective_number',
beta: float = 0.9999
) –> torch.Tensor:
"""
计算分类损失中使用的类别权重
策略:
1. 'inverse_freq': 权重 = 1 / 频率(最常用)
2. 'inverse_sqrt': 权重 = 1 / sqrt(频率)(更温和)
3. 'effective_number': 基于有效样本数理论(Class-Balanced Loss,CVPR 2019)
'effective_number' 策略来自论文:
"Class-Balanced Loss Based on Effective Number of Samples"
Cui et al., CVPR 2019
参数:
class_counts: 每个类别的样本数列表
strategy: 权重计算策略
beta: effective_number 策略的 beta 参数(推荐 0.9999)
"""
counts = np.array(class_counts, dtype=np.float64)
if strategy == 'inverse_freq':
# 经典策略:权重与频率成反比
weights = 1.0 / counts
elif strategy == 'inverse_sqrt':
# 温和策略:对少数类的提升幅度适中
weights = 1.0 / np.sqrt(counts)
elif strategy == 'effective_number':
# 基于有效样本数的 Class-Balanced Loss
# 有效样本数:E_n = (1 – beta^n) / (1 – beta)
# 这个公式的直觉:随着样本数增加,新样本带来的"新信息"递减
effective_num = (1.0 – np.power(beta, counts)) / (1.0 – beta)
weights = 1.0 / effective_num
else:
raise ValueError(f"未知策略: {strategy}")
# 归一化:权重均值为 1
weights = weights / weights.mean()
print("📊 类别损失权重:")
for i, w in enumerate(weights):
bar = "█" * int(w * 10)
print(f" 类别 {i:3d}: 权重 = {w:.4f} {bar}")
return torch.FloatTensor(weights)
# 示例:计算三种策略下的权重对比
def compare_weight_strategies(class_counts: List[int], class_names: List[str]):
"""可视化比较不同权重策略的差异"""
print("=" * 70)
print("三种权重策略对比")
print("=" * 70)
print(f"{'类别':<15} {'数量':>8} {'inv_freq':>12} {'inv_sqrt':>12} {'eff_num':>12}")
print("-" * 70)
strategies = ['inverse_freq', 'inverse_sqrt', 'effective_number']
results = {}
for s in strategies:
results[s] = compute_class_weights_for_loss(class_counts, strategy=s)
for i, (name, count) in enumerate(zip(class_names, class_counts)):
print(f"{name:<15} {count:>8,} "
f"{results['inverse_freq'][i]:>12.4f} "
f"{results['inverse_sqrt'][i]:>12.4f} "
f"{results['effective_number'][i]:>12.4f}")
print()
print("💡 建议:IR < 10 用 inv_sqrt;IR 10~100 用 effective_number;"
"IR > 100 用 inv_freq 配合过采样")
# 示例调用
# class_counts = [5000, 2000, 800, 300, 100, 50]
# class_names = ['car', 'person', 'bicycle', 'motorcycle', 'dog', 'rare_object']
# compare_weight_strategies(class_counts, class_names)
4.2 Focal Loss:让模型聚焦困难样本
Focal Loss 是 Facebook AI 在 RetinaNet 论文中提出的,专门用于解决目标检测中正负样本不均衡问题。它在 BCE 的基础上引入了一个动态缩放因子
(
1
−
p
t
)
γ
(1 – p_t)^\\gamma
(1−pt)γ:
F
L
(
p
t
)
=
−
α
t
(
1
−
p
t
)
γ
log
(
p
t
)
FL(p_t) = -\\alpha_t (1 – p_t)^\\gamma \\log(p_t)
FL(pt)=−αt(1−pt)γlog(pt)
其中:
-
p
t
p_t
pt 是模型对正确类别的预测概率; -
γ
\\gamma
γ(gamma)是聚焦参数,通常设为 2; -
α
t
\\alpha_t
αt 是类别均衡因子。
当模型对某个样本的预测很有把握(
p
t
p_t
pt 接近 1)时,
(
1
−
p
t
)
γ
(1 – p_t)^\\gamma
(1−pt)γ 会很小,这个样本对总 loss 的贡献被大幅压缩;而对于困难样本(
p
t
p_t
pt 较小),贡献则接近原始 BCE。
这个设计非常优雅——它不依赖于事先知道哪些类别是少数类,而是自适应地根据预测难度来调整权重。
class FocalLoss(nn.Module):
"""
Focal Loss 实现
适用于目标检测中的分类分支
原始论文:
"Focal Loss for Dense Object Detection"
Lin et al., ICCV 2017 (RetinaNet)
YOLOv10 原生使用 BCE loss,此类可作为替换选项使用。
Ultralytics 已内置 FocalLoss,但了解实现有助于调参。
"""
def __init__(self,
gamma: float = 2.0,
alpha: float = 0.25,
class_weights: Optional[torch.Tensor] = None,
reduction: str = 'mean'):
"""
参数:
gamma: 聚焦参数(通常 1.5~2.5)
gamma=0 时退化为 BCE;gamma 越大,对易分样本的压制越强
alpha: 正样本权重(通常 0.25)
用于平衡正负样本数量
class_weights: 额外的类别权重(与 alpha 配合使用)
reduction: 'mean', 'sum', 'none'
"""
super().__init__()
self.gamma = gamma
self.alpha = alpha
self.class_weights = class_weights
self.reduction = reduction
def forward(self,
pred: torch.Tensor,
target: torch.Tensor) –> torch.Tensor:
"""
参数:
pred: (N, C) 的 logit(未经 sigmoid)
target: (N, C) 的 binary target
"""
# 计算 BCE loss(不做 reduction)
bce_loss = F.binary_cross_entropy_with_logits(
pred, target, reduction='none'
)
# 计算预测概率
prob = torch.sigmoid(pred)
# 计算 p_t
p_t = prob * target + (1 – prob) * (1 – target)
# 应用 Focal 缩放因子
focal_weight = (1 – p_t) ** self.gamma
focal_loss = focal_weight * bce_loss
# 应用 alpha 因子(正负样本权重)
alpha_t = self.alpha * target + (1 – self.alpha) * (1 – target)
focal_loss = alpha_t * focal_loss
# 应用类别权重(少数类额外加权)
if self.class_weights is not None:
class_w = self.class_weights.to(pred.device)
# 对正样本位置施加类别权重
focal_loss = focal_loss * (1 + (class_w – 1).unsqueeze(0) * target)
if self.reduction == 'mean':
return focal_loss.mean()
elif self.reduction == 'sum':
return focal_loss.sum()
return focal_loss
def extra_repr(self) –> str:
return f"gamma={self.gamma}, alpha={self.alpha}"
# ============================================================
# 在 YOLOv10 训练中替换损失函数的方式
# ============================================================
# 注意:直接修改 Ultralytics 的 loss 函数需要继承 DetectionTrainer
# 并重写 criterion 属性,这里提供示范性代码
from ultralytics.models.yolo.detect import DetectionTrainer
from ultralytics.utils.loss import v8DetectionLoss
class FocalLossDetectionTrainer(DetectionTrainer):
"""
使用 Focal Loss 替换分类 BCE 的训练器
"""
def __init__(self, cfg=None, overrides=None, _callbacks=None):
super().__init__(cfg, overrides, _callbacks)
# 从配置中读取 Focal Loss 参数
self.focal_gamma = getattr(self.args, 'focal_gamma', 2.0)
self.focal_alpha = getattr(self.args, 'focal_alpha', 0.25)
self.class_weights_tensor = None
# 如果提供了类别权重,加载它
class_counts = getattr(self.args, 'class_counts', None)
if class_counts is not None:
self.class_weights_tensor = compute_class_weights_for_loss(
class_counts, strategy='effective_number'
)
def criterion(self, preds, batch):
"""
自定义 criterion,注入 Focal Loss
这个方法在每个训练步骤中被调用
"""
# 获取父类的 loss 计算器
if not hasattr(self, 'compute_loss'):
self.compute_loss = v8DetectionLoss(self.model)
# 临时替换分类损失
original_bce = self.compute_loss.bce
# 使用 Focal Loss 替换
self.compute_loss.bce = FocalLoss(
gamma=self.focal_gamma,
alpha=self.focal_alpha,
class_weights=self.class_weights_tensor
)
loss, loss_items = self.compute_loss(preds, batch)
# 恢复原始 BCE(避免影响验证阶段)
self.compute_loss.bce = original_bce
return loss, loss_items
4.3 GHM Loss:梯度均衡化
梯度均衡化机制(Gradient Harmonizing Mechanism,GHM)是另一种思路——它统计当前 batch 中各个"梯度模长"区间的样本数量,然后给梯度密集区域的样本降权。这样既压制了简单负样本(梯度接近0),也压制了被反复强调的困难样本(防止过度关注噪声标签)。
class GHMCLoss(nn.Module):
"""
梯度均衡化分类损失 (GHM-C)
论文:
"Gradient Harmonized Single-stage Detector"
Li et al., AAAI 2019
GHM 的核心思想:
对梯度进行直方图统计,密集区域降权,稀疏区域升权
自适应地平衡不同难度样本的贡献
"""
def __init__(self,
bins: int = 30,
momentum: float = 0.75,
use_sigmoid: bool = True,
loss_weight: float = 1.0):
"""
参数:
bins: 梯度直方图的 bin 数量
momentum: EMA 动量(平滑直方图统计)
use_sigmoid: 是否使用 sigmoid 激活
loss_weight: 损失权重系数
"""
super().__init__()
self.bins = bins
self.momentum = momentum
self.use_sigmoid = use_sigmoid
self.loss_weight = loss_weight
# 直方图边界
edges = torch.arange(bins + 1).float() / bins
self.register_buffer('edges', edges)
self.edges[–1] += 1e-6 # 让最后一个 bin 包含 1.0
if momentum > 0:
# 初始化移动平均直方图
acc_sum = torch.zeros(bins)
self.register_buffer('acc_sum', acc_sum)
def forward(self,
pred: torch.Tensor,
target: torch.Tensor,
label_weight: Optional[torch.Tensor] = None) –> torch.Tensor:
"""
参数:
pred: (N, C) 未经激活的 logit
target: (N, C) binary target
label_weight: (N, C) 可选的标签权重
"""
edges = self.edges
mmt = self.momentum
# 计算预测概率和梯度模长
prob = torch.sigmoid(pred)
# 梯度模长 |p – y|(对于 BCE loss,梯度模长等于预测误差)
grad_norm = torch.abs(prob.detach() – target)
# 梯度直方图统计
n = pred.numel()
weights = torch.zeros_like(grad_norm)
tot = max(n, 1)
for i in range(self.bins):
# 找到梯度模长落在当前 bin 范围内的样本
inds = (grad_norm >= edges[i]) & (grad_norm < edges[i + 1])
num_in_bin = inds.sum().item()
if num_in_bin > 0:
if mmt > 0:
# 使用 EMA 平滑直方图,减少 batch 间的波动
self.acc_sum[i] = mmt * self.acc_sum[i] + \\
(1 – mmt) * num_in_bin
weights[inds] = tot / self.acc_sum[i]
else:
weights[inds] = tot / num_in_bin
if label_weight is not None:
weights = weights * label_weight
# 计算 GHM-C loss
loss = F.binary_cross_entropy_with_logits(
pred, target, weight=weights, reduction='sum'
) / tot
return loss * self.loss_weight
相关示意图绘制如下,仅供参考:
五、策略四:配置层面的参数调整
有些不均衡问题可以通过调整训练配置来缓解,不需要改动代码逻辑。
5.1 cls 参数:分类损失的全局权重
YOLOv10 的 cls 参数控制分类损失在总损失中的比例(默认 0.5)。当类别不均衡严重时,可以适当提高 cls 权重,让模型更重视学习类别区分:
# 不均衡程度与 cls 权重的经验关系
# 注意:这只是经验值,实际需要根据验证集指标调整
cls_weight_guide = {
# IR: cls_weight
(0, 5): 0.5, # 轻度不均衡:默认值
(5, 20): 0.6, # 中度不均衡:略微提高
(20, 100): 0.7, # 严重不均衡:明显提高
(100, float('inf')): 0.8, # 极度不均衡:大幅提高
}
def get_recommended_cls_weight(imbalance_ratio: float) –> float:
"""根据 IR 返回推荐的 cls 损失权重"""
for (low, high), weight in cls_weight_guide.items():
if low <= imbalance_ratio < high:
return weight
return 0.5 # 默认值
5.2 label_smoothing:对少数类更友好
标签平滑(Label Smoothing)将硬标签(0 或 1)替换为软标签(如 0.1 或 0.9),这样做有几个好处:
# YOLOv10 训练配置示例
training_config_balanced = {
'model': 'yolov10s.pt',
'data': './data/unbalanced_dataset/data.yaml',
'epochs': 150,
'imgsz': 640,
'batch': 16,
# 损失权重调整(针对严重不均衡)
'cls': 0.7, # 提高分类损失权重(默认 0.5)
'box': 7.5, # 框回归损失权重(默认 7.5,通常不需要调整)
'dfl': 1.5, # DFL 损失权重(默认 1.5,通常不需要调整)
# 标签平滑(轻微,0.01~0.1)
'label_smoothing': 0.05, # 默认 0.0,不均衡时设置 0.05~0.1
# 增强配置(中度不均衡)
'mosaic': 1.0,
'mixup': 0.15,
'hsv_h': 0.02,
'hsv_s': 0.8,
'hsv_v': 0.5,
'fliplr': 0.5,
'flipud': 0.1,
# 其他
'optimizer': 'AdamW',
'lr0': 0.001,
'lrf': 0.01,
'weight_decay': 0.0005,
'patience': 30, # 不均衡训练更容易震荡,适当增大 patience
'save_period': 5, # 每 5 epoch 保存一次,方便分析少数类指标
# 训练结束关闭 mosaic 的 epoch 数
'close_mosaic': 15, # 最后 15 个 epoch 关闭 mosaic,以稳定收敛
}
5.3 验证集的正确配置
这是一个容易被忽视但非常重要的点:验证集的类别分布应该反映真实世界的分布,而不是训练集的均衡分布。
如果你把训练集过采样了,请确保验证集保持原始分布不变。用人工均衡的验证集评估模型,得到的指标会产生误导——在真实场景中,少数类的问题依然存在,但你的验证指标看起来已经"解决"了。
import yaml
import shutil
from pathlib import Path
from sklearn.model_selection import train_test_split
import glob
import os
def create_stratified_split(
dataset_dir: str,
output_dir: str,
train_ratio: float = 0.8,
val_ratio: float = 0.1,
test_ratio: float = 0.1,
seed: int = 42
):
"""
创建按类别分层的数据集划分
关键原则:
– 训练集:可以后续过采样
– 验证集:保持原始分布(用于真实评估)
– 测试集:保持原始分布(最终报告用)
策略:按照每张图片包含的主要类别进行分层,
确保每个类别在 train/val/test 中都有足够的代表
"""
assert abs(train_ratio + val_ratio + test_ratio – 1.0) < 1e-6, \\
"比例之和必须等于 1"
dataset_dir = Path(dataset_dir)
output_dir = Path(output_dir)
labels_dir = dataset_dir / 'labels'
images_dir = dataset_dir / 'images'
# 统计每张图片的主要类别
image_class_map = {} # {image_stem: primary_class_id}
for label_file in (labels_dir / 'all').glob('*.txt'):
class_counter = Counter()
with open(label_file, 'r') as f:
for line in f:
parts = line.strip().split()
if len(parts) >= 5:
class_counter[int(parts[0])] += 1
if class_counter:
primary_class = class_counter.most_common(1)[0][0]
else:
primary_class = –1 # 无标注图片
image_class_map[label_file.stem] = primary_class
# 按主类别分层划分
stems = list(image_class_map.keys())
classes = [image_class_map[s] for s in stems]
# 第一步:分出 test set
stems_trainval, stems_test, cls_trainval, _ = train_test_split(
stems, classes,
test_size=test_ratio,
stratify=classes,
random_state=seed
)
# 第二步:从剩余中分出 val set
val_ratio_adjusted = val_ratio / (train_ratio + val_ratio)
stems_train, stems_val, _, _ = train_test_split(
stems_trainval, cls_trainval,
test_size=val_ratio_adjusted,
stratify=cls_trainval,
random_state=seed
)
print(f"✅ 分层划分完成:")
print(f" 训练集: {len(stems_train)} 张")
print(f" 验证集: {len(stems_val)} 张(保持原始分布)")
print(f" 测试集: {len(stems_test)} 张(保持原始分布)")
# 复制文件到输出目录
splits = {
'train': stems_train,
'val': stems_val,
'test': stems_test
}
for split_name, split_stems in splits.items():
for subdir in ['images', 'labels']:
(output_dir / subdir / split_name).mkdir(parents=True, exist_ok=True)
for stem in split_stems:
# 复制标签
src_label = labels_dir / 'all' / (stem + '.txt')
if src_label.exists():
shutil.copy2(src_label, output_dir / 'labels' / split_name / (stem + '.txt'))
# 复制图片
for ext in ['.jpg', '.jpeg', '.png']:
src_img = images_dir / 'all' / (stem + ext)
if src_img.exists():
shutil.copy2(src_img, output_dir / 'images' / split_name / (stem + ext))
break
print("✅ 文件复制完成!")
return splits
六、综合实战:一个完整的类别不均衡处理 Pipeline
现在把前面介绍的所有策略整合成一个完整的工作流。
相关示意图绘制如下,仅供参考:
"""
类别不均衡训练完整 Pipeline
整合:分布分析 → 策略选择 → 数据准备 → 配置生成 → 训练监控
"""
import os
import yaml
import json
from pathlib import Path
from typing import Optional, Dict, Any
from collections import Counter
import numpy as np
class ImbalancedTrainingPipeline:
"""
类别不均衡训练完整 Pipeline
使用示例:
pipeline = ImbalancedTrainingPipeline(
data_yaml='./data/my_dataset/data.yaml',
model_path='yolov10s.pt',
output_dir='./experiments/balanced_training'
)
pipeline.analyze()
pipeline.prepare()
pipeline.train()
"""
def __init__(self,
data_yaml: str,
model_path: str = 'yolov10s.pt',
output_dir: str = './balanced_experiment',
strategy: str = 'auto'):
"""
参数:
data_yaml: 数据集配置文件路径
model_path: YOLOv10 预训练权重
output_dir: 实验输出目录
strategy: 'auto'(根据 IR 自动选择), 'light', 'medium', 'heavy'
"""
self.data_yaml = Path(data_yaml)
self.model_path = model_path
self.output_dir = Path(output_dir)
self.strategy = strategy
self.output_dir.mkdir(parents=True, exist_ok=True)
# 分析结果缓存
self._analysis_result = None
self._train_config = None
def analyze(self) –> Dict:
"""步骤1:分析数据集类别分布"""
print("\\n" + "="*60)
print("🔍 步骤1: 分析类别分布")
print("="*60)
result = analyze_class_distribution(str(self.data_yaml))
self._analysis_result = result
# 保存分析结果
with open(self.output_dir / 'distribution_analysis.json', 'w') as f:
json.dump({
'class_names': result['class_names'],
'counts': result['counts'],
'imbalance_ratio': result['imbalance_ratio'],
'total_instances': result['total_instances'],
'total_images': result['total_images'],
}, f, indent=2, ensure_ascii=False)
return result
def _auto_select_strategy(self, ir: float) –> str:
"""根据 IR 自动选择策略"""
if ir < 5:
return 'light'
elif ir < 20:
return 'medium'
else:
return 'heavy'
def prepare(self) –> Dict[str, Any]:
"""步骤2:根据分析结果准备训练配置"""
if self._analysis_result is None:
self.analyze()
ir = self._analysis_result['imbalance_ratio']
class_counts = self._analysis_result['counts']
# 确定策略
if self.strategy == 'auto':
actual_strategy = self._auto_select_strategy(ir)
else:
actual_strategy = self.strategy
print(f"\\n{'='*60}")
print(f"⚙️ 步骤2: 生成训练配置(策略: {actual_strategy})")
print(f"{'='*60}")
# 计算类别权重
class_weights = compute_class_weights_for_loss(
class_counts,
strategy='effective_number' if ir > 10 else 'inverse_sqrt'
).tolist()
# 获取增强配置
aug_config = get_balanced_augmentation_config(ir)
# 生成完整训练配置
base_config = {
'model': self.model_path,
'data': str(self.data_yaml),
'project': str(self.output_dir),
'name': f'balanced_{actual_strategy}',
'exist_ok': True,
'epochs': 150 if actual_strategy == 'heavy' else 100,
'imgsz': 640,
'batch': 16,
'optimizer': 'AdamW',
'lr0': 0.001,
'lrf': 0.01,
'weight_decay': 0.0005,
'patience': 40,
'save_period': 10,
'close_mosaic': 20,
'label_smoothing': 0.05 if actual_strategy != 'heavy' else 0.1,
'cls': get_recommended_cls_weight(ir),
**aug_config,
}
# 策略特定配置
if actual_strategy == 'heavy':
base_config.update({
'use_weighted_sampler': True,
'sampler_strategy': 'sqrt',
'focal_gamma': 2.0,
'focal_alpha': 0.25,
'class_counts': class_counts,
})
elif actual_strategy == 'medium':
base_config.update({
'use_weighted_sampler': True,
'sampler_strategy': 'sqrt',
})
self._train_config = base_config
# 保存配置
config_path = self.output_dir / 'train_config.yaml'
with open(config_path, 'w') as f:
yaml.dump(base_config, f, allow_unicode=True)
print(f"✅ 训练配置已保存至 {config_path}")
print(f"\\n🎯 关键配置:")
print(f" 策略: {actual_strategy}")
print(f" cls损失权重: {base_config['cls']}")
print(f" label_smoothing: {base_config['label_smoothing']}")
print(f" mixup概率: {base_config.get('mixup', 0)}")
print(f" weighted_sampler: {base_config.get('use_weighted_sampler', False)}")
return base_config
def train(self):
"""步骤3:启动训练"""
if self._train_config is None:
self.prepare()
print(f"\\n{'='*60}")
print(f"🚀 步骤3: 启动训练")
print(f"{'='*60}")
config = self._train_config.copy()
# 根据是否需要均衡采样选择 Trainer
use_weighted = config.pop('use_weighted_sampler', False)
sampler_strategy = config.pop('sampler_strategy', 'sqrt')
focal_gamma = config.pop('focal_gamma', None)
focal_alpha = config.pop('focal_alpha', None)
class_counts = config.pop('class_counts', None)
from ultralytics import YOLO
model = YOLO(self.model_path)
if use_weighted or focal_gamma:
print("⚡ 使用自定义均衡训练器…")
# 使用前面定义的 BalancedDetectionTrainer
# 这里为了示例简洁,直接调用 model.train()
# 实际项目中应注入自定义 Trainer
config['use_weighted_sampler'] = use_weighted
config['sampler_strategy'] = sampler_strategy
if class_counts:
config['class_counts'] = class_counts
# 启动训练
results = model.train(**config)
print(f"\\n✅ 训练完成!")
return results
def evaluate_per_class(self, model_path: str, data_yaml: Optional[str] = None):
"""
评估模型在各类别上的表现
重点关注少数类的 AP
"""
from ultralytics import YOLO
if data_yaml is None:
data_yaml = str(self.data_yaml)
model = YOLO(model_path)
# 在验证集上评估
results = model.val(data=data_yaml, verbose=True)
# 提取各类别 AP
class_names = self._analysis_result['class_names'] if self._analysis_result else []
if hasattr(results, 'ap_class_index') and hasattr(results, 'ap'):
print("\\n📊 各类别 AP50 统计:")
print("-" * 50)
for idx, cls_id in enumerate(results.ap_class_index):
ap = results.ap[idx] if idx < len(results.ap) else 0
cls_name = class_names[cls_id] if cls_id < len(class_names) else str(cls_id)
count = self._analysis_result['counts'][cls_id] if self._analysis_result else '?'
# 根据 AP 值标注状态
if ap >= 0.7:
status = "✅"
elif ap >= 0.4:
status = "⚠️ "
else:
status = "🚨"
bar_len = int(ap * 30)
bar = "█" * bar_len + "░" * (30 – bar_len)
print(f"{status} {cls_name:<15} AP50={ap:.3f} [{bar}] (n={count})")
return results
七、实验对比:不同策略的效果评估
光讲理论是不够的,我们需要知道各种策略在实践中的效果差异。以下是一个对比实验框架,帮助你在自己的数据集上量化各种方法的收益:
"""
类别不均衡处理策略对比实验
系统地比较不同策略的效果,为实际项目提供决策依据
"""
import os
import json
import time
from pathlib import Path
from dataclasses import dataclass, field
from typing import List, Dict, Optional
import matplotlib.pyplot as plt
import numpy as np
@dataclass
class ExperimentConfig:
"""单次实验的配置"""
name: str
description: str
# 采样配置
use_weighted_sampler: bool = False
sampler_strategy: str = 'sqrt'
oversample_ratio: float = 0.0 # 0表示不过采样
# 损失函数配置
use_focal_loss: bool = False
focal_gamma: float = 2.0
cls_weight: float = 0.5
label_smoothing: float = 0.0
# 增强配置
mixup: float = 0.0
copy_paste: float = 0.0
# 其他
epochs: int = 100
extra_params: Dict = field(default_factory=dict)
# 预定义的实验组合
EXPERIMENTS = [
ExperimentConfig(
name='baseline',
description='基线:无任何均衡策略',
epochs=100
),
ExperimentConfig(
name='label_smoothing_only',
description='仅使用标签平滑',
label_smoothing=0.05,
epochs=100
),
ExperimentConfig(
name='cls_weight_only',
description='仅提高分类损失权重',
cls_weight=0.7,
epochs=100
),
ExperimentConfig(
name='weighted_sampler',
description='WeightedRandomSampler(sqrt策略)',
use_weighted_sampler=True,
sampler_strategy='sqrt',
epochs=100
),
ExperimentConfig(
name='focal_loss',
description='Focal Loss(gamma=2)',
use_focal_loss=True,
focal_gamma=2.0,
epochs=100
),
ExperimentConfig(
name='augmentation_heavy',
description='加强增强(mixup + 色彩增强)',
mixup=0.2,
extra_params={
'hsv_s': 0.9, 'hsv_v': 0.5,
'flipud': 0.2, 'degrees': 10.0
},
epochs=100
),
ExperimentConfig(
name='combined_medium',
description='组合策略:采样 + Focal + 增强',
use_weighted_sampler=True,
use_focal_loss=True,
focal_gamma=2.0,
cls_weight=0.65,
label_smoothing=0.05,
mixup=0.15,
epochs=120
),
ExperimentConfig(
name='combined_heavy',
description='全套策略:过采样 + Focal + 增强 + 权重',
use_weighted_sampler=True,
use_focal_loss=True,
focal_gamma=2.0,
cls_weight=0.7,
label_smoothing=0.1,
mixup=0.2,
oversample_ratio=0.5,
epochs=150
),
]
def run_comparison_experiment(
data_yaml: str,
model_path: str = 'yolov10s.pt',
output_base_dir: str = './comparison_experiments',
experiments: Optional[List[ExperimentConfig]] = None,
minority_classes: Optional[List[int]] = None
):
"""
运行对比实验
参数:
data_yaml: 数据集配置
model_path: 预训练模型
output_base_dir: 实验输出根目录
experiments: 要运行的实验列表,None 则运行所有预定义实验
minority_classes: 少数类 ID 列表(用于重点监控)
"""
from ultralytics import YOLO
if experiments is None:
experiments = EXPERIMENTS
output_base = Path(output_base_dir)
output_base.mkdir(parents=True, exist_ok=True)
all_results = {}
for exp in experiments:
print(f"\\n{'='*70}")
print(f"🧪 运行实验: {exp.name}")
print(f" 描述: {exp.description}")
print(f"{'='*70}")
# 构建训练参数
train_kwargs = {
'data': data_yaml,
'project': str(output_base),
'name': exp.name,
'epochs': exp.epochs,
'imgsz': 640,
'batch': 16,
'optimizer': 'AdamW',
'lr0': 0.001,
'cls': exp.cls_weight,
'label_smoothing': exp.label_smoothing,
'mixup': exp.mixup,
'exist_ok': True,
**exp.extra_params
}
# 运行训练
start_time = time.time()
model = YOLO(model_path)
try:
results = model.train(**train_kwargs)
val_results = model.val(data=data_yaml)
elapsed = time.time() – start_time
# 提取结果
exp_result = {
'name': exp.name,
'description': exp.description,
'elapsed_minutes': elapsed / 60,
'map50': float(val_results.box.map50) if hasattr(val_results, 'box') else 0,
'map50_95': float(val_results.box.map) if hasattr(val_results, 'box') else 0,
}
# 提取各类别 AP(重点关注少数类)
if hasattr(val_results, 'ap_class_index') and hasattr(val_results, 'ap'):
class_ap = {}
for idx, cls_id in enumerate(val_results.ap_class_index):
ap = float(val_results.ap[idx]) if idx < len(val_results.ap) else 0
class_ap[int(cls_id)] = ap
exp_result['class_ap'] = class_ap
# 计算少数类平均 AP
if minority_classes:
minority_aps = [class_ap.get(c, 0) for c in minority_classes]
exp_result['minority_map50'] = np.mean(minority_aps)
print(f" 📊 少数类平均 AP50: {exp_result['minority_map50']:.4f}")
all_results[exp.name] = exp_result
print(f" ✅ 完成!mAP50={exp_result['map50']:.4f}, "
f"耗时={elapsed/60:.1f}分钟")
except Exception as e:
print(f" ❌ 实验失败: {e}")
all_results[exp.name] = {'name': exp.name, 'error': str(e)}
# 保存中间结果(防止中途崩溃丢失数据)
with open(output_base / 'comparison_results.json', 'w') as f:
json.dump(all_results, f, indent=2, ensure_ascii=False)
# 生成对比图表
_plot_comparison_results(all_results, output_base, minority_classes)
return all_results
def _plot_comparison_results(
results: dict,
output_dir: Path,
minority_classes: Optional[List[int]] = None
):
"""绘制实验对比图表"""
valid_results = {k: v for k, v in results.items() if 'error' not in v}
if not valid_results:
print("⚠️ 没有有效的实验结果可以绘图")
return
names = list(valid_results.keys())
maps = [valid_results[n].get('map50', 0) for n in names]
minority_maps = [valid_results[n].get('minority_map50', 0) for n in names]
fig, axes = plt.subplots(1, 2, figsize=(16, 7))
# 图1:Overall mAP50 对比
colors = ['#e74c3c' if n == 'baseline' else '#3498db' for n in names]
bars = axes[0].bar(range(len(names)), maps, color=colors)
axes[0].set_xticks(range(len(names)))
axes[0].set_xticklabels(names, rotation=45, ha='right', fontsize=8)
axes[0].set_ylabel('mAP50', fontsize=12)
axes[0].set_title('Overall mAP50 Comparison', fontsize=13, fontweight='bold')
axes[0].set_ylim(0, min(1.0, max(maps) * 1.15))
axes[0].grid(axis='y', alpha=0.3)
for bar, val in zip(bars, maps):
axes[0].text(bar.get_x() + bar.get_width()/2., bar.get_height() + 0.005,
f'{val:.3f}', ha='center', va='bottom', fontsize=8)
# 图2:少数类 mAP50 对比
if any(m > 0 for m in minority_maps):
colors2 = ['#e74c3c' if n == 'baseline' else '#2ecc71' for n in names]
bars2 = axes[1].bar(range(len(names)), minority_maps, color=colors2)
axes[1].set_xticks(range(len(names)))
axes[1].set_xticklabels(names, rotation=45, ha='right', fontsize=8)
axes[1].set_ylabel('Minority Class mAP50', fontsize=12)
axes[1].set_title('Minority Class mAP50 Comparison', fontsize=13, fontweight='bold')
axes[1].set_ylim(0, min(1.0, max(minority_maps) * 1.15 + 0.01))
axes[1].grid(axis='y', alpha=0.3)
for bar, val in zip(bars2, minority_maps):
axes[1].text(bar.get_x() + bar.get_width()/2., bar.get_height() + 0.005,
f'{val:.3f}', ha='center', va='bottom', fontsize=8)
else:
axes[1].text(0.5, 0.5, 'No minority class data available',
ha='center', va='center', transform=axes[1].transAxes, fontsize=12)
plt.suptitle('Class Imbalance Strategy Comparison', fontsize=14, fontweight='bold', y=1.02)
plt.tight_layout()
save_path = output_dir / 'comparison_chart.png'
plt.savefig(save_path, dpi=150, bbox_inches='tight')
plt.show()
print(f"📊 对比图表已保存至 {save_path}")
八、进阶话题:OHEM 与动态采样
8.1 在线困难样本挖掘(OHEM)
OHEM(Online Hard Example Mining)的思路是:在每个 batch 中,不是把所有样本的 loss 都用来更新梯度,而是只选择 loss 最高的 K 个样本(即模型当前最困难的样本)来计算梯度。
这对类别不均衡有辅助效果:因为少数类往往 loss 更高(模型对它们的预测更差),所以 OHEM 会自然地给少数类更多的关注。
class OHEMLoss(nn.Module):
"""
在线困难样本挖掘损失
只对 loss 最高的 top_k 个样本反向传播
适用于目标检测中正负样本比例悬殊的场景
"""
def __init__(self,
top_k_ratio: float = 0.7,
min_kept: int = 64,
base_loss: str = 'bce'):
"""
参数:
top_k_ratio: 保留 loss 最高的比例(如0.7表示保留top 70%)
min_kept: 至少保留的样本数
base_loss: 基础 loss 类型 ('bce' 或 'focal')
"""
super().__init__()
self.top_k_ratio = top_k_ratio
self.min_kept = min_kept
self.base_loss = base_loss
def forward(self,
pred: torch.Tensor,
target: torch.Tensor) –> torch.Tensor:
"""
参数:
pred: (N, C) 预测 logit
target: (N, C) 目标
"""
# 计算每个样本的基础 loss(不做 reduction)
if self.base_loss == 'focal':
element_loss = self._focal_loss_element(pred, target)
else:
element_loss = F.binary_cross_entropy_with_logits(
pred, target, reduction='none'
).mean(dim=–1) # 对类别维度平均,得到 (N,) 的样本级 loss
# 选择困难样本
n = element_loss.numel()
k = max(int(n * self.top_k_ratio), min(self.min_kept, n))
# 获取 loss 最高的 k 个样本的索引
topk_losses, _ = torch.topk(element_loss, k, largest=True, sorted=False)
return topk_losses.mean()
def _focal_loss_element(self, pred, target, gamma=2.0, alpha=0.25):
"""计算元素级 Focal Loss"""
bce = F.binary_cross_entropy_with_logits(pred, target, reduction='none')
p = torch.sigmoid(pred)
p_t = p * target + (1 – p) * (1 – target)
focal_weight = (1 – p_t) ** gamma
alpha_t = alpha * target + (1 – alpha) * (1 – target)
return (alpha_t * focal_weight * bce).mean(dim=–1)
8.2 动态采样:训练中期自动调整
一个更高级的想法是:随着训练进行,动态地调整采样权重。在训练初期,对少数类大幅过采样;随着模型逐渐学会识别少数类,降低过采样倍数,让训练更平稳地收敛。
class DynamicImbalanceSampler:
"""
动态采样器:根据当前验证集各类别 AP 动态调整采样权重
思路:
– 每隔 N 个 epoch 在验证集上评估各类别 AP
– AP 越低的类别,采样权重越高
– 随着训练进行,少数类 AP 提升后自动降低其采样倍率
"""
def __init__(self,
initial_weights: torch.Tensor,
update_interval: int = 10,
smoothing: float = 0.5):
"""
参数:
initial_weights: 初始采样权重
update_interval: 更新权重的 epoch 间隔
smoothing: EMA 平滑系数(防止权重剧烈变化)
"""
self.weights = initial_weights.clone()
self.update_interval = update_interval
self.smoothing = smoothing
self.history = []
def update_from_validation(self,
class_ap: Dict[int, float],
num_classes: int) –> torch.Tensor:
"""
根据验证集各类别 AP 更新采样权重
参数:
class_ap: {class_id: ap50} 字典
num_classes: 总类别数
返回:
更新后的权重 tensor
"""
# 基于各类别 AP 计算新权重(AP 越低,权重越高)
aps = [class_ap.get(i, 0.0) for i in range(num_classes)]
# 避免 AP=0 导致权重无穷大
aps = [max(ap, 0.01) for ap in aps]
# 权重与 AP 成反比,并归一化
new_weights = torch.FloatTensor([1.0 / ap for ap in aps])
new_weights = new_weights / new_weights.mean()
# EMA 平滑,避免权重剧烈波动
self.weights = (self.smoothing * self.weights +
(1 – self.smoothing) * new_weights)
self.history.append({
'class_ap': class_ap,
'weights': self.weights.tolist()
})
print(f"📈 动态权重已更新:")
for i, (ap, w) in enumerate(zip(aps, self.weights.tolist())):
print(f" 类别 {i:2d}: AP={ap:.3f} → 权重={w:.3f}")
return self.weights
九、常见问题与调试指南
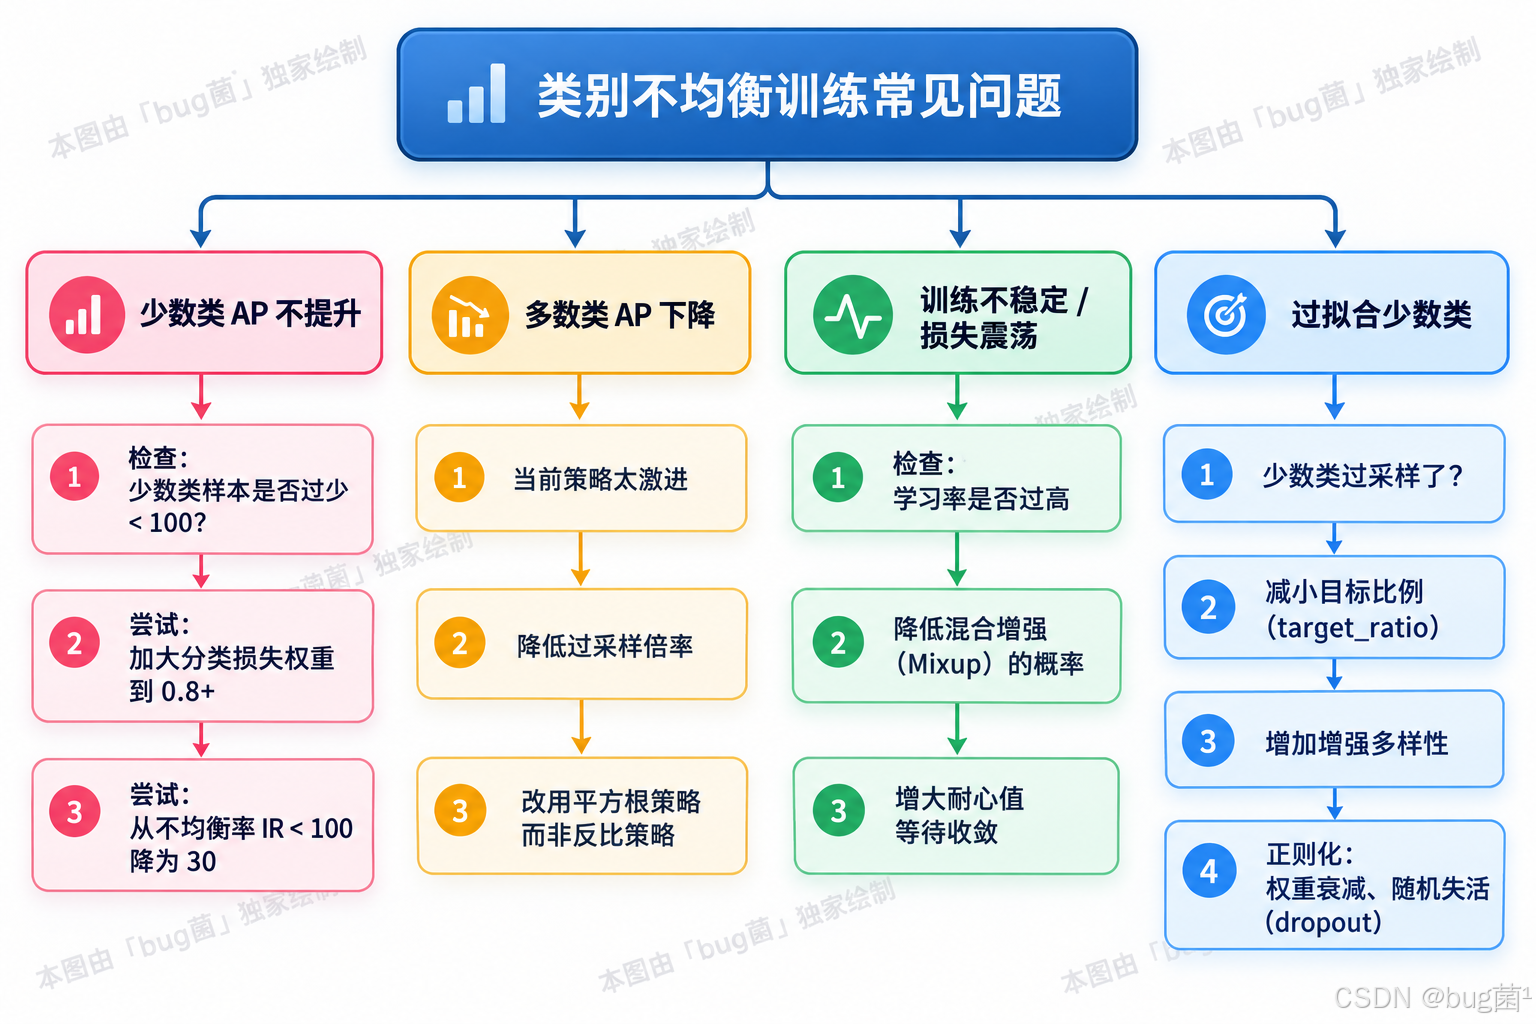
在实际处理类别不均衡问题时,会遇到一些典型的坑,这里总结出来供参考。
相关示意图绘制如下,仅供参考:
def diagnose_training_issues(
results_dir: str,
class_names: list,
minority_classes: list
) –> dict:
"""
训练后诊断工具
分析训练曲线,识别常见问题并给出建议
参数:
results_dir: 训练结果目录(包含 results.csv)
class_names: 类别名称列表
minority_classes: 少数类 ID
"""
import pandas as pd
results_csv = Path(results_dir) / 'results.csv'
if not results_csv.exists():
print(f"⚠️ 未找到 results.csv: {results_csv}")
return {}
# 读取训练曲线
df = pd.read_csv(results_csv, skipinitialspace=True)
df.columns = df.columns.str.strip() # 去除列名空格
issues = []
suggestions = []
# 检查1:训练是否收敛
if 'metrics/mAP50(B)' in df.columns:
map_values = df['metrics/mAP50(B)'].dropna().values
if len(map_values) > 10:
recent_10 = map_values[–10:]
improvement = recent_10[–1] – recent_10[0]
if improvement < 0.001:
issues.append("⚠️ 训练已基本收敛(mAP50 近10 epoch变化 < 0.001)")
if recent_10[–1] < 0.5:
suggestions.append("💡 mAP 偏低且已收敛,考虑:\\n"
" 1. 增加训练 epoch(当前可能还未充分训练)\\n"
" 2. 检查数据质量(标注是否准确)\\n"
" 3. 尝试更大的模型(n→s→m)")
# 检查2:Loss 是否震荡
if 'train/cls_loss' in df.columns:
cls_loss = df['train/cls_loss'].dropna().values
if len(cls_loss) > 20:
# 计算后半段 loss 的标准差
later_half = cls_loss[len(cls_loss)//2:]
cv = later_half.std() / (later_half.mean() + 1e-8)
if cv > 0.15:
issues.append(f"🔴 分类 Loss 震荡较大(变异系数 = {cv:.3f})")
suggestions.append("💡 Loss 震荡的应对措施:\\n"
" 1. 降低学习率(lr0 × 0.5)\\n"
" 2. 降低 mixup 概率(mixup × 0.5)\\n"
" 3. 增加 batch size\\n"
" 4. 检查少数类标注质量")
# 检查3:过拟合迹象
if 'train/cls_loss' in df.columns and 'val/cls_loss' in df.columns:
train_cls = df['train/cls_loss'].dropna().values
val_cls = df['val/cls_loss'].dropna().values
min_len = min(len(train_cls), len(val_cls))
if min_len > 10:
final_ratio = val_cls[–1] / (train_cls[–1] + 1e-8)
if final_ratio > 2.0:
issues.append(f"🔴 可能过拟合(val/train loss 比 = {final_ratio:.2f})")
suggestions.append("💡 过拟合应对措施:\\n"
" 1. 增加数据增强强度\\n"
" 2. 增大 weight_decay(如 0.001)\\n"
" 3. 减小过采样倍率\\n"
" 4. 启用 dropout(修改模型配置)\\n"
" 5. 减少 epoch 数(使用 early stopping)")
# 输出诊断报告
print("\\n" + "="*60)
print("🔬 训练诊断报告")
print("="*60)
if not issues:
print("✅ 未发现明显问题,训练状态良好!")
else:
print(f"发现 {len(issues)} 个潜在问题:\\n")
for issue in issues:
print(f" {issue}")
print()
for suggestion in suggestions:
print(suggestion)
print()
return {
'issues': issues,
'suggestions': suggestions
}
十、一份实用的决策清单
在每次面对类别不均衡问题时,我会按照这个清单来决策:
"""
类别不均衡处理决策清单
打印出来贴在显示器旁边——
□ Step 1: 量化问题
□ 计算 IR(不均衡比)
□ 查看各类别在训练/验证/测试集中的分布
□ 检查最少类别是否有足够样本(< 100 需要特别关注)
□ Step 2: 数据质量先行
□ 检查少数类的标注质量(比数量更重要)
□ 确认少数类样本的多样性(光照、角度、背景)
□ 是否存在漏标(把少数类标记为背景)
□ Step 3: 按 IR 选择策略
□ IR < 5: label_smoothing=0.05, 默认配置
□ IR 5~20: WeightedSampler + mixup + cls↑
□ IR > 20: 过采样 + Focal Loss + 全套增强
□ IR > 100: 先考虑补充采集少数类数据
□ Step 4: 验证集策略
□ 验证集保持原始不均衡分布(真实世界评估)
□ 报告各类别独立 AP,不只看整体 mAP
□ 特别关注少数类的 Recall(漏检更危险)
□ Step 5: 迭代调整
□ 先跑 30 epoch 快速验证策略有效性
□ 观察少数类 AP 是否从基线有所提升
□ 如果多数类 AP 下降过多,减少策略激进程度
□ 达到满意效果后再跑完整训练
"""
def print_decision_checklist(ir: float, min_class_count: int):
"""根据数据集情况打印决策建议"""
print("\\n" + "🗂️ 类别不均衡处理建议".center(60, "="))
print()
if min_class_count < 50:
print("⚡ 警告:最少类别样本数 < 50")
print(" 强烈建议先补充数据再训练!")
print(" 至少达到 100~200 张才能保证模型有机会学习到该类特征。")
print()
if ir < 5:
print("📋 IR < 5(轻度不均衡)推荐配置:")
print(" model.train(")
print(" label_smoothing=0.05,")
print(" cls=0.5, # 默认值")
print(" mixup=0.0,")
print(" )")
elif ir < 20:
print(f"📋 IR = {ir:.1f}(中度不均衡)推荐配置:")
print(" model.train(")
print(" label_smoothing=0.05,")
print(" cls=0.6,")
print(" mixup=0.15,")
print(" # 同时启用 WeightedRandomSampler")
print(" hsv_s=0.8, hsv_v=0.5,")
print(" )")
else:
print(f"📋 IR = {ir:.1f}(严重不均衡)推荐配置:")
print(" # 第一步:对少数类过采样到多数类的50%")
print(" oversampler.oversample(target_ratio=0.5)")
print()
print(" # 第二步:训练配置")
print(" model.train(")
print(" label_smoothing=0.1,")
print(" cls=0.7,")
print(" mixup=0.2,")
print(" # 启用 Focal Loss 和 WeightedSampler")
print(" close_mosaic=20,")
print(" )")
print()
print("⚠️ 无论哪种策略,都请务必:")
print(" 1. 验证集保持原始分布")
print(" 2. 按类别单独报告 AP")
print(" 3. 以少数类的 AP 作为主要优化目标")
下期预告:WandB、TensorBoard、MLflow 实验追踪实战
经过本节对类别不均衡处理的深度探讨,相信你已经意识到:在解决类别不均衡这类复杂问题时,实验管理的重要性极其突出——因为我们往往需要比较多种策略、多组超参数的效果,而这些实验的数量很快就会多到难以用人工记录的方式管理。
下一节,我们将系统地介绍三款主流实验追踪工具:
WandB(Weights & Biases),被很多工业级团队使用的云端实验管理平台。它的 AutoChart 功能可以实时可视化训练曲线,支持多实验对比,还能追踪每次实验使用的超参数、代码版本、硬件环境。在处理类别不均衡问题时,它能帮你一眼看出哪种策略在少数类上的效果更好。
TensorBoard,来自 TensorFlow 生态,但对 PyTorch/Ultralytics 也有完善的支持。它是本地部署的可视化工具,不需要联网,适合数据隐私要求高的项目。我们会介绍如何在 YOLOv10 训练中集成 TensorBoard,以及如何自定义记录各类别的 AP 曲线。
MLflow,侧重于完整的 MLOps 流程管理,不只记录训练指标,还能管理模型版本、打包模型、对比不同版本的性能。非常适合需要多人协作的团队项目。
更重要的是,我们会讲清楚三者的选型逻辑——什么场景下用哪个工具,以及如何在一套实验中同时使用多个追踪工具而不相互干扰。
本节小结:
类别不均衡是目标检测落地时最常遇到的"隐形杀手"。它不会让你的训练 crash,却会让你的模型在真正重要的类别上表现极差,而整体指标却显得还不错。解决它需要从数据、增强、损失函数三个层面同时入手——采样策略负责"量"的均衡,增强策略提高"质"的多样性,损失权重则从根本上纠正梯度方向的偏差。没有一种银弹解法,需要根据 IR 的大小、最少类的样本规模、任务的关键指标(是 Precision 优先还是 Recall 优先)来综合决策。
希望本节的内容能帮你在下一个不均衡数据集上少走些弯路。遇到困难不要放弃,类别不均衡问题是可以被系统化地解决的,你只需要一步一步来。
📌 附录
相关参考资料
- YOLOv10 官方论文:YOLOv10: Real-Time End-to-End Object Detection,Wang et al., 2024,arXiv: 2405.14458
- YOLOv10 核心机制:Consistent Dual Assignments(一致性双重标签分配)
- YOLOv10 端到端检测机制:One-to-Many + One-to-One Dual Assignments
- YOLOv10 高效模型设计:Holistic Efficiency-Accuracy Driven Model Design
- YOLOv10 NMS-Free 推理:End-to-End Object Detection without NMS
- DFL 相关:Generalized Focal Loss: Learning Qualified and Distributed Bounding Boxes for Dense Object Detection
- COCO 数据集基准:https://cocodataset.org
- YOLOv10 官方仓库:https://github.com/THU-MIG/yolov10
- PyTorch 官方安装指南:https://pytorch.org/get-started/locally/
- NVIDIA CUDA Toolkit 归档:https://developer.nvidia.com/cuda-toolkit-archive
- Miniconda 下载:https://docs.conda.io/en/latest/miniconda.html
- 本节所有脚本代码:见文章各代码块,可直接复制使用
COCO:
| YOLOv10-N | 640 | 38.5% | 2.3M | 6.7G | 1.84 ms |
| YOLOv10-S | 640 | 46.3% | 7.2M | 21.6G | 2.49 ms |
| YOLOv10-M | 640 | 51.1% | 15.4M | 59.1G | 4.74 ms |
| YOLOv10-B | 640 | 52.5% | 19.1M | 92.0G | 5.74 ms |
| YOLOv10-L | 640 | 53.2% | 24.4M | 120.3G | 7.28 ms |
| YOLOv10-X | 640 | 54.4% | 29.5M | 160.4G | 10.70 ms |
希望本文围绕 YOLOv10 的实战讲解,能够在以下几个维度上切实帮助到你:
- 🎯 模型精度提升:结合 YOLOv10 的一致性双重标签分配、端到端检测机制与整体效率-精度设计思想,从网络结构、特征融合、检测头、标签分配、损失函数和数据增强等方向展开优化,通过工程实验进一步提升目标检测精度;
- 🚀 推理速度优化:结合 YOLOv10 的 NMS-Free 推理机制,以及模型轻量化、结构重参数化、剪枝、量化、知识蒸馏与部署加速策略,帮助模型在真实业务场景中运行得更快、更稳定;
- 🧩 工程落地实践:覆盖数据准备、环境配置、模型训练、效果评估、问题排查、模型导出与部署推理等完整链路,提供可直接复用或稍加修改即可迁移的工程级方案;
- 🧠 核心机制理解:深入分析 YOLOv10 中 One-to-Many 与 One-to-One 双标签分配机制、一致性匹配度量、端到端检测以及高效网络设计 的设计逻辑,帮助你理解模型性能提升背后的原因,而不是停留在简单调用层面;
- 🔬 改进方案验证:通过消融实验、指标对比与可视化分析,评估不同改进模块对 Precision、Recall、mAP、FPS、Latency、参数量和 FLOPs 的实际影响。
PS:如果你按照文中步骤对 YOLOv10 进行优化后仍然遇到问题,请不必焦虑或灰心。
YOLOv10 是一个涉及网络结构、特征提取、标签分配、梯度优化、端到端预测与部署环境的复杂目标检测框架,最终表现会受到 硬件环境、数据集质量、任务定义、类别分布、训练配置、代码版本与部署平台 等多重因素的共同影响。
这是目标检测项目中十分常见的客观现象,并不意味着某个改进模块一定无效。
如果你在实践过程中遇到以下问题:
- 🐛 模块替换后出现新的报错或 Bug;
- 📉 Precision、Recall 或 mAP 难以继续提升;
- 📈 训练损失异常、梯度不稳定或模型难以收敛;
- 🎯 One-to-One / One-to-Many 分支训练效果异常;
- ⏱️ 推理速度、Latency、显存占用或部署性能不达预期;
- 🔄 修改网络结构后出现维度、通道数或特征层不匹配;
- ⚙️ 修改检测头后端到端预测分支出现兼容性问题;
- 📦 模型导出 ONNX、TensorRT、OpenVINO 等格式时失败;
欢迎将 完整报错信息 + 环境版本 + 关键配置截图 + 网络配置文件 + 核心代码片段 粘贴至评论区,我们可以一起分析问题根因,并探讨更加可行的解决方案。
如果你已经摸索出更优的训练参数、网络结构、标签分配策略、模块组合或部署优化思路,也非常欢迎在评论区分享。
你的每一条实战经验,都可能成为其他开发者解决问题、减少试错成本的关键线索。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对 YOLOv10 的主流改进方案进行重构与再设计,使内容更加贴近工业检测、智慧交通、游戏分析、行为识别、遥感影像、无人机视觉与边缘设备部署等真实应用场景。
## 🧧🧧 文末福利,等你来拿!🧧🧧
📌 文中所涉及的技术内容,大多来源于本人在 YOLOv10 项目中的一线实践积累,部分案例参考了开源项目、公开论文、技术社区资料与读者反馈。
如有版权相关问题,欢迎第一时间联系,我将尽快核实并进行修改或下线处理。
部分问题分析思路与排查路径参考了技术社区及 AI 问答平台,在此一并致谢 🙏
最后想说的是:
YOLOv10 的优化本质上是一个高度依赖任务、数据和部署环境的系统工程问题,不存在“一招通杀”的银弹方案。
一致性双重标签分配、One-to-Many / One-to-One 检测策略、注意力机制、轻量化卷积、改进检测头、IoU 损失函数、特征融合模块和数据增强策略,都有其适用条件。
某个模块在公开数据集上取得提升,并不意味着它能够在所有自定义数据集、硬件平台和业务场景中获得同样收益。
尤其对于 YOLOv10 而言,在进行结构改进时还需要额外关注 端到端检测分支、标签分配一致性以及 NMS-Free 推理链路。某些直接从 YOLOv8、YOLOv9、YOLOv11 等模型迁移过来的模块,如果没有处理好检测头与训练分支之间的适配关系,也可能出现精度下降、训练不稳定或推理逻辑异常等问题。
真正有效的优化路径,永远源于:
- 对业务目标与评价指标的准确理解;
- 对数据质量和类别分布的持续分析;
- 对模型瓶颈的定位与针对性改进;
- 对 One-to-Many 与 One-to-One 分支机制的正确理解;
- 对实验变量的严格控制;
- 对精度、速度、Latency、参数量和部署成本的综合权衡;
- 以及一轮又一轮可复现的对比实验。
如果你已经在自己的项目中探索出了更加高效、稳定的 YOLOv10 优化路径,非常鼓励你:
- 💬 在评论区简要分享核心思路与实验结论;
- 📊 分享不同模块的消融实验结果;
- 📝 将完整过程整理成教程、博客或系列文章;
- 🔧 提交可复现的配置文件、代码或工程实践经验。
你的经验,或许正是别人卡关已久所缺少的最后一块拼图。
✅ 本期关于 YOLOv10 优化与实战应用 的内容就先聊到这里。
如果你想进一步深入:
- 🔍 系统理解 Consistent Dual Assignments 与 YOLOv10 的整体网络结构;
- 🎯 深入理解 One-to-Many 与 One-to-One 双标签分配机制;
- 🚀 掌握 YOLOv10 无 NMS 端到端目标检测的实现原理;
- 🧱 学习主干网络、颈部网络、检测头与特征融合模块的改进方法;
- 📉 掌握损失函数、匹配度量、样本分配与训练策略的优化技巧;
- ⚡ 对比不同场景下的模型轻量化与部署加速方案;
- 🧪 建立规范的消融实验、指标对比与模型评估流程;
- 🧠 系统构建一套属于自己的 YOLOv10 调优方法论;
欢迎继续关注专栏:《YOLOv10实战:从入门到深度优化》
期待这些内容能够在你的项目中真正落地见效,帮助你 少踩坑、多提效、快验证、稳部署,我们下期见。
✨ 当然,如果 YOLOv10 专栏已经无法满足你,也可以继续关注:
-
《YOLOv9实战:从入门到深度优化》
-
《YOLOv11实战:从入门到深度优化》
-
《YOLOv12实战:从入门到深度优化》
更多新版本、新模块与新论文的工程复现内容,也会持续更新。
✍️ 码字不易,如果这篇文章对你有所启发或帮助,欢迎给我来个 一键三连:关注 + 点赞 + 收藏。
你的支持,是我持续输出高质量 YOLOv10 技术内容与工程实战案例最直接的动力来源。
同时诚挚推荐关注我的技术号: 「猿圈奇妙屋」
在这里,你可以:
- 📡 第一时间获取 YOLOv10、目标检测、多目标追踪与多任务学习等方向的进阶内容;
- 🛠️ 获取视觉算法、深度学习与模型部署的最新优化方案和工程实战经验;
- 📚 学习 PyTorch、OpenCV、ONNX、TensorRT 等相关技术;
- 🎁 获取 BAT 大厂面经、技术书籍 PDF、工程模板与常用工具清单等实用资源。
期待在更多维度上与你一起进步、共同成长。
👨💻 About Me · 关于作者
我是专注于 计算机视觉、图像识别、目标检测与深度学习工程落地 的讲师和技术博主,笔名 bug菌:
- 活跃于 CSDN|稀土掘金|InfoQ|51CTO|华为云开发者社区|阿里云开发者社区|腾讯云开发者社区|开源中国|博客园|墨天轮 等多个技术社区;
- CSDN 博客之星 Top 30、华为云多年度十佳博主及卓越贡献奖获得者、掘金多年度人气作者 Top 40;
- CSDN、掘金、InfoQ、51CTO 等平台签约作者及优质创作者;
- 全网粉丝累计 30w+。
更多高质量技术内容与成长资料,可查看合集入口:
👉 点击查看 👈️
硬核技术号 「猿圈奇妙屋」 期待你的加入,一起进阶、一起打怪升级。
– End –