网页里的信息很多,但表格是最特殊的一种——它天生就是结构化数据,一行一行、一列一列排好了,抓下来直接就能用,存成 CSV 打开就是整齐的表格。
今天教两种方法:
- 方法一:BeautifulSoup 手动解析——灵活,什么表格都能搞定
- 方法二:pandas.read_html 一键提取——懒人福音,一行代码
先看 HTML 表格长什么样
一个标准表格的结构:
<table>
<thead>
<tr>
<th>排名</th><th>电影名称</th><th>评分</th><th>年份</th>
</tr>
</thead>
<tbody>
<tr><td>1</td><td>肖申克的救赎</td><td>9.7</td><td>1994</td></tr>
<tr><td>2</td><td>霸王别姬</td><td>9.6</td><td>1993</td></tr>
</tbody>
</table>
关键标签记一下:
| <table> | 整个表格 |
| <thead> | 表头部分 |
| <tbody> | 表体,真正的数据在这 |
| <tr> | 一行 |
| <th> | 表头单元格 |
| <td> | 普通数据单元格 |
抓表格的思路就一句话:先找到 table,一行一行读,每行再一格一格读。
方法一:BeautifulSoup 手动解析
基本思路
核心代码
from bs4 import BeautifulSoup
import pandas as pd
# 假设 html 是 requests.get(url).text 拿到的网页源码
soup = BeautifulSoup(html, 'lxml')
table = soup.find('table', class_='movie-rank') # 找到目标表格
# 第一步:提取表头
headers = []
thead = table.find('thead')
if thead:
header_row = thead.find('tr')
headers = [th.get_text(strip=True) for th in header_row.find_all('th')]
else:
# 没有 thead 就取第一行当表头
first_row = table.find('tr')
headers = [c.get_text(strip=True) for c in first_row.find_all(['th', 'td'])]
# 第二步:提取数据行
tbody = table.find('tbody')
rows = tbody.find_all('tr') if tbody else table.find_all('tr')[1:]
data = [[c.get_text(strip=True) for c in row.find_all('td')] for row in rows]
# 第三步:转成 DataFrame 并保存
df = pd.DataFrame(data, columns=headers)
print(df)
df.to_csv('movie_rank.csv', index=False, encoding='utf-8-sig')
两个小细节:
- get_text(strip=True) 自动去掉文字首尾的空格换行,表格数据干净很多
- 没有 <thead> 的表格,把第一行当表头兜底,不崩
方法二:pandas.read_html 一键提取
如果你能少写一行就绝不多写,这个方法你会爱上——一行代码,把页面所有表格全提取出来。
import pandas as pd
# 就一行:直接从 URL 提取所有表格,返回 DataFrame 列表
tables = pd.read_html('目标网页地址')
print(f"页面上找到 {len(tables)} 个表格")
df = tables[0] # 取第一个表格
print(df.head())
不用 BeautifulSoup,不用遍历 tr/td,pandas 全包了。
注意事项(坑)
1. 返回的是列表,不是单个 DataFrame。页面上可能有好几个表格,打印每个的行数列数来判断哪个是你要的。
2. 需要装 lxml:
pip install lxml
3. 只能抓静态表格。JS 动态加载的表格,read_html 抓不到(后面会讲怎么处理动态网页)。
4. 表头识别可能不准,手动指定:
tables = pd.read_html(url, header=None)
df = tables[0]
df.columns = ['排名', '名称', '评分', '年份']
两种方法怎么选?
| 表格规整、简单 | pandas.read_html | 快,几行代码 |
| 只要文字数据 | pandas.read_html | 省事 |
| 有合并单元格 | BeautifulSoup 手动 | pandas 处理不了复杂结构 |
| 要提取链接、图片 | BeautifulSoup 手动 | read_html 只能拿文字 |
| 需要特殊清洗逻辑 | BeautifulSoup 手动 | 灵活可控 |
一句话:简单表格直接 pandas,复杂表格上 BeautifulSoup。
进阶技巧:表格里带链接一起抓
read_html 只能拿到文字,拿不到链接。需要连网址一起抓下来(比如后续要爬详情页),用 BeautifulSoup:
for row in rows:
cells = row.find_all('td')
link_tag = cells[1].find('a') # 第二列是链接
movie_name = link_tag.get_text(strip=True) if link_tag else cells[1].get_text(strip=True)
movie_url = link_tag.get('href') if link_tag else ''
data.append([cells[0].get_text(strip=True), movie_name, movie_url, cells[2].get_text(strip=True)])
真实运行效果
两种方法在配套资源包里跑一遍:
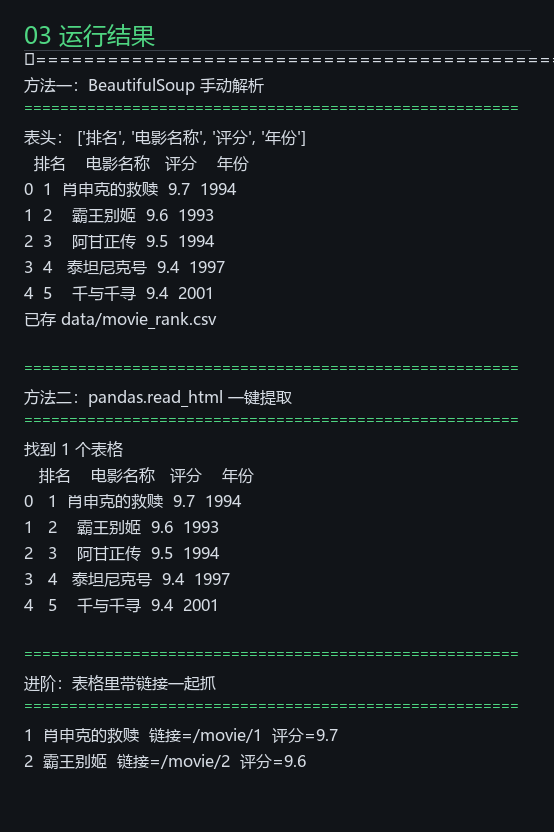
方法一 BeautifulSoup 手动解析:表头、5 行数据全部提取,转成 DataFrame 并存入 CSV;方法二 read_html 同样一行拿到整个表格;进阶的带链接提取也正常。三种玩法全跑通。
今天学了什么
完整可跑工程版(模拟电影排行榜实战 + read_html + 带链接进阶提取)在配套资源包里。
下一篇讲数据批量保存:怎么存成 CSV,怎么翻页一次抓好几页。
梅雅达编程工作室 · Python数据实战系列第3篇 简单表格直接 pandas,复杂表格上 BeautifulSoup——记住这一句,九成场景都不会慌。