文章目录
- 1. 架构之痛:为什么必须从云端 Web 彻底转向本地优先桌面端
-
- 1.1. 云端集中式爬取的致命瓶颈:240GB 流量击穿与内存 OOM 危机
- 1.2. 本地优先(Local-First)架构跃迁:100% 算力自治与真实网络 IP
- 1.3. 动态薄壳微内核:零打包(Zero-Installer)秒级热更新
- 2. 核心功能拆解:打造博主专属“数字分身”与离线知识库
-
- 2.1. 跨平台支持矩阵:9 大主流平台全量覆盖与微信 4.x 应对
- 2.2. 导出链接模式:直接赋能大模型与本地 AI Agent
- 2.3. 多格式导出与单篇/合集解耦机制
- 3. 硬核工程实录:高并发长链路下的防爆内存与去噪管道
-
- 3.1. 故障现场:千篇长文导出引发 14.5GB 图片膨胀血泪史
- 3.2. 三档自适应配图引擎与 Pillow 动态重采样
- 3.3. 全局 LRU 内存守卫与防盗链对冲
- 4. 保姆级上手指南:从安装部署到一键极速导出
-
- 4.1. 客户端下载与绿色免安装
- 4.2. 四步极速导出实操流程
-
- 步骤一:选择目标平台与输入模式
- 步骤二:粘贴博主主页链接
- 步骤三:挑选导出文章与格式
- 步骤四:配置配图与本地保存目录
- 5. 极限性能压测:简书 6000 篇超大规模实战与离线呈现
-
- 5.1. 6000 篇超大博文极限压力测试
- 5.2. 原版 HTML 离线排版保真度实测
- 6. 总结与开源生态未来规划
前言: 传统基于云端爬虫与 Web 转换的博文导出工具,在面对单博主数千篇长文导出时,极易面临云端流量瞬间打满、内存频繁 OOM 崩溃与平台 WAF 封控的致命瓶颈。针对上述工程痛点,开源项目 BlogDistiller(博萃)全面重构为「本地优先(Local-First)」自治桌面客户端,将网络抓取、DOM 清洗与文档多格式合成 100% 下放至用户本机,配合动态薄壳实现免安装包更新的秒级热更新。 本文将深入拆解其架构演进脉络、底层避坑实录与完整实战指南。 个人主页:艺杯羹 项目 GitHub:博萃 – 文章导出 在线网站:博萃 – 文章导出
1. 架构之痛:为什么必须从云端 Web 彻底转向本地优先桌面端
在知识管理与 AI 大模型快速普及的今天,许多开发者与知识工作者都希望将优质博主的原创内容批量下载并进行本地知识库沉淀,甚至作为本地私有大模型构建“数字分身”的高质量语料。
在项目初期的 1.0 版本中,笔者采用了纯 Web 网站结合云端集中式解析的架构方案,用户只需在网页输入目标博主链接即可在线生成并下载压缩包。
1.1. 云端集中式爬取的致命瓶颈:240GB 流量击穿与内存 OOM 危机
然而,随着用户导出任务规模从几十篇技术随笔扩展到单个博主两三千篇历史专栏,云端中心化架构迅速暴露了难以调和的工程缺陷。
云端架构的核心瓶颈在于计算与网络资源的过度集中。当多个用户同时发起长文导出时,服务器必须在内存中同时拉取上万张外链图片并进行并发渲染转换。在一次典型的万篇长文压测中,仅图片下载与暂存就瞬时吞噬了服务器 240GB 的出口带宽流量,磁盘空间被瞬间压缩至不足 8GB,后端 Python 进程频繁触发操作系统的内存保护机制。
[CRITICAL] 2026-08-22 14:32:08 [Worker-Process: 18422] Memory allocation failed!
Traceback (most recent call last):
File "/app/backend/app/exporters/pdf_exporter.py", line 186, in export_batch
raw_pdf_bytes = await render_html_to_pdf(large_html_buffer)
File "/app/backend/app/services/pdf_renderer.py", line 92, in render_html_to_pdf
return await page.pdf(format="A4", print_background=True)
MemoryError: Unable to allocate 1.84 GiB for an array with shape (1840, 2400, 4) and data type uint8
[SYSTEM ALERT] kernel: [48291.294102] oom-kill:constraint=CONSTRAINT_NONE,nodemask=(null),cpuset=/,mems_allowed=0,task=python3,pid=18422,uid=1000
[SYSTEM ALERT] kernel: [48291.294150] Out of memory: Killed process 18422 (python3) total-vm:8124920kB, anon-rss:7432104kB, file-rss:0kB
除了算力与内存瓶颈,云端服务器更致命的问题在于 机房 IP 与平台 WAF 策略的天然对抗。主流商业技术社区(如 51CTO、知乎、微信等)均部署了严密的云安全防护系统。数据中心机房 IP 只要稍有高频分页请求,便会立刻遭遇严厉的动态 JavaScript PoW 算力质询(如 567 拦截或 403 Forbidden),导致云端爬取经常半途雪崩。
1.2. 本地优先(Local-First)架构跃迁:100% 算力自治与真实网络 IP
为了打破这一死局,团队做出了彻底重构的决定:全面放弃云端中转,转向本地优先(Local-First)自治桌面客户端。
本地优先的核心哲学非常纯粹:将高并发网络 I/O、DOM 去噪清洗、二进制图片压缩与多格式文档生成 100% 迁移至用户本地电脑执行。
| 算力与内存承载 | 云端单点承载,极易遭遇 OOM 强杀 | 依赖浏览器单线程,大长文容易卡死 | 100% 本地运算,自由调度本地 CPU/内存 |
| 网络 IP 与风控 | 集中式机房 IP,极易被 WAF 批量封锁 | 需手动安装插件并频繁抓包获取 Token | 完全走用户本地真实宽带 IP,零风控隐患 |
| 长文导出极限 | 超过 300 篇容易超时中断 | 超过 500 篇页面崩溃 | 实测抗住 6000+ 篇超大博文批量并发归档 |
| 隐私与数据安全 | 抓取内容流经第三方服务器 | 数据留存在浏览器内存 | 数据直接写入用户本地磁盘,零数据泄露 |
| 更新维护成本 | 需频繁维护云端代理池与高额服务器 | 插件审核周期长达数周 | 动态薄壳架构,免安装包更新秒级热更新 |
重构之后,每一位用户都使用自己真实的家庭或办公网络出口,彻底消除了中心化 IP 被风控的隐患;由于算力分布在各用户的个人电脑中,导出万篇长文不再耗费服务器一分钱带宽与内存,实现了真正的无上限吞吐。
1.3. 动态薄壳微内核:零打包(Zero-Installer)秒级热更新
传统桌面客户端最令开发者与用户头疼的问题就是“分发与安装包体积膨胀”。若每次对页面按钮样式做微调、或针对某个平台调整了解析规则,都要重新打包出 150MB 的安装包并上传至 GitHub Releases,用户也需要重新下载、关进程、覆盖安装。
BlogDistiller 采用了**「动态薄壳 + 本地守护进程」**混编设计:
- 原生表现层:Electron 仅仅作为一个安全受控的轻量薄壳(Thin-Shell),动态承载云端受控的前端工作台界面。
- 本地服务层:本地自动启动一个超轻量的 Python FastAPI 微服务进程,负责所有的底层数据爬取、DOM 解析与文档流生成。
- 免安装热更新:当平台抓取规则迭代或界面增加新功能时,用户完全不需要重新前往 GitHub 下载安装包,只需在桌面客户端内轻轻按下 F5 刷新按键,即可秒级完成零打包静默升级。
2. 核心功能拆解:打造博主专属“数字分身”与离线知识库
BlogDistiller 围绕“深度去噪、高清固化、多端适配”三大原则,打造了一整套工业级的内容提取与知识沉淀流水线。
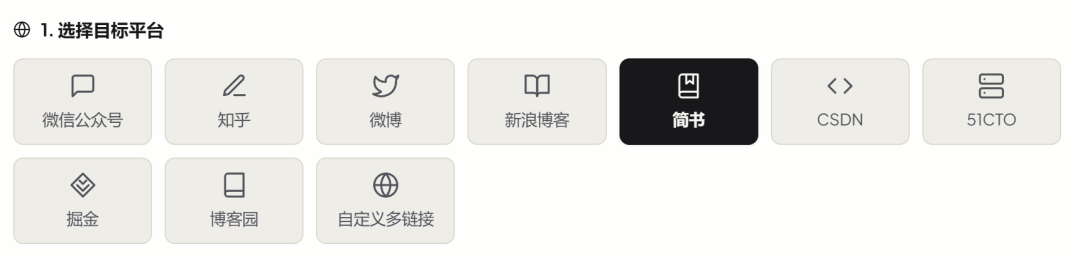
2.1. 跨平台支持矩阵:9 大主流平台全量覆盖与微信 4.x 应对
目前客户端已全面支持国内外 9 大主流自媒体与技术社区平台:
2.2. 导出链接模式:直接赋能大模型与本地 AI Agent
除了将博文合成为排版精美的文档,很多从事大模型开发、知识库构建的工程师往往只需要博主的全部文章清单与原始 URL,以便传入自己的自动化爬虫或 LangChain / Dify 等 AI 工作流中。
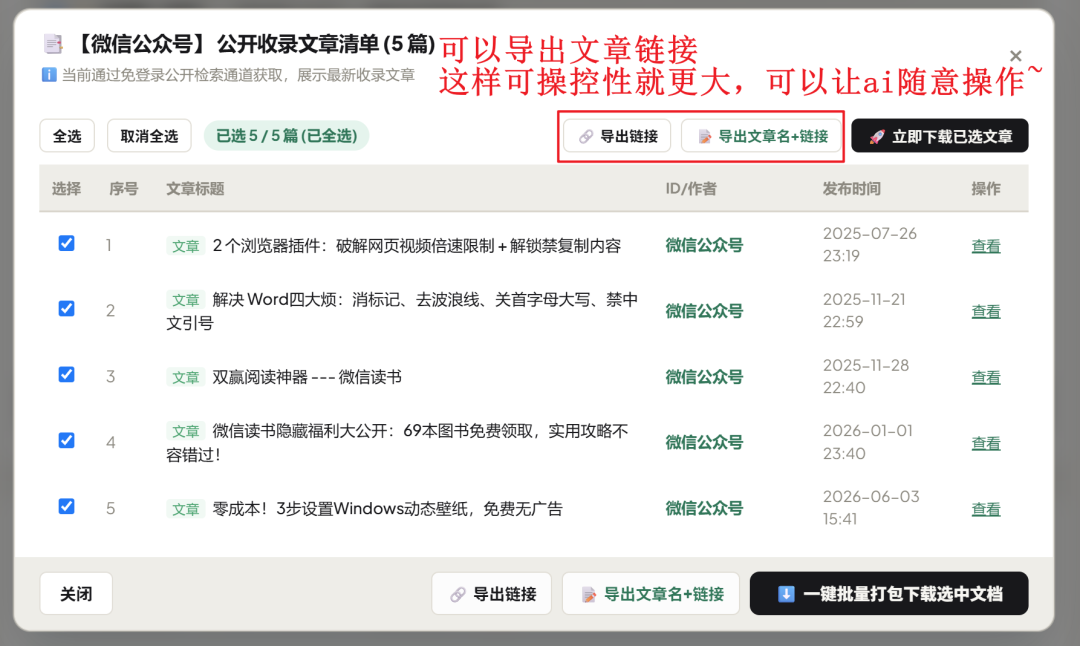
通过客户端的“仅导出链接”模式,可以秒级将目标博主的数千篇公开文章标题与对应 URL 整理为极简的文本清单,直接投喂给大模型进行语义聚类、知识图谱构建与博主写作风格建模。
2.3. 多格式导出与单篇/合集解耦机制
客户端支持同时导出 5 种行业标准格式,覆盖从阅读、离线归档到办公打印的全场景诉求:
- Markdown 格式:深度清洗原生 HTML 标签,保留标准语法块与高亮代码,专为 Obsidian、Notion、Logseq 等个人知识库量身打造;
- HTML 格式:完整内嵌目标平台的排版样式与视觉主题,离线双击即可用浏览器还原原汁原味的排版效果;
- PDF 格式:出版级排版引擎分页渲染,适配 A4 打印与平板阅读;
- Word (.docx) 格式:基于 OpenXML AST 结构化降维重构,文字排版整洁,方便二度编辑与论文引用;
- TXT 格式:纯文本极简清洗,去除所有标签与图片,体积轻巧。
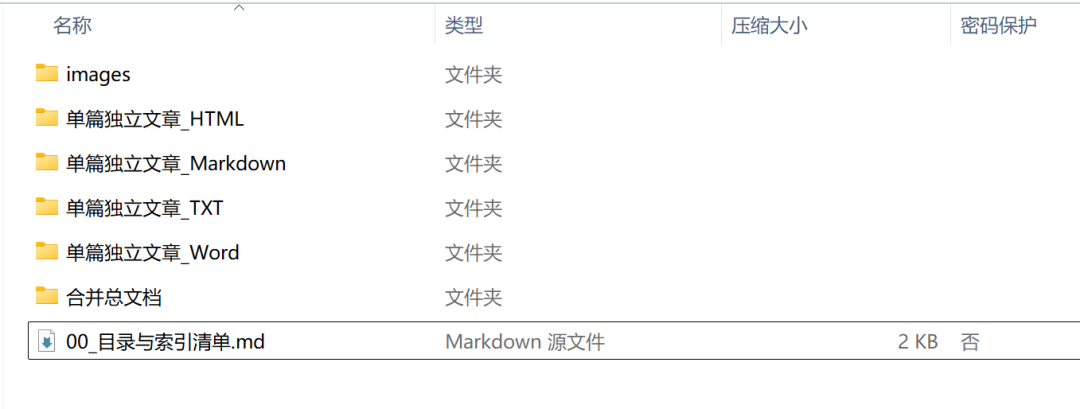
针对不同用户的阅读习惯,系统提供了**「单独分篇导出」与「合并为合集大长文」**两种灵活形态。当用户勾选单独分篇时,客户端会自动按照目录层级为每篇文章创建独立文档,井井有条。
3. 硬核工程实录:高并发长链路下的防爆内存与去噪管道
在数千篇博文的实际导出过程中,系统必然会遭遇各种极端边界条件。以下是本项目在生产实战中踩坑并沉淀的核心工程解法。
3.1. 故障现场:千篇长文导出引发 14.5GB 图片膨胀血泪史
在第一次对一个包含 1000 多篇深度长文的公众号进行批量导出测试时,一个意料之外的严重问题发生了:导出的内容目录体积竟然暴增到了惊人的 14.5GB!
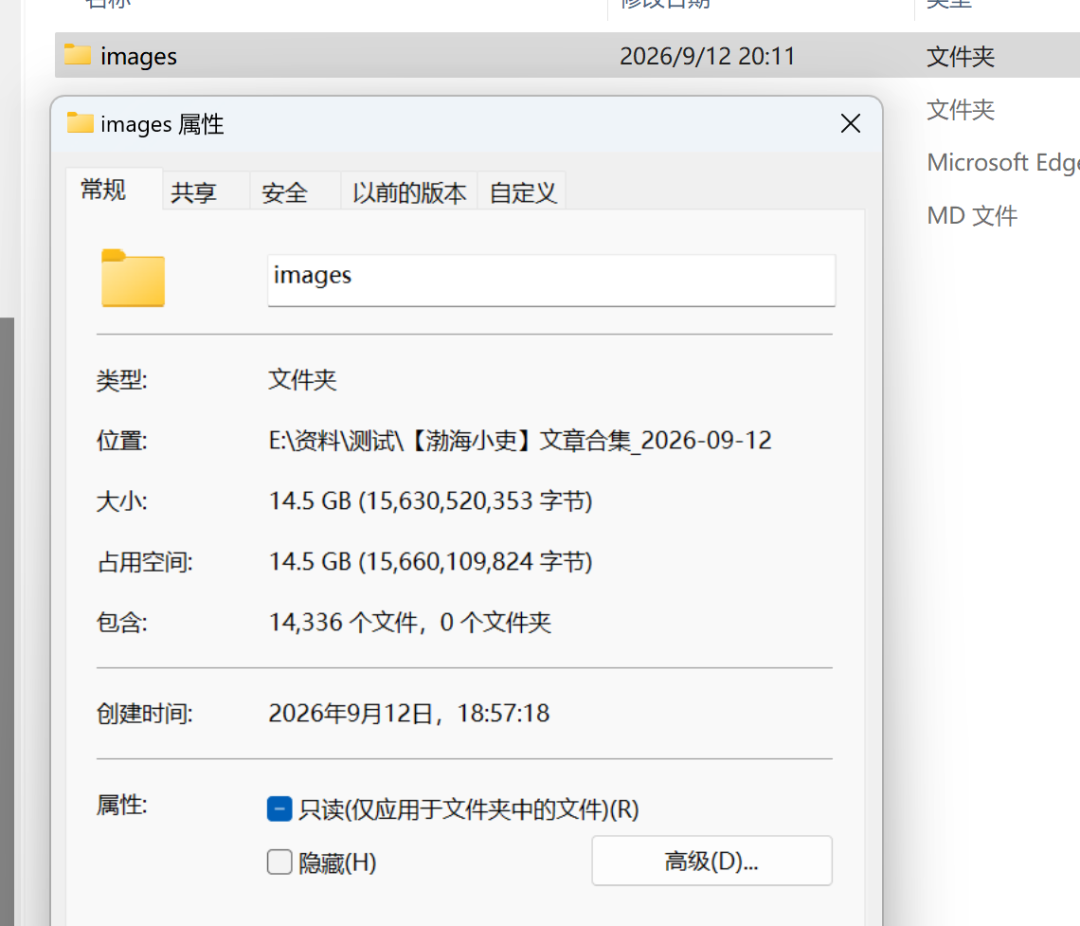
经过底层性能排查,根因浮出水面:微信与主流平台中的图片绝大多数采用了 2K 甚至 4K 的高分辨率原图,且格式多为未经重采样的 PNG 或超大 JPEG。在以往网页端少量下载时并不显眼,但在 1000 篇的规模下,图片数量高达上万张,导致磁盘瞬间被海量静态资源挤爆,内存占用也一路飙升。
3.2. 三档自适应配图引擎与 Pillow 动态重采样
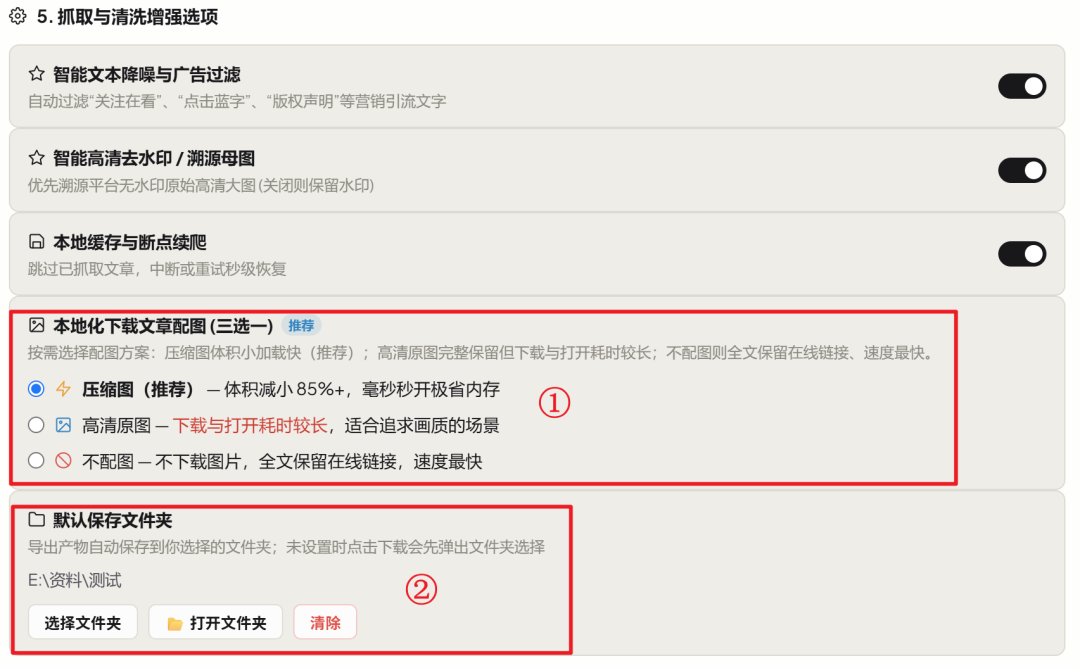
为了从根本上化解这一“磁盘与带宽吞噬兽”,研发团队在图片辅助管道(image_helper.py)中设计了**「三档自适应配图引擎」**:
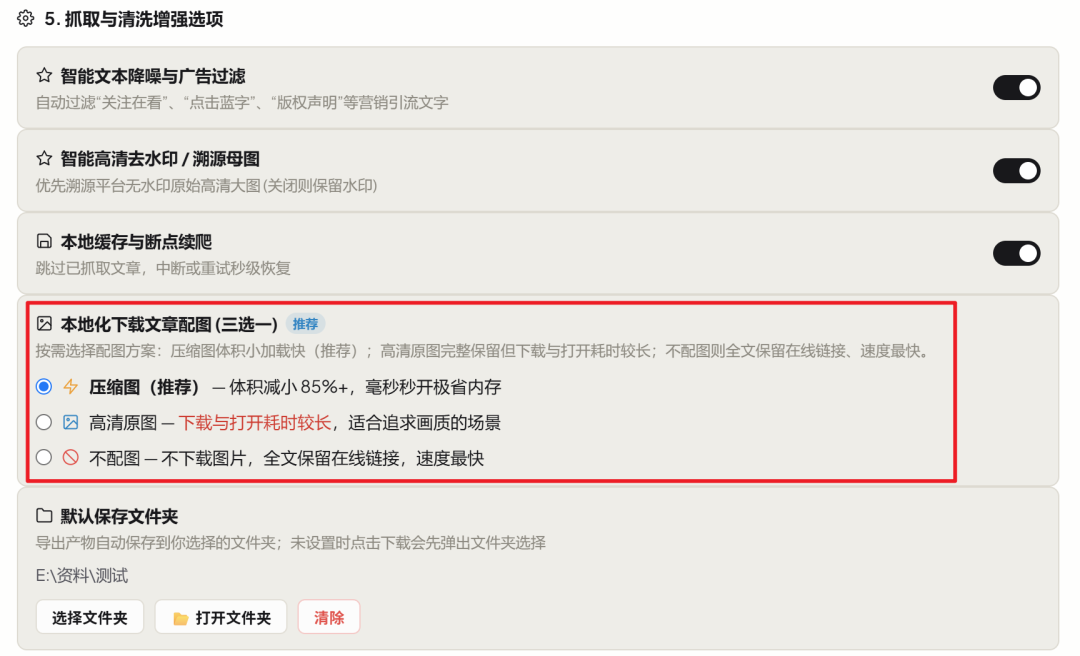
以下为本地服务中图片等比降维与压缩的核心实现代码:
def compress_image_bytes(raw_bytes: bytes, max_width: int = 1200, quality: int = 75) –> Tuple[bytes, str, str]:
"""使用 Pillow 将图片二进制流等比缩放并压缩为极致轻量的现代 WebP 或优化 JPEG。
返回: (compressed_bytes, ext, mime_type)
– 内存与体积极小:通常为每张大图减少 80%~95% 体积 (如 2MB 压至 30~50KB);
– 等比限制最大宽度至 max_width (默认 1200px),保证高清视网膜清晰度的同时杜绝巨幅大图撑爆内存;
– 动图 (GIF) 自动保留原样帧;若 Pillow 异常或压缩后未减小,自动平滑回退至原图。
"""
if not raw_bytes or len(raw_bytes) < 100:
return raw_bytes, ".png", "image/png"
try:
import io
from PIL import Image
with Image.open(io.BytesIO(raw_bytes)) as im:
# 动图 (GIF) 保持动效,不强行压缩静态帧
if getattr(im, "is_animated", False):
return raw_bytes, ".gif", "image/gif"
orig_w, orig_h = im.size
target_im = im
# 1. 超过最大宽度时采用高质量 LANCZOS 滤波等比缩小
if orig_w > max_width:
new_h = max(1, int(orig_h * (max_width / orig_w)))
target_im = target_im.resize((max_width, new_h), Image.Resampling.LANCZOS)
# 2. 导出为高能效 WebP 格式
out_bio = io.BytesIO()
if target_im.mode in ("RGBA", "LA") or (target_im.mode == "P" and "transparency" in target_im.info):
target_im.save(out_bio, format="WEBP", quality=quality, method=4)
else:
target_im = target_im.convert("RGB")
target_im.save(out_bio, format="WEBP", quality=quality, method=4)
compressed_bytes = out_bio.getvalue()
# 仅当压缩确实减小了体积时才采用
if len(compressed_bytes) < len(raw_bytes):
return compressed_bytes, ".webp", "image/webp"
return raw_bytes, ".png", "image/png"
except Exception:
# 异常情况下安全回退,确保导出主流程不中断
return raw_bytes, ".png", "image/png"
3.3. 全局 LRU 内存守卫与防盗链对冲
在连续爬取数千篇博文时,许多文章之间会重复引用相同的公共配图或头像。如果无脑全量缓存,数万张图片的 Base64 编码同样会触发内存泄漏。
为此,系统构建了基于 collections.OrderedDict 的受控 LRU 内存池,并严格限制最大常驻条目数。任务一旦执行完成,立刻显式触发内存释放:
# 严格限制内存图片缓存条目,防止数万张大图驻留引发 OOM
_MAX_IMAGE_CACHE_ENTRIES = 600
_GLOBAL_IMAGE_BASE64_CACHE: "OrderedDict[str, str]" = OrderedDict()
_GLOBAL_IMAGE_BYTES_CACHE: "OrderedDict[str, Tuple[bytes, str]]" = OrderedDict()
def _lru_put(cache: OrderedDict, key: str, value):
"""写入 LRU 缓存,超出上限时淘汰最久未使用的条目"""
if key in cache:
cache.move_to_end(key)
cache[key] = value
while len(cache) > _MAX_IMAGE_CACHE_ENTRIES:
cache.popitem(last=False)
def clear_image_caches():
"""导出任务结束后清空全局图片缓存,主动释放大对象内存"""
_GLOBAL_IMAGE_BASE64_CACHE.clear()
_GLOBAL_IMAGE_BYTES_CACHE.clear()
针对各个平台对图片防盗链的拦截,系统自动识别 URL 特征并动态注入伪装的 Referer 与安全 User-Agent,彻底杜绝了文章导出后图片出现裂痕与 403 占位符的问题。
4. 保姆级上手指南:从安装部署到一键极速导出
为了让非技术背景的普通创作者与读者也能轻松上手,BlogDistiller 提供了开箱即用的极简操作体验。
4.1. 客户端下载与绿色免安装
用户可以通过项目官网 doc.305758.xyz 或访问 GitHub Releases 页面直接下载最新的桌面版客户端压缩包:
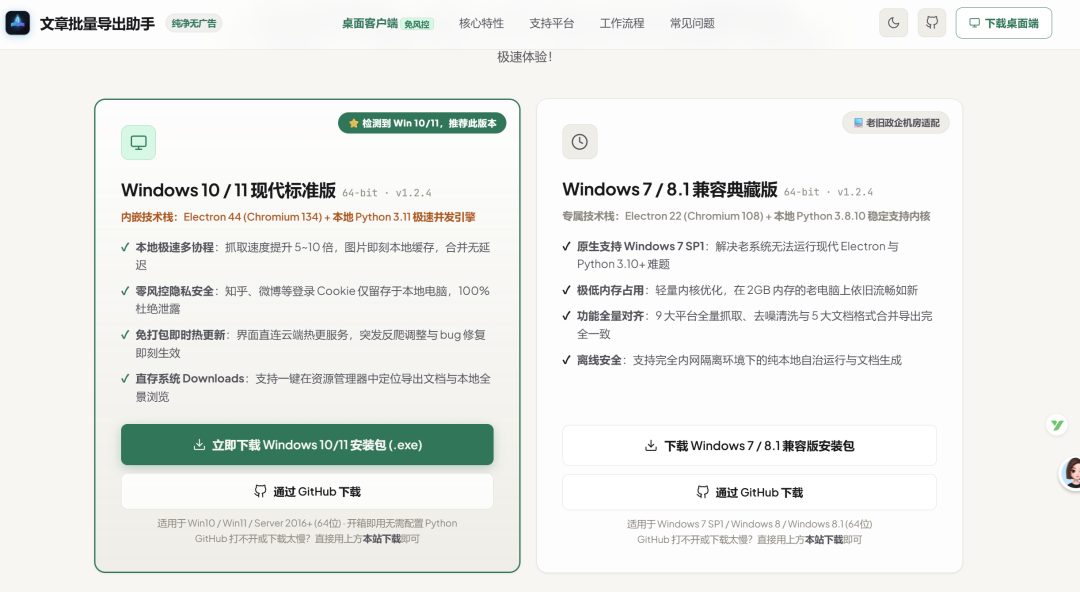
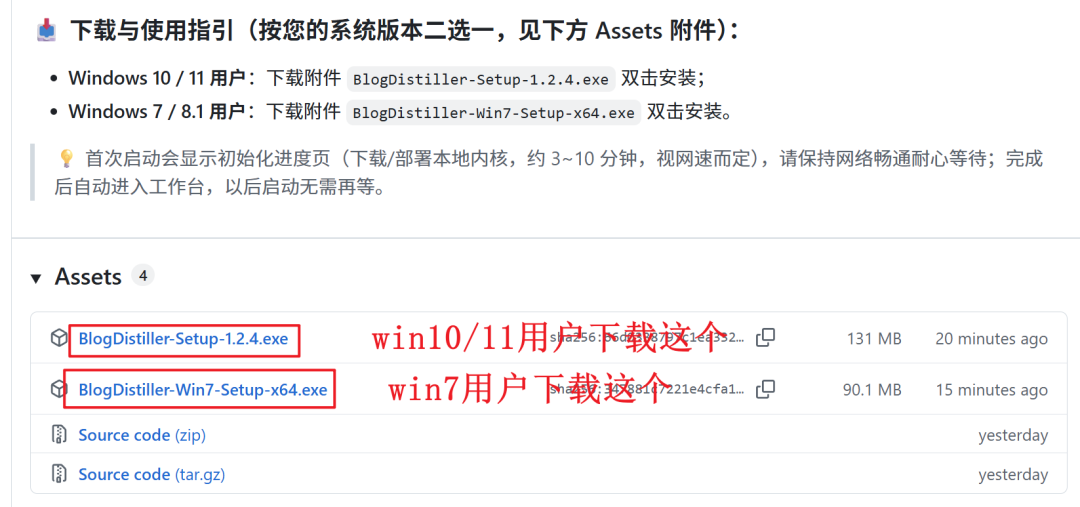
下载完毕后解压至任意目录,双击启动程序即可运行。客户端体积轻便,不会在系统深处写入冗余注册表项,纯绿色安全。
4.2. 四步极速导出实操流程
整个导出过程仅需四个清晰直观的步骤:
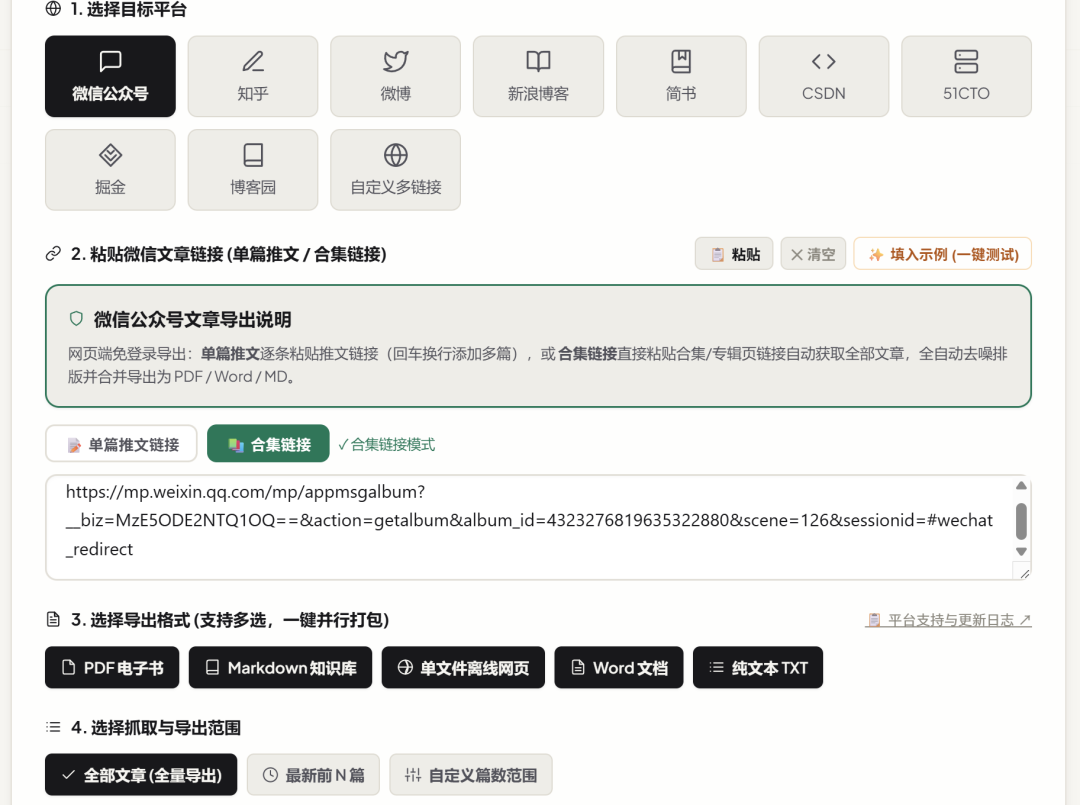
步骤一:选择目标平台与输入模式
打开客户端后,在平台选项卡中点击所需目标(如知乎、简书、CSDN 等)。如果需要批量抓取特定的单篇文章,可以在输入框内使用回车键一次性粘贴多行文章 URL:
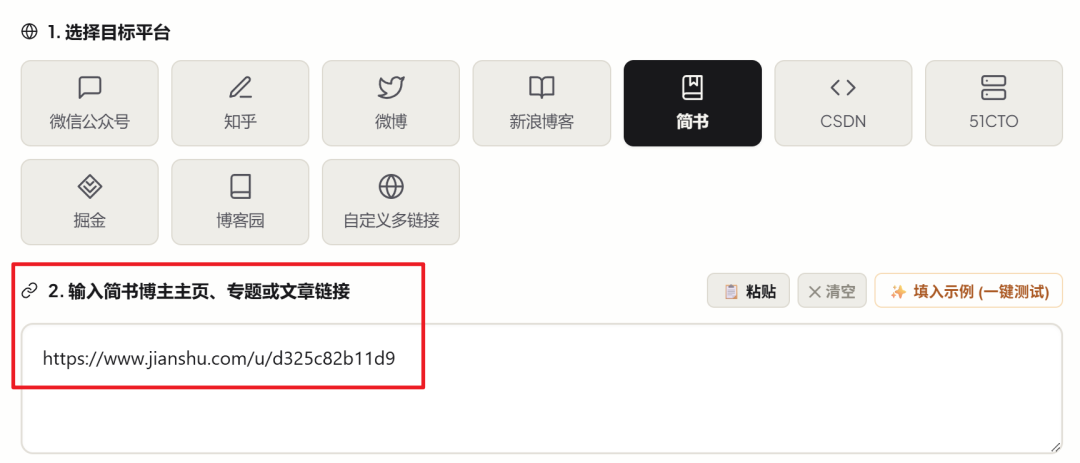
步骤二:粘贴博主主页链接
若是整号归档,直接将博主在对应平台的主页地址复制粘贴进输入框即可:
步骤三:挑选导出文章与格式
点击解析后,客户端会在数秒内列出该博主的名下所有文章。用户可以勾选“全选”,也可以在弹出的文章选择对话框中精确勾选某几篇心仪之作:
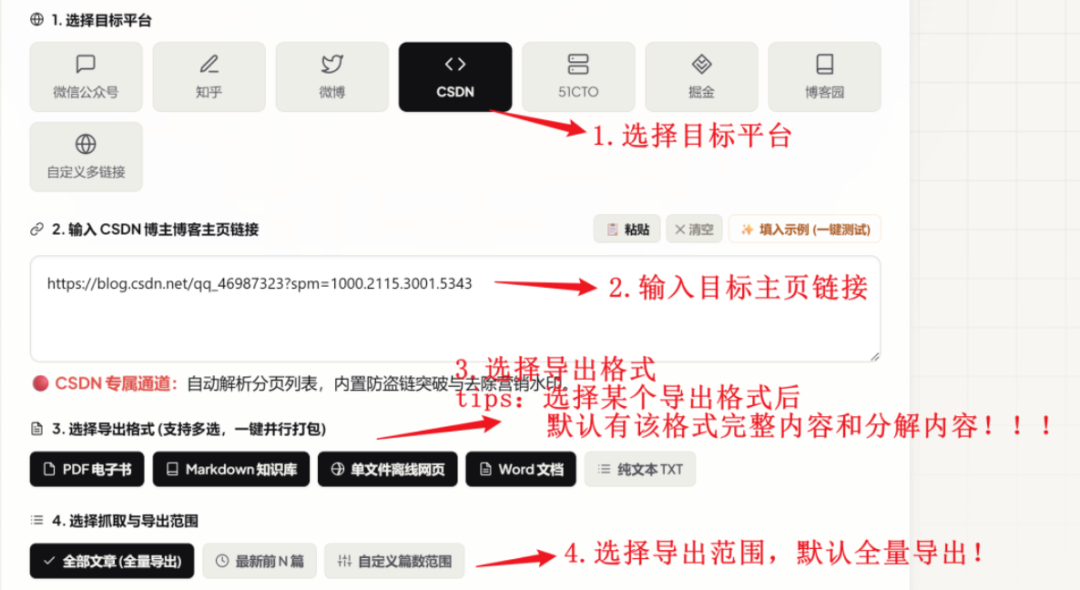
步骤四:配置配图与本地保存目录
在界面右侧选择所需的文档格式(如 Markdown + HTML),配图模式推荐保持默认的**「压缩图」,随后指定一个本地空文件夹作为导出存放位置,点击「开始导出」**:
5. 极限性能压测:简书 6000 篇超大规模实战与离线呈现
为了验证本地优先架构在极端工况下的鲁棒性,团队使用一个拥有超过 6000 篇博文 的超级博主账号进行了极限长链路压测。
5.1. 6000 篇超大博文极限压力测试
在连续长达数小时的高负荷运行中,客户端表现出了惊人的稳定性:
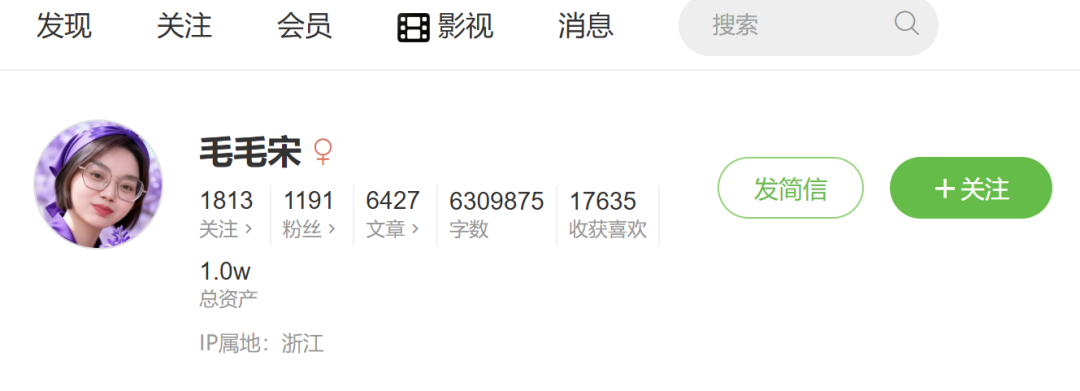

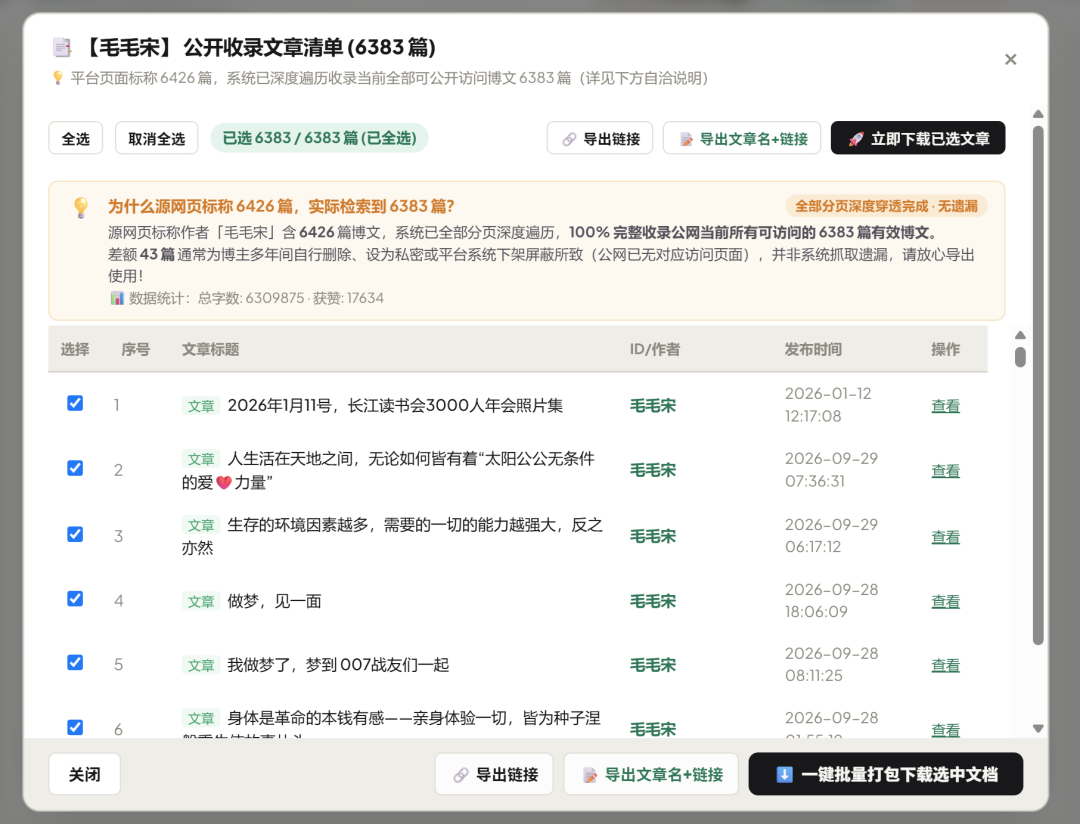
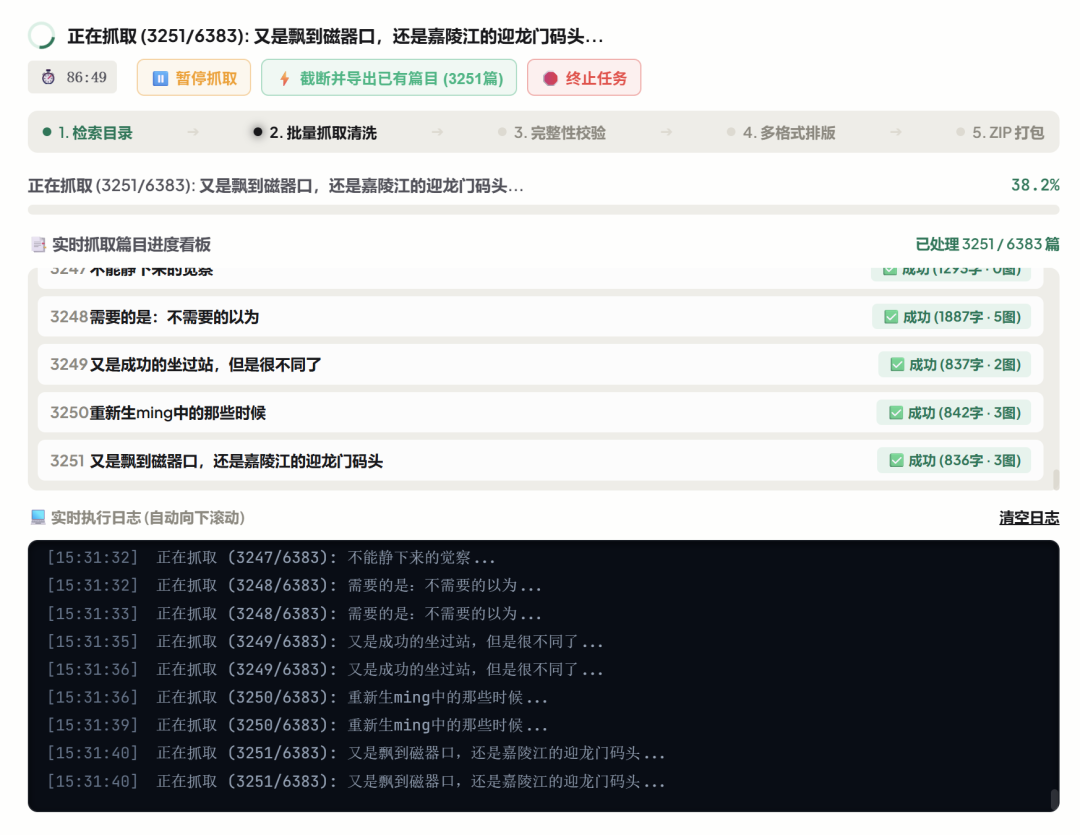
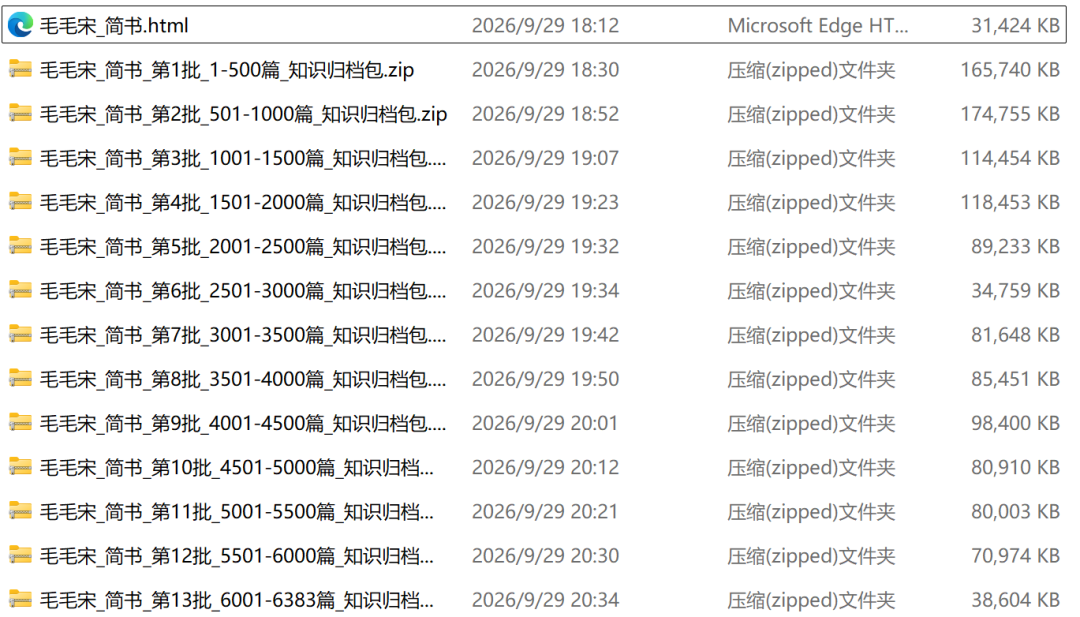
实测数据显示,导出 1000 篇完整图文仅耗时约 30 分钟。针对 6000 篇如此庞大的内容体量,系统并未将所有文本粗暴拼凑在一个巨型文件中(否则任何 Markdown 查看器或浏览器打开都会瞬间白屏崩溃),而是智能启用了分批次导出机制(每 500 篇自动分卷打包),既保障了导出过程的平稳流式推进,又让生成的文件便于日常随取随阅。
5.2. 原版 HTML 离线排版保真度实测
对于希望完美复刻文章阅读视觉体验的用户,客户端生成的 HTML 离线包展现了极高的还原度:
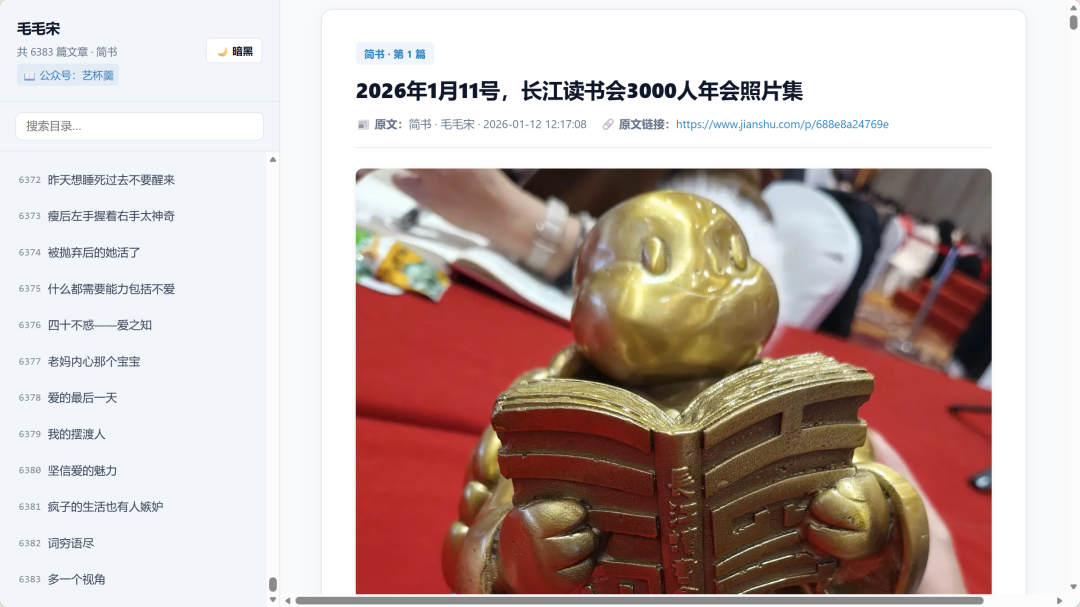
可以看到,目标博文原有的版心布局、字体间距、代码语法高亮均被精确保留,且所有图片均已完成本地二进制固化。即使断开电脑网络,依然能够如翻阅精美电子书一般顺畅离线阅读。
6. 总结与开源生态未来规划
从早期的云端 Web 架构遭遇 240GB 流量击穿与频繁 OOM,到全面重构为**「本地优先(Local-First)」**的自治桌面客户端,BlogDistiller 用扎实的工程实践证明了:对于高负载、长链路的网页抓取与富文本知识清洗,将算力与数据所有权还给本地用户,是解决资源瓶颈与平台风控的最佳路径。
未来,项目团队将持续沿着以下方向迭代演进:
本项目遵循开源协议持续免费维护,欢迎各位开发者前往 GitHub 为项目点亮一颗珍贵的 Star,也欢迎在 GitHub Issue 中提交您宝贵的优化建议与平台需求 ~