前面 Flink Time 系列讲完了 Watermark、乱序处理、AllowedLateness 等流处理核心概念。从这篇开始,我们进入 Flink SQL 系列。Flink SQL 是 Flink 最常用的 API 之一,而 TableEnvironment 是 Flink SQL 的核心入口——所有的表创建、SQL 执行、函数注册、配置管理都通过它完成。
很多同学用 Flink SQL 时,只是简单地 TableEnvironment.create(env) 然后 executeSql(sql),对 TableEnvironment 背后的原理、内部架构、核心组件、常见坑知之甚少。这篇从本质定义、两种实现、六大核心职责、四层内部架构、六大核心组件、SQL 执行七步流程、完整代码实现、常见配置、六个常见坑、八条最佳实践,把 TableEnvironment 一次性讲透。
一、TableEnvironment 本质定义
TableEnvironment 的本质一句话概括:Table API 和 SQL 的统一入口上下文,管理表的元数据、用户自定义函数、执行配置和 SQL 执行。
下面这张图把 TableEnvironment 的本质定义、六大核心职责、创建方式与 StreamExecutionEnvironment 的关系放在一起展示。
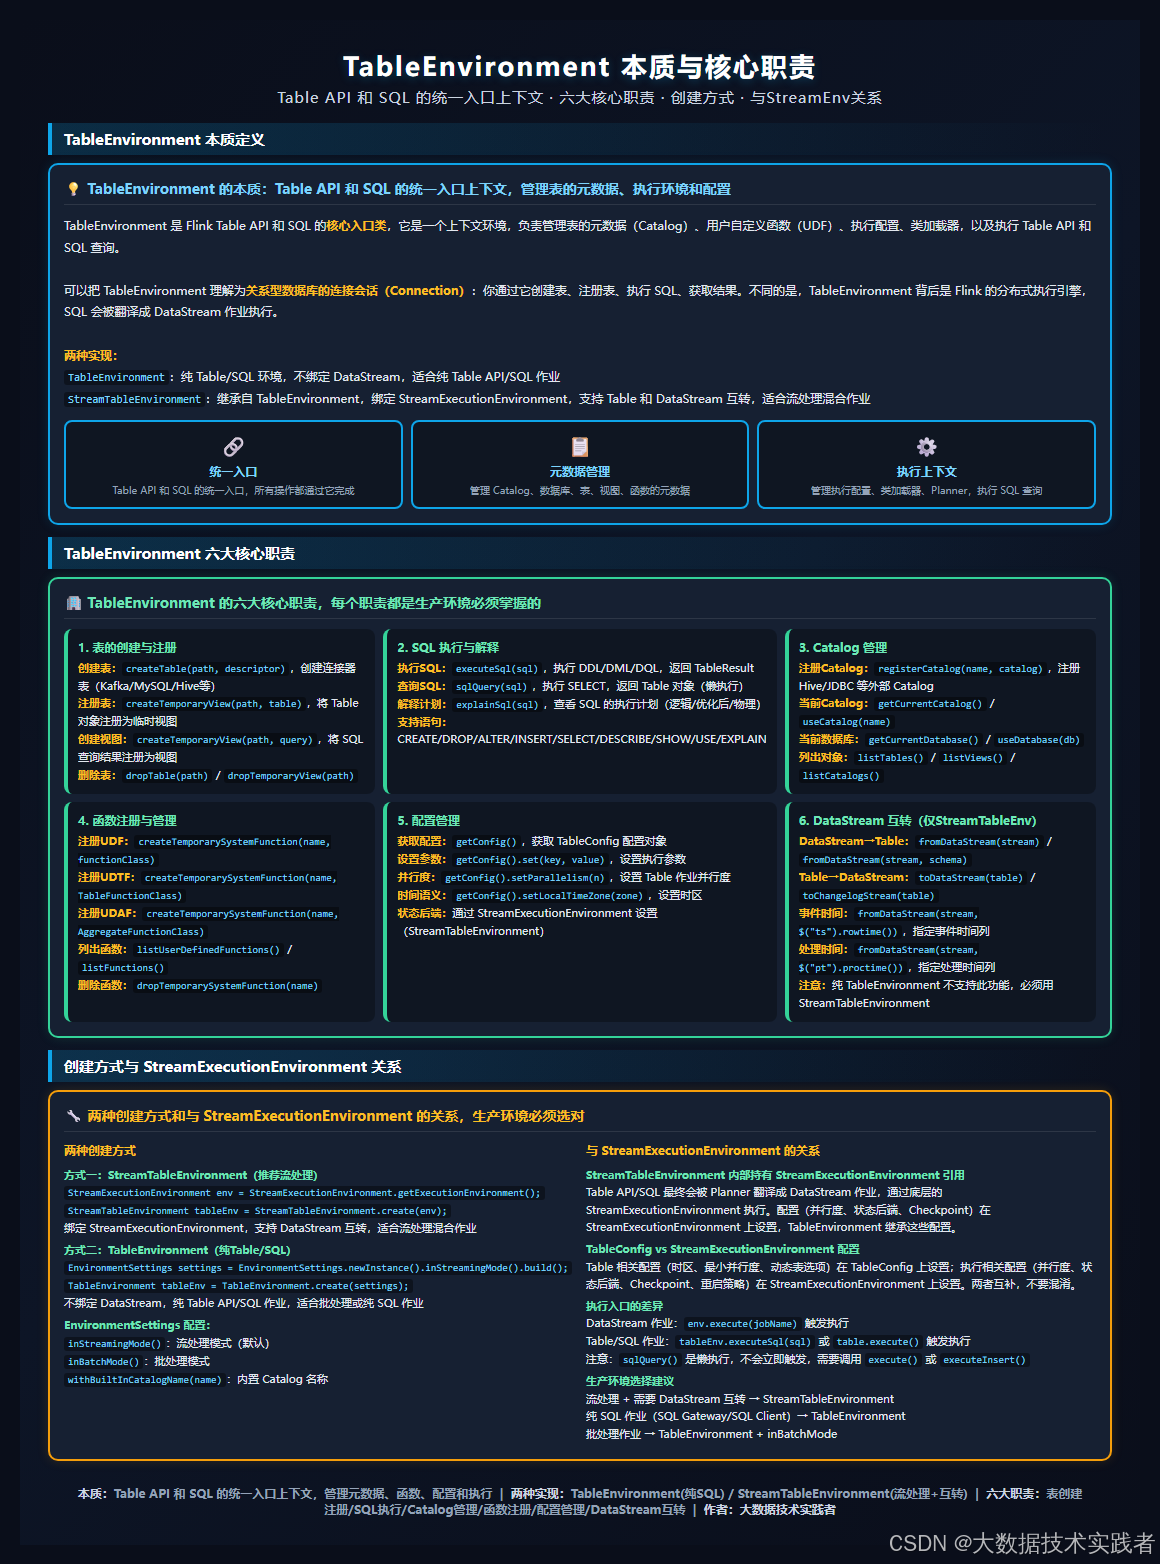
可以把 TableEnvironment 理解为关系型数据库的连接会话(Connection):你通过它创建表、注册表、执行 SQL、获取结果。不同的是,TableEnvironment 背后是 Flink 的分布式执行引擎,SQL 会被翻译成 DataStream 作业执行。
1.1 两种实现
Flink 提供了两种 TableEnvironment 实现,适用场景不同:
第一种:StreamTableEnvironment(推荐流处理使用)
继承自 TableEnvironment,内部持有 StreamExecutionEnvironment 引用,支持 Table 和 DataStream 互转。适合流处理作业,尤其是需要混合使用 Table API/SQL 和 DataStream API 的场景。
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);
第二种:TableEnvironment(纯 Table/SQL 使用)
不绑定 DataStream,纯 Table API/SQL 环境。适合批处理作业、纯 SQL 作业(SQL Gateway/SQL Client 模式)。通过 EnvironmentSettings 配置流/批模式。
EnvironmentSettings settings = EnvironmentSettings.newInstance()
.inStreamingMode() // 或 inBatchMode()
.build();
TableEnvironment tableEnv = TableEnvironment.create(settings);
生产环境选择建议:
- 流处理 + 需要 DataStream 互转 → StreamTableEnvironment
- 纯 SQL 作业(SQL Gateway/SQL Client)→ TableEnvironment
- 批处理作业 → TableEnvironment + inBatchMode
1.2 与 StreamExecutionEnvironment 的关系
StreamTableEnvironment 内部持有 StreamExecutionEnvironment 引用,Table API/SQL 最终会被 Planner 翻译成 DataStream 作业,通过底层的 StreamExecutionEnvironment 执行。
配置分工:
- Table 相关配置(时区、最小并行度、动态表选项、状态 TTL)在 TableConfig 上设置
- 执行相关配置(并行度、状态后端、Checkpoint、重启策略)在 StreamExecutionEnvironment 上设置
- 两者互补,不要混淆
执行入口差异:
- DataStream 作业:env.execute(jobName) 触发执行
- Table/SQL 作业:tableEnv.executeSql(sql) 或 table.execute() 触发执行
- 注意:sqlQuery() 是懒执行,不会立即触发,需要调用 execute() 或 executeInsert()
二、六大核心职责
TableEnvironment 的职责可以归纳为六大类,每一类都是生产环境必须掌握的:
2.1 表的创建与注册
- 创建表:createTable(path, descriptor),创建连接器表(Kafka/MySQL/Hive 等),表定义持久化到 Catalog
- 注册临时视图:createTemporaryView(path, table),将 Table 对象注册为临时视图,仅当前会话有效
- 创建视图:createTemporaryView(path, query),将 SQL 查询结果注册为视图
- 删除表:dropTable(path) / dropTemporaryView(path)
- 列出对象:listTables() / listViews() / listTemporaryTables()
2.2 SQL 执行与解释
- 执行 SQL:executeSql(sql),执行 DDL/DML/DQL,返回 TableResult(立即执行)
- 查询 SQL:sqlQuery(sql),执行 SELECT,返回 Table 对象(懒执行,需要后续触发)
- 解释计划:explainSql(sql),查看 SQL 的执行计划(逻辑计划/优化后计划/物理计划)
- 支持语句:CREATE/DROP/ALTER/INSERT/SELECT/DESCRIBE/SHOW/USE/EXPLAIN/LOAD/UNLOAD
2.3 Catalog 管理
- 注册 Catalog:registerCatalog(name, catalog),注册 Hive/JDBC 等外部 Catalog
- 当前 Catalog:getCurrentCatalog() / useCatalog(name)
- 当前数据库:getCurrentDatabase() / useDatabase(db)
- 列出对象:listCatalogs() / listDatabases() / listTables() / listViews()
2.4 函数注册与管理
- 注册 UDF:createTemporarySystemFunction(name, functionClass),注册 ScalarFunction
- 注册 UDTF:createTemporarySystemFunction(name, TableFunctionClass),注册 TableFunction
- 注册 UDAF:createTemporarySystemFunction(name, AggregateFunctionClass),注册 AggregateFunction
- 列出函数:listUserDefinedFunctions() / listFunctions() / listSystemFunctions()
- 删除函数:dropTemporarySystemFunction(name)
2.5 配置管理
- 获取配置:getConfig(),获取 TableConfig 配置对象
- 设置参数:getConfig().set(key, value),设置执行参数
- 并行度:getConfig().setParallelism(n),设置 Table 作业并行度
- 时区:getConfig().setLocalTimeZone(zone),设置时区(影响时间函数)
- 状态后端:通过 StreamExecutionEnvironment 设置(StreamTableEnvironment)
2.6 DataStream 互转(仅 StreamTableEnvironment)
- DataStream → Table:fromDataStream(stream) / fromDataStream(stream, schema),支持指定事件时间列和处理时间列
- Table → DataStream:toDataStream(table) / toChangelogStream(table),toDataStream 仅适用于仅追加表,toChangelogStream 保留变更日志(Retract/Upsert)
- 事件时间:fromDataStream(stream, $("ts").rowtime()),指定事件时间列
- 处理时间:fromDataStream(stream, $("pt").proctime()),指定处理时间列
三、TableEnvironment 内部架构
理解了本质和职责,下面深入内部架构,看 TableEnvironment 到底是怎么工作的。
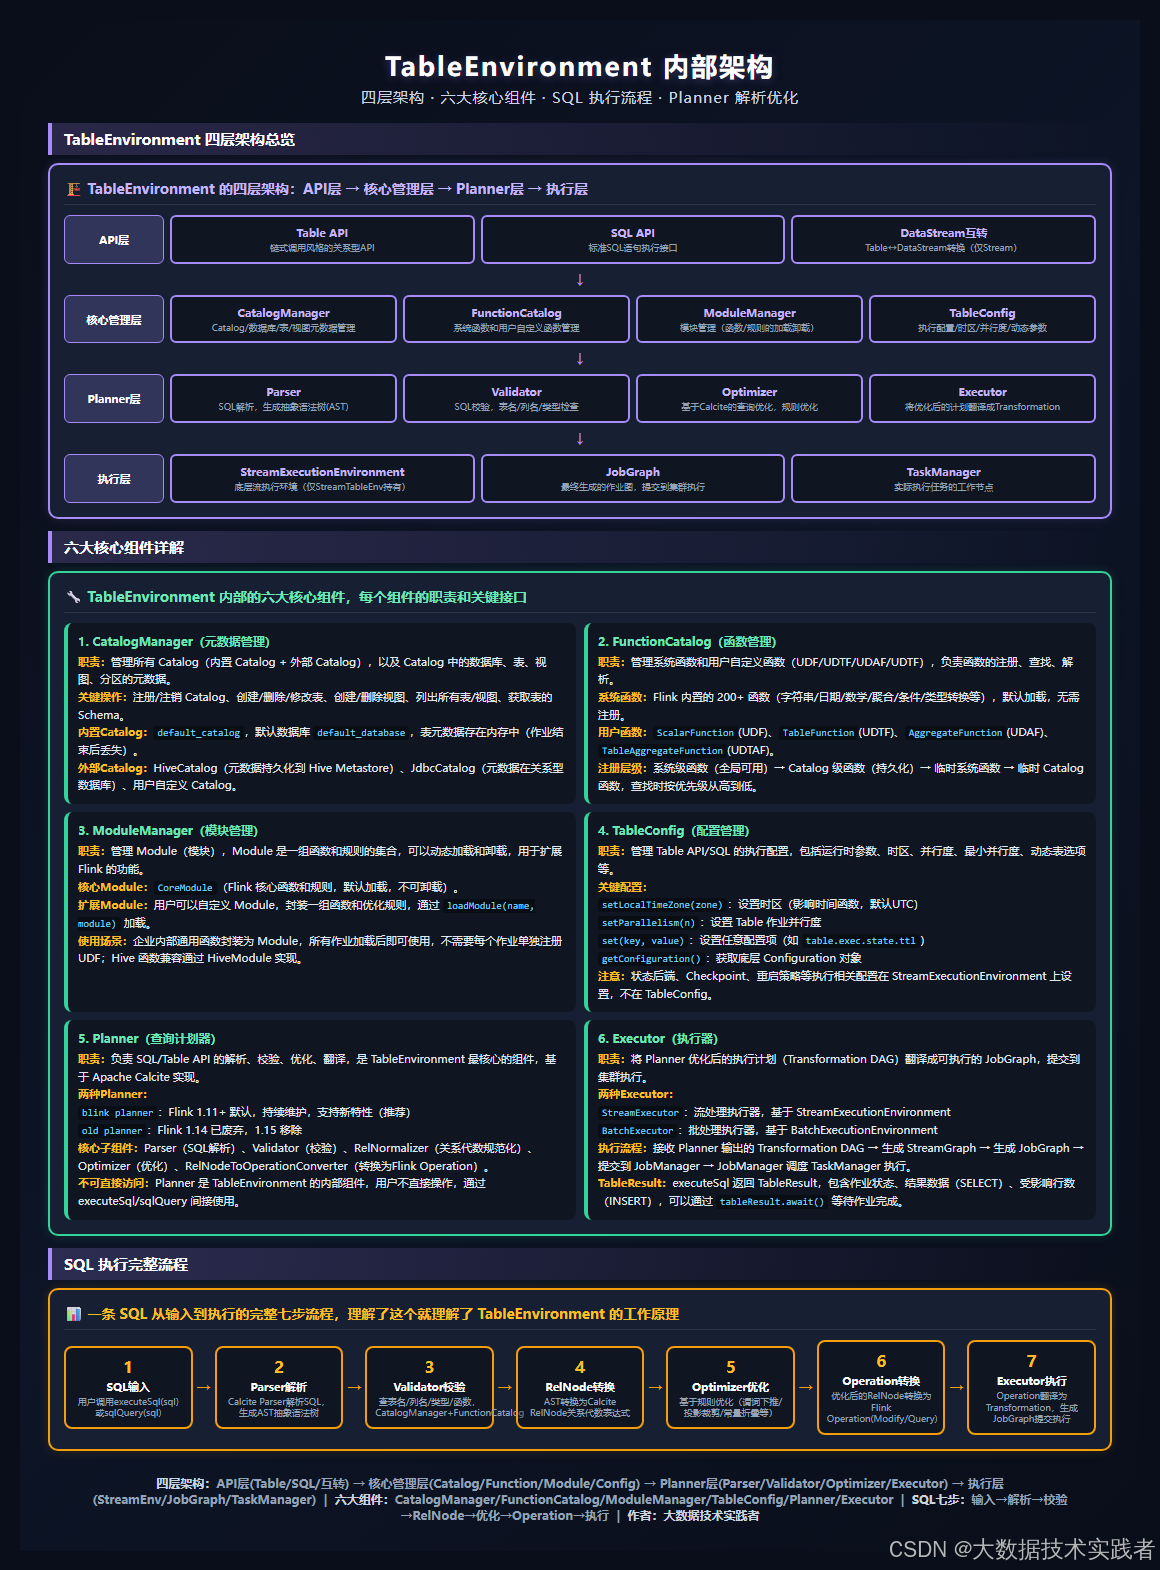
下面这张图把四层架构、六大核心组件、SQL 执行七步流程放在一起展示。
3.1 四层架构总览
TableEnvironment 的内部架构分为四层,从上到下依次是:
第一层:API 层
- Table API:链式调用风格的关系型 API(table.select().filter().groupBy())
- SQL API:标准 SQL 语句执行接口(executeSql() / sqlQuery())
- DataStream 互转:Table ↔ DataStream 转换(仅 StreamTableEnvironment)
第二层:核心管理层
- CatalogManager:Catalog/数据库/表/视图的元数据管理
- FunctionCatalog:系统函数和用户自定义函数管理
- ModuleManager:模块管理(函数/规则的加载卸载)
- TableConfig:执行配置/时区/并行度/动态参数
第三层:Planner 层
- Parser:SQL 解析,生成抽象语法树(AST)
- Validator:SQL 校验,表名/列名/类型检查
- Optimizer:基于 Calcite 的查询优化,规则优化
- Executor:将优化后的计划翻译成 Transformation
第四层:执行层
- StreamExecutionEnvironment:底层流执行环境(仅 StreamTableEnv 持有)
- JobGraph:最终生成的作业图,提交到集群执行
- TaskManager:实际执行任务的工作节点
3.2 六大核心组件详解
组件一:CatalogManager(元数据管理)
管理所有 Catalog(内置 Catalog + 外部 Catalog),以及 Catalog 中的数据库、表、视图、分区的元数据。内置 Catalog 是 default_catalog,默认数据库 default_database,表元数据存在内存中(作业结束后丢失)。外部 Catalog 包括 HiveCatalog(元数据持久化到 Hive Metastore)、JdbcCatalog(元数据在关系型数据库)、用户自定义 Catalog。
组件二:FunctionCatalog(函数管理)
管理系统函数和用户自定义函数(UDF/UDTF/UDAF/UDTAF),负责函数的注册、查找、解析。系统函数是 Flink 内置的 200+ 函数(字符串/日期/数学/聚合/条件/类型转换等),默认加载。用户函数包括 ScalarFunction(UDF)、TableFunction(UDTF)、AggregateFunction(UDAF)、TableAggregateFunction(UDTAF)。注册层级按优先级:系统级函数 → Catalog 级函数 → 临时系统函数 → 临时 Catalog 函数。
组件三:ModuleManager(模块管理)
管理 Module(模块),Module 是一组函数和规则的集合,可以动态加载和卸载。CoreModule 是 Flink 核心函数和规则,默认加载不可卸载。用户可以自定义 Module 封装企业内部通用函数,通过 loadModule(name, module) 加载,所有作业加载后即可使用,不需要每个作业单独注册 UDF。Hive 函数兼容通过 HiveModule 实现。
组件四:TableConfig(配置管理)
管理 Table API/SQL 的执行配置,包括运行时参数、时区、并行度、最小并行度、动态表选项等。关键配置包括 setLocalTimeZone(zone)(设置时区,默认 UTC)、setParallelism(n)(设置并行度)、set(key, value)(设置任意配置项)、getConfiguration()(获取底层 Configuration 对象)。注意:状态后端、Checkpoint、重启策略等执行相关配置在 StreamExecutionEnvironment 上设置,不在 TableConfig。
组件五:Planner(查询计划器)
负责 SQL/Table API 的解析、校验、优化、翻译,是 TableEnvironment 最核心的组件,基于 Apache Calcite 实现。Flink 1.11+ 默认使用 blink planner,持续维护支持新特性;old planner 在 1.14 已废弃,1.15 移除。核心子组件包括 Parser(SQL 解析)、Validator(校验)、RelNormalizer(关系代数规范化)、Optimizer(优化)、RelNodeToOperationConverter(转换为 Flink Operation)。Planner 是 TableEnvironment 的内部组件,用户不直接操作,通过 executeSql/sqlQuery 间接使用。
组件六:Executor(执行器)
将 Planner 优化后的执行计划(Transformation DAG)翻译成可执行的 JobGraph,提交到集群执行。两种 Executor:StreamExecutor(流处理执行器,基于 StreamExecutionEnvironment)、BatchExecutor(批处理执行器,基于 BatchExecutionEnvironment)。执行流程:接收 Planner 输出的 Transformation DAG → 生成 StreamGraph → 生成 JobGraph → 提交到 JobManager → JobManager 调度 TaskManager 执行。executeSql 返回 TableResult,包含作业状态、结果数据(SELECT)、受影响行数(INSERT),可以通过 tableResult.await() 等待作业完成。
3.3 SQL 执行完整七步流程
一条 SQL 从输入到执行,完整的流程分为七步:
理解了这七步,就理解了 TableEnvironment 的工作原理。explainSql(sql) 可以查看第 5 步优化后的执行计划,帮助排查 SQL 性能问题。
四、TableEnvironment 完整代码实现
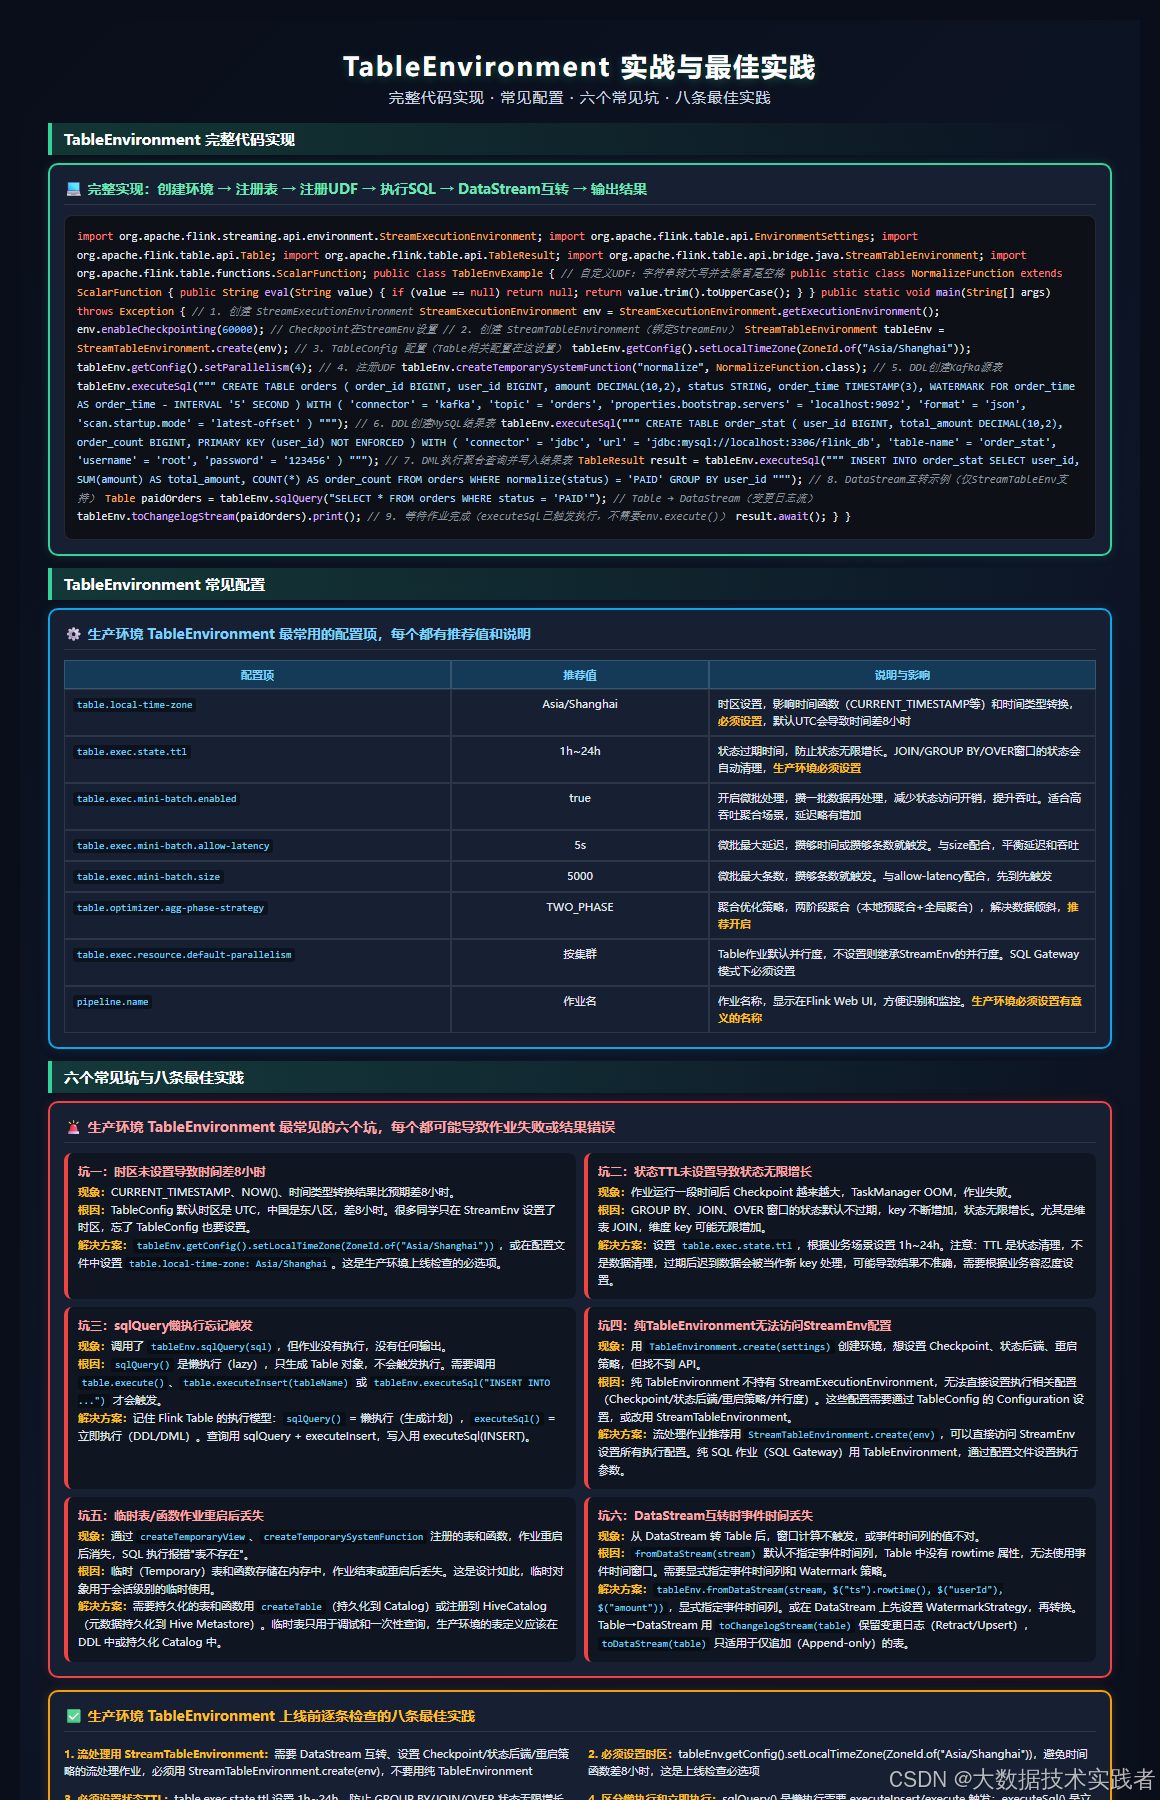
下面是一个完整的 TableEnvironment 使用示例,包含创建环境、配置管理、注册 UDF、DDL 建表、DML 执行、DataStream 互转、输出结果。
下面这张图把完整代码实现、常见配置、六个常见坑、八条最佳实践放在一起展示。
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.EnvironmentSettings;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.TableResult;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;
import org.apache.flink.table.functions.ScalarFunction;
import java.time.ZoneId;
public class TableEnvExample {
// 自定义UDF:字符串转大写并去除首尾空格
public static class NormalizeFunction extends ScalarFunction {
public String eval(String value) {
if (value == null) return null;
return value.trim().toUpperCase();
}
}
public static void main(String[] args) throws Exception {
// 1. 创建 StreamExecutionEnvironment
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
env.enableCheckpointing(60000); // Checkpoint在StreamEnv设置
// 2. 创建 StreamTableEnvironment(绑定StreamEnv)
StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);
// 3. TableConfig 配置(Table相关配置在这设置)
tableEnv.getConfig().setLocalTimeZone(ZoneId.of("Asia/Shanghai"));
tableEnv.getConfig().setParallelism(4);
// 4. 注册UDF
tableEnv.createTemporarySystemFunction("normalize", NormalizeFunction.class);
// 5. DDL创建Kafka源表
tableEnv.executeSql("""
CREATE TABLE orders (
order_id BIGINT,
user_id BIGINT,
amount DECIMAL(10,2),
status STRING,
order_time TIMESTAMP(3),
WATERMARK FOR order_time AS order_time – INTERVAL '5' SECOND
) WITH (
'connector' = 'kafka',
'topic' = 'orders',
'properties.bootstrap.servers' = 'localhost:9092',
'format' = 'json',
'scan.startup.mode' = 'latest-offset'
)
""");
// 6. DDL创建MySQL结果表
tableEnv.executeSql("""
CREATE TABLE order_stat (
user_id BIGINT,
total_amount DECIMAL(10,2),
order_count BIGINT,
PRIMARY KEY (user_id) NOT ENFORCED
) WITH (
'connector' = 'jdbc',
'url' = 'jdbc:mysql://localhost:3306/flink_db',
'table-name' = 'order_stat',
'username' = 'root',
'password' = '123456'
)
""");
// 7. DML执行聚合查询并写入结果表
TableResult result = tableEnv.executeSql("""
INSERT INTO order_stat
SELECT
user_id,
SUM(amount) AS total_amount,
COUNT(*) AS order_count
FROM orders
WHERE normalize(status) = 'PAID'
GROUP BY user_id
""");
// 8. DataStream互转示例(仅StreamTableEnv支持)
Table paidOrders = tableEnv.sqlQuery("SELECT * FROM orders WHERE status = 'PAID'");
// Table → DataStream(变更日志流)
tableEnv.toChangelogStream(paidOrders).print();
// 9. 等待作业完成(executeSql已触发执行,不需要env.execute())
result.await();
}
}
代码关键点:
五、常见配置
生产环境 TableEnvironment 最常用的配置项:
| table.local-time-zone | Asia/Shanghai | 时区设置,影响时间函数和时间类型转换,必须设置,默认 UTC 差 8 小时 |
| table.exec.state.ttl | 1h~24h | 状态过期时间,防止 GROUP BY/JOIN/OVER 状态无限增长,生产环境必须设置 |
| table.exec.mini-batch.enabled | true | 开启微批处理,攒一批数据再处理,减少状态访问开销,提升吞吐 |
| table.exec.mini-batch.allow-latency | 5s | 微批最大延迟,攒够时间或条数就触发,与 size 配合平衡延迟和吞吐 |
| table.exec.mini-batch.size | 5000 | 微批最大条数,攒够条数就触发,与 allow-latency 配合,先到先触发 |
| table.optimizer.agg-phase-strategy | TWO_PHASE | 聚合优化策略,两阶段聚合(本地预聚合+全局聚合),解决数据倾斜,推荐开启 |
| table.exec.resource.default-parallelism | 按集群 | Table 作业默认并行度,不设置则继承 StreamEnv 并行度,SQL Gateway 模式必须设置 |
| pipeline.name | 作业名 | 作业名称,显示在 Flink Web UI,生产环境必须设置有意义的名称 |
六、六个常见坑
6.1 坑一:时区未设置导致时间差 8 小时
现象: CURRENT_TIMESTAMP、NOW()、时间类型转换结果比预期差 8 小时。
根因: TableConfig 默认时区是 UTC,中国是东八区,差 8 小时。很多同学只在 StreamEnv 设置了时区,忘了 TableConfig 也要设置。
解决方案: tableEnv.getConfig().setLocalTimeZone(ZoneId.of("Asia/Shanghai")),或在配置文件中设置 table.local-time-zone: Asia/Shanghai。这是生产环境上线检查的必选项。
6.2 坑二:状态 TTL 未设置导致状态无限增长
现象: 作业运行一段时间后 Checkpoint 越来越大,TaskManager OOM,作业失败。
根因: GROUP BY、JOIN、OVER 窗口的状态默认不过期,key 不断增加,状态无限增长。尤其是维表 JOIN,维度 key 可能无限增加。
解决方案: 设置 table.exec.state.ttl,根据业务场景设置 1h~24h。注意:TTL 是状态清理,不是数据清理,过期后迟到数据会被当作新 key 处理,可能导致结果不准确,需要根据业务容忍度设置。
6.3 坑三:sqlQuery 懒执行忘记触发
现象: 调用了 tableEnv.sqlQuery(sql),但作业没有执行,没有任何输出。
根因: sqlQuery() 是懒执行(lazy),只生成 Table 对象,不会触发执行。需要调用 table.execute()、table.executeInsert(tableName) 或 tableEnv.executeSql("INSERT INTO …") 才会触发。
解决方案: 记住 Flink Table 的执行模型:sqlQuery() = 懒执行(生成计划),executeSql() = 立即执行(DDL/DML)。查询用 sqlQuery + executeInsert,写入用 executeSql(INSERT)。
6.4 坑四:纯 TableEnvironment 无法访问 StreamEnv 配置
现象: 用 TableEnvironment.create(settings) 创建环境,想设置 Checkpoint、状态后端、重启策略,但找不到 API。
根因: 纯 TableEnvironment 不持有 StreamExecutionEnvironment,无法直接设置执行相关配置(Checkpoint/状态后端/重启策略/并行度)。这些配置需要通过 TableConfig 的 Configuration 设置,或改用 StreamTableEnvironment。
解决方案: 流处理作业推荐用 StreamTableEnvironment.create(env),可以直接访问 StreamEnv 设置所有执行配置。纯 SQL 作业(SQL Gateway)用 TableEnvironment,通过配置文件设置执行参数。
6.5 坑五:临时表/函数作业重启后丢失
现象: 通过 createTemporaryView、createTemporarySystemFunction 注册的表和函数,作业重启后消失,SQL 执行报错"表不存在"。
根因: 临时(Temporary)表和函数存储在内存中,作业结束或重启后丢失。这是设计如此,临时对象用于会话级别的临时使用。
解决方案: 需要持久化的表和函数用 createTable(持久化到 Catalog)或注册到 HiveCatalog(元数据持久化到 Hive Metastore)。临时表只用于调试和一次性查询,生产环境的表定义应该在 DDL 中或持久化 Catalog 中。
6.6 坑六:DataStream 互转时事件时间丢失
现象: 从 DataStream 转 Table 后,窗口计算不触发,或事件时间列的值不对。
根因: fromDataStream(stream) 默认不指定事件时间列,Table 中没有 rowtime 属性,无法使用事件时间窗口。需要显式指定事件时间列和 Watermark 策略。
解决方案: tableEnv.fromDataStream(stream, $("ts").rowtime(), $("userId"), $("amount")),显式指定事件时间列。或在 DataStream 上先设置 WatermarkStrategy,再转换。Table → DataStream 用 toChangelogStream(table) 保留变更日志(Retract/Upsert),toDataStream(table) 只适用于仅追加(Append-only)的表。
七、八条最佳实践 Checklist
上线前逐条检查:
流处理用 StreamTableEnvironment:需要 DataStream 互转、设置 Checkpoint/状态后端/重启策略的流处理作业,必须用 StreamTableEnvironment.create(env),不要用纯 TableEnvironment。
必须设置时区:tableEnv.getConfig().setLocalTimeZone(ZoneId.of("Asia/Shanghai")),避免时间函数差 8 小时,这是上线检查必选项。
必须设置状态 TTL:table.exec.state.ttl 设置 1h~24h,防止 GROUP BY/JOIN/OVER 状态无限增长导致 OOM。
区分懒执行和立即执行:sqlQuery() 是懒执行需要 executeInsert/execute 触发;executeSql() 是立即执行。不要只调用 sqlQuery 就以为作业会执行。
高吞吐开启微批和两阶段聚合:table.exec.mini-batch.enabled=true + table.optimizer.agg-phase-strategy=TWO_PHASE,提升吞吐、解决数据倾斜。
持久化表定义用 Catalog:生产环境的表定义用 createTable 或 HiveCatalog 持久化,不要用 createTemporaryView(作业重启丢失)。
DataStream 互转显式指定事件时间:fromDataStream(stream, $("ts").rowtime(), …) 显式指定事件时间列;Table → DataStream 用 toChangelogStream 保留变更日志。
设置有意义的作业名:pipeline.name 设置有意义的作业名,方便 Flink Web UI 识别和监控,生产环境必须设置。
八、总结与下一篇预告
TableEnvironment 原理及代码实现要点回顾:
第一,本质:Table API 和 SQL 的统一入口上下文,管理元数据、函数、配置和执行。可以理解为关系型数据库的连接会话。两种实现:StreamTableEnvironment(流处理+互转,推荐)和 TableEnvironment(纯 SQL)。
第二,六大核心职责:表的创建与注册、SQL 执行与解释、Catalog 管理、函数注册与管理、配置管理、DataStream 互转(仅 StreamTableEnv)。
第三,四层内部架构:API 层(Table/SQL/互转)→ 核心管理层(CatalogManager/FunctionCatalog/ModuleManager/TableConfig)→ Planner 层(Parser/Validator/Optimizer/Executor)→ 执行层(StreamEnv/JobGraph/TaskManager)。
第四,六大核心组件:CatalogManager(元数据管理)、FunctionCatalog(函数管理)、ModuleManager(模块管理)、TableConfig(配置管理)、Planner(查询计划器,基于 Calcite)、Executor(执行器)。
第五,SQL 执行七步流程:SQL 输入 → Parser 解析生成 AST → Validator 校验 → RelNode 转换 → Optimizer 优化 → Operation 转换 → Executor 执行。
第六,完整代码实现:创建 StreamEnv → 创建 StreamTableEnv → TableConfig 配置(时区/并行度)→ 注册 UDF → DDL 建表(Kafka 源/MySQL 结果)→ DML 执行(INSERT 聚合写入)→ DataStream 互转(toChangelogStream)→ result.await() 等待完成。
第七,常见配置:时区(Asia/Shanghai,必须)、状态 TTL(1h~24h,必须)、微批(enabled=true + allow-latency=5s + size=5000)、两阶段聚合(TWO_PHASE)、默认并行度、作业名。
第八,六个常见坑:时区未设置差 8 小时、状态 TTL 未设置 OOM、sqlQuery 懒执行忘记触发、纯 TableEnv 无法访问 StreamEnv、临时表重启丢失、互转事件时间丢失。
第九,八条最佳实践:流处理用 StreamTableEnv、必须设置时区、必须设置状态 TTL、区分懒执行和立即执行、高吞吐开启微批和两阶段聚合、持久化表定义用 Catalog、互转显式指定事件时间、设置有意义的作业名。
TableEnvironment 是 Flink SQL 的入口和核心,理解了它的本质、内部架构、核心组件和执行流程,就能在生产环境中正确使用 Flink SQL,避开常见坑,写出高质量的 SQL 作业。