/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
AI 生成的 SQL 通过了语法检查、在测试库返回了预期结果,就能直接上线吗?
“跑通了”只说明它在当前测试数据和这一次参数下得到了返回值;这不能证明换一批数据后结果仍正确,也不能证明在代表性负载下性能可接受、执行权限合适。
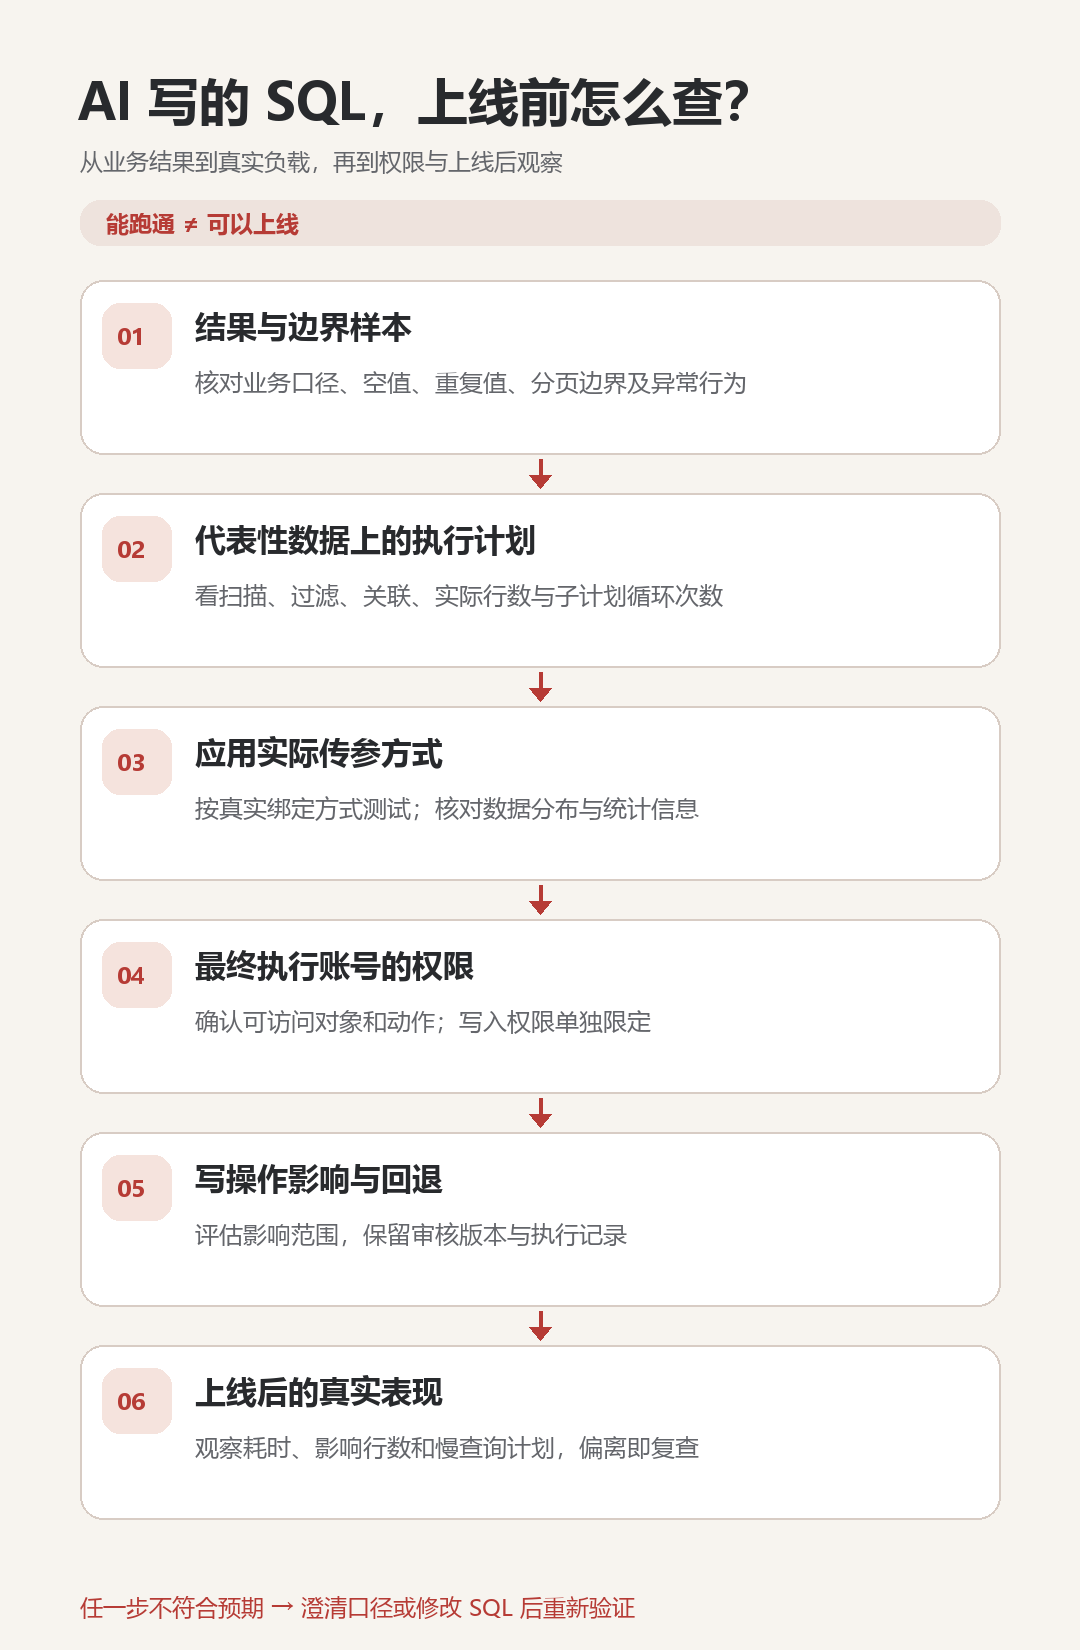
实际审核可以按六步走:核对结果、检查执行计划、复现应用传参、验证执行权限、评估变更与回退、上线后观察。下文把这六步归为三关:结果是否正确、执行代价是否可接受、执行与上线控制是否到位,并用案例说明每一步为什么必要。
上线前检查流程
第一关:查得出来,结果就对吗?
一条查询少了业务过滤条件、把空值算错、聚合时重复计数,数据库照样会返回结果。分页也一样:第一页的几行看着没问题,不代表换个边界或改写执行顺序后,结果和异常行为仍符合预期。
案例一:深分页改写,结果相同不等于语义相同
先看案例的测试环境:t1 和 t2 两张表各有 100 万行,t2.t2id1 是主键,并建有 idx_t2 索引。下面是案例中的建表和数据准备语句:
CREATE TABLE t1(t1id1 integer, t1name text);
CREATE TABLE t2(t2id1 integer PRIMARY KEY, t2name text);
INSERT INTO t1 SELECT generate_series(1,1000000), md5(random());
INSERT INTO t2 SELECT generate_series(1,1000000), md5(random());
CREATE INDEX idx_t2 ON t2(t2id1);
数据准备完成后,案例使用了下面这条原始分页 SQL:
EXPLAIN ANALYZE
SELECT t1id1,
(SELECT t2name FROM t2 WHERE t2id1 = t1id1)
FROM t1
ORDER BY t1id1
LIMIT 500000,200;
这条 SQL 最终只返回 200 行,但投影列里的相关子查询执行了 500200 次。问题不是 idx_t2 没有使用,而是索引访问随着 offset + limit 被重复执行。
为了减少这部分重复执行,该案例又给出了下面的改写版本:先在内层完成排序和分页,只筛出当前页的 t1id1,再查询对应的 t2name。
EXPLAIN ANALYZE
SELECT t1id1,
(SELECT t2name FROM t2 WHERE t2id1 = t1id1)
FROM (
SELECT t1id1 FROM t1 ORDER BY t1id1 LIMIT 500000,200
) t1
ORDER BY t1id1;
案例记录中,原始写法执行时间约 1210 毫秒,改写后约 383 毫秒;SubPlan 的 loops 从 500200 降为 200。但排序仍处理约 500200 行,所以改写减少的是相关子查询的重复执行,不是把深分页的排序成本消除了。
既然更快,为什么不能一律这样改?因为两条 SQL 返回同一页数据,不等于在所有情况下都等价。原写法会计算那些最终被 offset 跳过的行;改写后不会。该案例还讨论了一个语义边界:假如另一个场景里的标量子查询在某条被跳过的行上返回多行,原写法可能报错,改写后则可能直接返回当前页。这个异常是案例分析的假设情形,并未在上述测试数据中发生;该测试的关联键有主键约束。
审 AI 给出的“优化版”时,别只对比一页正常结果。先写清业务预期,再用空值、重复值、分页边界等样本核对改写前后的结果;涉及计算顺序变化时,还要问清楚异常是否允许被跳过。没有可靠基准查询,就先确认业务口径,而不是让“看起来一样”替代验证。
第二关:测试库很快,真实负载也跑得动吗?
结果正确,还要看数据库为得到这个结果做了多少工作。执行计划里的扫描、过滤、关联、预估与实际行数,以及子计划的 loops,比一句“我本地跑得挺快”更有信息量。不过,看到 Seq Scan 就判错、看到索引扫描就放心,同样不可靠;判断要结合数据量、选择率和实际耗时。
案例二:隐式类型转换,让索引看起来像失效了
案例二记录了一条生产慢查询,问题集中在关联条件与执行计划上。原有业务 SQL 的关联字段字符类型和长度不一致,比较时出现隐式转换,联合索引没有按预期充分发挥作用;计划中还有重复的 SubPlan。该案例记录了原查询约 398 秒,以及该环境中不同调整方法得到的毫秒级结果。这是该案例的记录,不是“改字段类型就能提速多少倍”的通用结论。
案例二的执行计划中,同一关联条件在调整前后的位置发生了变化。以下只摘录相关条件,省去业务表名和其他计划节点:
调整前
Index Cond: ((cen_seq)::text = (t.spec_seq)::text)
Filter: ((sys_sett_date)::text = (t.spec_sys_sett_date)::text)
调整后
Index Cond: ((sys_sett_date = (t.spec_sys_sett_date)::character(8 char)) AND ((cen_seq)::text = ((t.spec_seq)::text))
这里要看的是 sys_sett_date 从 Filter 进入了 Index Cond。以上两段是案例中的执行计划节选,不能据此推断其他环境也会得到相同耗时。
它能转化成两个实用检查动作:看关联条件两侧的数据类型,尤其留意意外的转换;再看计划中的 Index Cond、Filter 和 loops,确认过滤落在了哪里、相关子查询重复执行了多少次。发现可疑信号后,在有代表性的数据上测,而不是仅凭计划节点名称下结论。
案例三:常量测试,能代表应用里的绑定变量吗?
案例三讨论的是分区表查询。分区表把数据按规则放进不同分区;查询时跳过无关分区,叫“分区剪枝”。命令行里把条件写成常量时,优化器可能在计划阶段确定要访问的分区;应用使用绑定变量时,计划阶段掌握的信息不同,可能选择另一条扫描路径。这个现象取决于数据库版本、分区数量、统计信息和参数分布,不能简化为“绑定变量一定导致全表扫描”。
案例三以“25 个分区、计划阈值为 20”举例:如果计划阶段尚未剪枝,优化器可能改用父表的全局统计信息;父表统计信息没有更新时,成本估计可能偏离实际。这是机制说明,案例没有提供这一组条件下的完整实测计划。
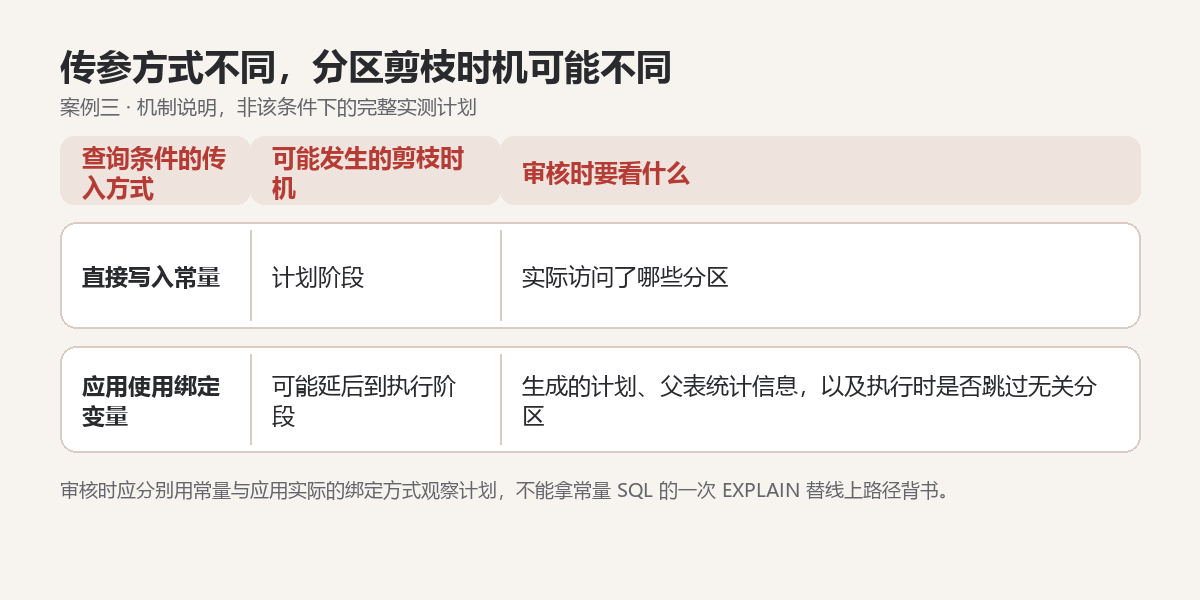
案例三给出的一个排查动作是 ANALYZE t_part,用于更新父表统计信息;它不是对所有分区表问题都适用的固定处方。
审核时,应分别用常量和应用实际的绑定方式观察计划。如果两种方式的计划不同,先核对真实参数分布和统计信息,再决定是否需要调整 SQL、索引或分区设计。不要拿常量 SQL 的一次 EXPLAIN,替应用线上路径背书。
EXPLAIN 给出的是预估计划;要看到实际行数和循环次数,EXPLAIN ANALYZE 会真正执行语句。涉及 UPDATE、DELETE 等写操作时,不要为了看计划而直接在生产环境运行它,应先在受控环境评估执行影响。
第三关:谁来执行,上线后怎么核对?
同样一条 SQL,放在只读账号和高权限账号下,风险不是一个量级。一条 SELECT 与一条没有限定范围的 UPDATE,也不能用同一套放行标准。审核时要确认最终执行账号能访问哪些对象、能做哪些动作,而不只是确认管理员账号“跑得通”。
案例四:能执行,不等于应该放行
案例四把 SELECT、INSERT、UPDATE、DELETE 列为不同的对象权限,并展示了角色授权后的操作验证。审核 AI 生成的 SQL 时,要用最终业务角色验证:查询账号能否只读目标对象,写入账号是否只能操作指定表,删除动作是否需要单独审批。确需写入时,还要确认预期影响范围和回退方式。管理员账号执行成功,不能替代这一步。
案例四中的同一条插入语句,在不同账号下得到了不同结果:
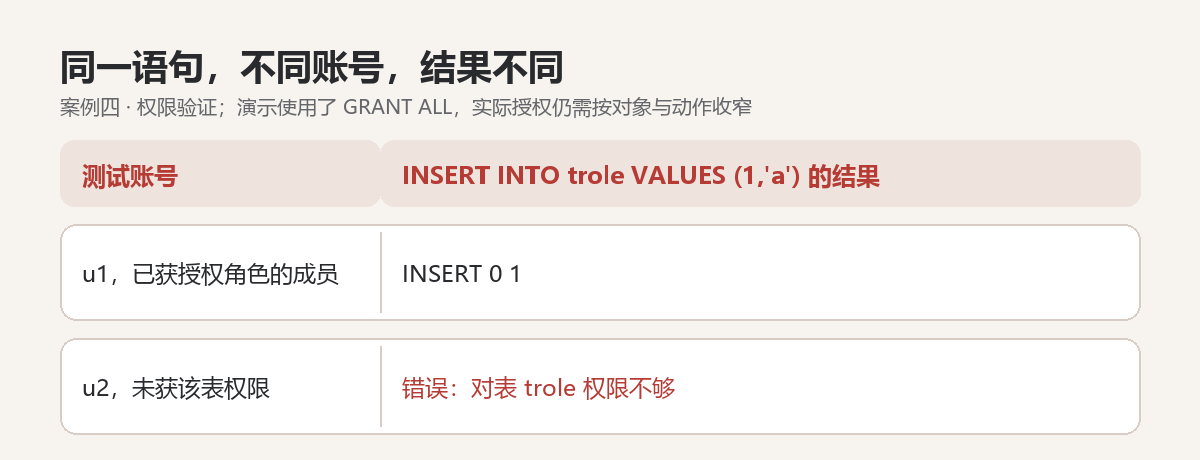
这项测试为演示差异使用了 GRANT ALL;这里引用的是权限验证结果,实际业务授权仍需按所需对象和动作收窄。
案例五:上线后还要知道真实计划
线上与测试环境可能因统计信息、数据分布和传参方式不同而出现不同计划,并发还会影响实际耗时。案例五展示了如何采集执行计划:类似 auto_explain 的功能需要显式配置,部分选项会增加开销。应按数据库版本和业务需要选择性启用,用采集到的计划核对线上执行情况;还要结合业务结果、耗时和影响行数判断,不能把“采集到了”当作“已经优化”。
案例五记录了采集到的计划日志,节选如下。估算的 rows=1 与实际的 rows=11 可以直接对照,过滤掉的行数也有记录:
日志: duration: 0.279 ms plan:
Query Text: select * from sys_class where relnamespace = 2200;
Seq Scan on pg_class (cost=0.00..39.45 rows=1 width=264) (actual time=0.033..0.198 rows=11 loops=1)
Filter: (relnamespace = '2200'::oid)
Rows Removed by Filter: 761
这是案例五中的测试日志。该测试将采集阈值设为 0 以记录所有语句,生产环境不应照搬这一设置。
案例六:规则拦截是最后一道边界,不是 SQL 审核的替代品
案例六介绍了一种 SQL 防护方式:通过学习形成白名单,对规则之外的语句选择告警或拦截。它能限制哪些语句可以执行,却不能判断语句是否满足业务要求。例如,一条被允许的 SELECT 仍可能漏掉过滤条件,或扫描大量数据。
因此,规则拦截适合作为执行时的最后一道边界。上线前仍要核对查询结果、执行计划和账号权限;运行时如果有语句被拦截,应记录 SQL、执行账号和拦截原因,便于排查。
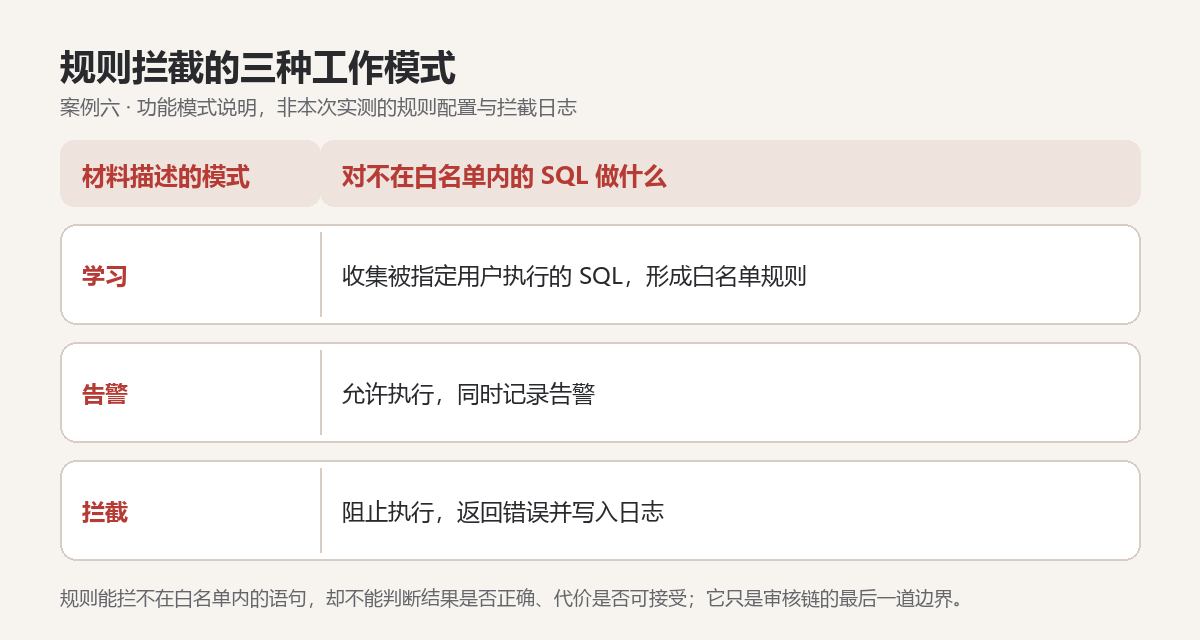
案例六介绍的是功能模式,没有提供可在本文复现的规则配置与拦截日志,因此不能把表格当成一次实测结果。
权限和规则回答“允许做什么”,结果与计划审核回答“做得对不对、代价能否接受”。
可以把这六类案例串成一条实际的审核链:先用案例一检查结果等价性,再用案例二和三检查执行代价与真实传参,用案例四确认执行权限,用案例五观察上线后的实际计划,最后用案例六检查规则边界。它们分别回答不同问题,不能用一个“通过”标记替代全部判断。
审核结果最好留下证据,而不是只在工单里写一句“已测试”。至少记录测试数据、传参方式、关键计划节点、最终执行角色,以及写操作的影响范围和回退办法。
真正提交上线前,可以把审核压缩成六项:
AI 可以帮我们更快写出 SQL,也能很快给出“优化版”。真正决定它能否上线的,是经过核对的业务结果、经得起真实负载检验的执行代价,以及清楚可控的权限边界。“能跑”只是起点,不是上线结论。
参考文档
文中引用的案例材料来自金仓社区技术资料;上线检查建议由这些案例归纳。案例中的性能结果只对应原测试环境。
文中测试数字沿用案例记录,未重新实测;案例里的条件和结果不构成通用性能承诺。
化案例》
3. 《分区剪枝失效案例:为什么绑定变量会导致执行计划走向全表扫描?》
4. 《KingbaseES 的角色和权限管理》
5. 《KingbaseES 查询应用慢查询执行计划》
6. 《SQL 防火墙文章 20260212》
文中测试数字沿用案例记录,未重新实测;案例里的条件和结果不构成通用性能承诺。