2026 年 9 月 1 日,科大讯飞全资子公司词元星火开源了 Spark-X2.5-4B(精确参数 4,112,079,360)与 Spark-X2.5-1.7B 两款端侧模型,Apache 2.0 许可、可商用、微调后无需开源。最大看点是原生 1,048,576 Token 上下文——这是目前公开的端侧模型里第一个把 100 万上下文做进 4B 稠密模型的。BF16 GGUF 权重 7.67 GiB,一张 12GB 显卡放得下。
一、模型速览
|
项目 |
内容 |
|
发布方 |
词元星火(科大讯飞全资子公司) |
|
发布时间 |
2026-09-01 |
|
参数量 |
4,112,079,360(约 4.112B),稠密架构,非 MoE |
|
上下文长度 |
1,048,576 Token(1M)原生 |
|
许可证 |
Apache 2.0(代码 + 权重,允许商用,微调产物无需开源) |
|
模态 |
文本 → 文本 |
|
语言覆盖 |
200+ |
|
权重体积 |
BF16 safetensors 约 7.7 GB;BF16 GGUF 7.67 GiB(启智社区镜像实测) |
|
推理模式 |
Thinking(默认)/ Standard 双模式 |
|
同系列 |
Spark-X2.5-1.7B、Spark-X2.5-4B-Base、Spark-X2.5-1.7B-Base |
一句话定位:一个能在 12GB 显卡或 Apple Silicon 上跑满长文档、并且真的会调工具的 4B 稠密模型——适合做信创环境下的本地 Agent、离线文档问答和端侧代码补全,不适合当通用知识库。
需要说明一点口径差异:部分中文媒体给的 BF16 权重是 8.23 GB,DataLearner 与启智社区镜像给的是 7.67–7.7 GB。差别来自是否计入 tokenizer 与索引文件,实际下载量按 7.7 GiB 量级准备即可。
另外,官方在 9 月 7 日发布了旗舰版"星火 X2.5",但那是云端旗舰、与本文这两个端侧开源权重是不同东西,别混淆。本文只讨论已开源的 4B/1.7B。
二、核心亮点
1. 混合注意力:1 层全量 + 3 层滑窗交替,是 1M 上下文能落到 4B 上的关键
Spark-X2.5 的注意力布局是一层全量注意力(full attention)与三层滑动窗口注意力(sliding window attention)交替堆叠(来源:官方模型卡)。这个 1:3 的配比是工程上的核心取舍——如果全部用全量注意力,1M 上下文的 KV Cache 会直接把端侧设备的内存吃穿;如果全用滑窗,跨章节的长程关联又会断。留 1/4 的全量层负责全局信息汇聚,剩下 3/4 用滑窗压成本。
长上下文能力不是预训练里顺带获得的,官方明确它来自一个独立的训练阶段:用数千亿 Token、序列长度直接扩到 1M 的语料专门训(来源:官方模型卡)。这也解释了为什么它在 AA-LCR 长上下文推理上能拿 56.3,虽然还不如 Qwen3.5-9B 的 63.0,但在 4B 档里是能打的。
⚠️ 这里必须泼一盆冷水:1M 是模型能力上限,不代表你的设备能低成本跑满。实际显存随上下文长度、并发数、KV Cache 精度显著增长。4B 权重只占 7.7 GB,但你真喂进 100 万 Token,KV Cache 的开销会是权重的数倍。日常用 32K–128K 是现实区间。
2. 后训练走的是"多教师 RL + MOPD 蒸馏合并",不是单条 SFT 流水线
官方披露的后训练流程分三段(来源:官方模型卡):
这种"多专精教师 → 单模型"的路线,解释了它基准分布的一个特点:Agent 与数学类项目异常突出,而通用知识类(GPQA 67.4、HLE 12.3)明显平庸。RL 加过的域涨得凶,没加的域就是 4B 的正常水平。选型时这点很重要。
3. 20 万亿 Token 预训练,全流程国产算力
预训练语料约 20 万亿 Token,覆盖网页、图书、学术出版物、代码与百科材料,官方针对数学、逻辑、代码等高价值领域做过数据配比实验(来源:官方模型卡)。全流程训练在国产算力平台上完成(来源:官方发布稿 / 新华社系媒体报道)。
推理侧硬件适配覆盖英伟达、华为昇腾、海光、后摩四类平台,昇腾用户官方推荐走 Modelers(modelers.cn),海光用户走 SCNet。对做信创替换的团队,这条比基准分更实际——2027 年底前信息化系统 100% 替换的时间表下,"能在国产芯片上跑起来"是硬门槛。
4. 1.7B 版本的端侧实测数字更有说服力
官方在智能家居测试集上给了 Spark-X2.5-1.7B 两个数字:控制指令端到端执行正确率 90.3%,平均响应时间 0.85 秒(来源:官方发布稿)。这是我在整个发布材料里看到的唯一带端到端时延的数字,比一堆 benchmark 百分比更能说明它的落地形态——它是拿来做设备控制指令解析的,不是拿来聊天的。
三、部署实战
3.1 环境准备与模型下载
先说一个必须提前知道的坑:Spark-X2.5 用的是 spark2_5 自定义架构,上游 llama.cpp 和官方 Ollama runtime 都还不支持。所以"一行 ollama run"在这个模型上是行不通的,必须走词元星火的定制版 llama.cpp。这一点官方 Ollama 页面自己写明了。
下载渠道(按网络环境选):
# 方式一:Hugging Face(BF16 safetensors,vLLM / transformers 用)
pip install -U "huggingface_hub[cli]"
hf download XHToken/Spark-X2.5-4B –local-dir ./Spark-X2.5-4B
# GGUF 量化版(Ollama / LM Studio 用)
hf download XHToken/Spark-X2.5-4B-GGUF –local-dir ./Spark-X2.5-4B-GGUF
# 方式二:ModelScope(国内推荐,速度更稳)
pip install -U modelscope
modelscope download –model XHToken/Spark-X2.5-4B –local_dir ./Spark-X2.5-4B
# 方式三:昇腾用户走 Modelers → https://modelers.cn/user/XHToken
# 方式四:海光用户走 SCNet → https://www.scnet.cn/ui/aihub/models/XHToken/Spark-X2.5-4B
如果你要走 Ollama/LM Studio 路线,需要先编译定制版 llama.cpp:
# 编译词元星火定制版 llama.cpp(提供 spark2_5 架构支持)
git clone https://github.com/XHToken/llama.cpp.git llama.cpp-spark
# 编译带 Spark 支持的 Ollama
git clone https://github.com/ollama/ollama.git ollama-spark
cd ollama-spark
export OLLAMA_LLAMA_CPP_SOURCE="$(cd ../llama.cpp-spark && pwd)"
cmake -S . -B build
cmake –build build –parallel 8
3.2 启动本地推理服务
路径 A:vLLM(推荐,生产/多并发首选)
vLLM 不能直接吃这个模型,需要装官方适配插件 Spark-plugin:
# 1) 建独立环境
pip install uv
uv venv ~/spark2_5
source ~/spark2_5/bin/activate
# 2) 安装官方 vLLM 适配插件(关键步骤,漏了会报架构不识别)
git clone https://github.com/XHToken/Spark-plugin.git
cd ./Spark-plugin
uv pip install .
cd ..
# 3) 启动 OpenAI 兼容服务
vllm serve "./Spark-X2.5-4B" \\
–port 30000 \\
–trust-remote-code \\
–served-model-name spark25 \\
–tensor-parallel-size 1 \\
–gpu-memory-utilization 0.7 \\
–enable-prefix-caching \\
–chat-template Spark-X2.5-4B/chat_template.jinja
几个参数解释:–gpu-memory-utilization 0.7 官方示例给的是 0.7 而不是常见的 0.9,给 KV Cache 留了余量,长上下文场景别贪心往上调;–enable-prefix-caching 对"同一份长文档反复问"这种场景收益极大,长文档 QA 务必打开;–chat-template 必须显式指定,不指定会走 vLLM 默认模板导致 thinking 标记错乱。
路径 B:Ollama(本地单机快速验证)
# 在 ollama-spark 目录下,用绝对路径指向下载好的 GGUF
printf 'FROM /absolute/path/to/Spark-X2.5-4B.gguf\\n' > ./Modelfile.spark
./ollama serve # 终端 1
# 终端 2(同样在 ollama-spark 目录)
./ollama create Spark-X2.5-4B -f ./Modelfile.spark
./ollama run Spark-X2.5-4B –think=false # –think=false 关闭思考模式,响应更快更直接
路径 C:MLX(Apple Silicon / 无需 GGUF 转换)
官方另有一个 Spark-MLX-LLM 项目,同时支持 Apple Silicon GPU、Linux CPU 和 Linux CUDA,不需要做 GGUF 格式转换:
git clone https://github.com/XHToken/Spark-MLX-LLM.git
cd Spark-MLX-LLM
python3 -m venv .venv && source .venv/bin/activate
python -m pip install -e . # Apple Silicon
# python -m pip install -e '.[cpu]' # Linux CPU
# python -m pip install -e '.[cuda12]' # Linux CUDA 12
# python -m pip install -e '.[cuda13]' # Linux CUDA 13
spark-mlx-generate \\
–device gpu \\
–dtype bfloat16 \\
–model XHToken/Spark-X2.5-4B \\
–prompt "用三句话说明滑动窗口注意力为什么能省显存。" \\
–max-tokens 512 \\
–temp 0
3.3 推理代码(复制即跑)
用 OpenAI SDK 对接 3.2 里 vLLM 起的本地端点,演示两个核心用法:长文档跨段落规则推理 + 工具调用。
Spark-X2.5-4B 本地推理示例
前置:已按 3.2 路径 A 启动 vLLM 服务在 127.0.0.1:30000
依赖:pip install openai
"""
from openai import OpenAI
\\# 指向本地 vLLM 端点,api_key 随便填但不能为空
client = OpenAI(base_url="http://127.0.0.1:30000/v1", api_key="EMPTY")
MODEL = "spark25" # 对应 vllm serve 的 –served-model-name
\\# 官方推荐采样参数:temperature=1.0, top_p=0.95, top_k=-1
\\# 注意 temperature=1.0 是官方给的推荐值,不是笔误。
\\# 这个模型是在 thinking 模式下调出来的,压低温度反而会削弱推理链质量。
SAMPLING = dict(temperature=1.0, top_p=0.95, extra_body={"top_k": -1})
\\# ———- 用法 1:长文档跨章节规则推理 ———-
\\# 真实场景请把 manual 换成读入的完整手册文本(可到几十万 token)
manual = """
【第3章 退换货】3.1 自购买之日起 7 日内出现性能故障,可选择退货、换货或修理。
3.2 第 8 日至第 15 日内出现性能故障,可选择换货或修理。
【第5章 例外条件】5.1 使用非原厂耗材导致的故障,不适用第 3 章免费换货条款,转为付费维修。
5.2 偏远地区(详见附录B)的换货处理时限延长至 15 个工作日,往返物流费用由厂家承担。
【第7章 数据处理】7.1 换货前用户须自行清除设备内存储的个人数据,厂家不承担数据恢复责任。
"""
resp = client.chat.completions.create(
model=MODEL,
messages=[
{"role": "system", "content": "你是售后规则审核助手。回答须逐条引用章节号,不确定就说不确定。"},
{"role": "user", "content": f"以下是售后手册:\\n{manual}\\n\\n"
"问题:用户购买 10 天后设备出现性能故障,期间使用过第三方耗材,"
"且身处偏远地区。他能否免费换货?处理时限多久?还要注意什么?"},
],
max_tokens=2048,
\\*\\*SAMPLING,
)
print("=== 长文档规则推理 ===")
print(resp.choices[0].message.content)
\\# ———- 用法 2:工具调用(Agent 的地基) ———-
tools = [{
"type": "function",
"function": {
"name": "set_device_state",
"description": "控制智能家居设备的开关与参数",
"parameters": {
"type": "object",
"properties": {
"device": {"type": "string", "description": "设备名,如 空调 / 客厅灯"},
"action": {"type": "string", "enum": ["on", "off", "set"]},
"value": {"type": "number", "description": "目标数值,如温度 26"},
},
"required": ["device", "action"],
},
},
}]
resp2 = client.chat.completions.create(
model=MODEL,
messages=[{"role": "user", "content": "把客厅空调开到 26 度,然后把客厅灯关掉。"}],
tools=tools,
tool_choice="auto",
max_tokens=1024,
\\*\\*SAMPLING,
)
print("\\n=== 工具调用 ===")
calls = resp2.choices[0].message.tool_calls
if calls:
for c in calls:
print(f"{c.function.name} <- {c.function.arguments}")
else:
\\# 没触发 tool_calls 时打印原文,便于定位是模板问题还是 prompt 问题
print("未触发工具调用,原始回复:", resp2.choices[0].message.content)
关于关闭思考模式:vLLM 侧通过 chat template 的开关控制,Ollama 侧直接用 –think=false。批量任务、结构化抽取、纯工具路由这类场景建议关掉——thinking 会显著拉长输出、拖慢吞吐。
3.4 效果验证
启动服务后先跑冒烟测试确认链路通:
curl -s http://127.0.0.1:30000/v1/chat/completions \\
-H "Content-Type: application/json" \\
-d '{
"model": "spark25",
"messages": [{"role": "user", "content": "安徽省的省会是什么?"}],
"max_tokens": 512,
"temperature": 1.0,
"top_k": -1,
"top_p": 0.95,
"repetition_penalty": 1,
"presence_penalty": 0,
"frequency_penalty": 0
}'
怎么判断成功: 返回 JSON 里 choices[0].message.content 是合理中文答案(合肥),finish_reason 为 stop 而不是 length,usage 里 token 数正常。如果内容是乱码或重复字符,几乎一定是走了不支持 spark2_5 架构的运行时,回去检查 Spark-plugin 是否装上、或 Ollama 是否用的定制版编译产物。
再验证长上下文是否真的生效:
# 生成一段 20 万字符的文本,把关键句埋在中间,看模型能否捞出来
python – <<'EOF'
filler = "这是填充文本。" * 20000
needle = "【关键信息】本次实验的校准系数是 7.318。"
print(len(filler + needle))
把 filler[:100000] + needle + filler[100000:] 拼成一个 user message 去问"校准系数是多少",能准确答出 7.318 说明长上下文链路没被截断。注意 vLLM 默认 max_model_len 可能小于 1M,需要显式加 –max-model-len 并确认显存够。
3.5 避坑提醒
四、性能测评
4.1 推理速度与显存
|
配置 |
显存/内存占用 |
吞吐 |
来源 |
|
BF16 safetensors 权重 |
约 7.7 GB(权重本身) |
— |
官方数据 |
|
BF16 GGUF 文件 |
7.67 GiB |
— |
启智社区镜像实测文件大小 |
|
Spark-X2.5-1.7B 智能家居指令 |
— |
端到端 0.85 s / 指令 |
官方数据 |
|
4B / 24GB 单卡 vLLM,32K 上下文 |
约 8 GB 权重 + KV Cache |
— |
按 –gpu-memory-utilization 0.7 推算,待验证 |
坦诚说明:我没有在本机跑过 Spark-X2.5-4B 的 tok/s 实测。 官方发布材料里唯一给出的时延数字是 1.7B 在智能家居测试集上的 0.85 秒端到端响应,4B 版本的 tok/s 官方没公布,社区目前也还没有可信的复测(模型发布仅一周,Ollama 早期拉取量只有 4B 266 次、1.7B 144 次,样本太小)。上表最后一行是按显存占用推算的估计值,标注为待验证,请以你自己的硬件压测为准。
4.2 生成质量分维度(官方模型卡,thinking 模式)
以下全部为官方发布值,评测均在 thinking 模式下进行:
Agent / 工具调用
|
基准 |
Spark-X2.5-4B |
Spark-X2.5-1.7B |
|
BFCL-V4 |
65.1 |
46.9 |
|
τ²-bench |
75.1 |
65.3 |
|
τ³-bench |
30.4 |
20.1 |
|
MCP-Atlas |
54.6 |
23.4 |
|
MCPMark |
14.2 |
2.3 |
|
Workspace Bench |
31.2 |
18.9 |
|
VitaBench 2.0 |
25.2 |
8.3 |
|
BrowseComp |
40.9 |
29.7 |
代码:SWE-Bench Pro 44.4 / SWE-Bench Verified 41.6 / SWE-Bench Multilingual 53.3 / SciCode 34.7
数学:Gaokao 2026 得 133.4(五套 2026 高考数学卷,每套满分 150)/ AIME 2026 90.7 / HMMT Feb 2026 81.2 / IMO-AnswerBench 74.2
通用与知识:IFEval 93.0 / IFBench 75.0 / AA-LCR 56.3 / HLE 12.3 / GPQA 67.4
4.3 同档模型对比
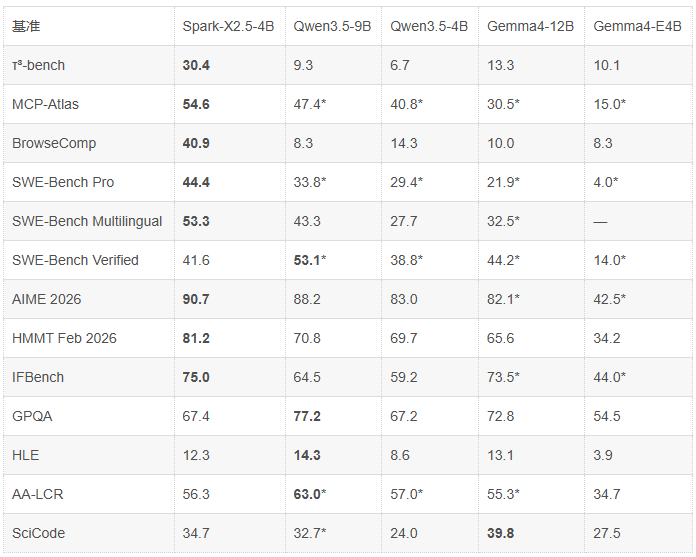
官方模型卡的对比组包含 Qwen3.5 与 Gemma4 系列,注意对比对象里有参数量 2–3 倍于它的模型(来源:官方模型卡,* 号项为对方公开模型卡/论文报告值):
结论:
选型看 workload,别只看单项。 这张表的形状非常清楚——Spark-X2.5-4B 在多步 Agent(τ³-bench 30.4 vs Qwen3.5-9B 的 9.3,3.3 倍)、浏览检索(BrowseComp 40.9 vs 8.3)、竞赛数学、指令遵循这几类上,确实越过了 2–3 倍参数的模型;但在通用科学知识(GPQA 67.4 vs 77.2)、专家级推理(HLE 12.3)、长上下文推理(AA-LCR 56.3 vs 63.0)、单语种 SWE-Bench Verified(41.6 vs 53.1)上仍是 4B 该有的水平,落后于 Qwen3.5-9B 和 Gemma4-12B。
一个值得注意的反差:它 SWE-Bench Pro 拿 44.4 领先全组,但 SWE-Bench Verified 41.6 落后 Qwen3.5-9B 11.5 分。同为代码修复基准,排名反转说明这两套评测的任务分布和 harness 差异不小,别只挑一个当结论。
必须坦诚的部分: 上表所有数字均为厂商自测口径,Spark-X2.5-4B 的分数来自词元星火官方模型卡,对比模型带 * 的来自各自公开模型卡/论文。我没有做任何独立复测,独立第三方(如 Artificial Analysis、LiveBench)的复测结果目前尚未跟进。厂商自测普遍存在 prompt/harness/reasoning effort 三重优势,实际差距通常会收窄。
五、使用建议
适用场景
不适用场景
- 通用知识问答 / 专家级科学推理:GPQA 67.4、HLE 12.3 摆在那里,需要这类能力请直接上 Qwen3.5-9B 以上或云端旗舰,不要指望 4B 补上知识密度。
- 长上下文密集推理生产负载:AA-LCR 56.3 落后同档,且 1M 上下文的 KV Cache 成本在端侧不现实。真要做大规模长文档推理,考虑 Qwen3.5-9B,或走服务端的中型稀疏 MoE(本专栏同日另一篇写的 K2-Horizon-MoVA-36B-A4B 就是这条路线)。
- 多模态需求:纯文本模型,无视觉/音频输入。要看图请转 Qwen3.8-27B 或 DeepSeek-V4-Flash-Vision-Exp。
- 想开箱即用、讨厌编译:这个模型的部署链路目前需要装插件或自编译 runtime(见第三节)。如果你的团队要的是 ollama run 一行命令,等上游 llama.cpp 合并 spark2_5 支持再上。
调优提示
一个 4B 模型在 τ³-bench 上拿到 30.4,是 Qwen3.5-9B(9.3)的 3.3 倍——但在 GPQA 上只有 67.4,比 Qwen3.5-9B 的 77.2 低了近 10 分。
这种"Agent 能力越级、知识密度不足"的分布,我认为是"多领域 RL + 蒸馏合并"这条后训练路线的必然结果:RL 加过的域涨得凶,没加的域就是原始规模的水平。
那么问题来了:在你的实际业务里,你更需要一个"会干活但知识面窄"的 4B,还是一个"知识全面但工具调用平庸"的 9B?
数据来源说明:本文性能数据分别来自词元星火官方模型卡与官方发布稿(Spark-X2.5-4B/1.7B 全部基准分数、架构细节、训练配置、1.7B 端侧时延)、Ollama 官方模型页(采样参数、Ollama 架构支持说明)、启智 AI 开源社区镜像(GGUF 文件体积实测)、DataLearnerAI(参数量与权重体积交叉核对)、以及 Hugging Face / GitHub XHToken 组织仓库(部署命令),均已在正文对应位置标注来源。所有基准均为厂商发布值、且在 thinking 模式下测得,本文未做任何独立复测,最终以独立第三方复测与你自己硬件上的实测为准。文中标注"待验证"的显存推算项请勿直接用于容量规划。
往期回顾:
- 稠密通用大模型K2-Horizon-7B 部署实测:单卡 18.5GB 跑通 512K 上下文
- GLM-5.3-Flash 部署实测:320B MoE 跑出 1/10 推理成本,Agent 编码对标
- 腾讯混元 Hy4 preview 实测:770B MoE 扛 1M 上下文,盲测 2.99 压过
- Apodex-1.1-mini 部署实测:Int4 量化 18GB 单卡跑通 Agent Team,35B 开源
- Meta Muse Glimmer 30B 部署实测:单卡 4090 跑通本地多模态 Agent,DFlas
- .NET 10 推理大模型TensorSharp 3.3.0 部署实测:纯.NET推理引擎反超llama.cpp 1.5倍,DFlash2提速62%