开篇介绍:
hello 大家,本篇博客我们来学习Redis中的hash类型数据。
作为 Redis 五大基础数据类型(String、Hash、List、Set、Zset)中最适合存储结构化数据的类型,Redis Hash(哈希 / 字典)在实际开发中的使用频率仅次于 String,也是面试中 Redis 板块的高频考点。
一、Redis Hash 核心概念:搞懂「嵌套键值对」的本质
在学习任何技术知识点时,先理解概念,再掌握用法是最稳妥的路径,Redis Hash 也不例外
1.1 什么是 Redis Hash?
几乎所有主流编程语言都提供了哈希类型的实现,比如 Java 的HashMap、Python 的dict、Go 的map,它们的核心都是键值对的映射结构,Redis Hash 正是对这种结构的实现。
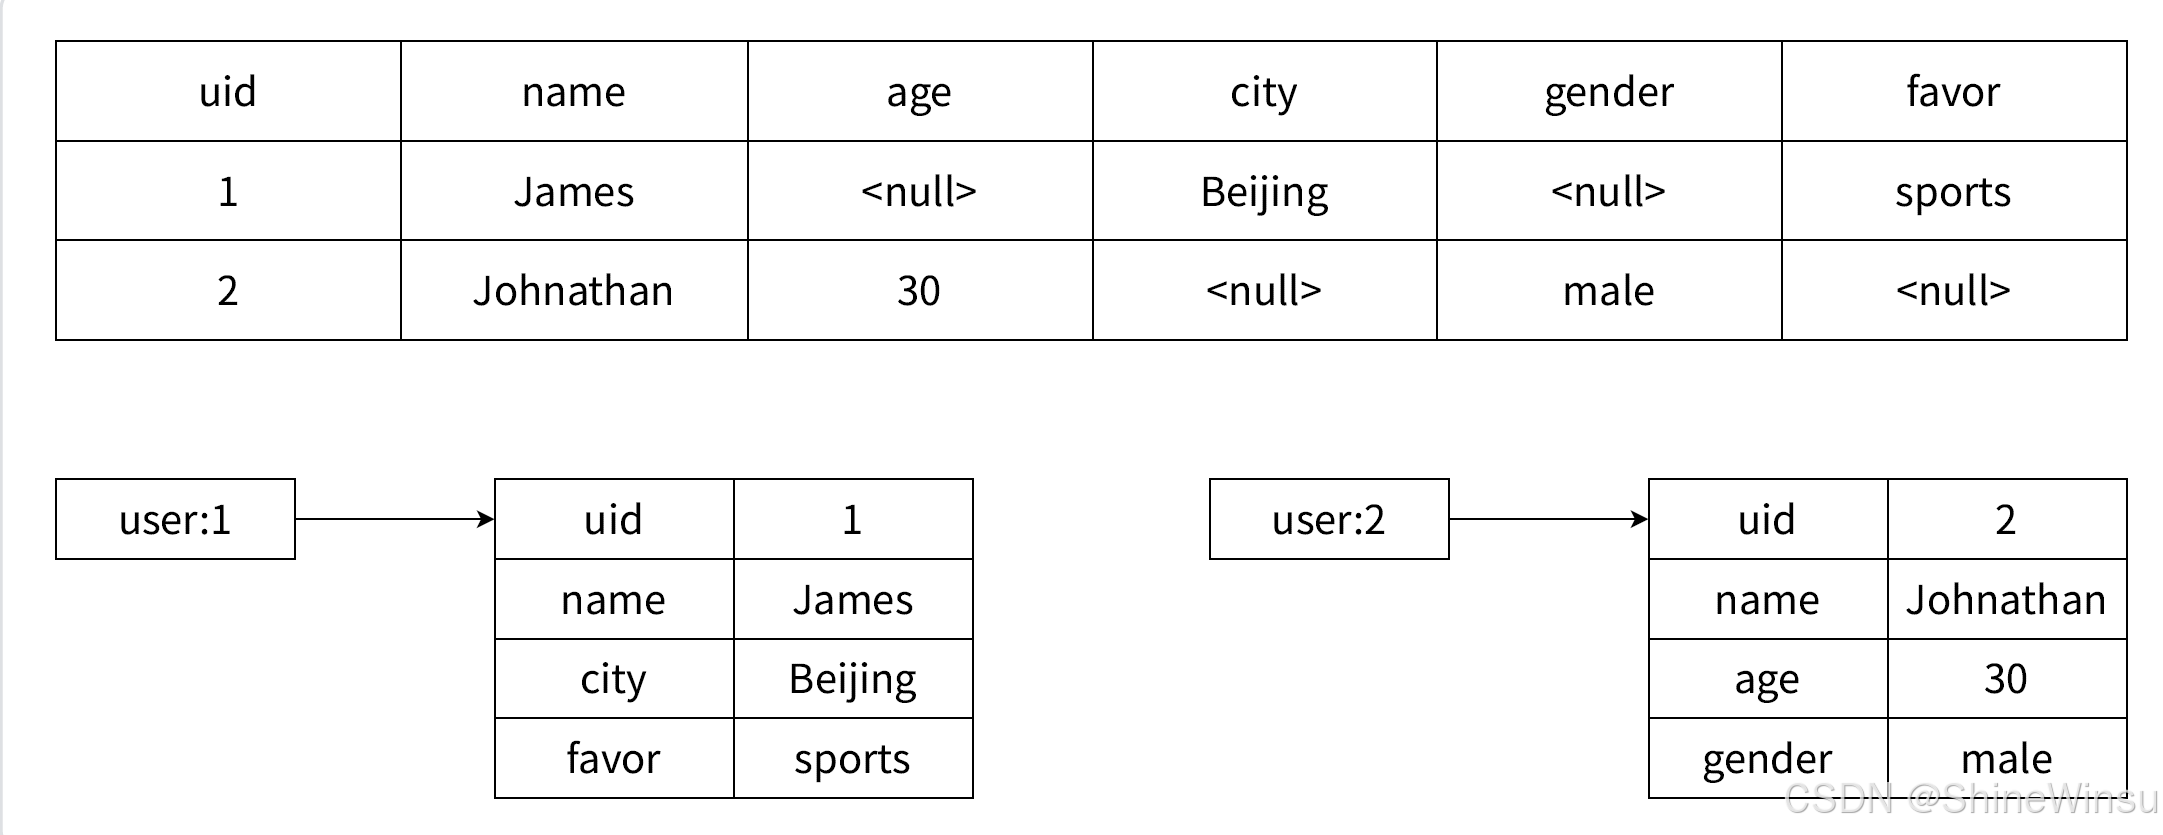
Redis Hash 是指Redis 的 Value 本身又是一个键值对结构,其整体结构可以描述为:Redis Key = 全局键名,Redis Value = {field1:value1, field2:value2, …, fieldN:valueN}。
为了区分 Redis 全局的键值对和 Hash 内部的键值对,Redis 官方将 Hash 内部的映射关系称为field-value(字段 – 值),请务必注意「value」在不同上下文的含义:
- 全局层面:key是 Redis 的键,对应的value是 Hash 整个结构;
- Hash 内部:field是 Hash 的字段,对应的value是该字段的具体值。
用一个简单的公式总结 Redis Hash 的结构:
Redis Hash = Redis Key + {field1:value1, field2:value2, …, fieldN:valueN}
1.2 Redis Hash 与 String 的对比:为什么需要 Hash?
我们以存储用户信息为例(用户 ID=1,姓名 James,年龄 28),分别用 String 和 Hash 实现,直观感受 Hash 的设计初衷。
方式 1:用 String 存储结构化数据
String 是 Redis 的基础类型,只能存储「单一键值对」,要存储用户的多个属性,有两种实现方式:
- 方案 A:单属性单键:为每个属性创建一个 String 键,键名通过「前缀 + 用户 ID + 属性名」区分。
set user:1:name James
set user:1:age 28 - 方案 B:序列化整存整取:将用户对象序列化为 JSON/Protobuf 字符串,存入一个 String 键。
set user:1 '{"name":"James","age":28}'

这两种方式都有明显的问题:方案 A 会创建大量 Redis 键,内存占用高且数据分散;方案 B 修改单个属性时需要整存整取,序列化 / 反序列化有开销,灵活性差。
方式 2:用 Redis Hash 存储结构化数据
Hash 天生为结构化数据设计,一个 Redis 键即可存储一个用户的所有属性,field 对应用户属性名,value 对应属性值:
hset user:1 name James age 28
对比可以发现,Redis Hash 完美解决了 String 存储结构化数据的痛点,既保证了数据的内聚性,又支持单个属性的独立操作,这也是 Hash 的核心设计价值。
1.3 Redis Hash 的核心特性
在使用 Hash 之前,我们需要掌握其 3 个基础特性,避免使用时踩基础坑:
1.4 Redis Hash 的适用场景预判
通过上述概念和对比,我们可以初步判断 Redis Hash 的适用场景:当需要存储「单个对象的多个属性」,且需要对「单个属性独立操作」时,优先使用 Hash。
反之,若数据是单一值(如验证码、计数器)、需要嵌套其他数据类型,或无需独立操作属性,则使用 String 更合适。
二、Redis Hash 核心命令全解析
Redis Hash 提供了近 20 个命令,但核心常用命令仅有 10 余个,我们按照基础增删改查、批量操作、判断统计、数值原子操作、辅助操作5 个模块对命令进行拆解
前置说明:所有命令的测试均基于 Redis 6.2 版本(主流稳定版本),命令均为小写(Redis 命令大小写不敏感),示例中redis> 为 Redis 客户端提示符,(integer) n表示整数返回值。
2.1 基础增删改查模块:操作单个 field-value
这是 Hash 最基础的命令,用于对单个 field 进行增、删、查、改操作,是日常开发中使用频率最高的模块。
2.1.1 HSET:设置单个 / 多个 field-value(核心新增 / 修改命令)
功能:为指定 Redis Hash 设置一个或多个 field-value,若field已存在则覆盖其 value,若 Redis Key 不存在则创建新的 Hash。
语法:hset key field value [field value …]
时间复杂度:设置 1 个 field 为 O (1),设置 N 个 field 为 O (N)
返回值:新增的 field 个数(已存在的 field 被覆盖,不计入返回值)。
实操示例:
# 1. 创建新Hash,设置单个field-value,返回1(新增1个)
redis> hset user:1 name James
(integer) 1
# 2. 为已存在的Hash设置单个field-value,返回1(新增1个)
redis> hset user:1 age 28
(integer) 1
# 3. 覆盖已存在的field,返回0(无新增)
redis> hset user:1 name Jack
(integer) 0
# 4. 批量设置多个field-value,新增2个,返回2
redis> hset user:1 city Beijing gender male
(integer) 2
# 5. 查看设置后的Hash(后续讲解hgetall)
redis> hgetall user:1
1) "name"
2) "Jack"
3) "age"
4) "28"
5) "city"
6) "Beijing"
7) "gender"
8) "male"

hset除了可以新增,也可以对已经存在的key值的内容进行增加和修改哦
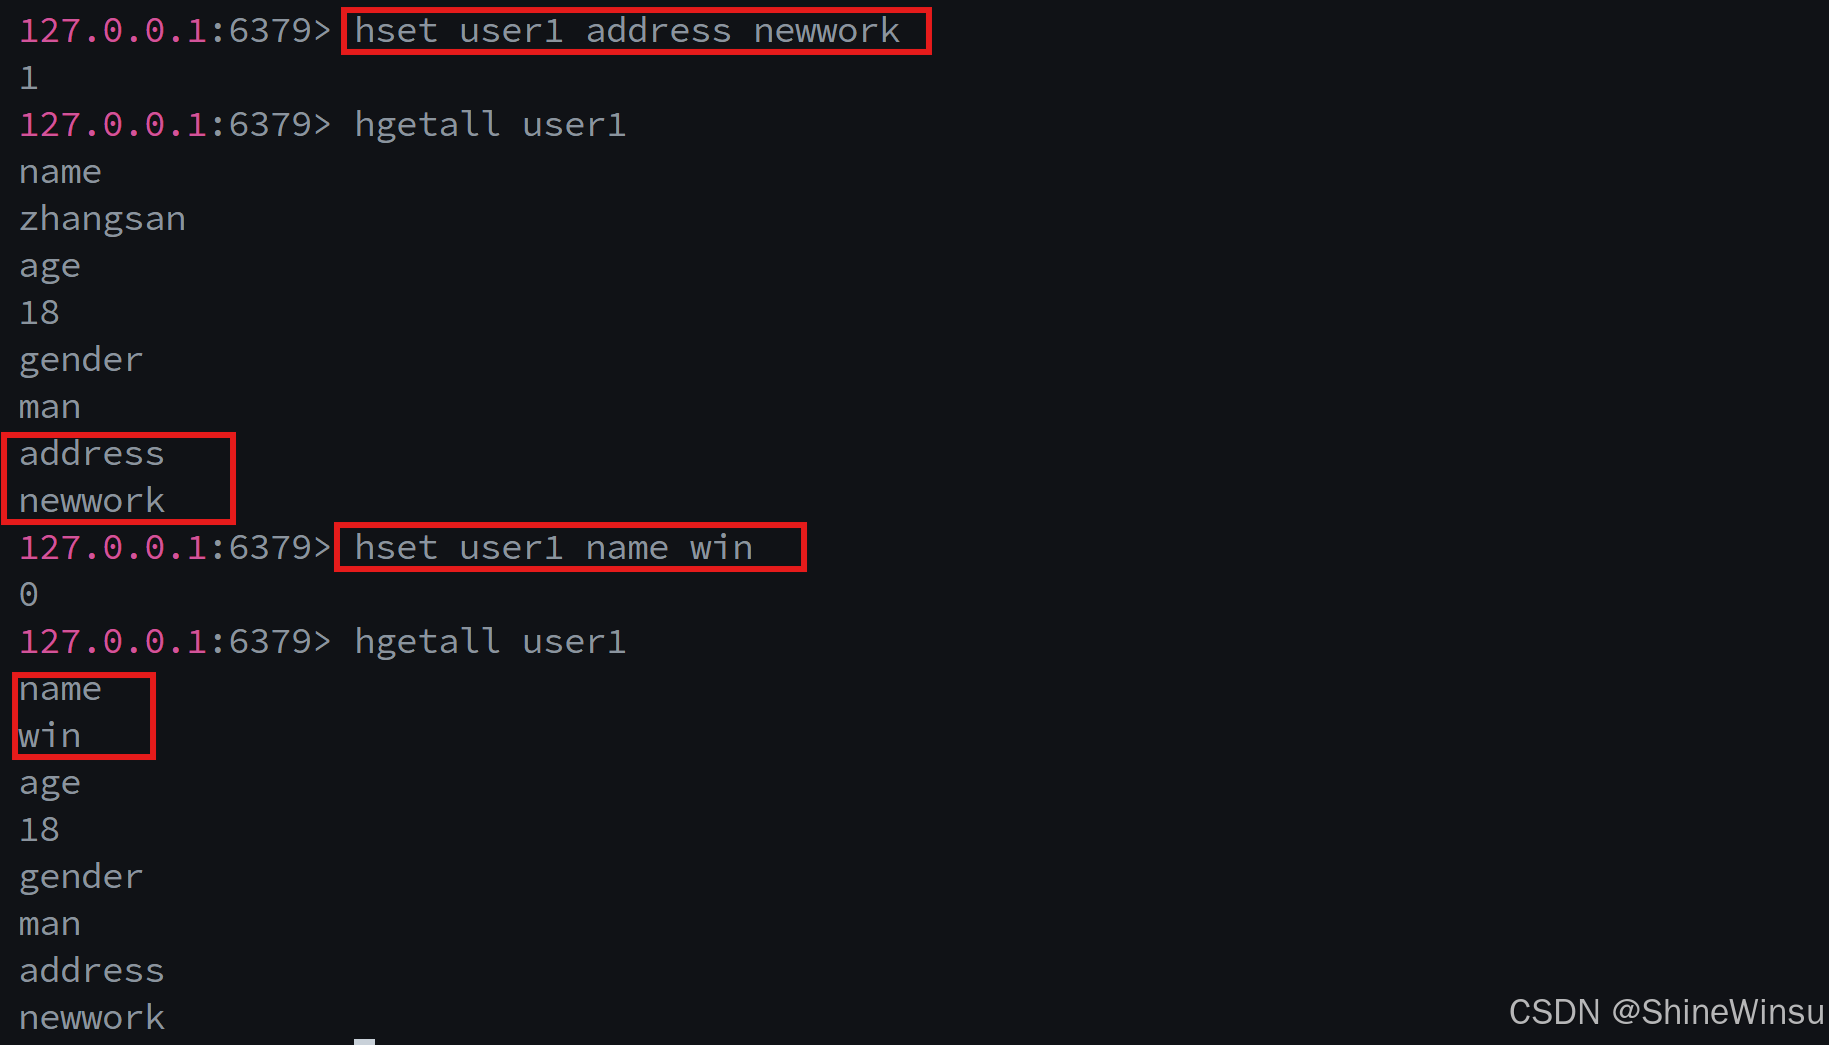
使用注意事项:
- HSET 是新增和修改的合一命令,无需单独的「修改命令」,这是 Redis 命令的设计特点(简化命令集);
- 支持批量设置多个 field-value,批量操作比多次单字段操作性能更高(减少网络 IO 和 Redis 单线程调度);
- 若需要仅当 field 不存在时才设置,请使用后续的 HSETNX 命令,避免误覆盖。
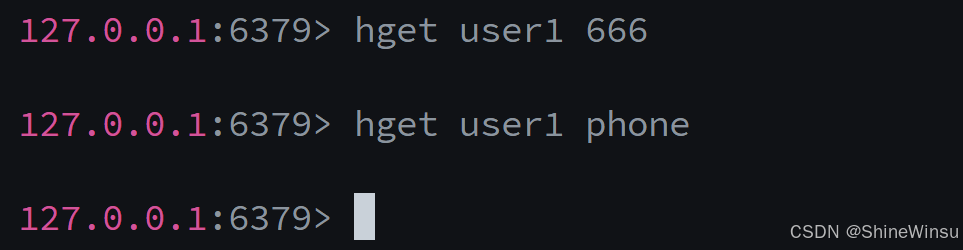
2.1.2 HGET:获取单个 field 的 value
功能:获取指定 Redis Hash 中单个 field 的 value,若 Redis Key 或 field 不存在,返回nil。
语法:hget key field
时间复杂度:O(1)
返回值:field 对应的 value(字符串),不存在则返回nil。
实操示例:
# 1. 获取存在的field,返回对应值
redis> hget user:1 name
"Jack"
# 2. 获取不存在的field,返回nil
redis> hget user:1 height
(nil)
# 3. 获取不存在的Redis Key的field,返回nil
redis> hget user:999 name
(nil)
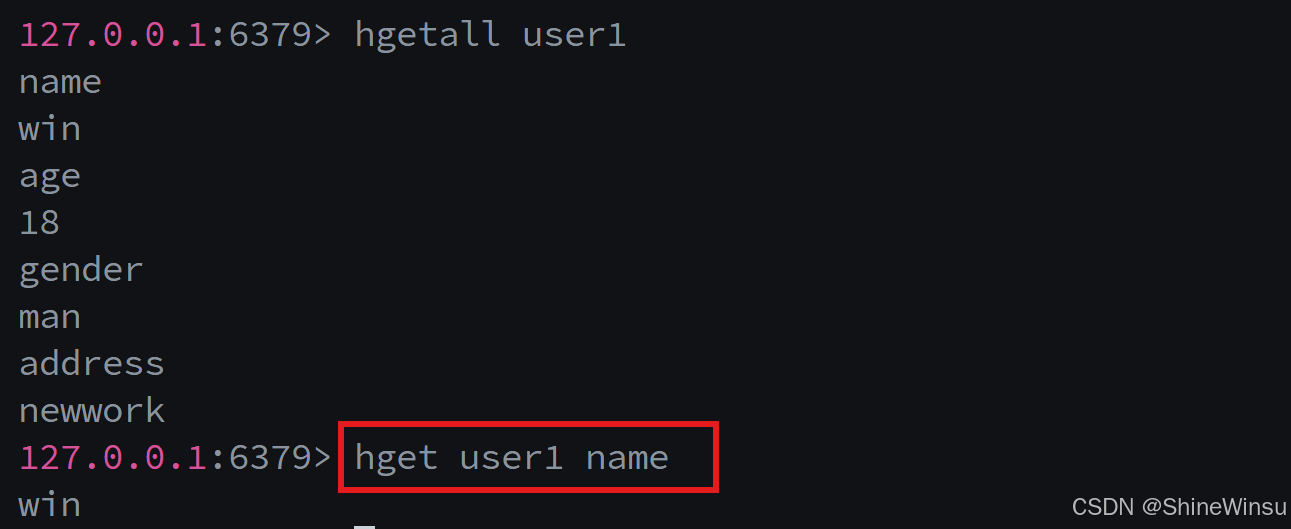
使用注意事项:
- 仅支持获取单个 field,批量获取请使用 HMGET 命令;
- 返回值为原始字符串,若 value 是数字,Redis 仍以字符串返回,客户端需自行转换类型。
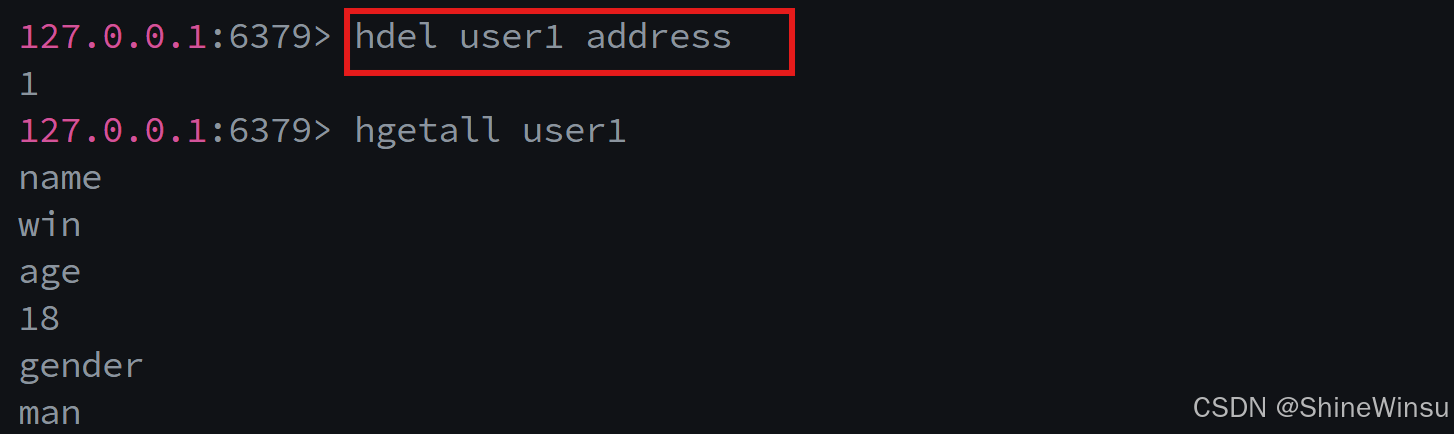
2.1.3 HDEL:删除单个 / 多个 field
功能:删除指定 Redis Hash 中的一个或多个 field,若 Redis Key 或 field 不存在,忽略该操作(不报错)。
语法:hdel key field [field …]
时间复杂度:删除 1 个 field 为 O (1),删除 N 个 field 为 O (N)
返回值:实际删除的 field 个数(不存在的 field 不计入)。
实操示例:
# 1. 删除单个存在的field,返回1
redis> hdel user:1 gender
(integer) 1
# 2. 批量删除多个field,1个存在1个不存在,返回1
redis> hdel user:1 city height
(integer) 1
# 3. 删除不存在的Redis Key的field,返回0
redis> hdel user:999 name
(integer) 0
# 查看删除后的Hash
redis> hgetall user:1
1) "name"
2) "Jack"
3) "age"
4) "28"
使用注意事项:
- 支持批量删除,建议批量操作减少网络请求;
- 若删除 Hash 中最后一个 field(即Hash中只剩下一个field了),该 Redis Key 会被自动删除(Redis 会回收空 Hash 的内存)。
2.2 批量操作模块:操作多个 field-value
当需要同时操作多个 field 时,使用批量命令替代多次单字段命令,将多次网络请求合并为一次,大幅减少网络 IO 开销(Redis 性能瓶颈多在网络,而非内存操作),这是 Redis 性能优化的基础技巧。
2.2.1 HMSET:批量设置 field-value(已被 HSET 替代,兼容保留)
功能:批量设置多个 field-value,功能与 HSET 的批量设置完全一致。
语法:hmset key field value [field value …]
时间复杂度:O (N)(N 为 field 个数)
返回值:设置成功返回OK。
实操示例:
redis> hmset user:2 name John age 30 city Xian
OK
使用注意事项:
- 该命令在 Redis 2.0.0 版本推出,后因 HSET 支持批量设置,在 Redis 3.0.0 版本中被标记为过时,但目前所有版本仍兼容;
- 开发中优先使用 HSET,无需再使用 HMSET,减少命令记忆量。
2.2.2 HMGET:批量获取多个 field 的 value
功能:批量获取指定 Redis Hash 中多个 field 的 value,若 field 不存在,对应位置返回nil。
语法:hmget key field [field …]
时间复杂度:O (N)(N 为 field 个数)
返回值:field 对应的 value 列表,顺序与传入的 field 顺序一致,也就是说即使我们调用该命令传入的field顺序和创建该Hash是传入的field 顺序不同,redis还是会按照创建该Hash是传入的field 顺序进行返回哦
实操示例:
# 1. 批量获取多个存在的field
redis> hmget user:2 name age city
1) "John"
2) "30"
3) "Xian"
# 2. 批量获取,包含不存在的field,对应位置返回nil
redis> hmget user:2 name height gender
1) "John"
2) (nil)
3) (nil)

使用注意事项:
- 返回值列表的顺序与传入的 field 顺序严格一致,客户端处理时需注意对应关系;
- 即使所有 field 都不存在,也会返回等长的 nil 列表,不会返回空。
2.2.3 HGETALL:获取 Hash 中所有的 field-value
功能:获取指定 Redis Hash 中所有的 field 和 value,返回结果为「field1, value1, field2, value2,…」的列表。
语法:hgetall key
时间复杂度:O (N)(N 为 Hash 的 field 总数)
返回值:field 和 value 的交替列表,若 Redis Key 不存在,返回空列表。
实操示例:
# 1. 获取存在的Hash的所有field-value
redis> hgetall user:2
1) "name"
2) "John"
3) "age"
4) "30"
5) "city"
6) "Xian"
# 2. 获取不存在的Redis Key,返回空列表
redis> hgetall user:999
(empty array)
使用注意事项:
- 核心坑点:当 Hash 的 field 数量过多(如上万条)时,HGETALL 会阻塞 Redis 单线程,导致其他命令等待,生产环境需谨慎使用;
- 若需要遍历大量 field 的 Hash,优先使用 HSCAN 命令(渐进式遍历,非阻塞),HSCAN 的基础用法为hscan key 0(0 为遍历起始游标),本文不做超纲讲解,只需记住其「非阻塞遍历」的特性,我们会在后面的文章中进行讲解;
- 仅在 Hash 的 field 数量较少(如几百条以内)时使用 HGETALL。
2.3 判断与统计模块:查询 Hash 的状态信息
该模块的命令用于判断 field 是否存在、统计 Hash 的 field 数量,是开发中常用的辅助命令,时间复杂度均为 O (1),性能极高。
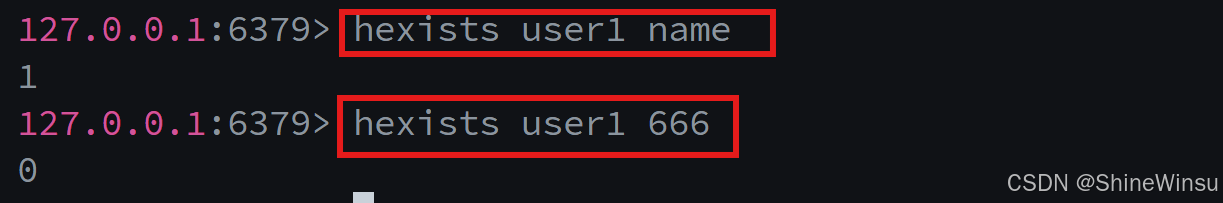
2.3.1 HEXISTS:判断 field 是否存在
功能:判断指定 Redis Hash 中是否存在某个 field,返回布尔型的整数结果。
语法:hexists key field
时间复杂度:O(1)
返回值:存在返回 1,不存在返回 0(Redis Key 不存在也返回 0)。
实操示例:
# 1. field存在,返回1
redis> hexists user:2 name
(integer) 1
# 2. field不存在,返回0
redis> hexists user:2 height
(integer) 0
# 3. Redis Key不存在,返回0
redis> hexists user:999 name
(integer) 0
使用注意事项:
- 该命令是判断 field 存在性的最优方案,比「先 HGET 再判断是否为 nil」更高效(减少一次数据返回);
- 常用于「防止重复设置 field」「判断属性是否存在」的业务场景。
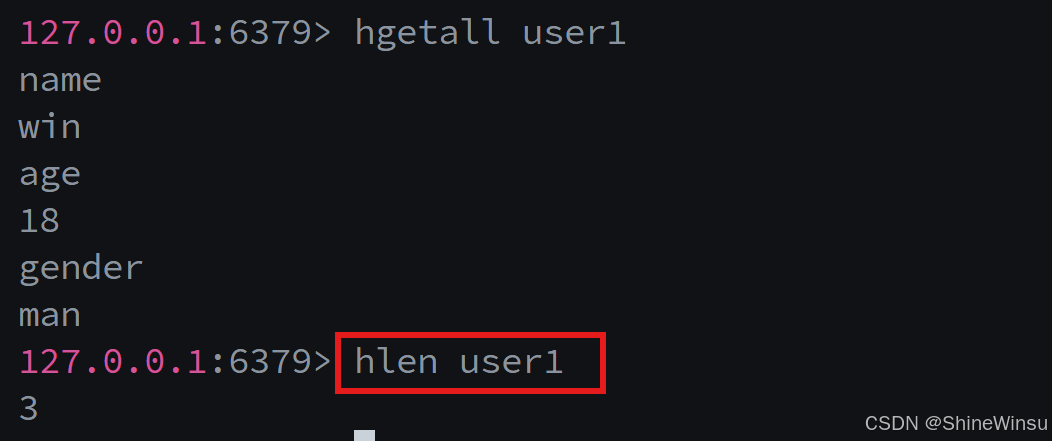
2.3.2 HLEN:统计 Hash 的 field 总数
功能:统计指定 Redis Hash 中的 field 个数,若 Redis Key 不存在,返回 0。
语法:hlen key
时间复杂度:O(1)
返回值:Hash 的 field 总数(整数)。
实操示例:
# 1. 统计存在的Hash的field数
redis> hlen user:2
(integer) 3
# 2. 统计不存在的Redis Key,返回0
redis> hlen user:999
(integer) 0
# 3. 删除后统计,field数减少
redis> hdel user:2 city
(integer) 1
redis> hlen user:2
(integer) 2
使用注意事项:
- Redis 会缓存 Hash 的 field 总数,无需遍历所有 field 统计,因此时间复杂度为 O (1),性能极高;
- 可用于「判断 Hash 是否为空」(hlen key == 0),比 HGETALL 更高效。
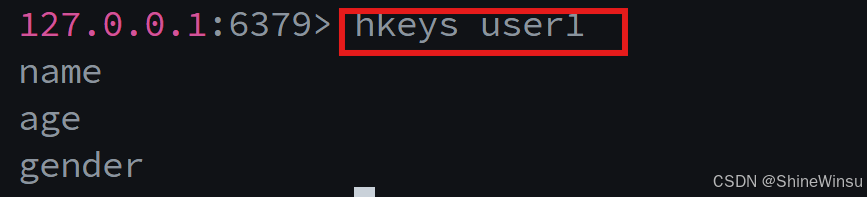
2.3.3 HKEYS:获取 Hash 中所有的 field
功能:获取指定 Redis Hash 中所有的 field,返回 field 列表,若 Redis Key 不存在,返回空列表。
语法:hkeys key
时间复杂度:O (N)(N 为 field 个数)
返回值:field 列表。
实操示例:
redis> hkeys user:2
1) "name"
2) "age"
使用注意事项:
- 与 HGETALL 类似,field 数量过多时会阻塞 Redis 单线程,建议使用 HSCAN 替代;
- 仅在需要单独获取所有 field 名称时使用。
2.3.4 HVALS:获取 Hash 中所有的 value
功能:获取指定 Redis Hash 中所有的 value,返回 value 列表,若 Redis Key 不存在,返回空列表。
语法:hvals key
时间复杂度:O (N)(N 为 field 个数)
返回值:value 列表。
实操示例:
redis> hvals user:2
1) "John"
2) "30"

使用注意事项:
- 同样存在「大 Hash 阻塞」问题,优先使用 HSCAN;
- 仅在需要单独获取所有 value 时使用,无需结合 field 的场景。
2.4 数值原子操作模块:对数字类型 value 做加减运算
Redis Hash 提供了专门的命令对数字类型的 value做原子加减运算,与 String 的 INCR/DECR 命令功能一致,保证高并发下的数值准确性,常用于「计数器」场景(如文章点赞数、商品库存数)。
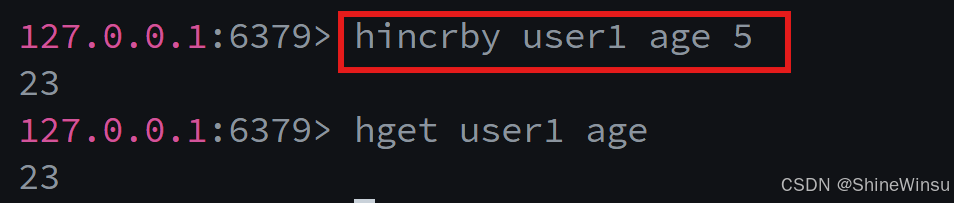
2.4.1 HINCRBY:对 value 做整数原子加减
功能:为指定 Hash 的 field 的 value 加上一个整数增量(增量可正可负,负则为减),若 field 不存在则初始化为 0 后再运算,若 value 非数字则报错。
语法:hincrby key field increment
时间复杂度:O(1)
返回值:运算后的数值(整数)。
实操示例:
# 1. 初始化商品库存,设置stock=100
redis> hset goods:5253 stock 100
(integer) 1
# 2. 库存减1(增量为-1),返回99
redis> hincrby goods:5253 stock -1
(integer) 99
# 3. 库存加5,返回104
redis> hincrby goods:5253 stock 5
(integer) 104
# 4. field不存在,初始化为0后加10,返回10
redis> hincrby goods:5253 sales 10
(integer) 10
# 5. value非数字,报错
redis> hset goods:5253 name "手机"
(integer) 1
redis> hincrby goods:5253 name 1
(error) ERR hash value is not an integer

使用注意事项:
- 增量可以是任意整数(正 / 负),是实现「整数计数器 / 库存」的核心命令;
- 若 field 不存在,Redis 会自动将其初始化为 0,再执行运算,无需提前设置,简化开发;
- 仅支持整数运算,若 value 是浮点数,需使用 HINCRBYFLOAT,非数字类型会直接报错。
2.4.2 HINCRBYFLOAT:对 value 做浮点原子加减
功能:为指定 Hash 的 field 的 value 加上一个浮点增量,功能与 HINCRBY 一致,支持浮点数运算。
语法:hincrbyfloat key field increment
时间复杂度:O(1)
返回值:运算后的数值(浮点数,若为整数则以小数形式返回,如 5→5.0)。
实操示例:
# 1. 设置商品价格为1999.99
redis> hset goods:5253 price 1999.99
(integer) 1
# 2. 价格加10.01,返回2010.0
redis> hincrbyfloat goods:5253 price 10.01
"2010.0"
# 3. 价格减50.5,返回1959.5
redis> hincrbyfloat goods:5253 price -50.5
"1959.5"
# 4. field不存在,初始化为0后加3.14,返回3.14
redis> hincrbyfloat goods:5253 discount 3.14
"3.14"

使用注意事项:
- 支持浮点数和整数增量,是实现「浮点计数器」的核心命令;
- 返回值为字符串类型的浮点数,客户端需自行转换为浮点型;
- 若 value 是整数,会自动转换为浮点数进行运算。
2.5 辅助操作模块:获取 value 长度 / 仅新增 field
该模块是 Hash 的辅助命令,使用频率较低,但在特定场景下能提升开发效率,避免手动实现逻辑。
2.5.1 HSETNX:仅当 field 不存在时设置 value
功能:为指定 Hash 设置 field-value,仅当 field 不存在时才成功,若 field 已存在则不做任何操作,与 HSET 的「覆盖特性」形成互补。
语法:hsetnx key field value
时间复杂度:O(1)
返回值:设置成功返回 1,失败返回 0。
实操示例:
# 1. field不存在,设置成功,返回1
redis> hsetnx user:3 name "Lucy"
(integer) 1
# 2. field已存在,设置失败,返回0
redis> hsetnx user:3 name "Lily"
(integer) 0
# 3. 查看结果,仍为Lucy
redis> hget user:3 name
"Lucy"
使用注意事项:
- 该命令是「防止覆盖」的核心命令,适用于「只能初始化一次,不能修改」的业务场景(如用户首次注册的默认属性);
- 仅支持单个 field,不支持批量设置,这是与 HSET 的重要区别。
2.5.2 HSTRLEN:获取 field 的 value 的字符串长度
功能:获取指定 Hash 的 field 的 value 的字符串长度,若 field 或 Redis Key 不存在,返回 0,若 value 是数字,按其字符串形式计算长度。
语法:hstrlen key field
时间复杂度:O(1)
返回值:value 的字符串长度(整数)。
实操示例:
# 1. 普通字符串,返回5
redis> hset user:3 name "Lucy"
(integer) 1
redis> hstrlen user:3 name
(integer) 4
# 2. 数字类型,按字符串计算,返回2
redis> hset user:3 age 25
(integer) 1
redis> hstrlen user:3 age
(integer) 2
# 3. field不存在,返回0
redis> hstrlen user:3 city
(integer) 0
使用注意事项:
- Redis 会缓存字符串的长度,因此时间复杂度为 O (1),无需遍历字符串计算;
- 可用于「校验 value 长度」的场景(如校验用户昵称长度是否符合要求)。
2.6 核心命令小结:按使用频率排序
为了方便大家快速掌握,我们将 Redis Hash 的核心命令按使用频率从高到低排序,并标注核心用途,建议优先掌握前 10 个命令:
核心原则:批量操作优先于单字段操作,非阻塞遍历(HSCAN)优先于全量获取(HGETALL/HKEYS/HVALS)。
三、Redis Hash 内部编码深度剖析:从原理理解性能差异
这是 Redis Hash 的核心难点,也是生产环境性能优化的关键。很多开发者只知道 Hash 的命令,却不知道其内部编码,导致在使用时出现「内存占用过高」「性能突然下降」的问题。
Redis 为 Hash 设计了两种内部编码,并会根据 Hash 的「field 数量」和「value 大小」自动切换,其设计初衷是平衡「内存占用」和「读写性能」:在 Hash 元素较少时,使用内存更紧凑的编码;在元素较多时,使用读写更高效的编码。
3.1 内部编码的基础认知
在学习具体的编码之前,我们需要掌握 3 个基础认知,避免理解偏差:
3.2 Redis Hash 的两种内部编码
Redis Hash 的内部编码仅有两种:ziplist(压缩列表) 和hashtable(哈希表),Redis 7.0 + 版本新增了listpack(列表包)替代 ziplist,本质是 ziplist 的优化版,用法和触发条件一致,本文以主流的 ziplist 为例讲解。
3.2.1 编码 1:ziplist(压缩列表)—— 内存优先
核心定位:Redis 为小 Hash设计的紧凑存储编码,以牺牲少量读写性能为代价,大幅节省内存。
结构特点:ziplist 是一种连续的内存块,将 Hash 的 field 和 value 按「field1-value1-field2-value2」的顺序紧凑存储,没有额外的元数据开销(如哈希表的指针、哈希桶),内存利用率极高。
读写性能:由于是连续内存,遍历和修改时需要移动内存块,因此读写性能随 field 数量增加而下降,适合 field 数量少、value 小的小 Hash。
触发条件:同时满足以下两个条件时,Redis 使用 ziplist 作为 Hash 的内部编码(默认配置):
上述两个配置是 Redis 的默认配置,可在 redis.conf 配置文件中修改,建议保持默认,无需手动调整(修改可能导致性能问题)。
3.2.2 编码 2:hashtable(哈希表)—— 性能优先
核心定位:Redis 为大 Hash设计的高效读写编码,以牺牲少量内存为代价,保证极致的读写性能。
结构特点:hashtable 的实现与 Java 的HashMap类似,由哈希桶和链表组成,Hash 的 field 作为哈希表的键,通过哈希算法映射到对应的哈希桶,每个哈希桶存储指向 field 和 value 的指针。
读写性能:哈希表的单个 field 的增删改查时间复杂度均为 O (1),不受 field 数量的影响,读写性能稳定,适合 field 数量多、value 大的大 Hash。
内存特点:由于存在哈希桶、指针等元数据开销,且哈希表需要预留哈希桶(避免哈希冲突),因此内存利用率远低于 ziplist,相同的 Hash 数据,hashtable 的内存占用可能是 ziplist 的数倍。
触发条件:只要满足以下任一条件,Redis 就会将 Hash 的内部编码从 ziplist 转为 hashtable:
3.3 内部编码的实际演示:看得到的转换过程
我们通过 Redis 的实际命令,演示 Hash 内部编码的初始状态和三种转换场景,让大家直观感受编码的切换(所有操作基于 Redis 默认配置)。
3.3.1 初始状态:小 Hash 使用 ziplist
创建一个 field 数量少、value 小的 Hash,查看其内部编码为 ziplist:
# 1. 批量设置3个field,value均为短字符串
redis> hmset hash:test f1 v1 f2 v2 f3 v3
OK
# 2. 查看内部编码,为ziplist
redis> object encoding hash:test
"ziplist"
# 3. 统计field数,3 ≤ 512
redis> hlen hash:test
(integer) 3
3.3.2 转换场景 1:value 超过 64 字节,转为 hashtable
为上述 Hash 添加一个 value 超过 64 字节的 field,编码立即转为 hashtable:
# 1. 添加field f4,value为65个字符的字符串(超过64字节)
redis> hset hash:test f4 "12345678901234567890123456789012345678901234567890123456789012345"
(integer) 1
# 2. 查看内部编码,已转为hashtable
redis> object encoding hash:test
"hashtable"
# 3. 删除该大value的field,编码仍为hashtable(单向不可逆)
redis> hdel hash:test f4
(integer) 1
redis> object encoding hash:test
"hashtable"
3.3.3 转换场景 2:field 数量超过 512,转为 hashtable
新建一个 Hash,批量添加 513 个 field,编码转为 hashtable(此处省略批量添加命令,仅演示结果):
# 1. 批量添加513个field,value均为短字符串
redis> hmset hash:big f1 v1 f2 v2 … f513 v513
OK
# 2. 查看内部编码,为hashtable
redis> object encoding hash:big
"hashtable"
# 3. 删除1个field,剩余512个,编码仍为hashtable
redis> hdel hash:big f513
(integer) 1
redis> object encoding hash:big
"hashtable"
3.3.4 转换场景 3:混合条件,任一满足即转换
只要满足「value 超 64 字节」或「field 数超 512」任一条件,编码就会转换,这是 Redis 的懒加载特性,在执行写命令时触发判断。
3.4 两种编码的性能与内存对比
为了让大家更直观的理解两种编码的差异,我们通过表格对 ziplist 和 hashtable 的内存占用、读写性能、适用场景做全面对比:
| 内存占用 | 极低,连续内存无额外开销 | 较高,哈希桶 / 指针有元数据开销 |
| 单 field 操作性能 | O (1)(少量 field),O (N)(大量 field) | 稳定 O (1),不受 field 数量影响 |
| 遍历性能 | 较低,需要移动内存块 | 较高,哈希桶遍历更高效 |
| 适用场景 | field≤512、所有 value≤64 字节的小 Hash | field>512 或任意 value>64 字节的大 Hash |
| 编码转换 | 初始默认编码,可转为 hashtable | 一旦转换,无法转回 ziplist |
核心结论:Redis Hash 的内部编码是「小 Hash 用 ziplist 省内存,大 Hash 用 hashtable 保性能」的自动优化,开发者无需手动干预,只需通过命令查看编码即可。
四、Redis Hash 经典使用场景实战
掌握了 Redis Hash 的概念、命令和内部编码后,我们结合实际互联网业务场景,讲解 Hash 的落地使用方法,每个场景都会做需求分析、实现方案、命令 / 伪代码演示、使用 Hash 的优势分析,让大家学会将知识点转化为实际开发能力。
Redis Hash 的核心适用场景是结构化对象的缓存,本文选取 5 个经典场景:用户信息缓存、商品信息缓存、购物车实现、计数器聚合、订单详情缓存,覆盖电商、社交、资讯等主流互联网业务。
4.1 场景 1:用户信息缓存(最经典场景)
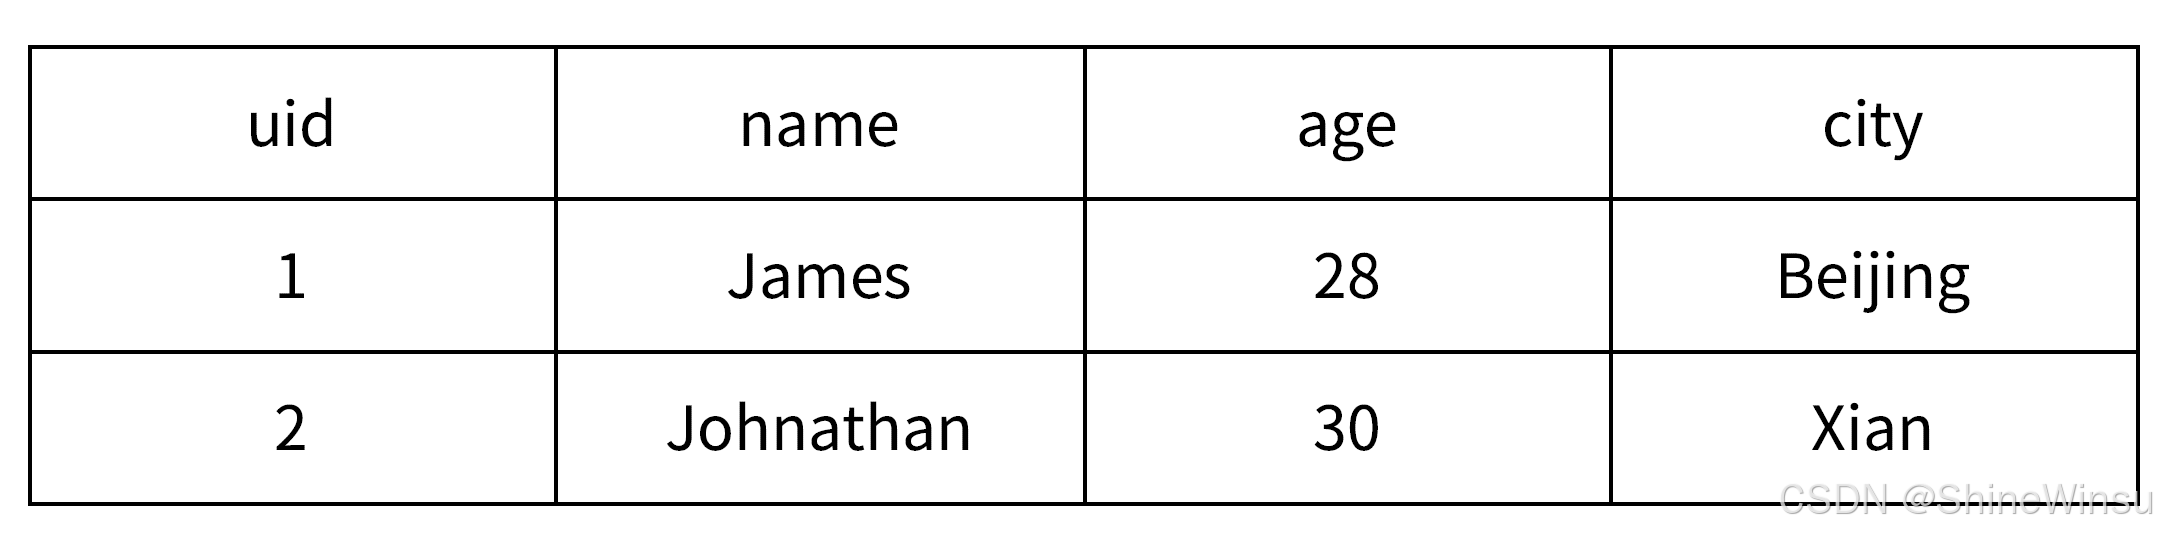
4.1.1 需求分析
几乎所有系统都有用户信息缓存的需求,核心需求:
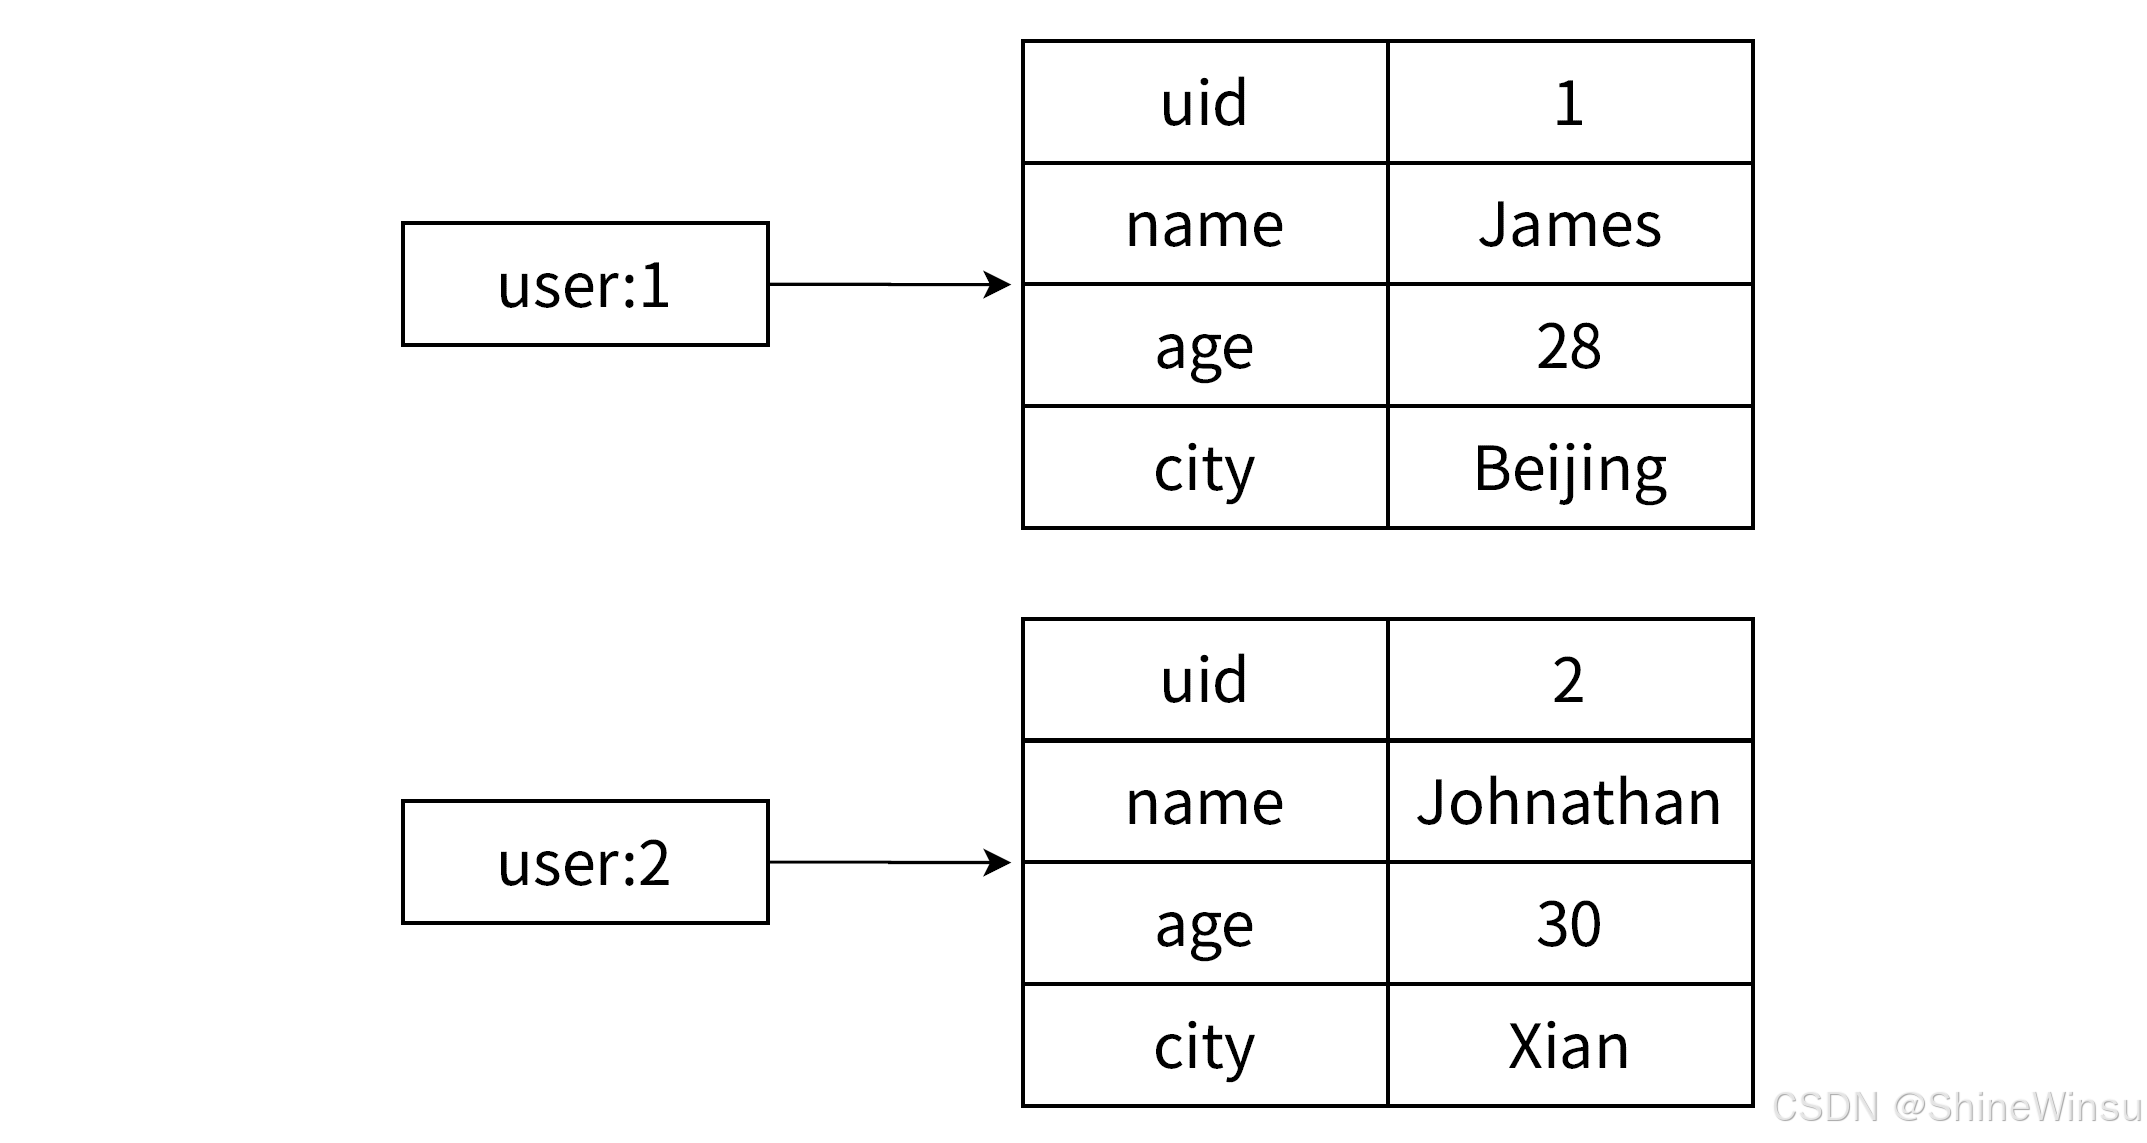
4.1.2 实现方案
4.1.3 实操演示(Redis 命令)
# 1. 从数据库查询用户ID=1001的信息,回写Redis Hash
redis> hmset user:info:1001 name "张三" age 25 phone "13800138000" avatar "https://xxx.jpg" level 2
OK
# 2. 为缓存设置过期时间1小时(3600秒)
redis> expire user:info:1001 3600
(integer) 1
# 3. 查询用户单个属性(头像)
redis> hget user:info:1001 avatar
"https://xxx.jpg"
# 4. 批量查询用户多个属性(姓名、年龄、等级)
redis> hmget user:info:1001 name age level
1) "张三"
2) "25"
3) "2"
# 5. 修改用户等级(单个属性更新)
redis> hset user:info:1001 level 3
(integer) 0
# 6. 用户信息在数据库更新,删除Redis缓存
redis> del user:info:1001
(integer) 1
4.1.4 伪代码实现(Java)
/**
* 根据用户ID获取用户信息,结合Redis Hash缓存
*/
public UserInfo getUserInfo(Long uid) {
// 1. 定义Redis Key
String redisKey = "user:info:" + uid;
Jedis jedis = getJedis();
try {
// 2. 判断缓存是否存在
if (jedis.exists(redisKey)) {
// 3. 缓存命中,批量获取用户核心属性
List<String> values = jedis.hmget(redisKey, "name", "age", "phone", "avatar", "level");
// 4. 封装为UserInfo对象
UserInfo userInfo = new UserInfo();
userInfo.setUid(uid);
userInfo.setName(values.get(0));
userInfo.setAge(Integer.parseInt(values.get(1)));
userInfo.setPhone(values.get(2));
userInfo.setAvatar(values.get(3));
userInfo.setLevel(Integer.parseInt(values.get(4)));
return userInfo;
}
// 5. 缓存未命中,从数据库查询
UserInfo userInfo = userMapper.selectByPrimaryKey(uid);
if (userInfo == null) {
return null;
}
// 6. 将用户信息回写Redis Hash
Map<String, String> hashMap = new HashMap<>();
hashMap.put("name", userInfo.getName());
hashMap.put("age", userInfo.getAge().toString());
hashMap.put("phone", userInfo.getPhone());
hashMap.put("avatar", userInfo.getAvatar());
hashMap.put("level", userInfo.getLevel().toString());
jedis.hmset(redisKey, hashMap);
// 7. 设置过期时间1小时
jedis.expire(redisKey, 3600);
return userInfo;
} finally {
jedis.close();
}
}
/**
* 更新用户等级,删除Redis缓存
*/
public boolean updateUserLevel(Long uid, Integer level) {
// 1. 数据库更新等级
int rows = userMapper.updateLevel(uid, level);
if (rows > 0) {
// 2. 更新成功,删除Redis缓存
Jedis jedis = getJedis();
jedis.del("user:info:" + uid);
jedis.close();
return true;
}
return false;
}
4.1.5 使用 Hash 的优势
4.2 场景 2:商品信息缓存(电商核心场景)
4.2.1 需求分析
电商系统的商品信息缓存与用户信息缓存类似,核心需求:
4.2.2 实现方案
4.2.3 核心 Redis 命令演示
# 1. 回写商品信息缓存
redis> hmset goods:info:5253 name "华为Mate60" price "5999.99" category "手机" stock 1000 sales 0
OK
# 2. 设置过期时间2小时
redis> expire goods:info:5253 7200
(integer) 1
# 3. 商品下单,库存扣1,销量加1(原子操作)
redis> hincrby goods:info:5253 stock -1
(integer) 999
redis> hincrby goods:info:5253 sales 1
(integer) 1
# 4. 商品降价,修改价格(单个属性更新)
redis> hset goods:info:5253 price 5499.99
(integer) 0
# 5. 查询商品库存和销量
redis> hmget goods:info:5253 stock sales
1) "999"
2) "1"
4.3 场景 3:购物车实现(电商经典场景)
4.3.1 需求分析
电商系统的购物车是 Hash 的经典落地场景,核心需求:
4.3.2 实现方案
4.3.3 核心 Redis 命令演示
# 1. 用户1001加购商品5253,数量1
redis> hincrby cart:1001 5253 1
(integer) 1
# 2. 加购商品5253,数量再加1(总数量2)
redis> hincrby cart:1001 5253 1
(integer) 2
# 3. 加购商品6666,数量1
redis> hincrby cart:1001 6666 1
(integer) 1
# 4. 查询购物车所有商品(商品ID-数量)
redis> hgetall cart:1001
1) "5253"
2) "2"
3) "6666"
4) "1"
# 5. 减购商品5253,数量减1(总数量1)
redis> hincrby cart:1001 5253 -1
(integer) 1
# 6. 删除购物车中的商品6666
redis> hdel cart:1001 6666
(integer) 1
# 7. 统计购物车商品数
redis> hlen cart:1001
(integer) 1
4.3.4 使用 Hash 的优势
购物车使用 Hash 实现,比其他方案(如 String 存储 JSON、Set 存储商品 ID)有明显优势:
4.4 场景 4:计数器聚合(社交 / 资讯场景)
4.4.1 需求分析
社交 / 资讯系统中,每篇文章 / 视频都有多个计数器(点赞数、评论数、收藏数、阅读数),核心需求:
4.4.2 实现方案
4.4.3 核心 Redis 命令演示
# 1. 文章10086发布,初始化所有计数器为0
redis> hmset content:count:10086 like 0 comment 0 collect 0 read 0
OK
# 2. 文章被点赞,点赞数加1(原子操作)
redis> hincrby content:count:10086 like 1
(integer) 1
# 3. 文章被阅读,阅读数加10(原子操作)
redis> hincrby content:count:10086 read 10
(integer) 10
# 4. 文章被收藏,收藏数加1(原子操作)
redis> hincrby content:count:10086 collect 1
(integer) 1
# 5. 批量查询所有计数器
redis> hmget content:count:10086 like comment collect read
1) "1"
2) "0"
3) "1"
4) "10"
# 6. 取消点赞,点赞数减1(原子操作)
redis> hincrby content:count:10086 like -1
(integer) 0
4.4.4 伪代码实现(Java)
/**
* 内容计数器操作工具类,基于Redis Hash实现
*/
public class ContentCountUtil {
private static Jedis getJedis() {
return new Jedis("127.0.0.1", 6379);
}
// 初始化内容计数器
public static void initCount(Long contentId) {
String redisKey = "content:count:" + contentId;
Jedis jedis = getJedis();
Map<String, String> initMap = new HashMap<>();
initMap.put("like", "0");
initMap.put("comment", "0");
initMap.put("collect", "0");
initMap.put("read", "0");
jedis.hmset(redisKey, initMap);
jedis.close();
}
// 计数器原子增加
public static Long incrCount(Long contentId, String type, Long step) {
String redisKey = "content:count:" + contentId;
Jedis jedis = getJedis();
Long result = jedis.hincrby(redisKey, type, step);
jedis.close();
return result;
}
// 批量查询计数器
public static Map<String, String> getCountMap(Long contentId) {
String redisKey = "content:count:" + contentId;
Jedis jedis = getJedis();
Map<String, String> countMap = jedis.hgetAll(redisKey);
jedis.close();
return countMap;
}
}
// 业务层调用
// 初始化文章10086计数器
ContentCountUtil.initCount(10086L);
// 文章点赞+1
ContentCountUtil.incrCount(10086L, "like", 1L);
// 文章阅读+10
ContentCountUtil.incrCount(10086L, "read", 10L);
// 获取所有计数器
Map<String, String> countMap = ContentCountUtil.getCountMap(10086L);
4.4.5 使用 Hash 的优势
4.5 场景 5:订单详情缓存(电商核心场景)
4.5.1 需求分析
电商系统的订单详情包含多维度信息(订单基本信息、买家信息、商品信息、支付信息),核心需求:
4.5.2 实现方案
4.5.3 核心 Redis 命令演示
# 1. 订单创建,回写订单详情缓存
redis> hmset order:info:1000001 orderNo "OD202510010001" createTime "2025-10-01 10:00:00" totalAmount "999.00" buyerId "1001" buyerName "张三" buyerPhone "13800138000" goodsId "5253" goodsName "华为Mate60" goodsNum "1" payStatus "0" logisticsStatus "0"
OK
# 2. 查询订单支付状态(0=未支付,1=已支付)
redis> hget order:info:1000001 payStatus
"0"
# 3. 订单支付成功,更新支付状态和支付时间
redis> hset order:info:1000001 payStatus "1" payTime "2025-10-01 10:05:00"
(integer) 1
# 4. 物流发货,更新物流状态
redis> hset order:info:1000001 logisticsStatus "1" logisticsNo "SF1234567890"
(integer) 1
# 5. 全量查询订单详情
redis> hgetall order:info:1000001
1) "orderNo"
2) "OD202510010001"
3) "createTime"
4) "2025-10-01 10:00:00"
5) "totalAmount"
6) "999.00"
7) "buyerId"
8) "1001"
9) "buyerName"
10) "张三"
11) "buyerPhone"
12) "13800138000"
13) "goodsId"
14) "5253"
15) "goodsName"
16) "华为Mate60"
17) "goodsNum"
18) "1"
19) "payStatus"
20) "1"
21) "logisticsStatus"
22) "1"
23) "payTime"
24) "2025-10-01 10:05:00"
25) "logisticsNo"
26) "SF1234567890"
4.5.4 伪代码实现(Java)
/**
* 订单详情缓存操作,基于Redis Hash实现
*/
public class OrderCacheUtil {
private static Jedis getJedis() {
return new Jedis("127.0.0.1", 6379);
}
// 订单创建,写入缓存
public static void setOrderInfo(OrderInfo orderInfo) {
String redisKey = "order:info:" + orderInfo.getOrderId();
Jedis jedis = getJedis();
Map<String, String> hashMap = new HashMap<>();
hashMap.put("orderNo", orderInfo.getOrderNo());
hashMap.put("createTime", orderInfo.getCreateTime());
hashMap.put("totalAmount", orderInfo.getTotalAmount().toString());
hashMap.put("buyerId", orderInfo.getBuyerId().toString());
hashMap.put("buyerName", orderInfo.getBuyerName());
hashMap.put("buyerPhone", orderInfo.getBuyerPhone());
hashMap.put("goodsId", orderInfo.getGoodsId().toString());
hashMap.put("goodsName", orderInfo.getGoodsName());
hashMap.put("goodsNum", orderInfo.getGoodsNum().toString());
hashMap.put("payStatus", orderInfo.getPayStatus().toString());
hashMap.put("logisticsStatus", orderInfo.getLogisticsStatus().toString());
jedis.hmset(redisKey, hashMap);
jedis.close();
}
// 更新订单单个属性
public static void updateOrderField(Long orderId, String field, String value) {
String redisKey = "order:info:" + orderId;
Jedis jedis = getJedis();
jedis.hset(redisKey, field, value);
jedis.close();
}
// 获取订单全量信息
public static Map<String, String> getOrderInfo(Long orderId) {
String redisKey = "order:info:" + orderId;
Jedis jedis = getJedis();
Map<String, String> orderMap = jedis.hgetAll(redisKey);
jedis.close();
return orderMap;
}
// 获取订单单个状态
public static String getOrderStatus(Long orderId, String statusField) {
String redisKey = "order:info:" + orderId;
Jedis jedis = getJedis();
String status = jedis.hget(redisKey, statusField);
jedis.close();
return status;
}
}
// 业务层调用
// 订单创建写入缓存
OrderCacheUtil.setOrderInfo(orderInfo);
// 支付成功,更新支付状态
OrderCacheUtil.updateOrderField(1000001L, "payStatus", "1");
// 获取物流状态
String logisticsStatus = OrderCacheUtil.getOrderStatus(1000001L, "logisticsStatus");
4.5.5 使用 Hash 的优势
五、Redis Hash 与其他缓存方式的深度对比:选对方案比用好命令更重要
在缓存结构化数据时,开发者通常有三种选择:单属性单 String 键、序列化对象为 String、Redis Hash。很多开发者因选错缓存方案,导致 Redis 性能下降、内存浪费、开发效率降低。
5.1 三种缓存方式的实现方式回顾
以用户 ID=1001,姓名张三,年龄 25,手机号 13800138000为例,分别展示三种方式的实现:
set user:1001:name 张三
set user:1001:age 25
set user:1001:phone 13800138000
set user:1001 '{"name":"张三","age":25,"phone":"13800138000"}'
hmset user:1001 name 张三 age 25 phone 13800138000
5.2 六维度深度对比
| 内存占用 | 极高,每个键都有元数据开销,键数量多导致内存浪费 | 较低,单个键元数据开销,序列化后字节数适中 | 极低,单个键元数据开销,ziplist 编码紧凑存储 |
| 操作灵活性 | 高,支持单个属性独立增删改查 | 极低,修改单个属性需整存整取,序列化 / 反序列化 | 极高,支持单个 / 批量属性独立增删改查 |
| 性能表现 | 差,多属性操作需多次网络请求,网络 IO 高 | 中,全量操作性能高,单个属性操作性能低 | 优,单 / 批量操作均为一次网络请求,原子操作保障高并发 |
| 开发成本 | 高,需维护大量键名,代码冗余 | 低,对象序列化 / 反序列化一键操作 | 中,需设计 field 名,命令稍多但逻辑清晰 |
| 数据内聚性 | 差,属性分散在不同键,无内聚性 | 高,所有属性在一个键,内聚性强 | 高,所有属性在一个键,内聚性强 |
| 异常风险 | 高,键数量过多易导致 Redis 键管理混乱,查找困难 | 中,序列化 / 反序列化可能出现版本兼容问题 | 低,field 设计规范即可,无额外异常风险 |
5.3 明确的选型建议
5.3.1 优先选择 Redis Hash 的场景
当需要缓存「结构化对象」,且满足以下任一条件时,优先使用 Redis Hash:
这是 Redis Hash 的核心适用场景,也是实际开发中最常见的场景,覆盖 80% 以上的结构化数据缓存需求。
5.3.2 选择序列化对象为 String 的场景
当需要缓存「结构化对象」,且满足以下所有条件时,选择序列化 String:
5.3.3 选择单属性单 String 键的场景
仅在特殊业务场景下使用,一般不推荐,如:
核心原则:能使用 Redis Hash 的场景,绝不使用单属性单 String 键;全量操作的结构化对象,可选择序列化 String。
六、Redis Hash 生产环境避坑指南与性能优化
很多开发者掌握了 Redis Hash 的命令和使用场景,却在生产环境中踩坑,导致内存占用飙升、Redis 阻塞、性能下降等问题。本质原因是忽略了 Hash 的内部编码特性、命令的性能差异、生产环境的特殊要求。
本节总结了生产环境中 Redis Hash 的8 大高频坑点,每个坑点包含问题表现、根本原因、优化方案,同时给出通用性能优化原则,让你从「能用」Redis Hash 走向「用好」Redis Hash,发挥其极致性能。
6.1 坑 1:忽视内部编码转换,导致 Redis 内存飙升
问题表现
前期使用 Hash 缓存数据时内存占用极低,后期突然出现内存占用飙升,Redis 内存使用率快速上涨,甚至触发内存淘汰机制。
根本原因
优化方案
6.2 坑 2:大 Hash 滥用 HGETALL/HKEYS/HVALS,阻塞 Redis 单线程
问题表现
Redis 偶尔出现命令阻塞,其他业务的 Redis 操作响应缓慢,排查发现是某几个 Hash 执行了 HGETALL/HKEYS/HVALS 命令。
根本原因
优化方案
redis
# 从游标0开始,每次遍历100个field,返回下一个游标和遍历结果
hscan key 0 COUNT 100
6.3 坑 3:滥用 HSETNX,不了解其单字段限制,导致开发错误
问题表现
开发者试图使用 HSETNX 批量设置多个 field,期望「所有 field 都不存在时才设置成功」,但实际命令执行报错,或实现逻辑与预期不符。
根本原因
HSETNX 仅支持单个 field 的新增判断,不支持批量操作,Redis 官方未提供批量版的 HSETNX,若传入多个 field-value,命令会直接报错。
优化方案
— 批量HSETNX脚本:KEYS[1]为Redis Key,ARGV为field1,value1,field2,value2…
local key = KEYS[1]
for i=1,#ARGV,2 do
local field = ARGV[i]
local value = ARGV[i+1]
if redis.call('HEXISTS', key, field) == 1 then
return 0
end
end
for i=1,#ARGV,2 do
local field = ARGV[i]
local value = ARGV[i+1]
redis.call('HSET', key, field, value)
end
return 1
6.4 坑 4:未规范设计 Key 和 Field,导致 Redis 维护困难
问题表现
Redis 中 Hash 的 Key 和 Field 命名混乱,如u1001、name1、user_1001_age,后期排查问题、数据迁移、业务迭代时,无法快速识别键和字段的含义,维护成本极高。
根本原因
未遵循统一的Key/Field 命名规范,开发人员随意命名,导致 Redis 键空间混乱。
优化方案
遵循见名知意、统一规范、分层设计的原则,制定 Redis Hash 的 Key 和 Field 命名规范,全网统一执行:
- 业务前缀:如user、goods、order、content(多业务共享 Redis 时必加);
- 模块名:如info、count、cart(区分同一业务的不同模块);
- 唯一标识:如用户 ID、商品 ID、订单 ID(区分同一模块的不同实例);
- 示例:user:info:1001、goods:count:5253、order:info:1000001。
- 全小写,使用下划线_分隔多单词(如pay_status、logistics_no);
- 与数据库表的列名保持一致,减少开发记忆成本;
- 避免使用无意义的字段名(如f1、f2),字段名需直观表达属性含义;
- 示例:name、age、pay_status、total_amount。
6.5 坑 5:忽略 Hash 的 value 类型限制,尝试嵌套其他数据类型
问题表现
开发者试图将 List/Set/Hash 等 Redis 数据类型直接存入 Hash 的 value 中,命令执行报错,或序列化后存储导致操作灵活性丧失。
根本原因
Redis Hash 的value 仅支持字符串类型,不支持嵌套其他数据类型,若直接传入非字符串类型,Redis 会直接报错;若序列化后存储,会失去原数据类型的操作特性。
优化方案
# 1. Hash存储用户核心信息,收藏列表单独存储为Set
hmset user:info:1001 name 张三 age 25 collect_key "user:collect:1001"
# 2. Set存储用户收藏的商品ID
sadd user:collect:1001 5253 6666 7777
6.6 坑 6:批量操作时一次性操作过多 Field,导致 Redis 阻塞
问题表现
使用 HSET/HMGET 批量操作 Hash 时,一次性传入上千甚至上万个 field,导致 Redis 命令执行时间过长,阻塞单线程。
根本原因
虽然批量操作能减少网络 IO,但 Redis 的单线程模型对单个命令的执行耗时有严格要求,一次性操作过多 field 会导致命令执行时间超过阈值,阻塞后续命令。
优化方案
6.7 坑 7:缓存更新策略不当,导致缓存与数据库数据不一致
问题表现
修改数据库中的结构化对象后,Redis Hash 的缓存未及时更新,导致业务读取到脏数据;或缓存更新方式错误,导致高并发下的数据不一致。
根本原因
优化方案
- 核心策略:先更新数据库,再删除缓存(而非更新缓存),避免高并发下的数据不一致;
- 原因:删除缓存后,后续请求会从数据库查询并回写缓存,保证数据一致性;若直接更新缓存,高并发下会出现多个客户端同时更新缓存,导致数据覆盖。
- 缓存穿透:对不存在的对象,缓存空值(设置短过期时间,如 60 秒);
- 缓存击穿:对热点 Hash 缓存,设置永不过期,由业务主动更新;
6.8 坑 8:将 Hash 用于非结构化数据存储,浪费其特性
问题表现
开发者将非结构化数据(如大文本、二进制流、单一值)存储为 Redis Hash,仅使用一个 field,导致 Redis Hash 的特性无法发挥,还增加了命令复杂度。
根本原因
对 Redis Hash 的适用场景理解偏差,认为「Hash 是万能的结构化存储」,忽视了其设计初衷是多属性结构化对象的缓存。
优化方案
- 错误:hset sms:code:13800138000 code 123456(单一值用 Hash);
- 正确:set sms:code:13800138000 123456(单一值用 String)。
- 单一值 / 计数器 / 验证码:String;
- 多属性结构化对象:Hash;
- 有序列表 / 消息队列:List;
- 无序唯一集合:Set;
- 有序唯一集合:Zset。
6.9 Redis Hash 通用性能优化原则
除了避开上述 8 大坑点,遵循以下通用优化原则,能让 Redis Hash 的性能发挥到极致:
七、Redis Hash 核心知识点大总结:
Redis Hash 作为 Redis 五大基础数据类型中最适合存储结构化数据的类型,核心知识点围绕概念、命令、内部编码、使用场景、优化原则展开,本节将所有核心知识点进行梳理,形成清晰的知识体系,方便快速记忆和复习。
7.1 核心概念:一句话讲透
Redis Hash 是Redis Value 为嵌套键值对的结构化数据类型,以Redis Key + {field:value}的形式存在,field 唯一,field 和 value 均为二进制安全的字符串,不支持嵌套其他数据类型,天生为缓存结构化对象设计。
7.2 核心命令:按模块分类,掌握高频即可
无需死记所有命令,按使用频率和功能模块分类,掌握以下10 个核心高频命令,即可满足 90% 以上的开发需求:
| 基础增删改查 | HSET/HGET/HDEL | 单 / 批量设置 / 获取 / 删除 field | O(1)/O(N) | HSET 是新增 / 修改合一,支持批量 |
| 批量操作 | HMGET | 批量获取多个 field 的 value | O(N) | 返回值顺序与 field 顺序一致 |
| 判断统计 | HEXISTS/HLEN | 判断 field 是否存在 / 统计 field 数 | O(1) | HLEN 缓存结果,性能极高 |
| 原子计数 | HINCRBY | 整数型 value 的原子加减 | O(1) | field 不存在则初始化为 0 |
| 仅新增 | HSETNX | 仅当 field 不存在时设置 | O(1) | 不支持批量操作 |
| 全量查询 | HGETALL | 获取所有 field-value | O(N) | 大 Hash 禁止使用,替换为 HSCAN |
7.3 内部编码:两大编码,自动切换,内存与性能的平衡
Redis Hash 有两种内部编码,由 Redis 根据 field 数量和 value 大小自动切换,编码单向不可逆,核心要点:
核心优化点:通过控制 field 数量和 value 大小,让 Hash 始终保持 ziplist 编码。
7.4 经典使用场景:5 大场景,覆盖主流业务
Redis Hash 的核心适用场景是结构化对象的缓存,五大经典场景覆盖电商、社交、资讯等主流互联网业务:
7.5 核心优化原则:五大原则,避开所有坑
7.6 选型原则:三选一,别选错
缓存结构化数据时,从单属性单 String、序列化 String、Redis Hash中选择,核心选型原则:
- 需单个属性独立操作 / 原子计数:选 Redis Hash;
- 仅全量操作结构化对象:选序列化 String;
- 特殊场景需单独设置属性过期时间:选单属性单 String(尽量避免)。
结语
到这里,Redis Hash 类型从核心概念、命令体系、内部编码到实战场景、生产避坑的完整讲解就全部结束了。作为 Redis 中专为结构化数据而生、使用频率仅次于 String的核心类型,Hash 完美解决了传统 String 在存储对象时 “键分散难管理、修改需全量序列化、属性操作不灵活” 的痛点,也是我们在实际业务中缓存用户、商品、订单、购物车等数据的首选方案。
回顾整篇内容,我们始终围绕一个核心逻辑展开:先理解设计本质,再掌握使用方法,最后守住生产规范。我们明白了 Hash 是「外层 Key + 内层 field-value」的嵌套键值结构,对比了它与两种 String 缓存方案的优劣;熟练掌握了 HSET/HGET/HMGET/HINCRBY 等高频核心命令,知道了批量操作优于单次请求、原子计数优于客户端计算;深入底层理解了 ziplist 与 hashtable 两种编码的自动切换规则,这是 Redis 平衡内存占用与读写性能的关键设计,也是生产环境内存优化的核心抓手;同时落地了五大经典业务场景,从用户信息缓存到电商购物车、聚合计数器,覆盖了互联网开发中绝大多数结构化数据需求。
更重要的是,我们梳理了生产环境中 8 个高频坑点:忽视编码转换导致内存暴涨、大 Hash 滥用 HGETALL 阻塞单线程、命名不规范、缓存更新策略错误等,这些都是从 “会用 Hash” 到 “用好 Hash” 的必经之路。Redis 的强大从来不止于命令本身,而在于基于底层原理做合理设计、基于业务场景做正确选型、基于单线程模型做规范操作。
Hash 类型的学习,也是 Redis 数据结构体系的重要一环。它和 String 共用底层存储思想,和后续要学习的 List、Set、Zset 共享 ziplist、hashtable 等底层结构,编码自动切换、渐进式遍历、原子操作、批量优化等设计思想完全相通。学好 Hash,不仅能解决 80% 的结构化缓存问题,更为后续所有数据类型的学习打下了统一的认知基础。
最后想跟大家说:Redis 的学习切忌只背命令、不碰原理、不练实战。建议大家把文中的命令、编码转换示例、业务伪代码在本地环境亲手跑一遍,观察 object encoding 的变化,体会批量操作的性能差异,模拟大 Hash 阻塞的场景,真正把知识转化为能力。