/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
大家好,我是程序员大海
从生产者到消费者分析可靠性(附 Java 实战代码)
分类:Java / 分布式 / 消息队列 标签:Kafka、Spring Boot、Java 后端
一、前言
在 Java 后端开发中,Kafka 经常被用于订单处理、异步通知、日志收集等场景。例如,用户下单后,系统需要发送订单事件,由下游服务完成积分发放、库存处理或发送通知。
如果订单已经创建成功,但下游服务迟迟没有处理对应消息,就需要考虑:Kafka 消息究竟在哪个环节出了问题?
消息丢失不一定是 Kafka 本身的问题。生产者发送失败、Broker 副本配置不合理、消费者提前提交 offset,甚至数据库事务与消息发送之间的时序问题,都可能导致业务层面出现消息丢失。
二、消息在哪些环节可能丢失?
先看一条消息的完整流转过程:
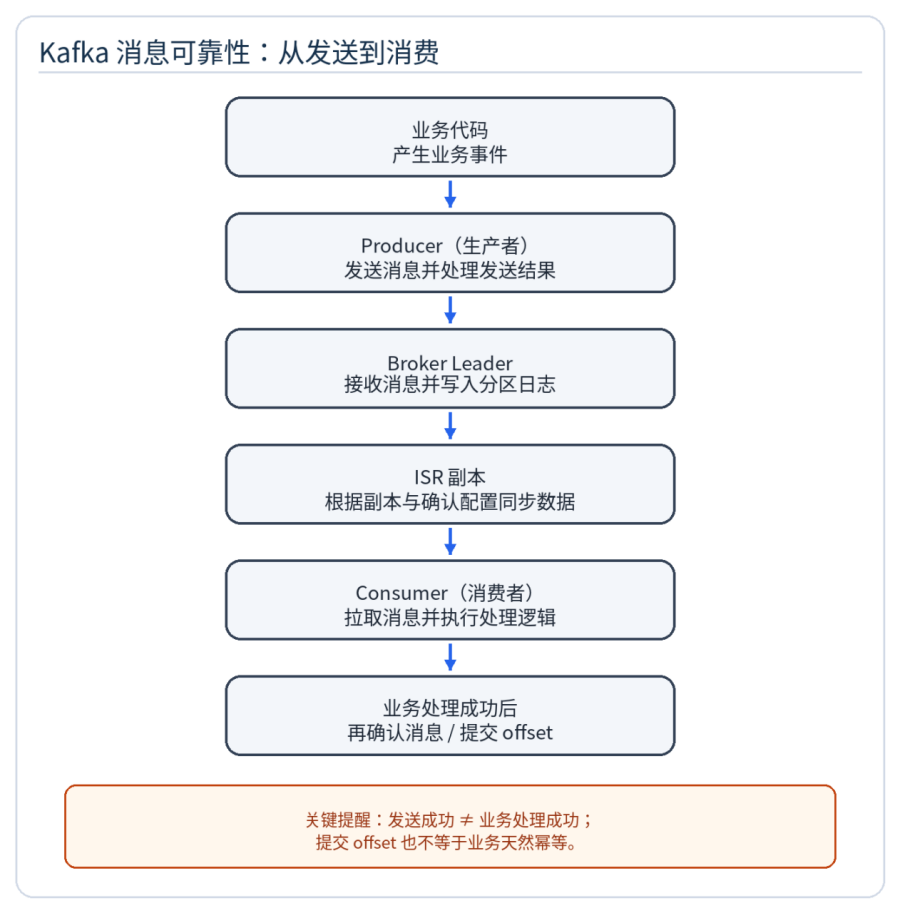
生产者环节:消息没有成功发送到 Kafka,或者发送失败后没有得到正确处理。
Broker 环节:消息已经写入,但副本配置或故障处理方式不合理,导致消息可能丢失。
消费者环节:消息已经被拉取,但业务尚未处理完成,offset 就已经提交。
数据库与 Kafka 双写:数据库事务已经提交,但对应消息没有可靠地发布到 Kafka。
因此,解决消息丢失问题不能只修改某一个参数,而应该从整个业务流程分析。
三、生产者:如何保证消息可靠发送?
3.1 acks 参数有什么作用?
Kafka 生产者通过 acks 参数控制需要等待多少确认,才能将一次发送视为成功。
配置含义主要风险
acks=0不等待 Broker 确认无法确认消息是否到达 Broker
acks=1等待 Leader 确认写入Leader 故障且副本尚未同步时,消息可能丢失
acks=all等待当前 ISR 副本确认副本不足时可能拒绝写入,发送延迟也可能增加
这里需要注意:acks=all 并不意味着等待所有配置的副本,而是等待当前 ISR(In-Sync Replicas,同步副本集合)中的副本确认。
例如,一个分区有三个副本,其中一个副本暂时落后,不在 ISR 中,那么 acks=all 等待的是当前 ISR 中的副本,而不是无条件等待三个副本全部确认。
在这里插入图片描述
对于可靠性要求较高的业务,可以考虑 acks=all,并结合合理的副本配置。
3.2 Spring Boot 中如何配置?
spring:
kafka:
producer:
acks: all
properties:
"[enable.idempotence]": true
这里配置了两个关键参数:
acks: all:等待当前 ISR 中的副本确认。
enable.idempotence: true:启用生产者幂等性,降低生产者重试造成重复写入的风险。
现代 Kafka Java 客户端在配置兼容时通常默认启用幂等性,但显式配置有助于表达可靠性要求。幂等生产者主要处理生产者自身重试引起的重复写入,不能自动识别业务代码重复调用两次 send() 产生的两条独立消息。
3.3 发送失败了,业务代码应该怎么处理?
使用 Spring Kafka 时,可以通过 KafkaTemplate 发送消息。以下示例适用于使用 CompletableFuture 的 Spring Kafka 3.x:
public void sendOrderMessage(String orderId, String message) {
kafkaTemplate.send("order-events", orderId, message)
.whenComplete((result, ex) -> {
if (ex != null) {
log.error("Kafka 消息发送失败,orderId={}", orderId, ex);
// 生产环境还需要配合可靠的重试、
// 持久化补偿等机制
return;
}
var metadata = result.getRecordMetadata();
log.info(
"消息发送成功,topic={}, partition={}, offset={}",
metadata.topic(),
metadata.partition(),
metadata.offset()
);
});
}
这里需要关注两个问题:
不能忽略发送失败。如果消息发送失败后只打印日志,没有补偿措施,关键消息仍然可能丢失。
不能把调用 send() 当成消息已经发送成功。send() 通常是异步操作,应根据返回结果判断发送是否成功。
上面的代码展示了发送结果处理方式,但没有实现可靠的失败补偿。订单等关键业务通常还需要消息持久化、重试和监控。
四、Broker:消息写入后,为什么仍然可能丢失?
4.1 理解副本机制
Kafka 的一个分区可以有多个副本,其中一个副本担任 Leader,其他副本作为 Follower。生产者通常向 Leader 发送消息,Follower 从 Leader 同步数据。
如果生产者使用 acks=1,Leader 确认消息后即可返回成功,不必等待 Follower 全部同步。此时,如果 Leader 确认消息后立即发生故障,而消息尚未同步到其他副本,就存在消息丢失的风险。
因此,对于重要业务,通常需要合理配置副本数量,并结合 acks=all 使用。
4.2 replication.factor 与 min.insync.replicas
replication.factor:分区的副本数量。
min.insync.replicas:使用 acks=all 时,允许写入成功所要求的最小同步副本数量。
replication.factor = 3
min.insync.replicas = 2
acks = all
这意味着:
一个分区配置三个副本。
生产者要求当前 ISR 中的副本确认写入。
如果 ISR 数量少于两个,写入会失败,而不是在副本不足时继续接受写入。
注意,min.insync.replicas=2 并不代表每次写入只需要两个副本确认。如果三个副本都处于 ISR 中,acks=all 仍然要求三个副本全部确认。
实际应用时,还需要确保集群中有足够的 Broker,并为目标 Topic 设置相应的副本与同步副本策略。单节点开发环境无法体现多副本容错能力。
五、消费者:为什么消息已经拉取,却没有完成处理?
5.1 offset 是什么?
Kafka 中,每个分区的消息都有自己的 offset,可以将它理解为消息在该分区中的位置标识。消费者组通过提交 offset,记录消费进度,以便重启后继续消费。
offset 100:订单 A
offset 101:订单 B
offset 102:订单 C
如果消费者读取了订单 A 和订单 B,但订单 B 还没有处理完成,就提前提交了后续 offset。消费者崩溃后,重启可能从已经提交的位置继续消费,导致尚未完成处理的消息被跳过。
因此,offset 提交时机不合理,是消费者端出现消息丢失的重要原因之一。
5.2 关闭自动提交,采用手动确认
spring:
kafka:
consumer:
enable-auto-commit: false
listener:
ack-mode: manual_immediate
这里关闭了 Kafka 消费者的自动提交,并将监听器确认模式设置为 MANUAL_IMMEDIATE。接下来,可以通过 Acknowledgment 控制确认时机。
@KafkaListener(
topics = "order-events",
groupId = "order-service"
)
public void consume(
String message,
Acknowledgment acknowledgment) {
// 先完成实际业务处理
orderService.process(message);
// 业务处理成功后,再确认消息
acknowledgment.acknowledge();
}
需要保证 orderService.process() 返回时,要求的业务处理已经真正完成。如果业务处理抛出异常,不应继续执行确认操作;异常应交给已配置的错误处理机制,例如有限次数重试和死信队列(DLT)。
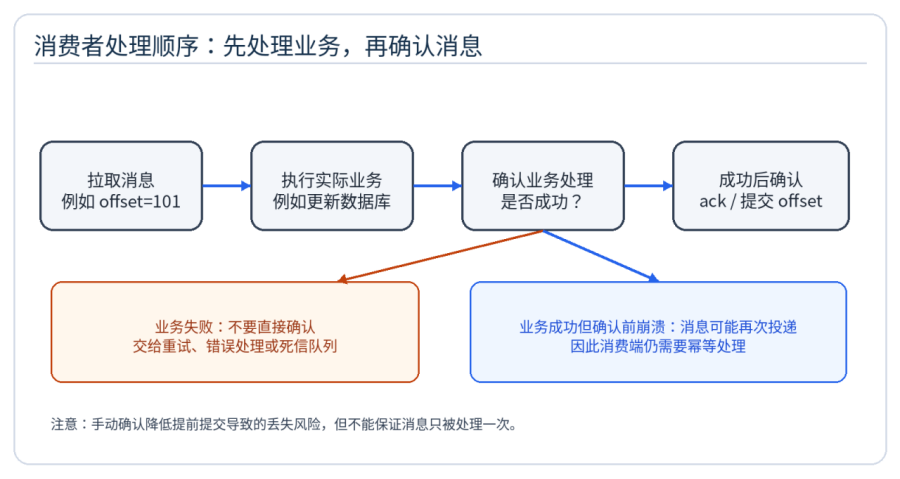
如果业务处理成功,但消费者在提交 offset 前崩溃,消息可能再次被消费。因此,手动确认能够降低提前提交导致的消息丢失风险,但不能保证消息只被处理一次。
六、消息不丢失,还要考虑重复消费
消费者可能在业务处理成功、offset 尚未提交时发生故障。重新消费同一条消息是可靠性设计中需要考虑的正常情况。
第一次消费:
更新订单状态成功
消费者崩溃,offset 尚未提交
第二次消费:
再次收到相同消息
6.1 什么是幂等处理?
幂等的核心是:同一条业务消息重复执行时,不会产生重复的业务结果。一种常见做法是为每条业务消息分配唯一的 eventId,并在数据库中记录已经处理过的消息。
CREATE TABLE processed_message (
event_id VARCHAR(64) NOT NULL,
created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
PRIMARY KEY (event_id)
);
业务处理时,可以将以下操作放在同一个数据库事务中:
尝试登记当前 eventId。
如果该消息已经处理过,则跳过重复的业务操作。
如果是首次处理,则执行相应的业务更新。
提交数据库事务。
仅仅先查询 eventId 是否存在,再决定是否处理,并不能彻底解决并发重复消费问题。生产环境应通过数据库唯一约束等机制保证去重正确性,并妥善处理重复插入异常。消息处理记录与实际业务更新也需要处于合适的事务边界内。
七、数据库事务与 Kafka 消息发送:容易忽略的风险
在实际开发中,还有一种常见情况:数据库操作成功了,但 Kafka 消息没有成功发送。
@Transactional
public void createOrder(Order order) {
orderMapper.insert(order);
kafkaTemplate.send(
"order-events",
order.getId().toString(),
"ORDER_CREATED"
);
}
这段代码中,数据库事务和 Kafka 发送并不是天然的同一个原子事务。可能出现数据库事务提交成功但 Kafka 发送失败,也可能出现 Kafka 消息发送成功但数据库事务最终回滚。
7.1 使用 Transactional Outbox 模式
Transactional Outbox(事务发件箱)是一种常见的解决思路:先将业务数据和待发送消息写入同一个数据库事务,再由后台任务将待发送消息发布到 Kafka。
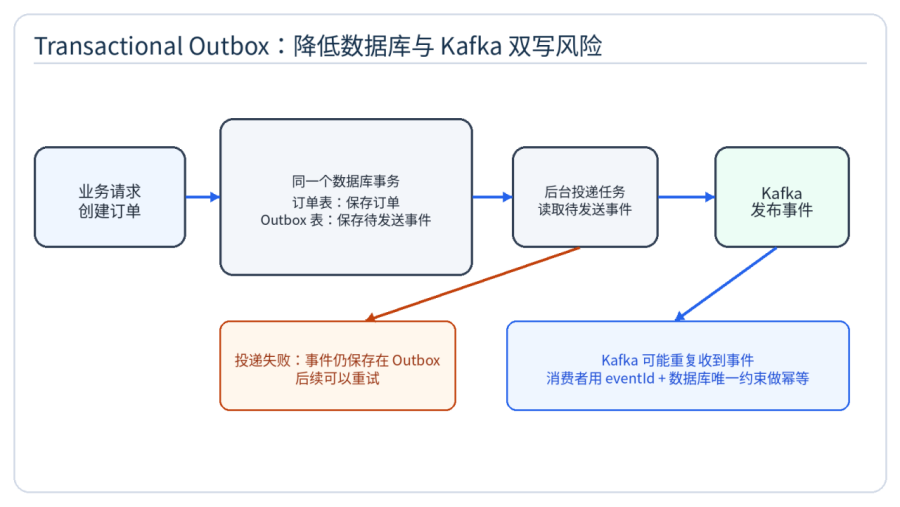
这样,订单创建成功时,对应的待发送消息也会在同一个数据库事务中持久化。即使后台发送任务暂时失败,消息仍保存在数据库中,可以继续重试。
不过,Outbox 并不意味着消息只会发送一次。例如,Kafka 已经接收消息,但后台任务还没来得及更新 Outbox 状态就发生故障,恢复后仍然可能再次发送。因此,通常需要将 Outbox 与消费者幂等处理结合起来。
八、如何建立一套完整的 Kafka 可靠性方案?
环节推荐措施主要解决的问题
生产者acks=all降低未充分复制就确认成功的风险
生产者启用幂等性降低生产者重试引起的重复写入
Broker合理配置副本数量提高节点故障时的数据冗余能力
Broker设置 min.insync.replicas副本不足时拒绝不满足要求的写入
消费者业务成功后再确认避免业务尚未完成就提前提交 offset
消费者幂等处理避免重复投递造成重复业务操作
异常处理重试与死信队列处理暂时失败和无法正常处理的消息
数据库与 KafkaTransactional Outbox降低数据库与消息发送之间的双写风险
这些措施解决的是不同层面的问题,不能相互替代。例如,生产者幂等性不能替代消费者幂等性;消费者手动确认也不能解决数据库与 Kafka 之间的双写问题。
Kafka 事务可以用于协调 Kafka 消费 offset 与 Kafka 输出消息等操作,但不会自动将任意外部数据库操作纳入同一个原子事务。
九、总结
Kafka 消息可靠性不是配置一个参数就能解决的问题,而是生产者、Broker、消费者和业务系统共同参与的结果。
生产者通过 acks=all 和幂等性配置,提高消息发送的可靠性。
Broker 通过副本机制和 min.insync.replicas,降低节点故障导致的数据丢失风险。
消费者在业务处理成功后再提交 offset,并通过幂等机制处理重复投递。
对于数据库与 Kafka 之间的双写问题,可以考虑 Transactional Outbox 模式。
对于发送失败、消费失败等异常,需要设计明确的重试、补偿和监控机制。
这些方案可以显著提高消息处理的可靠性,但并不意味着任何故障条件下都绝对不会丢失消息。真正的可靠性,还取决于集群部署、持久化配置、故障范围、异常处理和业务事务设计。
理解这些原理后,再遇到 Kafka 消息丢失或重复消费的问题,就可以按照实际消息流转过程逐步定位,而不是只依赖某个配置项解决所有问题。
参考资料
Apache Kafka 官方文档:Producer Configs — https://kafka.apache.org/documentation/#producerconfigs
Apache Kafka 官方文档:Broker Configs — https://kafka.apache.org/documentation/#brokerconfigs
Apache Kafka 官方文档:Topic Configs — https://kafka.apache.org/documentation/#topicconfigs
Spring for Apache Kafka:Message Listener Containers — https://docs.spring.io/spring-kafka/reference/kafka/receiving-messages/message-listener-container.html
Spring for Apache Kafka:@KafkaListener — https://docs.spring.io/spring-kafka/reference/kafka/receiving-messages/listener-annotation.html