文章目录
-
- 一、你有没有遇到过这样的困惑?
- 二、先搞懂一个概念:什么是"时序大模型"?
- 三、认识TimechoAI的"模型广场"
- 四、汇率预测实操:从数据到结果
-
- 4.1 第一步:拿到数据
- 4.2 第二步:配置预测参数
- 4.3 第三步:查看预测结果
- 4.4 第四步:反馈与迭代
- 五、为什么TimechoAI能做到"零门槛"?
- 六、不止于汇率:时序大模型的更多可能
- 七、写在最后:让预测能力"下沉"到业务人员手中
一、你有没有遇到过这样的困惑?
假设你手里有一堆数据:过去几年每天的人民币对美元汇率、每天的工厂温度记录、每小时的电量消耗……这些数据按时间顺序排列,就叫时序数据。
问题来了:这些数据除了画成折线图看看历史走势,还能干什么?
很多人的第一反应是——预测未来。比如:“下个月汇率大概会是多少?”“明天下午这台设备会不会出故障?”
但真要做起来,大部分人卡在了第一步:不会写代码、不懂算法、没有GPU服务器。就算勉强跑起来,结果也经常不准。于是,大量宝贵的时序数据就静静地躺在数据库里,成了"只读的历史档案"。
TimechoAI想解决的,就是这个问题。它是一个时序大模型服务平台——你不用懂算法、不用配环境,把数据传上去,点一下按钮,就能得到预测结果。
这篇文章,我们就用汇率预测这个例子,手把手带你走一遍完整流程,顺便把里面涉及的核心概念讲清楚。
二、先搞懂一个概念:什么是"时序大模型"?
在进入实操之前,有必要先花两分钟把基础概念说清楚。
普通大模型(比如ChatGPT)处理的是文字。它的核心能力是"理解语言"——你问它问题,它用文字回答你。
时序大模型处理的是"按时间排好队的数据"。它的核心能力是"理解规律"——你给它一段历史,它告诉你未来可能怎么走。
两者的区别,用一个比喻就能说清:
普通大模型像一个翻译官,擅长把一种表达变成另一种表达。 时序大模型像一个老中医,你告诉他病人过去几天的体温、脉搏、血压变化,他判断接下来病情会怎么发展。
TimechoAI背后用的是清华大学THUML团队研发的Timer系列时序大模型。这个模型已经在工业、能源、金融等多个领域验证过效果,目前最新版本是Timer-3.5。
三、认识TimechoAI的"模型广场"
打开TimechoAI,最先看到的是模型广场。你可以把它理解成一个"模型超市"——不同的模型擅长不同的任务,你可以根据需求挑选。 
页面顶部有三个筛选标签:全部、时序大模型、机器学习方法、领域模型。右边还有一个搜索框,可以按名称或标签找模型。
第一页展示的三个代表模型:
- Timer(时序大模型):支持协变量、分位数预测,能感知缺失值的多变量基础模型。这是"通用选手",什么场景都能上。
- TimerPV(领域模型):专门面向光伏功率预测,使用11个NWP协变量和5个场站静态属性。这是"专科选手",专攻光伏。
- TimerEPF(领域模型):面向电价单目标预测的两阶段模型,结合Timer-3.0滚动预测和LightGBM回归。这是"电力交易员"。
第二页是更强大的基础模型:
- Timer-3.5:十亿级MoE基础模型,面向零样本单变量分位数预测。参数最多、能力最强。
- Timer-3.0:面向零样本概率单变量预测的生成式基础模型。能给出"多种可能的未来"。
- Chronos-2:Amazon Science开源,面向相关序列、协变量和分位数输出的通用零样本预测模型。
第三页是经典统计方法:
- AutoARIMA:自动选择ARIMA或ARIMAX阶数的CPU统计预测模型。经典中的经典。
- Holt-Winters:基于季节性三次指数平滑的CPU统计预测模型。适合有明显季节性的数据。
看到这里你可能会问:这么多模型,我该选哪个?
答案很简单:如果你不确定,就选Timer-3.5或者直接用Auto模式。平台会根据你的数据特征自动匹配最合适的模型。这是TimechoAI对新手最友好的设计之一。
四、汇率预测实操:从数据到结果
接下来进入正题。我们用平台内置的汇率数据集,完整走一遍预测流程。
4.1 第一步:拿到数据
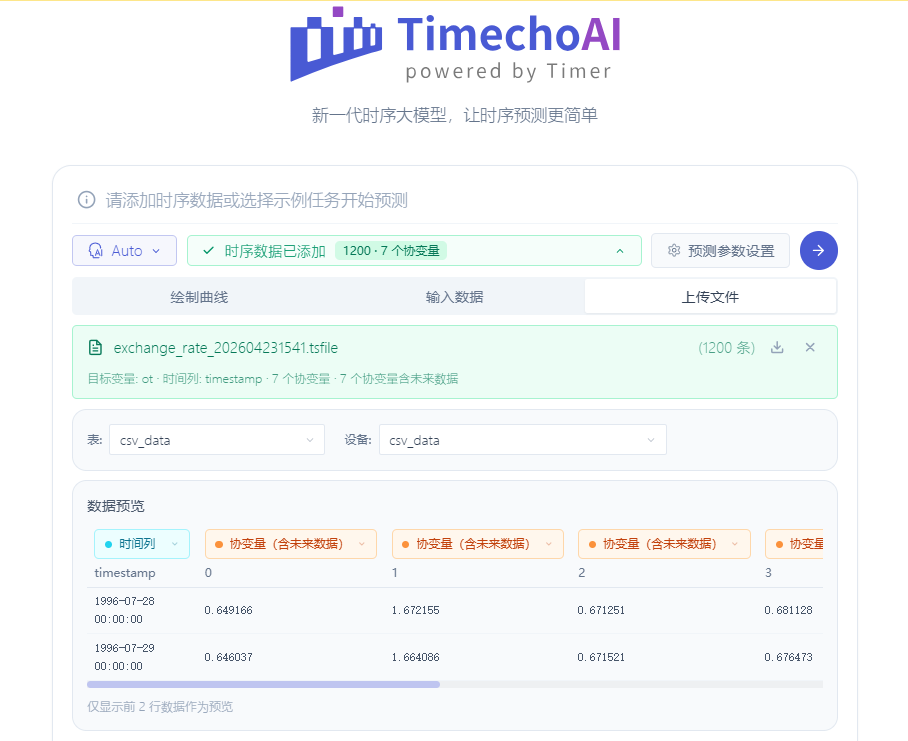
平台内置了一个汇率数据集,包含8个国家和地区对美元的每日汇率:澳大利亚、英国、加拿大、瑞士、中国、日本、新西兰、新加坡。
文件大小61.5 KB,格式是TsFile(这是天谋科技自家时序数据库Apache IoTDB的原生格式)。你可以点击"下载"把它保存到本地,也可以直接点"去预测"进入分析流程。
知识点:什么是TsFile? TsFile是Apache IoTDB专用的列式存储格式,专门为时序数据优化。相比CSV,它压缩率更高、读写更快。如果你的数据已经存在IoTDB里,可以直接导出成TsFile上传到TimechoAI,省去转换步骤。
4.2 第二步:配置预测参数
进入预测页面后,你需要设置两个核心参数:
- 预测点数:向未来预测多少个时间步。范围是1到720步。比如你选200,模型就会给出未来200天的预测。
- 预测起始位置:从哪条数据开始作为预测起点。比如你选第1000条,模型就用前1000条历史数据来预测后面。
协变量是另一个关键概念。汇率不是孤立变化的——它受利率、通胀、GDP等多种因素影响。TimechoAI允许你把这些"相关因素"一并输入模型,让预测更准。
知识点:什么是协变量? 协变量就是"和目标变量一起变化的辅助变量"。 打个比方:你要预测明天的冰淇淋销量(目标变量),气温(协变量)显然会影响销量。把气温一起输进去,预测会更准。 在汇率场景里,目标变量是"汇率",协变量可以是"利率差"“CPI”"进出口数据"等。
4.3 第三步:查看预测结果
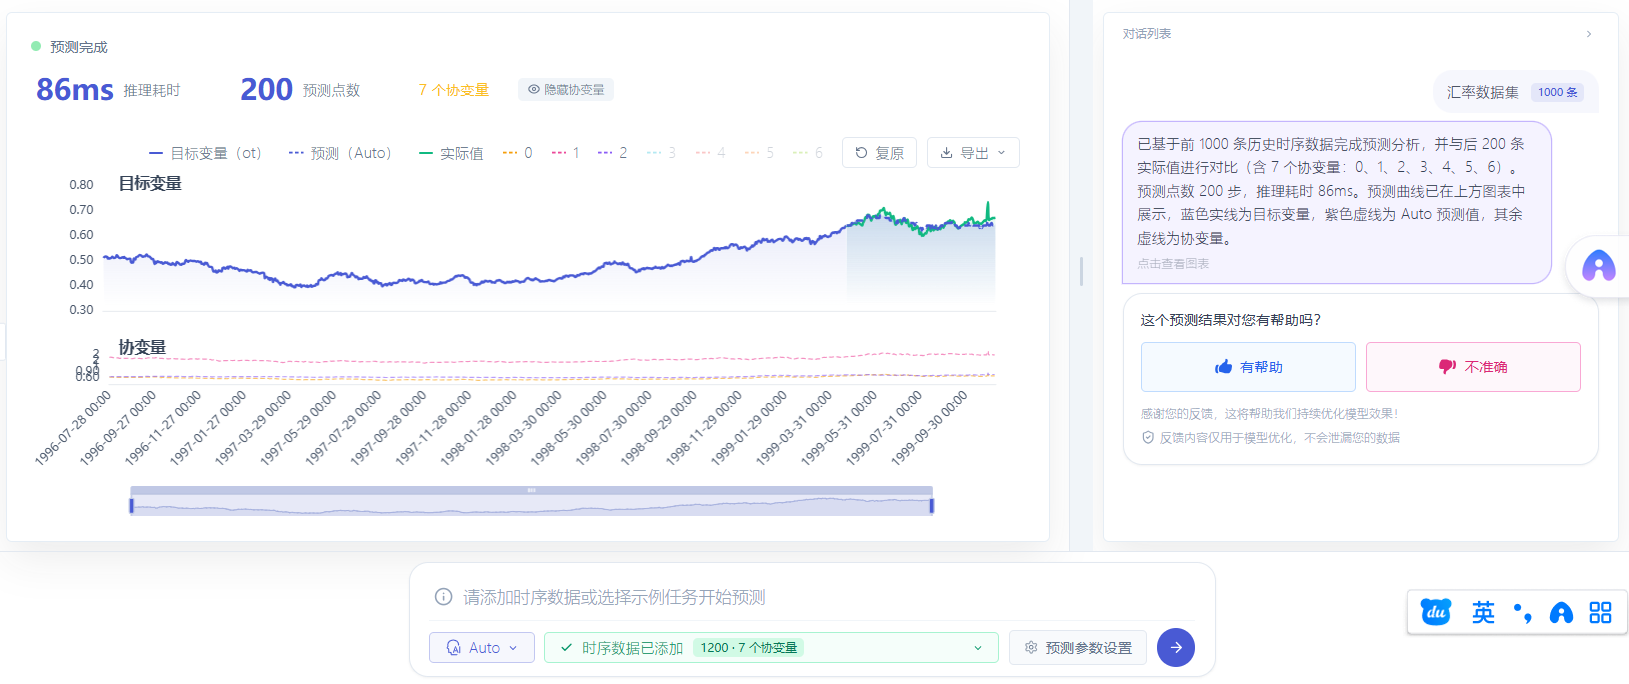
点下预测按钮后,结果几乎是瞬间返回的。看这张图:
- 推理耗时:88ms——不到0.1秒,比你眨一次眼还快。
- 预测点数:200——未来200个时间点的预测值。
- 7个协变量——这次预测用了7个辅助变量。
图表分上下两部分:
- 上方是目标变量:蓝色实线是历史汇率(ot),紫色虚线是模型预测值(Auto),绿色是实际值。可以看到预测曲线和实际值的走势高度吻合。
- 下方是协变量:7条彩色虚线,代表7个辅助变量的变化趋势。
右侧的对话列表里,模型用自然语言给出了分析结论:
“已基于前1000条历史时序数据完成预测分析,并与后200条实际值进行对比(含7个协变量:0、1、2、3、4、5、6)。预测点数200步,推理耗时88ms。”
这就是时序大模型和传统方法的区别——它不仅给你数字,还给你解释。
4.4 第四步:反馈与迭代
预测结果下方有两个按钮:“有帮助"和"不准确”。这是平台的反馈机制。你的评价会被用来持续优化模型效果,而且平台承诺反馈内容仅用于模型优化,不会泄露用户数据。
五、为什么TimechoAI能做到"零门槛"?
看完上面的实操,你可能会好奇:为什么不用写代码、不用配环境,就能跑出专业级的预测结果?
这背后是几个关键设计:
第一,模型已经预训练好了。 Timer系列模型在海量时序数据上训练过,学到了时序数据的通用规律。你不需要从零训练,直接用就行。这叫"零样本预测"——不用给模型看你的数据,它也能预测。
第二,算力在云端。 你不需要买GPU,不需要装CUDA,所有计算都在TimechoAI的服务器上完成。88ms的推理速度,普通笔记本根本做不到。
第三,交互设计极简。 整个流程只有三步:传数据、设参数、看结果。没有代码、没有配置文件、没有命令行。
第四,模型自动匹配。 如果你不确定用哪个模型,Auto模式会根据你的数据特征自动选择。这就像相机的"自动档"——你只管按快门,剩下的交给机器。
六、不止于汇率:时序大模型的更多可能
汇率预测只是TimechoAI的一个应用场景。同样的能力,可以迁移到很多领域:
工业设备预警:某大型航空公司用Timer模型监控飞机引气系统。模型先学会"正常压力应该是什么样",当实际值持续偏离预测值时,系统就发出异常预警。这种"先学正常,再识别异常"的思路,比传统"学习故障样本"的方法更实用——因为故障样本往往很少,而正常运行数据很多。
能源负荷预测:电网需要提前知道明天用电量是多少,才能安排发电计划。时序大模型可以综合历史负荷、天气、节假日等因素,给出更准的预测。
光伏功率预测:TimerPV模型专门做这个,输入气象预报和场站属性,输出未来发电功率。
电价预测:TimerEPF模型结合Timer-3.0和LightGBM,预测电力市场的现货价格。
这些场景的共同点是:数据按时间排列,未来受历史影响,且受多个外部因素干扰。只要符合这三条,时序大模型就能派上用场。
七、写在最后:让预测能力"下沉"到业务人员手中
过去,做时序预测是一件"高门槛"的事。企业需要招算法工程师、买GPU服务器、花几个月调模型。很多有价值的预测需求,就因为成本太高而被搁置。
TimechoAI试图改变这个局面。它把复杂的建模能力封装成一个网页服务,让业务人员自己就能完成预测——不需要理解Transformer架构,不需要知道注意力机制是什么,只需要知道自己要预测什么、有哪些相关因素。
这种"能力下沉",才是时序大模型真正实现规模化落地的关键。
如果你手里也有"躺在数据库里睡觉"的时序数据,不妨试试TimechoAI。也许下一次决策,你就能从"凭经验拍脑袋"变成"看预测做判断"。
企业版官方链接:https://timecho.com 时序大模型 TimechoAI:https://ai.timecho.com/