预测总是差一截?把"你知道的信息"喂给模型:TimechoAI 协变量预测实战
一、从一个卖伞的故事说起
先讲个小故事。
街口有家杂货店,老板卖雨伞。他想知道明天该进多少货,于是翻出了过去半年的销售记录,一条一条看:哪天卖得多、哪天卖得少。看了半天,他发现平均下来每天也就卖个七八把,于是按这个数备货。
结果呢?连着几天大雨,伞卖脱销了。老板很郁闷:明明数据都在手上,怎么就没算准呢?
问题出在哪?其实不在他算得不对,而在于他只看了"卖了多少",没看"为什么卖这么多"。雨伞的销量跟什么有关?跟下雨有关。天气预报早就说明天有雨,这个信息他明明知道,却没把它放进考虑里。
这个故事里藏着时序预测的一个普遍道理:一条序列的未来,往往不取决于它自己的历史,还取决于一堆"外部因素"。
雨伞销量取决于天气,奶茶店销量取决于节假日,写字楼用电取决于气温,商场客流取决于有没有搞活动。这些外部因素,在你的数据里可能都有记录,也可能你提前就知道一部分——比如天气预报、比如促销排期。但是很多人做预测的时候,手里攥着这些信息,却不知道怎么用,最后就用了最朴素的"看历史、猜未来"。
这就是预测精度上不去的一个很常见的原因:信息没用全。
那么,有没有一种办法,能把这些"额外知道的信息"正规地喂给预测模型?有。这个东西有个专门的名字,叫协变量(Covariate)。而 TimechoAI 平台对协变量提供了完整的支持,你只需要在调用的时候多传两个参数,就能把天气预报、促销日历、节假日安排这些信息一起交给模型。
这篇文章就把这件事讲透:协变量到底是什么、TimechoAI 里怎么用、跑通一个完整的对比实验,以及这个功能在真实业务里能帮你干什么。全程有可运行的代码,照着敲就能跑。
二、什么是协变量:说人话版
先给定义,但尽量不说官话。
协变量,就是你要预测的那条主数据之外,其他所有可能对它产生影响的、按时间记录的数据。
举个例子。假设你要预测一家奶茶店未来一周的销售额。这里面的角色是这样分的:
- 销售额本身,按天记录的一条序列——这个叫目标变量(Target),它是主角,你要预测的就是它的未来
- 每天的气温——跟奶茶销量有关系,天热买的人多
- 每天是不是周末——跟销量也有关系,周末人多
- 每天有没有搞第二杯半价——关系更大了
后面这三样,气温也好、周末标志也好、促销标志也好,它们不是主角,但它们都在旁边影响着主角的走向。它们就是协变量。
用 Mermaid 把这个关系画出来:
#mermaid-svg-NgGoRNA05J0k2vi2{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-NgGoRNA05J0k2vi2 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-NgGoRNA05J0k2vi2 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-NgGoRNA05J0k2vi2 .error-icon{fill:#552222;}#mermaid-svg-NgGoRNA05J0k2vi2 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-NgGoRNA05J0k2vi2 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-NgGoRNA05J0k2vi2 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-NgGoRNA05J0k2vi2 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-NgGoRNA05J0k2vi2 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-NgGoRNA05J0k2vi2 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-NgGoRNA05J0k2vi2 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-NgGoRNA05J0k2vi2 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-NgGoRNA05J0k2vi2 .marker.cross{stroke:#333333;}#mermaid-svg-NgGoRNA05J0k2vi2 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-NgGoRNA05J0k2vi2 p{margin:0;}#mermaid-svg-NgGoRNA05J0k2vi2 .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-NgGoRNA05J0k2vi2 .cluster-label text{fill:#333;}#mermaid-svg-NgGoRNA05J0k2vi2 .cluster-label span{color:#333;}#mermaid-svg-NgGoRNA05J0k2vi2 .cluster-label span p{background-color:transparent;}#mermaid-svg-NgGoRNA05J0k2vi2 .label text,#mermaid-svg-NgGoRNA05J0k2vi2 span{fill:#333;color:#333;}#mermaid-svg-NgGoRNA05J0k2vi2 .node rect,#mermaid-svg-NgGoRNA05J0k2vi2 .node circle,#mermaid-svg-NgGoRNA05J0k2vi2 .node ellipse,#mermaid-svg-NgGoRNA05J0k2vi2 .node polygon,#mermaid-svg-NgGoRNA05J0k2vi2 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-NgGoRNA05J0k2vi2 .rough-node .label text,#mermaid-svg-NgGoRNA05J0k2vi2 .node .label text,#mermaid-svg-NgGoRNA05J0k2vi2 .image-shape .label,#mermaid-svg-NgGoRNA05J0k2vi2 .icon-shape .label{text-anchor:middle;}#mermaid-svg-NgGoRNA05J0k2vi2 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-NgGoRNA05J0k2vi2 .rough-node .label,#mermaid-svg-NgGoRNA05J0k2vi2 .node .label,#mermaid-svg-NgGoRNA05J0k2vi2 .image-shape .label,#mermaid-svg-NgGoRNA05J0k2vi2 .icon-shape .label{text-align:center;}#mermaid-svg-NgGoRNA05J0k2vi2 .node.clickable{cursor:pointer;}#mermaid-svg-NgGoRNA05J0k2vi2 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-NgGoRNA05J0k2vi2 .arrowheadPath{fill:#333333;}#mermaid-svg-NgGoRNA05J0k2vi2 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-NgGoRNA05J0k2vi2 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-NgGoRNA05J0k2vi2 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-NgGoRNA05J0k2vi2 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-NgGoRNA05J0k2vi2 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-NgGoRNA05J0k2vi2 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-NgGoRNA05J0k2vi2 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-NgGoRNA05J0k2vi2 .cluster text{fill:#333;}#mermaid-svg-NgGoRNA05J0k2vi2 .cluster span{color:#333;}#mermaid-svg-NgGoRNA05J0k2vi2 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-NgGoRNA05J0k2vi2 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-NgGoRNA05J0k2vi2 rect.text{fill:none;stroke-width:0;}#mermaid-svg-NgGoRNA05J0k2vi2 .icon-shape,#mermaid-svg-NgGoRNA05J0k2vi2 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-NgGoRNA05J0k2vi2 .icon-shape p,#mermaid-svg-NgGoRNA05J0k2vi2 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-NgGoRNA05J0k2vi2 .icon-shape .label rect,#mermaid-svg-NgGoRNA05J0k2vi2 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-NgGoRNA05J0k2vi2 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-NgGoRNA05J0k2vi2 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-NgGoRNA05J0k2vi2 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
目标变量:奶茶日销售额(要预测的主角)
未来的销售额
协变量①:每日气温
协变量②:是否周末
协变量③:是否促销
虚线部分是关键:协变量不但影响历史,还会继续影响未来。明天的气温、明天是不是周末、明天有没有活动,这些都会决定明天的销量。所以协变量不是可有可无的背景板,它们是预测公式里实打实的一环。
协变量分两类
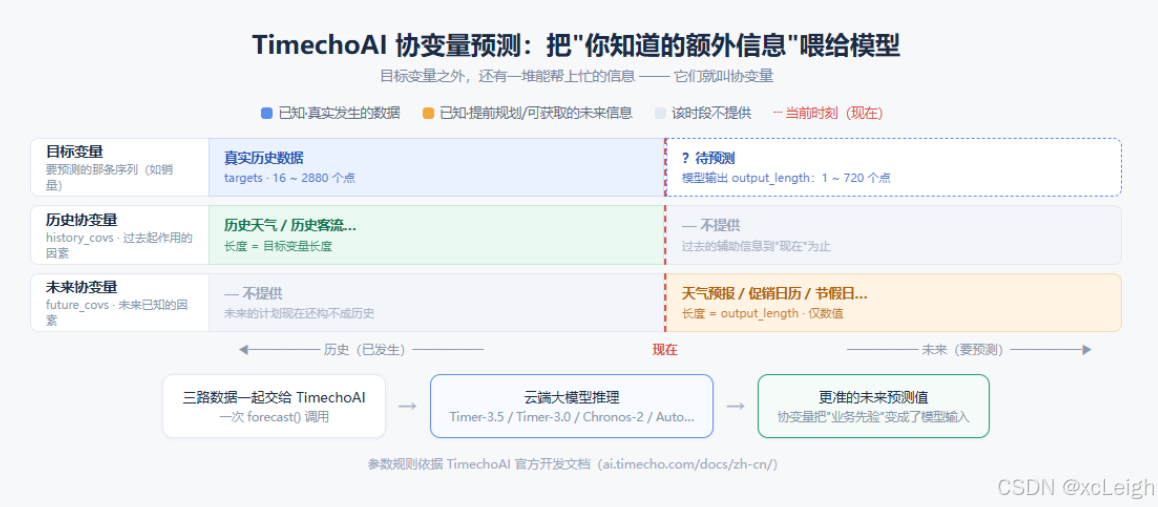
再往下分,协变量按"时间上的位置"分成两种,这个区分非常重要,因为 TimechoAI 里它们对应的就是两个不同的参数。
第一种:历史协变量(History Covariates)。
指的是过去时段的辅助数据。比如过去一个月每天的气温、每天的客流量。它们的共同特点是:已经发生了,是既成事实。它们的作用是帮模型理解"过去为什么会那样"——过去两周销量高,原来是因为连续晴天加周末促销,这个"为什么"搞清楚了,模型对规律的理解就更到位。
第二种:未来协变量(Future Covariates)。
指的是未来时段、但你现在就已经知道的数据。这听起来有点绕,其实很常见:
- 天气预报:明天的气温,气象台已经给了预测值
- 日历信息:明天是周六,后天是节假日,这个翻开日历就知道
- 活动排期:下周三开始大促,这是运营早就定好的计划
- 库存计划:下个月要铺货多少,这是自己公司的安排
它们的共同特点是:未来的事还没发生,但信息已经在手上。这类信息对预测的价值往往比历史协变量还大——毕竟预测的就是未来,未来已知的影响因素,能提前知道一分,预测就少一分盲目。
一句话总结这两类:历史协变量解释过去,未来协变量指引未来。
三、为什么协变量能实实在在提升精度
有人可能会想:大模型不是号称很聪明吗?光看目标变量的历史不行吗?
大部分时候,光看历史确实也能预测个大概。因为序列自身有惯性——今天卖 100 杯,明天大概率也在 100 上下。但是惯性只能覆盖"平稳的日子",一旦有外部因素搅局,纯靠历史就会翻车:
- 不加天气信息,模型不知道"明天降温",按惯性给了个平庸的数,结果寒潮一来销量翻倍,预测偏了一大截
- 不加促销信息,模型不知道"下周三是大促",历史里那些促销日的销量尖峰,它只当是随机波动给平滑掉了
拿一组编造但符合直觉的数字来说明这个问题。假设一家店的日销量长期在 200 上下波动,历史上有几次大促冲到了 500。你要预测"下周三"。下周三的历史规律是什么?跟普通日子没什么两样,模型一看,周围的日子的销量都在 180 到 220 之间,那就预测 200 吧。可实际上下周三是大促日,真实销量 480——预测误差直接飙到 280,误差率超过百分之百。但如果这个模型提前知道"下周三是大促",它在历史里学过"大促日的销量规律",给出的预测可能就是 450 上下,误差瞬间从 280 缩到 30 以内。
你看,同一个模型,多了一条信息,预测质量完全是两个量级。信息差就是精度差,这句话在时序预测里几乎是一条公理。
这就是为什么很多预测"看起来做了,但总差一截"——差的不是模型能力,是输入信息。你让一个只看历史的模型去猜一个被外力反复掰弯的序列,它只能取平均值,而业务上恰恰最需要它把那些"尖峰时刻"算准。
把协变量加进去之后,情况就变了。模型知道了"哦,原来那些尖峰是有促销的日子",它就把促销和尖峰之间的关系学下来了。等下次预测,你告诉它"下周三有促销",它就知道该把曲线抬起来了。
所以协变量带来的精度提升,往往不是均匀分布在每一天的,而是集中在那些外力作用大的关键日子——而业务上,恰恰是这些日子最值钱:备货备多少、排班排多少人、库存压多少,全看这些天。
TimechoAI 在这件事上的价值在于:它把"使用协变量"这件事的门槛降到了传两个参数的程度。在传统的自研流程里,光是把外部特征和目标序列对齐、灌进模型、处理好缺失,就能折腾掉工程师好几天。而在 TimechoAI 这里,这是调用接口时顺手的事。
四、TimechoAI 里的协变量:两个参数 + 两条规则
概念讲清楚了,来看落地。TimechoAI 的 Python SDK 里,协变量对应 forecast() 方法的两个参数:
- history_covs:历史协变量,类型是 pandas DataFrame
- future_covs:未来协变量,类型同样是 pandas DataFrame
配合使用的还有两个参数:
- time_col:指定哪一列是时间列。指定了这个参数之后,所有传入的数据(目标变量和协变量)都需要包含时间列,这样服务端才能把它们按时间对齐
- auto_adapt:自动数据适配,默认就是 True。数据有些小毛病——比如频率不完全规整、长度有点出入——它会自动做一些适配处理,新手建议保持默认
配图里那张"历史 / 现在 / 未来"的三车道图,就是这两个参数在时间轴上的位置关系:
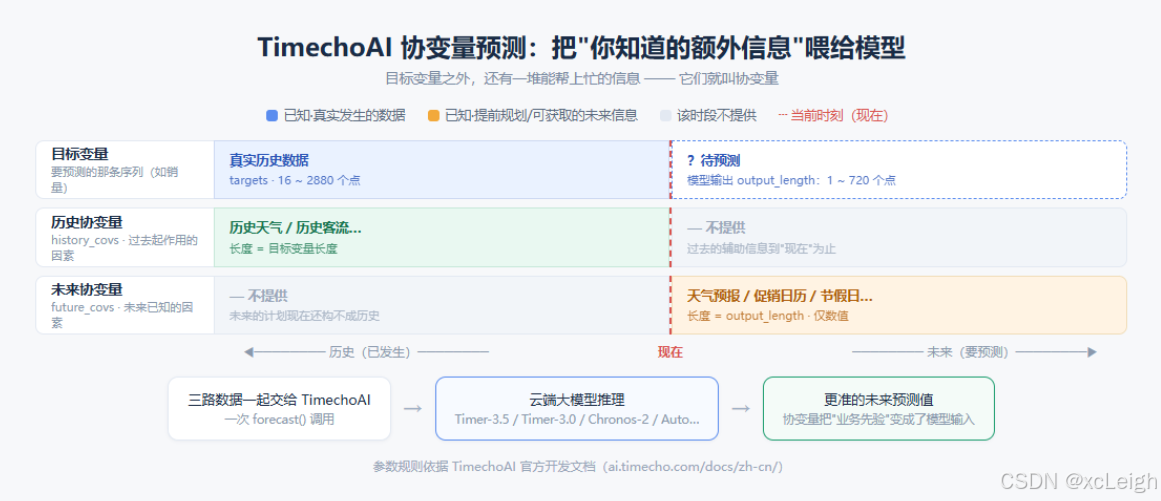
然后是两条必须记住的规则,这是官方文档里明确写的,传错就会报错:
| history_covs | 长度 = 目标变量(targets)的长度 | 与历史一一对应 |
| future_covs | 长度 = output_length(预测长度) | 仅数值类型 |
什么意思呢?展开说:
规则一:历史协变量必须和目标变量一样长。 你给了 240 个点的历史销量,那历史协变量也得是 240 个点——第 1 天的气温对第 1 天的销量,第 240 天的气温对第 240 天的销量,一一对应,一天不多一天不少。多出来的、缺掉的,要么自己裁掉,要么补齐。
规则二:未来协变量的长度必须等于你要预测的长度。 你要预测未来 14 天(output_length=14),那未来协变量就得备好 14 天的——从你历史数据的下一天开始,到预测结束的那天为止。而且注意"仅数值":气温、湿度、节假日标志(1/0)、促销力度(折扣数)这些都是数值,没问题;但像"周一/周二/周三"这种文字,得先转成数字才行,这个坑后面细说。
这两条规则记住了,协变量预测就已经成功了一大半。剩下的就是动手跑代码。
五、实战准备:环境和数据
开始之前,把环境备好。总共三样东西:
第一样,Python 环境。版本要求是 3.10 及以上、3.13 以下,这个区间是官方文档明确写的,别用太老的版本。
第二样,官方 SDK。一行命令:
pip install timecho-ai
第三样,API Key。去官网 https://ai.timecho.com 注册账号,进控制台创建一个 Key,后面创建客户端的时候用。
数据方面,官方文档贴心地提供了一份协变量示例数据 sample_cov.csv,直接通过网址就能读,不用自己找数据。这份数据的结构是这样的:一行一个时间点,包含四列——
- time:时间列
- target:目标变量,要预测的那条序列
- temperature:气温,一个典型的协变量
- humidity:湿度,另一个协变量
拿它来练手再合适不过:目标变量是主角,气温和湿度就是两个"外部因素",正好演示协变量的完整用法。等你自己上手的时候,把这几列换成你业务里的真实数据就行——比如把 temperature 换成"客流量",把 humidity 换成"促销标志",套路一模一样。
顺带说一下真实业务里数据长什么样。大部分公司的协变量其实早就存在了:销售系统里有促销记录、运营排期表里有活动计划、行政日历里有节假日安排、运维监控里有服务器负载的历史。它们散落在各个系统里,格式五花八门。做协变量预测之前的那点准备工作,无非是把这些散落的数据归拢到一张表里——一列时间、一列目标变量、若干列协变量,每行一个时间点,就跟 sample_cov.csv 的结构一样。归拢这件事,Excel 就能干, pandas 也行,没有任何技术门槛。换句话说,协变量预测的最大成本不在技术,而在于你有没有把业务里的"影响因素"当成数据认真记下来。从今天开始留心记录,三个月后你就是全公司数据最全的人。
六、实战第一回合:不加协变量,先跑个基准
做对比实验有个原则:先跑基准,再上改动。不然协变量到底是帮了忙还是帮了倒忙,你根本说不清。
基准版本就是最普通的预测,只给目标变量。代码不长:
import pandas as pd
from timecho_ai import TimechoAIClient
# 创建客户端(需替换为您的 API Key)
client = TimechoAIClient(api_key="your_timecho-ai_api_key")
# 任务定义:输入 16 个点,预测 8 个点
INPUT_LENGTH = 16
OUTPUT_LENGTH = 8
# 读取示例数据
raw_df = pd.read_csv("https://ai.timecho.com/data/sample_cov.csv")
target = raw_df[["time", "target"]][:INPUT_LENGTH]
# 不带协变量,直接预测
result = client.forecast(
targets=target,
output_length=OUTPUT_LENGTH
)
print(result[0])
这段代码干的事情:从示例数据里取前 16 个点的 time 和 target 两列,交给模型,预测未来 8 个点。TimechoAIClient 初始化只需要一个 api_key,其他的都不用配。
跑完把预测结果存下来——可以存成 CSV,也可以直接记在表格里。这份结果就是基准线,待会儿加了协变量之后,拿新结果跟它比,孰优孰劣一目了然。
这里多说一句 INPUT_LENGTH = 16 这个数。16 是官方允许的最小输入长度,实际业务里一般不会只给这么少——输入区间可以从 16 一直到 2880 个点,历史给得越足,模型能看的规律就越多。示例里用 16 只是演示方便,你自己跑的时候,手上有多长的干净数据就给多长(当然也要留意预测长度 output_length 的范围是 1 到 720 个点)。
七、实战第二回合:加入历史协变量
现在上正菜。同样一份数据,把 temperature 和 humidity 两列作为历史协变量一起传进去。这就是官方文档里的协变量预测示例,原版代码如下:
import pandas as pd
from timecho_ai import TimechoAIClient
# 创建客户端
client = TimechoAIClient(api_key="your_timecho-ai_api_key")
# 任务定义
INPUT_LENGTH = 16
OUTPUT_LENGTH = 8
# 读取数据
raw_df = pd.read_csv("https://ai.timecho.com/data/sample_cov.csv")
target = raw_df[["time", "target"]][:INPUT_LENGTH]
# 构建历史协变量 DataFrame
history_covs = raw_df[["time", "temperature", "humidity"]][:INPUT_LENGTH]
# 执行协变量预测
result = client.forecast(
targets=target,
history_covs=history_covs,
output_length=OUTPUT_LENGTH,
time_col="time",
auto_adapt=True
)
print(result[0])
跟基准版逐行对比一下,改动其实就三处,但每一处都有讲究:
改动一:多构建了一个 history_covs。 注意取列的方式:raw_df[["time", "temperature", "humidity"]][:INPUT_LENGTH]。这里有两个细节。第一,time 列也在里面——因为待会儿指定了 time_col="time",所有输入都要带时间列;第二,切片长度是 [:INPUT_LENGTH],跟 target 一模一样,这就对应了前面说的规则一:历史协变量必须和目标变量等长。
改动二:调用时多传了 history_covs 参数。 这是协变量预测的核心开关,传了它,模型就能"看到"那些外部因素了。
改动三:显式传了 time_col="time"。 这个参数的作用是告诉服务端"哪一列是时间"。一旦指定,所有传入的数据(包括协变量)都得带时间列,服务端会按时间把它们对齐。为什么不靠默认的顺序对齐呢?因为显式给时间列更稳——万一你的数据在中间缺了几个时间点,靠顺序对齐就会错位,而按时间戳对齐就不会。
auto_adapt=True 这里是显式写出来的,其实不写也是默认开启。它的作用是让服务端自动处理一些数据上的小瑕疵。数据比较干净的时候感觉不到它,数据糙的时候它是救命的,所以建议一直开着。
跑完之后,同样把结果存下来。现在你手里有两个版本的预测了:基准版(只看历史)和协变量版(历史 + 天气因素)。
八、实战第三回合:未来协变量——把"明天的事"提前告诉模型
前面两回合用的都是历史协变量。但还记得前面说的吗,价值最大的往往是未来协变量:把未来已知的信息提前告诉模型。
这一回合,用一个更贴近业务的假想场景来演示:预测某家店未来 7 天的销量,其中"未来一周的天气预报"你已经拿到了(天气预报本来就天天发布),另外你提前知道"周六店里搞周年庆活动"。
按官方参数规则来组装数据:
- 目标变量:历史销量,比如给 60 个点(targets,60 行)
- 历史协变量:过去 60 天每天的气温(history_covs,也是 60 行,等长)
- 未来协变量:未来 7 天的预报气温 + 活动标志(future_covs,7 行,等于 output_length)
代码的组织方式跟上面一样,只是多了一路数据:
import pandas as pd
from timecho_ai import TimechoAIClient
client = TimechoAIClient(api_key="your_timecho-ai_api_key")
# 历史数据:过去 60 天
INPUT_LENGTH = 60
# 要预测未来 7 天
OUTPUT_LENGTH = 7
target = df[["time", "sales"]][:INPUT_LENGTH] # 历史销量
history_covs = df[["time", "temperature"]][:INPUT_LENGTH] # 历史气温,等长
# 未来协变量:未来 7 天,长度必须等于 output_length
future_covs = pd.DataFrame({
"time": future_7_days, # 未来 7 天的时间戳
"forecast_temp": weather_forecast, # 天气预报气温(数值)
"is_event": [0,0,0,0,0,0,1] # 周六有活动,用 1/0 表示
})
result = client.forecast(
targets=target,
history_covs=history_covs,
future_covs=future_covs,
output_length=OUTPUT_LENGTH,
time_col="time",
auto_adapt=True
)
print(result[0])
这段代码里 df 和 future_7_days 是示意变量,换成你自己的真实数据即可;关键是三路数据的长度关系:target 60 行、history_covs 60 行、future_covs 7 行、output_length=7,严丝合缝地对应前面那张规则表。
这里专门说说 is_event 这一列的构造思路,因为它演示了两个实用技巧:
技巧一:用 1/0 表示"有没有"。 "周六有活动"是个非黑即白的事件,直接用 0 和 1 表示就行,完全满足"仅数值"的要求。类似的还有:是否节假日、是否周末、是否发薪日,全都能变成 0/1 列。
技巧二:把程度变成数字。 如果活动分大小——满减力度不一样——那就别用 0/1,改成表示力度的数字,比如普通日 0、小活动 1、大活动 2。模型能从数字大小里学到"活动越大、销量抬得越高"的规律。
那么,未来协变量的数据从哪来?给你三个最常用的来源,都是免费现成的:
换句话说,未来协变量几乎不需要额外成本,你要的信息大概率已经在Excel里躺着了,缺的只是"把它喂给模型"这一步。
九、结果怎么对比:别只看一两次
三回合跑完,手里有基准版和协变量版的两组预测。怎么判断协变量有没有用?
第一步很简单:把两组预测值和真实值画在同一张图上,肉眼看。重点看什么?看拐点和尖峰——协变量的功劳主要在这些地方,平稳段反而看不出差别。
第二步,算误差指标。最常用的两个:
- MAE(平均绝对误差):每个点的预测值减真实值,取绝对值,再求平均。这个数越小,预测越准
- RMSE(均方根误差):类似,但先平方再开方,对"错得离谱的点"惩罚更重
哪边指标小,哪边赢。用 pandas 几行就能算,不用额外装什么。
第三步,也是最容易忽略的:多试几段数据。只拿一个时间窗口对比,运气成分太大——可能恰好这次协变量帮上了大忙,也可能恰好碰上天气反常。靠谱的做法是取多个不同的历史起点,各跑一遍,看平均表现。多跑几组,心里就有数了。
具体操作可以这么干:比如数据有 300 个点,你可以先用前 200 个点预测第 201 到 210 个点,再用前 210 个点预测第 211 到 220 个点,一路滚下去。每个窗口都算一遍 MAE,最后把"基准版"和"协变量版"各自的平均 MAE 拿出来比。这种滚动式的验证办法虽然朴素,但结论扎实,比单次对比可信得多。
另外提醒一句,对比的时候别只盯着总误差。把每个预测点的误差按"普通日 / 周末 / 活动日"分个组,你大概率会发现一个有意思的现象:普通日的误差两边差不多,活动日的误差协变量版明显更小。这个发现很有价值——它告诉你协变量的钱花在哪儿了,也让你跟业务方汇报的时候有理有据。
根据大量使用者的普遍反馈,协变量带来的提升通常集中在两类地方:一是节假日和活动日(未来协变量的主场),二是天气敏感的行业(气温一变,需求跟着变)。如果你的数据恰好符合这两条,协变量的收益会非常明显。
十、容易踩的坑,一次说清
协变量的逻辑不复杂,但坑都在细节里。下面这几个,是实际使用中最常碰到的,提前排一遍雷:
坑一:长度不对齐。 再强调一遍那两条规则——历史协变量必须和目标变量等长,未来协变量必须等于 output_length。参数传错了,服务端会直接拒绝请求(这类参数校验失败会返回 422 状态码,SDK 里对应 UnprocessableEntityError 异常)。看到 422,第一反应就该去数行数。
坑二:协变量里混进了文字。 "仅数值"这条规则很容易被忽略。周一到周日、晴天到雨天,这些文字不转成数字就传不了。转法也简单:星期几转成 1~7,天气可以用"是否下雨"的 0/1,类别多的话用独热编码(one-hot)拆成多列 0/1。
坑三:单位混着用。 气温一会摄氏度一会华氏度、金额一会元一会万元,这种数据喂进去,模型学到的规律是拧巴的。传之前统一单位,一分钟的事。
坑四:未来协变量到时候拿不到。 这是战略层面的坑。你训练时喂了"天气预报"当协变量,上线之后每次预测都得有预报数据才能调接口。万一哪天预报服务挂了,你的预测流程就断链了。所以选未来协变量时先问自己一句:生产环境里,这个东西每次预测的时候都能稳定拿到吗? 答案是否定的就换,别把预测系统绑在一个不稳定的数据源上。
坑五:把"事后才知道"的信息当协变量。 比如用"当天实际客流"去预测"当天销售额"——听起来效果一定很好,但问题是你预测未来的时候根本不可能知道未来的实际客流。这种协变量叫数据泄漏,训练时指标漂亮得不行,一上线就原形毕露。判断标准就一句话:做预测的那一刻,这条协变量的值我真的已经知道了吗?
坑六:协变量和目标变量的粒度对不上。 销量是按天记的,天气预报却是按小时给的,直接拼到一起,行数对不上,规则一就先报错了。处理办法是先把粒度拉平:小时数据聚合成天(取日均值或日最高值),或者把天数据摊开到小时(重复填充)。总之先统一粒度,再谈等长。
十一、六大典型场景里的协变量用法速查
TimechoAI 官方列了六大典型场景。这六个场景里,协变量分别能怎么用?这一节直接给速查清单,你对着自己的业务挑着抄。
电网负荷预测:负荷跟气温的关系非常密切——夏天高温空调全开,冬天寒潮取暖拉满,所以"预报气温"是第一优先级的未来协变量。再加上"是否工作日"(工业负荷和居民负荷节奏不同)、“是否重大节假日”(节假日期间部分工厂停工,负荷结构会变),基本就够用了。
商品销量预测:协变量的主战场。“是否促销 / 促销力度”、“是否节假日”、“天气预报”(冷饮、御寒商品对气温极其敏感)这三样是标配。做电商的还可以加"是否有平台活动"(比如大促节点)、“是否上新”。
流量趋势分析:网站或 APP 的访问量,“是否工作日"是最基础的一条,外加"是否有运营活动”、“是否有版本发布”(大版本更新往往带来流量脉冲)。做内容平台的,还可以把"内容发布节奏"量化成数值列喂进去。
电池寿命预测:这个场景跟前面几个不太一样,外部因素少,但运行工况就是它的协变量——历史充放电倍率、历史工作温度。电池的衰减速度跟这些工况强相关,而且它们都是已经记录下来的历史数据,做成 history_covs 很自然。
气温预测:给气温做预测时,协变量可以考虑历史同期参考值、季节性标志这类数据。气温自身的周期性已经很强,协变量是锦上添花的角色,收益相对前面几个场景小一些。
城市用水预测:用水量的节奏跟生活作息高度绑定,“是否工作日”、“是否节假日"是必备的;再配上"预报气温”(天热用水多)和"是否有大型活动"(体育场、展会周边用水激增),覆盖面就比较全了。
看出规律了吗?协变量的挑选,本质上是在回答一个问题:我的业务里,什么东西一变,目标序列就会跟着变? 把这些"一变它就变"的东西按时记录下来,就是最好的协变量。
十二、什么情况下协变量帮不上忙
最后泼一盆理性的冷水,说说协变量什么时候没用了,免得把它当万金油。
目标序列本身规律极强、外部因素影响很小的,加协变量意义不大。 比如某些设备的心跳数据、内部系统的定期任务量,它们的行为几乎完全由自身节奏决定,外部因素插不上手。这种情况用纯历史预测就够了,省事。
你手上的协变量本身质量很差的,也别硬加。 协变量自己都是错漏百出,等于给模型喂噪声,不但帮不上忙,还可能把预测带偏。数据质量是底线,协变量也不例外。
相关性存疑的,先验证再上。 你觉得"湿度影响销量",最好先粗粗验证一下——比如把历史销量和湿度放一起看看是不是真的同涨同跌。确认有关系再加,别一股脑把十几列数据全怼进去,没关系的列加多了是负担。
总结成一句选型口诀:外力强的序列,协变量是利器;外力弱的序列,纯历史就够用。 先判断自己数据的性格,再决定用不用这个功能。
十三、写在最后
回顾一下这篇文章的内容:协变量是目标变量之外那些"你知道的信息",分历史协变量和未来协变量两类;TimechoAI 用 history_covs 和 future_covs 两个参数支持它们,配合 time_col 和 auto_adapt,几行代码就能把天气预报、促销日历这类业务先验喂给模型;长度对齐和仅数值是两条铁律;收益主要落在节假日、活动日、天气敏感这些关键时刻。
往深一层说,协变量功能代表的是一种思路的转变:预测这件事,不该只靠机器从历史里"悟",你还应该把人类已知的业务知识主动递过去。 模型负责从数据里找规律,你负责把模型看不见但你知道的信息补上,两边合力,预测才稳。
TimechoAI 把这套东西的工程门槛压到了传参数的程度——不用自己搭训练管线,不用操心特征工程的基础设施,调一次 forecast(),把三路数据(目标、历史协变量、未来协变量)一起递过去就行。如果你的业务里存在"天气/日历/活动影响销量和负荷"这类现象,强烈建议去 https://ai.timecho.com 注册个账号,用文档(https://ai.timecho.com/docs/zh-cn/)里的示例数据把这篇文章的三个回合亲手跑一遍。代码就那么几十行,跑通之后,把数据换成你自己的,就是一次真实的业务预测了。