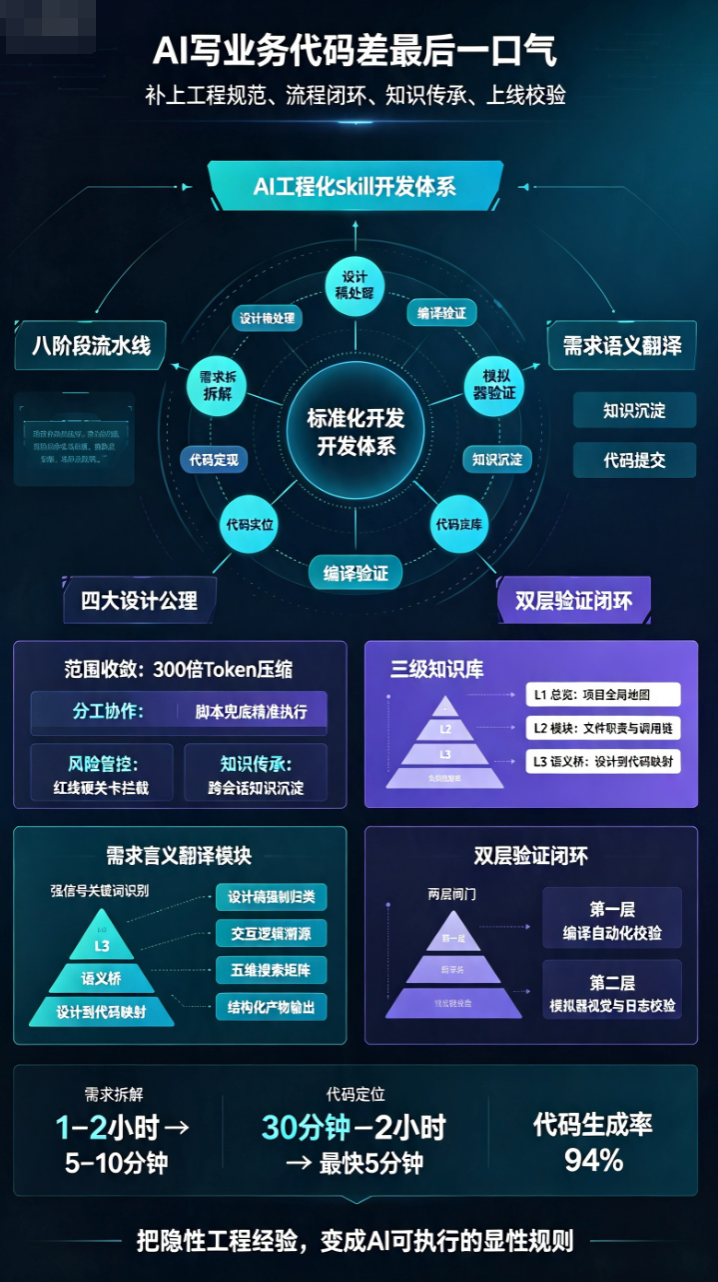
前言:为什么AI写业务代码永远差最后一口气
最近两年,AI编码工具已经成为绝大多数开发者的日常辅助工具。日常改几行代码、修复简单bug、编写通用工具函数,AI的效率远超人工。但只要落地到真实的企业级大型项目,所有人都会遇到同一个无解的问题,AI写的代码永远差一口气,能用但不敢直接上线,看似高效实则全程需要人工兜底。
我们在企业微信移动端大型项目的迭代过程中,深度踩遍了AI辅助编码的所有坑。项目拥有九千多个源文件,业务层级横跨五到六层,需求物料分散在各个平台,单纯依靠大模型原生能力开发,始终无法摆脱低效返工的困境。很多团队误以为AI编码效率低,是模型能力不够,一味追求更大参数、更强的通用大模型。但经过半年的实战打磨我们发现,问题的核心从来不是模型不够聪明,而是AI不懂企业工程规范,无法适配复杂项目的开发流程。
在真实企业开发场景中,AI编码的痛点高度统一,几乎是所有移动端开发者的共同困扰。首先是上下文过载问题,大型项目的完整代码库体量巨大,单次对话无法灌入全部上下文,模型只能基于碎片化信息做判断,天然存在信息缺失。其次是物料极度分散,一份完整的需求,PRD文档在TAPD平台,设计稿在Figma,接口协议在企微文档,UI规范需要对照Figma Token,多源物料割裂,AI无法自动联动整合。
除此之外,命名体系的语义鸿沟、模糊指令的无效执行、验证流程不闭环、跨会话记忆丢失等问题,更是反复拖慢开发节奏。产品和运营的口语化需求描述,和工程代码的标准化命名完全脱节,AI无法自主完成语义转换。面对“按照PRD优化功能”这类模糊指令,模型会跳过需求拆解直接改代码,频繁出现漏改、错改、越界修改等问题。更关键的是,AI自主判定的“开发完成”毫无可信度,经常出现代码编译失败、多处逻辑不同步的情况,且每次新建会话都会遗忘所有历史开发决策、代码修改逻辑,无法实现迭代接力。
基于这些真实痛点,我们放弃了“依赖模型原生能力突破”的思路,转而从工程流程本身破局。我们将完整的需求开发全流程,拆解为标准化、原子化、可校验、可复盘的流水线,打造出一套专属Skill开发体系。通过规范化的流程约束、结构化的项目知识沉淀、自动化的校验机制,让AI彻底适配企业工程规范,最终实现94%的代码生成率,真正让AI从辅助编码工具,升级为可独立承接需求迭代的开发助手。
一、重构开发流程:八阶段语义化流水线,定义AI开发标准范式
传统人工开发的优势,在于工程师拥有完整的项目认知、规范意识和迭代思维,能够自主完成物料整合、需求拆解、代码定位、开发验证、沉淀复盘全流程。而原生大模型的短板,正是缺乏这套标准化的工程流程,只会机械根据指令生成代码,不具备工程思维。
我们打造的Skill核心,就是一套严格有序的八阶段语义化流水线。整套流程摒弃了模糊的语义交互,每个阶段都拥有固定的输入物料、明确的核心产出、可机器自动校验的退出标准,全程闭环无漏洞。同时我们统一采用“阶段·动作”的命名范式,比如设计稿·脚本筛选、实现·UI·切图、拆解·TAPD收料,让AI在全流程中始终清晰定位自身所处环节,杜绝流程混乱。
整套流水线从需求接入到代码提交沉淀,形成完整闭环,每一个环节都精准对应人工开发的核心动作,同时通过机器标准化规避人工疏漏和模型随机性。
第一阶段为设计稿处理,核心输入是Figma设计链接,通过脚本自动化筛选,输出移动端候选稿清单和PNG高清概览。这一阶段彻底摒弃大模型主观判断的“手感分桶”,完全依靠数据直方图筛选,保证设计稿筛选的客观性和准确性,从源头过滤PC端、平板端、冗余注释稿等无效物料。
第二阶段是需求拆解,整合PRD文档、设计稿、CGI接口协议、TAPD需求单多源物料,输出标准化五列需求清单和用于跨会话接力的subtasks.json台账。核心动作是多源物料统一收料和需求归宿校验,确保每一张设计稿、每一段需求描述,都能精准对应具体业务场景,杜绝需求遗漏。
第三阶段为代码定位,基于拆解后的精准需求点,通过标准化五步定位法,精准匹配对应项目文件、代码行号和完整调用链,解决大型代码库检索难、定位不准的核心痛点。
第四阶段是代码实现,依托精准的调用链和项目上下文,遵循自底向上的开发逻辑,依次完成数据层、解析层、枚举层、业务层、UI层、日志层的代码开发,保证代码逻辑分层清晰、符合项目规范。
第五阶段为编译验证,针对修改后的源码,执行bazel build编译命令,以编译退出码0为唯一合格标准,支持最多三轮AI自主修复,解决代码语法错误、依赖缺失等基础问题。
第六阶段是模拟器验证,将编译通过的产物安装至模拟器,通过自动化操作、截图比对、日志校验,完成功能可用性和UI一致性校验,单阶段允许两轮重试,规避临时环境问题。
第七阶段是知识沉淀,基于git代码变更记录和开发时间线,生成TECH_SPEC.md唯一事实源文档,沉淀功能逻辑、开发决策、迭代历史,实现跨会话知识传承。
第八阶段是代码提交,整合所有开发产物,生成规范的三段式commit记录,完成分支提交,同步统计AI代码生成率,形成完整开发闭环。
这套流水线的核心价值,是把人工开发的隐性经验全部显性化、标准化、机器可执行化。不再依赖开发者的个人经验和判断,而是用固定流程约束AI的每一步动作,彻底解决模型随机性带来的开发风险。
二、四大核心设计公理 + 完整项目目录与核心命令,筑牢AI工程化开发根基
整套Skill流水线的设计,并非简单的流程拆分,而是基于四条核心公理搭建的工程化体系。所有流程、脚本、规则、校验机制,都围绕这四条公理展开,核心目标只有一个,让从未参与过项目开发的AI,在全新会话中能够像资深老员工一样,精准、规范、完整地完成需求迭代。
2.1 范围收敛公理:五步定位法,解决大代码库检索难题
很多团队使用AI开发大型项目时,会陷入一个误区,试图将整个代码库上下文灌入大模型。但九千文件级别的大型项目,完整上下文体量超千万Token,远超模型有效处理范围,只会导致模型信息过载、判断失效。
我们的核心解法是五步漏斗式定位法,通过逐级收敛的方式,将单次模型输入Token量压缩至可控范围,从千万级精简至三万级,实现三百倍的压缩比,同时保证定位精准度。整套流程严格遵循“先宏观后微观、先脚本后模型”的原则,最大程度减少无效模型调用。
第一步为意图消歧,输入2000字以内的项目概述和用户原始需求,输出当前需求对应的所有技术实现路径,完成需求的技术维度拆解,避免理解偏差。第二步是模块定位,依托项目目录树和意图拆解结果,筛选出两到三个核心候选模块和文件路径,锁定大范围开发区域。
第三步跳过LLM,直接通过rg脚本命令执行关键词检索,精准匹配目标函数声明和代码位置,用机器精准检索替代模型模糊判断。第四步进行调用链追踪,加载单文件万Token以内的相关代码片段,梳理完整的代码调用逻辑和层级关系。第五步为验证确认,加载五千Token以内的核心实现代码,最终锁定精准改动点,并输出改动依据。
这套定位法的精妙之处在于,前两步仅依托项目文档和目录结构做宏观判断,第三步完全依靠脚本执行精准检索,直到第四步才会读取核心源码片段。全程层层漏斗收敛,彻底避免模型被海量代码信息淹没,从根源解决代码定位不准、改动范围失控的问题。
2.2 分工协作公理:模型负责判断,脚本负责精准执行
大模型天生存在两大短板,精准数值计算能力弱、重复幂等执行稳定性差。如果让LLM包揽所有开发动作,必然会出现参数错误、执行遗漏、结果失真等问题。基于此,我们确立了明确的分工原则,主观判断、逻辑决策类工作交给LLM,精准检索、批量处理、数值校验、持久化执行类工作,全部下沉到Python、Shell脚本。
在多源物料收集环节,我们拒绝通用抓取脚本,为每一类需求物料配置专属抓取通道。TAPD需求单通过tapd_mcp_http专属接口获取完整单据内容、附件和评论,企微文档通过wecom-cli专属工具抓取结构化内容,Figma设计稿通过专属MCP脚本解析帧信息。严格遵循两条核心红线,禁止通用网页抓取企微文档内容,避免仅获取HTML空外壳,禁止通用抓取TAPD链接,避免丢失结构化需求描述。
设计稿筛选环节最能体现脚本的核心价值。一份Figma文件通常包含数十上百个画板,混杂移动端、PC端、平板端、备用稿、注释稿等各类内容,依靠模型主观判断筛选,极易出现错选、漏选。我们通过scan_figma_frames.py脚本,依托iphone_sizes.json设备尺寸白名单,生成画板尺寸直方图,完成客观分桶筛选。LLM仅可对不确定的UNCERTAIN项做补充判断,无权主观筛选画板,彻底杜绝人工手感判断带来的随机性误差。
同时我们引入落盘判定机制,彻底解决命令执行结果误判问题。终端执行长命令时,经常出现输出截断、后台运行、异步执行等问题,导致模型误判执行结果。我们规定,所有长跑命令的成功判定标准,不再依赖终端输出日志,而是以专属sentinel文件落盘为唯一依据。Git提交、代码编译、文档生成等核心动作,全部通过文件存在性、Git哈希值等客观标识判定结果,彻底规避信号丢失导致的开发事故。
2.3 风险管控公理:红线硬关卡,前置拦截所有翻车风险
大模型的最大工程风险,是无底线执行指令,无论需求是否合理、改动是否合规、代码是否可用,都会直接生成结果,极易引发越界修改、规范破坏、线上bug等问题。为了约束模型行为,我们搭建了分层级的红线管控体系,将所有历史翻车场景固化为可机器校验的硬规则,实现风险前置拦截。
整套红线体系分为两级,Critical核心红线共6条,项目启动即全局加载,违反后直接终止流程,规避线上事故和严重返工。Standard通用红线30余条,根据不同开发阶段按需加载,杜绝工程规范被破坏。所有红线规则统一收录在red_lines.yaml文件中,作为唯一真实数据源,可自动解析生成规范文档,保证全流程规则统一。
红线体系拥有固定的报错和处理机制,一旦触发规则,AI必须立即停止当前操作,按照固定模板输出报告,明确标注触发的红线编号、当前违规场景、具体整改方案和回退路径,让所有违规行为可追溯、可整改。
其中几条核心红线,是我们从无数实战事故中总结的关键准则。RL-15规定编译通过为开发完成的前置标准,以编译退出码0为唯一判定依据,最多支持三轮自主修复,杜绝AI虚假完成开发的问题。RL-16强制流程顺序约束,后一阶段的执行必须依赖前一阶段的标准化产出,禁止跳过需求拆解、定位等环节直接编码,从根源拦截越界开发。
RL-13和RL-14确立先读后写、模仿现有规范的原则,禁止AI凭空创造全新代码模式,所有新增代码必须贴合项目现有编码风格和架构设计。RL-31规范代码提交校验规则,以git log -1 hash更新记录为提交成功的唯一凭证,规避终端异步执行导致的提交状态误判。整套红线体系相当于给AI戴上了紧箍咒,将所有模糊的工程规范,转化为机器可识别、可拦截的硬规则。
2.4 知识传承公理:结构化沉淀,实现跨会话无缝接力
传统AI开发的一大致命短板,是跨会话失忆。每次新建对话,模型都会遗忘之前的开发逻辑、代码改动原因、功能边界定义,导致迭代需求、bug修复需要重复沟通、重复梳理代码,大量工作无效返工。我们通过搭建三重知识沉淀体系,彻底解决跨会话记忆丢失问题,让AI拥有和团队开发者一样的迭代记忆。
整套知识传承体系由三份核心文件组成,各司其职覆盖不同时间维度的迭代需求。TECH_SPEC.md承担永久知识沉淀职责,记录功能边界、模块拓扑、代码不变式、bug迭代历史、版本演进记录,是项目功能的唯一事实源。subtasks.json负责跨会话接力,记录每一个子需求的开发状态、所属阶段、关联提交记录,实现迭代无缝衔接。timeline.txt负责会话内事件记录,完整留存启动、人工校正、代码提交等全流程事件流水,方便复盘追溯。
其中TECH_SPEC.md是整套体系的灵魂,拥有标准化的固定结构,涵盖AI自检清单、功能边界、模块地图、核心不变式、迭代演进事件、产物清单、版本号迭代九大核心板块。新会话的AI只需按照固定顺序读取文档,就能快速掌握项目功能逻辑、禁止改动范围、历史迭代问题,无需人工重复讲解。
同时我们设置多场景入口分流机制,覆盖全新开发、bug修复、增量迭代、重构优化四类核心场景,适配需求全生命周期。搭配HK人机硬关卡机制,在进度接力、需求翻译、知识沉淀、代码提交四个关键节点,强制人工确认,实现自动化高效迭代和人工可控性的完美平衡,既保证开发效率,又杜绝不可逆的错误改动。
为了让整套Skill体系可落地、可复用、可运维,我们搭建了结构清晰、分层解耦的完整项目目录,所有自动化脚本、规则文件、知识库、流程规范均固定归档,同时配套可直接线上执行的核心命令,覆盖收料、筛查、编译、验证、沉淀、提交全流程。所有目录和命令均贴合企业级移动端项目实战场景,完全适配九千文件级别的大型代码库迭代,也是整套AI工程化体系能够稳定落地的核心载体。
2.5 全套Skill项目目录详解(生产级结构)
整套Skill工程统一收纳在 skills/mailplugin-feature-dev/ 根目录下,按照「入口层-配置层-脚本工具层-知识知识库层-流程规则层-红线管控层」六层架构拆分,目录职责清晰、各司其职,无冗余、无耦合,方便迭代维护和新人快速认知。
skills/mailplugin-feature-dev/
│
├── ① 对外入口层(LLM启动优先加载,流程总控)
│ ├── SKILL.md # 核心流程总图、四类业务入口、全局强约束规则
│ ├── README.md # 人工使用指南、环境依赖、启动方式
│ └── CHANGELOG.md # 版本迭代日志、能力更新记录
│
├── ② 环境安装与配置层(一次性初始化)
│ └── setup/
│ ├── install.sh # 一键部署:MCP注册、依赖安装、环境校验
│ ├── uninstall.sh # 一键卸载:环境清理、缓存清除
│ └── mcp.tapd.json # TAPD MCP服务专属配置(鉴权、接口地址、超时参数)
│
├── ③ 核心自动化脚本层(整套体系的执行引擎)
│ └── tools/
│ # 多源物料收料脚本(解决物料分散问题)
│ ├── fetch_tapd_story.py # 全量拉取TAPD需求:单据正文、附件、评论、迭代记录
│ ├── fetch_tapd_images.py # 批量下载TAPD内嵌图片、截图素材
│ ├── fetch_figma_mcp.py # Figma结构化数据拉取,解析图层、样式、节点ID
│ ├── scan_figma_frames.py # 设计稿直方图筛查,移动端画板自动分拣
│ │
│ # 知识沉淀与文档维护脚本(解决跨会话失忆)
│ ├── locate_feature_doc.py # 自动定位当前需求对应的TECH_SPEC.md路径
│ ├── render_tech_spec.py # 首次迭代自动生成标准化技术规格文档
│ ├── append_evolution_log.py # 增量更新迭代日志、版本号、功能变更记录
│ ├── append_bug_fix.py # 单独追加bug修复记录、根因、修复方案
│ ├── breakdown_subtasks.py # 需求拆解,自动生成subtasks.json跨会话台账
│ ├── gen_red_lines_docs.py # 从yaml红线配置自动生成可读规范文档
│ │
│ # 编译校验与知识库运维脚本(解决规范漂移、编译报错)
│ ├── build_verify.sh # bazel编译构建、退出码校验、错误日志解析
│ ├── check_implement_done.sh # 代码开发完成度自检,校验是否漏改、缺逻辑
│ ├── check_intermediate_artifacts.py # 阶段产物完整性校验,缺失则终止流程
│ ├── check_project_wiki_stale.py # 知识库SHA比对,自动标记过时文档
│ ├── check_ui_token_usage.sh # UI样式合规校验,拦截硬编码颜色、字号
│ │
│ # 模拟器验证与代码提交脚本(解决UI走样、提交异常)
│ ├── install_to_simulator.sh # 编译产物安装至模拟器、保留登录态
│ ├── iphone_sizes.json # 官方iPhone尺寸白名单、像素换算规则库
│ ├── finalize_commit.sh # 提交前最终校验、产物汇总
│ ├── render_commit_msg.py # 自动生成三段式规范commit日志
│ ├── timeline_to_commit_lines.py # 会话时间线转化为提交变更说明
│ └── md_to_pdf.py # 技术文档导出归档
│
├── ④ 项目知识库与语义桥(AI的项目地图)
│ └── references/
│ ├── project_wiki/ # 三级知识库核心目录
│ │ ├── overview.md # L1 项目全局总览(5KB以内)
│ │ └── *.md # L2 各模块细分文档(mlist.md、rmail.md等)
│ │
│ ├── figma_token_mapping.md # L3 UI语义桥:Figma Token ↔ 工程API映射
│ ├── figma_device_sizes.md # 多设备尺寸适配规范
│ └── ui_components_wiki.md # 全局UI组件开发规范、复用标准
│
├── ⑤ 全流程细则文档(分阶段按需加载)
│ └── references/
│ # 八阶段流水线执行细则
│ ├── stage_locate.md
│ ├── stage_design.md
│ ├── stage_breakdown.md
│ ├── stage_implement.md
│ ├── stage_verify.md
│ ├── stage_simulator_verify.md
│ ├── stage_commit.md
│ ├── stage_archive.md
│ │
│ # 四类业务场景专属流程
│ ├── bug_fix_workflow.md
│ ├── incremental_workflow.md
│ ├── redo_workflow.md
│ │
│ # 工程避坑工具箱
│ ├── simulator_toolbox.md
│ └── tech_spec_template.md
│
└── ⑥ 红线硬规则管控层(风险拦截核心)
└── references/
├── red_lines.yaml # 全局红线唯一配置源(DSL结构化配置)
├── red_lines_critical.md # 核心高危红线文档(启动必加载)
└── red_lines_by_stage/ # 分阶段按需生效红线
├── global.md
├── locate.md
├── design.md
├── breakdown.md
├── implement.md
├── verify.md
├── simulator_verify.md
└── commit.md
2.6 高频核心命令实操与使用场景(全流程可直接执行)
整套Skill摒弃模糊的模型交互,所有核心能力均通过可复现、可校验、可自动化调度的命令执行,每一条命令对应固定开发场景,完全替代人工重复操作,同时规避LLM主观随机性。
物料收料与需求拆解命令
用于开发初始化阶段,一键完成多源物料整合,替代人工1-2小时的物料整理工作。
python3 tools/fetch_tapd_story.py –tid 1008611 –output ./artifacts/tapd_story.md
该命令通过专属MCP接口拉取指定TAPD需求单全量内容,包含需求正文、验收标准、历史评论、附件链接,自动结构化输出为Markdown文档,规避通用抓取导致的内容缺失、格式错乱问题。
python3 tools/scan_figma_frames.py –key xxxxxxxx –device iphone
基于iphone_sizes.json尺寸白名单,对Figma画板做直方图统计筛选,仅保留合法移动端页面,自动剔除PC、平板、草稿、注释画板,输出标准化候选稿清单,严格遵循RL-17禁止LLM主观分桶的红线规则。
代码定位与检索命令
配合五步定位法使用,替代人工模糊检索,精准收敛代码改动范围,规避全局检索Token过载问题。
rg "XYZTipsView|showWarningTips" App/Mailbox/MList/ -l
这是项目专属的漏斗式检索命令,依托L2模块知识库生成,跳过LLM语义联想,直接通过脚本精准匹配组件类、显示方法、业务关键词,快速命中目标文件与代码位置,解决中文需求描述与英文代码命名的语义鸿沟,避免0命中或海量冗余命中问题。
编译验证与自修复命令
代码改动完成后强制执行,是判定开发完成的唯一前置标准,遵循RL-15核心红线。
bash tools/build_verify.sh –target //App/Mailbox:mail_plugin –max-retry 3
调用bazel编译指定业务目标,以退出码0为唯一合格标准,自动解析语法错误、类型不匹配、枚举缺失等A类可修复问题,最多执行三轮自主修复,超出轮次直接终止流程并上报报错,杜绝AI无限试错、越改越乱的问题。
模拟器自动化验证命令
编译通过后执行,完成自动化装机、页面跳转、截图比对、日志校验,落地UI视觉合规校验。
bash tools/install_to_simulator.sh –udid $UDID –keep-login
将编译产物安装至指定模拟器,–keep-login参数保留设备登录态,避免重复登录、数据为空导致的验证失败,解决模拟器沙盒重置的工程痛点。
idb ui tap –udid $UDID 200 420
精准执行模拟器坐标点击操作,配合动态像素换算规则,解决物理像素与逻辑像素不匹配导致的点击失效问题,自动化完成所有UI交互验证步骤。
知识库运维与红线校验命令
保障项目知识库实时同步、不与代码漂移,是AI精准认知项目的核心保障。
python3 tools/check_project_wiki_stale.py –scan-all –auto-mark
全局扫描所有代码文件SHA变更,比对知识库基线,自动标记新增、删除、大幅修改的过时文档,生成三色分诊清单,配合pre-commit钩子阻断违规提交,保证文档与代码永久同步。
python3 tools/check_ui_token_usage.sh –path App/Mailbox/UI/
批量校验UI代码,筛查硬编码字号、颜色、阴影等违规写法,对照figma_token_mapping.md语义桥文档,拦截所有不符合RL-29规范的代码,杜绝设计稿走样问题。
知识沉淀与代码提交命令
开发收尾阶段执行,完成知识归档、规范提交、版本迭代记录。
python3 tools/render_tech_spec.py –type iteration –out ./artifacts/TECH_SPEC.md
自动生成标准化技术规格文档,汇总功能边界、模块地图、改动点、不变式、迭代日志,作为跨会话接力的唯一事实源。
bash tools/finalize_commit.sh –msg-auto –check-redline
自动生成三段式规范commit日志,前置红线规则校验,校验通过后执行提交,以git log -1 hash为最终提交成功凭证,规避终端异步执行导致的状态误判。
三、三级金字塔知识库,打造AI专属项目全景地图
精准的代码定位、规范的代码开发,前提是AI拥有清晰、完整、实时的项目认知。原生大模型对项目的理解完全依赖临时输入的代码片段,碎片化且滞后,无法适配大型项目的迭代节奏。为此我们搭建了三级金字塔结构化知识库,搭配自动漂移检测机制,让AI随时拥有最新、最完整的项目全景地图,同时兼顾新人上手学习需求。
3.1 三级知识库分层设计,按需加载精准赋能
整套知识库分为L1总览、L2模块、L3语义桥三个层级,从宏观架构到微观字段逐层细化,支持按需加载,最大化节省Token资源,同时保证信息完整性。
L1为项目总览文档,以overview.md为核心,整体体量控制在5KB以内,定位阶段默认预加载。文档以表格形式清晰罗列项目所有一级模块,明确每个模块的核心职责、关联详细文档路径,相当于项目的大堂导览图。AI在需求定位初期,无需检索代码,仅通过这份文档就能快速锁定目标业务模块,实现秒级大范围定位。同时这份文档也能帮助新人快速搭建项目整体认知,半天即可摸清项目整体架构。
L2为模块级文档,以各个业务模块独立的模块名.md为载体,命中对应业务模块后按需加载。每份模块文档顶部标注机器可读的元数据,包含模块ID、根目录、核心功能描述,下方以表格形式罗列模块内所有控制器、视图、工具类文件,逐行标注每个文件的核心职责、功能边界、关联文件。这份文档相当于项目的街道地图,把资深工程师脑海中的隐性项目拓扑,全部显性化、结构化,让AI精准知晓每个文件的定位和作用。
L3为领域语义桥,是最具工程价值、最容易被忽视的核心层级,核心文件包含figma_token_mapping.md和ui_components_wiki.md,UI开发阶段强制加载。其核心作用是抹平设计端、协议端和代码端的语义鸿沟,解决UI样式硬编码、设计稿走样的行业顽疾。
以往开发中,面对Figma设计稿的字号、颜色、样式参数,开发者或AI容易凭肉眼判断硬编码写入代码,导致深色模式适配失效、样式不统一、版本迭代错乱等问题。而语义桥文档固化了所有UI规范映射规则,将Figma端的Mobile/callout文字样式、Base/base_gray_100颜色规范,精准映射到项目专属工程API。
我们通过RL-29硬性规则强制约束,所有UI改动必须对照语义桥映射文档,禁止硬编码字号、颜色、阴影等样式参数,彻底杜绝设计稿和线上页面样式偏差问题。目前这份映射表已覆盖字体样式、颜色规范、按钮组件、阴影渐变等二十余类UI规范,全面覆盖移动端常规开发场景。
3.2 自动维护机制,杜绝知识库与代码漂移
结构化知识库的搭建难度较低,核心难点在于长期时效性维护。企业级项目持续迭代,半年内可新增数百个文件、产生上千处代码改动,纯人工维护知识库会产生巨大成本,且极易出现文档和代码脱节的问题。为此我们开发了check_project_wiki_stale.py专属维护脚本,实现知识库自动化迭代更新。
脚本核心依托SHA基线缓存机制,通过.review_cache.json文件记录每个代码文件上次更新对应的SHA值。当代码文件发生新增、删除、大幅修改时,脚本会自动标记待复核状态,生成三色分诊清单,清晰区分新增、删除、大改三类变动,开发者30秒即可完成全局扫描。
同时我们配置pre-commit提交钩子,一旦检测到代码改动后知识库未同步更新,会直接阻断代码提交,强制开发者顺手完成文档同步。搭配元数据自动联动机制,修改模块文档的功能描述后,项目总览文档会自动同步更新,无需人工二次修改。
这套自动化维护机制,让我们的项目在半年数百次迭代、千余处代码改动的情况下,始终保持知识库和代码完全同步,彻底解决了文档滞后、失效、脱节的行业痛点,同时实现了AI开发赋能和新人入职赋能的双向价值。
3.3 知识库+定位法联动,实现极致提效
将三级知识库和五步定位法结合,就能形成完整的精准定位闭环,最大化压缩无效检索和判断成本。在需求定位过程中,AI首先通过L1总览文档1秒锁定核心业务模块,再依托L2模块文档5秒锁定目标文件,无需遍历源码。随后通过脚本精准检索核心关键词,仅加载万Token以内的核心调用链片段,最后参照L3语义桥规范,杜绝不规范编码。
整套流程将原本千万级Token的上下文负载,压缩至三万级,在保证定位精准度100%的前提下,实现三百倍的Token压缩比,大幅提升模型推理速度和开发准确率。
四、需求语义翻译:打通产品语言到代码语言的最后鸿沟
解决了代码侧的认知问题后,还需要攻克需求侧的语义转化难题。产品的需求描述是口语化、业务视角、模糊宽泛的,而代码开发是标准化、技术视角、精准严谨的,两者天然存在语义鸿沟。传统开发中,工程师的核心工作量之一,就是将产品模糊的自然语言需求,翻译为精准的代码开发指令。我们通过标准化拆解规则,让AI自主完成语义翻译,彻底解放人工翻译成本。
4.1 需求翻译的五大核心翻车点
在未标准化翻译规则前,AI处理产品需求极易出现五类典型问题,也是企业级开发漏需求、改bug、功能越界的核心根源。一是范围错判,PRD文档经常混杂后端配置、前端页面、移动端功能,模型容易整体判定为非移动端需求,遗漏客户端核心功能。二是归宿不明,多页设计稿无法精准匹配需求点,将有效页面笼统归为参考图,造成功能遗漏。
三是联想扩大,AI凭借语义主观延伸功能逻辑,在产品未明确要求的场景下,擅自新增拦截、适配、兼容逻辑,导致越界修改。四是关键词匹配失效,产品口语化描述和代码工程命名体系脱节,直接检索无结果,宽泛检索被海量冗余信息淹没。五是文件定位错误,相似业务模块混淆,改动完全偏离目标业务场景。
针对这五类翻车场景,我们逐一制定硬性规则,将概率性问题转化为确定性机器校验规则,彻底杜绝需求拆解失误。
4.2 五大硬性规则,实现需求精准翻译
我们通过五层确定性规则,逐层封堵需求翻译的所有漏洞,让AI完全脱离主观语义判断,依靠客观规则完成标准化拆解。
第一是硬关键词范围识别规则,摒弃模型语义主观判断,搭建移动端专属强信号关键词库。只要PRD段落中命中手机端、iOS、弹窗、红点、下拉刷新、安全区等预设关键词,无论段落主旨是否为后端配置,都强制判定为移动端需求,单独拆解开发项。这条规则彻底解决了需求范围错判的问题,将漏判概率降至零。
第二是设计稿归宿强制归类规则,对应RL-12红线,所有筛选后的移动端设计稿,必须精准归为新增UI、修改逻辑、交互适配三类场景之一,禁止设置未归类、参考图等模糊分类。无法归类的设计稿,要么剔除无效物料,要么新增对应需求项,彻底显性化隐藏的需求遗漏问题。
第三是交互拦截溯源规则,对应RL-21红线,彻底禁止AI语义联想扩展。所有点击拦截、弹窗触发、状态变更的交互逻辑,必须明确标注依据来源,仅认可Figma标注、TAPD原文、用户原话三类有效依据。任何无明确溯源的扩展逻辑,一律直接删除,杜绝AI自作主张的越界开发。
第四是五维搜索矩阵,解决产品口语到工程命名的语义转化难题。产品描述的小红条、提示弹窗等口语化词汇,无法直接匹配代码中的Tips、Banner、Warning等标准化命名。我们搭建五大搜索维度,覆盖iOS系统API、功能语义同义词、项目命名习惯、代理协议、跨模块通信方式,全方位扩展精准搜索词。
同时依托项目知识库和命名规范词典,精准匹配项目专属命名风格。以邮件列表域名过期提示需求为例,通过五维矩阵可快速将小红条映射为XYZTipsView组件、showWarningTips显示方法、domainExpire业务关键词,生成精准的检索命令,彻底解决关键词匹配失效问题。
第五是结构化产物输出规则,所有需求拆解完成后,必须输出人类可读的五列需求清单,以及机器可识别的subtasks.json文件。明确每个需求项的编号、功能描述、改动类型、数据来源、关联设计稿节点,同时标注任务依赖关系,为后续编码、迭代、接力开发提供标准化输入。
4.3 标准化翻译闭环,彻底解放人工翻译工作
整套语义翻译体系,结合代码侧的知识库地图,形成了完整的需求开发闭环。AI可以自主完成多源物料整合、需求范围判定、设计稿归类、交互逻辑溯源、关键词扩展、结构化输出全流程工作。原本需要工程师1到2小时的需求拆解工作,现在AI仅需5到10分钟即可完成,且拆解精度、完整性、规范性远超人工。
这也是AI提效的核心关键,真正的效率提升从来不是AI写代码的速度更快,而是AI彻底替代了人工最繁琐、最重复、最依赖经验的需求翻译工作。开发者从PRD翻译机、需求拆解员的角色中解放出来,仅保留核心决策权限,转变为AI的产品经理,专注于需求合理性、功能边界、技术方案的顶层判断。
五、双层验证闭环,让AI代码真正可上线、可信赖
AI编码最核心的信任问题,是自主判定的完成状态不可信。代码编写完成不代表编译通过,编译通过不代表功能正常,功能正常不代表UI样式合规。我们搭建了编译验证+模拟器运行验证的双层闸门,通过自动化、可量化、可追溯的校验机制,让AI产出的每一段代码都具备上线标准。
5.1 第一层闸门:编译自动化校验与自修复
代码改动完成后,AI禁止自主判定开发完成,必须执行bazel build编译命令,以退出码0为唯一合格标准。我们将编译错误分为两类,实现差异化处理,避免无效返工和风险扩散。
A类为可自修复错误,包含缺分号、标识符未声明、类型不匹配、枚举漏case、头文件缺失等基础语法和依赖问题,AI可通过替换文件、补充代码的方式自主修复,最多支持三轮修复迭代,超过三轮未解决则自动终止流程,上报人工处理,避免越改越乱。
B类为需人工介入错误,包含编译配置错误、链接异常、三方框架报错、非改动文件报错等复杂问题,AI禁止自主尝试修复,立即终止流程并输出详细报错日志,交由人工排查。这套分类机制既最大化提升自动化效率,又规避了盲目修复带来的代码风险。
5.2 第二层闸门:模拟器自动化运行与视觉校验
编译通过仅能保证代码语法合规,无法验证业务功能和UI展示效果。我们搭建了完整的模拟器自动化验证流程,实现装机、操作、截图、日志校验、视觉比对全自动化执行。
AI首先根据Git代码变更记录、技术文档、设计稿终态,反向推导标准化UI验证路径,生成verify_plan.md验证方案,明确每一步操作步骤、预期效果、截图节点、日志校验标准。针对UI改动、数据逻辑改动、纯业务逻辑改动等不同场景,适配对应的验证终点,确保所有代码改动都能对应可落地的验证动作。
验证执行过程中,通过idb工具完成模拟器启动、页面跳转、按钮点击等自动化操作,全程实时输出操作日志和截图文件。针对验证失败场景,我们同样采用A/B/C三类分类诊断机制,精准区分问题类型。A类为代码真实bug,立即回退至编码阶段整改;B类为验证路径不合理,修订验证方案后重新执行;C类为临时环境、时序问题,允许两轮阶段内重试,重试失败则判定为功能异常。
针对UI改动场景,我们通过RL-30红线实现视觉对齐硬校验,对照ui_alignment_spec.md规范文档,逐项核对控件尺寸、居中样式、字体字号、颜色参数、行高间距等指标,量化统计对齐偏差。所有未对齐项全部显性化展示,存在关键偏差直接判定验证失败,彻底杜绝肉眼比对的误差和疏漏。
5.3 工程死角沉淀,规避隐性开发陷阱
在长期模拟器验证过程中,我们梳理出大量模型无法自主感知的工程死角,全部沉淀为simulator_toolbox.md专属手册,让AI规避各类隐性陷阱。比如模拟器不支持3D Touch力度感应、边缘左滑手势无法通过合成事件触发、物理像素与逻辑像素需要动态换算、重装应用可保留登录态等实战细节。这些问题均非模型能力短板,而是工程环境固有特性,通过手册固化后,AI可全程主动规避,大幅降低验证失败概率。
六、实战提效数据与落地启示
整套Skill流水线体系在企业微信移动端项目落地半年,覆盖数千次代码改动、上百轮需求迭代,沉淀出真实可落地的提效数据,全方位优化传统开发流程。
在需求拆解环节,传统人工需要1到2小时整合多源物料、梳理需求点,AI自动化处理仅需5到10分钟,效率提升十倍以上。代码定位环节,人工试错检索需要30分钟到2小时,AI依托知识库和五步定位法,最快5分钟即可精准锁定改动点。编码实现环节,通过规范复用、精准改动、减少返工,整体编码效率提升30%至50%。
编译自查、UI视觉比对、日志校验等重复性工作,全部实现自动化执行,彻底解放人工重复劳动。最核心的隐性收益体现在迭代接力和新人培养上,传统bug修复、迭代开发需要重新梳理代码、对接原作者,耗时1小时以上,现在依托结构化沉淀文档,5分钟即可恢复现场、接续开发。新人无需依赖老员工一对一讲解,通过项目知识库即可快速搭建项目认知,大幅降低入职上手成本。
基于半年落地实战,我们总结出五条可通用落地的AI工程化开发原则,适用于所有中大型技术项目。首先是流水线化,将模糊的开发工作拆解为标准化、可校验的细分阶段,明确每一步的输入输出和退出标准。其次是脚本兜底,将精准执行、批量处理、数值校验类工作全部下沉至脚本与可执行命令,让模型专注于逻辑决策。
第三是红线前置,将所有历史翻车场景固化为机器可拦截的硬规则,提前规避开发风险。第四是落盘判定,所有核心执行动作以文件落盘、数据记录为唯一判定标准,杜绝终端输出误差。第五是沉淀闭环,每次需求迭代同步沉淀结构化技术文档,让知识和代码同步迭代、等量沉淀。
结语:AI编码的天花板,在于工程体系而非模型能力
落地整套Skill体系后,我们彻底改变了对AI编码的认知。最初我们的目标是让AI辅助写代码,追求更高的代码生成速度。但最终落地结果证明,AI编码提效的核心从来不是模型参数、推理速度等原生能力,而是工程体系的规范化、标准化、结构化。
94%的代码生成率,背后不是模型的超强算力,而是数千条显性化的工程规则、结构化的项目知识、自动化的校验流程、闭环的迭代沉淀体系。我们把资深工程师的隐性开发经验、项目规范、避坑技巧、迭代思维,全部转化为AI可识别、可执行、可复用的标准化体系。
更重要的是,整套体系的价值不局限于AI赋能。我们沉淀的项目知识库、技术规范文档、迭代复盘记录,即使脱离AI工具,依然是团队核心的工程资产,能够持续优化团队开发流程、降低新人上手成本、规范项目迭代标准。