Lakehouse 数据湖三大格式横向深度评测:Apache Iceberg vs Delta Lake vs Apache Hudi 架构选型与适用场景全景对比
在现代大数据技术栈从传统“Lambda 架构 / 分离数仓”向 Lakehouse(湖仓一体) 演进的过程中,基于开放列存文件(Parquet / ORC)之上的 数据湖存储表格式(Table Format) 扮演了整个技术底座的“承重墙”角色。
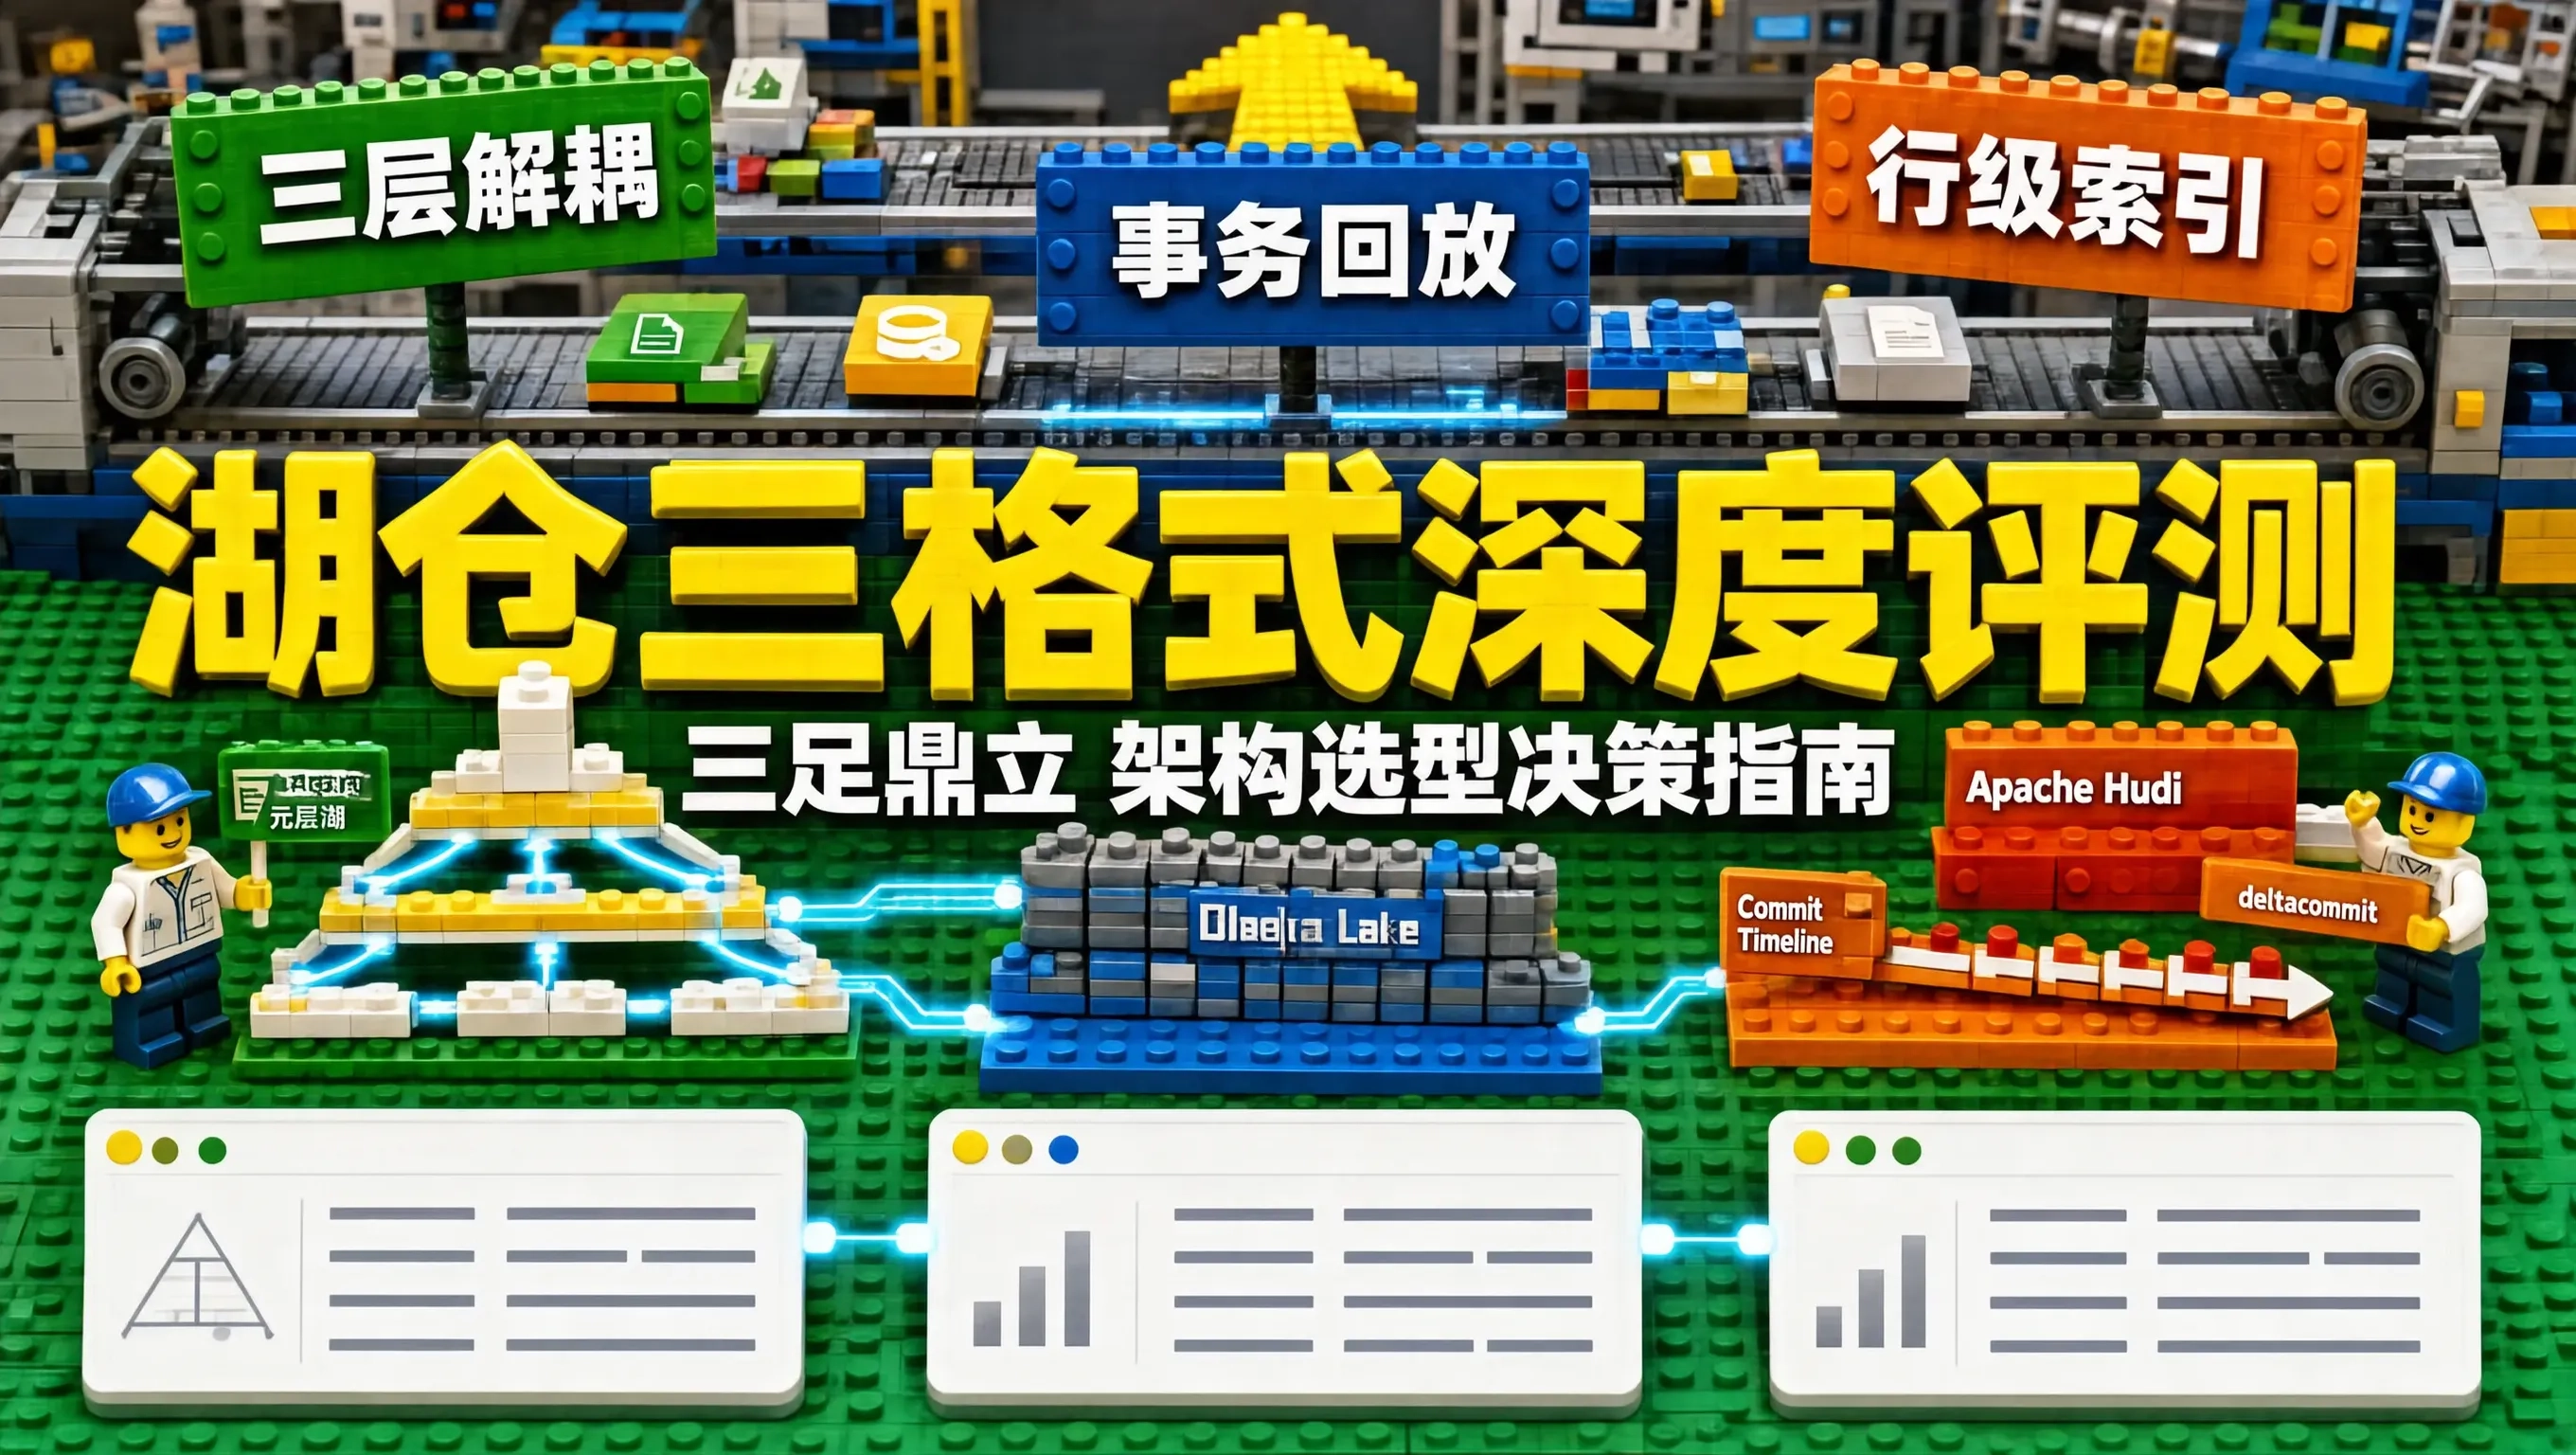
当前开源社区形成了三足鼎立的格局:
- Apache Iceberg(Netflix 开源,顶级 Apache 项目);
- Delta Lake(Databricks 开源,Linux 基金会托管);
- Apache Hudi(Uber 开源,顶级 Apache 项目)。
很多技术团队在进行湖仓一体选型时,往往被各家厂商的基准宣传搞得眼花缭乱:
- 盲目选用了与自身引擎不匹配的表格式,导致在 Flink 实时 CDC 入湖时遭遇严重的元数据冲突;
- 或者在多引擎(Spark + Trino + ClickHouse + StarRocks)混合查询场景下,因缺乏一等公民支持而频发语法不兼容与读取性能滑坡。
三大数据湖表格式的**底层元数据拓扑(Metadata Architecture)**有什么本质区别?并发控制冲突解决机制(OCC Conflict Resolution)孰优孰劣?在大规模批处理、秒级 CDC 实时写入、多引擎互操作场景下该如何精准选型?
本文深度剖析三大湖格式的底层架构机理、对比矩阵,并给出企业级生产选型决策树与实战准则。
一、Iceberg vs Delta Lake vs Hudi 核心架构横向全景对比矩阵
| 核心技术基因与定位 | 引擎完全中立的通用表格式,三层树状解耦元数据 | 与 Apache Spark 生态高度融合,基于事务日志回放 | 专为海量高频行级 CDC Upsert/Delete 打造 |
| 底层元数据结构 (Metadata) | metadata.json ➔ manifest-list.avro ➔ manifest.avro | _delta_log/0000.json + 每 10 个 Commit 合并为单个 Parquet | .hoodie/ 目录下的 Commit Timeline 时间轴与元数据 |
| 多计算引擎生态支持度 | 🏆 极佳(Spark、Flink、Trino、Presto、StarRocks 全平台一等公民支持) | 较好(Spark 最强,其他引擎主要通过 Delta Standalone/Kernel 接入) | 良好(Spark 与 Flink 支持完善,Trino 读取性能中等) |
| 分区演进 (Partition Evolution) | 🏆 黄金标准(支持隐藏分区 Hidden Partitioning,修改分区粒度零重写历史数据) | 物理显式目录分区(修改分区需重写数据或依赖 Liquid Clustering) | 物理显式目录分区(不支持隐藏分区) |
| 行级更新机制 (CDC Updates) | 支持 CoW (Copy-on-Write) 与 MoR (Merge-on-Read: Position/Equality Deletes) | 原生主打 CoW (写时复制),最新版本引入 Deletion Vectors (类似 MoR) | 🏆 极强(原生内置 MoR 增量日志 Log 机制与 Record-Level Index) |
| 索引加速能力 (Indexing) | 文件级 Min/Max 列统计值 + Bloom Filter | 文件级 Min/Max + Z-Order 空间局部性多维聚类 | 内置多种行级索引(HBase Index / Record Index / Bloom Index) |
| 小文件合并与运维开销 (Maintenance) | 提供丰富的内置 SQL 存储过程(rewrite_data_files),调度极灵活 | 提供 OPTIMIZE 与 VACUUM 命令,易用性好 | 内置 Compact 调度与 Cleaner,但配置参数庞杂度极高 |
二、三大表格式底层元数据架构物理拓扑比对
[1. Apache Iceberg: 三层树状解耦快照树]
Catalog Pointer
-> metadata.json (Table Metadata)
-> snap-8899.avro (Manifest List: 分区级裁剪)
-> manifest-1.avro (文件级 Min/Max 统计)
-> data_1.parquet, data_2.parquet (物理数据)
———————————————————————————
[2. Delta Lake: 基于单调递增 JSON 事务日志回放]
_delta_log/
├── 000000.json (第 1 次 Commit 操作日志)
├── 000001.json (第 2 次 Commit 操作日志)
└── 000010.checkpoint.parquet (每 10 次 Commit 压实合并为 1 个状态快照)
———————————————————————————
[3. Apache Hudi: 基于时间轴 (Timeline) 与混合日志]
.hoodie/
├── 202608290001.commit (批处理提交)
├── 202608290002.deltacommit (实时增量提交)
└── .aux/ (包含 Hoodie 专有索引元数据)
三、生产选型四大核心考量维度与选型决策树
[企业 Lakehouse 选型启动]
|
v
+——————————————+
| 核心诉求是否为: "高频秒级 CDC 实时写入" |
| 且需要极强的行级主键去重 (Record Index)? |
+——————————————+
/ \\
(YES) / \\ (NO)
v v
+———————–+ +——————————————+
| 🌟 首选: Apache Hudi | | 公司主力计算栈是否为 Spark 独占生态 |
| (在实时 CDC 增量入湖 | | 且深度依赖 Databricks 商业平台? |
| 场景下写入性能最强) | +——————————————+
+———————–+ / \\
(YES) / \\ (NO)
v v
+———————+ +————————————+
| 🌟 首选: Delta Lake | | 🌟 黄金标准: Apache Iceberg |
| (与 Spark 生态原生 | | (多引擎完全中立: Spark+Flink+Trino |
| 深度绑定,Z-Order) | | 隐藏分区、多流并发写首选方案) |
+———————+ +————————————+
四、生产级选型实战场景深度剖析
场景 1:多引擎混合分析与跨部门数据资产共享(推荐:Apache Iceberg)
- 典型业务画像:企业内部存在 Flink 实时计算、Spark 离线批处理、Trino 交互式即席查询、StarRocks 报表加速;
- 为什么选 Iceberg:Iceberg 的规范最开放且完全独立于任何特定计算引擎。任何引擎都可以通过统一的 Iceberg Catalog 访问数据,不会出现 Delta Lake 在非 Spark 引擎下语法受限或 Hudi 依赖专有 HoodieInputFormat 导致的读取开销。
场景 2:基于 Spark 的超大规模机器学习特征库与批量数仓(推荐:Delta Lake)
- 典型业务画像:以 PySpark / Spark SQL 为绝对主力,依赖 Databricks 平台,需要频繁对几十个特征列执行复杂的多维范围过滤;
- 为什么选 Delta Lake:Delta Lake 的 OPTIMIZE … ZORDER BY (user_id, feature_1, feature_2) 空间多维聚类能够极大降低海量 Parquet 文件的扫描量,配合 Caching 机制在 Spark 生态下性能极佳。
场景 3:千亿级 MySQL / Oracle 实时整库 CDC 同步与行级更新(推荐:Apache Hudi / Iceberg MoR)
- 典型业务画像:上游业务表存在海量 UPDATE 与 DELETE 变更(如订单状态频繁变更),需要秒级/分钟级在湖仓中追平;
- 为什么选 Hudi:Hudi 的 Record-Level Index(如基于 RocksDB 或 HBase 的全局索引)能够在数据写入时以极快速度定位旧数据所在的物理文件,避免了重写整个大文件的开销。
五、生产避坑与数据湖格式运维红线
在落地任何数据湖表格式时,必须坚守以下四项落地原则:
通过深刻理解三大数据湖表格式在元数据架构、ACID 事务模型与生态兼容度上的本质差异,企业技术架构委员会能够做出最契合自身数据流转链路与计算引擎生态的科学选型,彻底扫除未来架构演进与技术重构的阻碍。