文章目录
-
- 每日一句正能量
- 一、工业 AI 的"最后一公里"困境
- 二、范式对比:从"手工作坊"到"智能流水线"
- 三、构建端到端时序智能流水线
-
- 3.1 数据接入:打破格式壁垒
- 3.2 自动预处理:让数据"自我清洁"
- 3.3 模型推理:一个模型解决多种任务
- 四、实战:自然语言驱动的时序根因分析
-
- 4.1 用"人话"问数据
- 4.2 多变量根因定位的 SQL 实现
- 五、避坑指南:流水线落地的五个关键细节
-
- 避坑一:忽视数据质量评分
- 避坑二:混淆"相关性"与"因果性"
- 避坑三:过度依赖单点预测
- 避坑四:忽略模型的置信区间
- 避坑五:缺乏反馈闭环
- 六、结语:让时序数据自己"说话"
每日一句正能量
“你很自由,充满了无限可能。” 无论过去如何、现状怎样,未来在本质上并未被注定。每一个选择、每一次努力,都在开拓新的“可能”。
一、工业 AI 的"最后一公里"困境
在智能制造车间里,一位设备工程师的日常可能是这样的:凌晨两点被告警电话惊醒,发现 3 号数控机床主轴温度异常升高。他打开监控大屏,看到一串红色阈值告警,却无法判断这是润滑系统故障、冷却回路堵塞,还是轴承磨损的前兆。更棘手的是,当他联系数据团队请求建立预测模型时,得到的回复是:“需要至少三个月的历史故障样本,特征工程大概两周,模型训练调参再两周,上线部署还要一周。”
等模型终于上线,那台机床可能已经完成了两次计划外停机维修。
这是工业 AI 落地中最真实的困境:业务需求是分钟级的,而模型交付是月级的。传统机器学习方案在时序数据分析领域面临四大结构性瓶颈:
- 数据准备周期长:收集、清洗、标注、特征工程往往占据项目 70% 以上的时间
- 模型泛化能力差:为 A 设备训练的模型,换到同型号 B 设备上往往"水土不服"
- 运维成本高昂:模型上线后需持续监控漂移、定期重训练、调整阈值
- 结果解释困难:黑盒模型输出"异常概率 0.87",却无法告诉工程师"为什么"和"该怎么办"
时序大模型的出现,正在从根本上重构这一范式。它不再将时序分析视为"数据科学家的手工作坊",而是将其转变为"即插即用的智能流水线"。
二、范式对比:从"手工作坊"到"智能流水线"
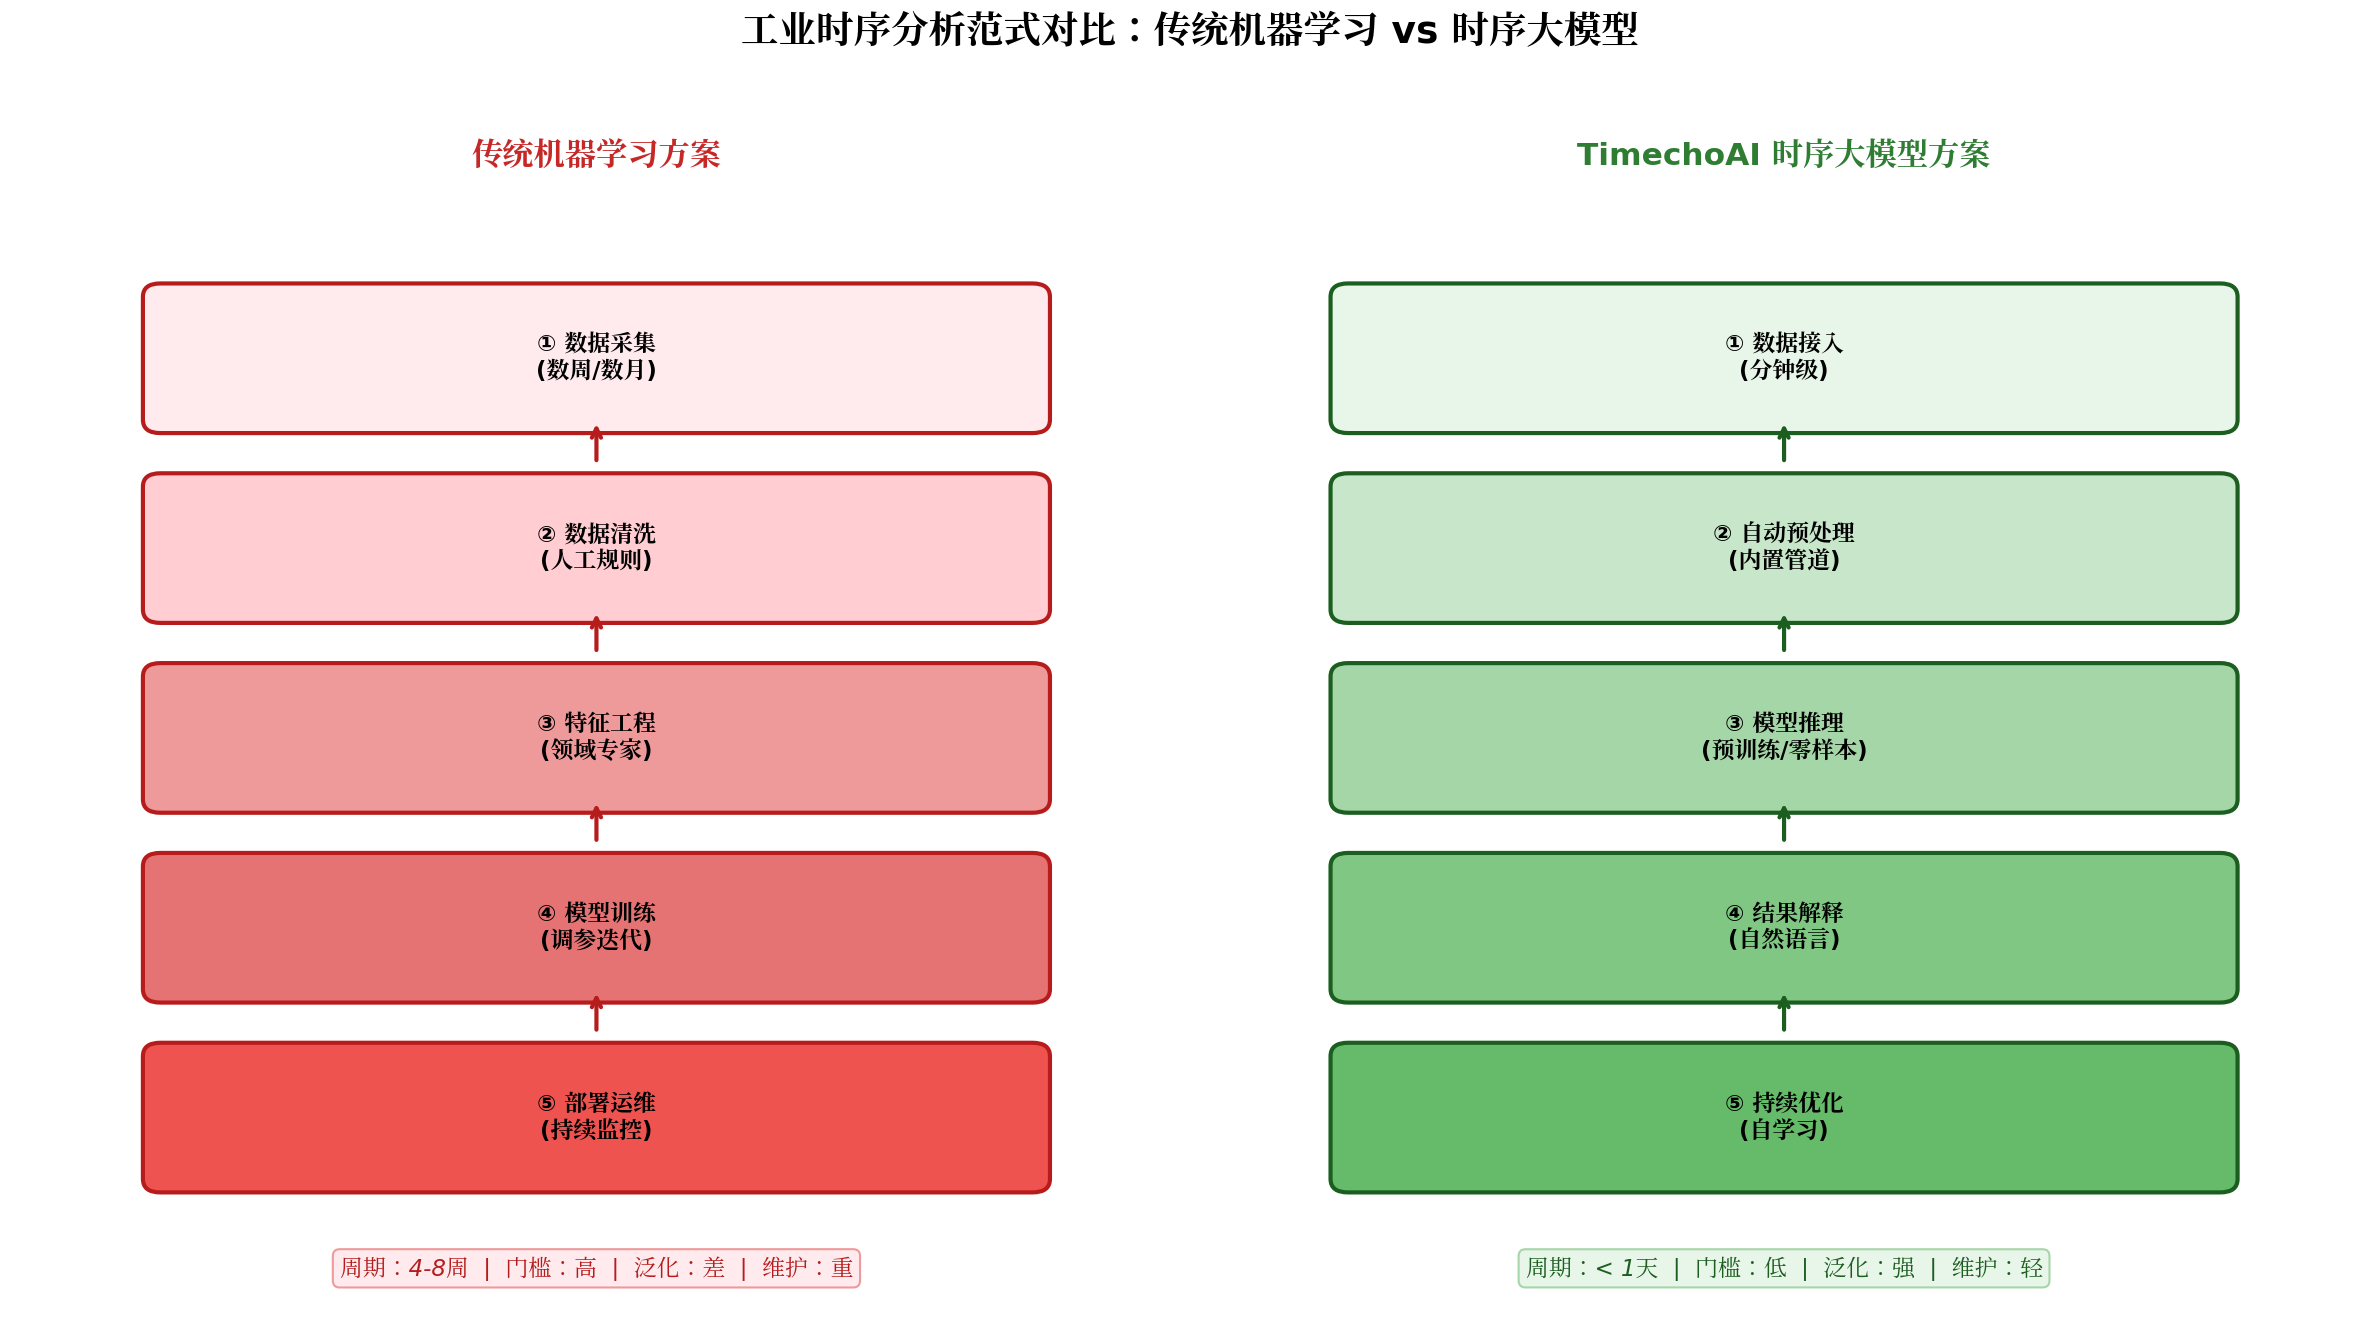
范式对比图:传统ML vs 时序大模型范式对比
传统机器学习方案遵循"数据 → 特征 → 模型 → 部署"的线性流程,每个环节都需要人工深度介入。以设备故障预测为例,领域专家需要定义"振动均方根"“温度变化率”"频域峰值"等数十个特征,数据工程师需要处理缺失值和异常点,算法工程师需要尝试随机森林、XGBoost、LSTM 等多种模型并调参,最后运维团队需要搭建监控体系防止模型漂移。
TimechoAI 时序大模型方案则完全不同。基于 Timer 系列模型在万亿级时序数据上的预训练,平台内置了通用的时序理解能力。用户只需将原始时序数据接入,系统即可自动完成预处理、特征提取、模式识别和结果解释。整个流程从"数周"压缩至"数小时",甚至"分钟级"。
这种范式转变的核心在于**“预训练 + 零样本/少样本”**架构。传统模型是"从头学起",需要大量标注数据才能理解"振动信号的正常模式是什么";而时序大模型是"举一反三",它已经在数百万条跨行业时序数据中学到了"正常"与"异常"的通用表征,面对新设备时只需少量上下文即可做出准确判断。
三、构建端到端时序智能流水线
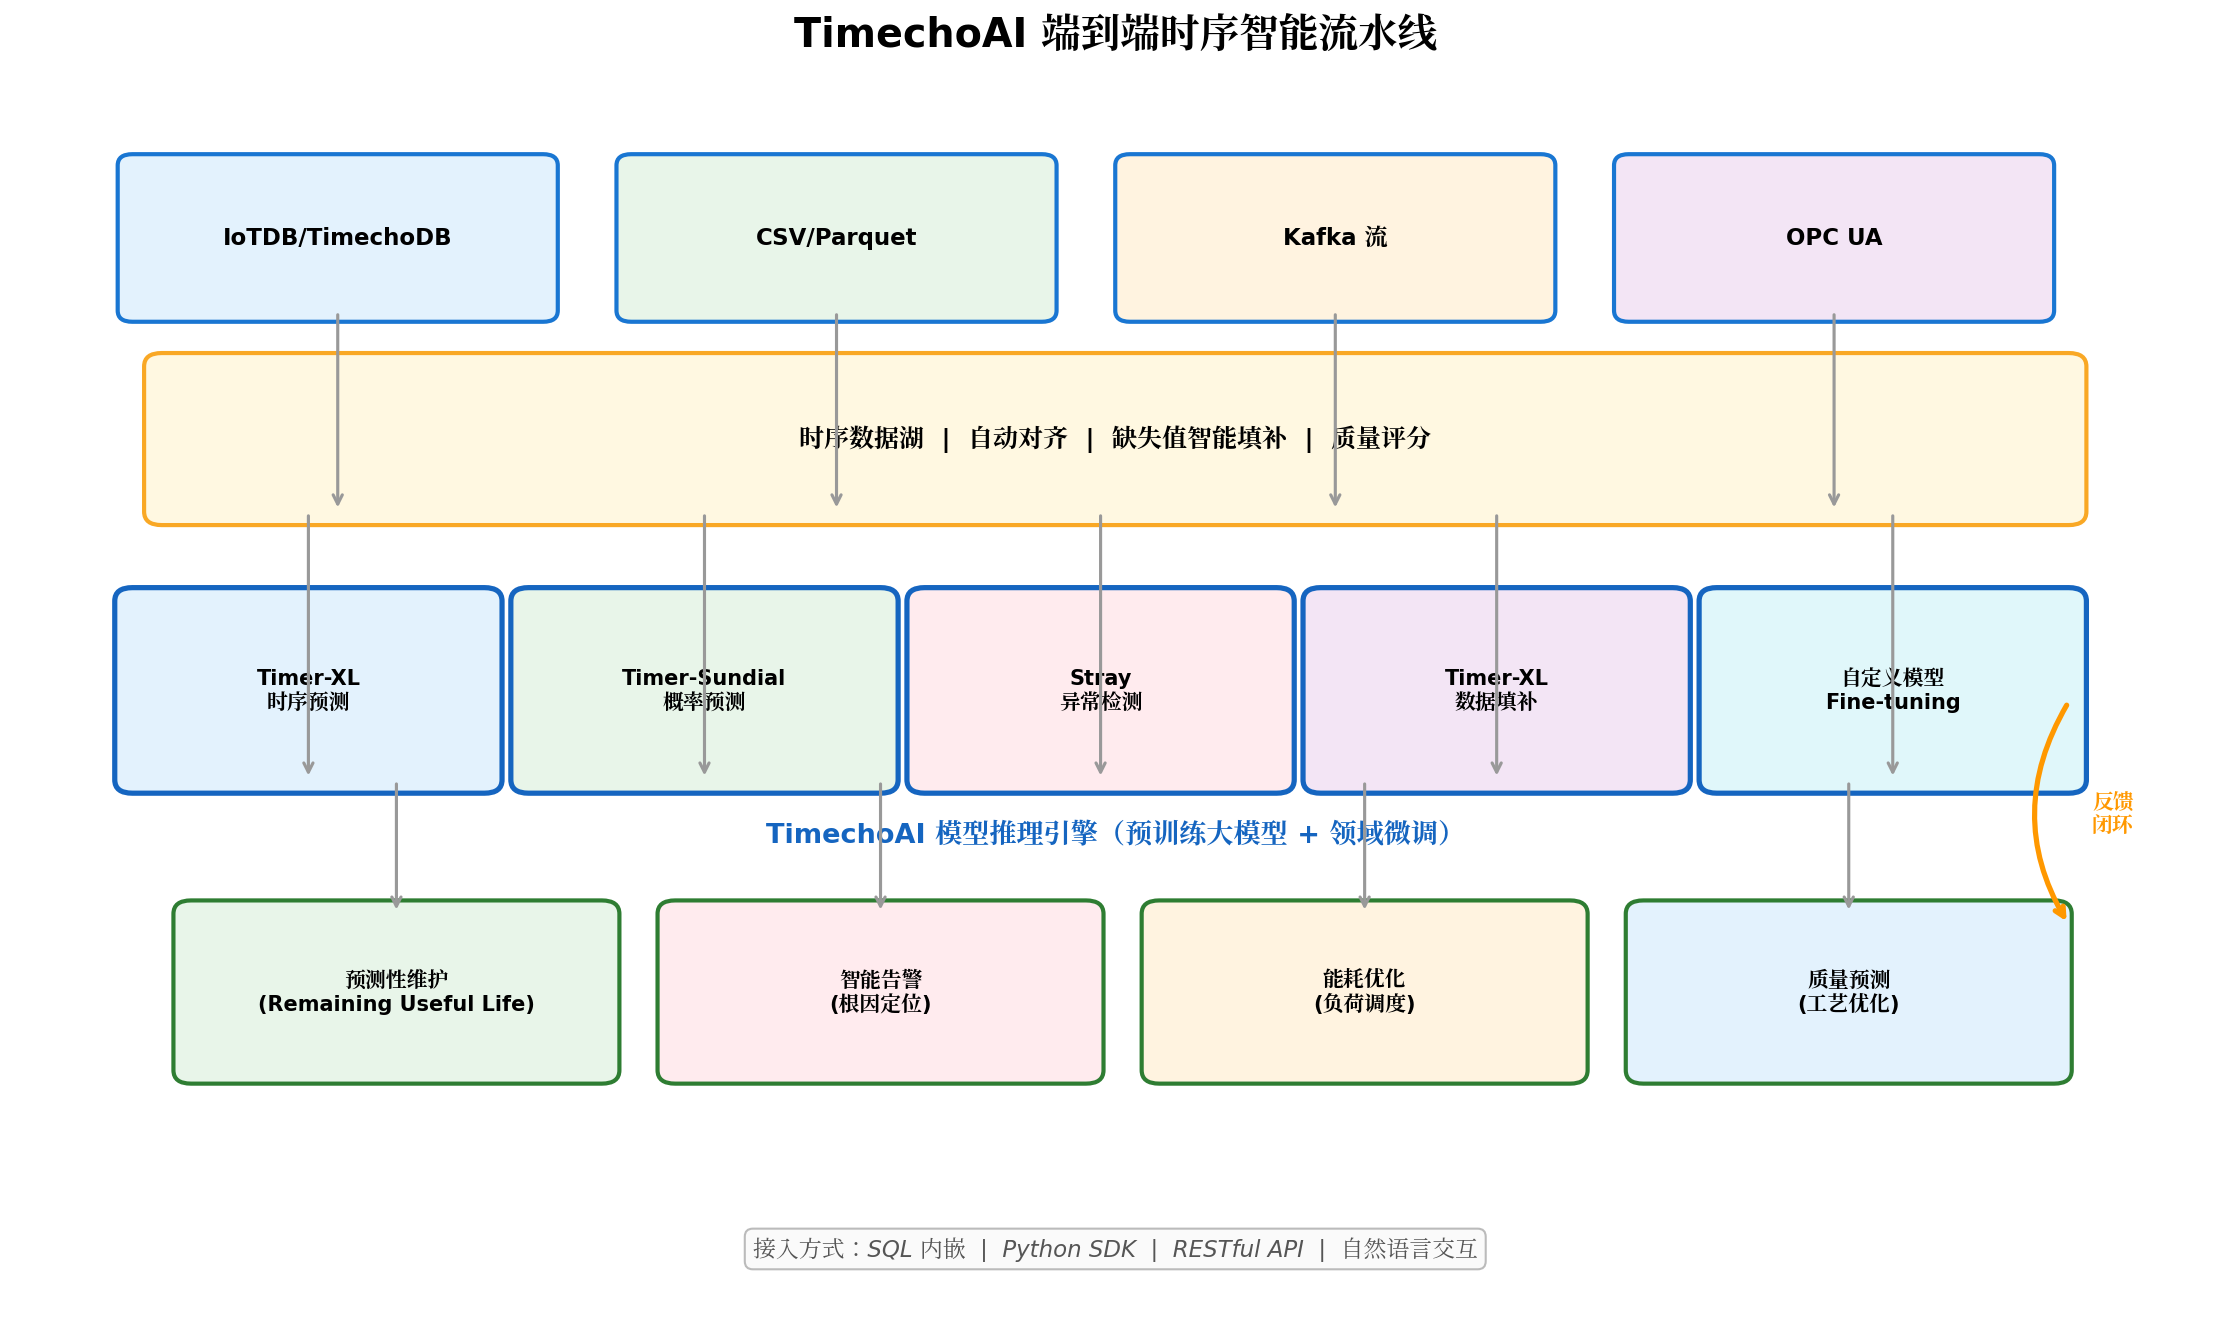
流水线架构图:端到端时序AI流水线
TimechoAI 平台将时序分析能力封装为一条完整的智能流水线,涵盖数据接入、自动预处理、模型推理、结果应用和反馈闭环五个环节。
3.1 数据接入:打破格式壁垒
平台支持四种主流数据接入方式,企业无需改造现有数据架构:
from timechoai import TimechoAIClient
client = TimechoAIClient(api_key="your_key", base_url="https://ai.timecho.com")
# 方式一:直接读取 IoTDB / TimechoDB(零拷贝)
result = client.analyze(
source="iotdb://root:root@localhost:6667",
query="SELECT vibration, temperature FROM root.factory.device_003 WHERE time > now() – 7d"
)
# 方式二:本地 CSV / Parquet 文件
result = client.analyze(
source="file://./sensor_data.csv",
time_column="timestamp",
value_columns=["vibration_x", "vibration_y", "temperature"]
)
# 方式三:Kafka 实时流
result = client.analyze(
source="kafka://broker:9092/topic-sensor-data",
stream_mode=True,
window_size="1h"
)
# 方式四:TsFile 原生格式(IoTDB 专属高效格式)
result = client.analyze(
source="tsfile://./2026-09-data.tsfile",
device_path="root.wind_farm.turbine_001"
)
TsFile 作为 IoTDB 的原生列式存储格式,具有 20:1 的高压缩比和自描述元数据特性。TimechoAI 可直接解析 TsFile 文件,无需解压或格式转换,数据从磁盘到模型推理的链路延迟降低 80% 以上。
3.2 自动预处理:让数据"自我清洁"
工业现场的数据质量往往参差不齐:传感器断网导致缺失、网关时钟漂移导致时间错位、电磁干扰导致尖峰噪声。传统方案中,这些清洗工作需要大量人工规则。
TimechoAI 内置了智能预处理管道:
# 自动预处理配置示例
preprocess = client.create_pipeline(
name="turbine_preprocessing",
steps=[
{"type": "missing_value_imputation", "method": "timer_xl_contextual"}, # 上下文感知填补
{"type": "outlier_detection", "method": "isolation_forest", "threshold": 0.05},
{"type": "resampling", "target_frequency": "1min", "method": "linear"}, # 降采样对齐
{"type": "quality_scoring", "min_score": 0.8} # 数据质量评分,低于 0.8 触发告警
]
)
其中,timer_xl_contextual 填补方法利用时序大模型的上下文理解能力,能够根据缺失段前后的趋势、周期和波动特征,生成最合理的补全值,远优于传统的线性插值或均值填充。
3.3 模型推理:一个模型解决多种任务
TimechoAI 的核心模型库基于 Timer 系列架构,覆盖时序分析的三大核心任务:
| 时序预测 | client.forecast() | 点预测 + 置信区间 | < 20ms |
| 异常检测 | client.anomaly_detect() | 异常分数 + 根因标签 | < 50ms |
| 数据填补 | client.impute() | 填补值 + 不确定性估计 | < 30ms |
更关键的是,这些任务共享同一个预训练底座(Timer-XL),无需为每个任务单独训练模型。企业只需维护一套数据接入逻辑,即可同时获得预测、检测、填补三大能力。
四、实战:自然语言驱动的时序根因分析
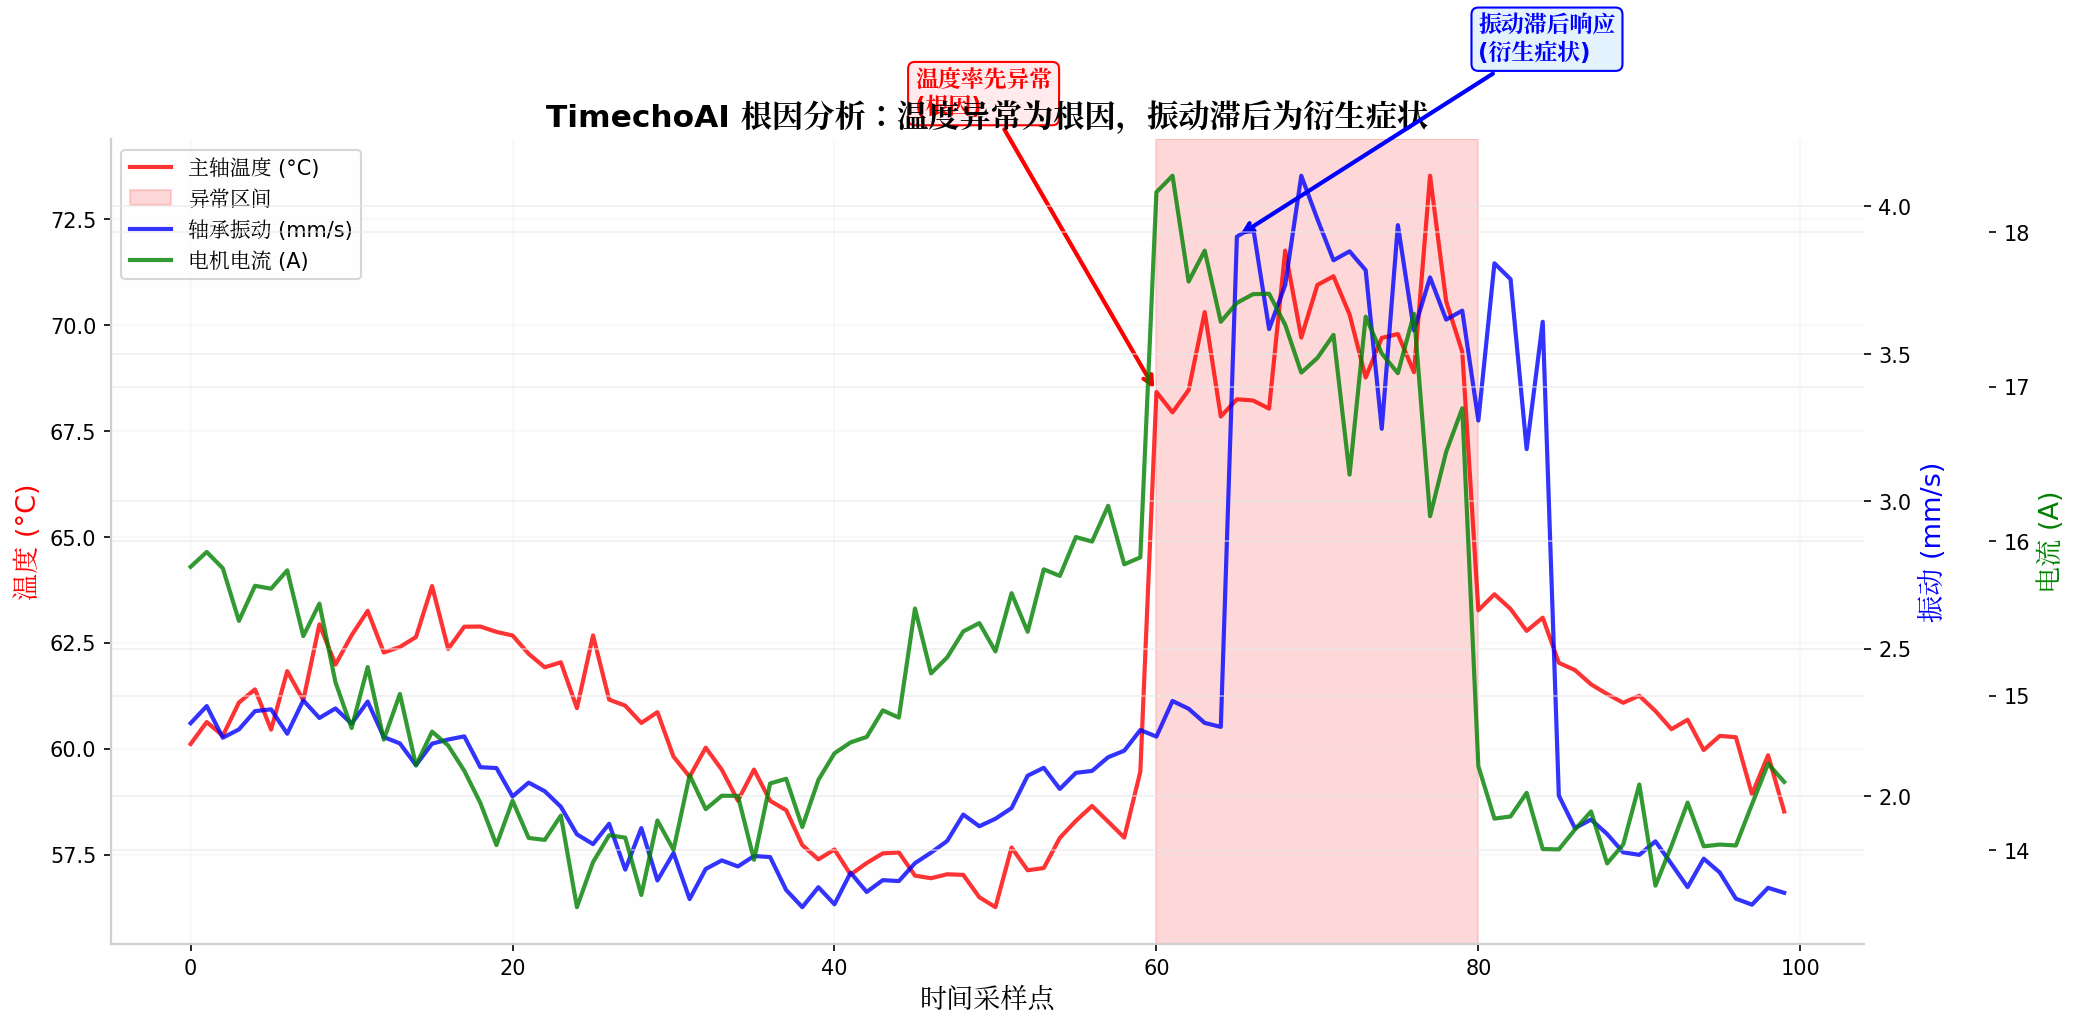
根因分析图:根因分析结果可视化
工业现场最耗费工程师精力的不是"发现异常",而是"定位根因"。当告警响起时,工程师需要在多个传感器、多个时间窗口、多个设备之间进行交叉比对,这个过程往往耗时数小时甚至数天。
TimechoAI 的自然语言交互能力,将这一过程压缩至秒级。 
自然语言查询图:自然语言时序查询交互
4.1 用"人话"问数据
# 自然语言时序查询示例
response = client.nl_query(
question="过去一周 3号风机振动异常的最可能原因是什么?",
context={
"database": "iotdb://localhost:6667",
"device": "root.wind_farm.turbine_003",
"sensors": ["vibration_x", "vibration_y", "vibration_z",
"generator_temp", "gearbox_temp", "wind_speed"]
}
)
print(response.answer)
# 输出示例:
# "根据过去 7 天的数据分析,3号风机振动异常的最可能根因是:
# ① 齿轮箱油温在 9月18日 14:00 开始持续升高(从 65°C 升至 82°C)
# ② 振动异常在油温升高后约 2 小时出现,呈现明显滞后相关性(滞后相关系数 0.91)
# ③ 建议优先检查齿轮箱润滑油冷却回路,其次排查轴承间隙"
自然语言查询的背后,是大语言模型(LLM)与时序大模型(Timer)的联合推理架构。LLM 负责理解用户意图、解析实体、生成结构化查询;Timer 负责在时序数据中提取模式、计算相关性、识别因果关系。两者协同,实现了"从问题到答案"的一站式交互。
4.2 多变量根因定位的 SQL 实现
对于习惯 SQL 的工程师,TimechoAI 同样提供了结构化的根因分析接口:
— 启用 AINode 根因分析功能
CALL ROOT_CAUSE_ANALYSIS(
'SELECT vibration, temperature, pressure, current
FROM root.factory.pump_001
WHERE time > now() – 7d',
target_sensor = 'vibration',
anomaly_window = '[2026-09-18T14:00:00, 2026-09-18T18:00:00]',
max_lag = '2h', — 最大滞后时间
top_k = 3 — 返回前 3 个最可能根因
);
— 返回结果:
— +——————+—————-+———-+——————————–+
— | root_cause_sensor| correlation | lag_time | explanation |
— +——————+—————-+———-+——————————–+
— | temperature | 0.91 | 2h | 温度率先异常,振动滞后响应 |
— | current | 0.78 | 0h | 电流同步异常,负载突变 |
— | pressure | 0.45 | 1h | 压力中度相关,可能为衍生症状 |
— +——————+—————-+———-+——————————–+
根因分析的核心算法是时序格兰杰因果检验(Granger Causality)的深度学习增强版。传统格兰杰检验假设数据线性平稳,在工业非平稳时序上效果有限。TimechoAI 通过 Timer 模型的注意力权重,提取变量间的非线性、非平稳依赖关系,显著提升了根因定位的准确率。
五、避坑指南:流水线落地的五个关键细节
避坑一:忽视数据质量评分
时序大模型虽强,但"垃圾进,垃圾出"的法则依然适用。如果输入数据缺失率超过 30%,或存在大量时间戳错位,模型可能输出误导性结果。务必启用 quality_scoring 步骤,对低于 0.7 分的数据段触发人工复核。
避坑二:混淆"相关性"与"因果性"
根因分析输出的是"统计关联性最强"的变量,而非绝对的物理因果。例如,“温度与振动高度相关"可能意味着温度是根因,也可能两者都是某个第三方因素(如负载增加)的结果。建议将 AI 输出作为"优先排查清单”,而非"最终诊断结论"。
避坑三:过度依赖单点预测
设备健康度评估应基于时间窗口内的趋势变化,而非单一时点的预测值。一台设备当前健康度 85 分看似正常,但如果三天前是 95 分,则退化趋势已十分明确。调用 API 时务必设置 return_trend=True,关注趋势而非绝对值。
避坑四:忽略模型的置信区间
在能源负荷预测等关键决策场景中,点预测的误导性极高。务必使用概率预测输出(Timer-Sundial),基于置信区间的上下界制定鲁棒调度策略,而非仅依赖中值预测。
避坑五:缺乏反馈闭环
时序大模型的预训练知识是"通用"的,而工业现场有"特殊"之处。建议将工程师的判定结果(如"AI 预警正确/误报")通过反馈接口回传平台,触发轻量级领域微调(Fine-tuning),持续提升模型在特定场景下的准确率。
# 反馈闭环示例
client.submit_feedback(
inference_id="inf_20260923_001",
feedback="true_positive", # 或 false_positive, false_negative
engineer_notes="实际为冷却风扇故障,AI 根因定位准确",
trigger_finetune=True # 触发自动微调
)
六、结语:让时序数据自己"说话"
工业智能化的终极目标,不是让工程师学会使用复杂的 AI 工具,而是让数据本身具备"自我解释"的能力。TimechoAI 时序大模型平台通过预训练架构消除了建模门槛,通过自然语言交互消除了技术壁垒,通过端到端流水线消除了工程复杂度。
当一位设备工程师可以用一句话——“过去一周 3号风机为什么振动异常?”——在数秒内获得包含根因定位、置信度评估和维护建议的完整答案时,工业 AI 才真正从"实验室里的技术Demo"变成了"车间里的生产力工具"。
这不仅是技术的进步,更是工业知识工作方式的范式转移。
相关资源:
- 时序大模型 TimechoAI 平台:https://ai.timecho.com/
- 企业版官网(Timecho):https://timecho.com
- Apache IoTDB 开源版下载:https://iotdb.apache.org/zh/Download/
- 官方文档:https://iotdb.apache.org/zh/UserGuide/latest/AI-capability/TimeSeries-Large-Model.html
转载自:https://blog.csdn.net/u014727709/article/details/166491639 欢迎 👍点赞✍评论⭐收藏,欢迎指正