目录
一、为什么时序预测一直很难
二、TimechoAI 到底是什么
三、它能做什么:从设备故障到门店客流
四、什么样的数据适合接入
五、动手接入:Python SDK 实操
六、异常处理:别让错误信息变成天书
七、还有个数据评估功能
八、几个实际建议
九、小结
🎬 攻城狮7号:个人主页
🔥 个人专栏:《AI前沿技术要闻》
⛺️ 君子慎独!
🌈 大家好,欢迎来访我的博客! ⛳️ 此篇文章主要介绍 时序大模型 TimechoAI 📚 本期文章收录在《AI前沿技术要闻》,大家有兴趣可以自行查看! ⛺️ 欢迎各位 ✔️ 点赞 👍 收藏 ⭐留言 📝!
一、为什么时序预测一直很难
做过运营、运维、生产或供应链的人,大概率都被"预测"折磨过。
下个月销量会涨还是跌?服务器流量什么时候到峰值?这台设备还能撑多久?大宗商品价格是现在备货还是再等等?这些问题的共同特点是——答案藏在历史数据里,靠人拍脑袋不准,靠传统统计模型又往往跟不上真实业务的变化节奏。
传统的时序预测方法,比如 ARIMA、Holt-Winters,对平稳序列还行,但面对真实业务里的节假日波动、突发异常、多变量耦合,基本是"看天吃饭"。而深度学习模型虽然效果好一些,但训练成本高、调参复杂,还得有专门的算法团队,中小企业根本玩不起。
TimechoAI 想解决的就是这个问题:把时序预测能力做成一个开箱即用的服务,你不用懂模型,不用买显卡,把数据传进去,结果拿出来。
二、TimechoAI 到底是什么
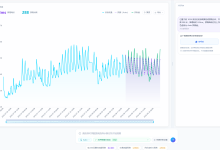
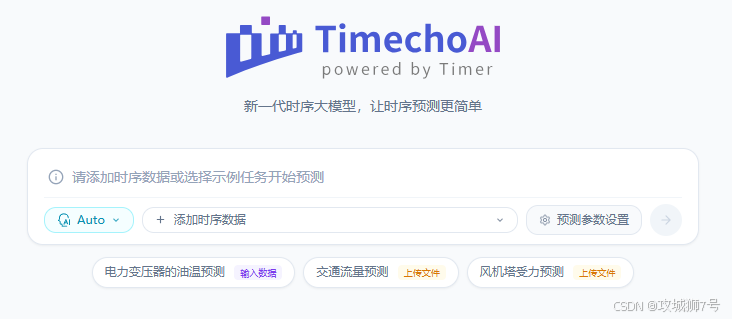
简单说,TimechoAI 是一个面向时间序列数据的预测服务平台。它底层整合了多种时序模型,从经典统计方法到大模型都有,用户不需要自己选型,平台会根据数据特征自动匹配。
目前支持的模型包括:
– Auto:自动模式,平台根据你的数据自动选择最合适的模型,适合不想折腾的用户。
– Timer-3.5 / Timer-3.0:Timecho 自研的时序大模型,擅长处理复杂模式和长序列预测。
– Chronos-2:基于 Transformer 架构的时序基础模型。
– AutoARIMA / Holt-Winters:经典统计模型,适合规律明显、数据量不大的场景。
这里的关键不是"模型多",而是"你不用选"。大多数业务人员根本不知道自己的数据该用 ARIMA 还是 Transformer,Auto 模式直接帮你搞定。如果对效果有更高要求,也可以手动指定模型做对比。
三、它能做什么:从设备故障到门店客流
TimechoAI 的适用场景比很多人想象的宽。只要你的业务问题可以抽象成"基于历史变化,预测未来趋势",就可以试试。
设备故障预测是最典型的场景之一。工厂里的关键设备一旦非计划停机,损失动辄几十万。传统做法是坏了再修或者定期保养,前者太被动,后者容易过度维护。有了设备运行数据的历史序列,TimechoAI 可以提前预判运行状态的异常趋势,把"事后抢修"变成"视情维修"。对设备制造商来说,还可以把预测能力内嵌到产品里,从卖硬件转向卖健康管理服务。
环境质量预警同样适用。排放企业可以在污染物接近合规上限前主动调整生产负荷,监管机构可以提前发布区域预警,农业场景里可以感知微气象变化自动触发灌溉或降温。
大宗商品价格预测对采购和贸易团队价值直接。低价窗口前置备货能压成本,价格高点提前预判能调整库存释放节奏。当然,价格受太多外部因素影响,预测不会百分百准,但有个量化参考总比拍脑袋强。
产能与供应预测解决的是"承诺交期"的问题。销售想接单,排产得有谱,仓储物流得提前安排。如果能基于历史数据预测有效产能,交货承诺会更可靠,物料和人力也能提前匹配,不至于临时抱佛脚。
工艺 KPI 预测偏制造业内部场景。质量团队可以预判工艺漂移,在出缺陷前做前馈调控;车间可以预测能耗峰值做精细化管控;研发还能通过时序回溯找良率下降的隐性因素。
运营与流量预测覆盖 IT 运维和门店运营。预测流量峰值提前扩缩容,预测客流合理排班,预判需求爆发时段分配促销预算——这些都是直接省钱或赚钱的事。
交通物流 ETA 预测和医疗健康预警也在探索范围内。前者用于路径规划和港口调度,后者用于门诊量预测、ICU 体征恶化预警和疫情趋势判断。
看起来场景很多,但底层逻辑就一个:你的数据是按时间顺序采集的,有历史规律,业务目标能量化成某个指标的未来值——那就可以试。
四、什么样的数据适合接入
不是所有数据都适合做时序预测。TimechoAI 对输入数据有几个基本要求,理解这些能帮你少走弯路:
1. 数据有明确时间戳,按时间顺序采集。
2. 存在历史规律,未来趋势受过去影响。纯随机数谁也预测不了。
3. 采集频率相对稳定,每秒、每分钟、每小时、每天都行,但不能一会儿一秒一个一会儿一天一个。
4. 数据量充足,建议历史数据不少于预测步长的两倍。比如你想预测未来 100 个点,至少给 200 个历史点。
5. 目标可量化,得是个数值,不能是"好/坏"这种标签(标签问题是分类,不是时序预测)。
数据长度方面,目标序列要求在 16 到 2880 个点之间,预测长度在 1 到 720 个点之间。这个范围覆盖了大部分业务场景,从短期的分钟级预测到长期的月度预测都能装下。
另外,TimechoAI 背后是 TimechoDB(基于 Apache IoTDB 的企业级时序数据库),所以如果你的数据本来就在 IoTDB 或 TimechoDB 里,从数据存储、特征治理到模型预测是打通的,不用来回倒数据。这一点对工业场景尤其重要——数据量动辄几亿点,倒来倒去既慢又容易出错。
五、动手接入:Python SDK 实操
说了这么多,实际用起来到底复不复杂?看代码最直观。
(1)环境准备
Python 版本要求 3.10 到 3.12,直接 pip 安装:
pip install timecho-ai
如果之前能用突然不行了,先升级试试:
pip install –upgrade timecho-ai
(2)单变量预测
最简单的场景,只有一列目标数据:
import pandas as pd
from timecho_ai import TimechoAIClient
# 读取示例数据
raw_df = pd.read_csv("https://ai.timecho.com/data/sample.csv")
# 输入 16 个点,预测 8 个点
INPUT_LENGTH = 16
OUTPUT_LENGTH = 8
# 创建客户端(替换为你的 API Key)
client = TimechoAIClient(api_key="your_timecho-ai_api_key")
# 构建目标变量
target = raw_df[["time", "target"]][:INPUT_LENGTH]
# 预测
result = client.forecast(
targets=target,
output_length=OUTPUT_LENGTH
)
print(result[0])
就这么多。没有模型定义,没有训练循环,数据进去,预测出来。`result` 返回的是预测结果,默认会带时间索引和预测值。
(3)带协变量的预测
真实业务里,预测目标往往受其他因素影响。比如预测销量,可能要结合温度、节假日、促销力度;预测设备温度,可能要结合负载、转速、环境湿度。这些"额外信息"在时序里叫协变量。
TimechoAI 支持两类协变量:
– history_covs:历史协变量,和目标数据长度一致。比如你有过去 16 个点的温度和湿度,这些就是历史协变量。
– future_covs:未来已知的协变量,长度等于预测长度。比如你已经知道未来 8 天的天气预报(温度是确定的),就可以传进去。
示例:
import pandas as pd
from timecho_ai import TimechoAIClient
client = TimechoAIClient(api_key="your_timecho-ai_api_key")
INPUT_LENGTH = 16
OUTPUT_LENGTH = 8
raw_df = pd.read_csv("https://ai.timecho.com/data/sample_cov.csv")
# 目标变量
target = raw_df[["time", "target"]][:INPUT_LENGTH]
# 历史协变量:温度和湿度
history_covs = raw_df[["time", "temperature", "humidity"]][:INPUT_LENGTH]
# 带协变量预测
result = client.forecast(
targets=target,
history_covs=history_covs,
output_length=OUTPUT_LENGTH,
time_col="time",
auto_adapt=True
)
print(result[0])
`auto_adapt=True` 是个很实用的参数,默认开启。它会自动处理数据里的一些常见问题,比如缺失值、频率不一致、量纲差异。对不熟悉数据预处理的人来说,开着就行。
(4)常用参数速览
– `model_id`:模型选择,默认 Auto,新手不用改。
– `output_length`:预测步长,默认 96(Timer-3.5 默认 272)。
– `output_start_time`:预测起始时间,必须大于历史数据最大时间。不传则自动推断。
– `output_interval`:预测点之间的时间间隔。
– `time_col`:时间列名,指定后所有输入数据需包含时间列。
– `auto_adapt`:自动数据适配,默认 True。
六、异常处理:别让错误信息变成天书
线上服务最怕出错了不知道怎么回事。TimechoAI 的 SDK 把常见错误都做了分类,你可以按需捕获:
– `BadRequestError`(400):请求格式有问题,检查参数。
– `AuthenticationError`(401):API Key 不对或者过期了。
– `PermissionDeniedError`(403):Key 是对的,但没权限。
– `NotFoundError`(404):模型或文件不存在。
– `RateLimitError`(429):调用太频繁被限流了,加个重试间隔。
– `InternalServerError`(500):服务端问题,可以稍后重试。
– `ServiceUnavailableError`(503):服务暂时不可用,通常重试即可。
– `ConnectionError` / `TimeoutError`:网络层问题,检查自己的网络。
– `ValidationError`:请求发出前客户端校验就没过,通常是参数填错了。
实际业务里,建议对限流和 5xx 做指数退避重试,对 4xx 直接报错并记录日志。这些异常类都继承自 `APIError`,想偷懒也可以直接捕获基类。
七、还有个数据评估功能
除了预测,TimechoAI 还提供数据质量评估能力(目前预告中,即将上线)。这个功能容易被忽略,但其实很重要——**预测效果的上限很大程度上取决于数据质量**。垃圾数据喂给再好的模型也出不了好结果。
评估从三个维度打分:
– 完整性(integrity):检查缺失点、冗余点、时效性异常。设备停机造成的长间隔可以通过 `downtime` 参数排除。
– 可预测性(forecastability):用频域谱熵衡量序列有没有规律。谱熵越低越适合预测,接近白噪声的就别费劲了。
– 皮尔逊相关性(pearson):算多条序列之间的相关系数,帮你判断哪些变量和目标有关系。
调用也很简单:
result = client.evaluate(df)
print(result.overall_score) # 综合评分
print(result.scores) # 各序列详细评分
建议在正式做预测之前先跑一下评估,心里有底。如果可预测性分数很低,可能得先回头检查数据采集或者换个预测目标。
八、几个实际建议
最后聊聊用这类服务时容易踩的坑。
先从小问题试起。 别一上来就想预测整个业务大盘,先挑一个具体指标、一个具体场景跑通。比如先预测某台设备的温度趋势,验证效果后再扩展。
别迷信模型,数据和特征更重要。 大模型不是万能的。如果数据本身噪声很大、关键信息缺失,换什么模型都白搭。协变量的质量往往比模型选择更影响最终效果。
预测结果要结合业务判断。 模型给的是基于历史数据的统计趋势,不考虑黑天鹅事件。促销、政策变化、供应链突发中断这些,模型不会提前知道。把预测作为决策参考,而不是唯一依据。
关注预测误差,而不是只看拟合效果。历史拟合得好不代表未来预测准。建议用最近一段时间的数据做回测,看看模型在"没见过的数据"上表现如何。
用好 auto_adapt,但别完全依赖。自动适配能处理大部分脏活,但如果你的数据有特殊业务逻辑(比如已知的停机时段、计划性维护),最好自己先清洗好。
九、小结
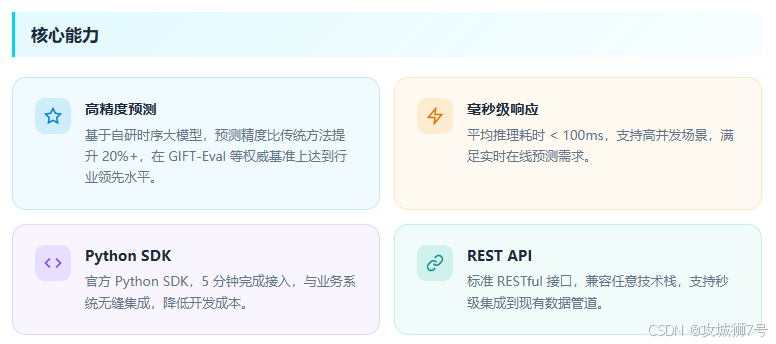
时序预测从来不是一个新问题,但真正用起来的门槛一直不低。TimechoAI 的价值在于把模型选型、训练、部署这些重活封装掉,让业务人员用几行 Python 就能拿到预测结果。
从设备运维到门店排班,从供应链到环境监测,时序数据存在于几乎每个行业。你不需要成为算法专家,只要数据在、问题明确,就可以先跑起来试试效果。预测这件事,开始做比做得完美更重要。
想了解更多或申请企业版,可以访问:
– 企业版官网:[https://timecho.com](https://timecho.com)
– TimechoAI 平台:[https://ai.timecho.com/](https://ai.timecho.com/)
看到这里了还不给博主点一个: ⛳️ 点赞☀️收藏 ⭐️ 关注! 💛 💙 💜 ❤️ 💚💓 💗 💕 💞 💘 💖 再次感谢大家的支持! 你们的点赞就是博主更新最大的动力!