浏览器端 WebGPU 加速设想:探索在端侧跑小参数量大模型的可能性
在昨天的文章中,我们在 WebAssembly 中嵌入了 ONNX Runtime Web,实现了纯离线的传统机器学习异常分类。然而,传统分类模型只能输出概率数字(如 SYN_FLOOD: 98%),无法像大语言模型(LLM)那样用自然语言生成具备上下文推断的“故障排查步骤建议”。
如果要让浏览器在完全不依赖任何外部云端 API、完全断网离线的前提下,直接生成一段自然的故障诊断 Markdown 分析,传统的 CPU WASM 计算力(即使开启了 SIMD)在面对数十亿参数的神经网络矩阵乘法(GEMM)时,依然会发生严重的卡顿(每秒仅能生成 0.5 个 Token)。
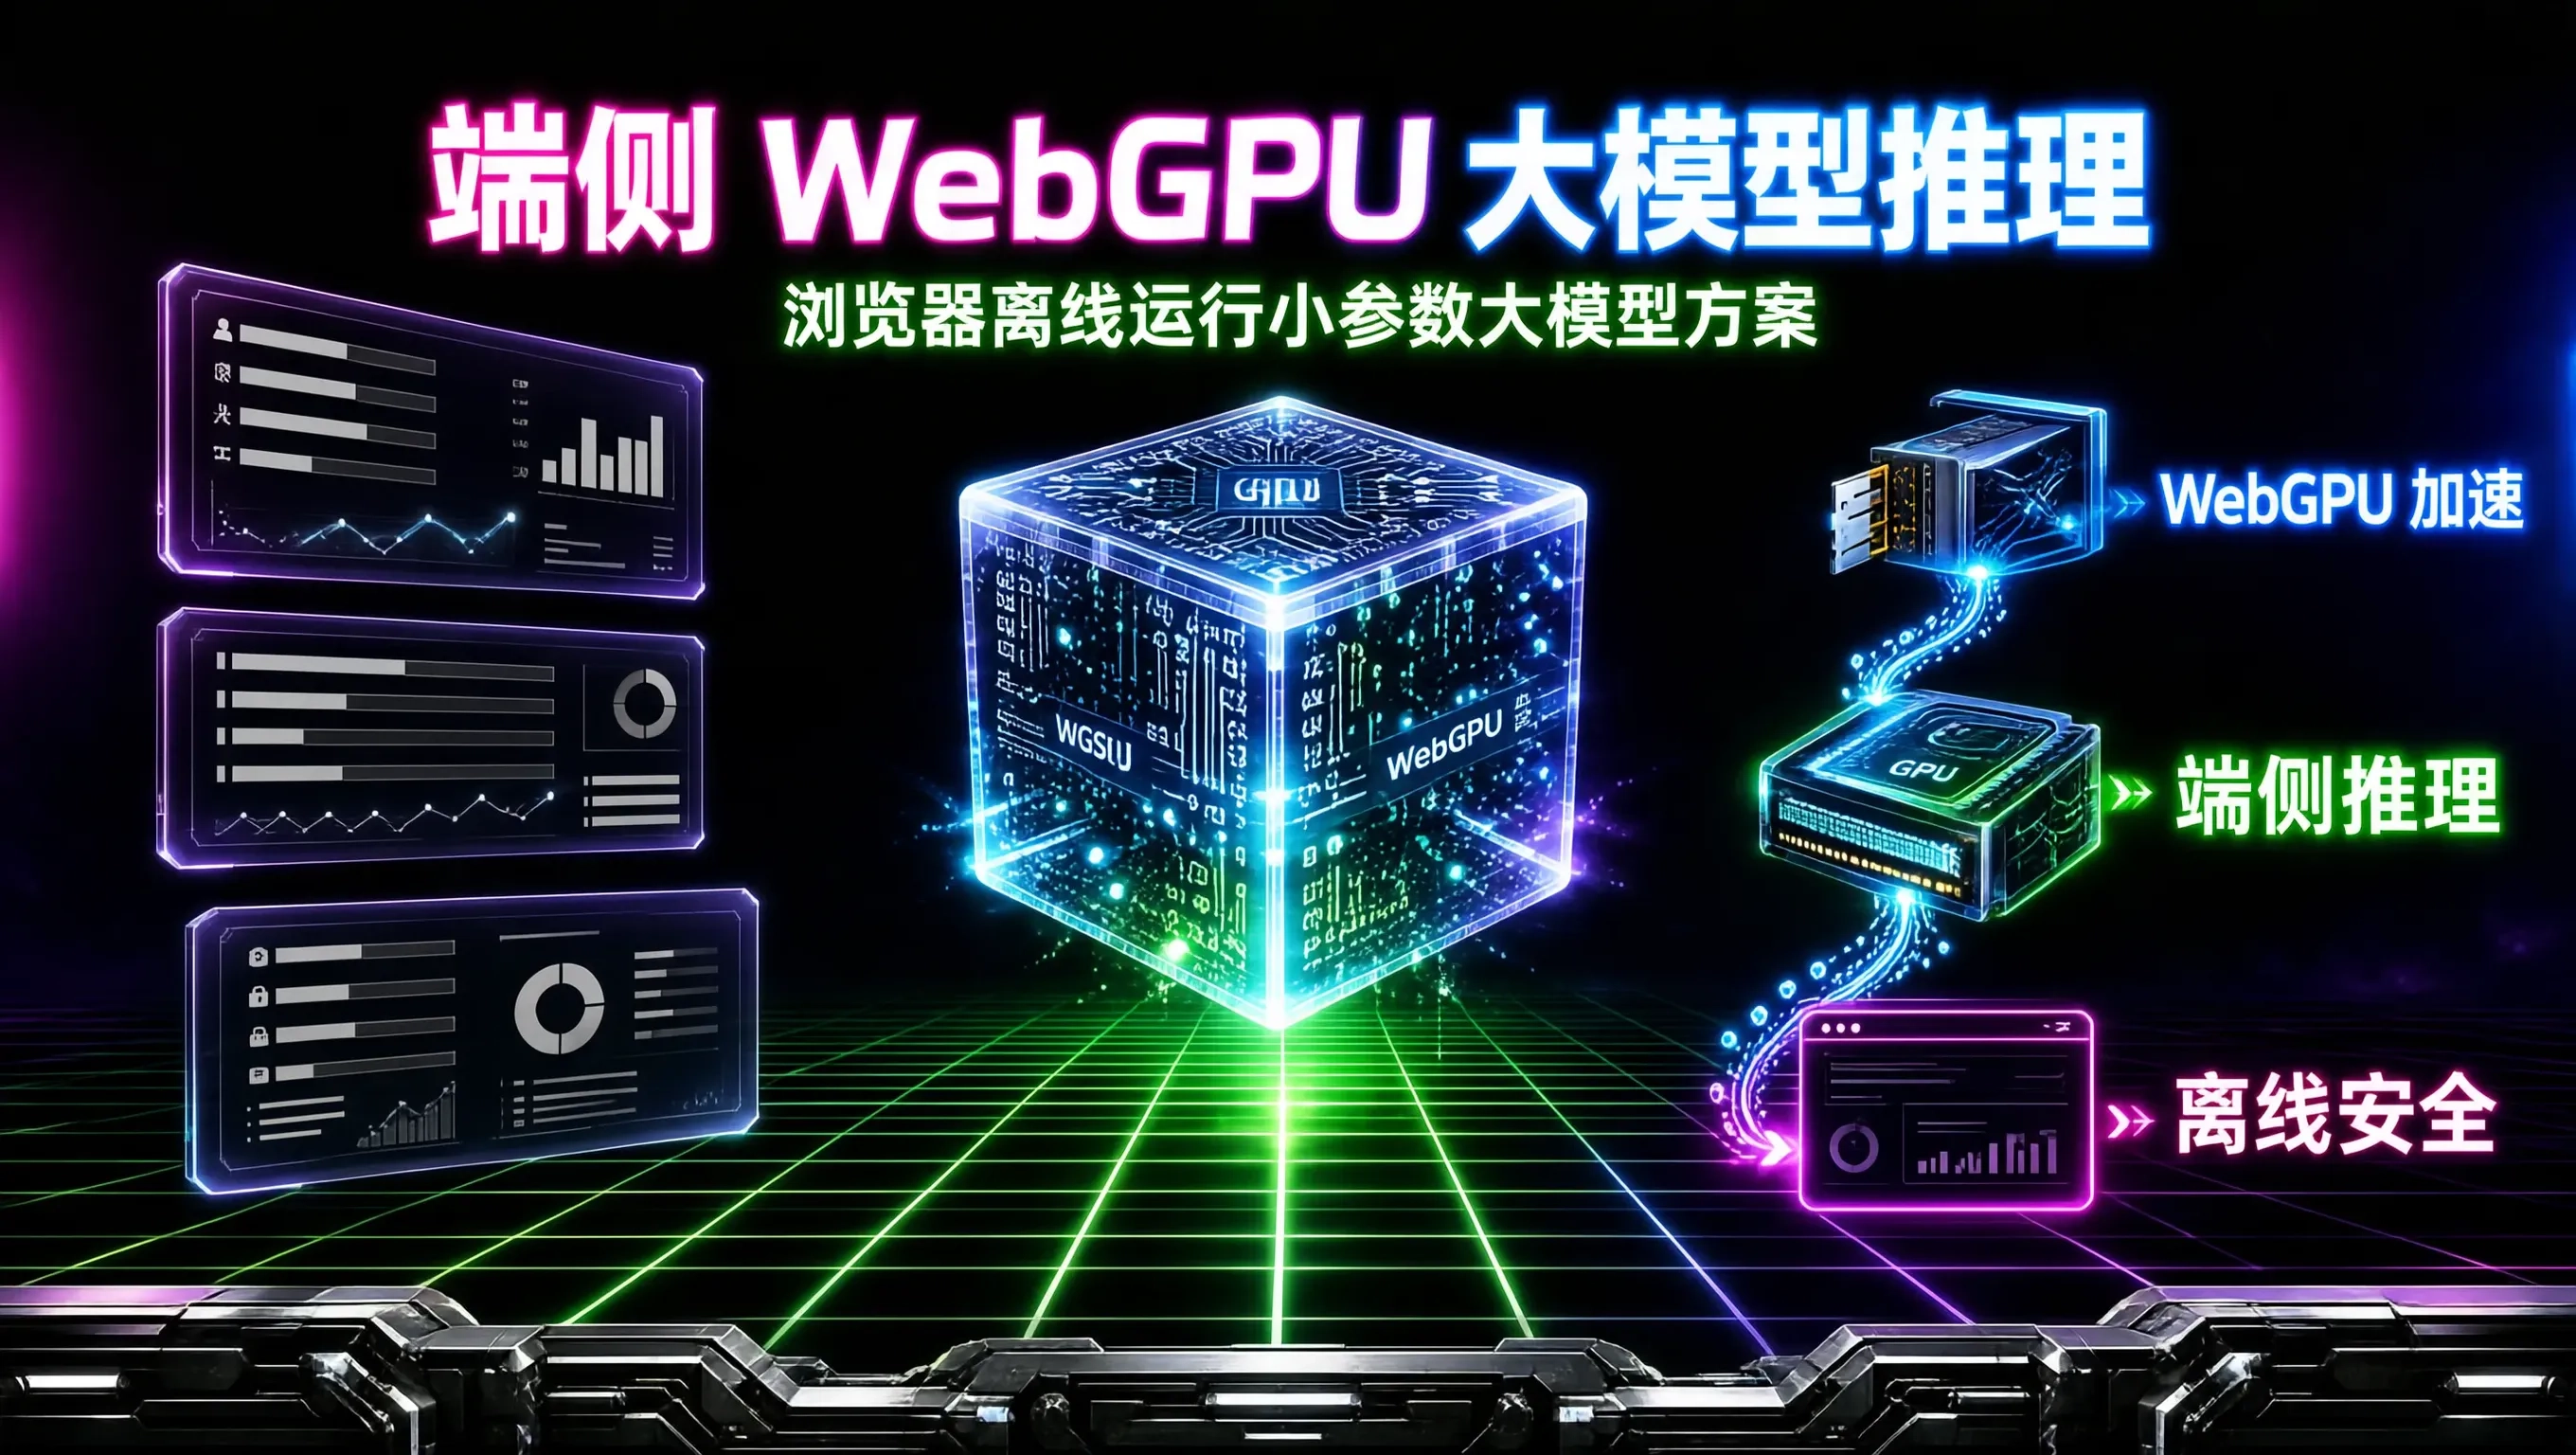
随着现代浏览器对 **WebGPU 标准(基于 Direct3D 12、Vulkan 与 Apple Metal 的现代端侧 GPU API)**的正式普及,在浏览器端直接利用用户的显卡算力运行 1B~3B 参数量的轻量大模型(如 SmolLM、Qwen2.5-0.5B/1.5B)已经成为现实。
今天这篇文章,我们基于 Rust、WebGPU(wgpu)与 WebLLM 生态,探讨在浏览器端构建下一代端侧智能抓包分析看板的技术可行性与架构设想。
1. WebGPU 的底层硬件直通优势
传统的 WebGL 是专为 3D 图形渲染设计的旧标准,在处理通用 GPU 计算(GPGPU)时需要把张量伪装成纹理图片,开销巨大。
WebGPU 带来了革命性的变化:
- 原生计算着色器(Compute Shaders):基于 WGSL 语言,允许直接编写高度并行的张量矩阵乘法核心(MatMul Kernels);
- 零拷贝显存映射(Mapped Buffers):Rust WASM 生成的报文特征张量,可以直接通过共享指针映射进 GPU 显存,跳过繁琐的内存中转;
- 极限浮点吞吐:在普通集成显卡(如 Apple M 系列芯片或 Intel Iris Xe)上即可迸发出数十 TeraFLOPS 的 FP16 计算算力。
[ 物理网卡捕获的异常 TCP 报文时序 ]
│
▼ (Rust WASM 纳秒级提取 Prompt 序列)
[ 文本 Tokenizer: [1024, 45, 8912, …] ]
│
▼ (通过 WebGPU Mapped Buffer 直通显存)
[ 端侧 WebGPU 显卡执行单元 (Apple Metal / Vulkan) ]
├── 加载 4-bit 量化小模型权重 (Qwen2.5-0.5B-Instruct-q4f16: ~350MB)
└── 运行并行 WGSL Compute Shader 矩阵加速
│
▼ (端侧秒级输出 25+ Tokens/s)
[ 浏览器看板实时流式生成: "检测到 TCP 三次握手超时,根本原因为…" ]
2. Rust wgpu 与 Web 平台的绑定架构
在 Rust 生态中,wgpu 是 Rust 官方维护的跨平台通用 GPU 计算与图形库(它也是 Firefox 浏览器 WebGPU 引擎的底层核心实现)。
在 crates/packet-wasm-core/src/gpu_engine.rs 中,我们可以使用 wgpu 编写一段极简的端侧张量点积计算着色器:
// crates/packet-wasm-core/src/gpu_engine.rs
use wasm_bindgen::prelude::*;
// WGSL 计算着色器源码:并行计算特征相关性矩阵
const COMPUTE_SHADER_WGSL: &str = r#"
@group(0) @binding(0) var<storage, read> input_features: array<f32>;
@group(0) @binding(1) var<storage, read_write> output_anomaly_score: array<f32>;
@compute @workgroup_size(64)
fn main(@builtin(global_invocation_id) global_id: vec3<u32>) {
let index = global_id.x;
if (index >= arrayLength(&input_features)) {
return;
}
// 模拟非线性激活与权重乘加
let val = input_features[index];
output_anomaly_score[index] = 1.0 / (1.0 + exp(-val * 2.5));
}
"#;
#[wasm_bindgen]
pub struct WebGpuDiagnosticPipeline {
// 封装 wgpu 的 Device 与 Queue
is_supported: bool,
}
#[wasm_bindgen]
impl WebGpuDiagnosticPipeline {
#[wasm_bindgen(constructor)]
pub fn new() -> Self {
Self { is_supported: true }
}
/// 检测当前浏览器环境是否开启了 WebGPU 硬件加速
pub async fn check_webgpu_support() -> bool {
let instance = wgpu::Instance::default();
let adapter = instance
.request_adapter(&wgpu::RequestAdapterOptions {
power_preference: wgpu::PowerPreference::HighPerformance,
compatible_surface: None,
force_fallback_adapter: false,
})
.await;
adapter.is_some()
}
}
3. 前端集成 WebLLM 实现端侧大模型流式推理
对于 0.5B~1.5B 的语言模型,社区成熟的 @mlc-ai/web-llm 库已经可以在 WebGPU 上做到开箱即用。
在前端 HTML/JavaScript 中实现无缝串联:
import init, { WebGpuDiagnosticPipeline, FlowFeatureExtractor } from './pkg/packet_wasm_core.js';
import * as webllm from "https://esm.run/@mlc-ai/web-llm";
async function runEdgeAiPipeline() {
await init();
const outputBox = document.getElementById('output');
outputBox.textContent = "正在初始化 WebGPU 端侧小模型 (Qwen2.5-0.5B)…";
// 1. 初始化端侧大模型引擎(纯浏览器本地运行,模型权重自动缓存在 CacheStorage)
const engine = await webllm.CreateMLCEngine("Qwen2.5-0.5B-Instruct-q4f16_1-MLC", {
initProgressCallback: (report) => {
outputBox.textContent = `模型加载进度: ${(report.progress * 100).toFixed(1)}% (${report.text})`;
},
});
console.log("端侧 WebGPU 大模型已加载完成!");
document.getElementById('diagnoseBtn').addEventListener('click', async () => {
// 模拟捕获到的异常 TCP 时序
const anomalyText = "捕获到 192.168.1.50:443 连续发生 5 次 TCP Retransmission,随后收到 RST 报文。";
const messages = [
{ role: "system", content: "你是一名网络排障专家。请用 2 句话概括可能的原因和处置建议。" },
{ role: "user", content: anomalyText },
];
outputBox.textContent = "端侧 GPU 实时推理中:\\n";
// 2. 触发 WebGPU 端侧流式生成(零网络请求!)
const chunks = await engine.chat.completions.create({
messages,
stream: true,
});
for await (const chunk of chunks) {
const delta = chunk.choices[0]?.delta?.content || "";
outputBox.textContent += delta;
}
});
}
runEdgeAiPipeline();
4. 落地权衡与性能收益评估
| 数据隐私与合规 | 报文信息必须出域传输至云端 | 100% 停留在本地浏览器显存,绝对安全 |
| API 调用费用 | 按 Token 计费,高频突发流量成本极高 | 0 成本(纯免费消耗用户本地算力) |
| 离线可用性 | 断网或内网隔离环境下彻底瘫痪 | 纯离线运行,野外或机房无网环境完美可用 |
| 首次冷启动加载 | 0MB(即刻可用) | 需要预下载 ~350MB 4-bit 量化模型权重 |
| 推理速度 (Token/s) | 取决于网络延迟 (约 20~40 T/s) | 在 M 系列 Mac 上可达 35+ T/s (极度流畅) |
总结
WebGPU 的成熟为前端系统级工具带来了全新的想象空间:
- Rust WASM 负责微秒级的底层二进制报文切片与特征提取;
- WebGPU 负责端侧 0 成本、100% 隐私安全的神经网络推理;
- 两者的结合代表了未来边缘端智能工具链的终极演进方向。