作者:来自 Elastic David Pilato
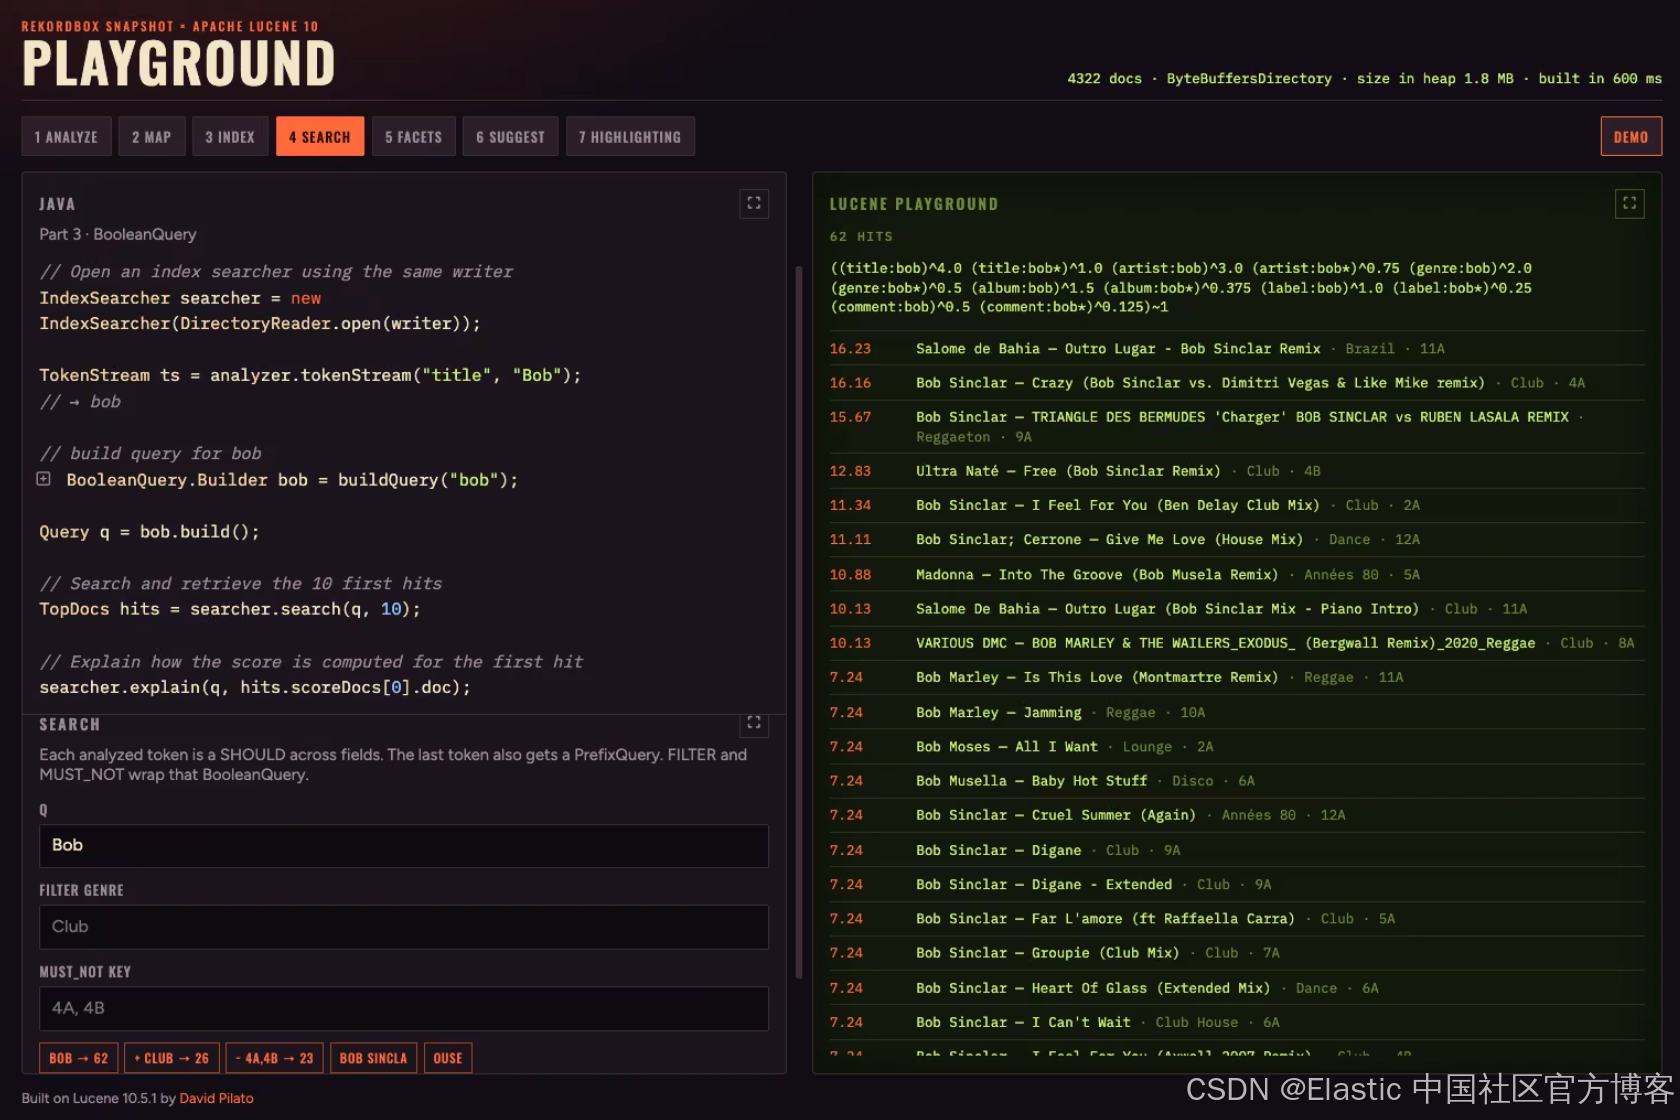
我们已经将 Bean 映射为文档并建立了索引。现在来看看当你在输入框中输入内容、添加过滤条件、排除两个键时会发生什么。
先不设置任何条件,并输入 MatchAll 查询:
// Open an index searcher using the same writer
IndexSearcher searcher = new IndexSearcher(DirectoryReader.open(writer));
// Search and retrieve the 10 first hits
TopDocs hits = searcher.search(MatchAllDocsQuery.INSTANCE, 10);
// Join stored ids back to beans:
for (var hit : hits.scoreDocs) {
String id = searcher.storedFields().document(hit.doc).get("id");
Track track = trackDatabase.get(id);
if (track != null) {
// Do something with the track, e.g., print it or add it to a list
}
}
输入“Bob”
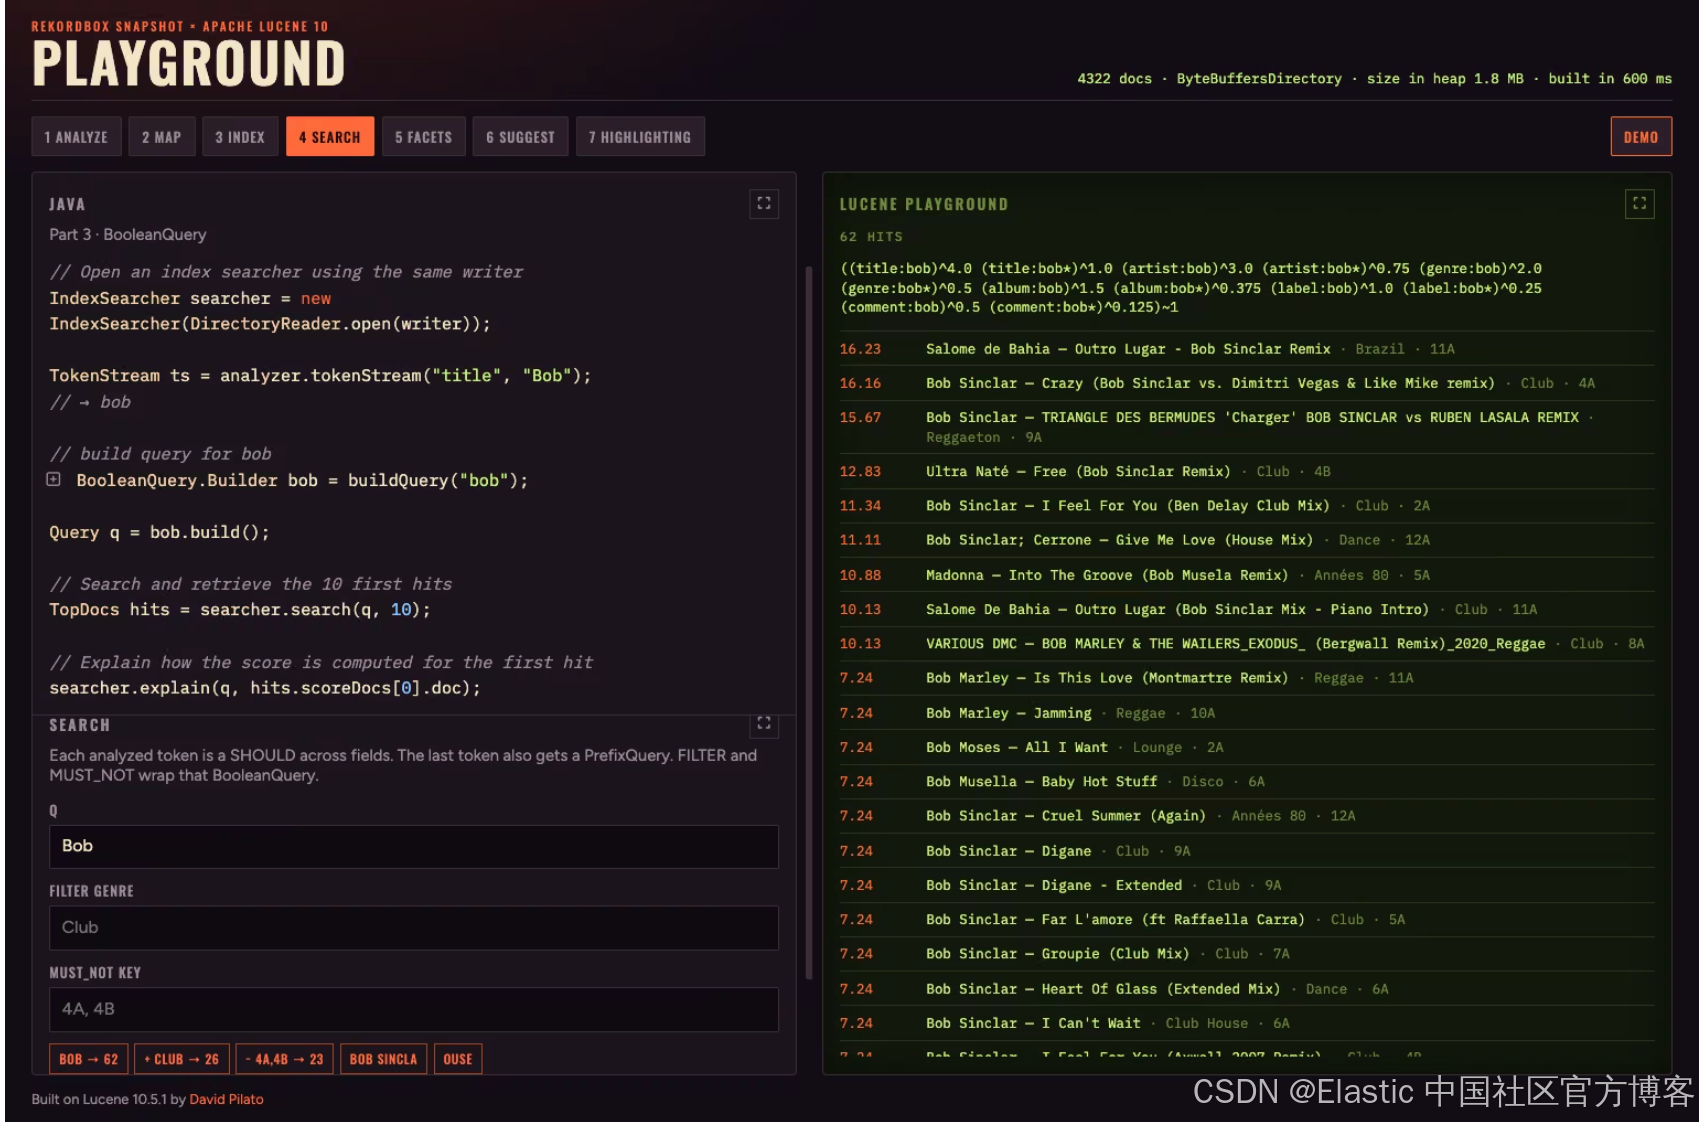
q=Bob → 62 个匹配结果。Title boost 优先于 artist;最后一个 token 还会获得一个 PrefixQuery。
分析查询字符串,并根据这些 token 构建查询:
TokenStream ts = analyzer.tokenStream("title", "Bob");
// → bob
// build query for bob
Query bob = new BooleanQuery.Builder()
.add(new BoostQuery(new TermQuery(new Term("title", "bob")), 4.0f), BooleanClause.Occur.SHOULD)
.add(new BoostQuery(new PrefixQuery(new Term("title", "bob")), 1.0f), BooleanClause.Occur.SHOULD)
.add(new BoostQuery(new TermQuery(new Term("artist", "bob")), 3.0f), BooleanClause.Occur.SHOULD)
.add(new BoostQuery(new PrefixQuery(new Term("artist", "bob")), 0.75f), BooleanClause.Occur.SHOULD)
// … genre^2 / album^1.5 / label^1 / comment^0.5 (+ prefixes) …
.setMinimumNumberShouldMatch(1)
.build();
// Search and retrieve the 10 first hits
TopDocs hits = searcher.search(bob, 10);
buildQuery 是 playground 展开的 fold:每个经过分析的字段都是一个带 boost 的 SHOULD TermQuery,此外还会针对最后输入的 token 添加一个 boost 为原 boost 四分之一的 PrefixQuery:
Lucene 将其打印为:
((title:bob)^4.0 (title:bob*)^1.0 (artist:bob)^3.0 (artist:bob*)^0.75
(genre:bob)^2.0 (genre:bob*)^0.5 (album:bob)^1.5 (album:bob*)^0.375
(label:bob)^1.0 (label:bob*)^0.25 (comment:bob)^0.5 (comment:bob*)^0.125)~1
多个 token 通过 AND 进行连接(每个 token 的 builder 都是 MUST)。只有最后一个 token 是前缀;之前的单词保持精确匹配。bob sincla 要求同时匹配 bob 和 sincla… 前缀。ouse 找不到 House —— 它不是子串匹配。
你还记得我们在上一篇文章中生成的 posting list 吗?
artist:bob → 1, 2, 3
artist:claude → 4, 5
artist:francois → 4, 5, 6
artist:marley → 2
artist:sinclar → 1, 3
artist:valery → 6
你看到与我们的搜索 (artist:bob)^3.0 的匹配了吗?
添加过滤条件(包含 Club)
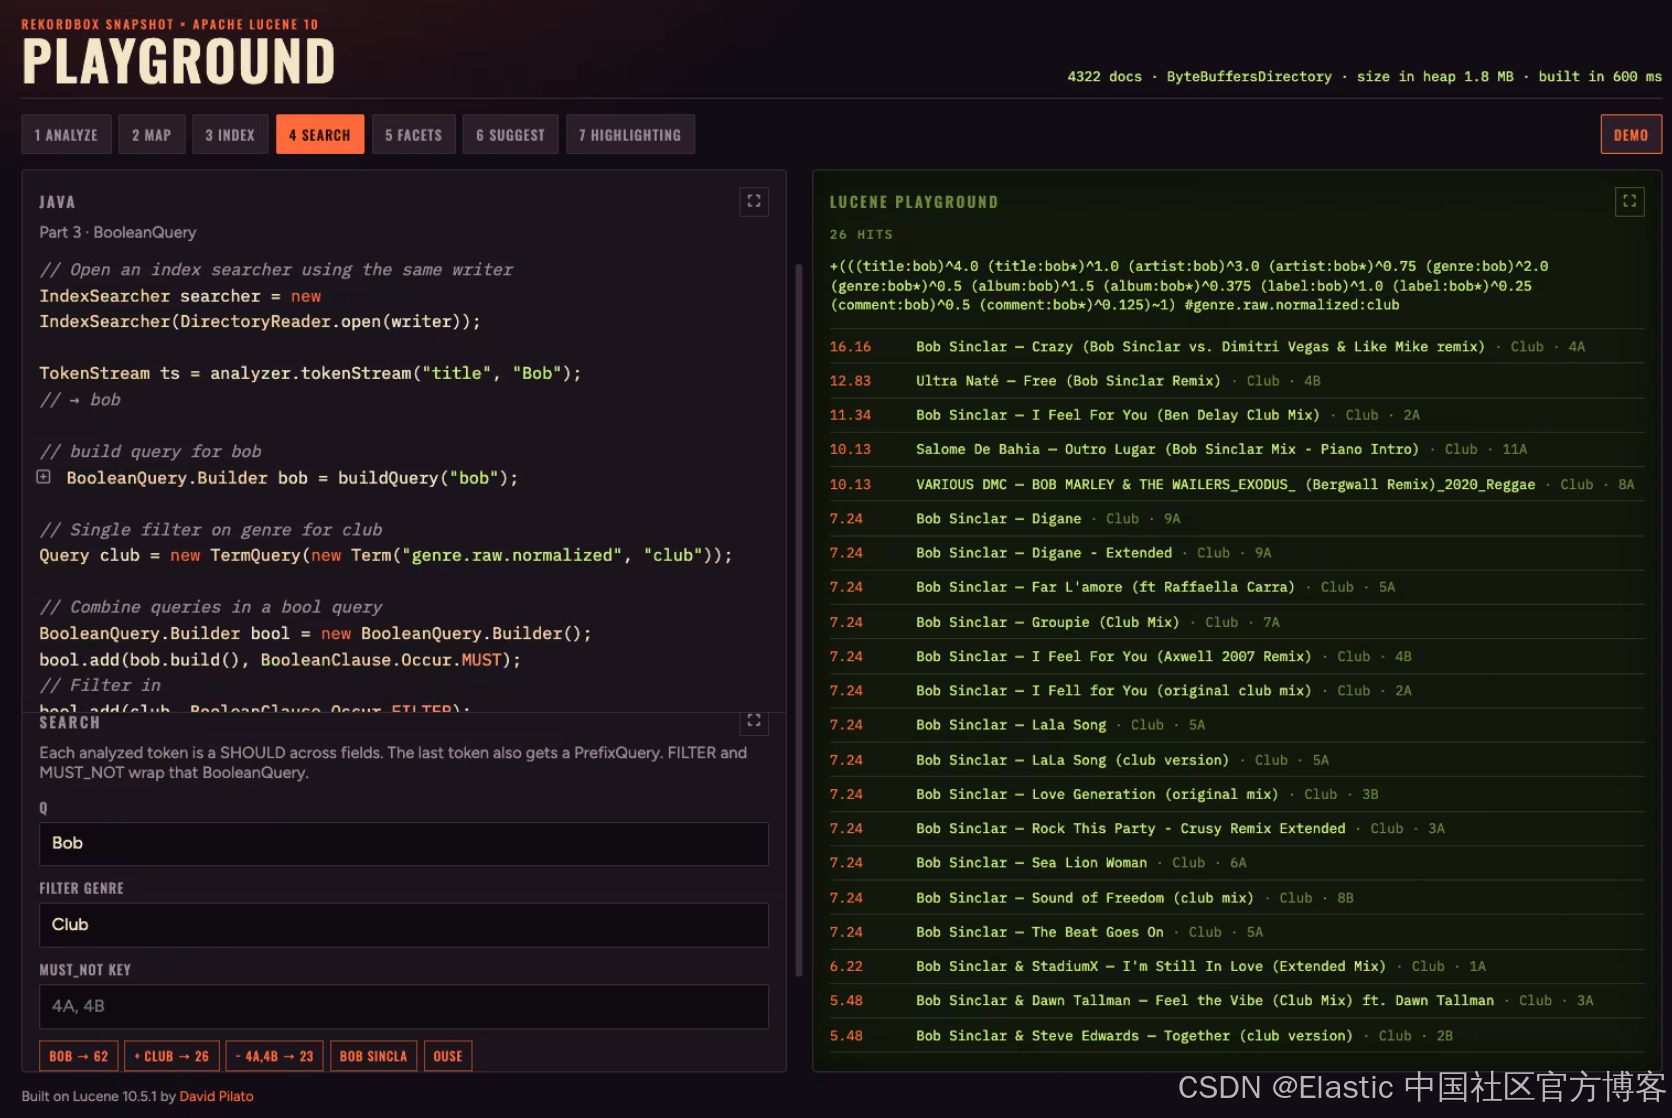
相同的 q=Bob,再加上 FILTER genre=Club —— 62 首曲目变成 26 首。
将自由文本查询 builder 包装为 MUST,并添加一个 FILTER —— 进行约束,但不参与评分。与 playground 生成的叶子查询相同:
// Single filter on genre for club
Query genre = new TermQuery(new Term("genre.raw.normalized", "club"));
// Combine queries in a bool query
Query bool = new BooleanQuery.Builder()
.add(bob, BooleanClause.Occur.MUST)
// Filter in
.add(genre, BooleanClause.Occur.FILTER)
.build();
Lucene 将其打印为:
+(((title:bob)^4.0 (title:bob*)^1.0 … )~1) #genre.raw.normalized:club
在 genre.raw 旁边建立一个规范化的 keyword 副本(genre.raw.normalized),这样 Club 和 club 就能匹配相同的文档。不要对它使用 wildcard。
排除两个键(4A 和 4B)
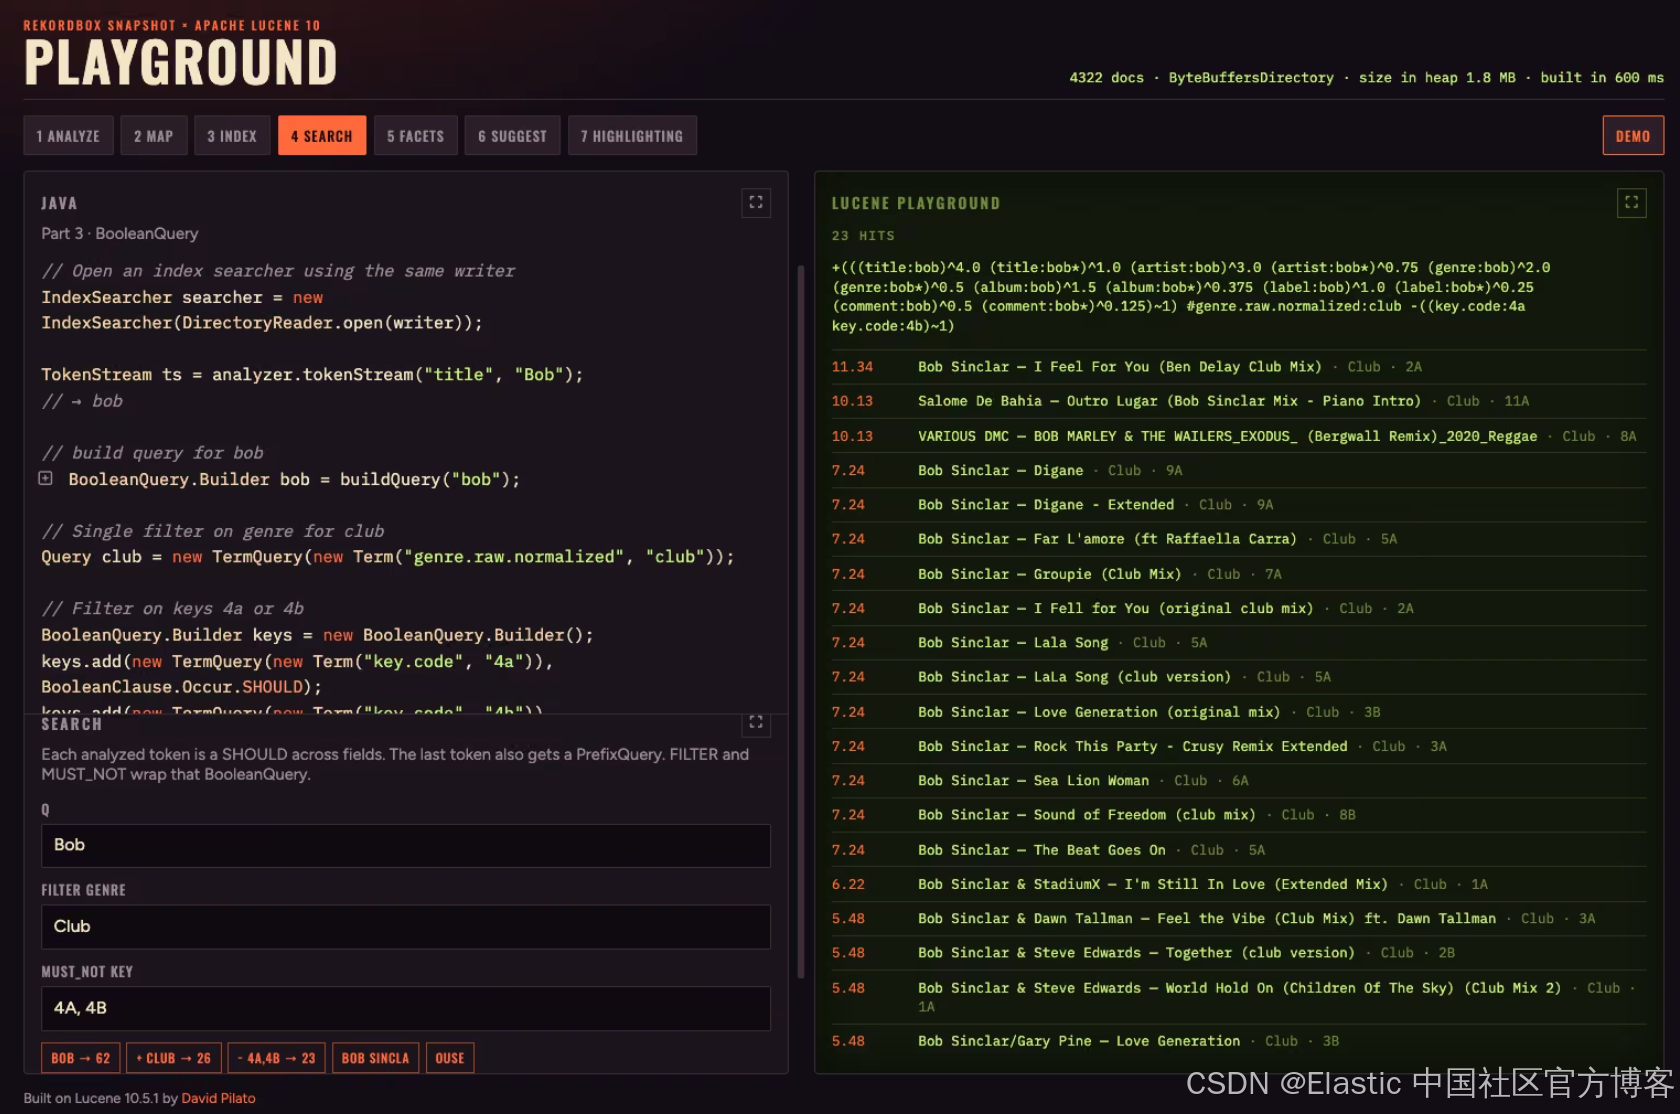
Club 保持启用。使用 MUST_NOT 排除 4A 或 4B —— 26 首曲目变成 23 首。
使用相同的 MUST + FILTER,再为排除的键添加 MUST_NOT。同一维度上的多个键使用 OR(SHOULD,minShouldMatch = 1):
// Filter on keys 4a or 4b
Query keys = new BooleanQuery.Builder()
.add(new TermQuery(new Term("key.code", "4a")), BooleanClause.Occur.SHOULD)
.add(new TermQuery(new Term("key.code", "4b")), BooleanClause.Occur.SHOULD)
.setMinimumNumberShouldMatch(1)
.build();
Query bool = new BooleanQuery.Builder()
.add(bob, BooleanClause.Occur.MUST)
.add(genre, BooleanClause.Occur.FILTER)
// Filter out
.add(keys, BooleanClause.Occur.MUST_NOT)
.build();
Lucene 将其打印为:
+(((title:bob)^4.0 … )~1) #genre.raw.normalized:club -((key.code:4a key.code:4b)~1)
这意味着:
| 输入“Bob” | Bob → 62 | MUST 匹配 + 最后一个 token 前缀 |
| 包含 Club | + Club → 26 | FILTER 精确匹配 club |
| 排除 4A 或 4B | − 4A、4B → 23 | MUST_NOT(4a SHOULD 4b) |
评分在确定搜索结果的相关性方面发挥着重要作用。一些子句会影响评分,而其他子句则充当过滤条件或排除条件。
| MUST | 分析后的匹配 + 最后一个 token 前缀 | 是 |
| FILTER | 字段约束(genre、bpm……) | 否 |
| MUST_NOT | 排除 | 否 |
| SHOULD + minShouldMatch = 1 | 一个子句内部的多选 OR | 否 |
只有 MUST_NOT 的 BooleanQuery 什么都匹配不到 —— 如果用户没有输入内容却进行了排除,请添加一个 MUST MatchAllDocsQuery。全部为空时使用 MatchAllDocsQuery。
首先显示“最佳”结果(按评分排序)
如果你想了解评分是如何计算的,可以对指定的文档和查询,在 IndexSearcher 上使用 explain 方法:
// Explain how the score is computed for the first hit
searcher.explain(query, hits.scoreDocs[0].doc);
这会得到类似这样的结果:
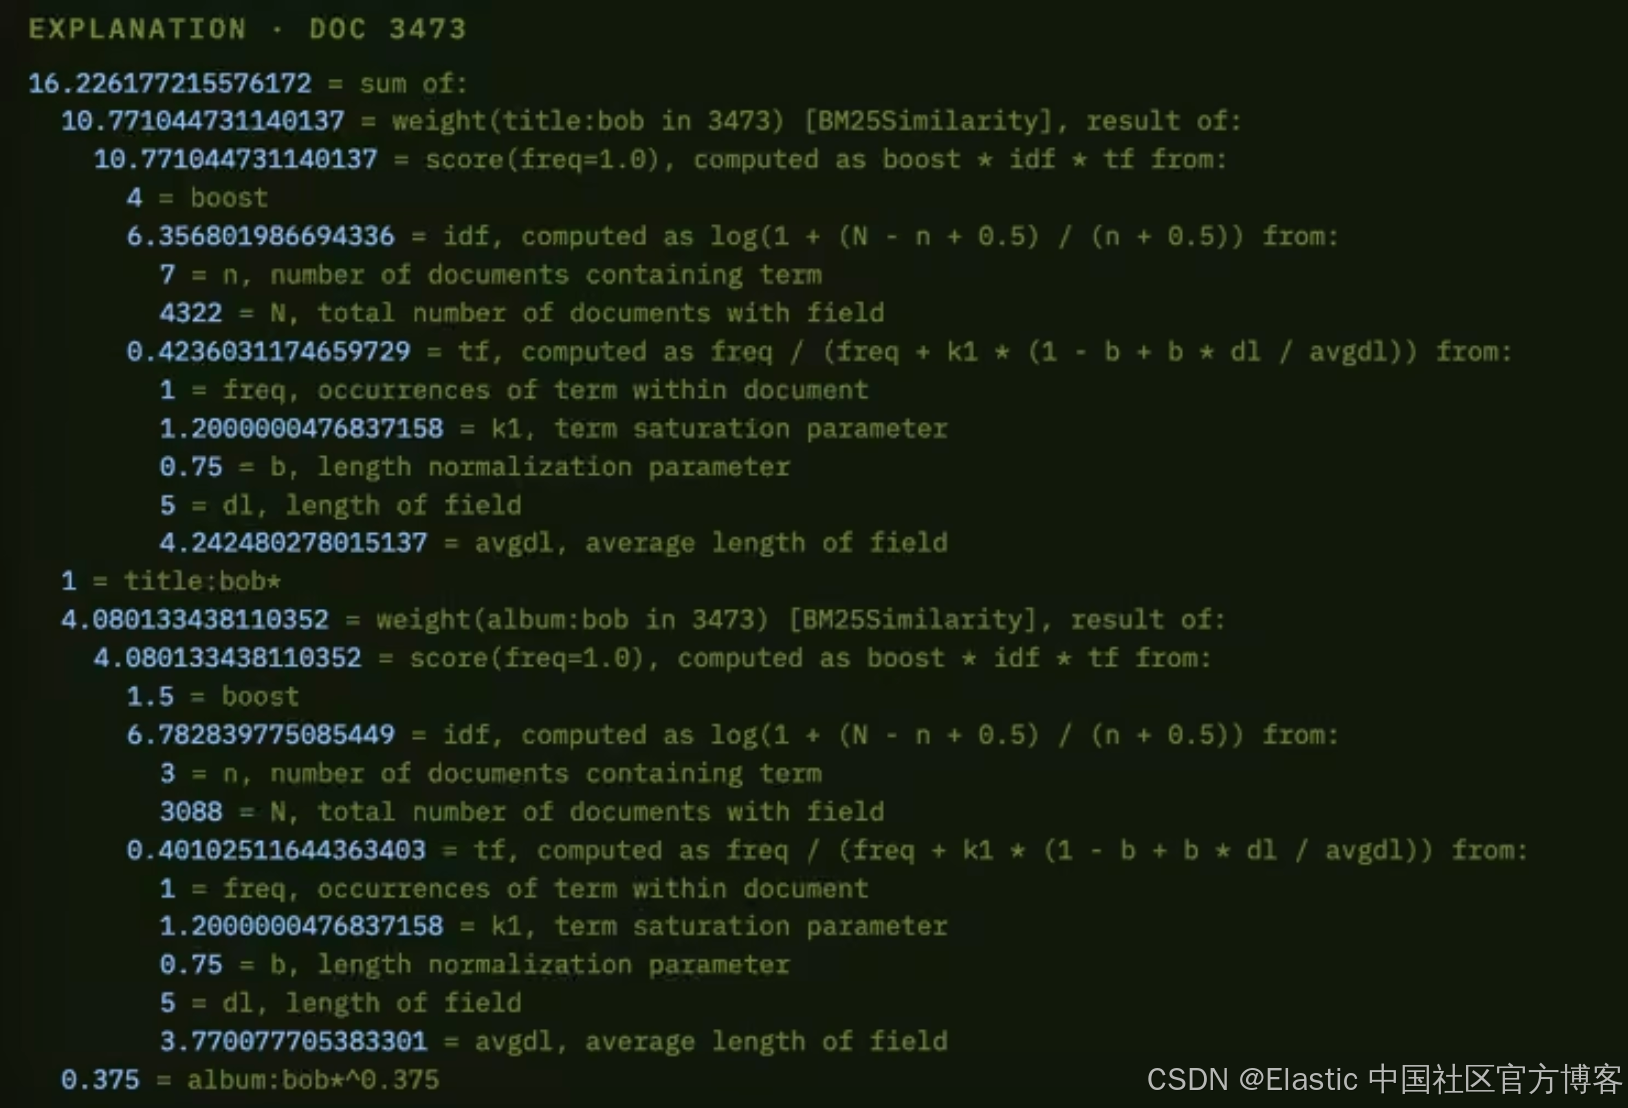
对于 q=Bob,文档 3473 的评分:title:bob 和 album:bob 上的 BM25 权重(boost × idf × tf)。
这棵树是 Lucene BM25 的评分分解。对于每个匹配的词项,评分为:
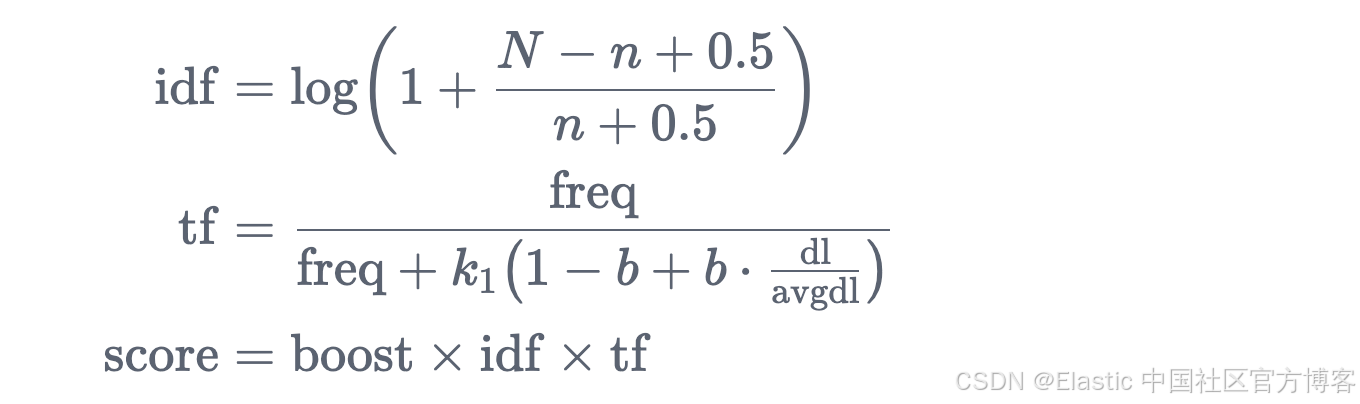
N 是包含该字段的文档数,n 是包含该词项的文档数,freq 是该词项在本文档中的出现次数,dl / avgdl 分别是字段长度与平均字段长度。k1 和 b 是 BM25 中常用的参数(默认值分别为 1.2 和 0.75)。
以截图中的文档 3473 的 title:bob 为例。在整个索引中,有 7 个标题包含 bob(n = 7),而共有 4,322 个文档包含 title 字段(N = 4,322)。在这个匹配结果中,bob 在标题中出现一次(freq = 1),标题包含 5 个 token(dl = 5),平均标题长度约为 4.24(avgdl)。字段 boost 为 4:
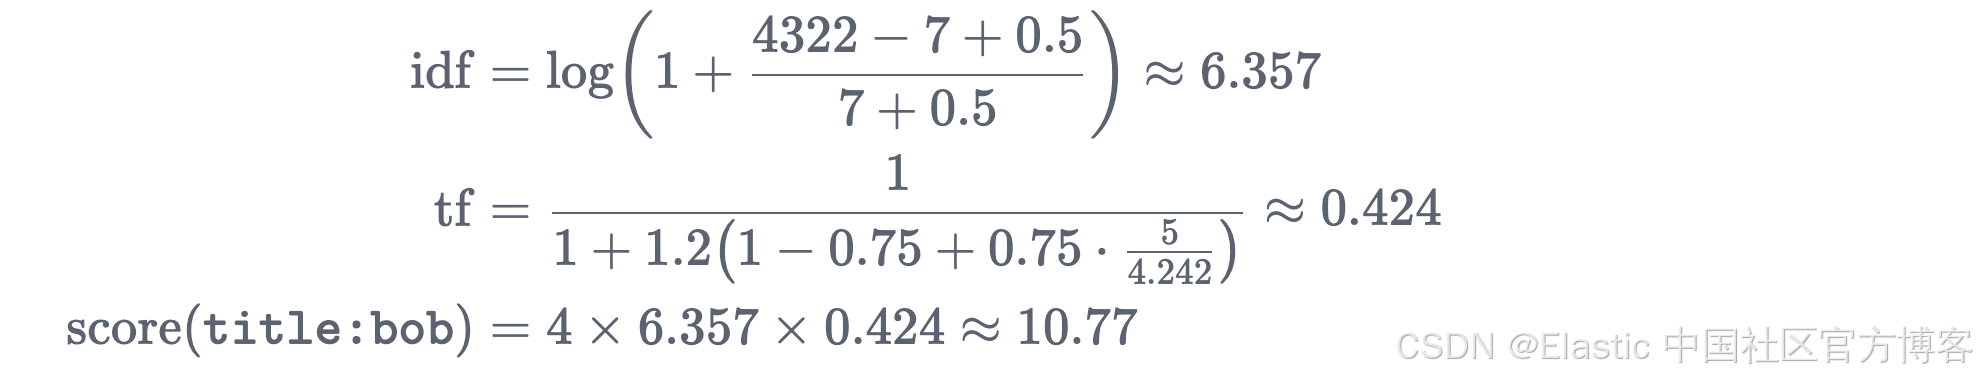
对 album:bob 进行同样的分析:只有 3 个专辑包含该词项(n = 3),而共有 3,088 个文档包含 album 字段(N = 3,088),同样是 freq = 1、dl = 5、avgdl \\approx 3.77,boost 为 1.5:
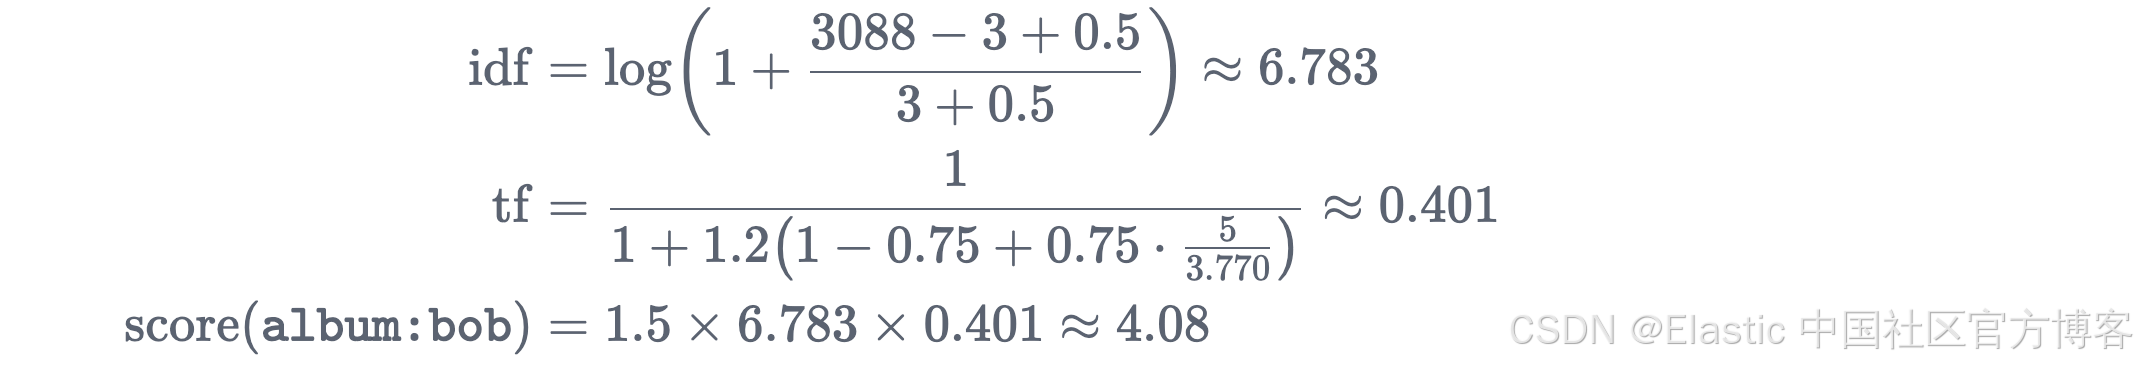
加上前缀叶子查询(title:bob* → 1、album:bob* → 0.375)后,就可以得到该匹配结果的评分:10.77+1+4.08+0.375≈16.23。
完整演示代码位于 GitHub:lucene-search-tracks。
原文:来自 Elastic https://david.pilato.fr/posts/2026-09-11-lucene-bean-search-query-sync/