想给自己的设计流程找一款图像生成模型,MOSS-Image(MOSS 图像生成模型系列)开源后,不少人的第一反应是拿它和 GPT Image 2 比一比。MOSS-Image 是 2026 年 10 月开源、能在本地运行的模型;GPT Image 2 是 OpenAI 通过 ChatGPT 和 API 提供的闭源模型,常被当作参照标杆。两者差多少、哪些活儿交给开源模型就够,光看宣传很难回答。
两边参与对比的分别是 MOSS-Image-Base 和 OpenAI 于 2026 年 4 月推出的 GPT Image 2。MOSS-Image 本身是开源文生图模型,扩散主干 5B(文本编码器和 VAE 另计),最突出的两项能力是长文本渲染和布局控制。结论放在前面:在按坐标摆放元素的 7Bench 评测里,MOSS-Image-Base 目标定位的 mIoU 达到 0.88,GPT Image 2 是 0.30;只拿一句简短需求出设计稿的盲评中,搭配基于 GPT-6 的 Layout PE(一种布局提示词增强器)的 MOSS-Image-Base 在参评端到端系统中排名第二,仅次于 GPT Image 2;整段文字的覆盖率则是 GPT Image 2 更高,LLTB 六组平均 99.0% 对 96.3%。想一句话拿到完成度最高的成品,GPT Image 2 更省事;想按坐标管住版面、在本地跑或训练自己的风格,MOSS-Image 更合适。
MOSS-Image:权重开放、可以本地部署的 5B 主干文生图模型
把 MOSS-Image 开源出来的是模思智能和 OpenMOSS 团队,时间在 2026 年 10 月 16 日,技术报告也在当月发布到 arXiv。OpenMOSS 是三方共建的产学研团队,成员分别来自复旦大学 NLP 实验室、上海创智学院和模思智能,此前也开源过语音、多模态理解方向的模型。模型骨架是一个从零起步预训练的单流扩散 Transformer,5B 主干之外另有文本编码器和 VAE;文本条件和图像 token 排进同一条序列,一起做注意力计算。
能力上,MOSS-Image 定位为通用的开源文生图模型。人像、风景、商品静物这类写实画面,插画、动漫、概念设计,再到海报、信息图、UI 视觉稿等带字的设计图,它都能出。训练集约 30 亿张图片,刻意去掉了 AI 生成的图,让数据分布贴近真实世界。一条提示词最多能写 4K tokens,自然语言描述、标签串、JSON 布局三种写法可以混用。在这些通用能力之上,长文本渲染与布局控制是它最突出的两项。
开源的版本有两个。MOSS-Image-Base 没有做后训练,保留了完整的预训练能力,适合拿来训 LoRA 或二次开发;MOSS-Image-SFT 是 Base 经过精选数据微调后的版本,适合直接出图。两个版本的代码与权重同属 Apache-2.0 许可,可以用于商业项目;下载渠道为 Hugging Face 与 ModelScope。
硬件上,官方口径是 INT8 量化后一张 RTX 3060 12GB 可本地运行;官方插件也可直接在 ComfyUI Manager 中搜索安装。社区的反应也很快:开源仅一周,Comfy-Org 在 Hugging Face 上打包发布的 MOSS-Image 权重,下载量就超过了 150 万次,LoRA 训练框架、少步数方案、全量微调模型也接连出现。
GPT Image 2:OpenAI 通过 ChatGPT 和 API 提供的闭源图像生成模型
GPT Image 2 由 OpenAI 于 2026 年 4 月 21 日发布。在 ChatGPT 里,它以 ChatGPT Images 2.0 的名义上线;面向开发者的模型名为 gpt-image-2,发布当天就在 OpenAI API 和 Codex 中开放。它是闭源模型,不提供权重下载,OpenAI 没有公开它的参数规模,使用时调用的是 OpenAI 的云端服务。
按 OpenAI 的官方介绍,GPT Image 2 面向复杂的视觉任务,主打方向集中在几处:文字渲染和多语言文字渲染都有改进;图表、信息图、海报、漫画这类结构化画面的生成更强;指令遵循、构图和细节保留更可靠。官方发布文章里的示例覆盖摄影、插画、漫画、像素画等多种风格;按 OpenAI API 文档,长宽比可在 1:3 到 3:1 之间设定;发布时官方称 API 中最高可输出 2K 分辨率。
使用方式上,发布时,ChatGPT 的所有方案都能使用 ChatGPT Images 2.0;付费方案选择 Thinking 或 Pro 模型时,还能开启带思考的图像生成,让模型先规划、再出图,官方称它可以检索信息、生成多个版本并自行检查结果。开发者通过 API 调用时,同一个模型既能根据文字生成图像,也能基于输入图片做编辑。
LLTB 长文本评测、7Bench 布局评测和端到端设计盲评都把 GPT Image 2 列入了对比,两款模型在相同条件下的成绩可以直接对照。
两款模型的规格和用法对照
| 项目 | MOSS-Image-Base | GPT Image 2 |
| 发布方 | 模思智能与 OpenMOSS 团队 | OpenAI |
| 发布时间 | 2026 年 10 月 16 日 | 2026 年 4 月 21 日 |
| 开放方式 | 代码、权重均开放,Apache-2.0,可商用 | 闭源,通过 ChatGPT、OpenAI API 和 Codex 使用 |
| 规模 | 扩散主干 5B,文本编码器与 VAE 不计在内 | 未公开 |
| 定位与同系列版本 | 面向微调和二次开发的底座;同一代另有 SFT 版,用于直接出图 | ChatGPT 中称 ChatGPT Images 2.0,API 模型名 gpt-image-2;付费方案可开启带思考的图像生成 |
| 输入 | 提示词上限 4K tokens;自然语言、标签串、JSON 布局均可 | 文字和图片 |
| 上手方式 | 本地出图,官方推荐 50 步、CFG 3、Shift 5,并开启跳层引导 | 在 ChatGPT 对话中描述需求,或通过 API 提交提示词 |
| 出图尺寸 | 长宽比不限,推荐总像素 1M / 1.5M / 2M,宽高须为 16 的整数倍 | 长宽比 1:3 到 3:1,宽高须为 16 的倍数;发布时官方称 API 中最高 2K 分辨率 |
| 运行环境 | 本地:ComfyUI 插件、Gradio 网页、Diffusers(自定义 pipeline),推理框架 SGLang、vLLM-Omni 也已支持;INT8 量化后 RTX 3060 12GB 可运行 | OpenAI 云端服务:ChatGPT(发布时所有方案可用)、OpenAI API、Codex |
| 改图与编辑 | 当前版本专注于文生图,图生图和基于参考图的图像编辑已在官方后续规划中 | 同一模型支持生成和编辑,API 提供图像编辑接口 |
注:左列信息出自 MOSS-Image 官方模型卡和用户指南,右列出自 OpenAI 的发布文章、API 模型页与 ChatGPT 更新说明。本文 MOSS-Image-Base 的评测分数,对应参评的预训练生成器,即公开发布的 Base 版;SFT 版由 Base 再经精选数据微调而来,是官方推荐的直接出图版本。
7Bench 按坐标摆放元素,差距拉得最开
海报、信息图要好用,标题、配图、按钮得各就各位,这一点往往比单张画面的美感更难把握。7Bench 是专门衡量布局能力的评测:题库有 224 组提示词与布局的组合,覆盖物体绑定、重叠框、颜色与属性绑定、物体关系、复杂构图等 7 类任务,合计 576 个目标物体;每个模型每题只生成 1 张图。
打分分两步:先由检测模型在画面里找到目标,再算它与指定框的交并比(IoU)。GPT Image 2 参评时,收到的也是含目标框的原始 JSON 提示词,统一出 1024×1024 的图。
| 指标 | MOSS-Image-Base | GPT Image 2 |
| 检出目标的平均定位精度(mIoU_det) | 0.88 | 0.30 |
| 布局 AUC(IoU 阈值 0.1–0.9 九档平均) | 0.70 | 0.16 |
| 576 个目标的检出率 | 0.77 | 0.47 |
| 准确率 @ IoU 0.5 | 0.73 | 0.12 |
| 准确率 @ IoU 0.7 | 0.72 | 0.03 |
| 准确率 @ IoU 0.9 | 0.47 | 0.00 |
注:两款模型的评测设置相同,每题 1 张图,不做挑选。GPT Image 2 在 7Bench 中有 22 个请求被安全策略拦下,这部分按 0 分计算。
7Bench 一共有 6 个模型参评,其中开放权重模型 2 款、闭源模型 4 款,都按同一套设置出题和打分。从全局看,MOSS-Image-Base 的 mIoU_det 和布局 AUC 都排在 6 款中的第一位;4 款闭源模型的 mIoU_det 集中在 0.30–0.33,布局 AUC 集中在 0.16–0.18,GPT Image 2 也在这个区间里。
具体到两款模型,六项对比里 MOSS-Image-Base 全部领先:检出目标的平均定位精度 0.88 对 0.30,布局 AUC 0.70 对 0.16。阈值收紧后,GPT Image 2 的准确率很快见底:IoU 0.5 时为 0.12,0.7 时为 0.03,0.9 时为 0.00;MOSS-Image-Base 在 IoU 0.7 时仍有 0.72,0.9 时仍有 0.47。
差距的来源在 MOSS-Image 的设计里:JSON 布局和自然语言共用一条文本条件通道,训练数据中也有一部分带边界框、逐字转写文字的结构化标注,坐标对它来说本就是熟悉的输入。7Bench 用带坐标框的 JSON 提示词出题,考的正是 MOSS-Image 原生支持的输入方式;按坐标落位并非 GPT Image 2 主打的用法。
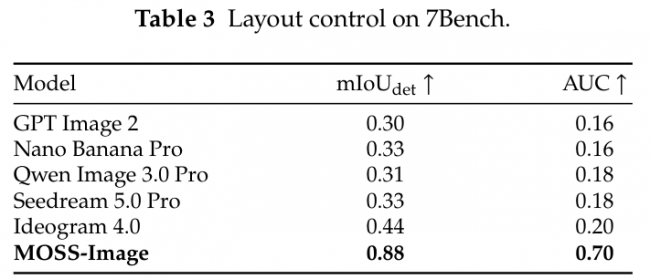
图注:7Bench 布局控制结果,mIoU_det、Layout AUC 两项都是数值越高越好
原表列出了全部 6 个参评模型的两项成绩。表中写作 MOSS-Image 的一行就是 MOSS-Image-Base,mIoU_det 和 Layout AUC 分别为 0.88、0.70,都是 6 款中最高;GPT Image 2 一行为 0.30、0.16,两项分别相差 0.58 和 0.54。
上千字长段文字的覆盖率都在九成以上
要把整段文字放进画面,LLTB(LongLongTextBench)这项长文本评测更有参考意义。240 道题里中文、英文各 120 道,目标文字按长度切成短、中、长三档,均长约 1340 个字符,再短的题也有 444 个字符。英文素材来自古登堡计划里的经典文学,中文选自《大学》《中庸》《孟子》与鲁迅的文章。评分靠文字识别模型读图,算出目标文字有多大比例出现在画面中,即文本覆盖率;每个模型每题生成 4 张,全部计分。
| 模型 | 英文短 | 英文中 | 英文长 | 中文短 | 中文中 | 中文长 | 六组平均 |
| MOSS-Image-Base | 98.0 | 97.1 | 97.1 | 96.3 | 96.7 | 92.4 | 96.3 |
| GPT Image 2 | 99.8 | 99.8 | 97.3 | 99.4 | 99.2 | 98.2 | 99.0 |
| 分差 | -1.8 | -2.7 | -0.2 | -3.1 | -2.5 | -5.8 | -2.7 |
注:数值为文本覆盖率(%),分差 = MOSS-Image-Base − GPT Image 2(百分点)。评测设置对两款模型一致;覆盖率衡量写出了多少目标文字,不等同于逐字准确率。
LLTB 一共有 12 个模型参评,其中闭源模型 4 款、开放权重模型 8 款。从全局看,GPT Image 2 的六组平均为 99.0%,在 12 款中最高;MOSS-Image-Base 为 96.3%,在全部参评模型中排第三,在 8 款开放权重模型中排第一,比开放权重组的第二名高出 31.4 个百分点。
具体到两款模型,GPT Image 2 在六组里都更高,两者的差距并不大:英文长档只差 0.2 个百分点,除中文长档外,其余五组的差距都不超过 3.1 个百分点;差距最大的是中文长段落一档,GPT Image 2 为 98.2%,MOSS-Image-Base 为 92.4%。
MOSS-Image-Base 的六组平均为 96.3%,每一组都在 92% 以上。官方给出的解释有两点:4K tokens 的提示词上限,让上千字的原文能整段放进去;单流结构则让文字条件与画面在同一条序列里同步处理。需要本地运行时,整段中英文写进画面这件事,MOSS-Image 已经能做到九成以上的覆盖。
一句话需求直接出设计稿:9 个系统的端到端盲评里排前两名
整体效果要看人工盲评 RealLayoutArena。它的 61 个设计需求取自真实场景,其中 UI 界面 21 个,海报、信息图各 20 个,每个需求都只是一句简短的中文。端到端这一组比的是完整系统,各家从同一句话出发,走自己的提示词处理流程出图;MOSS-Image 这边参评的是 MOSS-Image-Base 加上基于 GPT-6 的 Layout PE,后者负责规划版面、扩写提示词。
规则上,每个系统每题只交 1 张图,不允许重抽或挑图。评审看到的只有原始需求,并不知道图片来自哪家,每次在两张图中选更好的一张,也可以判平,最后换算成 Elo 积分。
| 系统 | Elo 点估计 | 在 9 个参评系统中的名次 |
| GPT Image 2 | 1844.4 | 第 1 |
| MOSS-Image-Base(结合基于 GPT-6 的 Layout PE) | 1698.7 | 第 2 |
注:Elo 点估计来自 61 个设计任务的人工盲评,MOSS-Image-Base 一方的 95% 置信区间是 1656.0 到 1741.4。本组 Elo 独立拟合,不和这项盲评其他分组的分数对比。
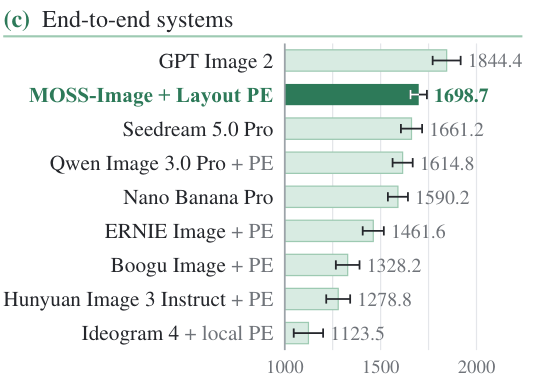
图注:端到端系统盲评,各系统都只拿到一句简短设计需求,柱高为 Elo 点估计,误差线代表 95% 置信区间,本组 Elo 单独拟合
这一组共有 9 个系统参评,其中闭源系统 4 个、开放权重系统 5 个,Elo 分数从 1123.5 到 1844.4 不等;排在前五名的,是 4 个闭源系统和 MOSS-Image-Base 这一个开放权重系统。第二名与第三名的分数相差约 38 分,第三名的分数落在第二名的 95% 置信区间之内,这两个名次的先后在统计上还不算稳定。
具体到两款模型:第一名是 GPT Image 2,1844.4 分;第二名是图中标注为“MOSS-Image + Layout PE”的 MOSS-Image-Base,1698.7 分,比第一名低约 146 分。从投票明细看,这一组里 MOSS-Image-Base 一共经历 457 次两两对决,赢 293 次、平 100 次、输 64 次。
这组成绩可以这样理解:只给一句需求、要求直接交出完整设计稿时,GPT Image 2 的整体完成度最高;MOSS-Image-Base 这一开放权重生成器,配合基于 GPT-6 的 Layout PE 先做版面规划,排在它之后的第二位。
版面可控、权重在手,MOSS-Image 能接进自己的流程
MOSS-Image 最有辨识度的用法,是直接在提示词里写 JSON 布局:summary 交代整体场景和风格,items 把物体、文字块逐个列出来,每一项附上边界框,文字项还可以写明要渲染的原文。坐标原点在画布中心,四个数依次是 y_min、x_min、y_max、x_max,出图尺寸要和布局画布对得上。哪一块要调整,就改它在 JSON 里的文字或坐标再生成一次;这样做会重画整张图,别处不保证原样保留。
配套的 Prompt Enhancer Skill 可以借助 AI 智能体,把一句创意扩写成带坐标的布局提示词。
权重开放带来的是另一层自由。模型可以部署在自己的电脑或服务器上,提示词、文案和生成结果都留在本地,适合素材在公开前需要保密的团队;Apache-2.0 许可允许商用,可以把它接进自家的设计工具或内容生产流程。ComfyUI 有官方插件,SGLang、vLLM-Omni 这类推理框架也已接入,搭建批量出图的服务不必从零开始。
需要固定的品牌风格或特定题材时,可以在 MOSS-Image-Base 上训练 LoRA 或做全参数微调,官方建议训练时保持文本编码器冻结,社区训练框架 KohakuMoss 两种方式都已支持;开源第一周,社区还推出了少步数方案和基于 Base 的全量微调模型。
第三方的评价也落在这几点上:AI Polix 把布局控制看作它最有特色的能力;OrcaRouter 则提到,用 MOSS-Image 时可以直接查看决定画面的那份布局输入,也能自行微调和量化。
GPT Image 2 完成度高、打开 ChatGPT 就能用
GPT Image 2 的长处主要有三点。
整体设计完成度高。在只给一句简短需求的设计盲评里,GPT Image 2 以 1844.4 Elo 在 9 个参评系统中排名第一。不用自己写长提示词、也不用规划版面,一句话就能得到完成度很高的海报、信息图和 UI 画面,这与 OpenAI 官方强调的复杂视觉任务方向一致。
LLTB 长文本覆盖率在 12 个参评模型中最高。 LLTB 评测中,GPT Image 2 的六组平均文本覆盖率为 99.0%,中文长段落一档为 98.2%,六组成绩都在 97% 以上。按官方介绍,多语言文字渲染也是这一代模型的主要改进之一。
无需部署,生成和编辑在一处完成。 发布时,ChatGPT 的所有方案都能直接使用,付费方案还能开启带思考的图像生成,先规划再出图;开发者通过 OpenAI API 或 Codex 调用,同一个模型既能出图,也能基于输入图片做编辑。对没有显卡、也不想维护本地环境的个人和团队来说,上手几乎没有门槛。
按任务与部署条件挑选更合适的模型
| 你手上的任务 | 建议先试 | 依据 |
| 带几百字说明文字的海报、长图、知识卡片 | 两款都可以,按部署方式选 | LLTB 短档(目标文字也有几百个字符):MOSS-Image-Base 英文 98.0%、中文 96.3%,GPT Image 2 为 99.8%、99.4% |
| 上千字的中文长段落,如古文、长篇说明 | 两款都可以:追求最高覆盖率选 GPT Image 2,需要本地运行选 MOSS-Image | LLTB 中文长档:GPT Image 2 为 98.2%,MOSS-Image-Base 为 92.4% |
| 要指定标题、插图、按钮和文字块的位置 | MOSS-Image | JSON 直接写坐标;7Bench 定位精度 MOSS-Image-Base 0.88、GPT Image 2 0.30,布局 AUC 0.70 对 0.16 |
| 提示词和素材不能离开本地 | MOSS-Image | 权重开放,可本地部署;官方口径为 INT8 量化后 RTX 3060 12GB 可运行 |
| 训练品牌风格或做商用二次开发 | MOSS-Image | Apache-2.0 许可,可商用;MOSS-Image-Base 面向 LoRA 和全参数微调 |
| 只有一句需求,想直接拿到完成度高的设计稿 | GPT Image 2 | 只给简短需求的端到端盲评中排名第一(1844.4 Elo) |
| 没有显卡,也不想维护本地环境 | GPT Image 2 | 发布时 ChatGPT 所有方案可用,开发者可通过 OpenAI API 和 Codex 调用 |
| 出图后要基于已有图片继续修改 | GPT Image 2 | 同一模型支持生成和编辑;MOSS-Image 当前版本专注于文生图,图生图和基于参考图的图像编辑已在官方后续规划中 |
两款模型也可以分工使用:前期找方向、试概念时,在 ChatGPT 里用 GPT Image 2 一句话出几版草图;方向定下来之后,把需要固定的版式写成 MOSS-Image 的 JSON 布局,标题、文案和配图的位置按坐标锁定,再用本地部署的 MOSS-Image-SFT 替换文字、批量出图,批量生产阶段的文案和素材都留在自己的机器上。
版面精度与部署方式决定选择
从三项评测的结果看,GPT Image 2 在 LLTB 长文本(六组平均 99.0%)和只给一句需求的端到端盲评中领先;MOSS-Image-Base 的长文本覆盖率为 96.3%,六组都在 92% 以上;MOSS-Image-Base 结合基于 GPT-6 的 Layout PE,在参评端到端系统中排名第二,仅次于 GPT Image 2;7Bench 布局控制评测中,MOSS-Image-Base 单独参评,mIoU 0.88、布局 AUC 0.70,两项都明显高于 GPT Image 2 的 0.30、0.16。
落到具体情形:需要精确到坐标的版面、要求素材留在本地,或者想在模型上训练自己的风格,MOSS-Image 更合适,它的权重以 Apache-2.0 许可开放、可以商用,INT8 量化后一张 RTX 3060 12GB 可本地运行;只有一句需求、希望直接拿到完成度高的设计稿,或者手边没有显卡,GPT Image 2 更省事。