第 4 章 使用 AI 前必须知道的边界
文章目录
- 第 4 章 使用 AI 前必须知道的边界
-
- 🌈 关于《AI 零基础 36 讲》
- 流畅回答也可能没有事实依据
- 正确答案也可能已经过期
- 输入框不是随手倒资料的地方
- AI 不能替你取得版权许可
- 高风险任务需要把人放入流程
- 发布前走完四步检查
- 参考资料
请看一段很像百科资料的回答。
《雨天算法》由林桥写于 2018 年,全书 312 页,并在当年获得青岚技术图书奖。
书名像真的,作者、页数和奖项也互相配合。问题在于,这些信息是本章人为编造的教学材料。一个没有核验习惯的读者,很容易把它复制进文章,随后又被搜索引擎和其他 AI 当成新的文字材料。 
AI 可以帮人整理和起草,事实、数据、隐私与发布责任仍要由使用者检查。
读完本章,你应该能识别四类常见风险,判断哪些内容不能直接交给公共 AI 服务,并能按来源、日期、隐私和版权四个方向检查一段输出。本章不提供针对个人案件的法律意见。涉及医疗、法律、金融和就业等重要决定时,还需要查原始文件并请合适的专业人员复核。
🌈 关于《AI 零基础 36 讲》
🧠 零基础也能开始学 AI
《AI 零基础 36 讲》是一套面向初学者的 AI 入门教程。课程从认识和使用 AI 开始,逐步学习 Python、数据处理、机器学习与深度学习,再进入大模型应用开发,最后完成个人知识库助手的综合实践。
📖 本篇是正式讲解文章
通过具体例子、原创图示和操作结果讲清概念。涉及编程的章节提供可运行代码,方便你边读边试。
🎯 读完以后,动手检验
建议按专栏顺序学习,并完成对应的课后训练,检查自己能否独立运用本章知识。
博客专栏:《AI 零基础 36 讲》
流畅回答也可能没有事实依据
第 3 章讲过,语言模型根据上下文逐步选择后续 Token。这个过程能够写出连贯句子,却不会自动给每句话附上一张真实世界的凭证。
模型自信地生成错误或虚假内容称为 confabulation,中文讨论中常叫幻觉。模型可能编出论文、书名、法规条款和人物经历,也可能把几个真实片段接成一条错误结论。内容越符合常见写法,人越容易相信。
遇到事实型回答,可以先把句子拆成可核验的主张。前面的虚构书目至少含有书名是否存在、作者是谁、出版时间、页数和获奖记录五项主张。搜索到一篇重复这段话的博客,只能说明有人写过同样的话,不能证明五项主张都成立。
核验时优先找能直接负责的来源。法律去国家机关网站查正式文本,论文去期刊、会议或作者页面查,产品功能去官方文档和更新记录查。新闻事件要核对事件发生时间,也要看文章发布时间。搜索摘要方便定位,最终判断仍要回到原页面。
正确答案也可能已经过期
有些回答在写成那天完全正确,几个月后就不能再用。软件价格、考试政策、模型功能、机构负责人和办事流程都可能变化。
用户只问“这个功能怎么开”,模型可能根据旧界面回答。更稳妥的问法会给出产品名称、版本或使用日期,并要求附上当前官方文档。拿到链接以后还要查看页面的更新时间,确认它讲的是正在使用的版本。
模型能联网也不能省掉这一步。搜索工具可能找到旧页面,网页也可能更新不及时。决定报名、付款、签约或提交材料以前,应该打开负责该事项的机构页面,检查适用地区、生效日期和例外条件。
本地知识也要保存日期。团队把一份制度文件交给 AI 做问答,可以在文件名或元数据中记录版本、生效日期和来源地址。新制度发布时替换旧文件,并保留变更记录。这样发现答案有问题时,能够追到模型当时参考了哪一版材料。
输入框不是随手倒资料的地方
很多人只盯着模型会回答什么,提交之前却没有看自己贴进去了什么。
《中华人民共和国个人信息保护法》把生物识别、医疗健康、金融账户和行踪轨迹等列为敏感个人信息,不满十四周岁未成年人的个人信息也在其中。身份证照片、病历、银行卡信息、精确住址和带姓名的学生资料,都不适合随手粘贴到公共 AI 对话框。
工作资料还多一层限制。未公开合同、客户名单、内部代码、财务数据和访问密钥可能属于商业秘密或受公司制度约束。英国国家网络安全中心给出的建议很直接,不要在公共大语言模型查询中放入敏感信息,也不要提交一旦公开就会带来问题的内容。
使用某项服务前,需要阅读它当前的隐私政策、数据用途、保存期限和账号设置。个人版、企业版与接口服务的规则可能不同,产品也会更新。关闭某个训练选项,只能说明该选项管辖的用途发生变化,不能替代公司的数据分级和保密要求。
确实需要 AI 帮忙处理材料,可以先做最小化。姓名换成角色代号,删除身份证号和联系方式,金额改成不影响分析的区间,只保留完成任务所需的段落。单位已经部署获批的内部系统时,也要按单位规则选择账号、存储位置和可上传的数据级别。
还有一条容易漏掉。别人的个人信息也需要保护。你愿意公开自己的简历,不等于同学、客户和受访者也同意把他们的资料交给第三方服务。
AI 不能替你取得版权许可
让 AI 改写一篇文章,不会让原文的权利关系消失。把付费课程、整本电子书、摄影作品或他人的完整代码上传后再生成新内容,仍要考虑你是否有权复制、上传、改编和发布这些材料。
《中华人民共和国著作权法》规定了复制、改编、翻译和信息网络传播等权利,也列出了可以不经许可使用作品的具体情形。实际使用是否落在这些情形中,要结合用途、篇幅、传播方式和授权合同判断。商业发布或争议较大的项目,应请专业人员审查。 
AI 输出本身也需要检查。模型可能复现常见句子、代码片段或与训练材料相近的表达,服务通常无法替用户保证每段内容都可自由使用。发布前可以搜索显眼句子,检查图片来源与许可,确认代码依赖的许可证,并保留自己使用的资料、提示和修改记录。
引用来源也不能靠模型代填。模型给出的论文标题、作者和链接可能不存在。先打开原文,确认作者、标题、发布日期和链接,再把它放进参考资料。引用文字要对照原文,不能让模型根据记忆补齐。
高风险任务需要把人放入流程
还要注意人机配合中的过度依赖。模型说得快,格式又整齐,人很容易把检查当成多余步骤。
风险大小取决于答案会带来什么后果。给旅行清单补一个普通物品,错了通常只是麻烦。用 AI 判断药物剂量、合同责任、投资金额或求职者去留,错误可能影响健康、财产和他人的机会。后面这些任务需要明确的责任人、可靠资料和人工复核。
人工复核也要有内容。让同事快速看一眼,常常只能发现错别字。有效复核会要求检查者看到原始资料、模型输出和使用目的,逐项核对数字、引用与关键判断,并知道谁有权作最后决定。
保留原始材料很重要。模型写出摘要后,不要用摘要覆盖会议记录、政策文件或实验数据。发现一句话有争议时,原始材料能让人回到上下文,分清模型漏了条件,还是原文件本来就含糊。
发布前走完四步检查
下面这张图可以用来对照。它不保证结果永远正确,却能挡住很多低级错误。
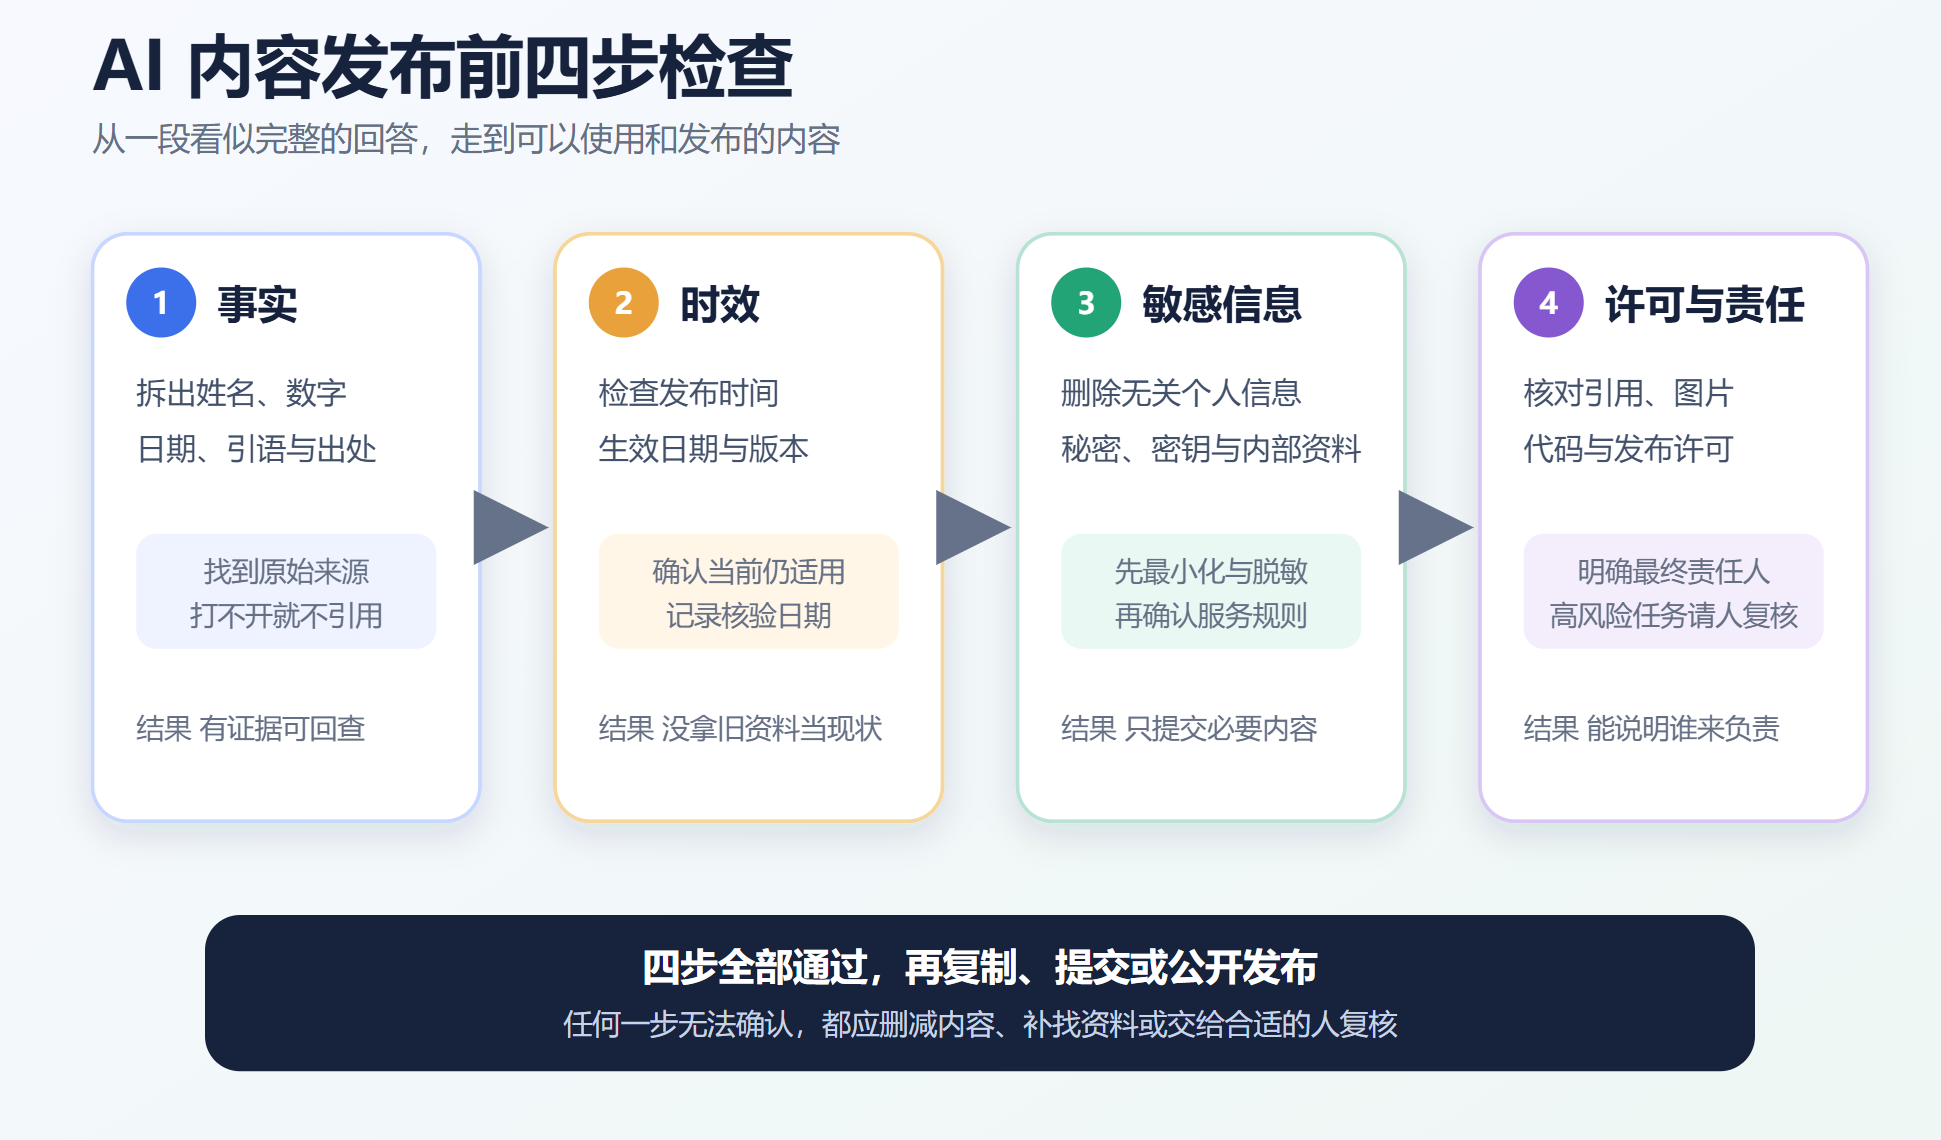
第一步检查事实。圈出姓名、数字、日期、书名、论文、政策和引语,给每项找到能直接证明它的来源。找不到来源就删掉,或者明确标为未核实。
第二步检查时效。看来源何时发布,规则何时生效,产品版本是否一致。涉及当前状态的问题,应记录核验日期。
第三步检查输入与输出中的敏感内容。删除任务不需要的个人信息、商业秘密和账号凭证,并确认服务与单位规则允许处理剩余材料。
第四步检查使用权与责任。确认引用、图片、代码和原文的许可,判断发布或决策造成后果时由谁负责。高风险任务在这一步安排专业复核。
本章的课后练习准备了三份小材料。你会拆解一段虚构回答,给一份简历脱敏,再判断几种内容能否直接交给公共 AI。完成以后,你应该能在复制答案之前停一下,知道该查什么,也知道哪些东西从一开始就不该粘贴进去。
参考资料
- NIST 生成式 AI 风险说明
- 英国国家网络安全中心关于公共大语言模型的建议
- 中华人民共和国个人信息保护法
- 中华人民共和国著作权法
- 生成式人工智能服务管理暂行办法


