前言:从零写 Demo 不算本事,敢不敢接老系统的第二次迭代?
打开技术社区,AI 辅助编程的实测一抓一大把,但翻上十篇你会发现套路几乎一样:空白编辑器里敲一句提示词,两分钟生成一个 TodoList 或者单表增删改查。
可我们真正的工作日不是这么过的。后端大部分的精力和头发,都花在“接手一套已经在跑的系统、改接口、加字段、补权限”上。 二次开发最容易出事的就三处:
- 老系统改表结构:旧数据还在线上跑着,新增字段怎么平滑兼容、怎么不把历史记录读崩;
- 前后端认知脱节:我这边改了 DTO、加了必填项,前端不知道;前端按老交互调接口,控制台一片 400;
- 二次联调:业务代码改完了,两边拉个会议室抓包、对字段驼峰、排查跨域和 401,比从头写一个新功能还累。
飞算 JavaAI 全栈功能上线时的核心主张挺激进:“Java 后端不用学前端框架、不用经历前后端联调,一个人就能独立交付前后端项目。” 官方给了一组对照数据(出处是官方口径,不是我测的):
| 效率 | 中等复杂度 CRUD 页面:传统模式约 7 天(前端 3 + 后端 2 + 联调 2);飞算 JavaAI 模式约 1 天(后端 1 人独立完成) |
| 人力 | 传统模式至少前端 1 人 + 后端 1 人;飞算模式只要 Java 后端 1 人 |
| 案例 | 已有 Java 后端工程师独立交付 6 个前端页面及配套后端并上线 |
我更好奇的是另一件事:如果不是空项目,而是在一套已经有三个版本在跑的老系统上突然加一大块需求,它还能不能做到“不学前端、联调归零、一个人交付”? 带着这个问题,我拿手头真在维护的中后台服务——“拾光|园区智慧失物认领系统”,做了一轮完整的二次迭代实测。
一、老系统现状:一套已经跑到 V3 的系统,突然要大改
动手之前,“拾光”已经跑通了三轮业务,全是增量演进,没推倒重来过:
| V1 | 物品台账 lost_item:编号、名称、类型(拾得/遗失)、分类、地点、发生时间 | item_no 唯一约束 |
| V2 | 特征标签 tags + 流转状态 OPEN / CLAIMING / RESOLVED,前端支持标签检索 | 旧行用 DEFAULT 'OPEN' 补状态,原列不动 |
| V3 | 独立认领流水 claim_record:归属证明材料、裁决结果 | item_id 外键挂回台账 |
突发的二次需求:权限必须收敛,系统必须能直接交出去
就在准备试运行时,业务方提了两条很严肃的要求:
- 先把越权漏洞堵上——系统当时完全没有账号体系,任何人往 /api/lost-found/claims/audit 发一个 POST,就能替别人审批认领单;
- 补齐账号与权限:增量加用户表,支持加盐密码注册、登录与 Bearer Token 鉴权;审核(通过/驳回)收敛为园区管理员(ROLE_ADMIN)独占,普通用户只能看和管理自己的工单;
- 旧数据一行不能少:历史台账平滑过渡,旧接口不报空指针,不允许推倒重做;
- 交付得像个产品——清掉 DEMO-001 这类合成假数据和已经失效的初始化脚本,补齐健康检查与容器编排,界面上要能看到真实的业务流转。
在传统模式下,这种“改数据模型 + 加鉴权拦截 + 前端加登录弹窗 + 按钮按角色受控 + 生产容器化”的迭代,前端加后端没有 7 天根本下不来。
二、第一步:把需求丢给插件,它会先问生产约束吗?
过去做二次开发,我最头疼的其实不是写代码,而是改前端交互:在老页面上塞登录弹窗、加用户状态栏、让审核按钮跟着角色显隐,都还算小事;表结构一动,历史数据读取极容易踩空指针。
接下来这一步很关键。我打开 IntelliJ IDEA 里的飞算 JavaAI 插件,让左侧工程树停在 shiguang 目录上,在会话框里输入了这次二次迭代的结构化需求,一共 701 个字,把“当前工程上下文”和“本次二次增量需求”分开写:
本次输入的指令(701 字):
【当前工程上下文】
我们正在维护既有的“拾光·园区失物认领系统”,目前已具备 V1 物品台账、V2 标签与状态流转(OPEN/CLAIMING/RESOLVED)及 V3 认领流水记录。但当前系统处于无鉴权裸奔状态,存在匿名越权漏洞。
【本次二次增量需求】
请在既有代码库基础上进行安全加固与全栈增量升级,严禁推倒重做:
1. 数据库与领域模型演进:
– 增量引入系统用户表(sys_user),字段包含用户名、密码哈希、真实姓名、联系电话、角色(ROLE_ADMIN, ROLE_USER);
– 增量生成 Flyway V4 迁移脚本,确保历史存量物品和认领数据平滑兼容,不丢数据、不报空指针。
2. 后端安全与权限收敛:
– 密码采用加盐安全散列(PBKDF2),提供基于 Bearer Token 的无状态登录认证(/api/auth/login, /api/auth/register, /api/auth/me);
– 严格权限隔离:认领审核裁决接口(/api/lost-found/claims/audit)增加权限注解,严格限定为管理员(ROLE_ADMIN)独占权限;普通用户访问直接 403 拦截。
3. 前端界面增量适配:
– 在既有单页顶部 Header 增量增加用户状态栏(未登录显示“访客模式+登录注册按钮”,已登录展示“用户名+角色徽章”);
– 增加登录/注册模态弹窗(Modal),支持 Tab 切换与自动回显;
– 认领审核中心受控展示:普通用户隐藏【通过/驳回】操作按钮并提示权限保护,仅管理员登录后高亮呈现审核控制台。
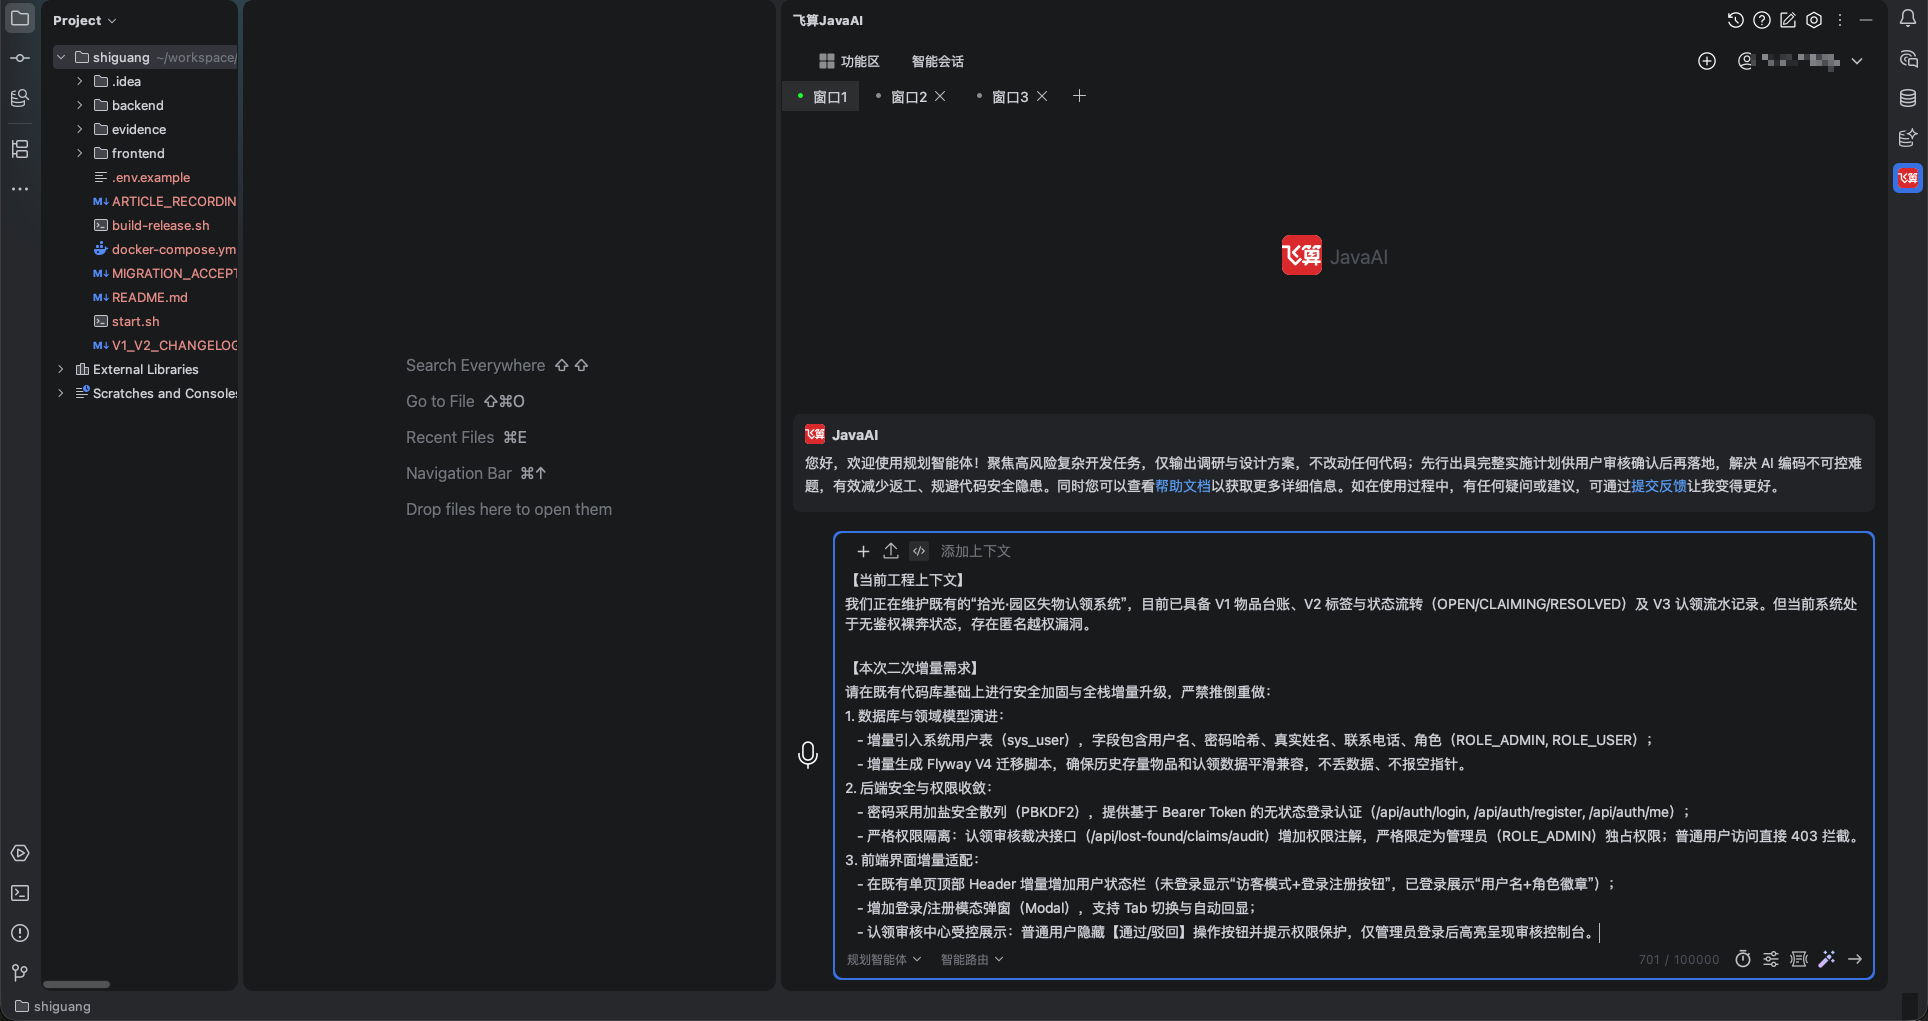
📷 图 1:把二次需求交给飞算 JavaAI(右下角计数 701 字)
需求发出去之后,插件没有立刻动手改文件。会话窗口顶部有一段模式说明,图 1 里能看到原文:
“您好,欢迎使用规划智能体!聚焦高风险复杂开发任务,仅输出调研与设计方案,不修改任何代码;先行出具完整实施计划供用户审核确认后再落地,解决 AI 编码不可控问题,有效减少返工、规避代码安全隐患。”
也就是说,我这次用的「规划智能体」模式(就在输入框左下角切换,旁边是「智能路由」)本身就是“只调研、出方案、不动代码”。它的第一步去干了什么?说出来有点反直觉:先去读生产环境是怎么配的。
| 比对多环境配置差异 | local:Flyway 关、ddl-auto=update;prod:Flyway 开、ddl-auto: validate;test:create-drop |
| 点名生产崩溃红线 | “改动实体字段时必须同步 V4 脚本,否则 prod 启动校验失败” |
| 核对实体与脚本对齐 | UserEntity / LostItemEntity / ClaimRecordEntity 与 V4 列一一对应(可空 Long) |
| 排查存量数据空值安全 | Service 层对历史数据 user_id 为空的处理,Response.from 不抛空指针 |
💡 老系统改造最常翻车的地方,就是实体和迁移脚本对不齐导致生产启动即失败。它没有急着写业务代码,而是先把这条“启动红线”拎出来。 这就是一个架构师接手改造时的标准动作:动刀之前,先看生产约束,再看旧数据会不会崩。
三、第二步:先给方案文档,再按计划落地
研判完,它没有直接改工程文件,而是先在项目里落下一份方案文档,文件是 .feisuan/documents/安全加固验收与补强方案.md,自动呈现在 IDEA 编辑区等我审核。
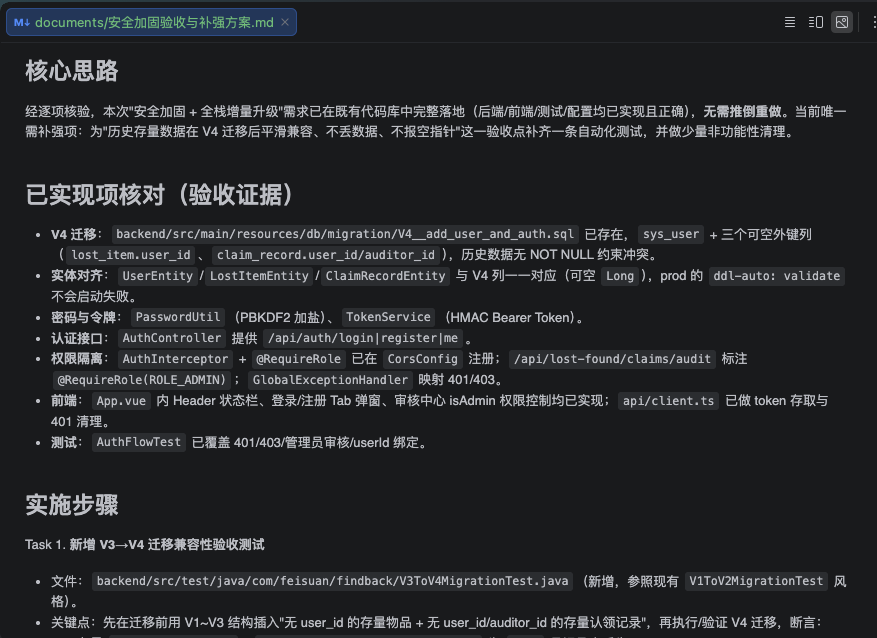
📷 图 2:先出方案文档,再动代码
方案文档的核心内容(节选):
## 核心思路
经逐项核验,本次"安全加固 + 全栈增量升级"需求已在既有代码库中完整落地(后端/前端/测试/配置均已实现且正确),**无需推倒重做**。当前唯一需补强项:为"历史存量数据在 V4 迁移后平滑兼容、不丢数据、不报空指针"这一验收点补齐一条自动化测试,并做少量非功能性清理。
## 已实现项核对(验收证据)
– **V4 迁移**:backend/src/main/resources/db/migration/V4__add_user_and_auth.sql 已存在,sys_user + 三个可空外键列(lost_item.user_id、claim_record.user_id/auditor_id),历史数据无 NOT NULL 约束冲突。
– **实体对齐**:UserEntity/LostItemEntity/ClaimRecordEntity 与 V4 列一一对应(可空 Long),prod 的 ddl-auto: validate 不会启动失败。
– **密码与令牌**:PasswordUtil(PBKDF2 加盐)、TokenService(HMAC Bearer Token)。
– **认证接口**:AuthController 提供 /api/auth/login|register|me。
– **权限隔离**:AuthInterceptor + @RequireRole 已在 CorsConfig 注册;/api/lost-found/claims/audit 标注 @RequireRole(ROLE_ADMIN);GlobalExceptionHandler 映射 401/403。
– **前端**:App.vue 内 Header 状态栏、登录/注册 Tab 弹窗、审核中心 isAdmin 权限控制均已实现;api/client.ts 已做 token 存取与 401 清理。
– **测试**:AuthFlowTest 已覆盖 401/403/管理员审核/userId 绑定。
## 实施步骤
Task 1. 新增 V3→V4 迁移兼容性验收测试(V3ToV4MigrationTest.java,参照现有 V1ToV2MigrationTest 风格)
Task 2.(可选)清理退役文件
Task 3.(可选)重建前端产物
这份文档里有一点值得单独说:它判断本次增量已经在代码库里实现了,唯一缺的是一条针对“V3 → V4 迁移兼容”的自动化测试。 它没有为了显得“干了很多活”去重写一遍已经正确的代码,而是把力气放在真正的验收缺口上。二次开发最怕的恰恰是“为了改而改”,这个判断很对我的胃口。
看过方案文档,确认设计符合生产预期之后,我在对话框里回了一句:“按照规划文档执行”。
接下来输入框左下角的状态切到了 「智能体(计划模式)」,它开始按方案里的 Task 逐条执行:读 V1~V4 四个迁移脚本和 pom.xml 摸清迁移链,读三个实体类确认 setter 形态,落盘那条新的迁移兼容测试,收尾把 Task 2、Task 3 这两个可选项也一并做掉;图 3 顶部的任务清单里能看到“清理退役文件并登记”和“重建前端产物 pnpm build”,这正好对上了仓库里后来出现的 RETIRED_SOURCES.md 退役登记和重新构建过的 frontend/dist。
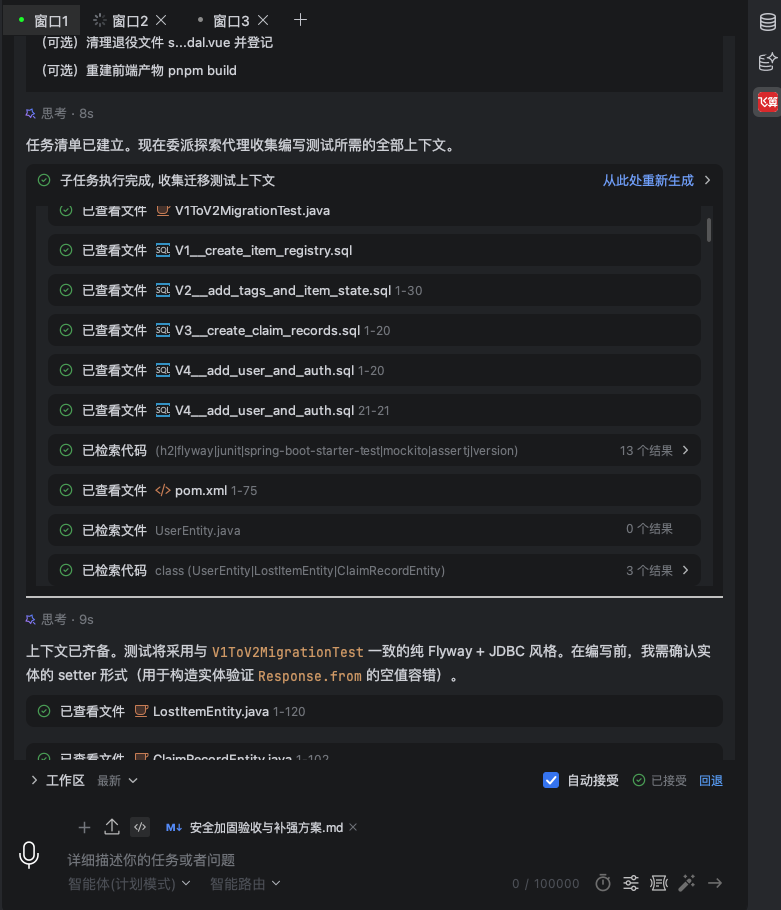
📷 图 3:计划模式下按子任务清单推进
💡 “先出方案 → 人工确认 → 再按计划落地”这条链路,解决的是 AI 编程里最让人不放心的一环:指令一发就闷头改文件,改出问题找不到源头。有方案文档在,改动范围和风险点是可核对的,有点像动工前先把水电图钉在墙上。
四、第三步:这轮增量到底有没有联调?
先把传统二次开发最容易翻车的三种情况列出来,这是我以前真实踩过的:
- 后端给接口加了鉴权,前端发请求忘了带 Authorization: Bearer <token>,接口全 401;
- 后端改了用户实体的返回字段,前端登录后取不到用户名,界面空白;
- 前端发了审核请求,后端 403 越权,前端却没有处理错误提示。
这次代码跑起来之后,这几类问题一个都没出现。登录、拿 Token、回显身份、提交认领、管理员审核,整条链路是直接通的。
为什么能省掉联调这一环
原因说出来其实不神秘,是“前后端由同一份契约派生”这件事带来的:
1)后端 DTO 和前端类型来自同一个设计结论。 后端的登录响应长这样:
// dto/LoginResponse.java
public class LoginResponse {
private String token;
private UserDto user;
// 构造与 getter/setter 省略
}
前端对应的类型定义在 Pinia store 里:
// stores/user.ts
export interface LoginResult {
token: string
user: User
}
字段名逐字对齐,没有驼峰分歧。补一句实话:后端所有接口外面还套了一层统一信封 Result<T>{code, message, data, timestamp},前端在 api/client.ts 的 request() 里统一解包——这也是一起生成的,所以两边对“数据在哪一层”的认知是一致的。
2)鉴权请求头在客户端封装里就写好了。 生成的 Axios 实例带着请求拦截器,业务代码不用关心 Token:
// api/client.ts
client.interceptors.request.use((config) => {
const token = getToken()
if (token) {
config.headers.Authorization = `Bearer ${token}`
}
return config
})
3)老接口的字段契约没有动。 历史接口的请求体结构保持不变,服务端只是从 UserContext 里取出当前登录人,自动补上登记人或认领人 ID,老前端不需要重写请求结构。
⚠️ 有一点我要主动交代清楚:字段契约没变,但访问门槛变了。 登记物品、提交认领、查看我的工单这几个接口,现在都带上了 @RequireRole,未登录请求一律 401——这是权限收敛的应有结果,但确实改变了老接口的可用范围,不能算“零影响”。AuthFlowTest 里专门有一条用例就是断言这件事的。
五、第四步:这套 AI 写的前端,我一个 Java 后端能改吗?
这一段是我最不放心的。嗯,怎么说呢,在别人(或 AI)写好的 Vue 3 页面里“缝”新组件,我以前就在这上面吃过亏。这次我把改动过的 App.vue 和新增的 store 通读了一遍,结论比预期好。
状态没有被搅在一起。 认证相关状态全部由 Pinia store 统一管理,页面只做消费:
// stores/user.ts
export const useUserStore = defineStore('user', {
state: () => ({ currentUser: null as User | null, token: getToken() }),
getters: {
isLoggedIn: (state) => state.currentUser !== null,
isAdmin: (state) => state.currentUser?.role === 'ROLE_ADMIN'
}
// …
})
// App.vue
const userStore = useUserStore()
const { currentUser, isAdmin } = storeToRefs(userStore)
const showAuthModal = ref(false)
const authMode = ref<'login' | 'register'>('login')
物品列表、筛选、登记表单这些原有逻辑一行没改。这就是这次“免学前端”最实在的部分:我要维护的不是整块前端工程,而是几个职责清晰的状态和模板片段。
权限判断写在 getter 里,界面只做展示。 审核按钮不是靠人肉判断“现在登录的是谁”:
<template v-if="isAdmin && claim.status === 'SUBMITTED'">
<button class="primary compact" @click="auditClaim(claim, 'APPROVE')">通过</button>
<button class="secondary compact" @click="auditClaim(claim, 'REJECT')">驳回</button>
</template>
前端隐藏 + 后端 @RequireRole(ROLE_ADMIN) 403 兜底,是两道防线。
样式是手写 CSS,没背组件库的包袱。 弹窗、Tab、角色徽章都用原生 CSS Flexbox 写的。不过得补一句:package.json 里还挂着 element-plus、vue-router 这些没被引用到的依赖,src/views、src/components 下也有几个和当前后端契约对不上的旧组件——工程卫生问题,第九节的不足里一起列。
界面实际交付成了什么样
在这套代码基础上,我把视觉风格定成了“晨曦暖晖·白瓷琉璃(Aurora Sunrise Luxe)”,和前面几套项目的深色风格区分开。用 pnpm dev 起前端(http://localhost:5178),访客态长这样:
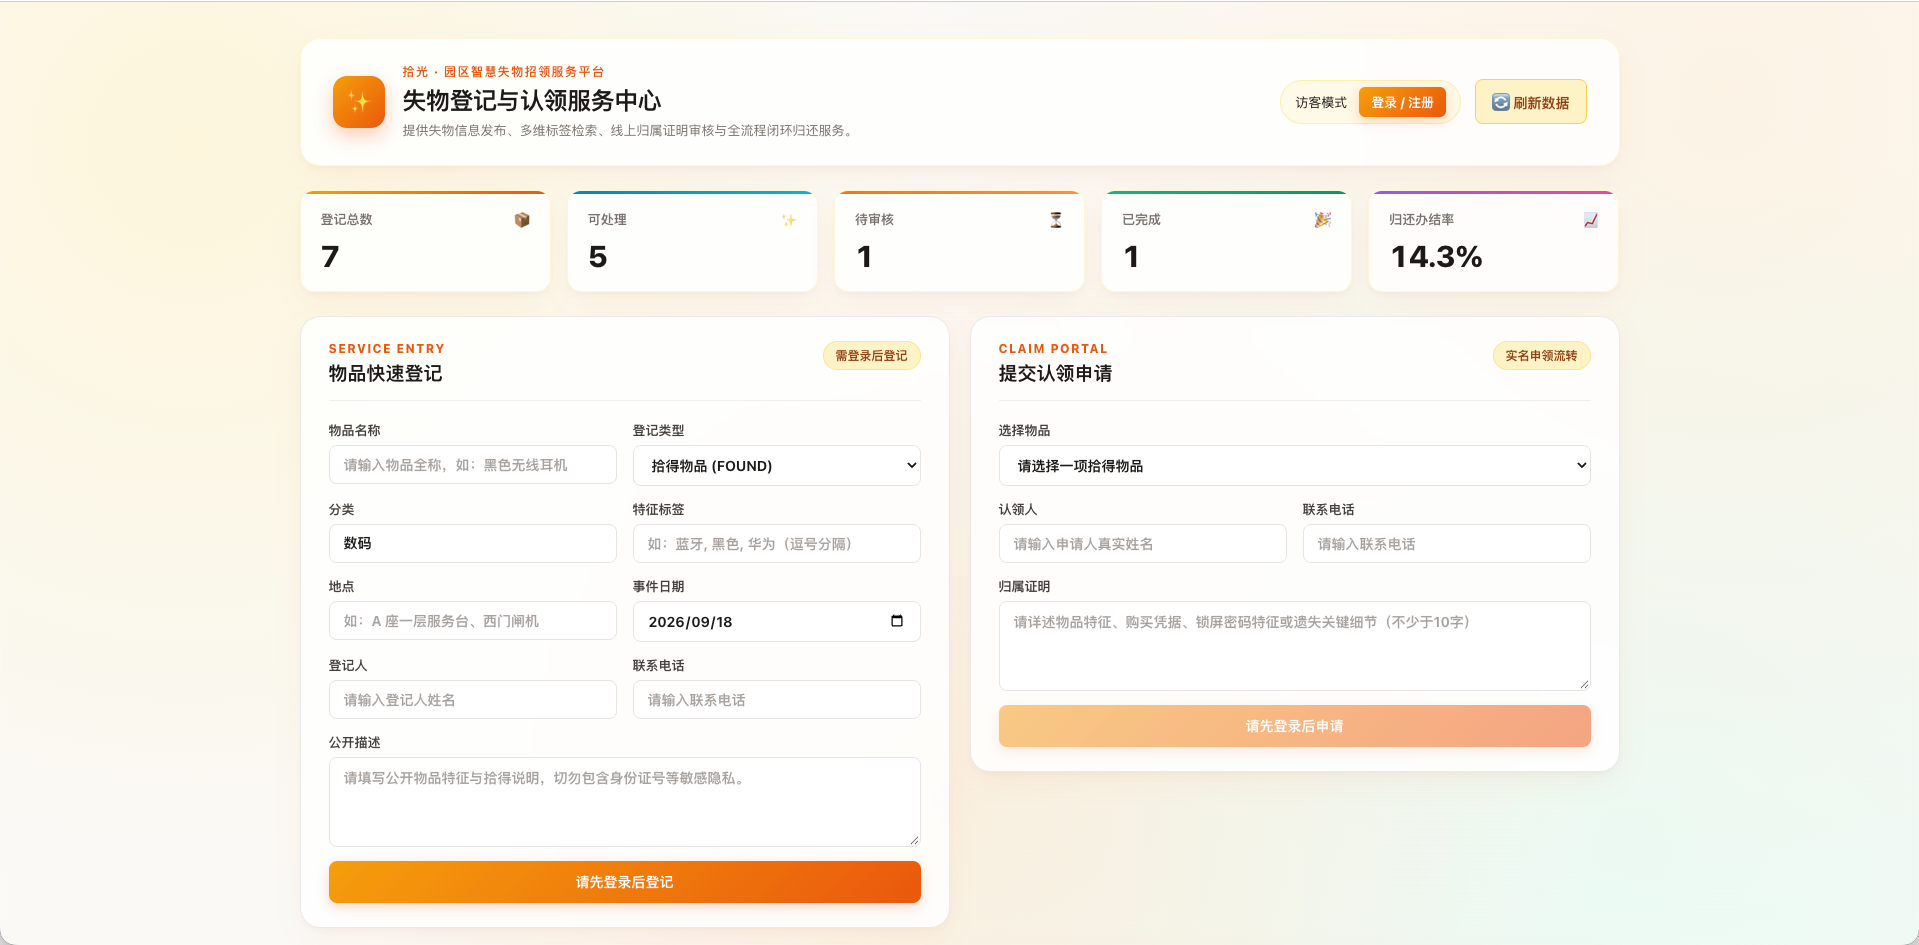
📷 图 4:首页(访客态)
顶部服务栏右侧是「访客模式」标识、橙色【登录 / 注册】按钮和一个【🔄 刷新数据】按钮;往下是五张指标卡:
| 登记总数 | 7 | 物品表里的全部记录 |
| 可处理 | 5 | OPEN 状态 |
| 待审核 | 1 | CLAIMING,有一笔认领申请在等审核 |
| 已完成 | 1 | RESOLVED,已办结归还 |
| 归还办结率 | 14.3% | resolved / total 实时算出(1/7) |
顺带说一个我自己修掉的小坑:办结率在后端是 Math.round(resolved * 1000.0 / total) / 10.0 算出来的,空库时返回 null;而全局 Jackson 配了 default-property-inclusion: non_null,这个字段压根不会出现在 JSON 里,前端直接拼字符串就会出现刺眼的 undefined%。现在的处理是:
<strong>{{ (stats.resolutionRate == null) ? '—' : stats.resolutionRate + '%' }}</strong>
数据方面,库里是 7 条园区样例工单:6 条拾得物品 + 1 条遗失登记,分类覆盖数码配件、智能穿戴、生活用品、箱包装备、办公外设和证件门禁,Apple 编织充电线、华为手环、膳魔师保温杯、ThinkPad 无线鼠标、园区一卡通工牌都在里面。这些是我为验收和演示写的样例数据,不是真实业主的物品信息,第六节和“不足”里还会交代它的使用边界。
访客态下,两个表单的提交按钮分别显示成“请先登录后登记”和“请先登录后申请”(图 4 底部能看到),点一下会直接弹出登录窗:
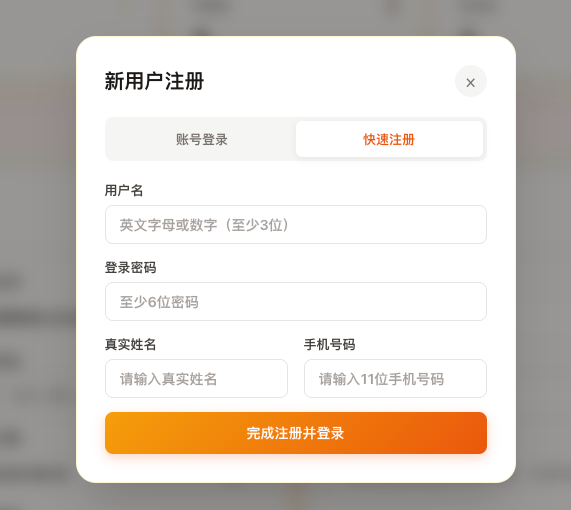
📷 图 5:登录/注册弹窗
图 5 截的是切到「快速注册」标签页的样子,弹窗标题是“新用户注册”,左边还留着「账号登录」Tab。四个字段都带前端校验,手机号有 pattern 正则,提交按钮在请求期间会置灰防重复提交。
双角色的权限受控,一张静态截图很难同时体现两种身份,用表格说清楚:
| 普通用户 | 青蓝色「认证用户」实名徽章 | 只读:操作按钮被 v-if="isAdmin" 隐藏,只剩状态标签 |
| 管理员 | 金色「系统管理员」徽章 | 【通过】【驳回】亮起;点通过后“待审核”减 1、“已完成”加 1、办结率重算 |
这套行为由前端 isAdmin 与后端 403 双重保证,不是靠改按钮文案实现的。
六、第五步:旧数据平滑升到 V4,和最后那段只能人工做的活
飞算 JavaAI 把增量代码、方案文档和迁移兼容测试给我铺好了,那么剩下最关键的一段就需要我自己来接:存量数据的兼容性断言,还有生产交付物。 这段做完,项目才算真正能交出去。我一共做了四件事。
1. 用增量迁移脚本,而不是重建表
二次开发最忌讳推倒重来。V4 没有改 V1~V3 的任何一行,而是新增一个迁移脚本:
CREATE TABLE sys_user (
id BIGINT AUTO_INCREMENT PRIMARY KEY,
username VARCHAR(64) NOT NULL,
password_hash VARCHAR(128) NOT NULL,
real_name VARCHAR(64) NOT NULL,
phone VARCHAR(32) NOT NULL,
role VARCHAR(16) NOT NULL DEFAULT 'ROLE_USER',
created_at DATETIME NOT NULL,
updated_at DATETIME NOT NULL,
version BIGINT NOT NULL DEFAULT 0,
CONSTRAINT uk_sys_user_username UNIQUE (username)
);
CREATE INDEX idx_sys_user_role ON sys_user (role);
— 为既有历史表增量增加可空外键,不触碰任何已有列
ALTER TABLE lost_item ADD COLUMN user_id BIGINT;
ALTER TABLE claim_record ADD COLUMN user_id BIGINT;
ALTER TABLE claim_record ADD COLUMN auditor_id BIGINT;
CREATE INDEX idx_lost_item_user_id ON lost_item (user_id);
CREATE INDEX idx_claim_record_user_id ON claim_record (user_id);
关键在于三个外键列都是可空的:历史台账的 user_id 是 NULL,因为 V1/V2 时期根本没有账号体系;V2 新增的 status 用 NOT NULL DEFAULT 'OPEN' 给旧行补了默认值;tags 也是可空。旧记录的编号、名称、分类一个都没动,查询不受影响。
2. 密码和令牌按生产标准来
- 密码存储:PasswordUtil 用 JDK 内置的 PBKDF2WithHmacSHA256,10000 次迭代、16 字节随机盐、256 位密钥,库里存 salt:hash,比对用等长异或比较,不走 equals;
- 令牌:TokenService 用 HmacSHA256 签发无状态 Bearer Token,签名密钥通过环境变量注入;
- 越权拦截:审核接口挂权限注解,由拦截器统一判定:
@Operation(summary = "审核待处理认领申请(仅限园区管理员)")
@RequireRole(UserRole.ROLE_ADMIN)
@PostMapping("/claims/audit")
public Result<ClaimResponse> auditClaim(@Valid @RequestBody ClaimAuditDto dto) {
return Result.success(ClaimResponse.from(service.auditClaim(dto)));
}
3. 清掉失效脚本,换成一套可复现的样例数据
两件事。先把没用的清掉:db/schema.sql、db/data.sql(建表职责早就交给 Flyway,留着只会双份 schema 漂移)和 Navbar.vue、RegisterModal.vue 两个无引用的占位组件,删完在 RETIRED_SOURCES.md 里登记退役记录。
然后处理数据。AI 首版生成的工程里带着 DEMO-LF-00000001 这类明显是假的记录,我清掉之后写了一个 DataBootstrapInitializer:只在物品表为空时注入 7 条园区样例工单(5 条 OPEN、1 条 CLAIMING、1 条 RESOLVED)和 2 条认领工单(1 条待审核、1 条已办结),让看板和审核中心能真实地跑起来。
⚠️ 有一句必须写进“不足”里的实话:这个播种器目前挂在 @Profile("!test") 上,prod profile 下也会生效。 如果哪天生产库恰好是空的,它会往里塞这 7 条样例工单。上线之前,这个开关一定要收紧成显式配置。我不想把这件事藏在“已彻底去演示化”这种说法后面。
4. 补齐生产交付物
- backend/Dockerfile:eclipse-temurin:17-jre-alpine,非 root 用户运行,HEALTHCHECK 打 /actuator/health;
- frontend/Dockerfile + nginx.conf:Gzip 压缩、静态资源 1 年强缓存、/api/ 反向代理到后端;
- docker-compose.yml:MySQL 8.0(带健康检查与数据卷)+ 后端 + 前端 Nginx 一键编排;
- build-release.sh:一条命令走完前端构建、后端打包和产物校验。
七、关于「7 天 vs 1 天」,我把能核实的和不能核实的分开说
先说不能核实的:我没有做两条独立代码线的对照计时。 官方那组数据(传统 7 天 = 前端 3 + 后端 2 + 联调 2,飞算 1 天)出处是官方,不是我测的;我这边只有一条 V1→V4 的增量线,也没有逐环节的原始计时记录。所以我不会给出“省了 X 小时”“提效 X%”,也不会把两侧数字拼成一张“实测对比表”——那样写出来的数字看着漂亮,但核不了。
我能确认的是各个环节的处理方式变了,这才是省下时间的真正原因:
| 需求与设计 | 前后端反复沟通加哪些按钮/弹窗,来回改原型 | 701 字结构化需求 → 插件先出方案文档,我确认后再动手 | 设计决策在写代码之前就落成文档,改动范围可核对 |
| 表结构与后端接口 | 手工改表、加认证接口、加拦截器、改 DTO | Flyway V4 增量脚本 + 权限注解 + 拦截器,一次成型 | 增量是“加脚本”,不重建表,历史数据不迁移 |
| 前端弹窗与受控逻辑 | 前端同事手写弹窗、配 Token、改组件受控状态 | 同一次生成里产出 Pinia store 与 App.vue 增量 | 前后端契约来自同一份设计结论 |
| 二次联调 | 抓包对字段、排查 401 和驼峰错配 | 这一环在本次迭代中没有出现 | 前后端由同一份契约派生,字段天然对齐 |
| 旧数据兼容与生产加固 | 手工写迁移脚本、调连接池与容器 | 还是要人做(第六节那四件事就是我自己做的) | AI 给的是骨架,兼容性断言和发布口径得架构师拍板 |
💡 这轮做下来,我一开始以为省的是敲键盘的时间,复盘完发现不是这么回事:真正省掉的,是两边对齐的时间。 联调环节之所以能从流程里消失,说白了,不是工具帮你把 bug 改掉了,而是前后端压根没产生分歧的机会。
八、质量验证:12 个自动化用例,一次通过
改得快、测试过不了等于白搭。二次迭代最核心的验证只有一条:老数据不能被破坏。
cd backend && mvn test
本次运行的摘要(5 个测试类,12 个用例,全绿):
[INFO] Running com.feisuan.findback.DataBootstrapInitializerTest
[INFO] Tests run: 1, Failures: 0, Errors: 0, Skipped: 0
[INFO] Running com.feisuan.findback.V3ToV4MigrationTest
[INFO] Tests run: 1, Failures: 0, Errors: 0, Skipped: 0
[INFO] Running com.feisuan.findback.V1ToV2MigrationTest
[INFO] Tests run: 1, Failures: 0, Errors: 0, Skipped: 0
[INFO] Running com.feisuan.findback.FindBackApplicationTests
[INFO] Tests run: 6, Failures: 0, Errors: 0, Skipped: 0
[INFO] Running com.feisuan.findback.AuthFlowTest
[INFO] Tests run: 3, Failures: 0, Errors: 0, Skipped: 0
[INFO] Tests run: 12, Failures: 0, Errors: 0, Skipped: 0
[INFO] BUILD SUCCESS
这 12 条用例覆盖四类风险:
| V1ToV2MigrationTest | 1 | 只执行 V1 → 插入旧行 → 全量升级;断言旧行编号保留、tags=NULL、status=OPEN、user_id 为空,外键与 sys_user 就位 |
| V3ToV4MigrationTest | 1 | 方案文档补的那条:V3 存量认领记录升到 V4 之后的空值安全 |
| FindBackApplicationTests | 6 | 状态机流转、重复审核被拒、并发认领只留一条待审工单、公开响应不含联系人与证明材料 |
| AuthFlowTest | 3 | 加盐密文不含明文且可比对、未登录 401、普通用户审核 403 而管理员审核落库 auditorId |
| DataBootstrapInitializerTest | 1 | 样例数据 7 条物品 / 2 条工单、状态分布 5/1/1、看板统计口径吻合 |
打包和交付物也一起过了一遍:./build-release.sh 产出 frontend/dist 和 shiguang-1.0.0.jar(约 57 MB)。编排文件齐了之后,docker compose up -d –build 就能把 MySQL、后端和 Nginx 前端一起拉起来(这一步本次没有实际执行)。
ℹ️ 一点说明:容器编排文件我都写完并逐项核对过了,但这次没有实际执行 docker compose up,也没有部署到真实服务器,所以这篇文章里不会出现“已生产上线”这种说法。
九、「三真实」客观评价:优点、不足与建议
按约稿要求里“真实操作、真实数据、真实评价”的原则,这一节不吹不黑。
👍 核心优点
⚠️ 现阶段不足
💡 生产落地建议
- 把飞算 JavaAI 当作“交付推进器”,而不是“责任人”:它负责把页面交互、状态响应、接口对齐这些胶水代码一次性铺好;架构师负责的仍然是领域逻辑、数据兼容性、权限收敛和发布口径。
- 把方案文档当成 review 清单用:它列出的“已实现项”和“注意事项”,正好是一份现成的验收要点,我就是照着它去核对实体与 V4 列的对齐关系。
- 老系统改造,先要迁移兼容测试,再谈别的:新增一条测试覆盖“旧行升级后字段的默认值”,比多写十个 CRUD 接口更有价值。
十、总结:2026 年,Java 后端还要不要学前端?
经过这轮“老系统二次迭代”的实测,我的答案很明确:在 2026 年,Java 后端不用再把大量时间花在死记前端框架语法、打包配置和 CSS 属性上了。
“全栈”的定义正在被改写。过去的全栈,要求你既懂 Spring 源码,又懂 Webpack 和 Vue 渲染底层,门槛高、精力分散;今天更实用的全栈能力,是理解业务意图、掌握数据契约、能守住生产级工程底线——前端的代码实现和接口对齐,可以交给飞算 JavaAI 这类一体化工具去抹平。
但这不等于后端可以不懂工程。恰恰相反:这次真正卡住我的地方,不是写不出登录弹窗,而是怎么让一套跑到 V3 的老库安全地升到 V4、怎么在生产环境收紧默认口令和演示闸门。这些判断,工具替不了你。
如果你也正在被“老系统改不动、前后端联调扯皮”折磨,不妨打开 IDEA 装上插件,拿手上那套最不想动的小系统试一次二次迭代——比在空项目里生成 Demo 有用得多。
发布标签:#飞算JavaAI #AI编程 #Java #全栈开发 #前后端分离 #后端开发 #前端开发 #IDEA插件 #程序员 #IDEA开发 #Java开发 #SpringBoot #程序员必备