✨作者主页:IT研究室✨ 个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。 ☑文末获取源码☑ 精彩专栏推荐⬇⬇⬇ Java项目 Python项目 安卓项目 微信小程序项目
文章目录
- 一、前言
- 二、开发环境
- 三、系统界面展示
- 四、代码参考
- 五、系统视频
- 结语
一、前言
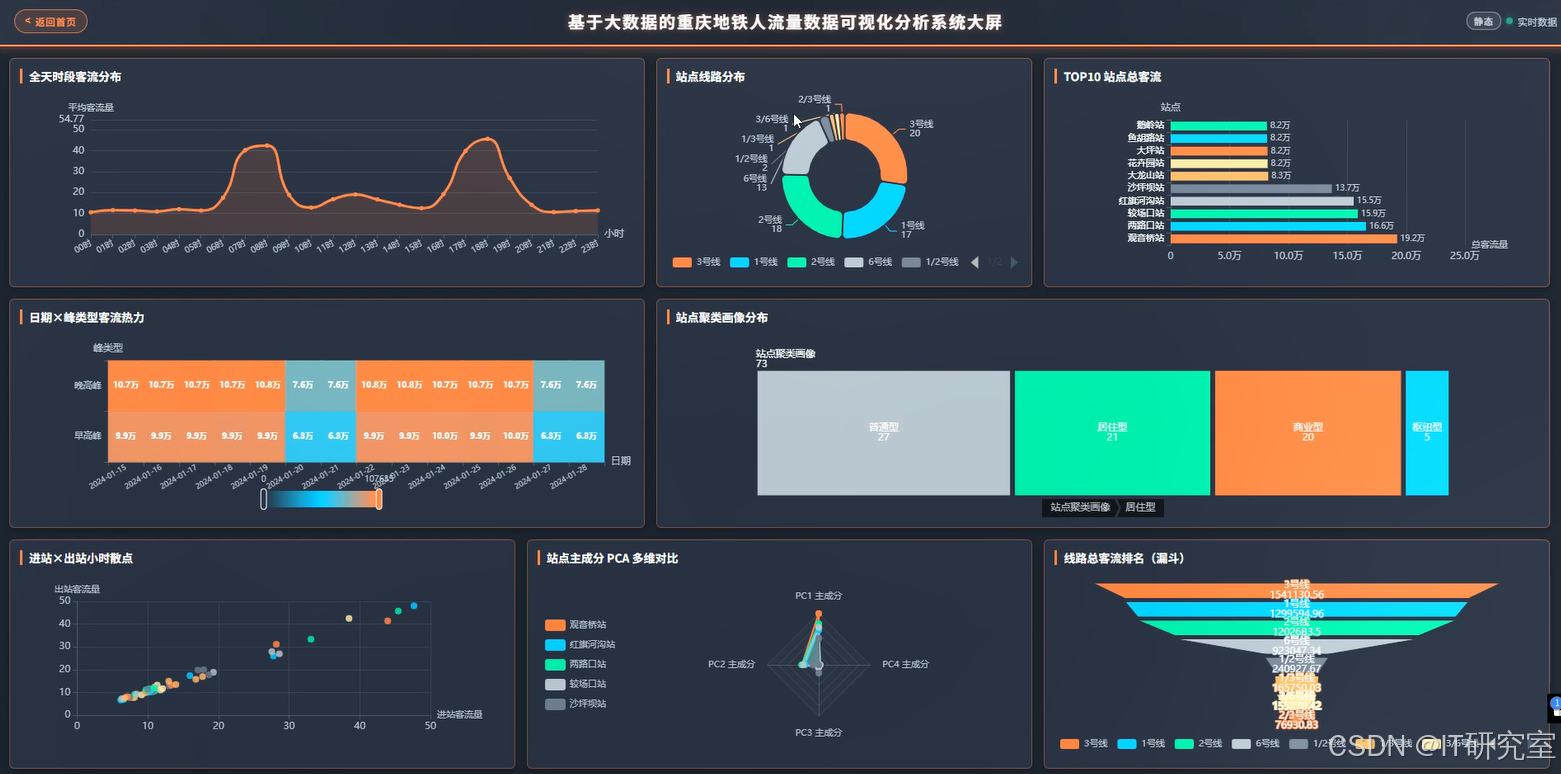
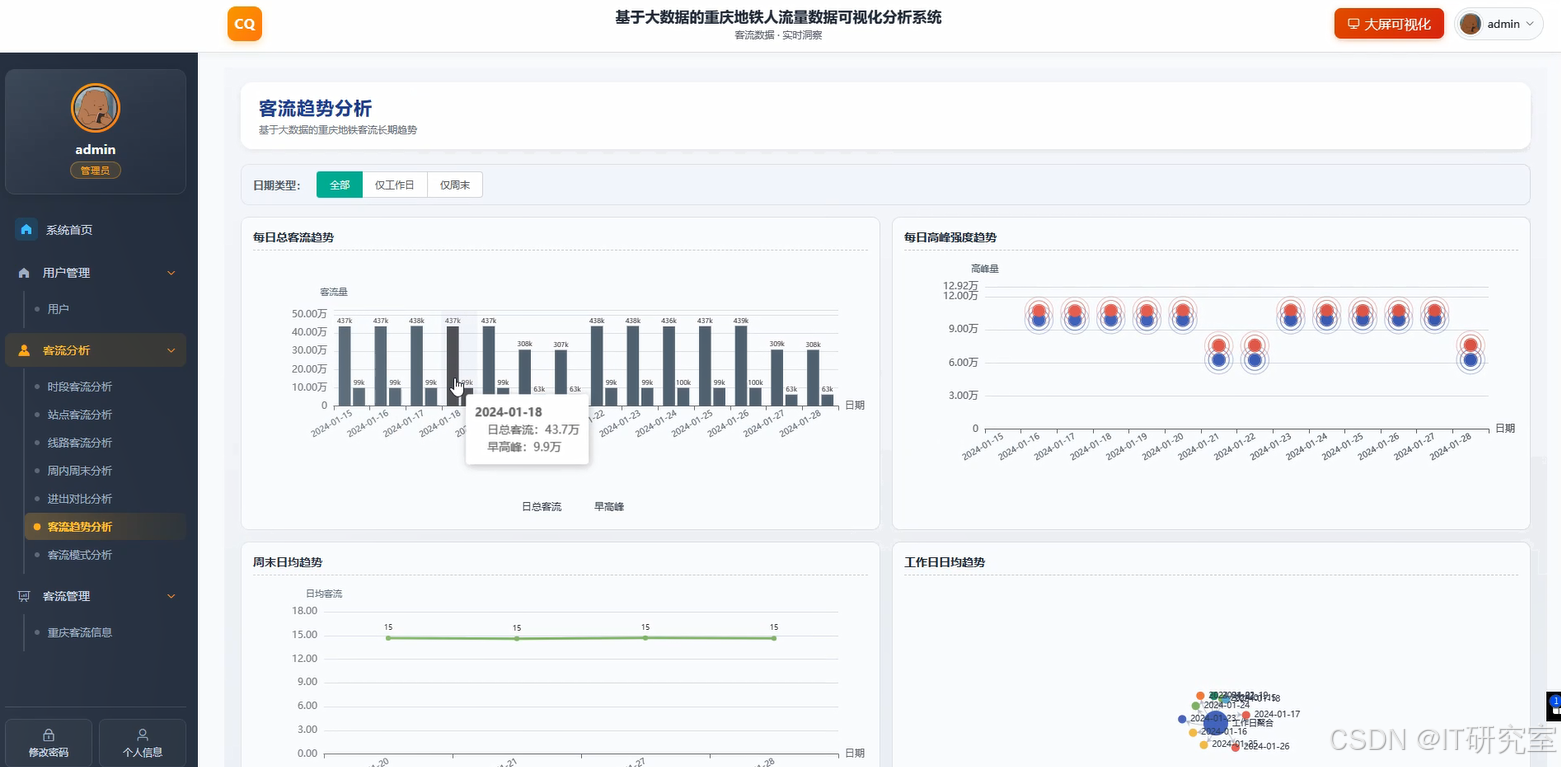
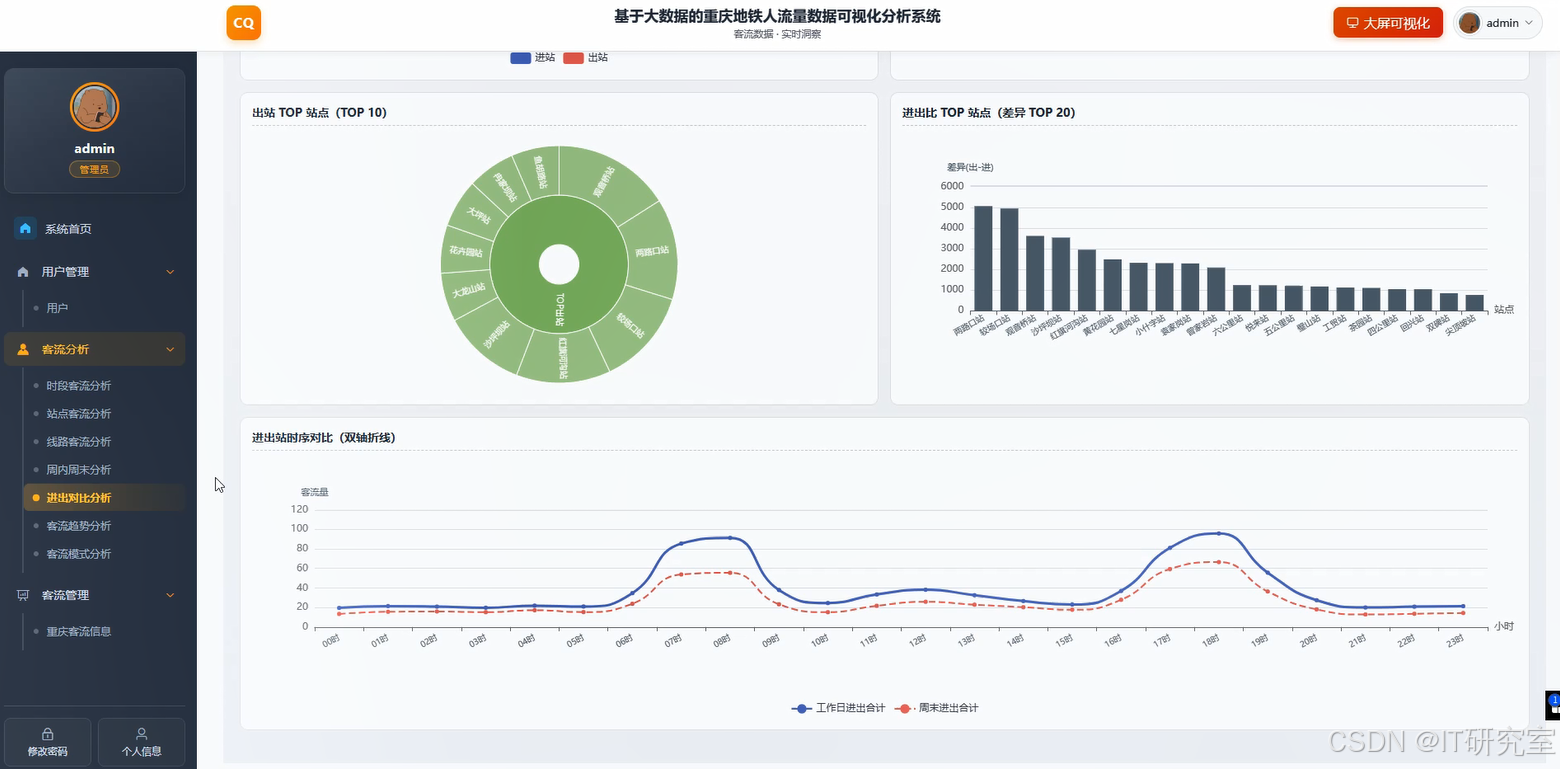
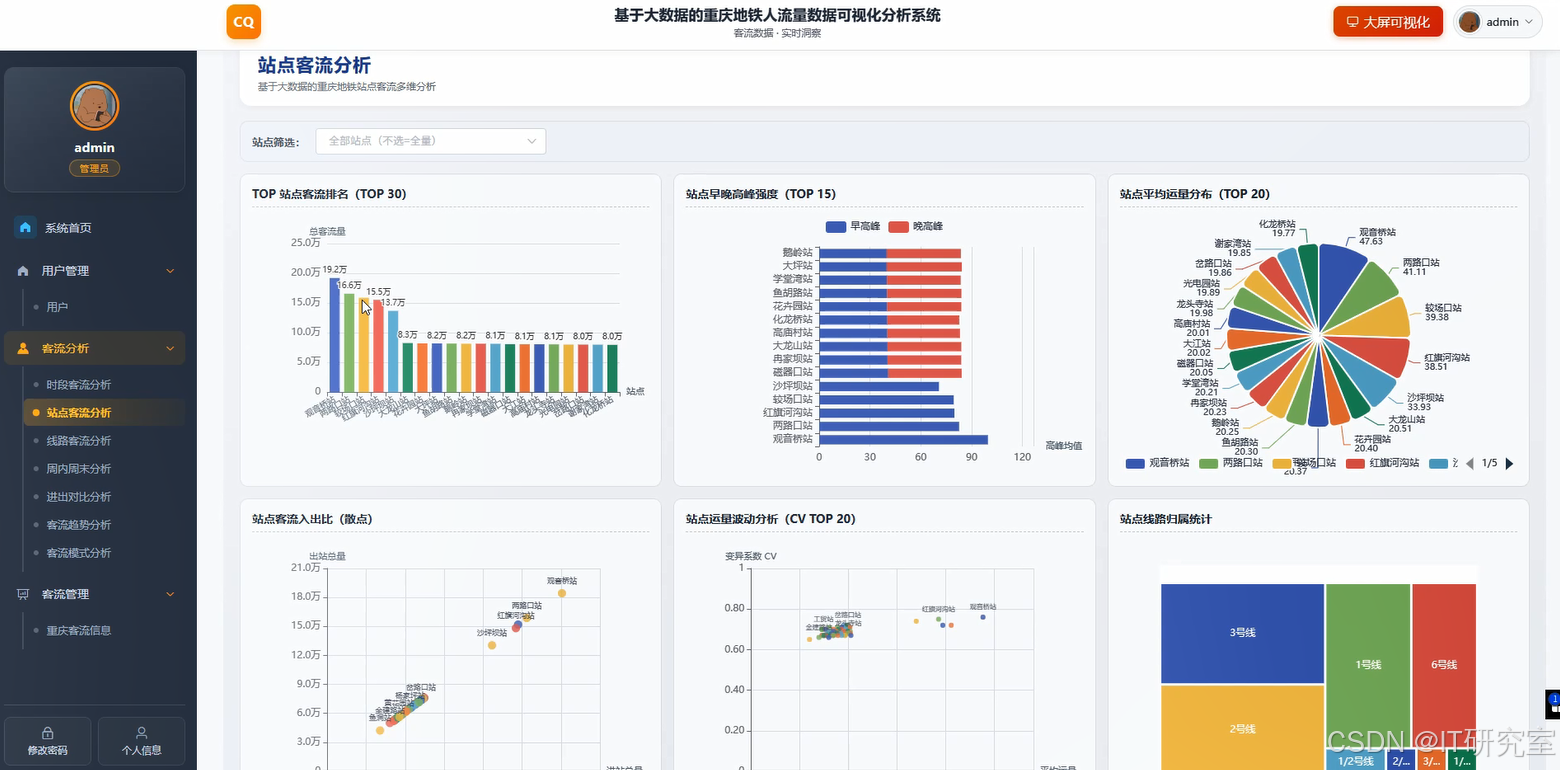
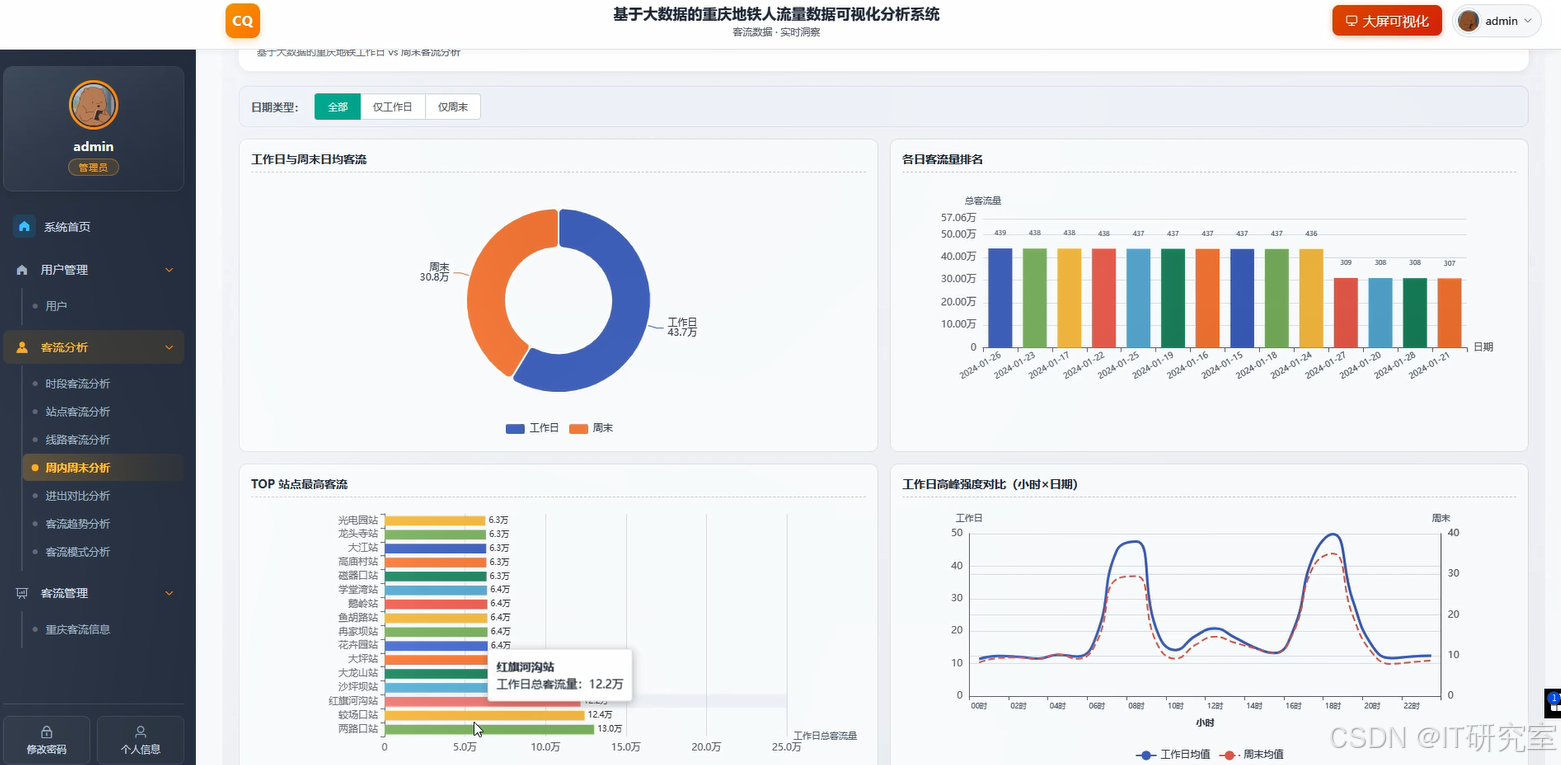
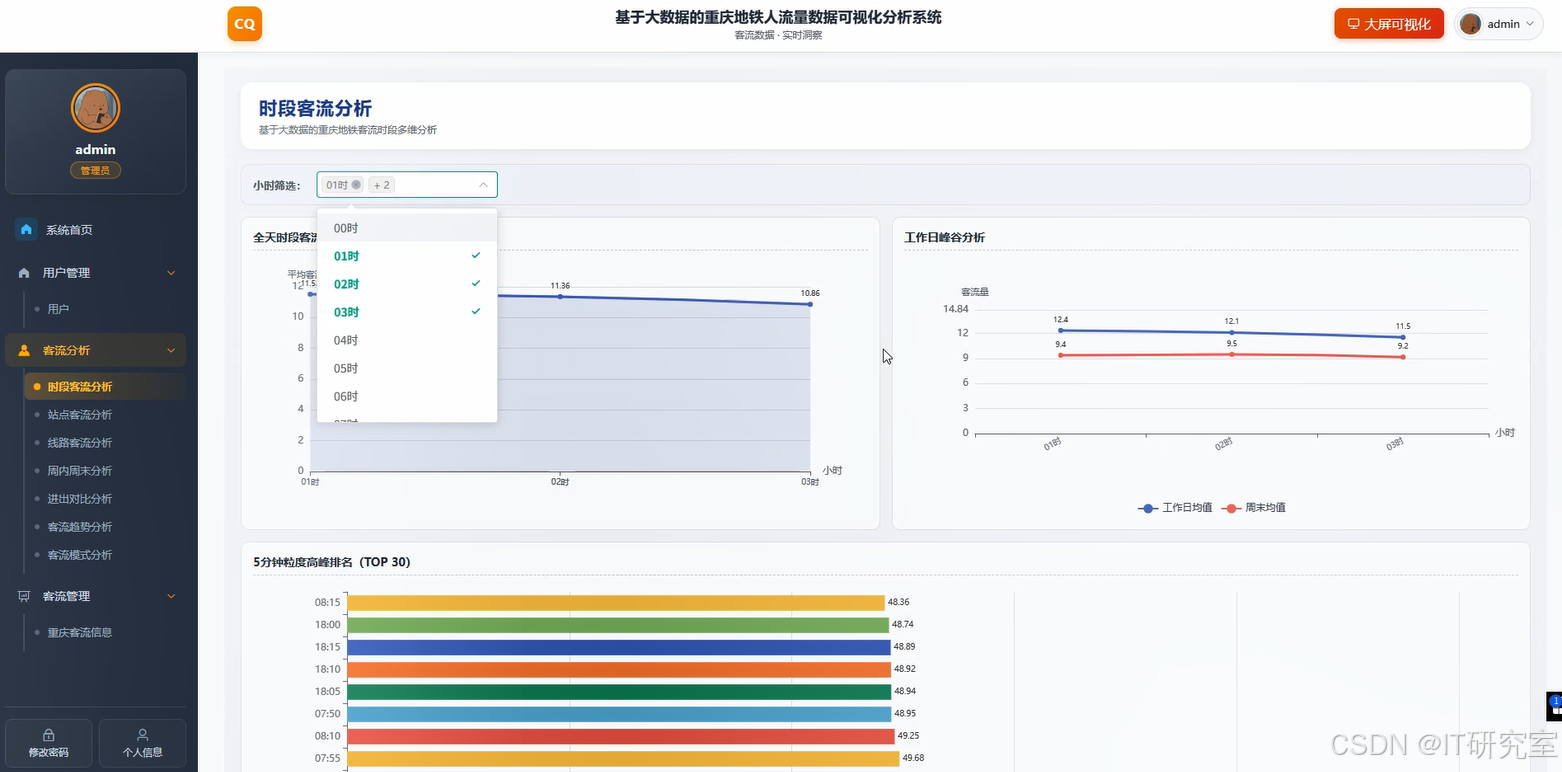
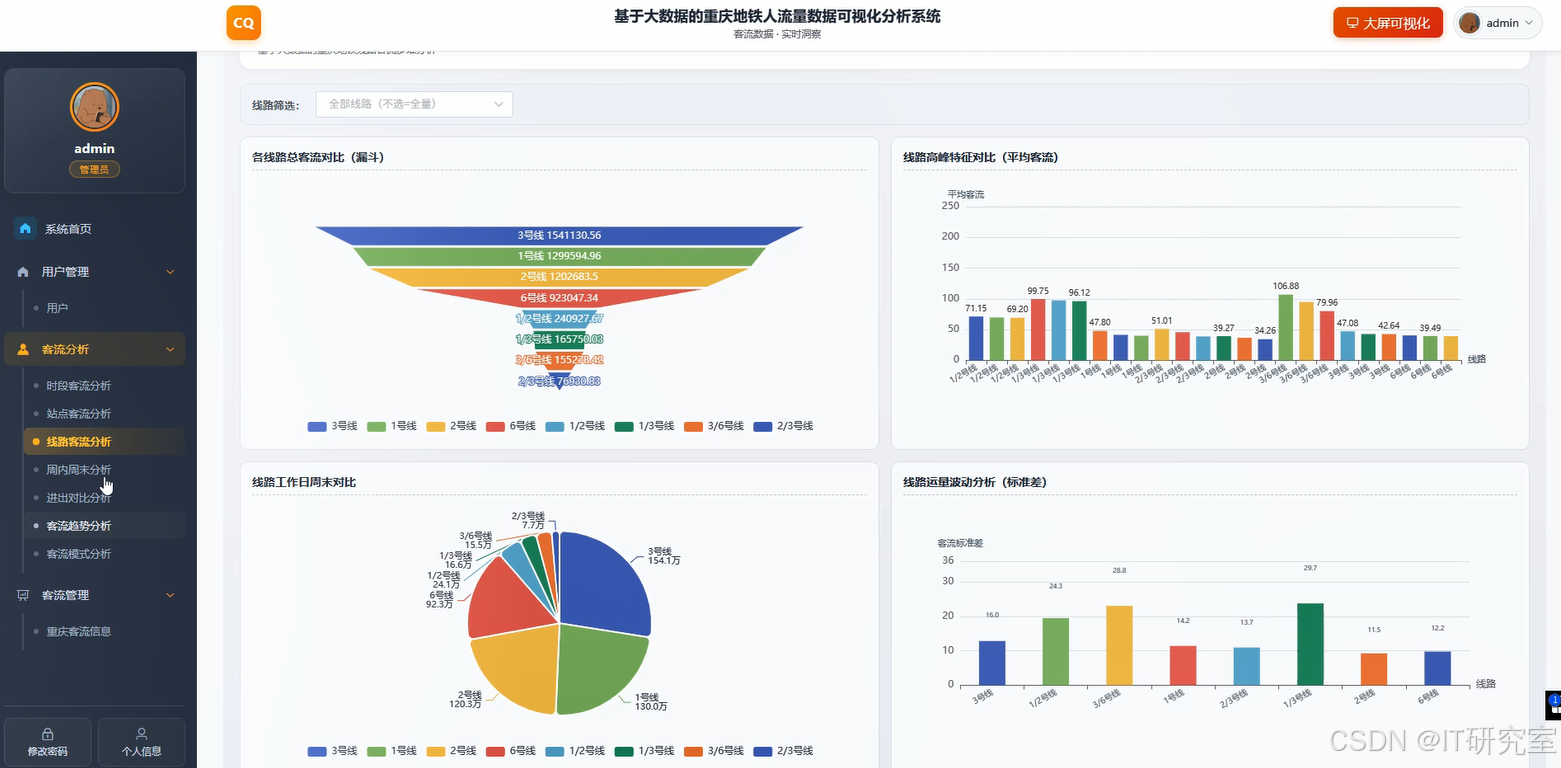
系统介绍 本系统名为《基于大数据的重庆地铁人流量数据可视化分析系统》,围绕重庆地铁客流数据的采集、存储、计算与可视化展示展开,技术栈采用Hadoop与Spark作为大数据处理核心,配合HDFS完成数据存储,使用Spark SQL与Pandas、NumPy进行客流数据的清洗、统计与模式挖掘,后端可选Python+Django或Java+Spring Boot两种版本实现业务接口,前端采用Vue、ElementUI、Echarts、HTML、CSS、JavaScript与jQuery完成页面交互与图表渲染,数据库使用MySQL保存用户信息与客流分析结果。系统功能涵盖系统首页、用户管理、客流分析、时段客流分析、站点客流分析、线路客流分析、周内周末分析、进出对比分析、客流趋势分析、客流模式分析、流管理与重庆客流信息等模块,能够从时间、站点、线路、工作日与周末等多个维度对重庆地铁人流量数据进行统计分析与可视化呈现,帮助使用者直观了解重庆地铁客流的分布特征与变化规律。
选题背景 重庆作为山城,地形起伏大、组团分布明显,地铁逐渐成为市民日常出行的主要方式之一。随着线路不断延伸和客流量持续增长,重庆地铁在早晚高峰、节假日以及热门站点周边容易形成明显的客流聚集,这对运营管理提出了更高要求。传统方式下,客流数据多以报表或简单统计形式呈现,难以直观反映不同时段、不同站点和不同线路之间的客流差异,也不容易发现隐藏在数据中的出行规律。与此同时,计算机专业毕业设计越来越强调数据处理的完整性与技术应用的合理性,Hadoop与Spark等大数据框架为海量客流数据的存储与计算提供了可行路径,Echarts等可视化工具也让分析结果更易理解。在这样的背景下,把重庆地铁人流量数据与大数据处理、可视化分析结合起来,形成一个结构清晰、功能明确的毕业设计课题,既贴合实际数据场景,也符合当前计算机专业毕设的技术方向。
选题意义 从实际意义来看,这个课题虽然只是一个毕业设计,但能把课堂上学到的Hadoop、Spark、Spark SQL以及Django或Spring Boot等内容串起来,完成从数据存储、数据清洗、统计分析到图表展示的完整流程,对个人来说是一次比较系统的工程练习。对于重庆地铁客流数据而言,系统可以按站点、线路、时段、周内周末等维度做统计,把进出站差异、客流趋势和客流模式用图表呈现出来,方便使用者快速了解客流变化情况,也能为后续类似的数据分析项目提供一个可参考的实现思路。从学习角度来说,借助Spark SQL和Pandas、NumPy处理客流数据,再通过Echarts完成可视化展示,可以加深对大数据处理流程和前后端协作方式的理解。整体上,这个课题不追求复杂功能,更注重把已有技术用清楚、把数据讲明白,算是一次踏实且有针对性的毕业设计实践。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
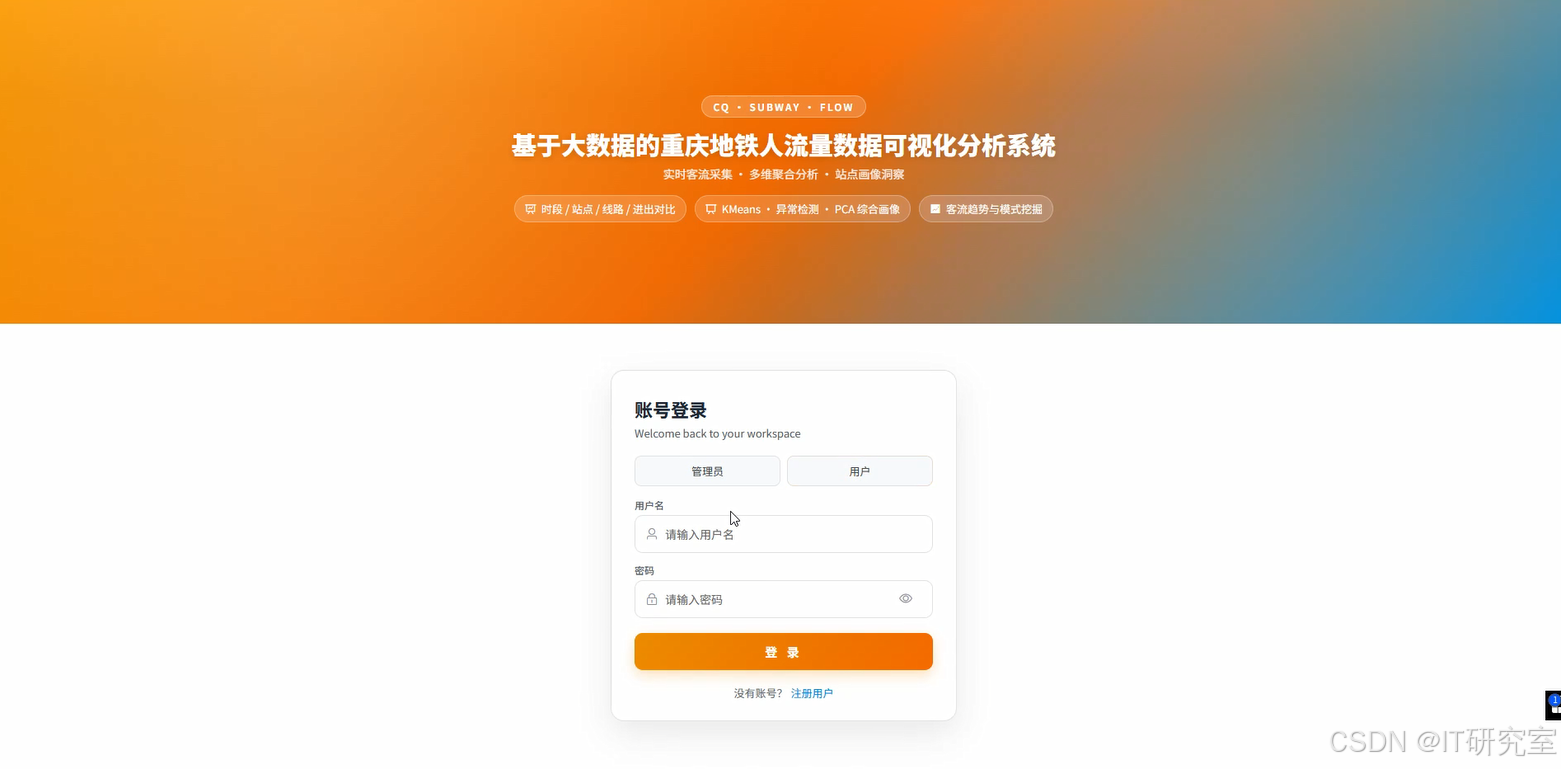
- 基于大数据的重庆地铁人流量数据可视化分析系统界面展示:
四、代码参考
- 项目实战代码参考:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, sum as _sum, avg, hour, dayofweek, when
from django.http import JsonResponse
from django.views.decorators.http import require_GET
from .models import MetroFlow, StationInfo, LineInfo
import pandas as pd
import numpy as np
spark = SparkSession.builder.appName("ChongqingMetroFlowAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
def load_flow_data():
flow_df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/metro_db").option("dbtable", "metro_flow").option("user", "root").option("password", "123456").load()
station_df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/metro_db").option("dbtable", "station_info").option("user", "root").option("password", "123456").load()
line_df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/metro_db").option("dbtable", "line_info").option("user", "root").option("password", "123456").load()
flow_df.createOrReplaceTempView("metro_flow")
station_df.createOrReplaceTempView("station_info")
line_df.createOrReplaceTempView("line_info")
return flow_df, station_df, line_df
@require_GET
def station_flow_analysis(request):
flow_df, station_df, line_df = load_flow_data()
station_flow = spark.sql("""
SELECT s.station_name, l.line_name, SUM(f.in_count) AS total_in, SUM(f.out_count) AS total_out
FROM metro_flow f
JOIN station_info s ON f.station_id = s.station_id
JOIN line_info l ON s.line_id = l.line_id
GROUP BY s.station_name, l.line_name
ORDER BY total_in DESC
""")
result = station_flow.toPandas()
result["total_flow"] = result["total_in"] + result["total_out"]
result["in_out_ratio"] = np.where(result["total_out"] == 0, 0, result["total_in"] / result["total_out"])
chart_data = {
"station_name": result["station_name"].tolist(),
"total_in": result["total_in"].astype(int).tolist(),
"total_out": result["total_out"].astype(int).tolist(),
"total_flow": result["total_flow"].astype(int).tolist()
}
return JsonResponse({"code": 200, "msg": "站点客流分析成功", "data": chart_data})
@require_GET
def time_period_flow_analysis(request):
flow_df, station_df, line_df = load_flow_data()
time_flow = spark.sql("""
SELECT HOUR(f.record_time) AS flow_hour, SUM(f.in_count) AS total_in, SUM(f.out_count) AS total_out
FROM metro_flow f
GROUP BY HOUR(f.record_time)
ORDER BY flow_hour
""")
result = time_flow.toPandas()
result["total_flow"] = result["total_in"] + result["total_out"]
result["peak_flag"] = np.where(result["total_flow"] > result["total_flow"].mean(), "高峰", "平峰")
hour_list = result["flow_hour"].astype(int).tolist()
flow_list = result["total_flow"].astype(int).tolist()
peak_list = result["peak_flag"].tolist()
chart_data = {"flow_hour": hour_list, "total_flow": flow_list, "peak_flag": peak_list}
return JsonResponse({"code": 200, "msg": "时段客流分析成功", "data": chart_data})
@require_GET
def week_weekend_analysis(request):
flow_df, station_df, line_df = load_flow_data()
week_flow = spark.sql("""
SELECT CASE WHEN DAYOFWEEK(f.record_time) IN (1, 7) THEN '周末' ELSE '周内' END AS day_type,
SUM(f.in_count) AS total_in, SUM(f.out_count) AS total_out
FROM metro_flow f
GROUP BY CASE WHEN DAYOFWEEK(f.record_time) IN (1, 7) THEN '周末' ELSE '周内' END
""")
result = week_flow.toPandas()
result["total_flow"] = result["total_in"] + result["total_out"]
result["avg_flow"] = result["total_flow"] / result["day_type"].map({"周内": 5, "周末": 2})
day_type_list = result["day_type"].tolist()
total_flow_list = result["total_flow"].astype(int).tolist()
avg_flow_list = result["avg_flow"].round(2).tolist()
chart_data = {"day_type": day_type_list, "total_flow": total_flow_list, "avg_flow": avg_flow_list}
return JsonResponse({"code": 200, "msg": "周内周末分析成功", "data": chart_data})
五、系统视频
基于大数据的重庆地铁人流量数据可视化分析系统项目视频: 演示视频
结语
最新大数据毕业设计选题推荐-基于大数据的重庆地铁人流量数据可视化分析系统-大数据-Spark-Hadoop-Bigdata 想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家! 有技术这一块问题大家可以评论区交流或者私我~ 大家可以帮忙点赞、收藏、关注、评论啦~ 源码获取:⬇⬇⬇
精彩专栏推荐⬇⬇⬇ Java项目 Python项目 安卓项目 微信小程序项目