回顾
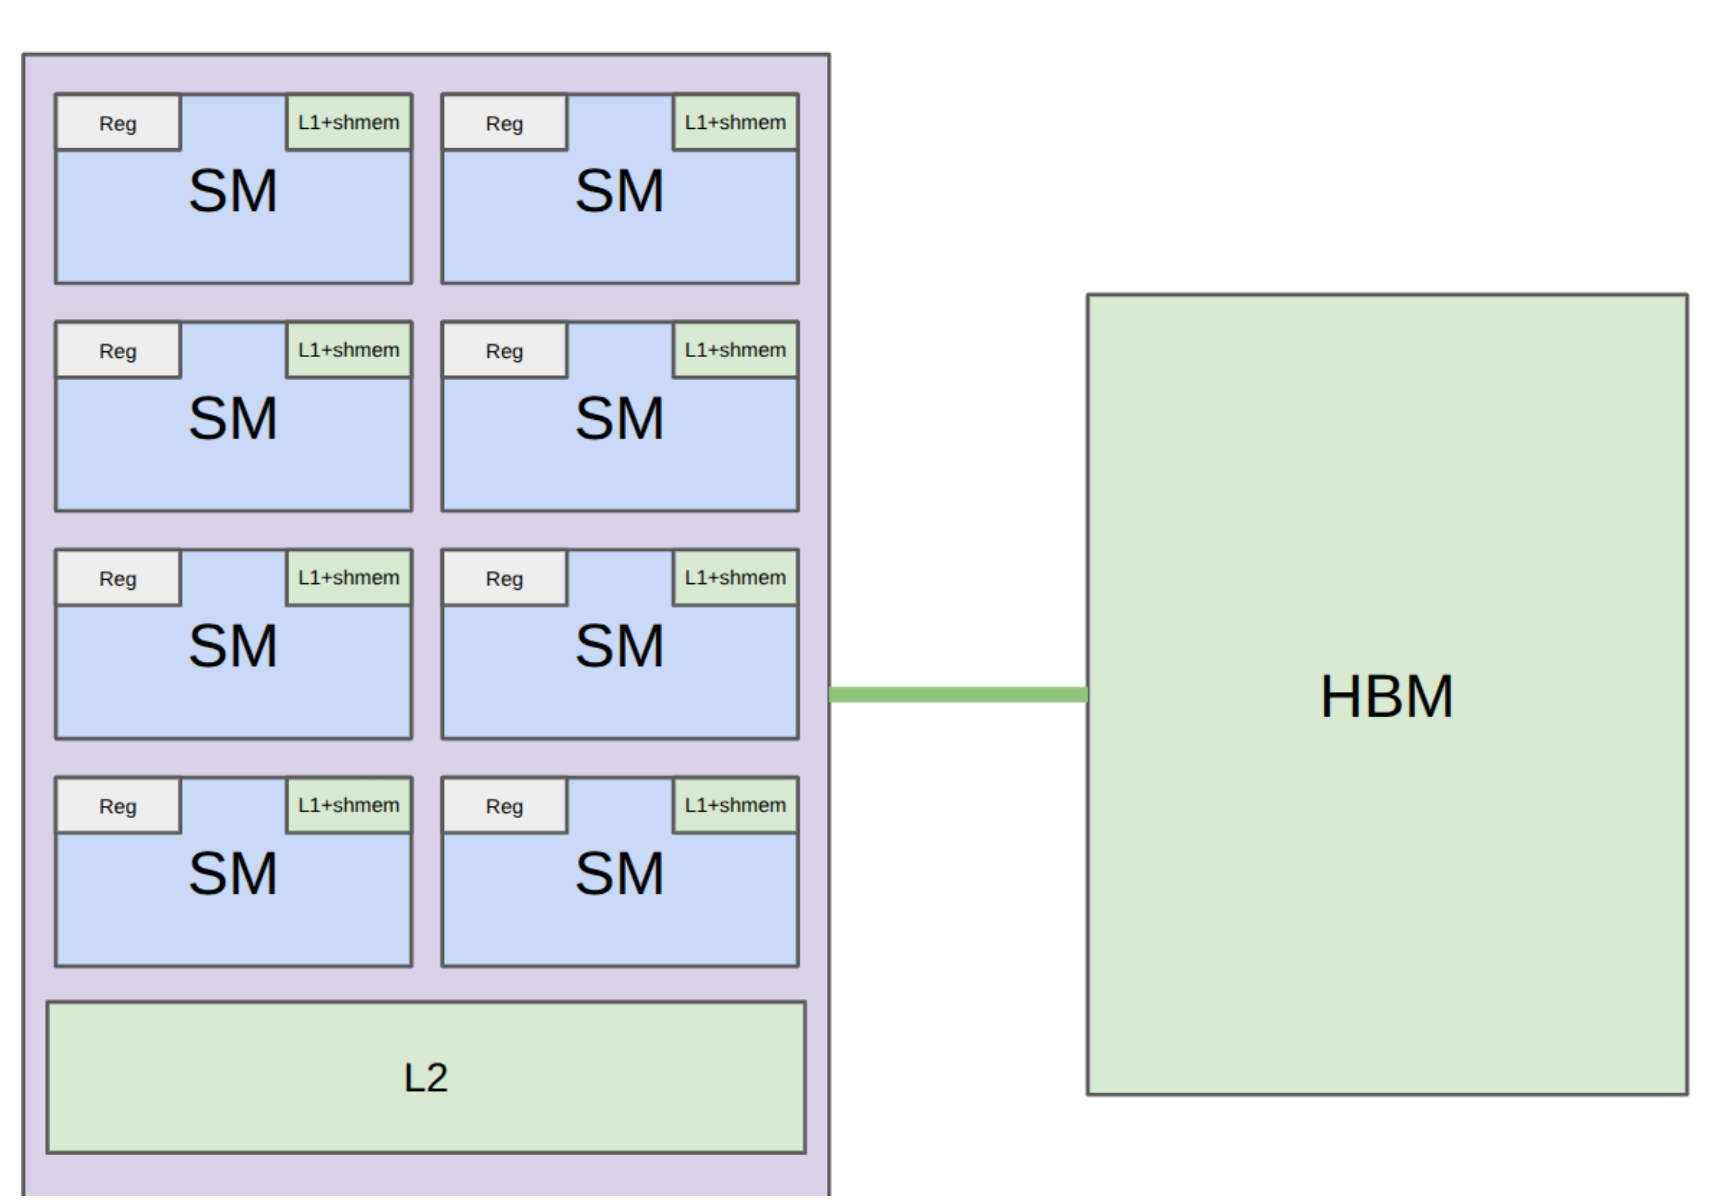
这节主要讲的是如何用triton写算子,优化性能。首先回顾一下上一节讲的GPU架构。一个GPU上有多个SM,多个SM共享全局内存(HBM),以及一个全局缓存L2。
每个SM共享L1缓存和共享内存。每个线程独享寄存器资源,但一个SM上的寄存器其实也是公用的一块区域划分出来的。
| SM 数量 | 108 | 132 | 148 |
| Register 大小(每个 SM) | 256 KB | 256 KB | 256 KB |
| L1 cache + shared memory(每个 SM) | 192 KB | 256 KB | 256 KB |
| L2 cache 大小 | 40 MB | 50 MB | 96-126 MB |
| HBM 大小 | 80 GB | 80 GB | 192 GB |
| Register bandwidth | ~116 TB/s | ~401 TB/s | ~447 TB/s |
| L1 cache + shared memory bandwidth | ~19 TB/s | ~33 TB/s | ~19 TB/s |
| L2 cache bandwidth | ~5-8 TB/s | ~12 TB/s | ~9 TB/s |
| HBM bandwidth | 2 TB/s | 3.35 TB/s | 8 TB/s |
对于各级内存的具体大小和带宽,如上表。
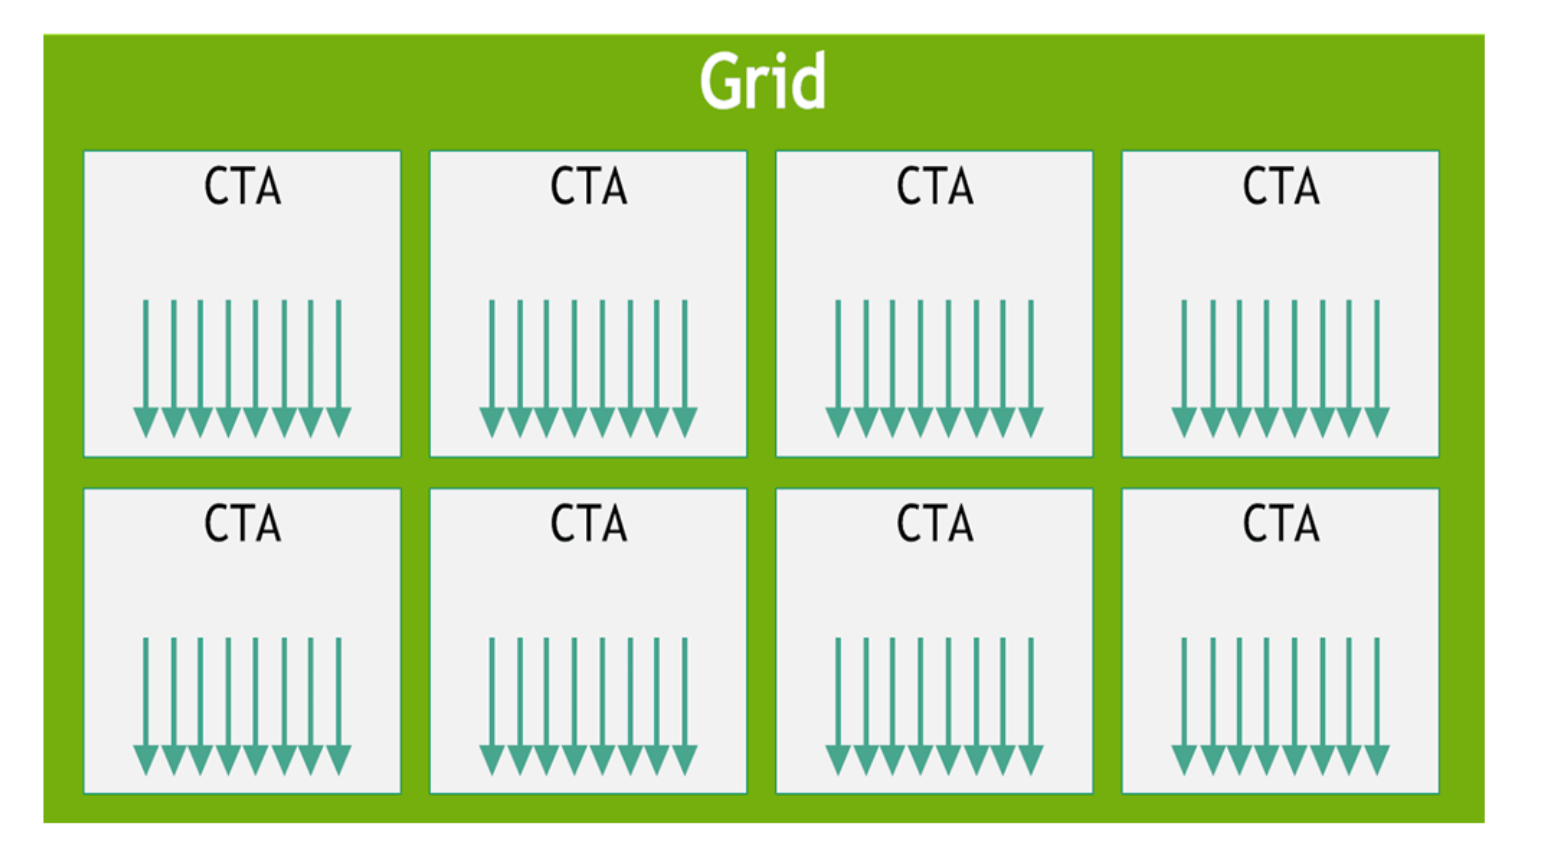
对于线程模型,每次启动只能启动一个grid,grid的shape决定了线程块block的排布。每个block也称为CTA(Cooperative Thread Array),保存了一组线程。最底层是单个线程thread。
对于逐元素操作,看起来让每个线程各干各的就好了,不需要block这层抽象。设置block这层的原因是有些算子需要块内协作,比如softmax,需要求块内最大值,求和,才能计算每个位置的结果,也就是每个线程需要访问其他线程的数据,这如果都通过全局内存就太慢了,所以设置block,每个block内共享SMEM,可以把块内共享的数据加载到SMEM中,快速访问。
Warp occupancy
上节课没提到的GPU优化的另一个重点。
在一个 thread block 内,thread 被分为 warp,每个 warp 有 32 个 thread。
例如,一个有 64 个 thread 的 thread block 包含 2 个 warp。
每个 thread 可以使用 0 到 255 个 register。每个thread 使用的寄存器越多,一个 SM 能调度的 thread 就越少,即 occupancy 越低。如果每个 thread 做了更多工作,低 occupancy 不一定是坏事。一个例子是 thread coarsening,即每个 thread 处理多个 element。但申请了不必要的,过多的寄存器,会导致能并发的warp数太少。
一个SM并发的warp数多,有利于SM调度,可以在一个warp等待数据读写时,调度另一个warp进行计算,类似于CPU里的超线程技术,并发线程数大于物理核心数,可以提高SM/CPU的利用率。对于warp occupancy的严格定义是当前warp数,和SM的最大warp数的比值,一般来讲越高越好。
当然除了寄存器,限制SM利用率的因素还有共享内存,一个SM会有多个block,每个block都需要共享内存,而SM的共享内存有限,会限制block个数,进而限制了线程数和warp个数。
Bank conflict
另一个上节课没提到但很重要的东西是bank冲突。bank指的是共享内存实际被划分为32个可并行读写的块,正好等于warp大小,在设计上,理想情况下warp内每个线程都去读写共享内存的不同bank,实现完全的并行内存访问。
如果32个线程不是访问32个不同bank,而是有些线程会访问同一个bank,此时在这个多线程都要访问的bank上,请求会退化成串行处理,这被称为bank conflict。由于warp是同步的,所有线程都要等待这个bank的几个线程串行读写完毕,访存延迟大幅增加
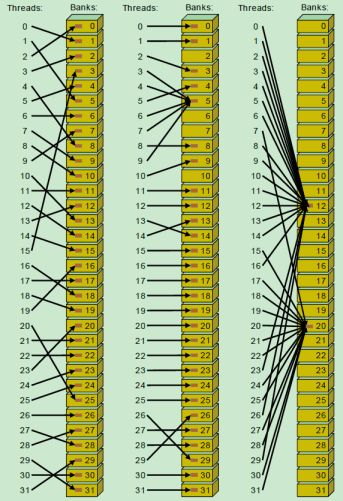
如图,最左侧的情况是线程和bank一一对应,不存在bank冲突。中间的图大部分一一对应,有几个bank出现冲突,访存延迟略微增加。最右边的情况,32个线程只读2个bank,出现了严重的bank冲突,访存延迟大幅增加。
对此的主流解决方法是swizzling
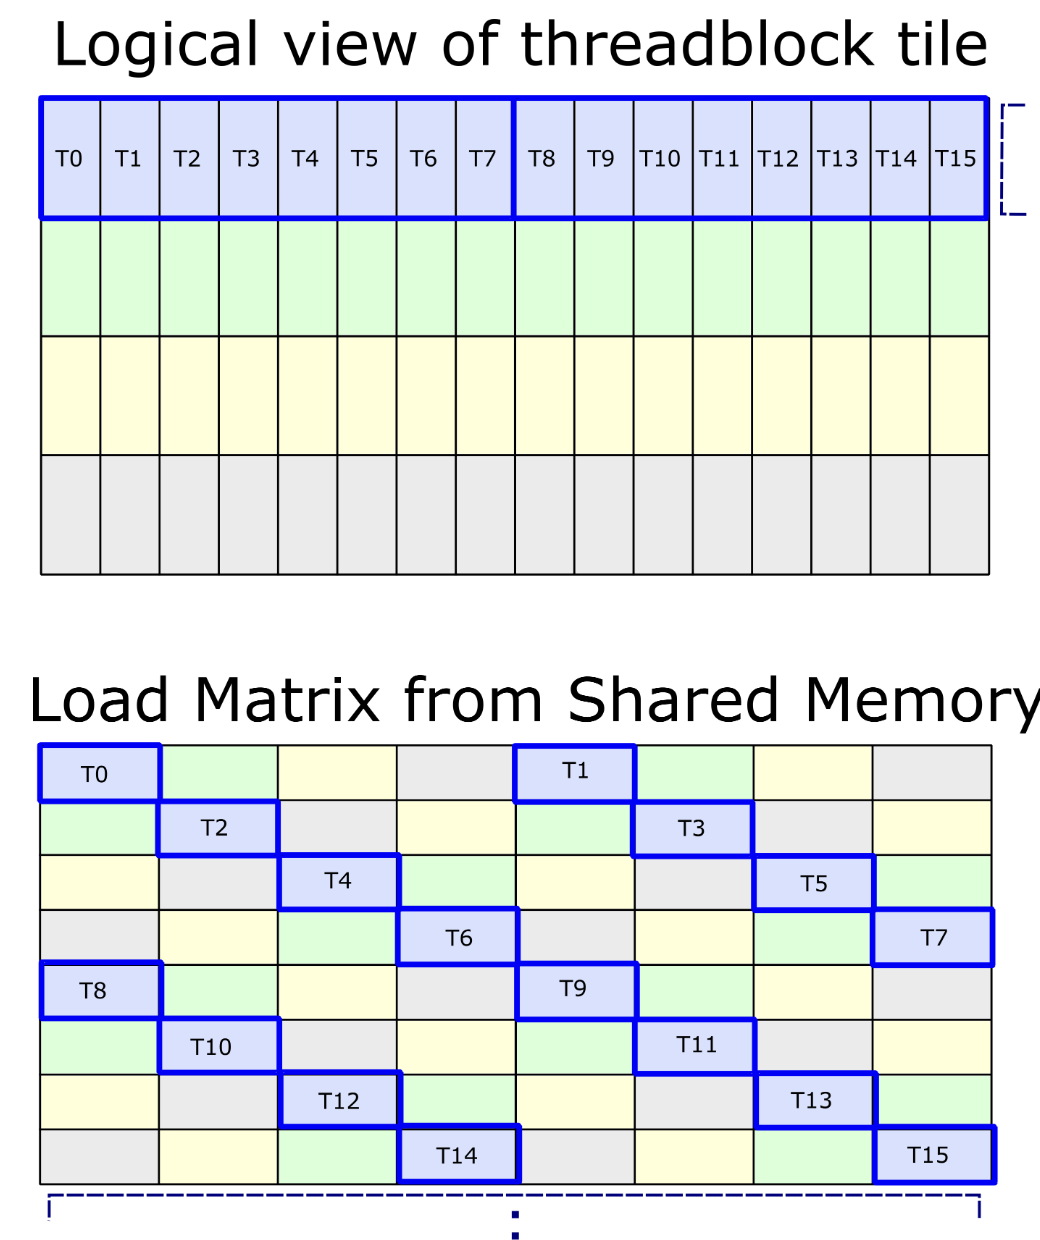
把数据按照一定规则打乱,让一个warp内的线程读取的是不同bank的数据
Triton
这节给一些算子的实际例子,用triton实现,triton是一个类python的GPU算子开发语言,写类py语法,然后triton编译器会帮你编译成ptx汇编,也就是GPU的专用汇编代码,因此可以获得媲美纯CUDA的执行效率,同时还有python的开发效率,综合来讲是一个比较好的语言。
在相当长的时间内triton都是唯一的主流算子开发DSL(领域专用语言),vllm,SGLang,甚至OpenAI内部有大量算子是用triton实现的。直到近几年才有mojo,tilelang,cutile等竞品开始挑战triton的地位。
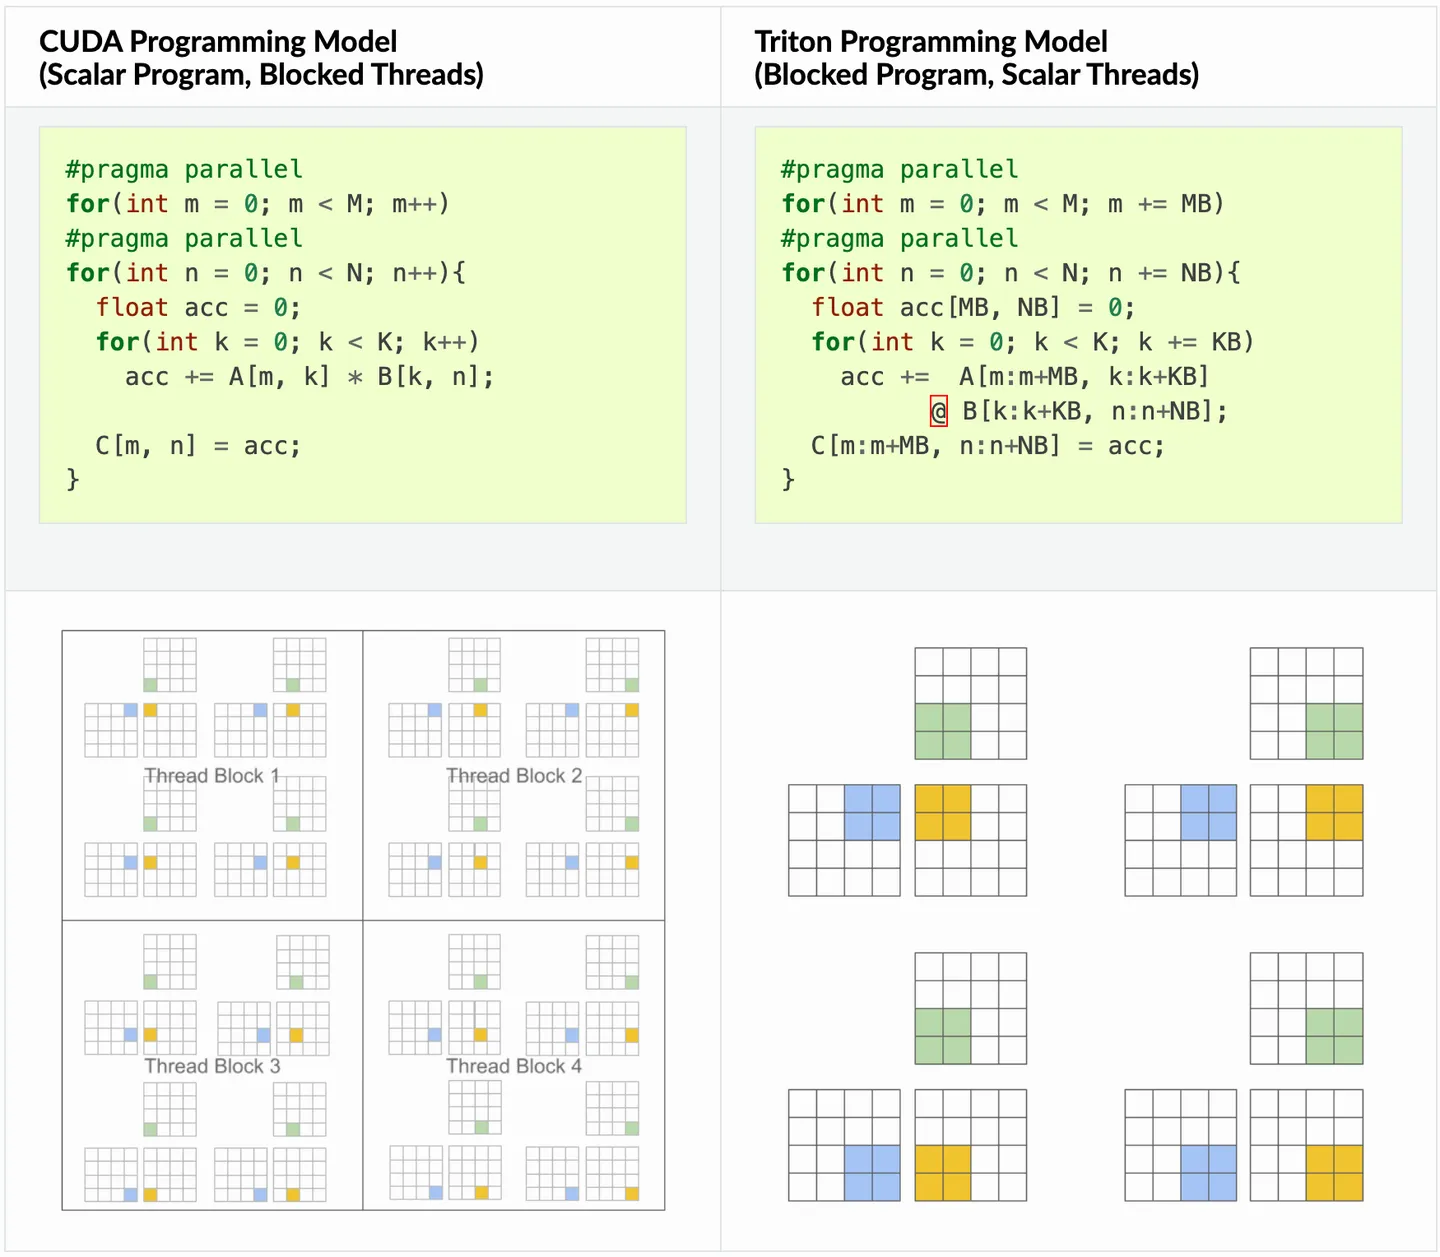
triton简化了编程模型,编程者不再能直接控制线程,而只能控制到block这个维度,这虽然损失了一定的灵活性和性能上限,但是简化了开发。开发时只用考虑如何把数据分块,每一块要做什么计算即可,不用考虑每个线程需要做什么,把对初学者可能造成困惑的SIMT编程范式,替换成了便于理解的SIMD。
如上图,左侧是CUDA编程模型,需要考虑每个线程做什么,每个线程具体负责哪个元素;右侧是triton,只用考虑划分成那几个数据块,每个数据块需要做什么,相当于在CUDA中只需要考虑block,不考虑thread,warp这些。
GeLU
def triton_gelu(x: torch.Tensor):
assert x.is_cuda
assert x.is_contiguous()
y = torch.empty_like(x)
num_elements = x.numel()
BLOCK_SIZE = 1024
num_blocks = triton.cdiv(num_elements, BLOCK_SIZE)
kernel = triton_gelu_kernel[(num_blocks,)](
x, y, num_elements, BLOCK_SIZE=BLOCK_SIZE
)
output_ptx("triton_gelu", kernel)
return y
@triton.jit
def triton_gelu_kernel(x_ptr, y_ptr, num_elements, BLOCK_SIZE: tl.constexpr):
pid = tl.program_id(axis=0)
start = pid * BLOCK_SIZE
offsets = start + tl.arange(0, BLOCK_SIZE)
mask = offsets < num_elements
x = tl.load(x_ptr + offsets, mask=mask)
# Approx gelu is 0.5 * x * (1 + tanh(sqrt(2/pi) * (x + 0.044715 * x^3)))
# tl.tanh doesn't exist; use tanh(a) = (exp(2a) – 1) / (exp(2a) + 1)
a = 0.79788456 * (x + 0.044715 * x * x * x)
exp = tl.exp(2 * a)
tanh = (exp – 1) / (exp + 1)
y = 0.5 * x * (1 + tanh)
tl.store(y_ptr + offsets, y, mask=mask)
从一个例子来看利用triton的算子开发。triton_gelu()是对外提供的python函数接口,启动kernel之前的准备工作,都在这里做,包括确定block大小(block大小必须是2的幂次,这里直接硬编码1024),根据block大小计算分块个数,检验数据是否传送到显存上,检验数据排布是否连续。
triton_gelu_kernel()是triton内核,从这个内核可以初步了解一下triton的编程范式。首先,确定当前内核的编号pid,根据这个编号确定当前block对应的数据区间,也就是从下标start开始,长度BLOCK_SIZE的一块数据。
根据这个区间构造一个下标数组offsets,保存这个区间内的下标。为了防止越界,再构造一个mask数组,和offsets等长,每个位置表示offsets里的对应下标,是否有效(不能超出num_elements)
后面就是体现triton的block思想的地方了,我们直接用offsets和mask数组作为参数,调用tl.load(),搬运当前block负责的数据块,不必像CUDA中需要计算每个线程负责的下标,而是直接整块搬运。
后面对这取出来的这个数据快,当成类似numpy数组来处理,利用py的语法糖对整块数据做统一操作,也就是GeLU的具体定义
最后,还是用tl.store(),和tl.load()类似,也传入offsets和mask。不同的是写入结果地址是y指针开头的地址,不是输入时的x指针
对于运行,triton只是长得像py,但他并不是py的解释执行,而是和CUDA一样也会编译成完整PTX汇编,直接在GPU上运行可执行程序,这也是triton性能可以媲美纯CUDA的原因。
并且事实上,triton代码往往很简单,很多优化工作是编译器自动帮我们做的,triton的编译器优化的很好,随手写的简单triton实际上往往就可以打败大多数手写CUDA了,只是和顶尖CUDA优化有差距。
softmax
def triton_softmax(x: torch.Tensor):
y = torch.empty_like(x)
M, N = x.shape
block_size = triton.next_power_of_2(N) # Each block contains all columns
num_blocks = M # Each block is a row
triton_softmax_kernel[(M,)](
x_ptr=x, y_ptr=y,
x_row_stride=x.stride(0), y_row_stride=y.stride(0),
num_cols=N, BLOCK_SIZE=block_size,
)
return y
@triton.jit
def triton_softmax_kernel(
x_ptr, y_ptr, x_row_stride, y_row_stride,
num_cols, BLOCK_SIZE: tl.constexpr,
):
assert num_cols <= BLOCK_SIZE
row_idx = tl.program_id(0)
col_offsets = tl.arange(0, BLOCK_SIZE)
x_start_ptr = x_ptr + row_idx * x_row_stride
x_ptrs = x_start_ptr + col_offsets
x_row = tl.load(
x_ptrs, mask=col_offsets < num_cols, other=float("-inf")
)
x_row = x_row – tl.max(x_row, axis=0)
numerator = tl.exp(x_row)
denominator = tl.sum(numerator, axis=0)
y_row = numerator / denominator
y_start_ptr = y_ptr + row_idx * y_row_stride
y_ptrs = y_start_ptr + col_offsets
tl.store(y_ptrs, y_row, mask=col_offsets < num_cols)
GeLU是逐元素算子,再来看个复杂一点的,逐行规约算子。分块规则是每个block负责一行。列数是变长的,所以块大小不能硬编码了,应该取不小于列数的最小的2的幂。
输入是一个矩阵,kernel的内的寻址稍微复杂一点。首先找到所在行的开始地址x_start_ptr,。然后构造一行内的下标数组col_offsets,也就是一个[0,BLOCK_SIZE)的列表。col_offsets 和x_start_ptr 加起来得到这一行的具体下标数组x_ptrs,用这个数组来做tl.load。mask设计为不超过列数的为1,别的为0,softmax计算时进行幂操作,想让无效位置不影响结果,应该赋值为负无穷
接下来做一下safe softmax的操作,找到行内最值,给每个元素减去最值。求以e为底数的幂。规约求和,作为分母,除以幂。都可以用类numpy/torch.tensor的重载快速实现。最后还是tl.store写入结果数组。
行内分块reduce
def triton_row_sum(x: torch.Tensor, BLOCK_SIZE: int = 1024) -> torch.Tensor:
M, N = x.shape
y = torch.empty(M, device=x.device, dtype=x.dtype)
row_sum_kernel[(M,)](x, y, N, BLOCK_SIZE=BLOCK_SIZE)
return y
@triton.jit
def row_sum_kernel(x_ptr, out_ptr, N, BLOCK_SIZE: tl.constexpr):
row = tl.program_id(0)
# One row: T1 T2 T3 T4 | T1 T2 T3 T4 | T1 T2 T3 T4
acc = tl.zeros([BLOCK_SIZE], dtype=tl.float32)
for start in range(0, N, BLOCK_SIZE):
cols = start + tl.arange(0, BLOCK_SIZE)
mask = cols < N
x = tl.load(x_ptr + row * N + cols, mask=mask, other=0.0)
acc += x
result = tl.sum(acc, axis=0)
tl.store(out_ptr + row, result)
softmax的核心是两次规约得到max和sum。这两部分刚才都是一个block就做完了。这里的block实际上就对应CUDA里的block,每个block把数据从全局内存加载到共享内存,再执行计算,问题在于共享内存是有限的,因此很多时候列数很大的时候,不能让一整行都一次load全部加载,应该在分成多次加载。这里给出一个reduce sum的行内分tile做法
block大小固定为1024,列数为N的话,需要加载N/1024(向上取整)次,每次把1024个元素load到共享内存,进行计算。对于sum操作来说分块求和,再把每一块的和加起来,是等价的。
Matmul
def triton_matmul_relu(a: torch.Tensor, b: torch.Tensor):
assert a.is_cuda and b.is_cuda
assert a.is_contiguous() and b.is_contiguous()
assert a.shape[1] == b.shape[0]
M, K = a.shape
K, N = b.shape
c = torch.empty((M, N), device=a.device)
BLOCK_M, BLOCK_N, BLOCK_K = 64, 64, 32
grid = (triton.cdiv(M, BLOCK_M), triton.cdiv(N, BLOCK_N))
matmul_relu_kernel[grid](
a, b, c,
M, N, K,
a.stride(0), a.stride(1),
b.stride(0), b.stride(1),
c.stride(0), c.stride(1),
BLOCK_M, BLOCK_N, BLOCK_K,
)
return c
@triton.jit
def matmul_relu_kernel(
a_ptr, b_ptr, c_ptr,
M, N, K,
stride_am, stride_ak,
stride_bk, stride_bn,
stride_cm, stride_cn,
BLOCK_M: tl.constexpr,
BLOCK_N: tl.constexpr,
BLOCK_K: tl.constexpr,
):
pid_m = tl.program_id(0)
pid_n = tl.program_id(1)
indices_m = pid_m * BLOCK_M + tl.arange(0, BLOCK_M)
indices_n = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)
indices_k = tl.arange(0, BLOCK_K)
a_ptrs = (
a_ptr
+ indices_m[:, None] * stride_am
+ indices_k[None, :] * stride_ak
)
b_ptrs = (
b_ptr
+ indices_k[:, None] * stride_bk
+ indices_n[None, :] * stride_bn
)
acc = tl.zeros([BLOCK_M, BLOCK_N], dtype=tl.float32)
for k in range(0, K, BLOCK_K):
a = tl.load(
a_ptrs,
mask=(indices_m[:, None] < M) & (indices_k[None, :] + k < K),
other=0.0,
)
b = tl.load(
b_ptrs,
mask=(indices_k[:, None] + k < K) & (indices_n[None, :] < N),
other=0.0,
)
acc += tl.dot(a, b)
a_ptrs += BLOCK_K * stride_ak
b_ptrs += BLOCK_K * stride_bk
acc = tl.maximum(acc, 0.0)
c_ptrs = (
c_ptr
+ indices_m[:, None] * stride_cm
+ indices_n[None, :] * stride_cn
)
tl.store(
c_ptrs, acc,
mask=(indices_m[:, None] < M) & (indices_n[None, :] < N),
)
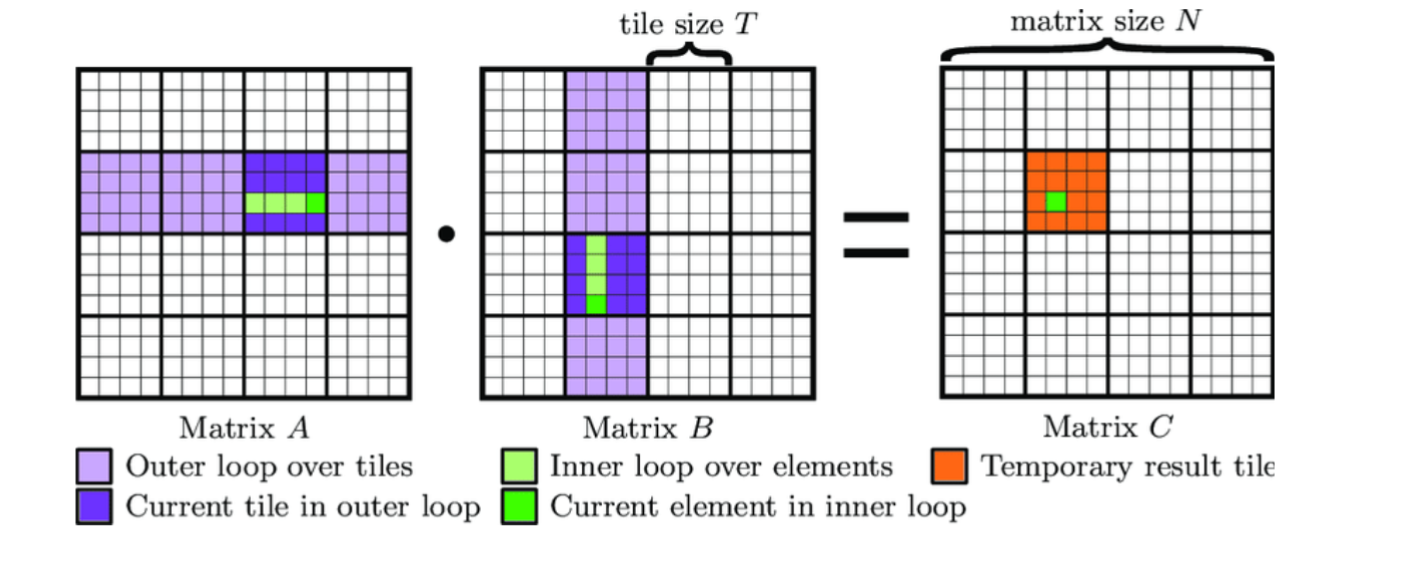
这里用的就是第五讲讲过的矩阵乘法tiling策略,如上图对结果数组C分tile,每个(d,d)的c tile会需要(d,k)的A tile,(k,N)的B tile。如果NM很大,贡献内存会放不下,这就用到我们前面reduce算子提到的技巧:block内用一个循环,继续分块,每次只load一小块到共享内存里。
对于这一小块,利用tl.dot(a, b)直接计算,这是以block为基本单位的好处,不用再操作线程具体做三重循环的矩阵乘法,也就是我们不需要做绿色部分的操作。对于每个小块的matmul结果,都累加到c tile临时数组arr,最后把acc写回c数组