在数据工程中,"把同样的逻辑对 30 个列各写一遍"是重复代码的重灾区。SQLMesh 提供了多种在 SQL 模型中实现"循环"的手段:内置的 @EACH 宏操作符、Python @macro() 函数中的原生 for 循环,以及 Jinja 模板的 {% for %} 语法。本文重点讲解前两者——SQLMesh 原生宏与 Python 宏,并深入介绍如何用 SQLGlot 表达式以"语义感知"的方式安全地拼接 SQL;Jinja 宏仅作简要提及。全文配有 8 个可落地的实战案例(PIVOT 指示列、Schema 批量改名、按类型脱敏、UNION 分片、GRANT 语句生成、宏实现 UNPIVOT 等),帮助你把几十行重复 SQL 收敛为一个宏调用。
适合读者:熟悉 SQLMesh 基本模型概念(MODEL 块、宏变量)、想在项目中落地 DRY 原则的数据工程师。
1. 为什么 SQLMesh 的循环不同于模板引擎
先建立一个正确的心智模型,后面所有内容都会顺理成章。
模板引擎(Jinja、Jinja2、dbt 的默认宏系统)的本质是字符串替换:扫描文本 → 找到特殊字符 → 替换成别的文本。它的控制流(if / for)只是为了"替换对字符串"而存在的服务设施,对语言完全无感知——同一套模板可以生成 HTML、邮件、也可以生成 SQL。
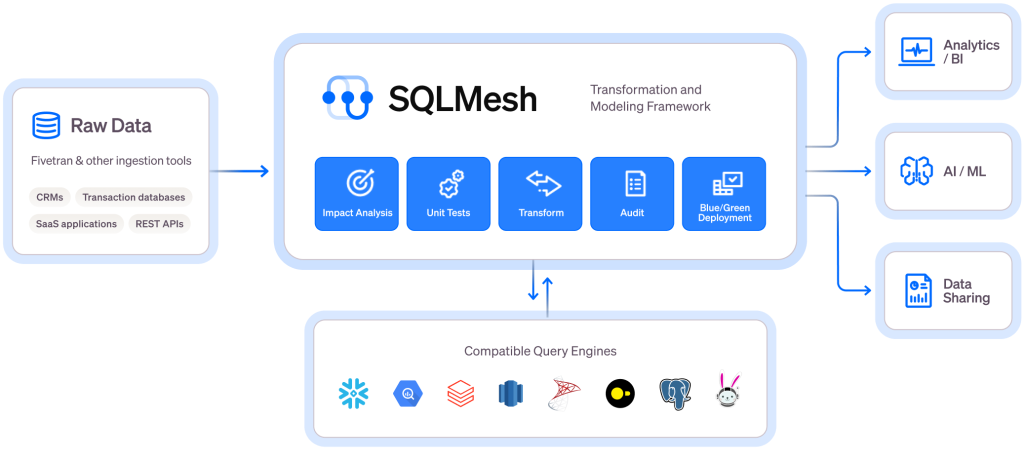
SQLMesh 宏则完全不同:它是为生成 SQL 而设计的,背后用 Python 的 SQLGlot 库对 SQL 做语义解析。官方文档描述的处理流程分五步:
关键结论:在 SQLMesh 里,字符串替换只是手段,最终产物是一棵语义正确的 SQL 语法树。 这带来两个直接好处:
- 宏生成的片段会被"理解",而不是被塞进文本里听天由命——渲染结果保证是合法 SQL;
- 宏可以基于语义做事:比如在 SELECT 子句里,@EACH 知道各项之间需要逗号,会自动补上。
模板引擎: 文本 ──替换──▶ 文本(是否合法全凭手写者水平)
SQLMesh: SQL ──解析──▶ AST ──宏修改 AST──▶ AST ──渲染──▶ 合法 SQL
2. SQLMesh 宏系统速览
进入循环主题前,快速过一遍会用到的语法要素。
变量:四级作用域
| Global | config.yaml 的 variables: | @var / @VAR('var', 默认值) | 最低 |
| Gateway | 某 gateway 的 variables: | 同上 | 中 |
| Blueprint | MODEL 块的 blueprints(…) | @var / @BLUEPRINT_VAR('var') | 高 |
| Local | 模型内 @DEF(name, value); | @name | 最高 |
局部变量用 @DEF 定义,三条硬性要求:MODEL 块以 ; 结尾、所有 @DEF 位于 MODEL 块之后查询之前、每条 @DEF 以 ; 结尾。
内联宏函数(lambda)
@DEF 不仅能定义值,还能定义函数,在 SQL 里像调用内置函数一样调用:
MODEL (
name dummy.model,
kind FULL
);
@DEF(area, r –> pi() * r * r);
@DEF(container_volume, (r, h) –> @area(@r) * h);
SELECT container_id, @container_volume((cont_di / 2), cont_hi) AS volume
@ 与 @{}:字面量 vs 标识符
SQLMesh 需要根据上下文判断一个字符串值该渲染成字面量('col')还是标识符(col):
SELECT @my_variable AS c; — my_variable = 'col' → SELECT 'col' AS c 字面量
SELECT @{my_variable} AS c; — my_variable = 'col' → SELECT col AS c 标识符
在标识符中间嵌入变量必须用花括号消歧:@{x}_column、my_@{x}_column;嵌入末尾可以简写为 column_@x。
SQL 子句操作符
@WITH、@JOIN、@WHERE、@GROUP_BY、@ORDER_BY……作用是把循环/宏生成的片段正确地挂到对应子句上。后面案例会用到 @JOIN。
3. 方式一:@EACH —— SQL 里的 for 循环
官方文档明说:@EACH “analogous to a for loop”。它的语法是"集合 + 对每个元素做的动作",正好对应 for 循环的两个组成部分:
@EACH([列表], [匿名函数])
匿名函数写作 x -> 表达式:箭头左边声明循环变量名(对应 for x in […] 的 x),右边声明对每个元素做什么(对应循环体)。
3.1 最小示例
SELECT
@EACH([4, 5, 6], number –> number)
FROM table
渲染为:
SELECT
4,
5,
6
FROM table
注意 SQLMesh 的"语义自觉":它在 SELECT 子句中自动为各项补逗号,无需手写 x -> x + ',' 这类补丁。
3.2 字面量与标识符的双重身份
看一个真实需求:把 favorite_number 列打散成 one-hot 指示列。手写版本:
SELECT
CASE WHEN favorite_number = 4 THEN 1 ELSE 0 END AS favorite_4,
CASE WHEN favorite_number = 5 THEN 1 ELSE 0 END AS favorite_5,
CASE WHEN favorite_number = 6 THEN 1 ELSE 0 END AS favorite_6
FROM table
每个数字以两种身份出现:favorite_number = 4 里是字面量,favorite_4 里是列名的一部分。@EACH 处理规则:
- 作字面量:原样保留列表里的引号——写 ['4','5','6'] 就渲染成 '4',写 [4,5,6] 就渲染成 4;
- 作标识符:在 lambda 体内用 @x 拼接。
SELECT
@EACH(['4','5','6'],
x –> CASE WHEN favorite_number = x THEN 1 ELSE 0 END AS column_@x)
FROM table
渲染为:
SELECT
CASE WHEN favorite_number = '4' THEN 1 ELSE 0 END AS column_4,
CASE WHEN favorite_number = '5' THEN 1 ELSE 0 END AS column_5,
CASE WHEN favorite_number = '6' THEN 1 ELSE 0 END AS column_6
FROM table
3.3 循环的组合技:@EACH + @FILTER + @REDUCE
三个操作符可以组合成"过滤 → 映射 → 归约"的流水线:
- @FILTER([a,b,c], x -> 条件):按条件筛列表;
- @EACH:逐项映射;
- @REDUCE(列表, (acc, x) -> 表达式):把列表归约成一项(匿名函数用括号声明两个参数:累积值 acc 和当前项 x)。
需求:对存在于 [col1, col2, col3] 中、且同时满足"在 (col1, col3) 里"的列生成 colN = 1 条件,并用 AND 连接:
SELECT
a
FROM table
WHERE
@REDUCE(
@EACH(
@FILTER([col1, col2, col3], x –> x IN (col1, col3)),
x –> x = 1
),
(acc, x) –> @AND(acc, x)
)
渲染为:
SELECT
a
FROM table
WHERE
col1 = 1 AND col3 = 1
这就是"循环里累积拼接条件"的纯 SQL 宏写法。
4. 方式二:Python @macro() 函数里的原生 for 循环
当循环逻辑变复杂——多分支、要读 Schema、要返回多值、要在不同运行阶段做不同事——就该把循环写进 Python。SQLMesh 的宏系统"allow use of Python code so users can tidily implement sophisticated macro logic",这正是它的价值所在。
4.1 基本骨架
# macros.py
from sqlmesh.core.macros import macro
@macro()
def my_macro(evaluator, arg1, arg2):
# 普通 Python:for / if / try / 任何库
...
return 结果
- 第一个参数固定是 evaluator(宏求值上下文);
- 文件放在项目的 macros/ 目录下自动加载;
- SQL 中以 @my_macro(…) 调用。
4.2 返回值:决定"一次循环展开成什么"
宏函数的返回值会被 SQLMesh 解析并整合进查询的语义树:
| 单个字符串 / SQLGlot 表达式 | 替换宏调用处,成为单个 SQL 元素 |
| 字符串列表 / 表达式列表 | 展开为多项(如 SELECT 里的多列)——这是循环输出的关键 |
| 语句列表(用作 pre/post-statement 的宏) | 生成多条前后置语句 |
4.3 入参的"两副面孔"与迭代方式
这是 Python 宏最大的坑,必须先讲清楚:
不加类型注解时,SQLMesh 会先把入参用 SQLGlot 解析成表达式。你传入的列表 [a, b, c] 在函数体内是 SQLGlot 的 Array 表达式,不是 Python list:
- 数字、带引号字符串 → Literal 表达式
- 不带引号的词 → Column 表达式
因此不能直接 for x in values,要遍历它的 expressions 属性:
for value in values.expressions: # ✅
...
加类型注解后(Typed Macros),SQLMesh 会在函数执行前把入参强制转换为目标 Python 类型,循环就写得很自然:
@macro()
def my_macro(evaluator, values: list[str], count: int):
for v in values: # ✅ 真正的 Python list
...
支持的注解包括 str / int / float / bool / datetime / SQL / list[T] / tuple[T] / T1 | T2,以及任意 SQLGlot 表达式类型(exp.Table、exp.Column、exp.Literal……)。原则:输入端交给注解强制转换,输出端自己负责——返回值要符合查询语义树期望的类型,必要时用 exp.Literal.string(…) 显式包装。
4.4 evaluator:循环可以读取的上下文
Python 宏里的循环不只是遍历列表,还能遍历"项目知识":
| 全局/网关变量 | evaluator.var('name', 默认值) |
| 预定义/局部变量(如 runtime_stage、execution_epoch) | evaluator.locals['name'] |
| 上游模型 Schema(列名 → 类型) | evaluator.columns_to_types('schema.model') |
| 本模型物理表 / 视图名 | evaluator.this_model / this_model_fqn |
| 快照(含已处理区间) | evaluator.get_snapshot('model').intervals |
4.5 遍历 Schema:最典型的循环场景
上游模型有 50 列,下游想全部加 stg_ 前缀——官方文档给出的 prefix_columns 范式:
from sqlglot import exp
from sqlmesh.core.macros import macro
@macro()
def prefix_columns(evaluator, model_name, prefix: str):
renamed_projections = []
# model_name 是 SQLGlot 表达式,转成查找 key(未加引号的模型名)
model_name_sql = model_name.sql()
for name in evaluator.columns_to_types(model_name_sql): # ← 循环 Schema
new_name = prefix + name
renamed_projections.append(exp.column(name).as_(new_name))
return renamed_projections
MODEL (
name schema.child,
kind FULL
);
SELECT
@prefix_columns(schema.parent, 'stg_')
FROM schema.parent
若 schema.parent 的列为 id, amount, status,渲染为:
SELECT
id AS stg_id,
amount AS stg_amount,
status AS stg_status
FROM schema.parent
一个宏替代了"每列手写一次别名"的 50 行样板。注意事项:上游 Schema 在加载期不可用时,columns_to_types 会返回占位列 __schema_unavailable_at_load__,健壮实现要跳过它(见第 8 节)。
5. SQLGlot 表达式:让循环"懂 SQL"
前面反复提到"语义表示",这一节展开。在 Python 宏里拼 SQL 有两种风格:
风格 A:f-string 拼接——简单直观,但引号、转义、合法性全靠自己保证:
cases.append(f"CASE WHEN {col} = '{v}' THEN 1 ELSE 0 END AS {col}_{v}")
风格 B:SQLGlot 表达式 API——循环体内构造/修改 AST 节点,渲染交给 SQLMesh:
from sqlglot import exp
out.append(exp.column(name).as_(prefix + name))
官方立场很明确:SQLMesh 会自动把宏返回的字符串解析成 SQLGlot 表达式再并入查询语义树;但直接返回表达式更稳,因为:
值得掌握的表达式 API:
-
入参天然就是表达式。未注解的字符串参数会被解析为 Column,它是 Condition 的子类,自带条件构造方法:
@macro()
def between_where(evaluator, column, low_val, high_val):
return column.between(low_val, high_val) # 直接返回表达式# SELECT a FROM table WHERE @between_where(a, 1, 3)
# → WHERE a BETWEEN 1 AND 3 -
构造节点:exp.column(name)、exp.column(name).as_(alias)、exp.Literal.string(s)、exp.Literal.number(n);
-
组合查询:parse_one(sql) + Select.union(other, distinct=False);
-
改写节点:table.set("catalog", "dev");
-
类型注解即解析器:参数注解为 exp.Select 时,传入的字符串字面量会被自动解析成 Select 表达式:
@macro()
def stamped(evaluator, query: exp.Select) –> exp.Subquery:
return query.select(
exp.Literal.string(str(datetime.now())).as_("stamp")
).subquery() -
失败不崩溃:注解强制转换失败时记录警告并原样传入表达式,不中断加载;想要强约束,自己加 assert isinstance(…)。
经验法则:能用表达式 API 就别用裸字符串;混合使用没问题,但涉及引号语义的地方(字面量 vs 标识符)用 exp.Literal.string() / .as_() 显式表达意图。
6. Jinja 宏:简要提及
SQLMesh 同时支持 Jinja 宏体系,启用后(项目配置 jinja_macros: true)可直接使用标准 Jinja 控制流:
@JINJA_QUERY_BEGIN
SELECT
{% for col in ['a', 'b', 'c'] %}
{{ col }}{{ "," if not loop.last }}
{% endfor %}
FROM my_table
@END_JINJA
循环能力与 Jinja 原生无异(loop.index、{% if %}、宏定义等)。但官方强烈警告:一个模型只用一套宏系统——SQLMesh 宏与 Jinja 混用"可能失败或行为反直觉",因为两套系统的解析入口和渲染时机不同。本文不展开,选型建议见第 9 节。
7. 实战案例集
以下 8 个案例由浅入深,覆盖日常开发最常见的循环需求。
案例 1:PIVOT 指示列(@EACH 一行顶十行)
需求:vehicle 列取值 truck / bus / car,各生成一个 one-hot 指示列。
方案 A:纯 SQL 宏
SELECT
@EACH([truck, bus, car],
x –> CASE WHEN vehicle = '@x' THEN 1 ELSE 0 END AS vehicle_@x)
FROM transport
方案 B:Python 宏(官方 make_indicators 范式)
@macro()
def make_indicators(evaluator, string_column, values):
cases = []
for value in values.expressions:
cases.append(
f"CASE WHEN {string_column} = '{value}' THEN '{value}' "
f"ELSE NULL END AS {string_column}_{value}"
)
return cases
SELECT @make_indicators(vehicle, [truck, bus, car]) FROM transport
两者渲染结果一致:三个 CASE WHEN … AS vehicle_truck/vehicle_bus/vehicle_car 列。列表固定、逻辑简单选 A;值还要参与更复杂计算选 B。
案例 2:全表加前缀重命名(循环 Schema,解耦上游)
需求:下游模型不想与外部表列名强耦合,全部加 stg_ 前缀。
即第 4.5 节的 prefix_columns,调用一行:
SELECT @prefix_columns(schema.parent, 'stg_') FROM schema.parent
价值:上游加列时下游只需重跑渲染,不改代码;这正是"用宏实现 DRY"的官方推荐场景。
案例 3:按类型批量改写列——循环 + 类型判断
需求:字符串列统一 UPPER(),其余列原样透出。
from sqlglot import exp
from sqlmesh import macro
@macro()
def upper_string_cols(evaluator, model_name):
out = []
cols = evaluator.columns_to_types(model_name.sql())
for name, dtype in cols.items(): # ← 同时拿到列名和类型
if dtype.this in (exp.DataType.Type.VARCHAR,
exp.DataType.Type.TEXT):
out.append(exp.func("upper", exp.column(name)).as_(name))
else:
out.append(exp.column(name))
return out
SELECT @upper_string_cols(schema.parent) FROM schema.parent
同一模板可派生:数值列 COALESCE(col, 0)、日期列统一时区转换、所有列套 PII 脱敏函数。循环 + 类型过滤是 Schema 驱动开发的核心招式。
案例 4:按类型脱敏 PII(循环 + 名单匹配)
需求:凡列名命中敏感词表(email / phone / ssn),套哈希脱敏。
PII_WORDS = {"email", "phone", "ssn", "mobile"}
@macro()
def mask_pii(evaluator, model_name, algo: str = "MD5"):
out = []
for name in evaluator.columns_to_types(model_name.sql()):
if name.lower() in PII_WORDS:
out.append(f"{algo}({name}) AS {name}")
else:
out.append(name)
return out
SELECT @mask_pii(raw.users) FROM raw.users
— → email → MD5(email) AS email;id、name 原样
生产变体:把名单和算法放进全局变量,evaluator.var('pii_columns', []) 读进循环——配置驱动,改名单不动代码。
案例 5:多区域 UNION ALL 分片(循环 + 表达式组合查询)
需求:一张大表按 region 拆成多段 UNION ALL(每段可各自加 WHERE / 分区裁剪)。
from sqlglot import parse_one
from sqlmesh import macro
@macro()
def union_by_region(evaluator, source, regions: list[str]):
parts = []
for r in regions:
parts.append(f"SELECT * FROM {source} WHERE region = '{r}'")
q = parse_one(parts[0])
for p in parts[1:]: # ← 表达式级组合
q = q.union(parse_one(p), distinct=False)
return q
SELECT * FROM ( @union_by_region(raw.orders, ['cn', 'us', 'eu']) ) t
渲染为三段 UNION ALL。要点:parse_one 把每段文本升格为表达式,再用 Select.union 在 AST 层拼装——比字符串拼 UNION ALL 可靠(后者容易在 ORDER BY、括号上翻车)。
案例 6:为每个角色循环生成 GRANT 后置语句(pre/post-statements)
需求:模型评估完成后,对一组角色批量授权。
from sqlmesh import macro
@macro()
def grant_select(evaluator, *roles: str):
if evaluator.runtime_stage != 'evaluating':
return []
stmts = []
for role in roles: # ← 循环生成语句
stmts.append(f"GRANT SELECT ON {evaluator.resolve_template('{{this_model}}')} TO {role}")
return stmts
MODEL (
name my.model,
kind FULL,
post (@grant_select(analyst, bi_team))
);
渲染时在 this_model 解析出的物理表上执行两条 GRANT。要点:宏返回值用作 post-statement 时是"语句列表";变长参数 *roles: str 让调用方自由增减角色。若宏只影响元数据不影响数据,用 @macro(metadata_only=True) 声明,避免改宏触发回刷。
案例 7:动态回溯窗口(循环 + 全局变量 + 阶段判断)
需求:按月回溯生成回填窗口列表,回朔月数由全局变量控制,只在执行期生效。
from sqlmesh import macro
@macro()
def backfill_months(evaluator, n: int | None = None):
months = n or int(evaluator.var('backfill_months', 3)) # 全局变量兜底
out = []
for i in range(months): # ← 纯 Python 循环
out.append(f"DATEADD(month, –{i}, CURRENT_DATE) AS month_minus_{i}")
return out
— config.yaml: variables: { backfill_months: 6 }
SELECT id, @backfill_months() FROM raw.events
生成 6 列 month_minus_0 … month_minus_5。把循环次数的决定权交给配置,是"参数化宏"的常见形态。
案例 8:用宏实现 UNPIVOT(循环 + CTE 交叉连接 + @JOIN)
需求:把宽表"反转"成长表——月份列 jan / feb / mar … 展开成 month, sales 两行一列的窄表。目标引擎(如某些版本的 Hive/Spark)没有原生 UNPIVOT,标准做法是"值列表 CTE + CROSS JOIN UNNEST 或 LATERAL VIEW EXPLODE",手写 12 个 UNION ALL 或 STACK 参数非常枯燥——这正是宏循环的主场。
方案 A:纯 SQL 宏 —— @EACH + 手写 CTE 壳 + @JOIN
先说清两个前置语法事实(官方文档的写法比较易迷惑):
- @WITH 是条件开关,不是 CTE 生成器。@WITH(True) all_cities as (select * from city) 渲染为 WITH all_cities as (…)——参数 True 只决定"要不要这段 WITH",CTE 的名字和查询体始终由你手写;
- CTE 名字不能由宏变量充当。即便在查询正文里用花括号 @{name} as (…),SQLMesh 也解析不了"动态 CTE 名 + 查询体"的结构(标识符上下文中的宏渲染是已知限制,名字嵌入场景仅限 @DEF 值和 MODEL name)。
所以"CTE 名叫 months"的正确实现是:CTE 壳固定写死,循环只生成壳内的 UNION ALL 分支:
MODEL (
name sales.monthly_long,
kind FULL
);
@WITH(True) months as (
@EACH(
[jan, feb, mar],
x –> SELECT '@{x}' AS month, @x AS sales FROM sales.wide
)
)
SELECT
t.month,
s.sales
FROM months AS t
@JOIN(sales.wide AS s, TRUE);
渲染结果(@EACH 在 CTE 内部自动把各分支用 UNION ALL 连接——官方 @DATE_SPINE 宏正是同款套路;@JOIN(…, TRUE) 把交叉连接挂到 FROM 上):
WITH months AS (
SELECT 'jan' AS month, jan AS sales FROM sales.wide
UNION ALL
SELECT 'feb' AS month, feb AS sales FROM sales.wide
UNION ALL
SELECT 'mar' AS month, mar AS sales FROM sales.wide
)
SELECT
t.month,
s.sales
FROM months AS t
JOIN sales.wide AS s
ON TRUE
方案 B:Python 宏 —— 循环 Schema 自动识别月份列(列清单免维护)
列多达几十个月、或列名不固定时,让宏自己遍历上游 Schema 挑列,并适配引擎方言:
from sqlglot import exp
from sqlmesh.core.macros import macro
MONTH_NAMES = {"jan", "feb", "mar", "apr", "may", "jun",
"jul", "aug", "sep", "oct", "nov", "dec"}
@macro()
def unpivot(evaluator, source, value_name: str = "value",
name_column: str = "name", keep_cols=None):
cols = evaluator.columns_to_types(source.sql())
unpivot_cols, keep = [], []
for name, dtype in cols.items():
if name.lower() in MONTH_NAMES: # ← 循环 Schema 挑待转列
unpivot_cols.append(name)
else:
keep.append(name) # 透传列,如 region
dialect = evaluator.dialect # 目标引擎方言
# 用 SQLGlot 表达式构造 unpivot 节点;DuckDB/Spark/BigQuery 等支持原生 UNPIVOT
unpivot_expr = exp.UnPivot(
expressions=[exp.column(value_name)],
unpivot_columns=[
exp.PivotColumn(
columns=[exp.column(c) for c in unpivot_cols],
values=[exp.Literal.string(c) for c in unpivot_cols],
)
],
include_nulls=False,
)
select = exp.select(
*[exp.column(c) for c in keep],
exp.column(name_column),
exp.column(value_name),
).from_(source).pivot(unpivot_expr)
return select
SELECT @unpivot(raw.sales_monthly, 'sales', 'month') FROM raw.sales_monthly
渲染为(方言支持原生语法时):
SELECT
region,
month,
sales
FROM raw.sales_monthly
UNPIVOT INCLUDE_NULLS (
sales FOR month IN (jan, feb, mar)
)
两个方案的选型:方案 A 零 Python 代码、纯 SQL 声明,CTE 壳固定 + 循环只填分支,适合列固定、引擎不支持原生 UNPIVOT 的通用场景(ON TRUE 交叉连接是 ANSI 标准写法,所有引擎通吃);方案 B 免维护列清单、自动按类型/名单挑列、且通过 evaluator.dialect 走目标引擎的原生 UNPIVOT/STACK/LATERAL 语法,适合列多或跨项目复用。
顺带一提:SQLMesh 内置的 @PIVOT 宏负责反方向(长转宽),而 UNPIVOT 官方没有内置操作符——自己用宏循环实现它,恰好把本章所有知识点串成一个完整闭环。
8. 最佳实践与常见坑
9. 总结
SQLMesh 中的"循环"是一个三层工具箱:
| SQL 层 | @EACH(+ @FILTER / @REDUCE) | 列表固定、逻辑简单的逐项映射 | 一行搞定,语义自动补逗号/连接符 |
| Python 层 | @macro() 原生 for 循环 | 复杂逻辑、遍历 Schema、生成多值/多语句 | 图灵完备,可访问 evaluator 全部上下文 |
| 模板层 | Jinja {% for %} | 项目已有 Jinja 生态 | 语法熟悉,但禁止与 SQLMesh 宏混用 |
贯穿全部案例的主线是 SQLMesh 的设计哲学:宏的目标不是替换字符串,而是修改查询的语义表示。 因此——
- @EACH 会"知道"自己在 SELECT 里该补逗号;
- 传入的列表会变成 Array 表达式(要 .expressions,或注解成 list[str]);
- 最稳的输出方式是直接构造 SQLGlot 表达式:exp.column(…).as_(…)、column.between(…)、parse_one(…).union(…);
- 而 evaluator.columns_to_types() 把"列清单"变成可编程对象后,Schema 驱动的批量改名、类型脱敏、UNION 分片、UNPIVOT 都退化为十几行循环代码。
一句话收尾:在 SQLMesh 里,重复 SQL 不是靠复制粘贴 + 全局替换解决的,而是靠"让宏在 AST 上循环"解决的。 从 @EACH 起步,遇到复杂需求升格到 Python 宏,输出尽量走 SQLGlot 表达式——这条路径能覆盖从单列 PIVOT 到全 Schema 治理的绝大多数工程场景。
参考资料
- SQLMesh macros(官方文档) —— @EACH、@IF、@FILTER、@REDUCE、User-defined macro functions、Typed Macros 各节
- Jinja macros(官方文档)
- Macro variables(官方文档)
- SQLGlot expressions API