从响应变慢到跑满 1000 并发:MCP 服务器 JMeter 压测与性能优化完全指南
【免费下载链接】mcp-for-beginners This open-source curriculum introduces the fundamentals of Model Context Protocol (MCP) through real-world, cross-language examples in .NET, Java, TypeScript, JavaScript, Rust and Python. Designed for developers, it focuses on practical techniques for building modular, scalable, and secure AI workflows from session setup to service orchestration.  项目地址: https://gitcode.com/GitHub_Trending/mc/mcp-for-beginners
几十个用户用 MCP 服务器没问题,一旦开放给整个团队,响应从 200 毫秒爬到 2 秒,还时不时超时报错。该问题在 mcp-for-beginners 这个跨语言 MCP 教学项目里可以完整复现与解决。本文用 JMeter 对 MCP 服务器做实战压测(JMeter 是 Apache 出品的开源负载测试工具),帮你从"感觉变慢"走到"用数据定位性能瓶颈、完成性能优化"。
压测前先过一遍清单:环境、工具、基准水位
压测失败十有八九是环境没准备齐。先按这张清单逐项打勾,再谈加载。
- 被测服务:按 部署指南 把 MCP 服务器跑起来。HTTP 传输的示例可以直接看 06-http-streaming 目录,它提供 Streamable HTTP 端点,天然适合 JMeter 打流量。
- 压测机:JMeter 5.5+ 建议配 Java 17;压测机 CPU 和内存要够,别让它自己先成为瓶颈。
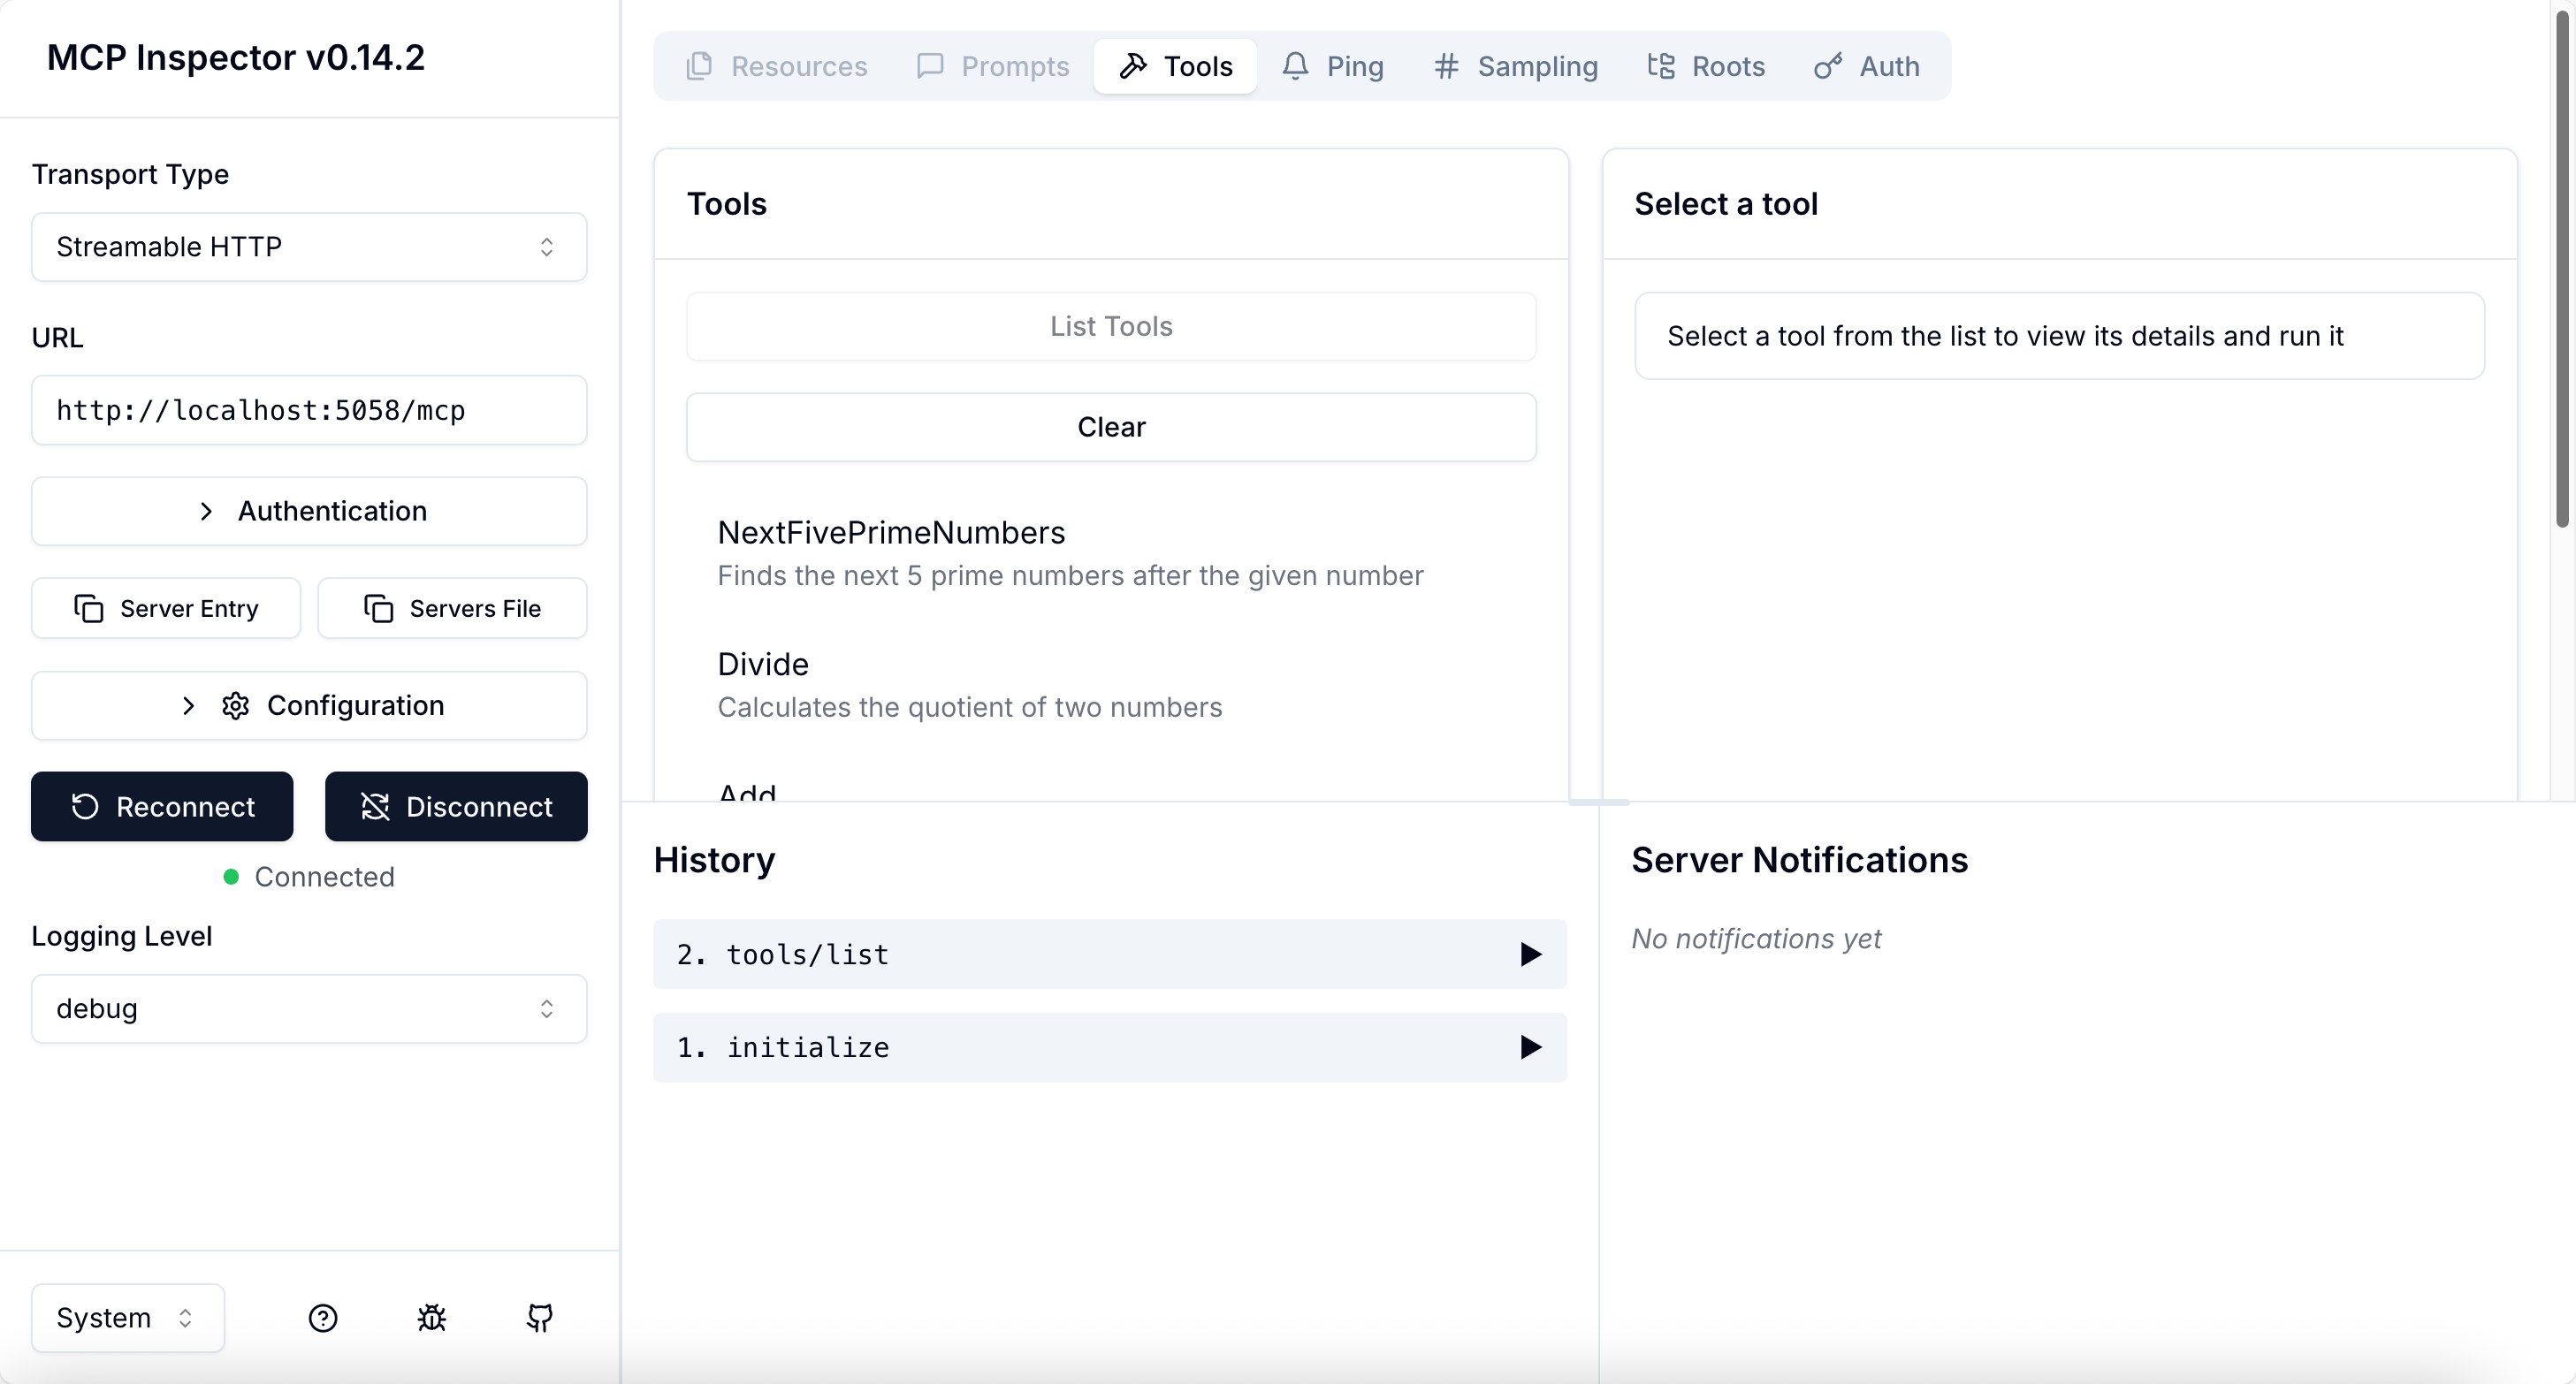
- 验证工具:用 MCP Inspector 先手动打通一次连接,确认工具列表能拉取、单条工具调用有正确返回(参考 02-client 示例)。
- 监控:压测期间服务器侧要能看 CPU、内存、连接数,监控章节 讲了如何接入指标采集。
- 基准水位:单用户、空载状态下先手工请求 10 次,记下平均响应时间。后面所有对比都以这个数为"零号基线"。
下图是用 MCP Inspector 连接 HTTP 型 MCP 服务器的状态,绿色 Connected 出现、History 里能看到 initialize 和 tools/list 请求,说明压测前置条件已就绪:
看对指标:P99 达标线怎么定
指标看错了,优化方向就会跟着错。四个核心指标,建议按下面的顺序看:
| 错误率 | 系统"能不能用" | 稳态下 < 0.1%,任何 5xx 都要有解释 |
| P99 响应时间 | 最倒霉的 1% 用户体验如何 | 生产场景控制在 500ms 内 |
| 吞吐量 | 单位时间能扛多少请求 | 记录拐点:并发再加、吞吐不再涨的那一点 |
| CPU / 内存 | 资源还剩多少余量 | 稳态 CPU < 70%,避免高峰期被 OOM |
两个新手常踩的坑:
- 只看平均值。平均 200ms 可能掩盖了 3% 的请求在 2 秒以上,务必同时盯 P90/P99 分位数。
- 达标线没有业务依据。上面 500ms 是通用参考值;如果你的调用里包含大模型推理,就该放宽到秒级并单独说明。先定线,再压测,顺序不能反。
设计一轮能跑通的压测:并发阶梯与负载场景
场景设计只回答一个问题:真实流量长什么样? 拆成三类用例:
执行要点:
- 测试计划文件命名后放进版本库,团队复用同一份 .jmx。
- 压测机本地磁盘要留够空间存 .jtl 结果文件;结果树(View Results Tree)只用于调试阶段,正式压测关掉,否则监听器本身会拖慢压测机。
- 命令行无头模式跑完整轮次:
jmeter -n -t mcp-test-plan.jmx -l results.jtl -Jthreads=200 -Jrampup=60
跑完先翻聚合报告,把上一节的四个指标按阶梯画成表,拐点在哪一级一目了然。
常见瓶颈的三种快速定位法
压出来问题不难,难的是快速归因。MCP 服务器的高频瓶颈就下面三种,对照表格查:
| 并发到某一级后 503 激增、连接被拒 | 连接池耗尽(数据库或下游客户端) | 看服务端日志的超时/获取连接失败关键字;观察连接数曲线是否顶到池上限 | 调大池上限并压测验证拐点右移;同时检查是否有慢请求长期占用连接 |
| 首波请求明显慢、随后恢复正常 | 模型或依赖冷启动加载 | 对比"第 1 分钟"与"第 5 分钟"的 P99;预热后复测 | 服务启动时预热加载;把冷启动延迟单独标注,不混入稳态指标 |
| 大请求体延迟陡增、小请求正常 | 网络带宽或序列化开销受限 | 固定并发、只变请求体大小,画"体积-延迟"曲线看斜率 | 启用压缩传输;上下文做裁剪或分页;必要时扩容网络带宽 |
诊断时记住一个原则:一次只改一个变量。改了池大小又调了 JVM 参数,指标好转了,你其实不知道是谁的功劳。
优化三件套与回测:改完必须再跑一轮
确认瓶颈后,按代价从低到高依次尝试缓存、连接池、运行时参数三件套:
spring:
datasource:
hikari:
maximum-pool-size: 20
connection-timeout: 30000
JAVA_OPTS="-Xms4g -Xmx8g -XX:MetaspaceSize=256m -XX:MaxMetaspaceSize=512m"
改完不能只说"感觉变快了",要回测:同一测试计划、同一并发档位再跑一轮,和基线对比。以 100 并发档为例,可接受的改善幅度:
| 吞吐量 | 95 req/s | 140+ req/s(提升 > 40%) |
| P99 | 480ms | < 300ms |
| 错误率 | 0.05% | 趋近 0 |
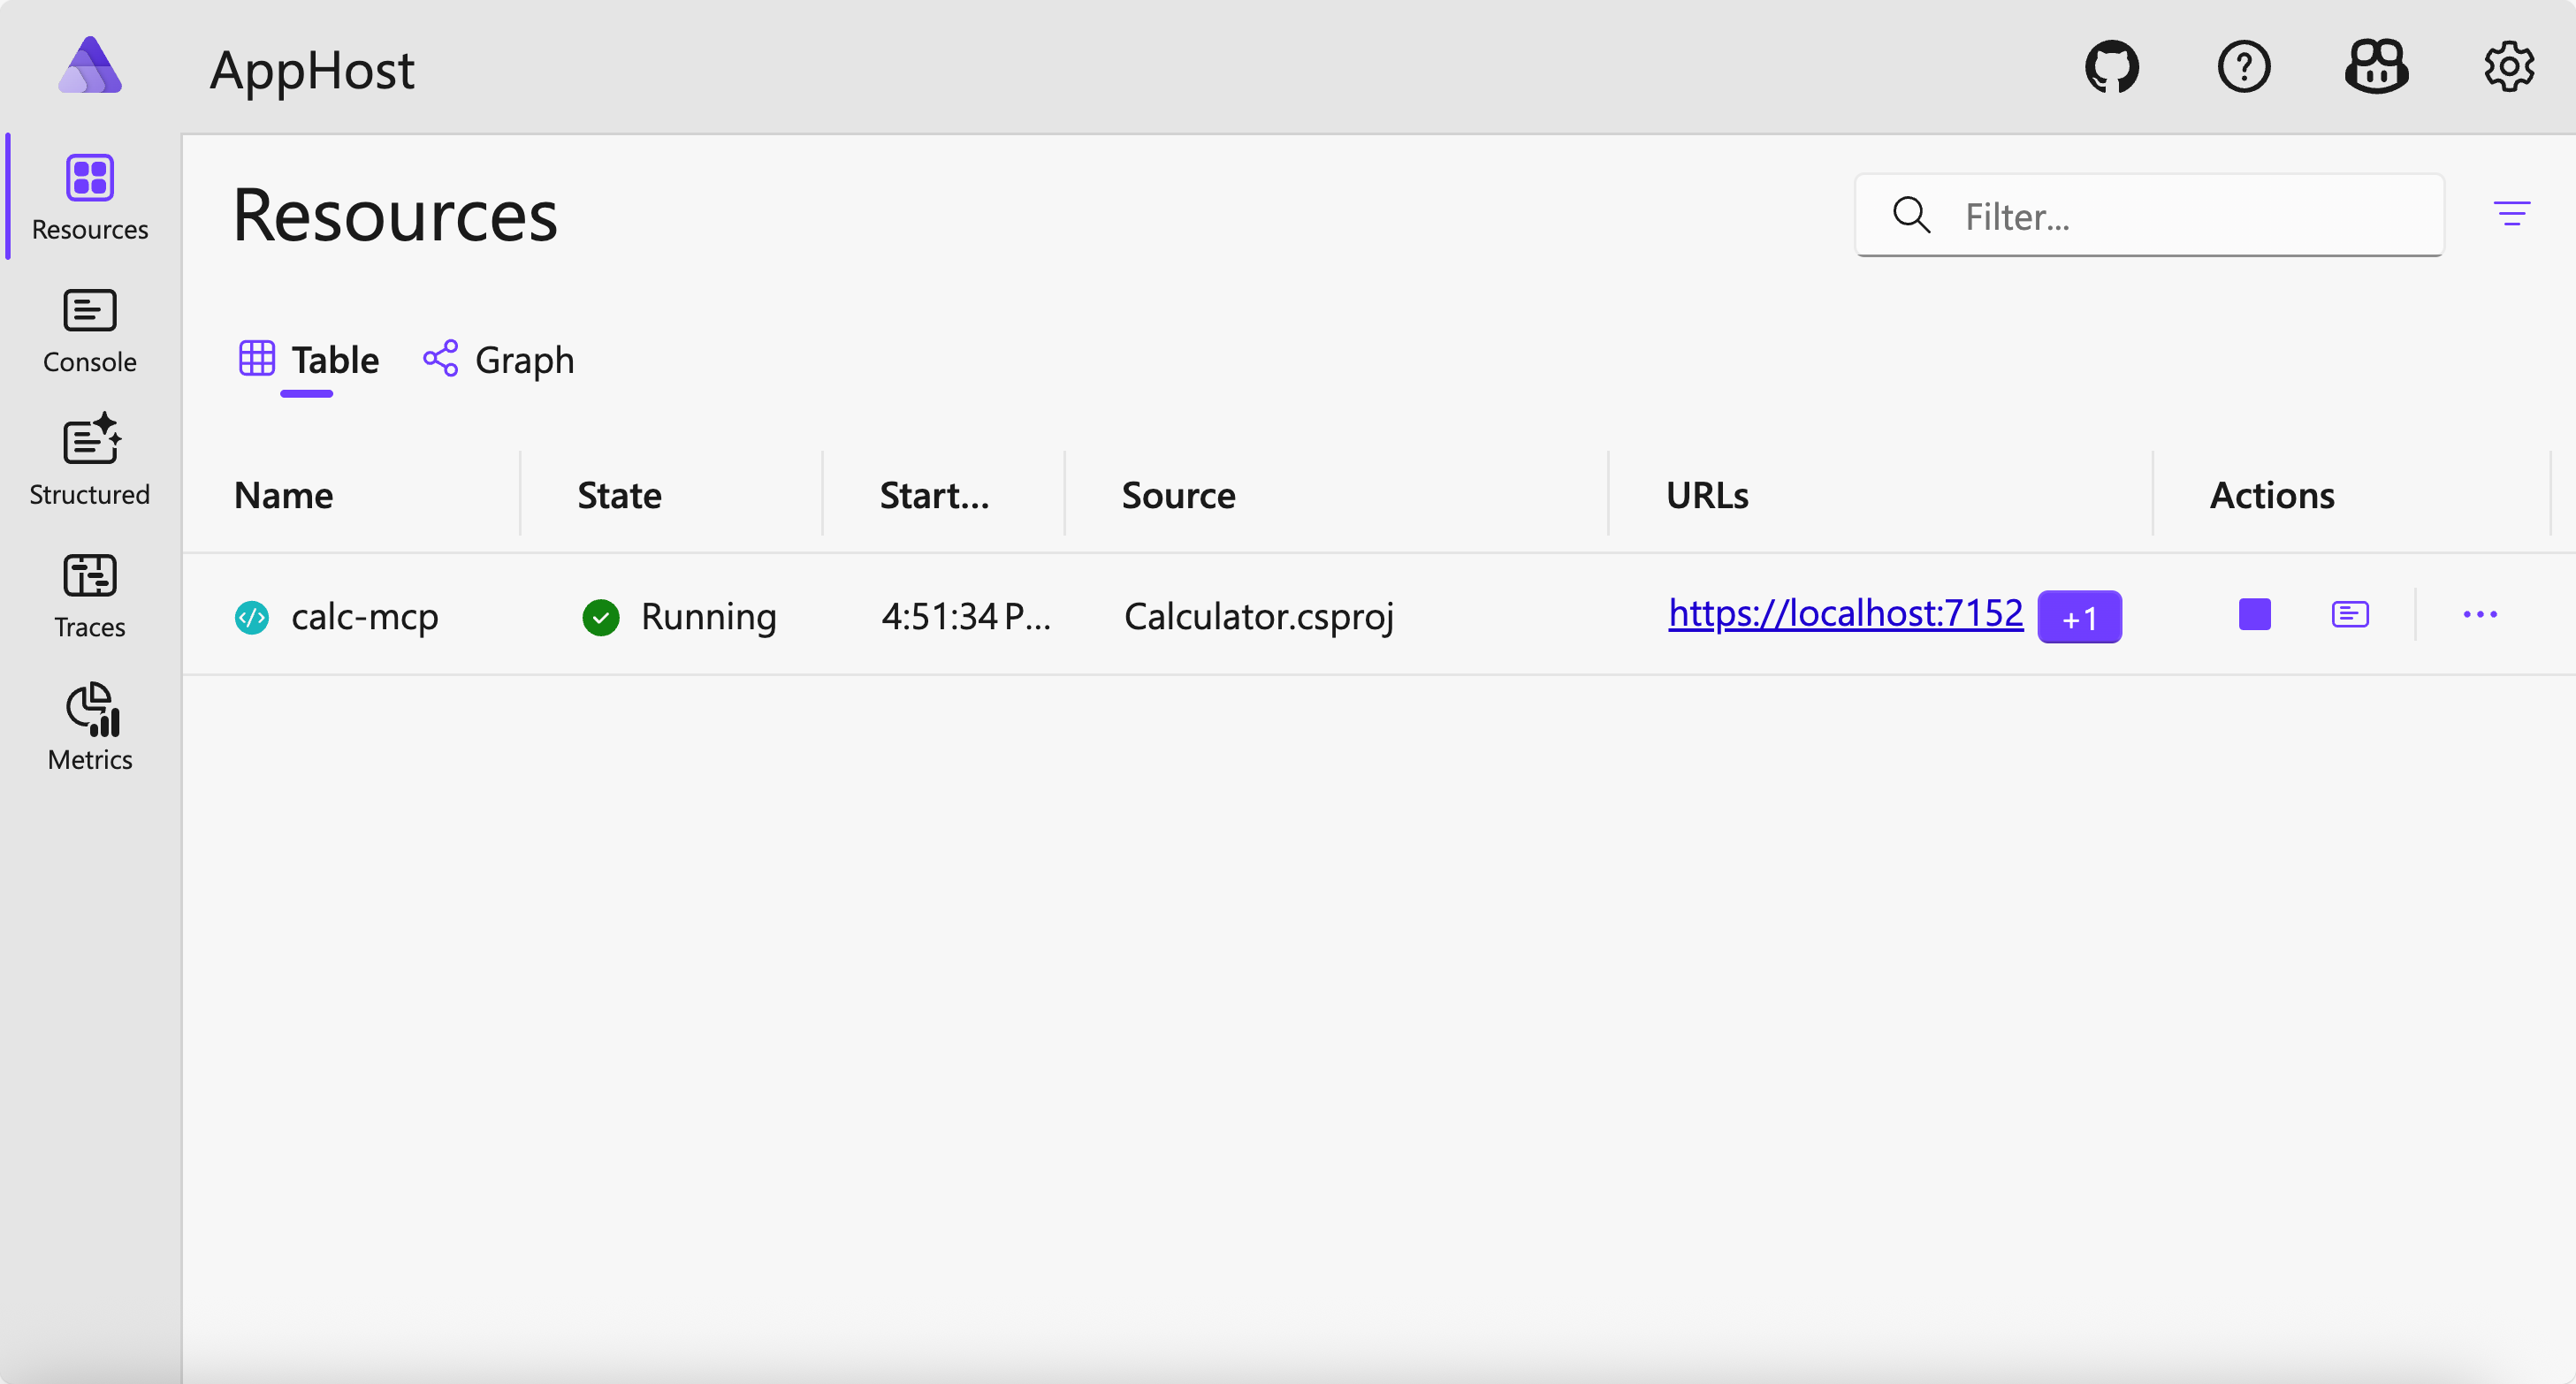
压测期间盯着监控面板确认资源没有顶满,下图是 .NET 示例里 AppHost 的资源状态视图,Running 状态下可核对服务持续在线:
进阶方向与项目资源导航
单节点压测跑通后,下一步通常是把视野放大:
- 分布式压测:单机 JMeter 打不到万级并发,用分布式模式把多个压测节点挂到同一个控制器上,模拟 10000+ 用户。
- 混沌测试:在稳态流量下随机杀掉实例、注入网络延迟,验证系统会不会优雅降级而不是雪崩。
- 水平扩展策略:负载均衡 + 多实例 + 分布式缓存的组合拳,扩展性章节 有 .NET 与 Java 两种实现的讲解。
项目内可以接着看的材料:
- 协议与客户端入门:03-GettingStarted/,含 MCP Inspector 使用教程
- 企业级实战案例(含性能调优场景):09-CaseStudy/
- 生产环境最佳实践:08-BestPractices/ 与 可靠性 sidecar 示例
- 安全约束下的性能权衡(限流、鉴权对吞吐的影响):02-Security/
压测不是上线前的一次性仪式,而是每周一次的健康检查。把基线数据沉淀下来,性能趋势比单次报告更有价值。
【免费下载链接】mcp-for-beginners This open-source curriculum introduces the fundamentals of Model Context Protocol (MCP) through real-world, cross-language examples in .NET, Java, TypeScript, JavaScript, Rust and Python. Designed for developers, it focuses on practical techniques for building modular, scalable, and secure AI workflows from session setup to service orchestration. 项目地址: https://gitcode.com/GitHub_Trending/mc/mcp-for-beginners
创作声明:本文部分内容由AI辅助生成(AIGC),仅供参考