我不会起名字322 · 后端 / 算法 / 数据库
📘 技术栈 | 🧩 力扣 Hot100 | 🐹 Go 项目 | 🟥 Redis | 🐬 MySQL
文章目录
- MySQL 的脏页什么时候写回:Buffer Pool、redo log 与 4 个刷脏时机
-
- 一、先建立三层结构的地图
- 二、Buffer Pool 的冷热分离:不是普通 LRU
- 三、redo log 的环形结构与 LSN
- 四、4 个刷脏时机
- 五、控制刷脏速度的 3 个参数
-
- 5.1 `innodb_io_capacity`:告诉 InnoDB 磁盘有多快
- 5.2 `innodb_max_dirty_pages_pct`:脏页比例上限
- 5.3 `innodb_flush_neighbors`:机械盘与 SSD 的分水岭
- 六、一份可以直接抄的配置清单
- 七、结论分三档写
- 八、小结
MySQL 的脏页什么时候写回:Buffer Pool、redo log 与 4 个刷脏时机
一条 UPDATE 明明只改一行、走的是主键索引,为什么监控上会突然出现几百毫秒的尖刺?更奇怪的是,尖刺过后业务完全恢复正常,数据也没丢。
答案通常在脏页写回上。InnoDB 的设计是"先在内存改,再找机会刷盘",这个"找机会"的时机选择,直接决定了你的写入延迟是平滑的还是有毛刺的。把 Buffer Pool、redo log、checkpoint 三者串成一条链,这几个抖动就都能解释了。
一、先建立三层结构的地图
一次更新,数据库里的数据要经过三层:
| Buffer Pool | 内存 | 页,默认 16KB | 读写都在这里发生,默认大小 128MB |
| redo log | 磁盘,顺序写 | 字节流 + LSN | 固定大小,循环写,用完会覆盖 |
| 表空间 | 磁盘,随机写 | 页 | 真正的数据落点,由刷脏推进 |
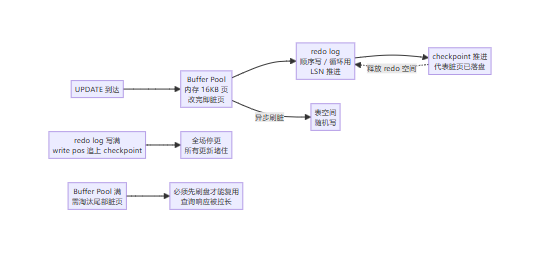
更新的实际顺序是:
UPDATE 到达
→ 数据页不在 Buffer Pool 就从磁盘读进来
→ 在内存里直接改这一页(此时内存与磁盘不一致 = 脏页)
→ 写 redo log(顺序 IO,很快)
→ 返回成功 ← 到这里客户端就已经拿到响应了
↑ 以上全部在内存 + 顺序写里完成,所以 UPDATE 很快
注意最后一步:响应返回时,数据页根本还没落盘。真正把脏页写到表空间是后面异步完成的。所以"UPDATE 快"和"刷脏慢"是两件互不干扰的事——干扰只发生在某个时间点、刷脏来不及的时候。
二、Buffer Pool 的冷热分离:不是普通 LRU
Buffer Pool 用 LRU 管理,但不是教科书里的那个 LRU。朴素 LRU 有两个致命问题:
- 预读失效:InnoDB 会线性预读相邻的页(innodb_read_ahead_threshold,默认 56:一个 extent 里顺序读满 56 页就预读下一个 extent)。预读进来但没被访问的页,会白白挤掉尾部的热数据。
- 缓冲池污染:一条 select * from user where name like '%John%' 全表扫描,会把大量冷页灌进池子,把真正的热数据全换出去。
InnoDB 的解法是把 LRU 链表切成两段:
| innodb_old_blocks_pct | 37 | 老生代(冷区)占整条链的比例,即新生代:老生代 ≈ 63:37 |
| innodb_old_blocks_time | 1000(毫秒) | 页进入冷区后,必须"停留超过 1 秒且被访问"才晋升到热区头部 |
这两条规则一起把预读失效和缓冲池污染都压住了:
- 新读入的页只放到冷区头部,不会被立刻当成热数据;
- 全表扫描扫到的页,1 秒内不会被晋升,扫描结束就被淘汰——这正是全表扫描不再冲垮缓冲池的原因;
- 热区的页被访问也不一定移动,只有热区后 3/4 被访问才挪到链表头,避免链表频繁调整带来的额外开销。
额外多实例的设置:Buffer Pool 默认只有 1 个实例(innodb_buffer_pool_instances = 1),大内存机器上建议按"每 GB 一个实例"切分,减少内部资源竞争。
— 看清楚当前配置
SHOW VARIABLES LIKE 'innodb_buffer_pool_size';
SHOW VARIABLES LIKE 'innodb_buffer_pool_instances';
SHOW VARIABLES LIKE 'innodb_old_blocks_pct';
SHOW VARIABLES LIKE 'innodb_old_blocks_time';
三、redo log 的环形结构与 LSN
redo log 是固定大小的,写满就绕回头覆盖最旧的部分。判断"哪些日志已经被安全落盘"的标准,是 LSN:
| write pos | 当前写到哪里 |
| checkpoint | 哪些日志对应的数据页已经刷盘、可以覆盖了 |
| write pos – checkpoint | 还空着多少位置,剩得越少写得越急 |
关系很直白:checkpoint 推进得越慢(脏页刷得越慢),可复用的 redo 空间就越少。当两者追平时,InnoDB 就没有新空间写日志了——这时只能停下所有更新,集中刷脏、推进 checkpoint。这就是"redo log 满了"的后果。
这也是为什么刷脏速度不是由一个固定参数决定的,而是被 redo 的剩余空间动态驱动的:剩余越少,刷得越猛。
四、4 个刷脏时机
| redo log 满 | write pos 追上 checkpoint | 全场停更:所有更新堵住,等刷脏推进 checkpoint |
| Buffer Pool 满 | 需要新页但池子没空位 | 淘汰尾部页:干净页直接复用;脏页必须先刷盘才能复用 |
| 系统空闲 | 没有请求 | 后台安静刷脏,无感 |
| 正常关闭 | mysqladmin shutdown | 全部脏页落盘,必然变慢 |
先记住两者的区别:第一种最致命,第二种最常见。
第一种(redo log 满)的表现是"连接都正常、SHOW PROCESSLIST 里全是 updating、但一个都不返回",同时 Innodb_buffer_pool_pages_dirty 会飙高。如果你的实例内存小、写入量大,每个小时都可能撞一次。
第二种是最常见的毛刺来源。一次查询需要读入若干页,必须淘汰尾部页;淘汰到干净页只要释放复用,淘汰到脏页就得先写盘。如果一次要淘汰的脏页太多,这次查询的响应时间就会明显变长——这就是文章开头那个几百毫秒尖刺的成因。
五、控制刷脏速度的 3 个参数
5.1 innodb_io_capacity:告诉 InnoDB 磁盘有多快
它表示"每秒能刷多少个页(IOPS)",默认值偏低,SSD 上必须调:
SHOW VARIABLES LIKE 'innodb_io_capacity'; — 默认 200
SET GLOBAL innodb_io_capacity = 2000; — SSD 上常见的取值
参考:机械盘 IOPS 只有几百,SSD 上千很轻松。在 SSD 上留默认的 200,等于让 InnoDB 以为自己只有机械盘的能力,刷脏会不必要地慢,redo 空间更容易被吃满。
5.2 innodb_max_dirty_pages_pct:脏页比例上限
默认 75%。这个值的含义是"脏页占 Buffer Pool 的比例接近它时,InnoDB 会全力刷脏"。说明书上的一句话要记住:不要让实际脏页比例接近 75%——一旦接近,说明刷脏已经跟不上写入,随时可能触发全场停顿。
实时监控脏页比例(这段 SQL 值得存下来):
SELECT
(SELECT VARIABLE_VALUE FROM performance_schema.global_status
WHERE VARIABLE_NAME = 'Innodb_buffer_pool_pages_dirty') AS dirty_pages,
(SELECT VARIABLE_VALUE FROM performance_schema.global_status
WHERE VARIABLE_NAME = 'Innodb_buffer_pool_pages_total') AS total_pages,
ROUND(
(SELECT VARIABLE_VALUE FROM performance_schema.global_status
WHERE VARIABLE_NAME = 'Innodb_buffer_pool_pages_dirty')
/ (SELECT VARIABLE_VALUE FROM performance_schema.global_status
WHERE VARIABLE_NAME = 'Innodb_buffer_pool_pages_total')
* 100, 2) AS dirty_pct;
dirty_pct 长期在 30% 以内是健康的;持续高于 60% 就该扩内存或者调 innodb_io_capacity 了。
5.3 innodb_flush_neighbors:机械盘与 SSD 的分水岭
这个参数控制"刷一个脏页时,要不要顺便把相邻的脏页也一起刷"。相邻刷对机械盘是净收益(顺序 IO 比随机 IO 快得多),但对 SSD 是纯负担——SSD 的随机 IOPS 本来就上千,多刷相邻页只是白白增加写放大。
MySQL 8.0 里它的默认值已经是 0(不刷相邻),如果你是从 5.7 升级过来的老实例,这一项一定要检查。
六、一份可以直接抄的配置清单
| innodb_io_capacity | 200 | 2000 | 告诉 InnoDB 真实 IOPS |
| innodb_max_dirty_pages_pct | 75 | 60 | 留出更多余量 |
| innodb_flush_neighbors | 1 | 0 | SSD 上必须关 |
| innodb_buffer_pool_size | 内存的 50%~70% | 同左 | 池子越大,脏页尖刺越少 |
| innodb_buffer_pool_instances | 1 | 内存 GB 数 | 减少内部竞争 |
改完之后的验证方式很直接:盯 dirty_pct 的曲线。改之前它在白天长期在 60%~70% 之间游走,改之后应该稳定压到 30% 以下,同时应用侧的写入 P99 毛刺消失。
七、结论分三档写
- 现象(可复现的数字):写入 P99 从 8ms 突增到 420ms,dirty_pct 同期从 24% 升到 68%,innodb_io_capacity 为默认值 200,SHOW ENGINE INNODB STATUS 的 LOG 段显示 checkpoint 与 write pos 距离在收窄。
- 已排除的解释:已排除锁竞争——同期 Innodb_row_lock_time_avg 无变化;已排除慢 SQL——慢日志在该时段只有 3 条,均为 1.2s 以外的其他业务;已排除磁盘故障——iostat 的 %util 峰值 41%,未打满。
- 尚未证实的猜测:把 innodb_io_capacity 从 200 提到 2000 后尖刺消失,但还需要在写入量翻倍的压测下复现一遍,才能确认是"IO 能力设置偏低"而不是"内存不够";另外同机另一个实例的刷脏是否互相抢 IO,暂未隔离验证。
八、小结
脏页写回这件事,记住三句话就够用:
反过来,如果尖刺不是来自刷脏,而更可能是锁在等,那就是另一条排查链路了——那部分在《一条 UPDATE 等了 30 秒:InnoDB 锁等待的完整排查链路》和《MVCC 快照读为什么读不到刚提交的数据》里分别讲过。先分清是"写不进去"还是"等不到",再决定看 Buffer Pool 还是看锁。