上一篇我们聊了索引的设计策略:怎么建复合索引、什么时候用部分索引、INCLUDE 的收益边界在哪里。但建好索引只是开始。真实的生产库跑上几个月,往往会积累出一堆“看起来有用、实际没用”的索引——有的因为查询写法失效,有的因为统计信息过期被优化器放弃,有的因为 MVCC 膨胀到体积是合理值的几倍,还有的纯粹是冗余。这一篇,我们把索引从“建”到“管”的常见问题逐一拆开:为什么索引没被使用?怎么找到没用的索引?找到了之后怎么安全地清理?
一、索引失效的四种高频场景:先确认“到底用没用”
在讨论“索引没用”之前,第一步永远是用执行计划确认事实,而不是凭感觉猜。
EXPLAIN (ANALYZE, BUFFERS)
SELECT ... FROM your_table WHERE ...;
重点看三件事:是 Seq Scan 还是 Index Scan;Filter 后面有没有出现对索引列的转换或函数;Rows Removed by Filter 是否远大于实际返回的行数。如果执行计划显示全表扫描,而查询条件又确实有索引,再往下对号入座。
场景一:隐式类型转换——最常见、也最隐蔽
当查询参数的类型与索引列的类型不一致时,PostgreSQL 可能触发隐式转换。如果转换发生在索引列一侧,B-tree 存储的原始值就无法直接匹配,索引失效。
一个典型例子:device_id 是 VARCHAR,查询却写成 WHERE device_id = 12345678(整数)。执行计划中的 Filter 会显示类似 (device_id)::text = '12345678'::text——转换被加在了索引列上,而不是参数上,索引自然用不上。
— 失效写法
WHERE device_id = 12345678;
— 修复:显式转换参数,而不是转换列
WHERE device_id = 12345678::text;
同样的陷阱也出现在 BIGINT 列用字符串查询(WHERE id = '100'),以及 JOIN 两边的关联列类型不一致的场景。修复的核心原则:让参数去匹配列的类型,而不是让列去匹配参数的类型。
场景二:函数包裹索引列——破坏了 B-tree 的有序性
B-tree 索引存储的是列的原始值。一旦查询对索引列做了函数运算,比如 WHERE EXTRACT(YEAR FROM order_date) = 2023 或 WHERE lower(email) = '…',优化器无法用原始值的有序结构去匹配函数计算后的结果,索引失效。
两条修复路径:
— 路径一:创建匹配的表达式索引
CREATE INDEX idx_sales_order_year ON sales (EXTRACT(YEAR FROM order_date));
— 路径二:改写查询,避免函数包裹
WHERE order_date >= '2023-01-01' AND order_date < '2024-01-01'
表达式索引的代价是每次写入都要重新计算表达式,适合高频且稳定的函数查询;改写查询往往更轻量,但需要业务逻辑允许。
场景三:统计信息过期——优化器“算错了账”
即使索引可用,优化器也可能主动选择 Seq Scan。PostgreSQL 依靠 ANALYZE 收集的统计信息(行数、数据分布、不同值数量)来估算不同执行计划的成本。如果统计信息严重过期,优化器可能错误地认为“全表扫描更便宜”。
典型触发场景:大批量导入或清空重建之后没有执行 ANALYZE。CREATE INDEX 虽然会更新部分统计信息(如 reltuples),但它不会替代完整的统计收集。表的数据分布已经彻底变了,优化器的估算却还停留在旧世界。
— 修复:手动收集统计信息
ANALYZE your_table;
— 如果是高频写入的表,确认 autovacuum 的 ANALYZE 阈值是否跟得上
判断统计信息是否失真的一个实用信号:EXPLAIN ANALYZE 中估算的 rows 与实际返回的行数差距是否超过 20%。如果差距很大,先跑 ANALYZE,再重新看计划。
场景四:选择率过高——索引“不划算”,而不是“失效”
如果查询返回的行数占表的比例过高(通常超过 5%–10%),索引扫描需要随机访问大量堆页,成本可能高于顺序扫描。优化器选择 Seq Scan 是理性决策,不是 bug。
— status 只有几个值,查询覆盖 40% 的行
WHERE status IN ('paid', 'shipped');
这种情况下,不要用 SET enable_seqscan = off 强行逼索引。更有效的方向是:创建部分索引只覆盖高频子集,或者用覆盖索引(INCLUDE) 减少回表,让索引扫描的“性价比”真正提升。
二、未使用索引:用 pg_stat_user_indexes 识别,但不要急着删
索引失效讨论的是“有索引但查询没用上”。另一种问题是索引建了,但根本没有任何查询在用——它不加速任何操作,却在每一次写入时被维护。
识别方法
SELECT
schemaname,
relname AS table_name,
indexrelname AS index_name,
idx_scan,
pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
idx_scan = 0 表示自统计信息上次重置以来,这个索引没有被任何索引扫描使用过。idx_scan 很低(比如 1–2 次)也值得关注——对于一个跑了一个月的库,个位数的扫描次数通常意味着“可有可无”。
清理前的四条安全红线
第一,唯一索引和主键索引不能仅凭 idx_scan = 0 删除。 它们承担约束职责,即使从未被用于查询加速,也不能删。
第二,统计信息可能刚被重置。 pg_stat_reset() 或数据库重启都会让计数器归零。至少观察一个完整的业务周期(通常一个月,覆盖月末报表、批处理等低频但关键的操作)再做判断。
第三,低频但关键的查询可能“恰好”没被统计到。 一个季度跑一次的合规对账,可能在未来一周内触发一次全表扫描,而它依赖的索引在当前的 idx_scan 中显示为 0。删除前,对照 pg_stat_statements 中是否有相关查询模式,或者与业务方确认。
第四,先 “停用” 而不是直接 DROP。 安全做法是把索引设为不可见(ALTER INDEX … SET (enabled = off),部分版本/扩展支持)或者先重命名为 _deprecated 后缀,观察一个周期确认没有查询报错或变慢,再执行 DROP INDEX CONCURRENTLY。
— 安全删除
DROP INDEX CONCURRENTLY idx_never_used;
未使用索引的真正代价不在空间,而在写入。 每一次 INSERT/UPDATE/DELETE 都要维护所有索引;autovacuum 在清理表之前会先清理索引,大量未使用的索引会显著拖慢 autovacuum,进而加剧死元组堆积和膨胀。清理未使用索引,同时是在为 autovacuum 减负。
三、索引膨胀:不报错、不告警,只会让系统慢慢变慢
PostgreSQL 的 MVCC 机制下,UPDATE 和 DELETE 不会原地清理旧版本行,索引条目同样留下死元组。长期运行的 OLTP 库中,索引体积达到合理值的 2–5 倍并不罕见。膨胀本身不触发错误,但它会稀释缓存命中率:同样大小的 shared_buffers 能缓存的“有效索引页”变少了,查询需要读更多页才能找到目标条目。
量化膨胀:pgstattuple 的 avg_leaf_density
CREATE EXTENSION IF NOT EXISTS pgstattuple;
SELECT * FROM pgstatindex('idx_orders_user_id');
返回结果中的 avg_leaf_density 是关键指标:叶子页的平均密度。密度低于 70% 通常说明膨胀已经明显,重建是有收益的。leaf_fragmentation 和 deleted_pages 可以辅助判断碎片和死条目的分布。
如果生产环境不方便对索引做全量扫描,可以用 pg_stat_user_indexes 和 pg_class 做粗略估算(n_dead_tup 与 relpages 对比),但重建决策前建议用 pgstatindex 复核,因为估算误差可能较大。
在线重建:REINDEX CONCURRENTLY 是首选,但有前置条件
PostgreSQL 12+ 的 REINDEX INDEX CONCURRENTLY 允许在不阻塞读写的情况下重建索引:构建新索引,然后原子替换。
REINDEX INDEX CONCURRENTLY idx_bloated;
但“不阻塞”不等于“无代价”。执行前需要确认三件事:
- 没有长事务持有旧快照。 CONCURRENTLY 重建需要等待持有旧快照的事务结束,一个运行数小时的长事务会直接卡住重建过程。
- 磁盘有足够余量。 重建期间新旧索引并存,至少需要该索引大小 1.1 倍以上的空闲空间。
- 一次只重建一个。 并发重建多个大索引会互相放大 I/O 和 WAL 压力,串行执行并观察系统指标。
一个重要的诊断提醒: 如果 REINDEX CONCURRENTLY 之后查询性能没有改善,问题很可能不在索引膨胀,而在表膨胀。索引重建了,但堆表上的死元组仍然让扫描需要读大量无效页。这时应该用 pgstattuple 检查表的膨胀情况,考虑 VACUUM 或 pg_repack。
四、冗余索引:两种形态,检测思路不同
冗余索引有两种常见形态,清理前者几乎总是安全的,清理后者需要更谨慎的判断。
形态一:完全重复的索引
两个索引的列、顺序、条件、表达式完全一致,只是名字不同。这通常是迁移、重建或多人协作时“不小心建重了”。
检测思路:对比 pg_index 中的 indkey(索引列数组)和 indclass,在同一张表上找出定义完全相同的索引。清理时保留承载约束的那个(UNIQUE/PRIMARY KEY),删除多余的那个。
形态二:前缀重叠的复合索引
索引 A (col1) 和索引 B (col1, col2) 并存。B 可以完全覆盖 A 的能力(最左前缀),而 A 不能覆盖 B。A 是 B 的前缀冗余。
CREATE INDEX idx_a ON t (col1);
CREATE INDEX idx_b ON t (col1, col2);
— idx_a 是 idx_b 的前缀冗余,可以评估删除
检测思路:在同一张表上,判断一个索引的键列数组 indkey 是否是另一个索引 indkey 的前缀子集。如果是,前者很可能是冗余的。
但前缀冗余的清理需要比“完全重复”更谨慎: 如果 idx_a 是一个非常小、被高频使用的索引,而 idx_b 很宽、维护成本高,删除 idx_a 可能让那些只查 col1 的查询被迫使用更宽的 idx_b,扫描的索引页反而增多。在删除前缀冗余索引前,对比两者的 idx_scan 和实际查询模式,确认宽索引确实能“接住”所有原本走窄索引的查询,且性能不下降。
五、一套可操作的排查流程
把上面的内容串成一个从“发现问题”到“安全清理”的流程。
第一步:从慢查询出发,而不是从索引列表出发。 用 pg_stat_statements 找到高 total_exec_time 或高 mean_exec_time 的查询,对它们跑 EXPLAIN (ANALYZE, BUFFERS)。先确认问题到底是“索引失效”还是“根本没有合适的索引”。
第二步:对确认失效的索引,按场景修复。 隐式转换 → 显式转换参数;函数包裹 → 表达式索引或改写查询;统计信息过期 → ANALYZE;选择率过高 → 部分索引或覆盖索引,而不是强行逼索引。
第三步:独立地、周期性地审计未使用索引。 用 pg_stat_user_indexes 找出 idx_scan = 0 或极低的索引,排除唯一/主键索引,观察足够长的业务周期后,用 DROP INDEX CONCURRENTLY 安全清理。
第四步:对高频写入的大表,监控索引膨胀。 用 pgstattuple 的 avg_leaf_density 量化膨胀,密度低于 70% 时评估 REINDEX CONCURRENTLY。重建后如果没有改善,转去检查表膨胀。
第五步:清理完全重复和明确的前缀冗余。 完全重复的索引优先删除;前缀冗余的索引,用实际查询模式验证宽索引能否接住后再决定。
六、总结
| 隐式类型转换 | 参数类型与索引列不一致,转换发生在列一侧 | EXPLAIN 中 Filter 出现 (col)::type | 显式转换参数;或统一物理类型 |
| 函数包裹索引列 | B-tree 存储原始值,函数结果无法匹配 | 执行计划 Filter 中出现函数表达式 | 表达式索引;或改写查询避免函数 |
| 统计信息过期 | 优化器基于旧分布估算成本,误判 Seq Scan 更优 | 估算 rows 与实际行数差距 >20% | ANALYZE;调校 autovacuum 阈值 |
| 选择率过高 | 索引扫描随机 I/O 成本高于顺序扫描 | 查询返回行数占比高,优化器主动选 Seq Scan | 部分索引;覆盖索引;不强行逼索引 |
| 未使用索引 | 建了但无查询使用,只消耗写入和 autovacuum 成本 | pg_stat_user_indexes.idx_scan = 0 | 观察完整周期后 DROP INDEX CONCURRENTLY;唯一/主键除外 |
| 索引膨胀 | MVCC 死元组留在索引页,页密度下降 | pgstattuple 的 avg_leaf_density < 70% | REINDEX CONCURRENTLY;检查表膨胀 |
| 完全重复索引 | 定义完全一致,仅名称不同 | 对比 pg_index 的 indkey/indclass | 保留约束索引,删除多余者 |
| 前缀冗余索引 | 窄索引的列是宽索引的前缀 | indkey 前缀子集关系 | 验证宽索引能接住后删除窄索引 |
两句话回答核心问题:
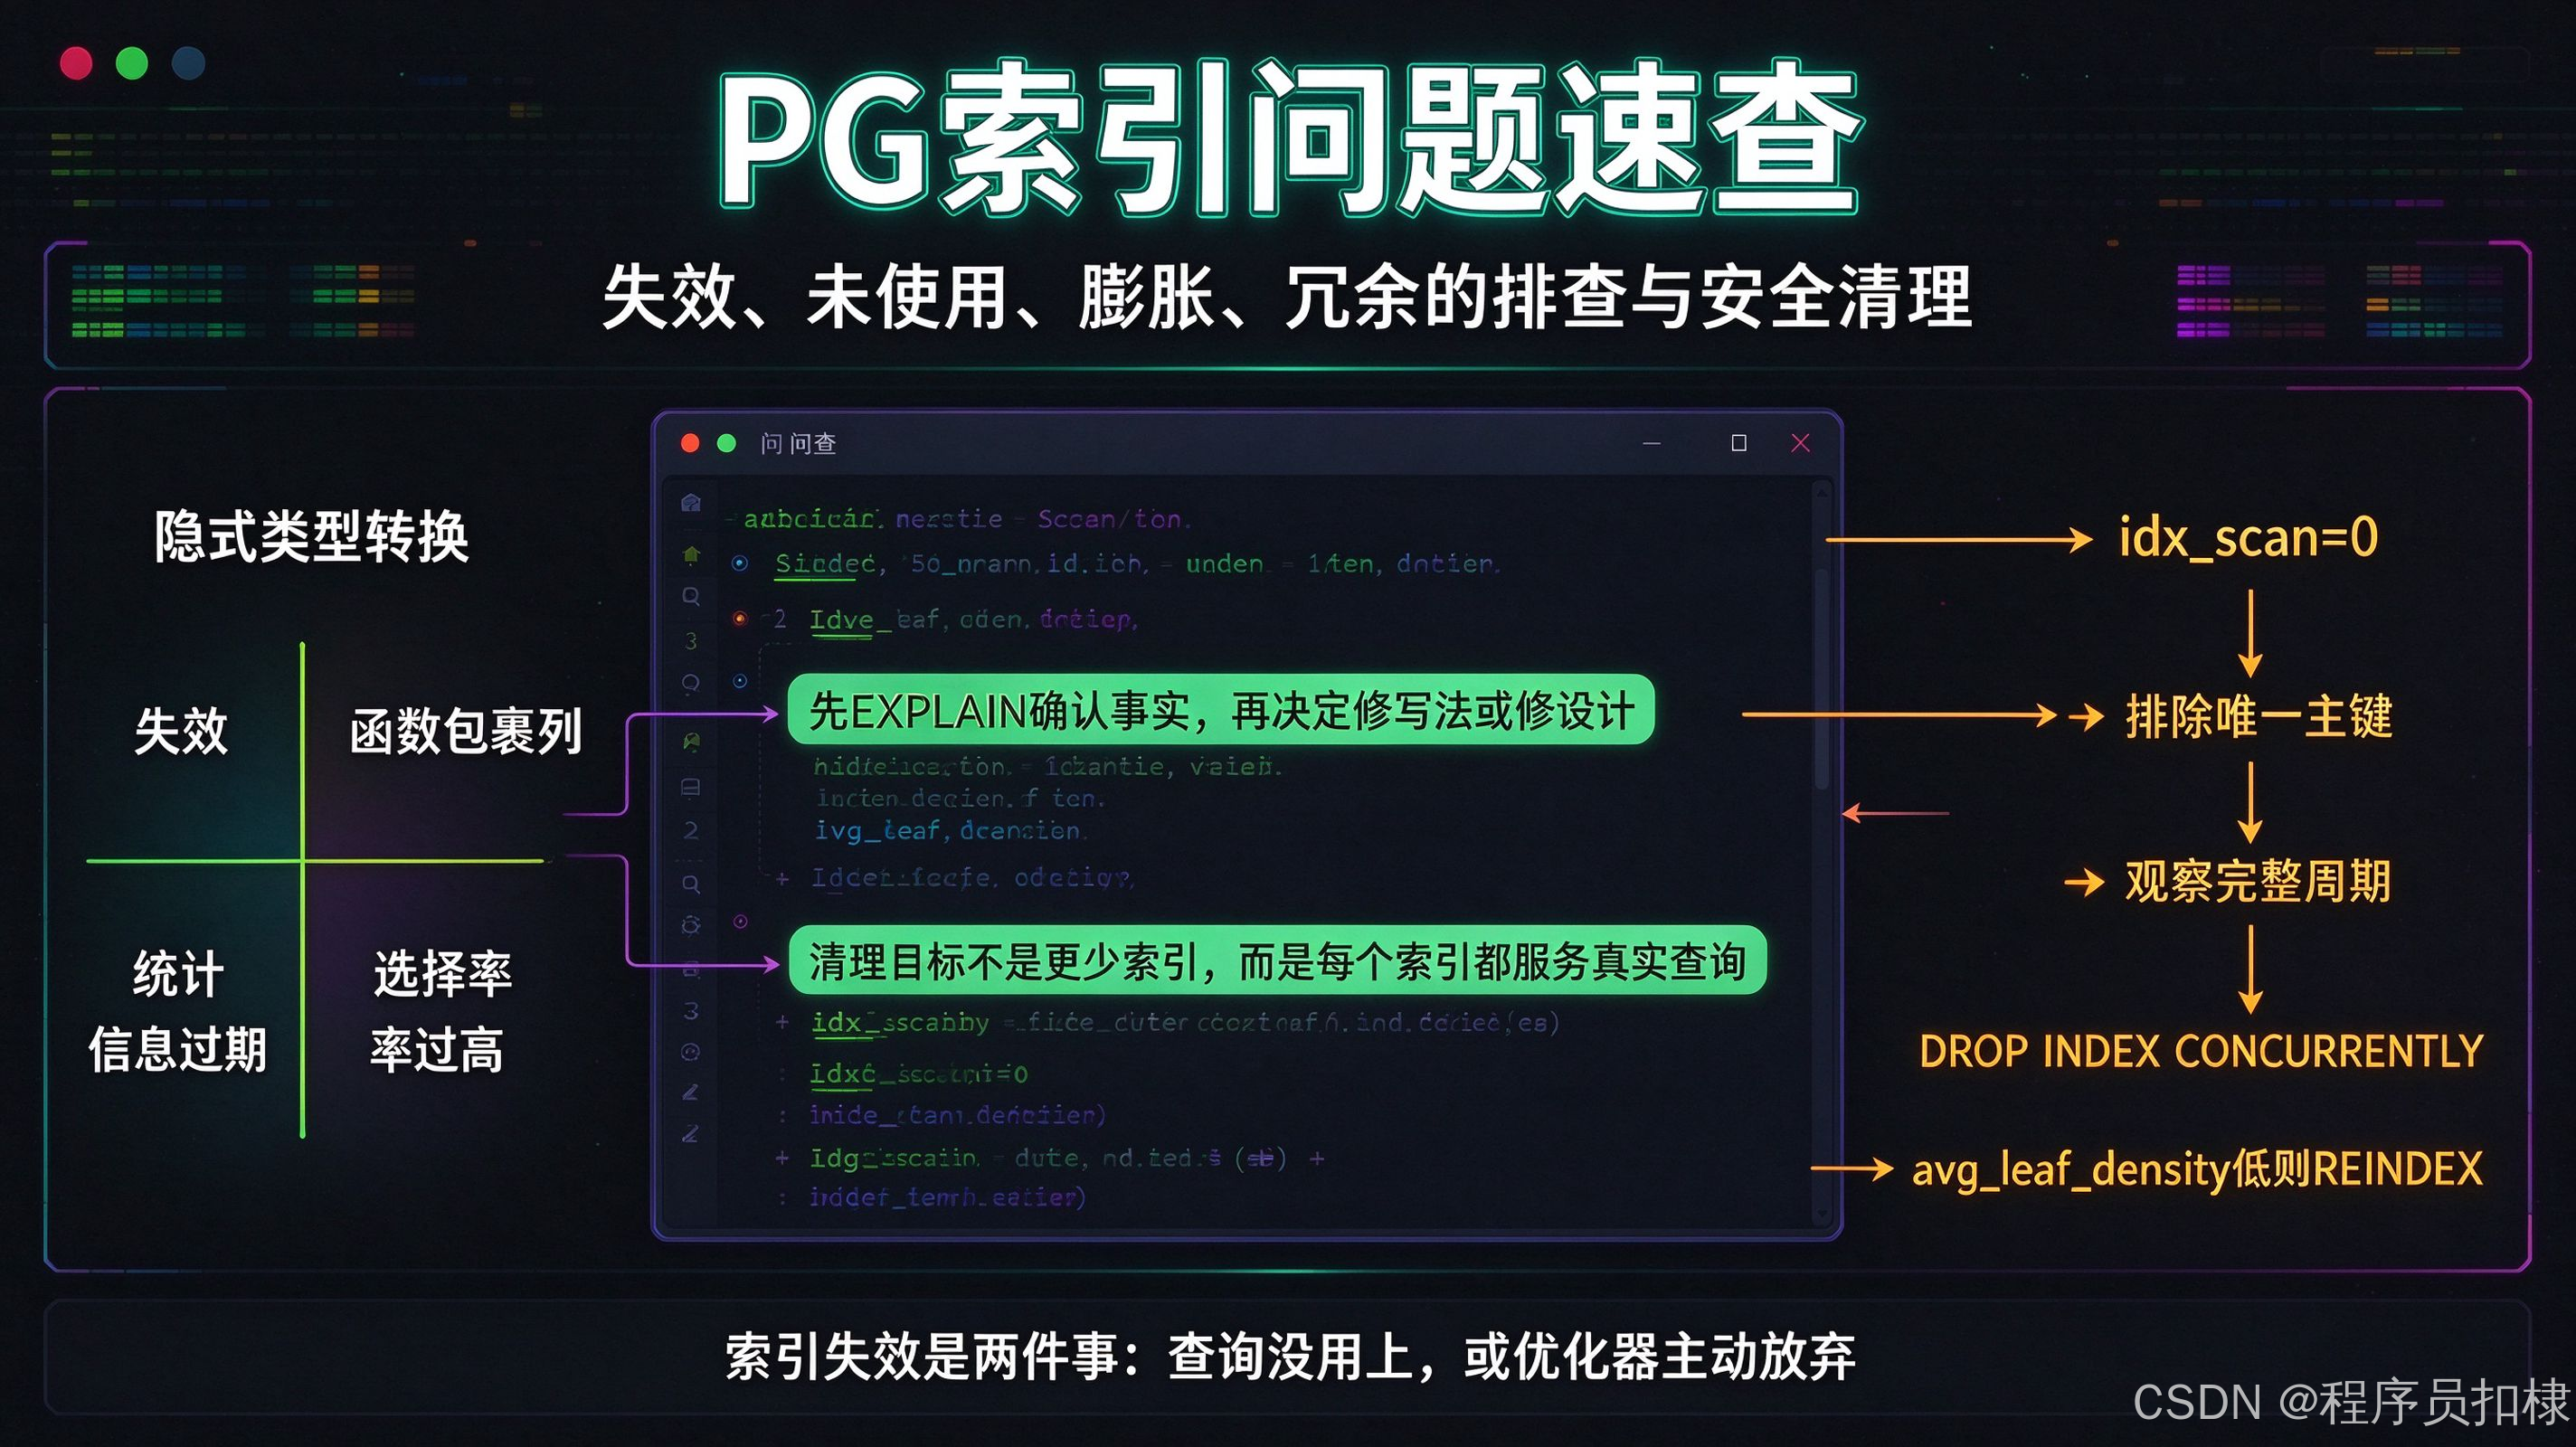
为什么索引没被使用? 先看执行计划,再对号入座:隐式转换让索引列被函数包裹、函数操作破坏了 B-tree 有序性、统计信息过期让优化器算错成本、选择率过高让索引“不划算”。索引失效和执行计划主动放弃索引是两件事,前者修写法,后者修设计。
如何清理无用索引? 用 pg_stat_user_indexes 的 idx_scan 识别“从未被使用”的索引,排除唯一/主键索引,观察完整业务周期后用 DROP INDEX CONCURRENTLY 删除;对膨胀索引用 pgstattuple 量化密度,低于 70% 时 REINDEX CONCURRENTLY;对冗余索引,完全重复的直接清,前缀冗余的先验证宽索引能接住。清理的目标不是“索引越少越好”,而是“每一个保留下来的索引,都在为某个真实查询服务”。
下一篇,我们进入执行计划解读:EXPLAIN 输出中的 cost、rows、width 到底在说什么?Seq Scan、Index Scan、Bitmap Scan 分别适合什么场景?Nested Loop、Hash Join、Merge Join 如何选择?
思考题:
你库里有没有 idx_scan = 0 但一直没删的索引?如果有,它占了多少空间、每次写入多维护了多少 B-tree?另外,你有没有遇到过 REINDEX CONCURRENTLY 之后查询没变快的情况——当时有没有意识到问题可能出在表膨胀,而不是索引膨胀?欢迎在评论区聊聊。