在 Simulink 中做多电机控制,最常遇到的困惑就是:同一份逻辑,到底该用普通子系统、封装子系统、引用子系统,还是引用模型?选错了,轻则代码冗余、模型臃肿,重则多人协作时版本管理一团乱麻。本文用一张对比表 + 实战案例,帮你把这几类子系统的本质、适用场景和代码生成差异一次讲清楚。
一、普通子系统VS封装子系统VS引用子系统VS引用模型
| 英文 | Subsystem | Mask Subsystem | Referenced Subsystem | Model Reference | Model Reference |
| 本质 | 同一模型内的分组框 | 子系统 + 自定义界面 | 独立的 .slx 文件 | 独立 .slx | 一个块里装多个候选实现,编译时选一个 |
| 复用方式 | 复制(副本各自独立) | 库链接,改库可同步 | 多处实例,同一份 | 多处实例,同一份 | 配置切换 |
| 双击看到 | 内部原始图 | 弹出参数配置框 | 打开那个 .slx | 打开那个 .slx | 变体选择/当前实现 |
| 内容存放 | 父模型内 | 父模型内 / 库里 | 独立 .slx | 独立 .slx | 父模型内 |
| 内容独立成文件 | ✗ | ✗ | ✓ | ✓ | ✗ |
| 编译/代码生成 | 内联进父模型 | 内联进父模型 | 内联进父模型 | 独立编译,支持增量 | 只编译被选中的那个 |
| 大项目编译速度 | 慢 | 慢 | 慢(每次重编) | 快(增量) | 只编选中的 |
| 生成代码 | 内联进父模型 | 内联进父模型 | 内联进父模型 | 独立 .c/.h | 只生成选中分支 |
| 能否单独仿真 | ✗ | ✗ | ✗ | ✓ | ✗ |
| 能否自设采样率/状态 | 否(跟随父模型) | 否 | 否 | 能独立设置 | 否 |
| 里面能否再放 Model 块 | ✓ | ✓ | ✗ | ✓(支持分层) | ✓ |
| 接口(Inport/Outport) | 有 | 有 | 有 | 有,且是严格契约 | 各分支各自有 |
| 主要用途 | 整理画布 | 组件复用、隐藏细节 | 轻量复用 + 独立文件 | 大项目 / 分工 / 加速 | 配置与版本切换 |
| 主要代价 | 无复用能力 | 要维护库 | 无独立编译 | 搭建与接口管理复杂 | 变体管理复杂 |
| 典型场景 | 整理画布 | 做可复用组件、隐藏细节 | 多人分工、大项目、独立测试 | 硬件/算法/配置版本切换 |
二、Subsystem普通子系统
画布清爽,但没有复用机制:复制出来的副本互不相干,改一个不影响另一个。
普通子系统分两种:虚拟子系统 / 原子子系统 (Atomic)
- 拟子系统(默认):只是视觉分组,代码不会单独生成函数,代码会平铺到上层函数
- 勾选 Treat as atomic unit → 原子子系统:作为独立调度单元,单独生成 C 函数
适合:当前模型内分层,把上下电逻辑、故障逻辑分块,不适合大量复用
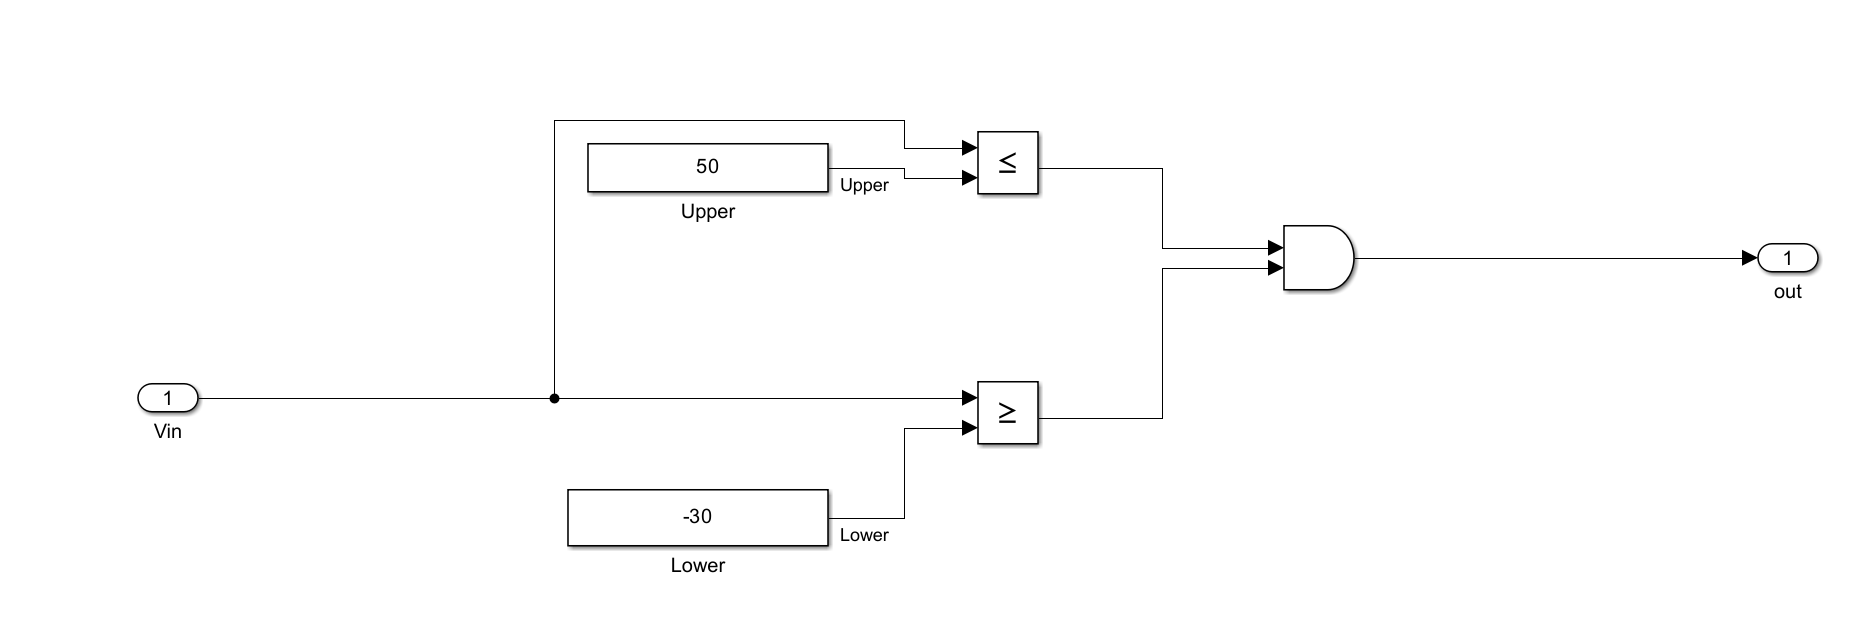
全选,ctr+G
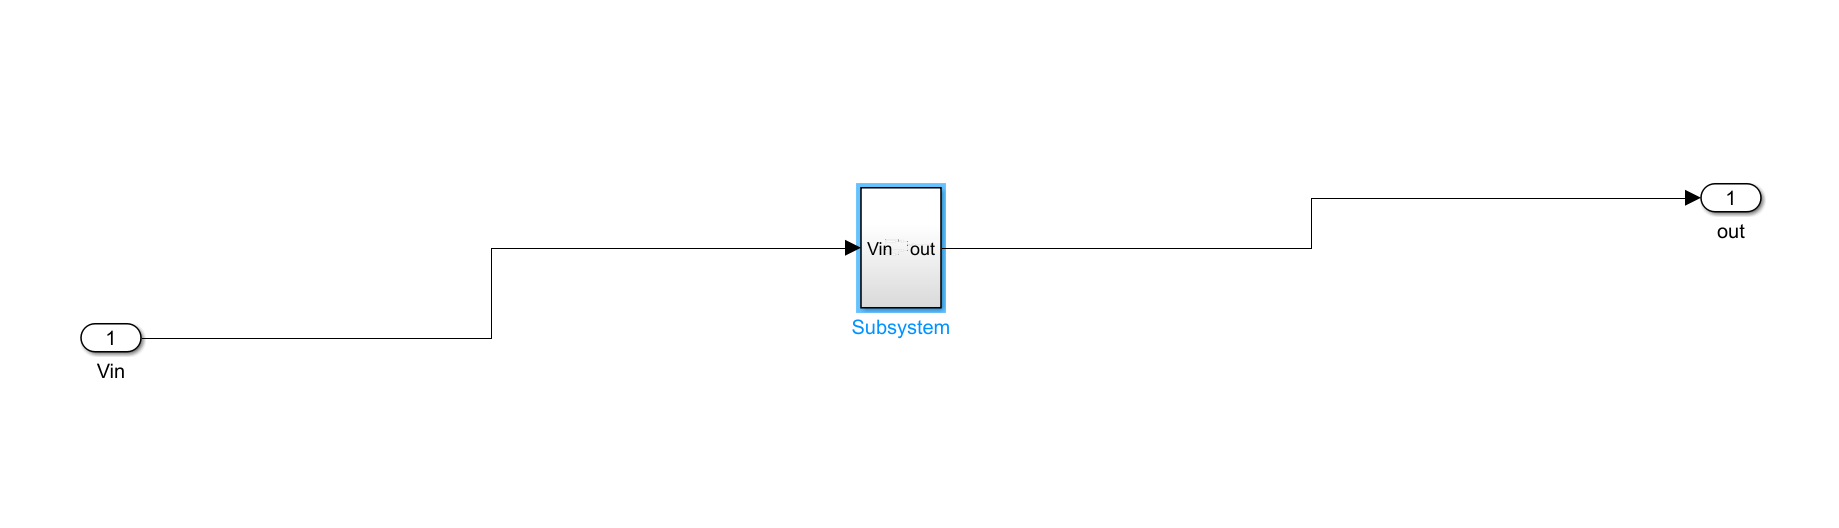
三、封装子系统Mask Subsystem (Ctrl+M)
子系统 + Mask
Mask 给它一个自定义对话框(比如让你填“采样周期”“限幅值”),把实现藏起来。通常放在自定义库里,像 Simulink 原生模块一样拖拽使用、改库即全更新。
注意:Mask 是参数界面,不是加密。要保护内容得靠库链接只读或密码保护。
⚠️重点:所有实例的底层模型全部保存在当前 slx 里面,复制多少次,模型体积都会膨胀;多人协同版本管理不方便。
1、创建流程
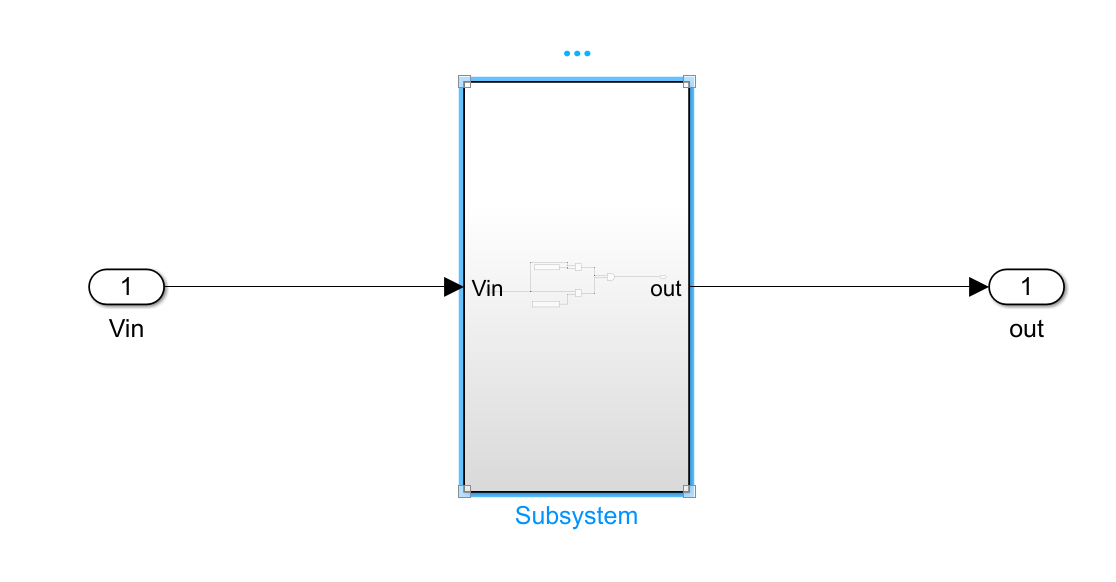
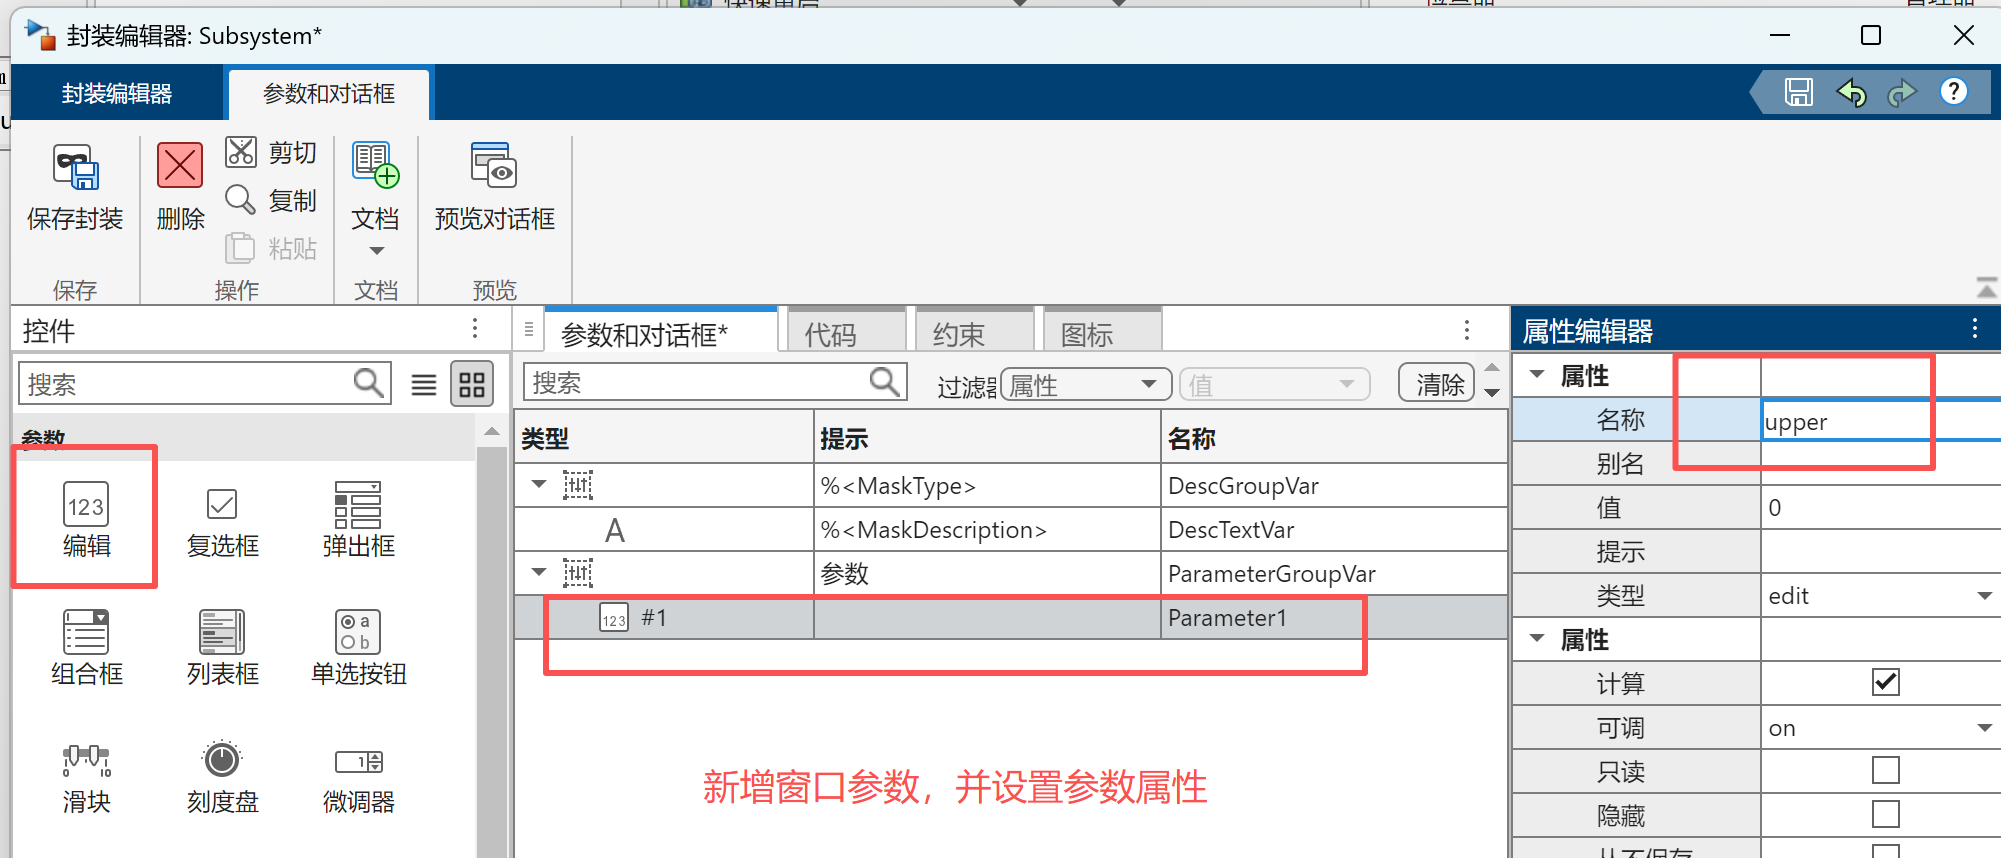
点击subsystem,ctr+m,或者右键,封装,弹出封装编辑器对话框
常用的转换入口:右键 → 子系统与模型引用 菜单里能直接:
- 从选中内容创建子系统
- 转换成引用模型 / 子系统引用
- 变体子系统 ⇄ 变体模型
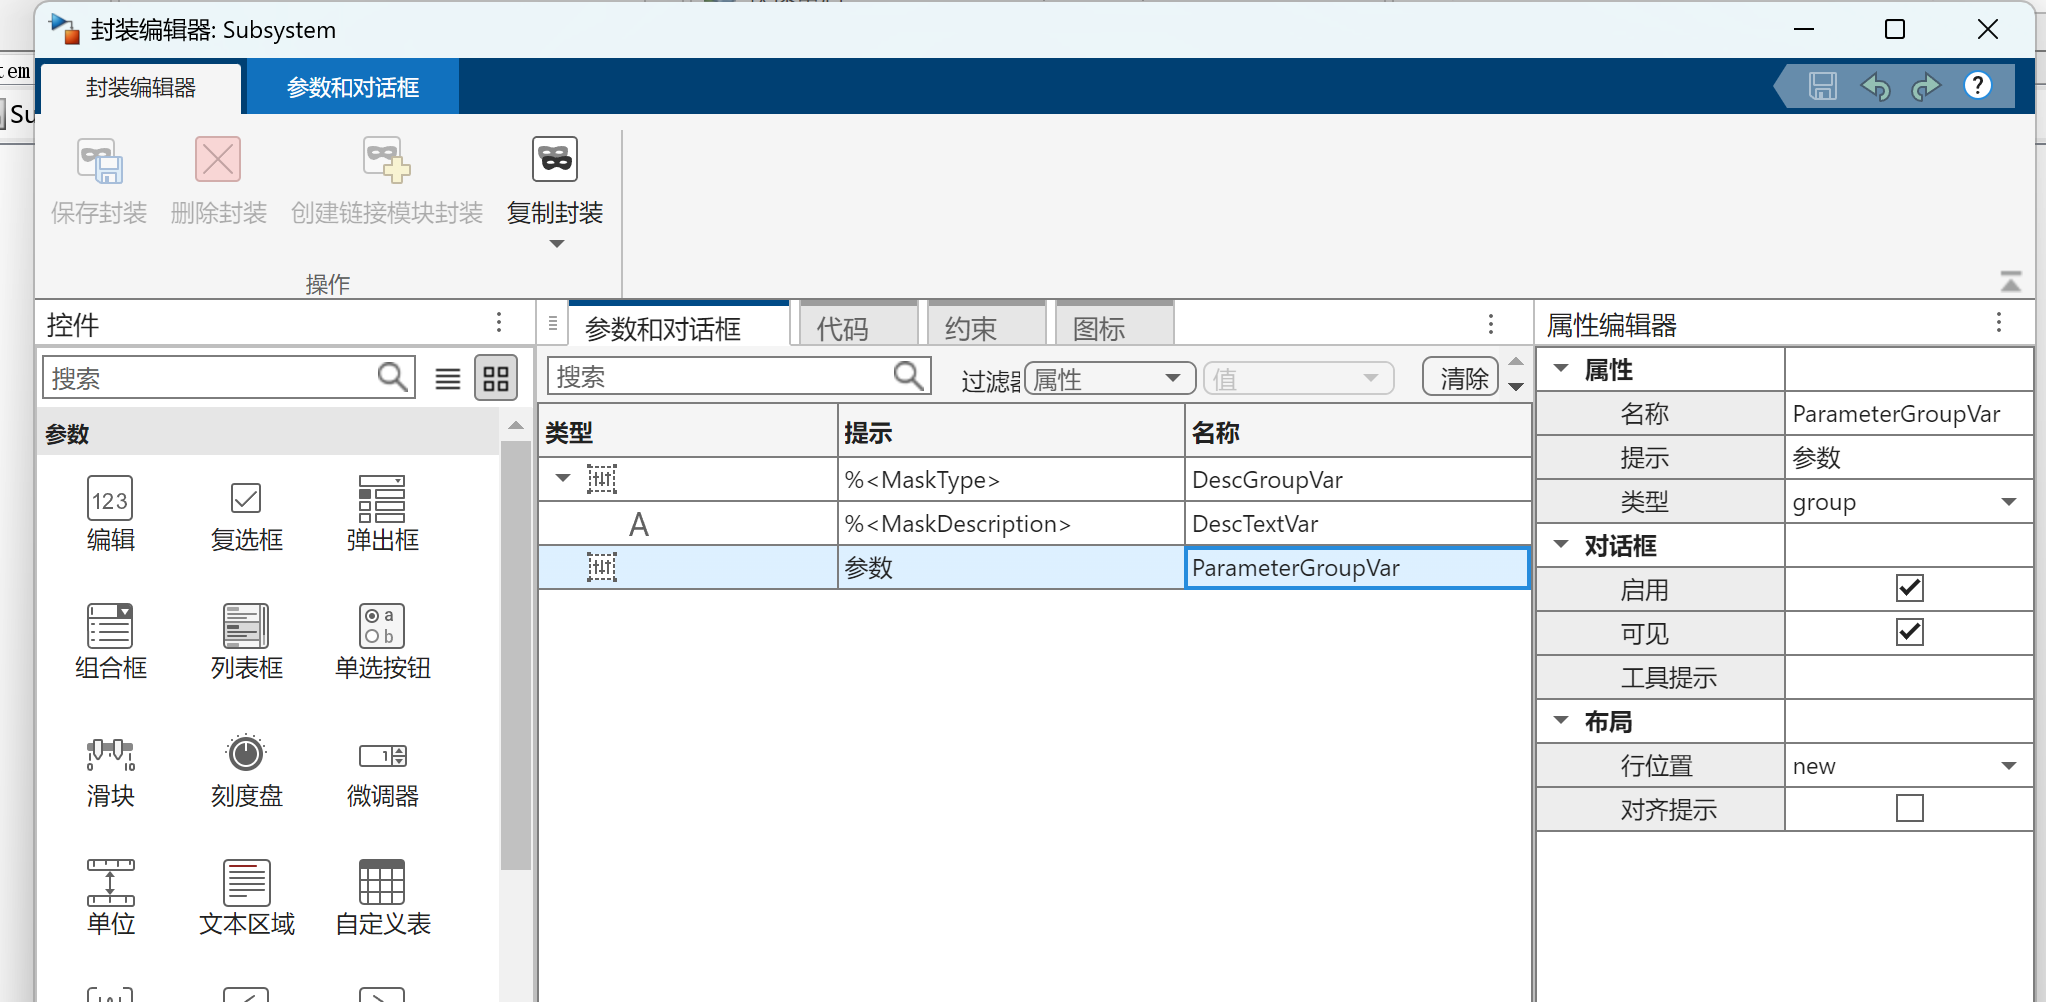
生成后
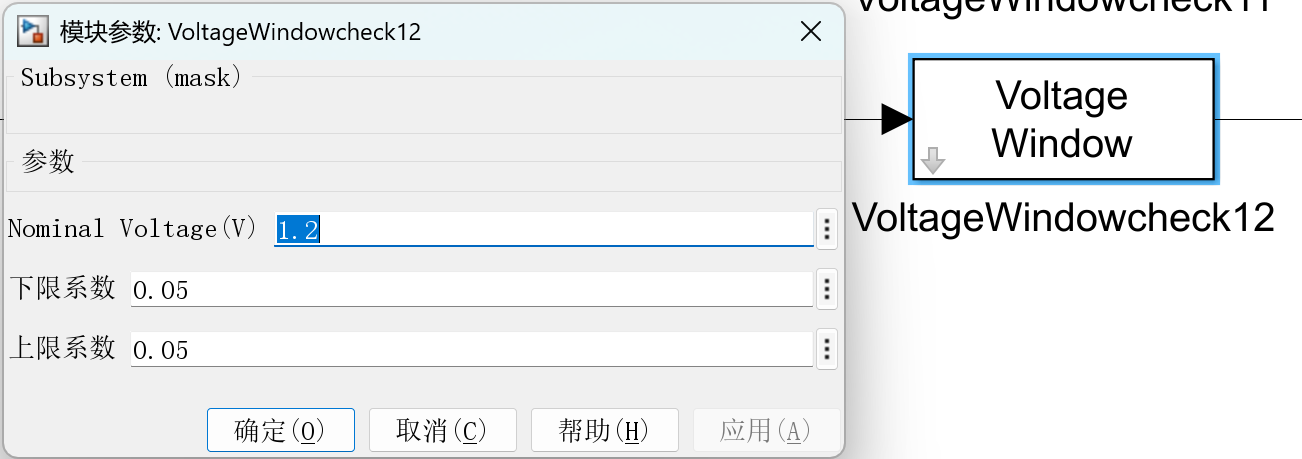
双击对话框,设置参数
2、应用:
1)直接复制
刚封装好的 VoltageWindowFault,默认只存在当前这个 slx 模型画布上,不会自动出现在 Simulink 库浏览器!
只在当前模型里面复用(最简单)
2)永久放到库浏览器
所有模型都能直接拖拽(工程推荐,电源、故障诊断模块统一建库)
步骤:新建自定义库文件
Simulink 首页 → 新建 → 库(Library),不是普通模型 Model!
把你已经封装好的 VoltageWindowFault 模块,从当前模型画布复制粘贴进这个空白库画布;
保存库文件,命名:PowerDiagnosisLib.slx(后缀 slx,库文件图标和普通模型不一样);
MATLAB 主页 → 设置路径,把这个库所在文件夹添加到 MATLAB 搜索路径;
打开库浏览器(快捷键 Ctrl+Shift+L),点浏览器左上角刷新按钮(F5 刷新库),你的自定义库就会出现在左侧列表,直接拖拽模块到任意模型。
具体的可参考:https://blog.csdn.net/qq_37973576/article/details/164718497
三、Model Reference 引用模型
子系统存成独立 .slx,用 Model 块引用。一份模型多处引用(多个实例)
1、核心优势:
- 一份模型多处引用(多个实例)
- 可独立编译 → 大项目编译快、支持增量
- 多人分工,各人管自己的模型
- 接口即契约(Inport/Outport),可单独仿真和测试
- 代价:接口变更影响所有实例,跨模型信号要显式传
好处:省 Flash/RAM、可独立仿真被引用模型、可团队分工(各做各的模型)、增量编译。
2、创建流程
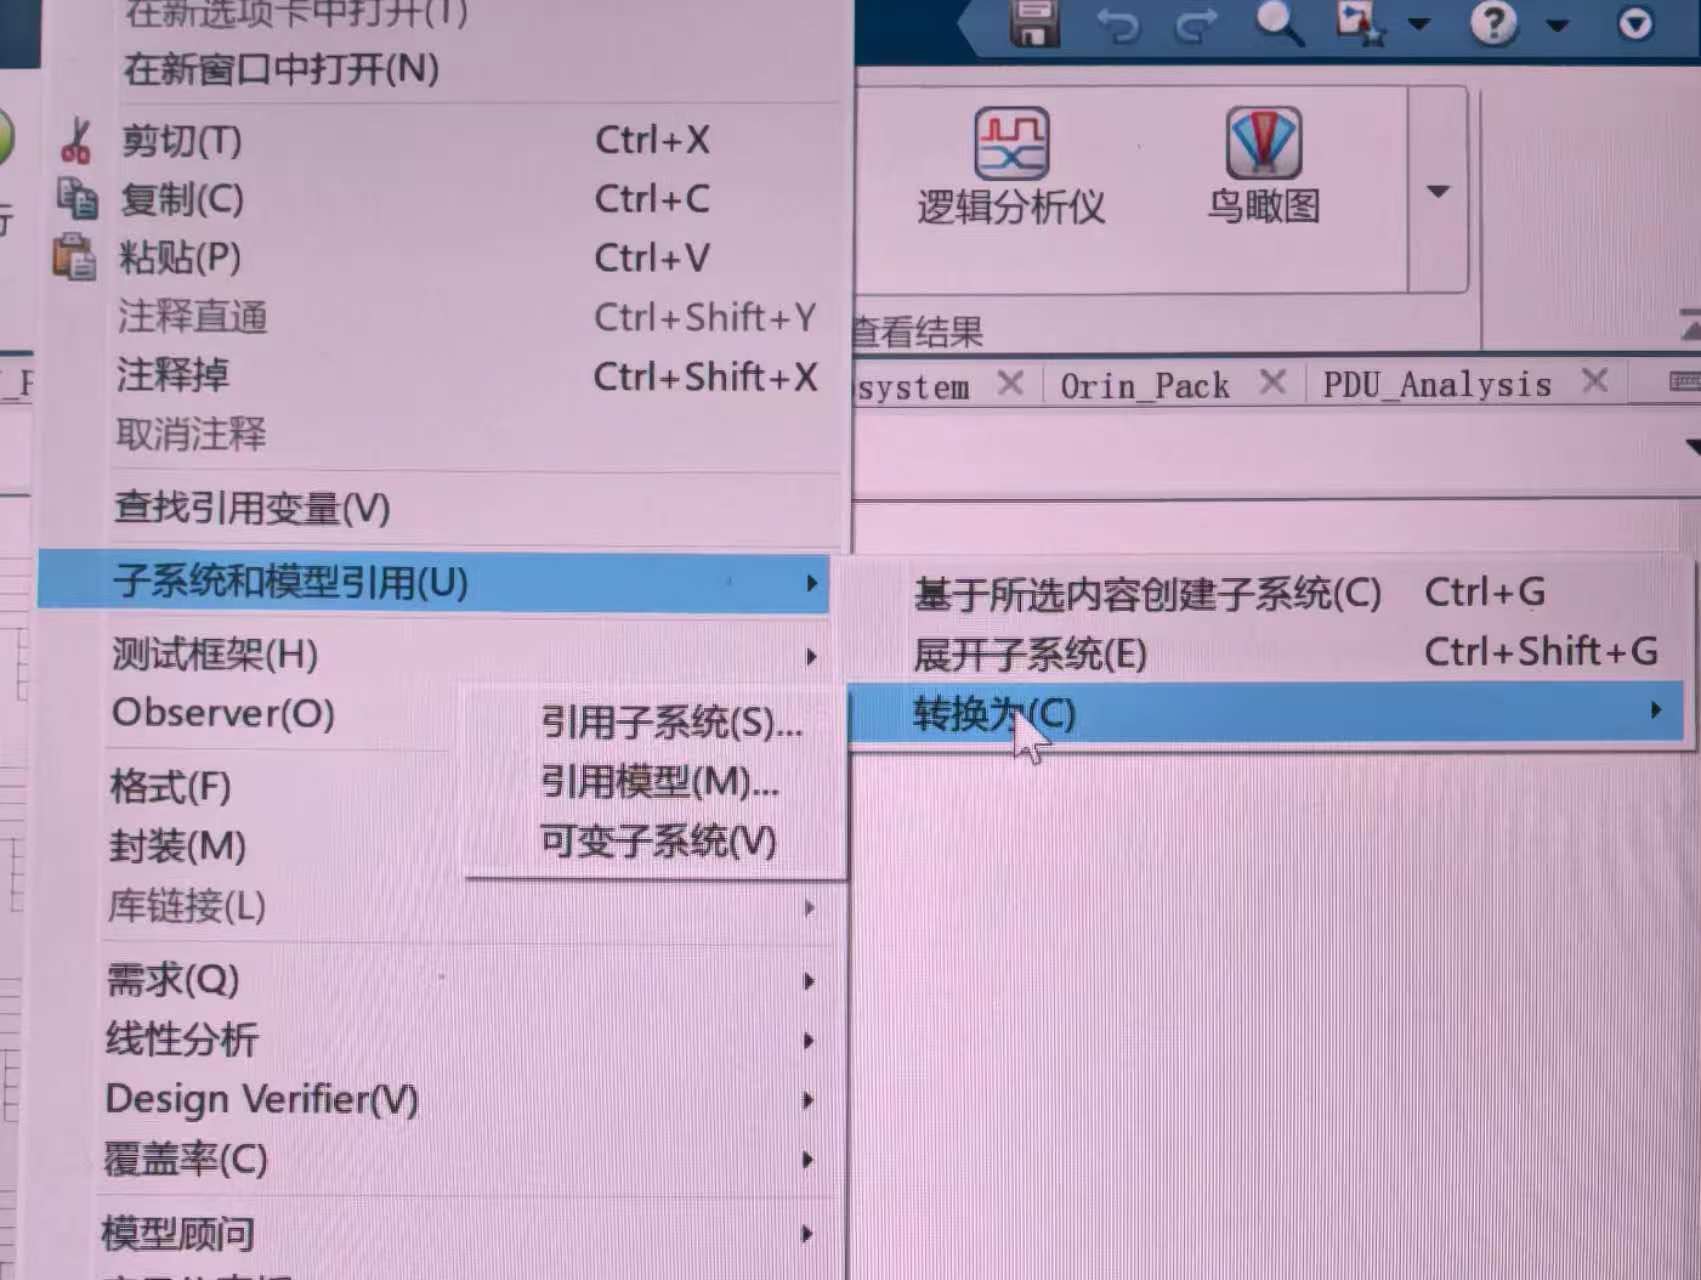
首先先把他变成一个普通的子系统,ctr+g,然后右键子系统与模型引用,转换为,引用模型
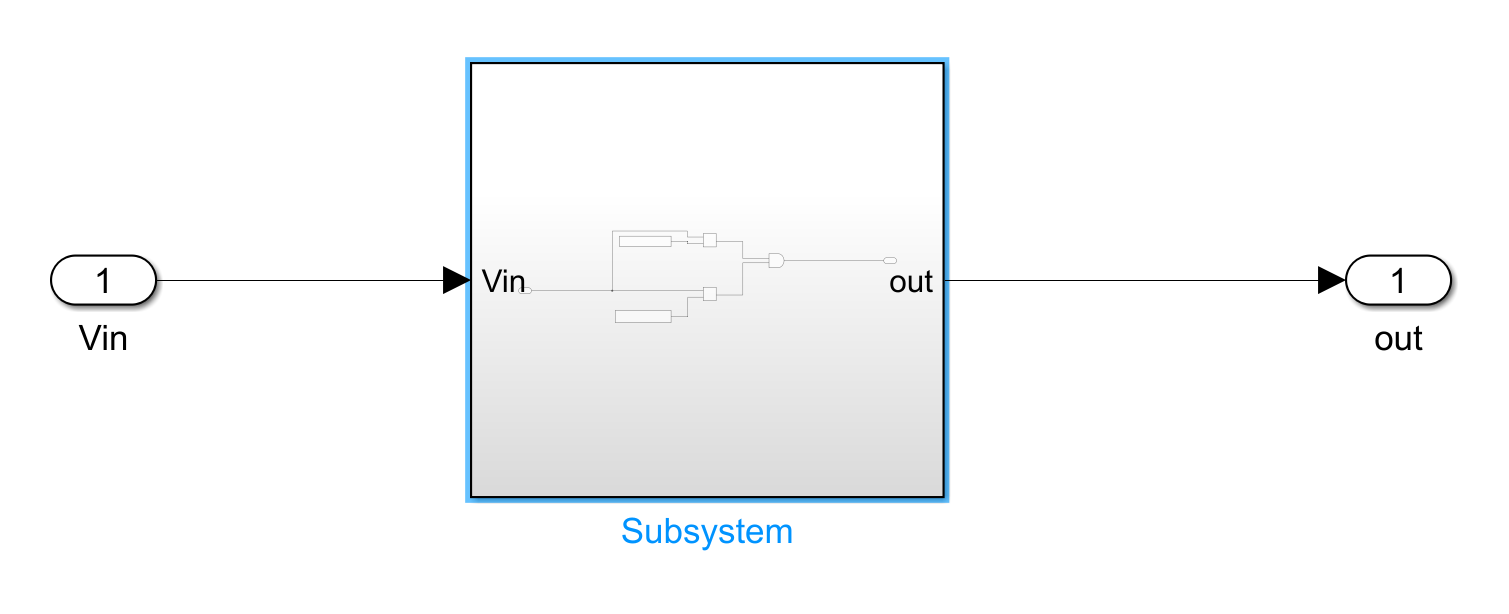
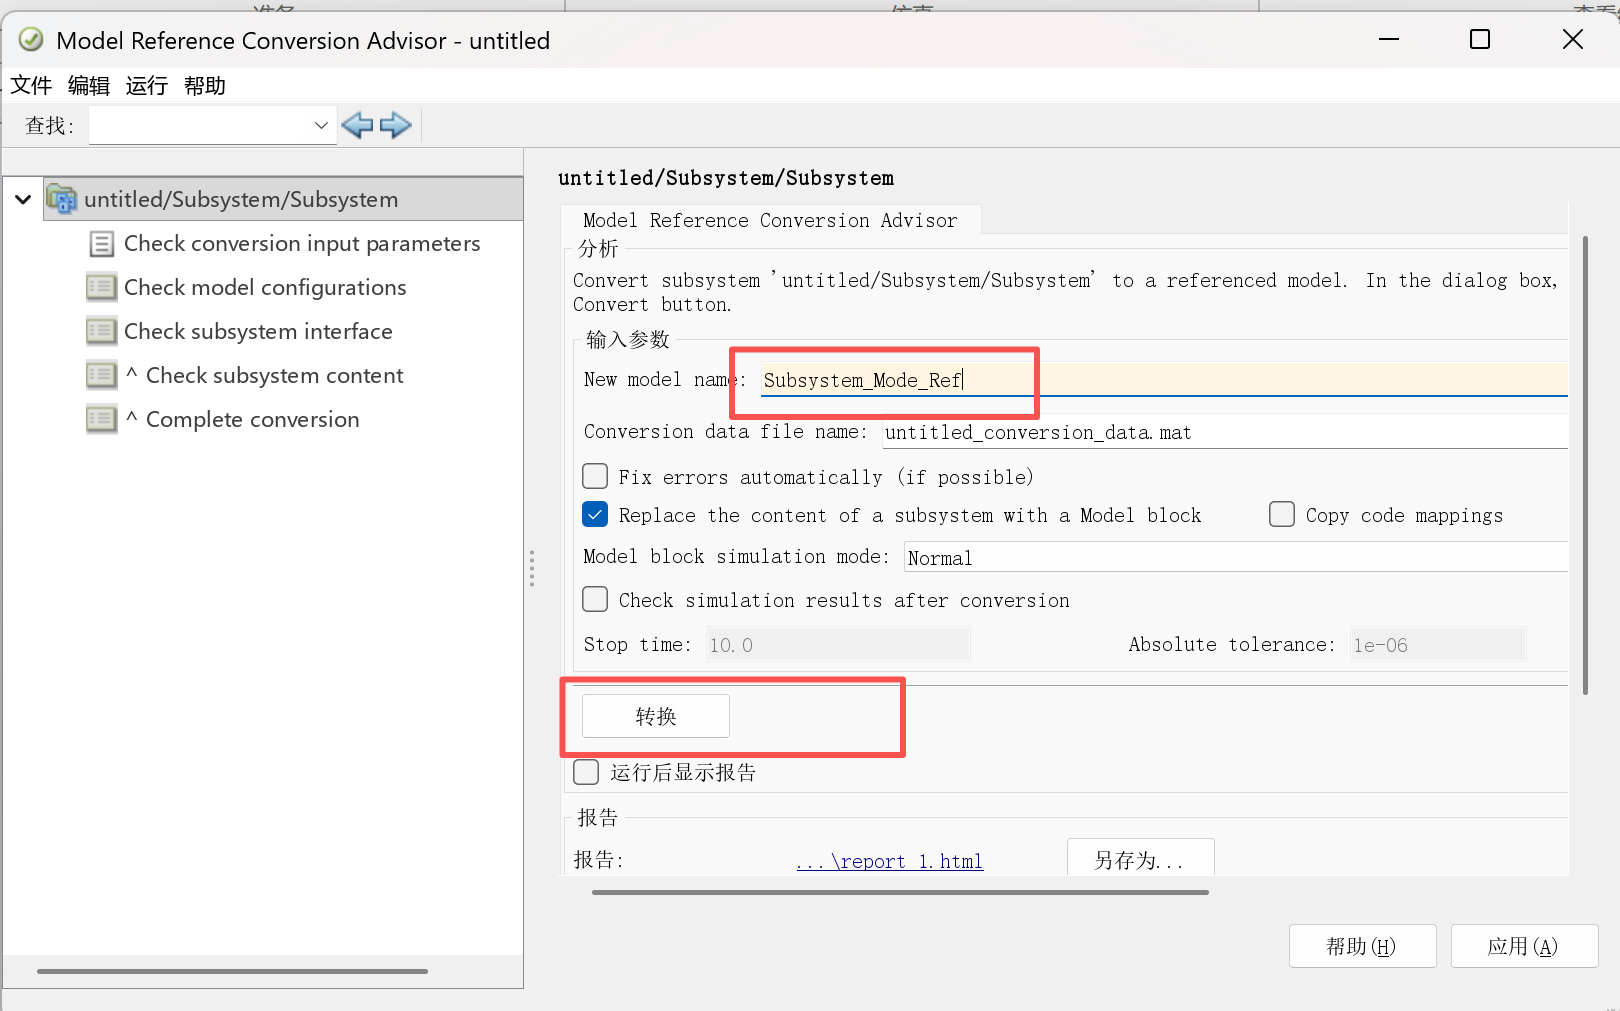
点击转换后就会开始转换了
有时候会报错,翻到下面会有一个fix,点了之后在翻到上面点继续
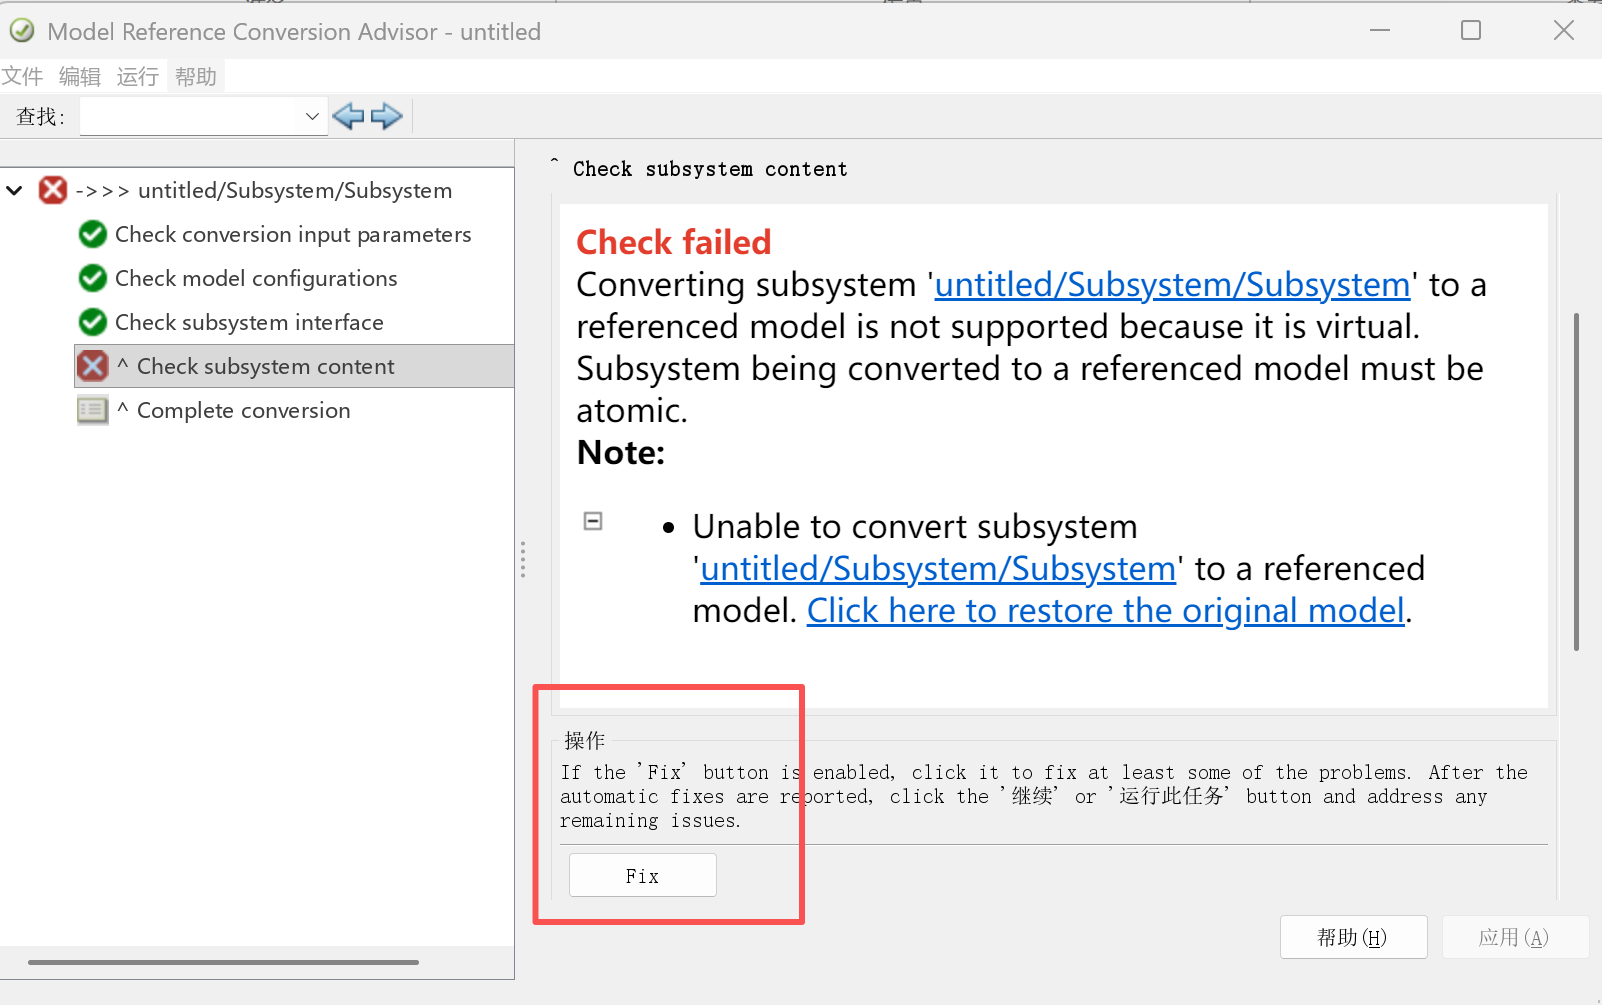
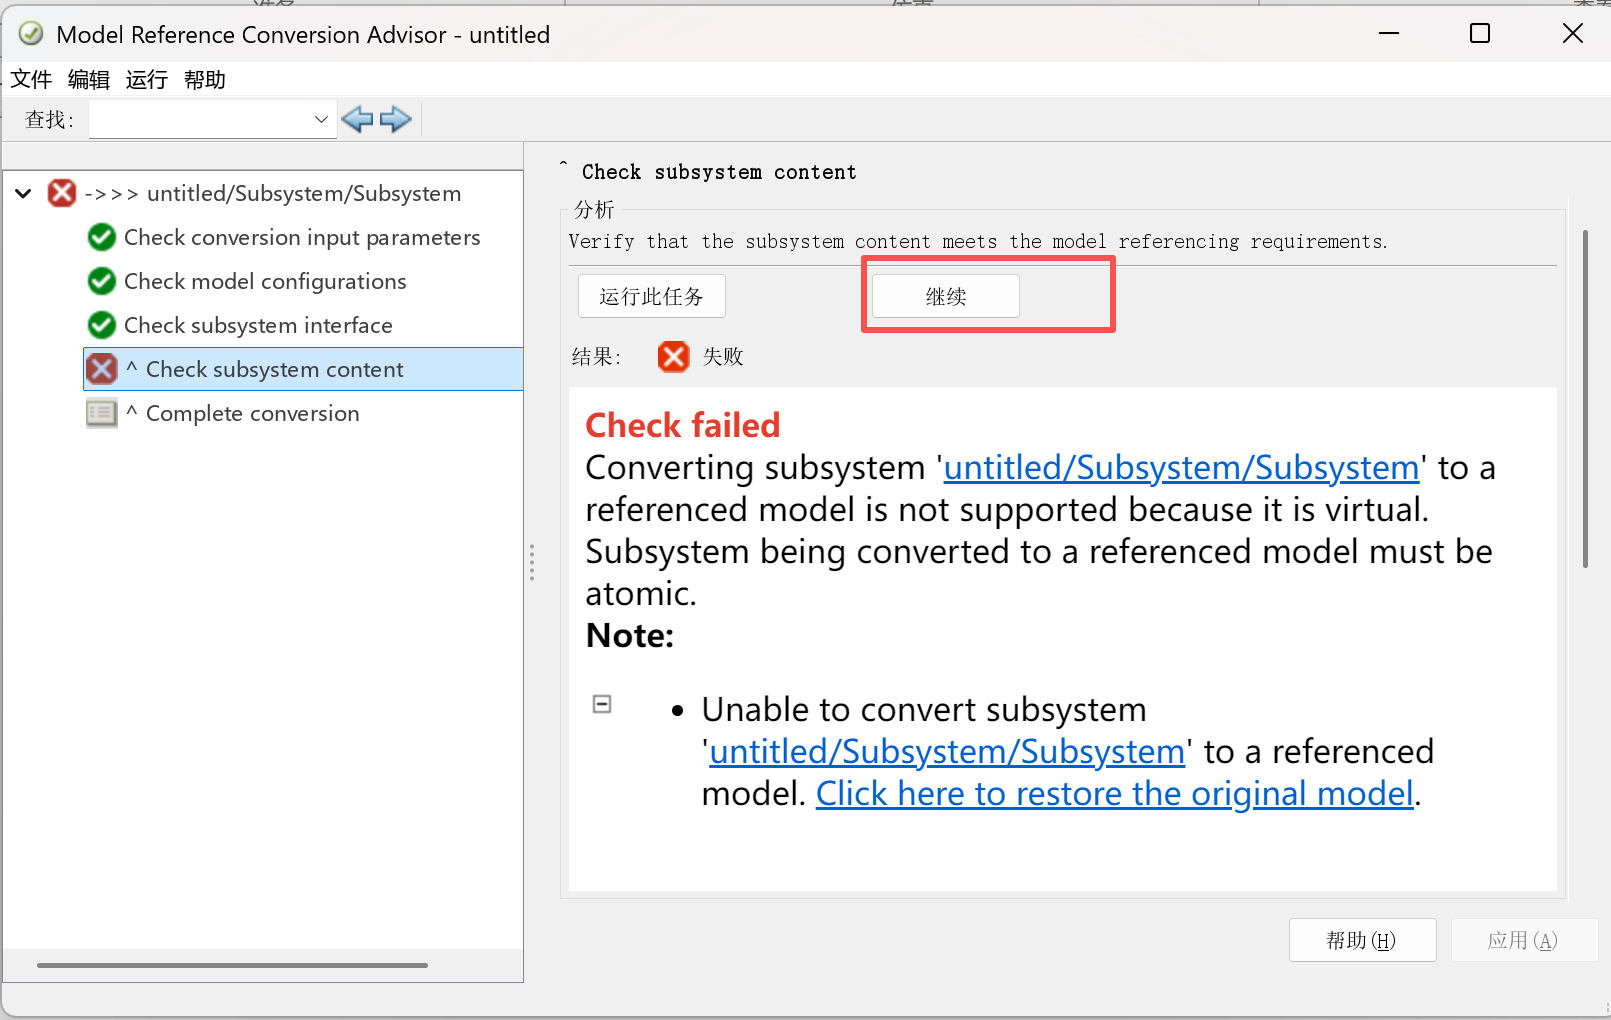
转换成功后
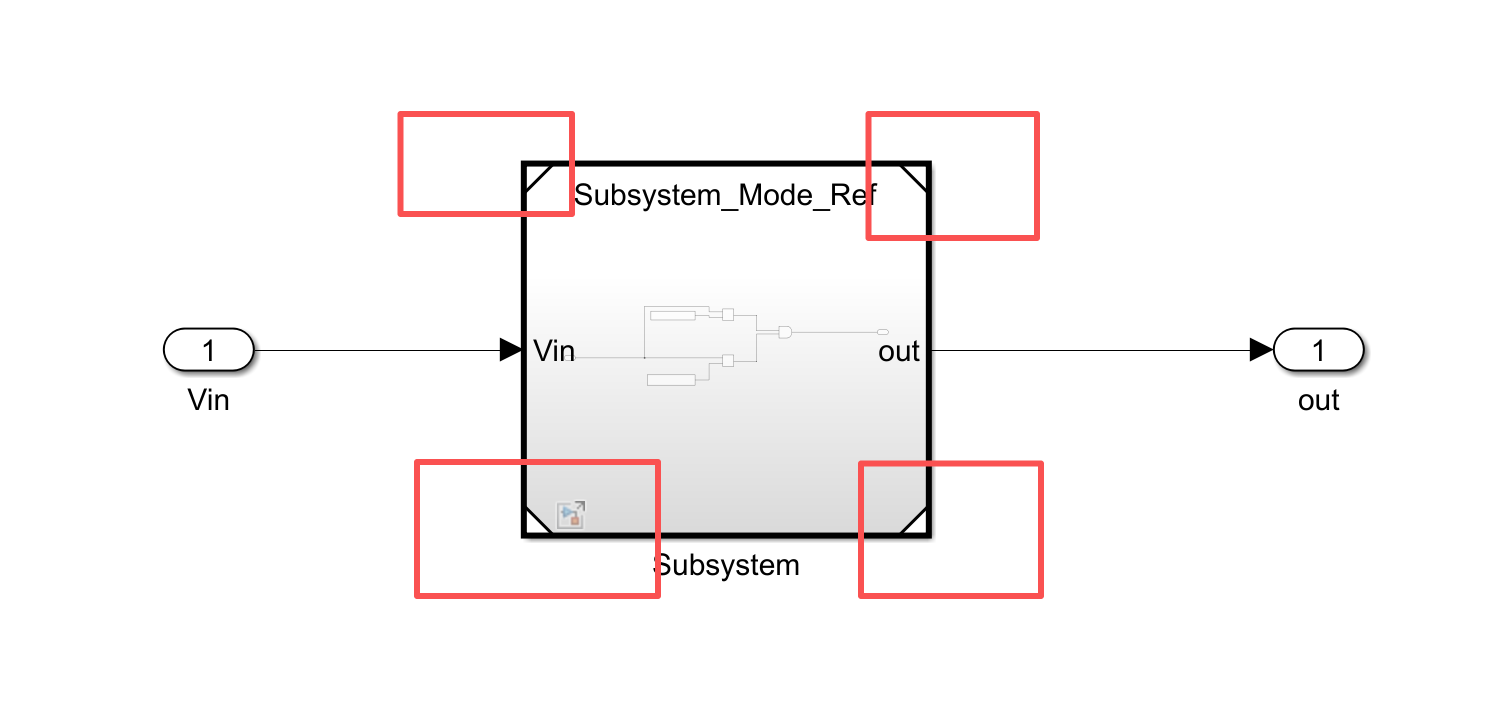
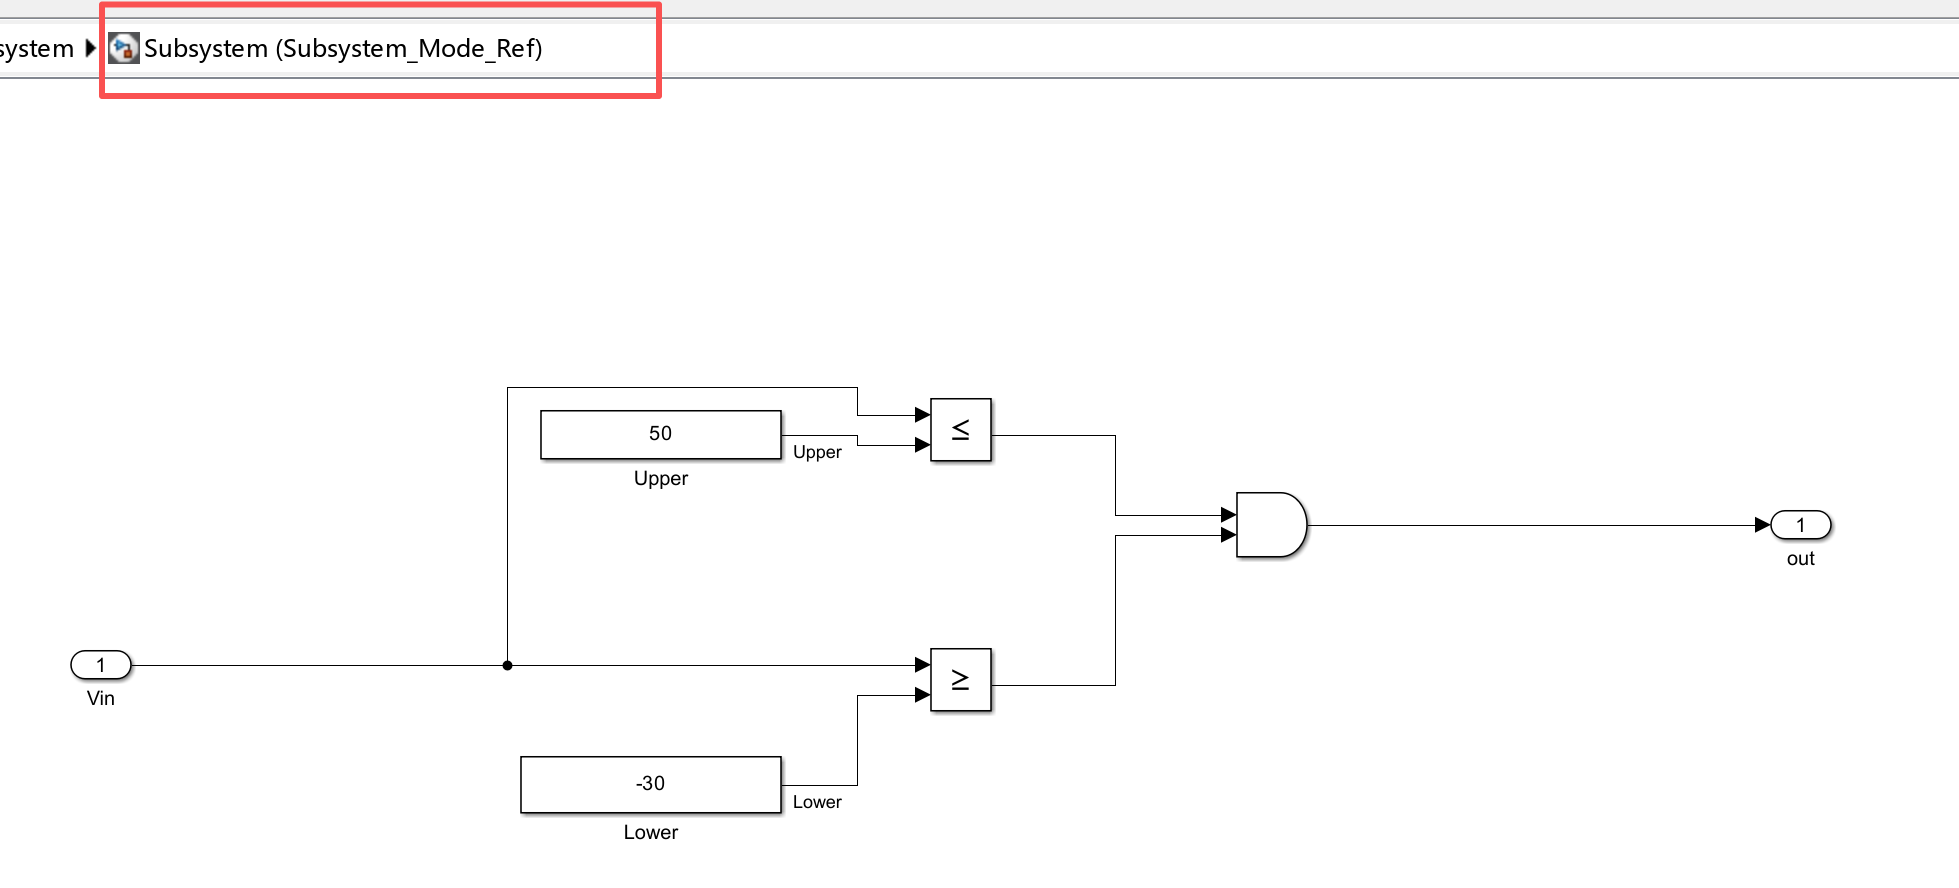
如果此时双击该子系统,打开的就是一个新的模型
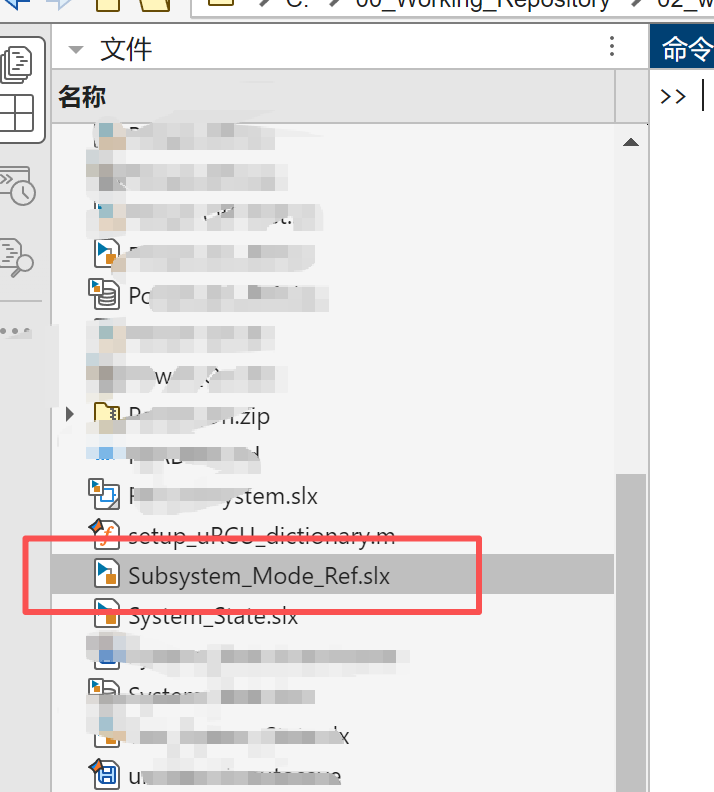
工程路径下也会多一个.slx文件
3、应用
直接复制到你新的模型中即可,simulink自己会追踪原引用模型,如果原引用模型,你复制的引用模型也会同步变更。
三、引用子系统
是库子系统 Library Subsystem的实例引用,他与引用模型最大的区别就是,在生成代码时,一个引用子系统生成一份代码,而引用模型是不管多少个实例,都只生成一份代码
1、创建流程
右键,子系统与模型引用,转换为,引用子系统
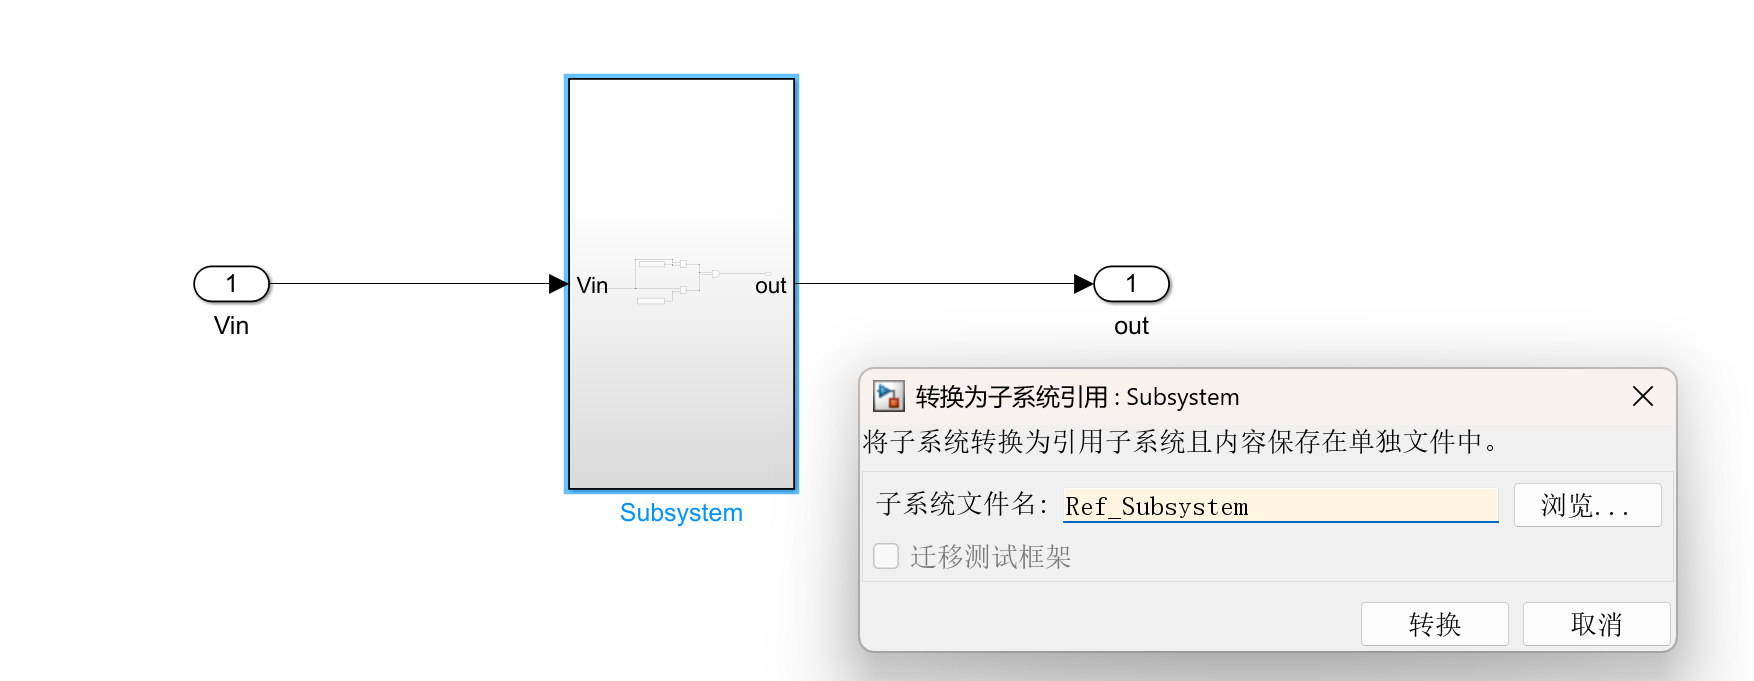
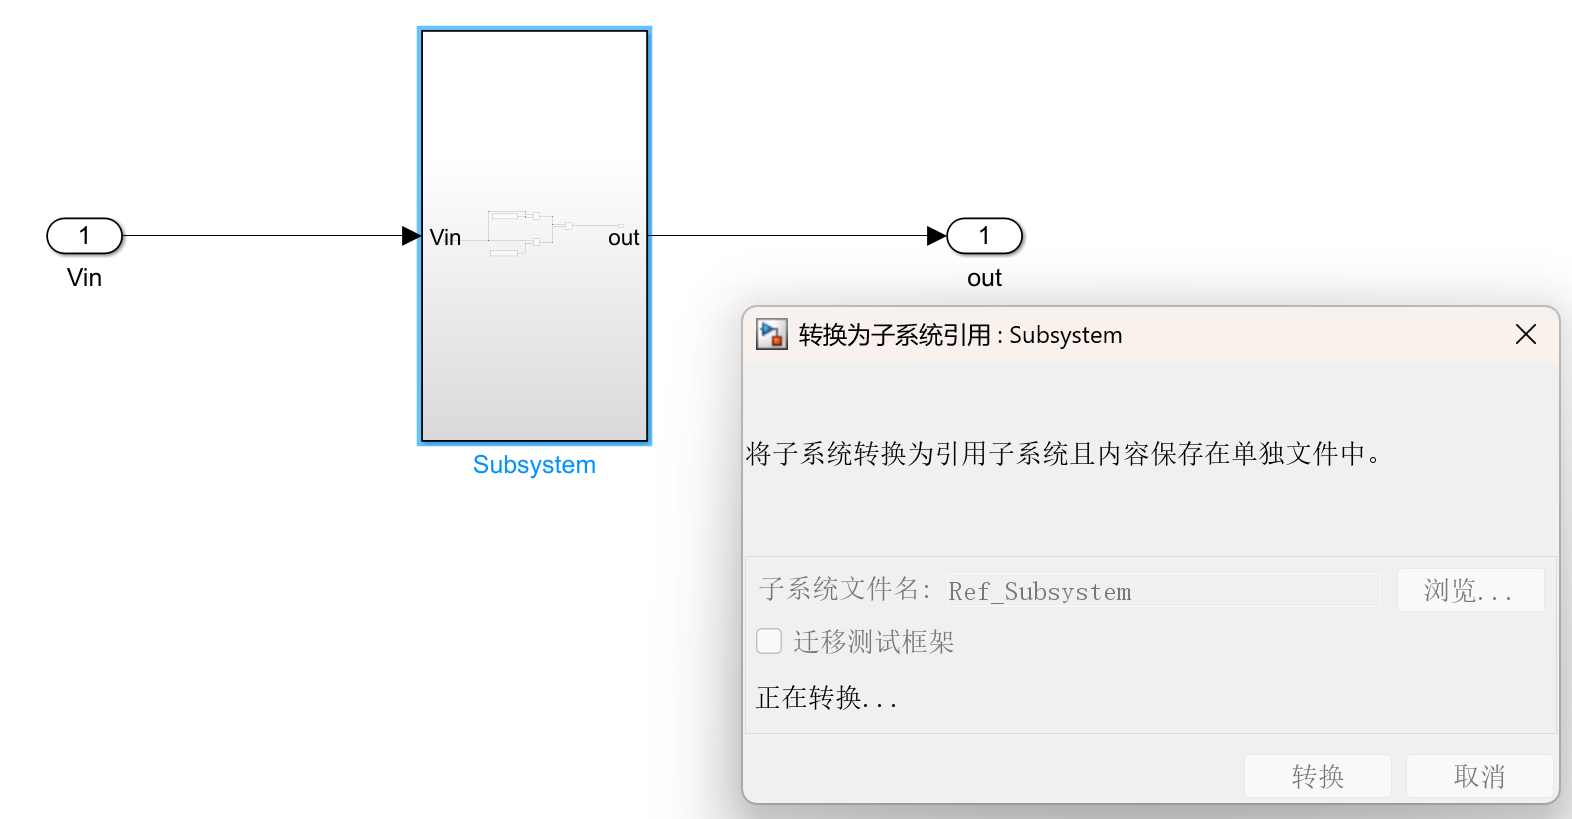
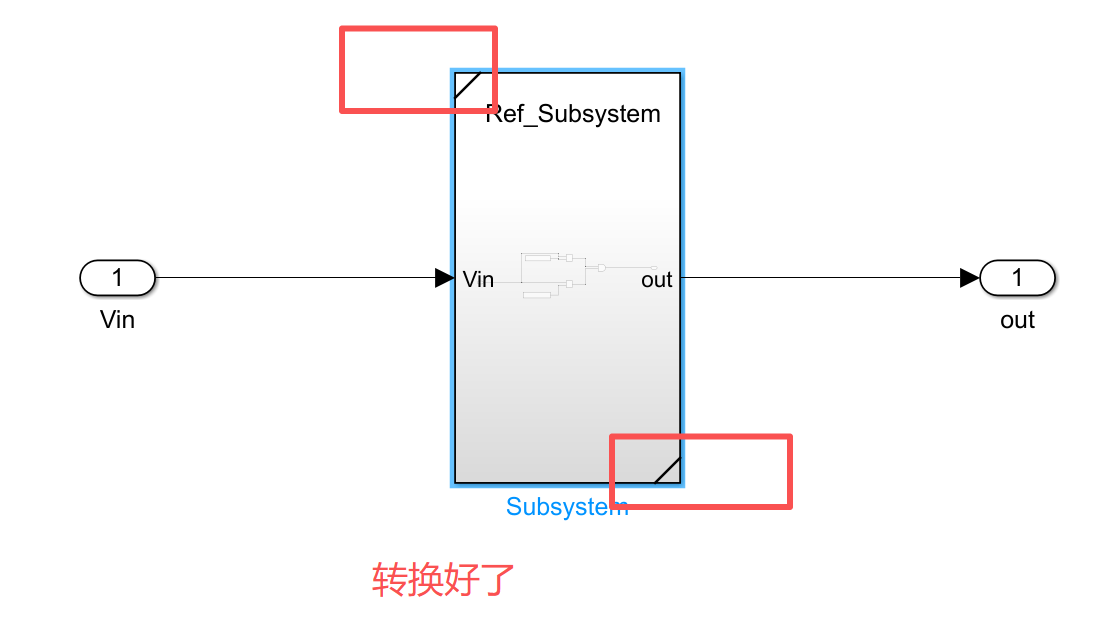
2、应用
1)直接复制
刚封装好的 VoltageWindowFault,默认只存在当前这个 slx 模型画布上,不会自动出现在 Simulink 库浏览器!
只在当前模型里面复用(最简单)
2)永久放到库浏览器
所有模型都能直接拖拽(工程推荐,电源、故障诊断模块统一建库)
步骤:新建自定义库文件
Simulink 首页 → 新建 → 库(Library),不是普通模型 Model!
把你已经封装好的 VoltageWindowFault 模块,从当前模型画布复制粘贴进这个空白库画布;
保存库文件,命名:PowerDiagnosisLib.slx(后缀 slx,库文件图标和普通模型不一样);
MATLAB 主页 → 设置路径,把这个库所在文件夹添加到 MATLAB 搜索路径;
打开库浏览器(快捷键 Ctrl+Shift+L),点浏览器左上角刷新按钮(F5 刷新库),你的自定义库就会出现在左侧列表,直接拖拽模块到任意模型。
原文链接:https://blog.csdn.net/qq_37973576/article/details/164718497
四、可变子系统
(此处暂未使用,后续使用了再补充)
一个块内放多个候选实现,按变体条件(表达式、Simulink.Variant 对象、配置)在编译时选一个生效。常用于:不同硬件版本、快速原型 vs 量产、测试桩 vs 真实实现。
五、总结
1、如何选用?
| 只是把画布整理清爽 | 普通子系统 |
| 多个模型复用同一个组件 | 自定义库 + Mask(或 Subsystem Reference) |
| 多人协作 / 大项目 / 要独立编译 | 引用模型 |
| 按配置切换不同实现 | 可变子系统 |
| 需要事件驱动执行 | Function-Call / Enabled / Triggered |
2、引用子系统与Model Reference到底用哪个比较好?
首先来对比一下这两个之间的差异性
| 逻辑位置 | 展开在父模型 | 独立模型(被引用) |
| 参数化 | Mask 参数 | Model Arguments / 实例参数 |
| 代码量 | 4 份(除非 reusable function) | 1 份(4 实例共用) |
| 改一处 | 改库→更新链接 | 改被引用模型→全部更新 |
| 独立仿真 | ❌(跟父模型一起) | ✅(可单独仿真) |
| 团队分工/分工开发 | 一般 | ✅ 适合 |
| 配置复杂度 | 中(简单) | 较高(要设实例参数/多实例代码) |
| 适合 | 逻辑相同、实例少、想快速 |
多实例(4电机)、大工程、要省代码 |
从上面的表格对比,并结合实际的工程应用来看,如果该模型逻辑只应用一次,用哪个其实都一样,甚至使用普通子系统都可以,对于该子模块多次使用,或多人并行开发,需要单独测试时,Model Reference似乎更合适,尤其是生成嵌入式代码,他只生成一份,不管有多少个实例
一句话核心结论:
小的、标准化底层组件(PI、限幅、CAN 信号解析)→ 引用子系统;
大功能模块、多人并行开发、需要独立版本管理 → Model Reference
3、踩坑记录(can解析不要做成引用子模型)
但是有一个特殊情况,这是我之前模型搭建时踩的坑,对于CAN报文解析和打包的子系统,尽量使用引用子系统,引用模型在代码生成时会出错
背景记录
有一个控制器,他上面有四路can,用于对四路电机的控制,这四路can上发送和接收的报文都一样,每路CAN上控制器接收2条报文,比如0x100,0x101,在设计时,我考虑的是将can接收做成引用子模型,这样可以实例成四份,给四路电机使用,这样只需要生成一份代码即可,也便于后期维护,
问题
其实在仿真阶段都是正常的,不会报错,但是在代码生成时会报错,报文ID没办法实例—-这里就会有问题,后来改成引用子系统就行了
此处有点描述不清,后续找一下记录在补充吧
4、如何相互转换?
这几个子系统之间可以相互转换,操作如下:
右键 → 子系统与模型引用,可以直接转:
- 从选中内容创建子系统
- 普通子系统 ⇄ 引用子系统
- 引用子系统 → 引用模型
- 引用模型 → 引用子系统(若里面含 Model 块会失败)
- 变体子系统 ⇄ 变体模型
六、Subsystem 的其他变体
按“执行时机”分的特殊子系统(都是 Subsystem 的变体):
| Enabled 使能子系统 | 使能信号为真时 |
| Triggered 触发子系统 | 边沿触发时执行一次 |
| Enabled and Triggered | 两者都满足 |
| Function-Call 函数调用子系统 | 由函数调用信号触发(你 CAN 接收用的就是这个) |
| Resettable 可复位子系统 | 外部信号复位内部状态 |
| If Action / Switch Case Action | 配合 If / Switch Case 块 |
| For Each | 对数组/总线数组的每个元素迭代 |
| For / While Iterator | 循环执行 |
| Atomic 原子子系统 | 强制作为一个执行单元(影响执行顺序、代码生成的函数边界) |
按“复用层次”分的三种:
| 自定义库 + Mask | 最轻,内联 | 组件复用 |
| Subsystem Reference(R2019b+) | 中间:独立 .slx、支持多实例、但不独立编译 | 想复用又不想背引用模型的编译负担 |
| Model Reference | 最重:独立文件 + 独立编译 | 大项目、多人协作 |
其他相关概念:
- Configurable Subsystem:从指定库里选一个块放进来
- Variant Model:变体的“模型级”版本
- Bus Creator / Bus Selector:信号打包(不是子系统,但常一起用)
- Mask 的组成:参数、对话框控件、图标绘制、初始化回调、Help