在写 Vulkan 程序的早期阶段,几乎每一个图形程序员都会经历一段暗无天日的“黑屏与蓝屏”循环。
你写完了设备初始化、交换链创建和三角形录制,点击运行,屏幕要么是一片漆黑,验证层(Validation Layers)以每秒上百条的频率疯狂喷出关于“资源读写未定义竞争”的刺眼报错;要么画面虽然出来了,但在快速转动视角时,屏幕中央横贯着一道道极其难看的锯齿状裂痕(画面撕裂 Tearing);甚至在运行几十帧之后,显卡驱动程序突然无响应重置,抛出绝望的 VK_ERROR_DEVICE_LOST。
产生这些悲剧的核心根源只有一个:你把传统的 CPU 串行同步思维,盲目套用在了高度异步并发的 GPU 硬件上。
在 Vulkan 中,CPU 的指令发射、GPU 图形队列的硬件光栅化、以及显示器(Display Controller)从交换链抓取扫描线,是运行在三个完全脱节的物理时间线上的。
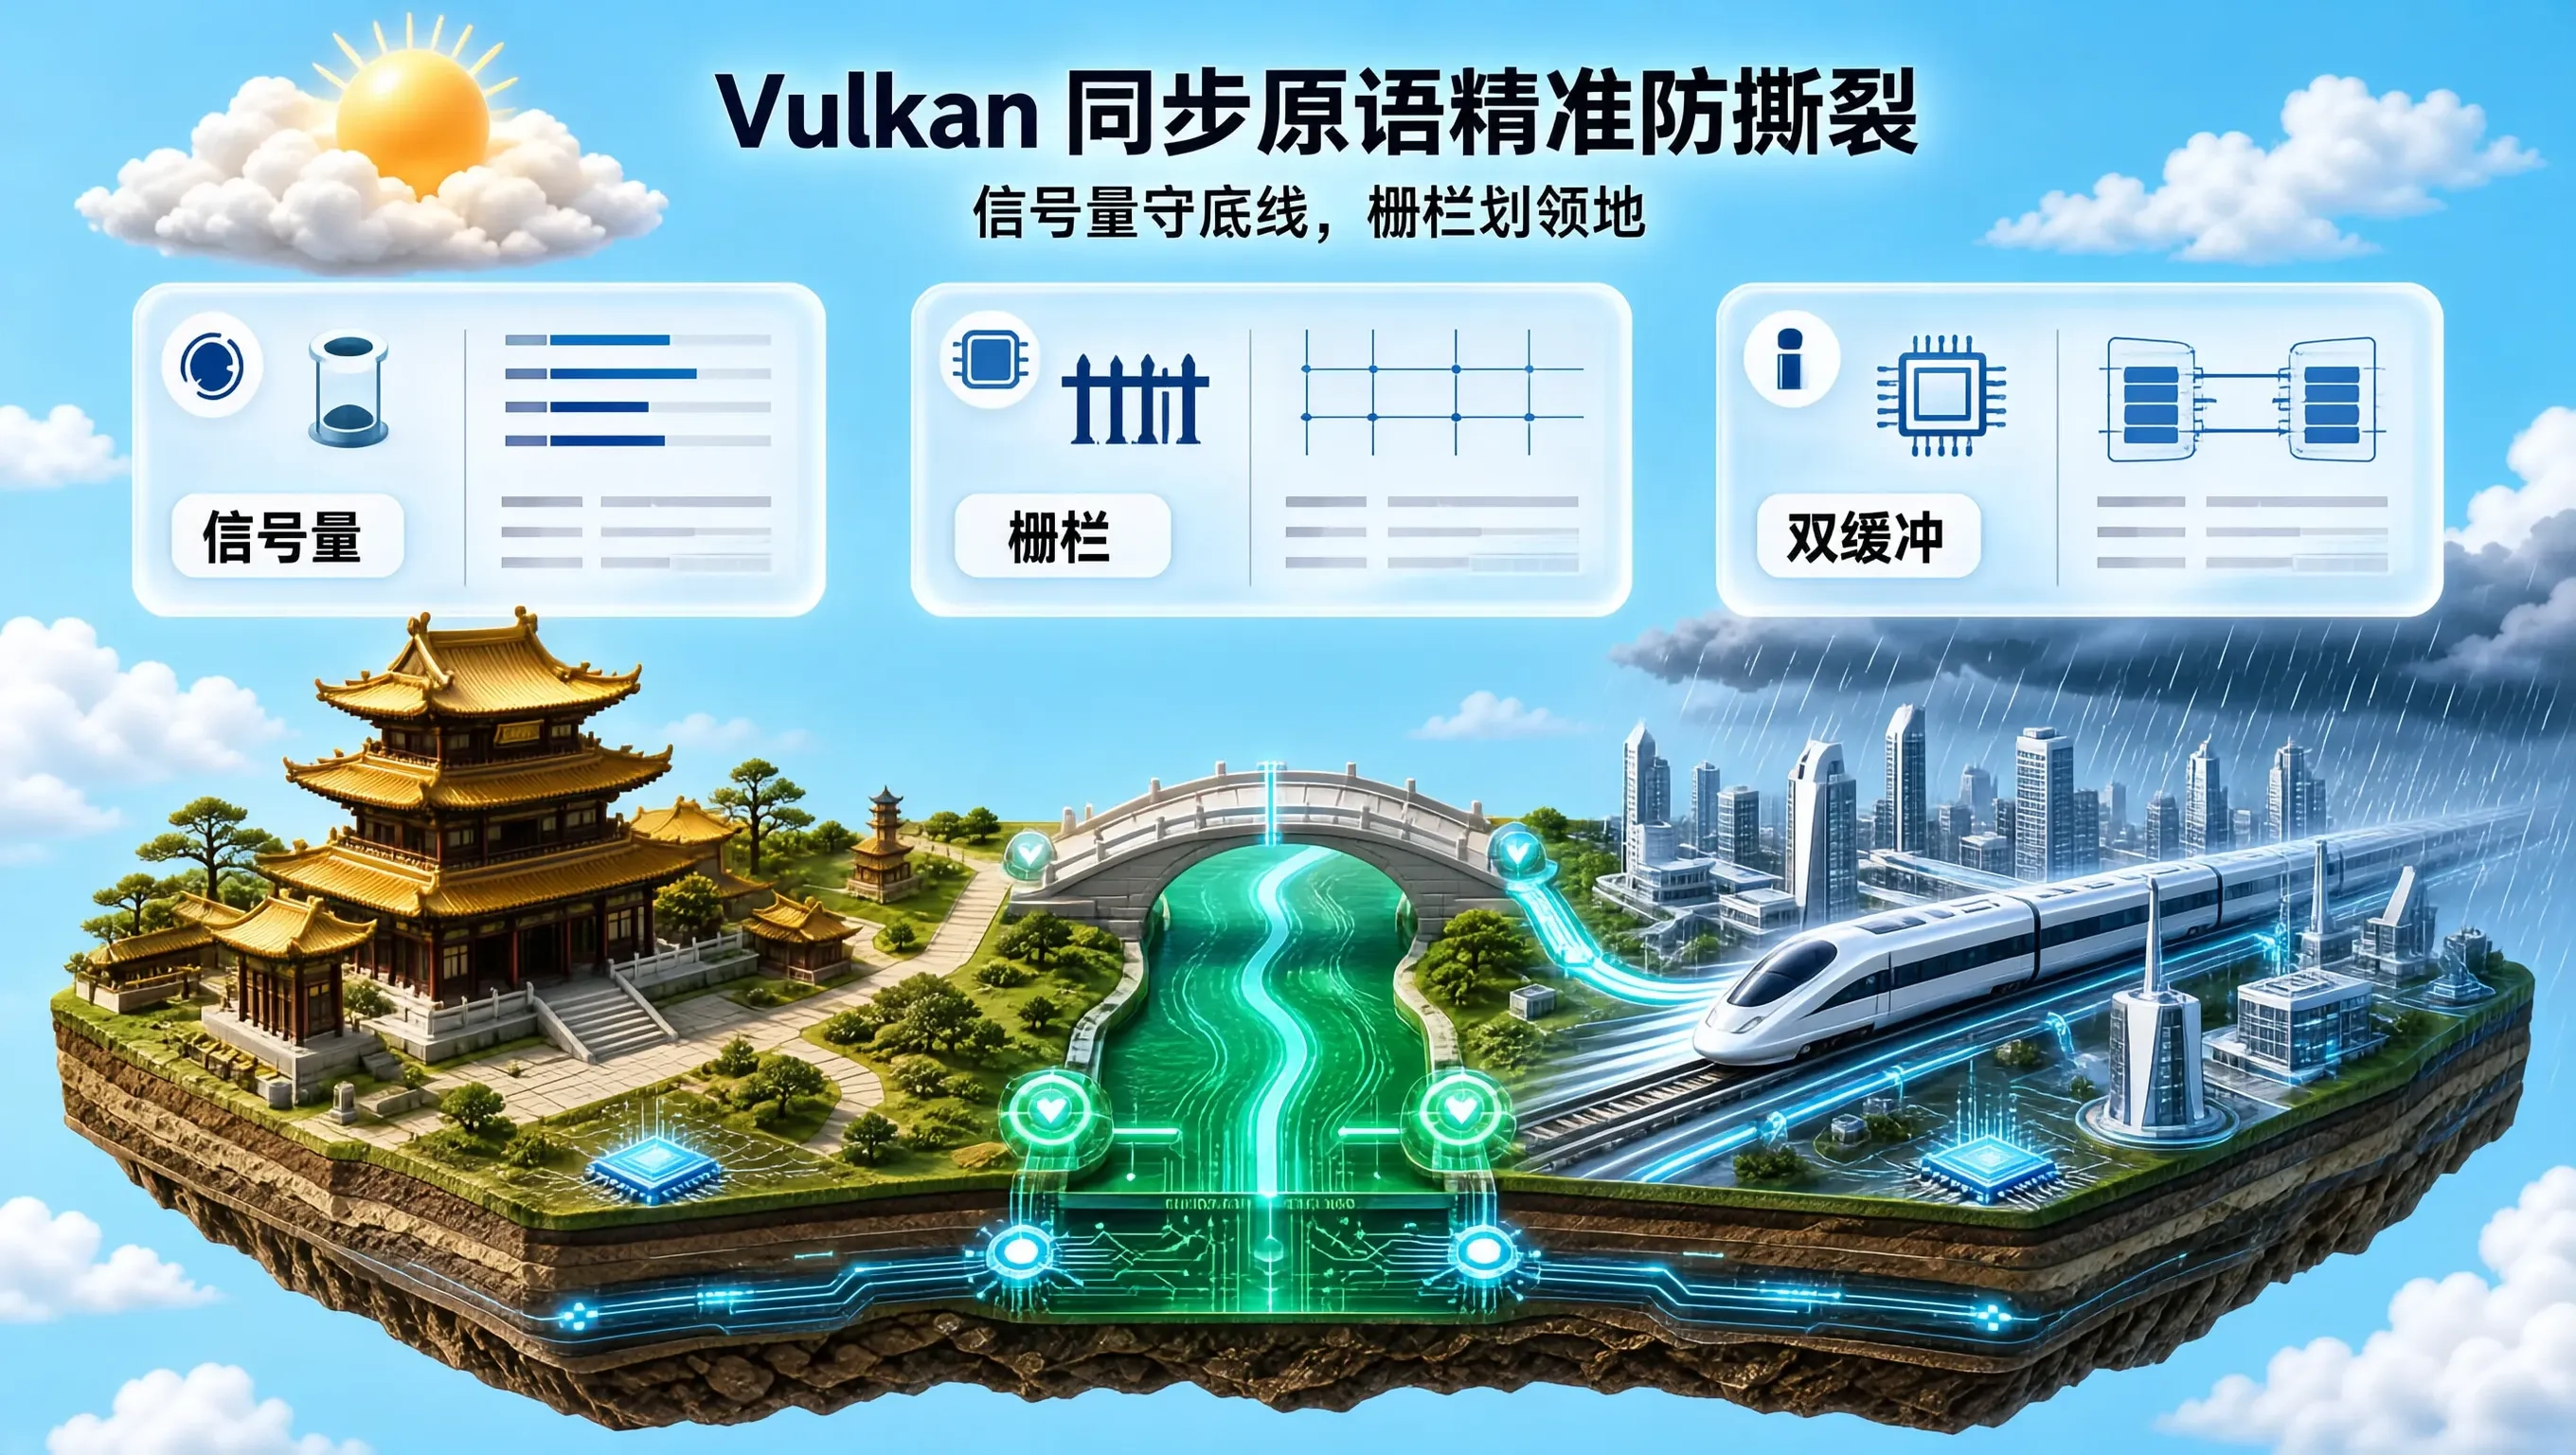
要想让这三匹脱缰的野马严丝合缝地步调一致,既不让画面产生半个像素的撕裂,又不让 CPU 发生无谓的死锁等待,必须彻底搞懂现代 Vulkan 的两大终极守护神——VkSemaphore(信号量) 与 VkFence(栅栏) 的精准配合之道。
物理职责分水岭:GPU 内部与跨 CPU 边界
很多初学者最大的困惑,就是分不清信号量和栅栏到底有何区别,经常在代码里胡乱安插。
它们的物理边界有着不可逾越的铁律划分:
| VkSemaphore | GPU 内部硬件队列之间 (Queue-to-Queue) | 否 (CPU 完全看不见) | 极轻量 (GPU 内部寄存器/计数器流转) | 交换链图像获取就绪 $\\rightarrow$ 渲染启动;渲染完成 $\\rightarrow$ 呈现引擎显示 |
| VkFence | GPU 向 CPU 状态通知 (GPU-to-CPU) | 是 (CPU 可显式 Wait / Poll) | 适中 (涉及系统线程唤醒与中断) | 防止 CPU 跑得过快覆盖了 GPU 正在读取的 Uniform 缓冲 (Frames in Flight) |
简单来说:GPU 自己的不同队列打配合,用信号量;GPU 想告诉 CPU 某件事干完了,用栅栏。
双飞行动画帧环(Frames in Flight)经典流转拓扑
在追求极致吞吐的现代管线中,我们通常采用双缓冲(Frames in Flight = 2)。在任何一个时刻,GPU 正在全力绘制第 $N$ 帧,而 CPU 正在并发录制第 $N+1$ 帧的命令,两者在空间和时间上重叠狂奔。
在这一模型下,每一帧飞行槽位必须配齐四件套资产:
现代 C++ 规范 Vulkan 1.3 帧同步协调器实现
下面展示在主渲染循环中严丝合缝控制信号量与栅栏状态流转的生产级 C++ 实现:
#include <vulkan/vulkan.h>
#include <vector>
#include <stdexcept>
class VulkanFrameSyncCoordinator {
public:
const size_t maxFramesInFlight = 2;
size_t currentFrame = 0;
std::vector<VkSemaphore> imageAvailableSemaphores;
std::vector<VkSemaphore> renderFinishedSemaphores;
std::vector<VkFence> inFlightFences;
void Initialize(VkDevice device) {
imageAvailableSemaphores.resize(maxFramesInFlight);
renderFinishedSemaphores.resize(maxFramesInFlight);
inFlightFences.resize(maxFramesInFlight);
VkSemaphoreCreateInfo semaphoreInfo{};
semaphoreInfo.sType = VK_STRUCTURE_TYPE_SEMAPHORE_CREATE_INFO;
VkFenceCreateInfo fenceInfo{};
fenceInfo.sType = VK_STRUCTURE_TYPE_FENCE_CREATE_INFO;
// 关键秘诀:初始状态必须为 SIGNALED,确保首帧调用 vkWaitForFences 不会陷入永久死锁!
fenceInfo.flags = VK_FENCE_CREATE_SIGNALED_BIT;
for (size_t i = 0; i < maxFramesInFlight; ++i) {
if (vkCreateSemaphore(device, &semaphoreInfo, nullptr, &imageAvailableSemaphores[i]) != VK_SUCCESS ||
vkCreateSemaphore(device, &semaphoreInfo, nullptr, &renderFinishedSemaphores[i]) != VK_SUCCESS ||
vkCreateFence(device, &fenceInfo, nullptr, &inFlightFences[i]) != VK_SUCCESS) {
throw std::runtime_error("创建 Vulkan 帧同步原语失败!");
}
}
}
// 每一帧的主调度流程
void DrawFrame(
VkDevice device,
VkSwapchainKHR swapChain,
VkQueue graphicsQueue,
VkQueue presentQueue,
VkCommandBuffer currentCmdBuffer
) {
// 1. CPU 等待当前槽位的上一轮 GPU 渲染彻底结束 (超时时间设为 1 秒)
vkWaitForFences(device, 1, &inFlightFences[currentFrame], VK_TRUE, UINT64_MAX);
// 2. 从交换链获取下一张可用图像索引
uint32_t imageIndex;
VkResult acquireResult = vkAcquireNextImageKHR(
device,
swapChain,
UINT64_MAX,
imageAvailableSemaphores[currentFrame], // 当硬件拿到图像时,激活此 GPU 信号量!
VK_NULL_HANDLE,
&imageIndex
);
if (acquireResult == VK_ERROR_OUT_OF_DATE_KHR) {
// 处理窗口大小变动时的交换链重建 …
return;
}
// 3. 只有确认进入渲染,才重置当前槽位的栅栏!
vkResetFences(device, 1, &inFlightFences[currentFrame]);
// 4. 提交命令缓冲区到图形队列
VkSubmitInfo submitInfo{};
submitInfo.sType = VK_STRUCTURE_TYPE_SUBMIT_INFO;
// 等待条件:必须等到图像拿到后,且在颜色附件写入阶段才阻断
VkSemaphore waitSemaphores[] = { imageAvailableSemaphores[currentFrame] };
VkPipelineStageFlags waitStages[] = { VK_PIPELINE_STAGE_COLOR_ATTACHMENT_OUTPUT_BIT };
submitInfo.waitSemaphoreCount = 1;
submitInfo.pWaitSemaphores = waitSemaphores;
submitInfo.pWaitDstStageMask = waitStages;
submitInfo.commandBufferCount = 1;
submitInfo.pCommandBuffers = ¤tCmdBuffer;
// 唤醒目标:渲染完成时,激活此信号量
VkSemaphore signalSemaphores[] = { renderFinishedSemaphores[currentFrame] };
submitInfo.signalSemaphoreCount = 1;
submitInfo.pSignalSemaphores = signalSemaphores;
// 提交图形队列,并绑定 inFlightFence。当 GPU 全部跑完,硬件自动激活该 Fence 释放 CPU!
if (vkQueueSubmit(graphicsQueue, 1, &submitInfo, inFlightFences[currentFrame]) != VK_SUCCESS) {
throw std::runtime_error("提交图形队列失败!");
}
// 5. 呈递显示给操作系统屏幕
VkPresentInfoKHR presentInfo{};
presentInfo.sType = VK_STRUCTURE_TYPE_PRESENT_INFO_KHR;
presentInfo.waitSemaphoreCount = 1;
presentInfo.pWaitSemaphores = signalSemaphores; // 等待渲染完全完成!
presentInfo.swapchainCount = 1;
presentInfo.pSwapchains = &swapChain;
presentInfo.pImageIndices = &imageIndex;
vkQueuePresentKHR(presentQueue, &presentInfo);
// 推进环形槽位游标
currentFrame = (currentFrame + 1) % maxFramesInFlight;
}
};
工业化落地的死穴与避坑军规
- Fence 初始创建必须加上 VK_FENCE_CREATE_SIGNALED_BIT:如果创建 Fence 时 flags 填 0,在游戏跑第一帧时,CPU 刚进循环调用 vkWaitForFences,由于第一帧还没有任何 GPU 任务去唤醒这个 Fence,CPU 主线程会在此永久挂起,程序瞬间死锁假死。
- 图像索引(Image Index)与飞行帧槽位(Current Frame)的混淆:这是新手最常栽跟头的盲区。交换链里的图像可能有 3 张(imageIndex 为 0, 1, 2),而我们在飞行中的帧可能只有 2 帧(currentFrame 为 0, 1)。vkAcquireNextImageKHR 返回的 imageIndex 是任意无序的,信号量和栅栏必须严格与 currentFrame 槽位绑定,绝对不能用 imageIndex 去索引信号量数组,否则会导致上一帧正在使用的信号量被瞬间错乱覆盖。
- Vulkan 1.3 时间轴信号量(Timeline Semaphores)的前瞻升级:对于超大规模引擎,传统的二值二进制信号量正在被 Vulkan 1.3 原生核心的 Timeline Semaphores 取代。一个时间轴信号量维护一个单调递增的 64 位整数计数器,不仅支持细粒度的跨队列多批次依赖等待,还能同时被 CPU 在主线程显式等待,极大简化了复杂计算着色器与异步传输队列的编排。
让信号量在显卡硬件的极速流转中守住防撕裂的底线,让栅栏在跨物理边界的通信中为 CPU 划定安全的领地。驯服了这两大原语,现代 Vulkan 流水线才能在狂暴的并发计算中,展现出如交响乐般分秒不差的精密秩序。