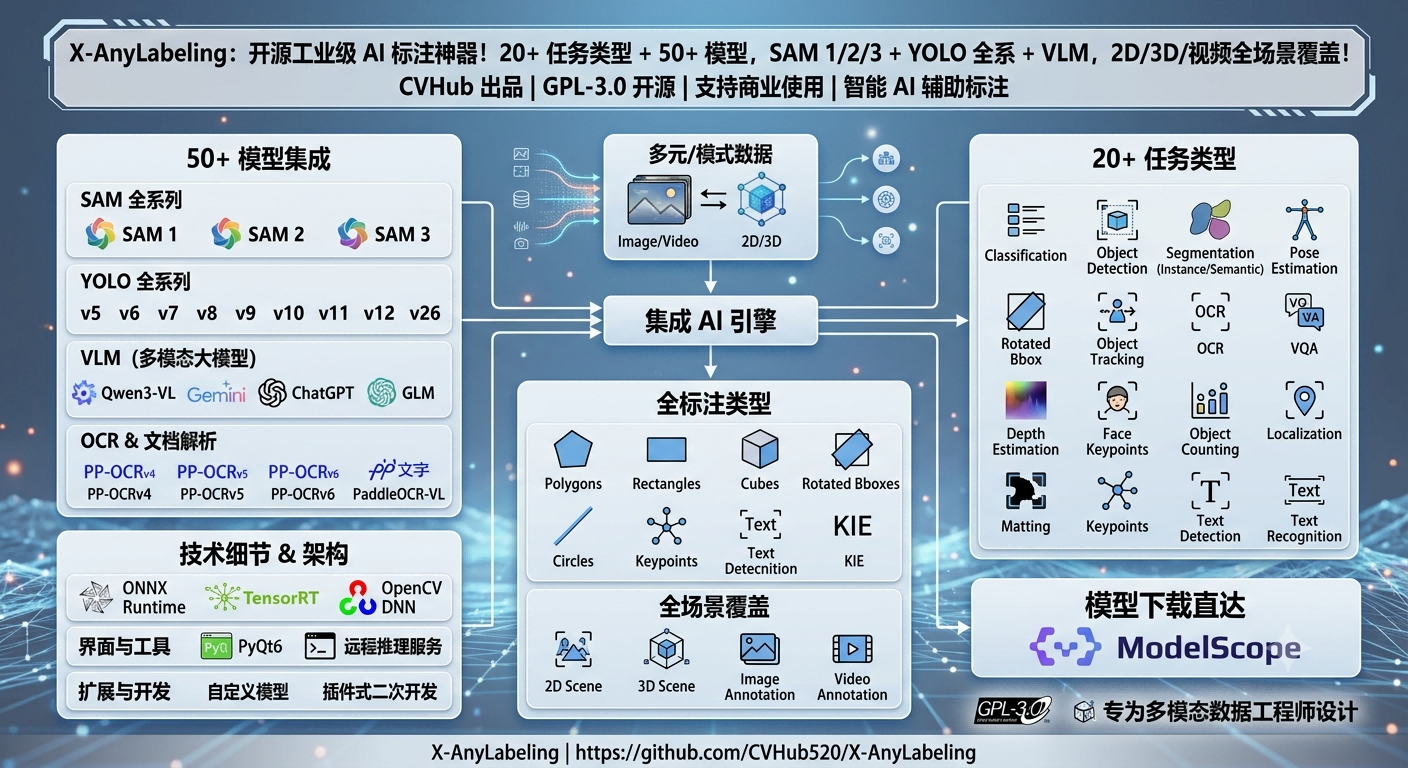
X-AnyLabeling:开源工业级 AI 标注神器!20+ 任务类型 + 50+ 模型,SAM 1/2/3 + YOLO 全系 + VLM,2D/3D/视频全场景覆盖!
💡 CVHub 出品,GPL-3.0 开源,支持商业使用。集成了 AI 引擎的智能标注工具,支持分类/检测/分割/姿态/旋转框/跟踪/OCR/VQA/深度估计/人脸关键点/目标计数/定位/抠图… 20+ 任务 + 50+ 模型。SAM 1/2/3 + YOLO 全系列(v5/v6/v7/v8/v9/v10/v11/v12/v26)+ VLM(Qwen3-VL/Gemini/ChatGPT/GLM)+ OCR(PP-OCRv4/v5/v6)+ PaddleOCR-VL 文档解析。ONNX Runtime / TensorRT / OpenCV DNN 三后端。图像 + 视频标注。多边形/矩形/立方体/旋转框/四边形/圆形/线条/关键点/文本检测/文本识别/KIE 全标注类型。支持自定义模型 + 插件式二次开发。2D/3D 全场景。PyQt6 GUI + CLI。远程推理服务。模型下载直达 ModelScope。
📌 目录
- 1. X-AnyLabeling 是什么?
- 2. 核心特性
- 3. 模型库全景
- 4. 最新更新速览
- 5. 快速上手部署
- 6. 竞品对比
- 7. 适用场景
- 8. 总结与推荐
1. X-AnyLabeling 是什么?
X-AnyLabeling 是 CVHub 出品的一款功能强大的 AI 辅助标注工具,集成 AI 引擎实现快速自动化标注,专为多模态数据工程师设计。
- 🔗 项目地址:https://github.com/CVHub520/X-AnyLabeling
- 🖥️ 远程推理服务:X-AnyLabeling-Server
- 🤗 模型库:ModelScope 集合
- 📜 协议:GPL-3.0(可商用,需保留品牌标识)
- 👤 作者:Wei Wang
- 📧 联系:cv_hub@163.com
你是谁的产品?
X-AnyLabeling = AnyLabeling + LabelMe + LabelImg + roLabelImg + PPOCRLabel + CVAT
+ AI 引擎(SAM + YOLO + VLM + OCR + …)
= 工业级 AI 智能标注工具
一句话总结
X-AnyLabeling = 开源工业级 AI 标注工具(GUI + CLI)
= GPL-3.0,开源免费,可商用
= 20+ 任务类型 + 50+ 模型
= SAM 1/2/3 + YOLOv5~26 + VLM + OCR + 全系列
= ONNX Runtime / TensorRT / OpenCV DNN 三后端
= 图像 + 视频双模式
= 2D/3D 全场景标注
= 12+ 标注样式(多边形/矩形/立方体/旋转框/四边形/圆形/线条/关键点…)
= 8+ 导入导出格式(COCO/VOC/YOLO/DOTA/MOT/MASK/PPOCR/ShareGPT…)
= 四语言 UI(中/英/日/韩)
= 远程推理服务 / 自定义模型 / 一键全图推理
= 标注可视化导出为图片或视频
2. 核心特性
🎯 20+ 任务类型
| 🖼️ 图像分类 | 图像级别 + 形状级别分类 |
| 🎯 目标检测 | 水平框(HBB)+ 旋转框(OBB) |
| 🖌️ 实例分割 | YOLOv5~26 全系分割 |
| 🏃 姿态估计 | 人体关键点 + 人脸关键点 |
| 🧩 SAM 分割 | SAM 1/2/3 + SAM-HQ + SAM-Med2D + EdgeSAM + EfficientViT-SAM + MobileSAM |
| 🔄 旋转目标检测 | YOLO OBB 全系 |
| 📏 深度估计 | Depth Anything |
| 👣 多目标跟踪 | TrackTrack / Bot-SORT / ByteTrack / SAM2/3-Video |
| ✂️ 图像抠图 | RMBG 1.4/2.0 |
| 📄 OCR | PP-OCRv4/v5/v6 文本检测+识别 |
| 📑 文档解析 | PaddleOCR-VL / PaddleOCR-VL-1.6 智能文字识别面板 |
| 🧾 版面分析 | PP-DocLayoutV3 |
| 🗣️ VQA | Qwen3-VL / Gemini / ChatGPT / GLM |
| 💬 Chatbot | 集成对话助手 |
| 🏷️ 自动打标 | RAM / RAM++ |
| 🛣️ 车道线检测 | CLRNet |
| 🔢 目标计数 | CountGD / GeCO / GeCo2 |
| 📍 开集定位 | Grounding DINO / YOLO-World / YOLOE / SAM 3 / LocateAnything |
| 🎥 视频分类 | 时间线段分类 + AI 辅助 |
📐 12+ 标注样式
✅ 多边形(Polygon) ✅ 矩形(Rectangle)
✅ 立方体(Cuboid) ✅ 旋转框(Rotated Box)
✅ 四边形(Quadrilateral) ✅ 圆形(Circle)
✅ 线条(Line) ✅ 线条串(Line Strip)
✅ 关键点(Point) ✅ 文本检测(Text Detection)
✅ 文本识别(Text Recognition)
✅ KIE 关键信息提取
🆕 擦除工具(Eraser) 删除多边形/线条串顶点
🔌 三引擎后端
| ONNX Runtime | 默认,跨平台通用 |
| TensorRT | NVIDIA GPU 加速(2026-04 新增 YOLO 支持) |
| OpenCV DNN | 轻量级推理 |
🌐 四语言 UI
| 简体中文 | zh_CN |
| English | en |
| 日本語 | ja_JP |
| 한국어 | ko_KR |
📦 8+ 导入导出格式
✅ COCO(目标检测/实例分割)
✅ VOC(Pascal VOC 格式)
✅ YOLO(TXT 标注)
✅ DOTA(旋转框检测)
✅ MOT(多目标跟踪)
✅ MASK(分割掩码)
✅ PPOCR(OCR 标注)
✅ MMGD / VLM-R1 / ShareGPT
🖥️ 高级功能
🔥 远程推理服务
→ 搭配 X-AnyLabeling-Server 实现远程 AI 推理
→ 轻量、可扩展
🔥 一键全图推理
→ 当前任务全部图片一次性推理,批量标注
🔥 Auto-Training
→ 标注完成后一键启动 Ultralytics 训练
→ 标注→训练→迭代 闭环工作流
🔥 标注可视化导出
→ 标注结果导出为图片或视频(2026-04)
🔥 标注审核工作流
→ 检查已标注图像的状态(2026-04)
🔥 GUI 内直接设置
→ 内置 Settings 面板,常见选项 GUI 调整
3. 模型库全景
| 🖼️ 图像分类 | YOLOv5-Cls, YOLOv8-Cls, YOLO11-Cls, InternImage, PULC |
| 🎯 目标检测 | YOLOv5/6/7/8/9/10/11/12/26, YOLOX, YOLO-NAS, D-FINE, DAMO-YOLO, Gold_YOLO, RT-DETR, RF-DETR, DEIMv2 |
| 🖌️ 实例分割 | YOLOv5-Seg, YOLOv8-Seg, YOLO11-Seg, YOLO26-Seg, Hyper-YOLO-Seg, RF-DETR-Seg |
| 🏃 姿态估计 | YOLOv8-Pose, YOLO11-Pose, YOLO26-Pose, DWPose, RTMO |
| 😀 人脸估计 | SCRFD, YOLOv6Lite-Face |
| 👣 跟踪 | TrackTrack, Bot-SORT, ByteTrack, SAM2/3-Video |
| 🔄 旋转检测 | YOLOv5-Obb, YOLOv8-Obb, YOLO11-Obb, YOLO26-Obb |
| 📏 深度估计 | Depth Anything |
| 🧩 分割一切 | SAM 1/2/3, SAM-HQ, SAM-Med2D, EdgeSAM, EfficientViT-SAM, MobileSAM |
| ✂️ 抠图 | RMBG 1.4/2.0 |
| 💡 提议 | UPN |
| 🏷️ 打标 | RAM, RAM++ |
| 📄 OCR | PP-OCRv4, PP-OCRv5, PP-OCRv6 |
| 🧾 版面分析 | PP-DocLayoutV3 |
| 📑 文档解析 | PaddleOCR-VL, PaddleOCR-VL-1.6 |
| 🗣️ 视觉基础模型 | Rex-Omni, Florence2 |
| 👁️ 视觉语言模型 | Qwen3-VL, Gemini, ChatGPT, GLM |
| 🛣️ 车道线 | CLRNet |
| 🔢 目标计数 | CountGD, GeCO, GeCo2 |
| 📍 定位 | Grounding DINO, YOLO-World, YOLOE, SAM 3, LocateAnything |
粗体 = 最新/前沿模型。完整模型列表见 model_zoo
YOLO 模型覆盖(地表最全)
YOLOv5 → YOLOv6 → YOLOv7 → YOLOv8 → YOLOv9 → YOLOv10
→ YOLO11 → YOLO12 → YOLO26
每个版本覆盖:
→ 检测(Detect)
→ 分割(Seg)
→ 旋转框(Obb)
→ 分类(Cls)
→ 姿态(Pose)
外加:YOLOX / YOLO-NAS / DAMO-YOLO / Gold_YOLO / YOLO-World / YOLOE
4. 最新更新速览
| 2026-06-20 | 🔥 TrackTrack 多目标跟踪算法 |
| 2026-06-19 | 🔥 PP-OCRv6 多语言文本检测与识别 |
| 2026-06-18 | SCRFD 10G KPS 人脸检测+五点关键点 |
| 2026-06-15 | 擦除工具 快速删除多边形/线条串顶点 |
| 2026-06-06 | 🔥 LocateAnything 开集定位+指向+场景文字检测 |
| 2026-05-23 | 视频分类面板 时间线段分类+AI辅助分割+描述生成 |
| 2026-04-26 | SAM 3 客户端 ONNX 文本定位分割 |
| 2026-04-25 | GeCo2 目标计数模型 |
| 2026-04-19 | 标注审核工作流 + TensorRT YOLO 推理 |
| 2026-04-18 | 标注可视化导出(图片/视频) + PaddleOCR 文档解析面板 |
| 2026-04-01 | 日文/韩文 UI |
| 2026-03-22 | GUI 内置 Settings |
| 2026-03-10 | 3D 立方体 从矩形生成 |
| 2026-03-01 | PyQt5 → PyQt6 升级重构 |
5. 快速上手
pip 安装(推荐)
pip install x-anylabeling-cvhub
# 启动
x-anylabeling-cvhub
从源码安装
git clone https://github.com/CVHub520/X-AnyLabeling.git
cd X-AnyLabeling
# 安装依赖
pip install -r requirements.txt
# 启动
python anylabeling/app.py
模型下载
ModelScope 直达:X-AnyLabeling 模型集合
工作流程
1. 打开图像或视频
2. 选择 AI 模型(SAM/YOLO/OCR…)
3. AI 自动标注
4. 手动微调
5. 导出 COCO/VOC/YOLO 等格式
6. 一键启动 Ultralytics 训练(Auto-Training)
自定义模型
# 基于现有模型二次开发
# 详见 docs/en/custom_model.md
# 插件式架构,支持 ONNX 模型接入
6. 竞品对比
| AI 引擎 | ✅ 50+ 模型 | ❌ | ❌ | ✅ 部分 | ❌ | ✅ PP-OCR |
| 任务类型 | 20+ | 5+ | 1 | 10+ | 1 | 1 |
| SAM 支持 | ✅ SAM 1/2/3 | ❌ | ❌ | ✅ 有限 | ❌ | ❌ |
| VLM 支持 | ✅ Qwen3-VL/Gemini/ChatGPT | ❌ | ❌ | ❌ | ❌ | ❌ |
| 视频标注 | ✅ | ❌ | ❌ | ✅ | ❌ | ❌ |
| 3D 立方体 | ✅ | ❌ | ❌ | ✅ | ❌ | ❌ |
| 旋转框 | ✅ | ❌ | ❌ | ✅ | ✅ | ❌ |
| OCR 标注 | ✅ PP-OCRv4/v5/v6 | ❌ | ❌ | ✅ | ❌ | ✅ |
| 文档解析 | ✅ PaddleOCR-VL | ❌ | ❌ | ❌ | ❌ | ❌ |
| 远程推理 | ✅ X-AnyLabeling-Server | ❌ | ❌ | ✅ | ❌ | ❌ |
| 自动训练 | ✅ Ultralytics | ❌ | ❌ | ❌ | ❌ | ❌ |
| 四语言 UI | ✅ 中/英/日/韩 | ❌ | ❌ | ✅ 多语言 | ❌ | ❌ |
| 三后端 | ✅ ONNX/TRT/OpenCV | ❌ | ❌ | ❌ | ❌ | ❌ |
| PyQt6 | ✅ | ❌ | ❌ | Web | ❌ | ❌ |
| 跨平台 | ✅ Win/Mac/Linux | ✅ | ❌ Win | ✅ Web | ✅ | ✅ |
| 开源协议 | GPL-3.0 | GPL-2.0 | MIT | GPL-2.0 | GPL-2.0 | Apache-2.0 |
最大差异化
1. 50+ 模型集成:地表最全开源标注工具模型库
2. SAM 1/2/3 + VLM:最新分割一切 + 视觉语言模型
3. 20+ 任务:从分类到文档解析,一条龙
4. 三后端:灵活切换 ONNX/TensorRT/OpenCV DNN
5. 视频 + 图像双模式:不仅标图片,也标视频
6. Auto-Training 闭环:标注完直接训练
7. 自定义模型 + 插件式架构:开发者友好
8. GPL-3.0 可商用:企业可用,保留品牌标识即可
7. 适用场景
✅ 适合场景
🎯 CV 数据集制作
→ YOLO/COCO/VOC 格式数据集标注
→ SAM 辅助分割标注,效率提升 10x
📄 文档数字化
→ OCR 文本检测 + 识别
→ PaddleOCR-VL 文档解析 + KIE
📊 工业质检
→ 旋转框 + 多边形标注
→ 目标计数 + 缺陷检测
🤖 多模态数据标注
→ VQA 问答对标注
→ 图像描述生成
🎬 视频分析
→ 多目标跟踪标注
→ 视频分类 + 时间线标注
🏥 医学图像
→ SAM-Med2D 医学图像分割
→ 姿态估计
🏗️ 自动驾驶
→ 车道线检测
→ 3D 立方体标注
→ 深度估计
8. 总结与推荐
推荐指数:⭐⭐⭐⭐⭐
| 功能 | ⭐⭐⭐⭐⭐ | 20+ 任务,50+ 模型,地表最强 |
| 模型 | ⭐⭐⭐⭐⭐ | SAM 1/2/3 + YOLO 全系 + VLM + OCR |
| 易用 | ⭐⭐⭐⭐ | pip 一键安装,但模型较多需熟悉 |
| 开源 | ⭐⭐⭐⭐ | GPL-3.0 可商用 |
| 创新 | ⭐⭐⭐⭐⭐ | Auto-Training 闭环 + 远程推理 + 三后端 |
| 跨平台 | ⭐⭐⭐⭐⭐ | Win/Mac/Linux |
一句话推荐
如果你需要一款开源免费的 AI 辅助标注工具,X-AnyLabeling 是目前功能最全、模型最多的选择。
50+ 模型覆盖 SAM 1/2/3 + YOLO 全系 + VLM + OCR,
20+ 任务类型从分类到文档解析一条龙,
2D/3D/视频全场景覆盖,
Auto-Training 标注完直接训练,
ppip 一行安装即用。
CV 数据标注,有这一款就够了。
📢 项目地址:https://github.com/CVHub520/X-AnyLabeling 🖥️ 远程推理:X-AnyLabeling-Server 🤗 模型下载:ModelScope 集合 📖 文档:docs/
原文链接:https://github.com/CVHub520/X-AnyLabeling
标签:#X-AnyLabeling #数据标注 #CVHub #SAM #YOLO #OCR #VLM #AI标注 #开源 #GPL3 #深度学习 #计算机视觉 分类:原创文章