前面几篇分别讲了 ApplicationMaster、ResourceManager、Dispatcher 的启动流程,这篇聚焦 Flink 集群的核心——JobManager。你有没有想过,执行 bin/yarn-session.sh 或 bin/flink run -m yarn-cluster 后,JobManager 进程内部依次启动了哪些组件?ResourceManager 和 Dispatcher 为什么必须按顺序启动?JobMaster 是如何从 JobGraph 构建 ExecutionGraph 并调度 Task 的?这篇从 ClusterEntrypoint 入口讲起,深入 JobManager 内部组件启动流程,剖析 JobMaster 启动和 ExecutionGraph 构建的源码,把 JobManager 从进程启动到作业执行的完整链路讲透。
一、JobManager 整体架构
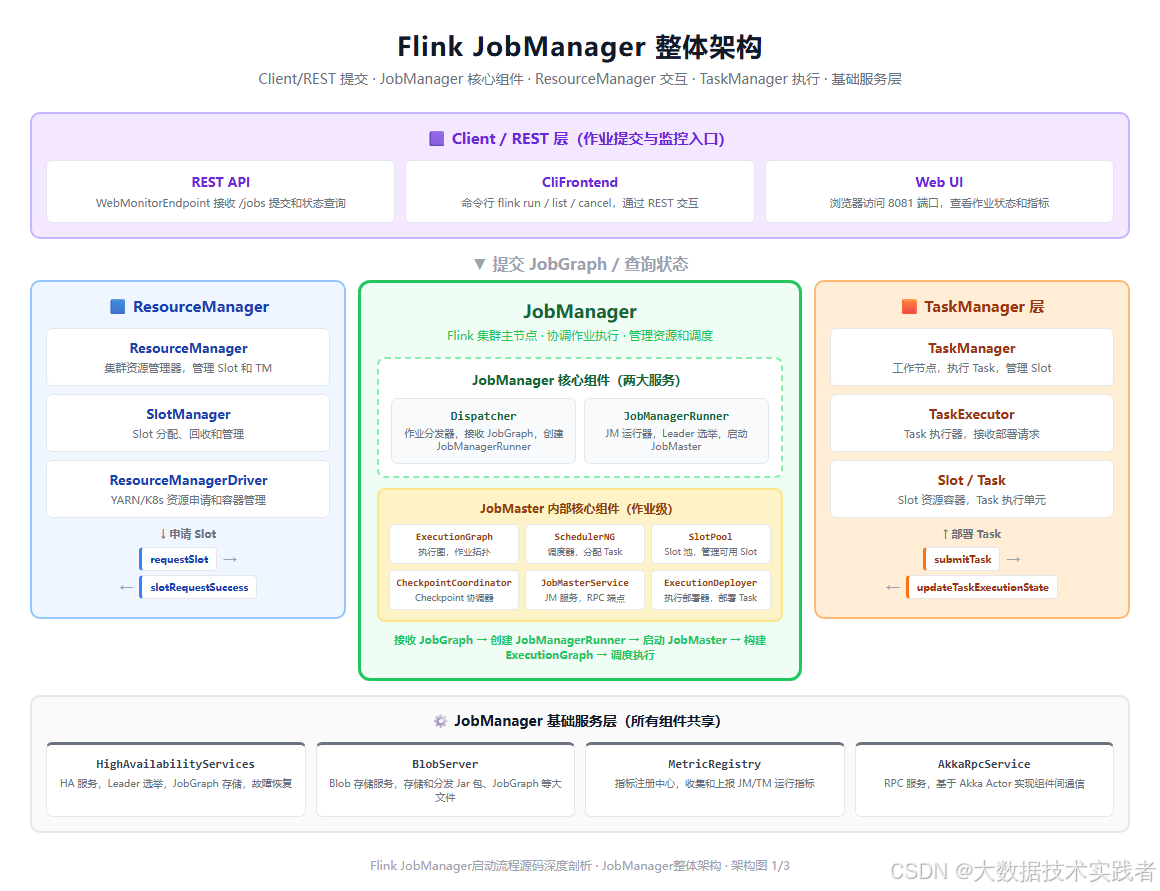
下面这张图是 Flink JobManager 整体架构,包括 Client/REST 层、JobManager 核心组件(ResourceManager / Dispatcher / JobMaster)、TaskManager 执行层,以及基础服务层。
1.1 JobManager 在 Flink 集群中的定位
JobManager 是 Flink 集群的主节点(Master),负责协调集群的所有作业执行。它的核心职责包括:
- 资源管理:通过 ResourceManager 管理集群资源,分配 Slot 给作业
- 作业分发:通过 Dispatcher 接收客户端提交的 JobGraph,创建并启动 JobMaster
- 作业调度:通过 JobMaster 构建 ExecutionGraph,调度 Task 到 TaskManager 执行
- 状态管理:通过 CheckpointCoordinator 触发和管理 Checkpoint,保证容错
- 监控服务:通过 WebMonitorEndpoint 提供 REST API 和 Web UI,监控作业状态
JobManager 不是一个单一组件,而是一个进程内运行多个服务的集合。理解 JobManager 的启动,就是理解这些服务如何按顺序初始化、如何协作。
1.2 JobManager 核心组件
JobManager 进程内运行以下核心组件:
ResourceManager:集群资源管理器。负责管理 TaskManager 的注册和心跳,通过 SlotManager 分配和回收 Slot,通过 ResourceManagerDriver 与 YARN/K8s 交互申请容器。ResourceManager 是集群级别的,所有作业共享。
Dispatcher:作业分发器。负责接收客户端提交的 JobGraph(通过 REST API),创建 JobManagerRunner,启动 JobMaster。Dispatcher 管理所有运行中作业的生命周期,HA 模式下持久化 JobGraph。
JobManagerRunner:作业级运行器。每个作业对应一个 JobManagerRunner 实例,负责该作业的 Leader 选举(HA 模式下可能有多个 Standby),选举成功后启动 JobMaster。
JobMaster:作业主节点。每个作业对应一个 JobMaster 实例,负责构建 ExecutionGraph,调度 Task 执行,管理 Checkpoint,监控作业状态。JobMaster 是作业级别的,每个作业独立。
WebMonitorEndpoint:REST 端点。提供 /jobs、/overview、/config 等 REST API,以及 Web UI 界面。客户端通过 REST API 提交作业、查询状态、取消作业。
1.3 JobMaster 内部核心组件
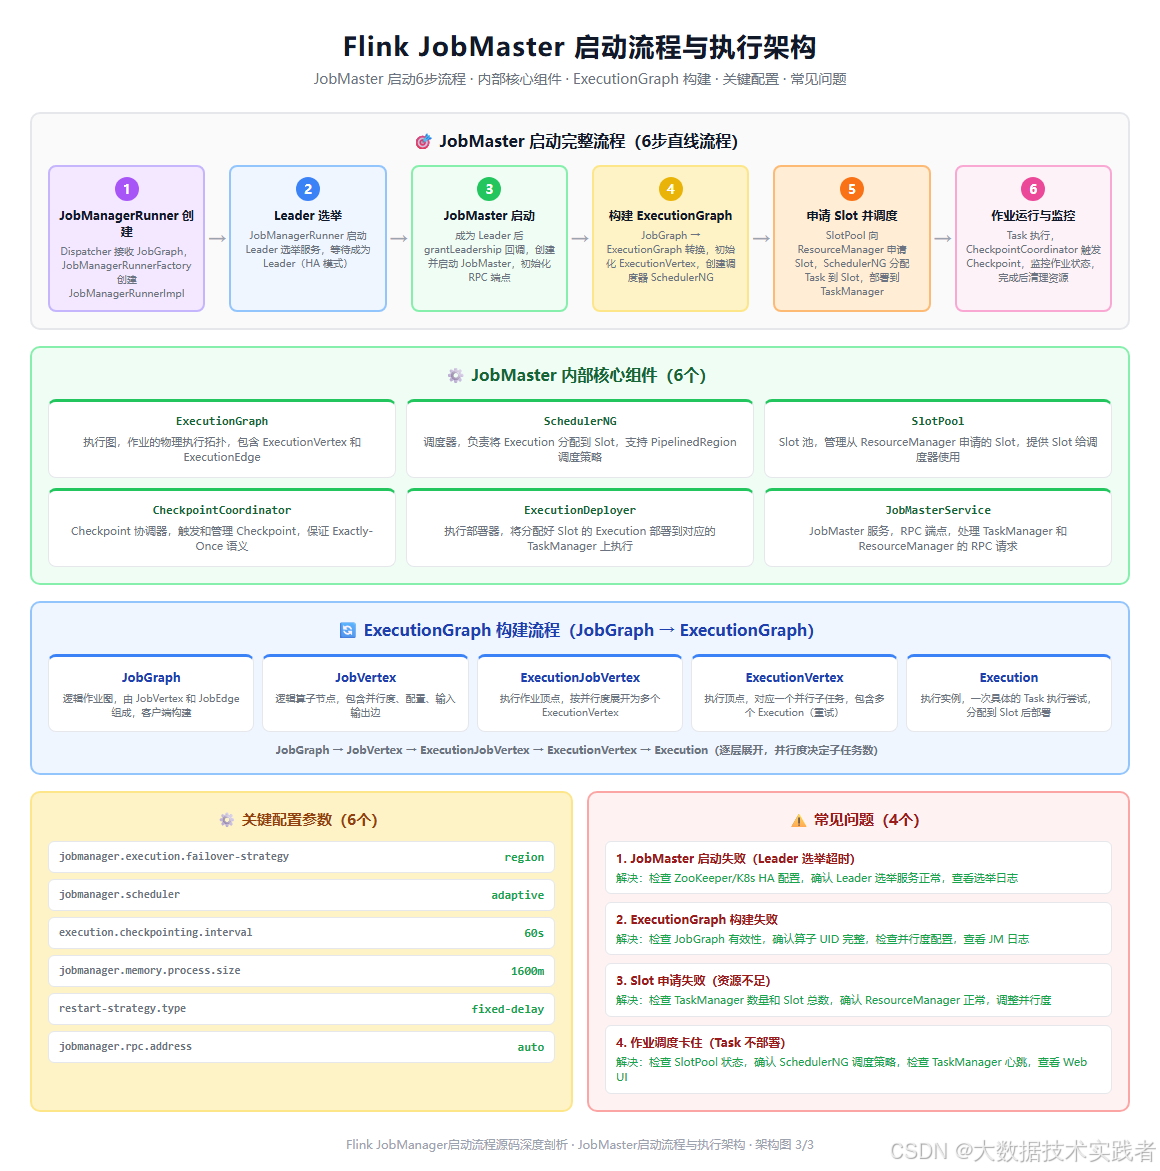
JobMaster 内部有6个核心组件,各司其职:
ExecutionGraph:执行图。作业的物理执行拓扑,由 JobGraph 转换而来,包含 ExecutionJobVertex、ExecutionVertex、Execution 三层结构。
SchedulerNG:调度器。负责将 Execution 分配到 Slot,支持 PipelinedRegion 调度策略,按区域调度 Task。
SlotPool:Slot 池。管理从 ResourceManager 申请的 Slot,提供 Slot 给调度器使用,维护 Slot 的可用性和生命周期。
CheckpointCoordinator:Checkpoint 协调器。触发和管理 Checkpoint,协调 Source 触发 Checkpoint,收集 Task 的 Checkpoint 确认,保证 Exactly-Once 语义。
ExecutionDeployer:执行部署器。将分配好 Slot 的 Execution 部署到对应的 TaskManager 上执行,处理部署失败和重试。
JobMasterService:JobMaster 服务。RPC 端点,处理 TaskManager 和 ResourceManager 的 RPC 请求,如 Task 状态更新、Slot 分配确认等。
二、ClusterEntrypoint 启动流程源码
JobManager 的启动始于 ClusterEntrypoint,这是所有 Flink 集群入口的抽象基类。
2.1 八步标准启动流程
public abstract class ClusterEntrypoint implements AutoCloseable {
public void startCluster() throws Exception {
try {
// 1. 初始化基础组件
pluginManager = PluginUtils.createPluginManager(...);
FileSystem.initialize(configuration, pluginManager);
SecurityUtils.install(new SecurityConfiguration(configuration));
MetricRegistry metricRegistry = createMetricRegistry(configuration);
// 2. 启动 RPC 服务
rpcService = createRpcService(configuration);
// 3. 启动 HA 服务
haServices = createHaServices(configuration, rpcService);
// 4. 启动 BlobServer
blobServer = new BlobServer(configuration, haServices.createBlobStore());
// 5. 启动 ResourceManager(必须在 Dispatcher 之前)
resourceManager = createResourceManager(...);
resourceManager.start();
// 6. 启动 Dispatcher
dispatcher = createDispatcher(...);
dispatcher.start();
// 7. 启动 REST 端点
webMonitorEndpoint = createRestEndpoint(...);
webMonitorEndpoint.start();
// 8. 进入 RUNNING 状态
LOG.info("JobManager started successfully.");
} catch (Exception e) {
throw new FlinkException("Could not start cluster entrypoint.", e);
}
}
}
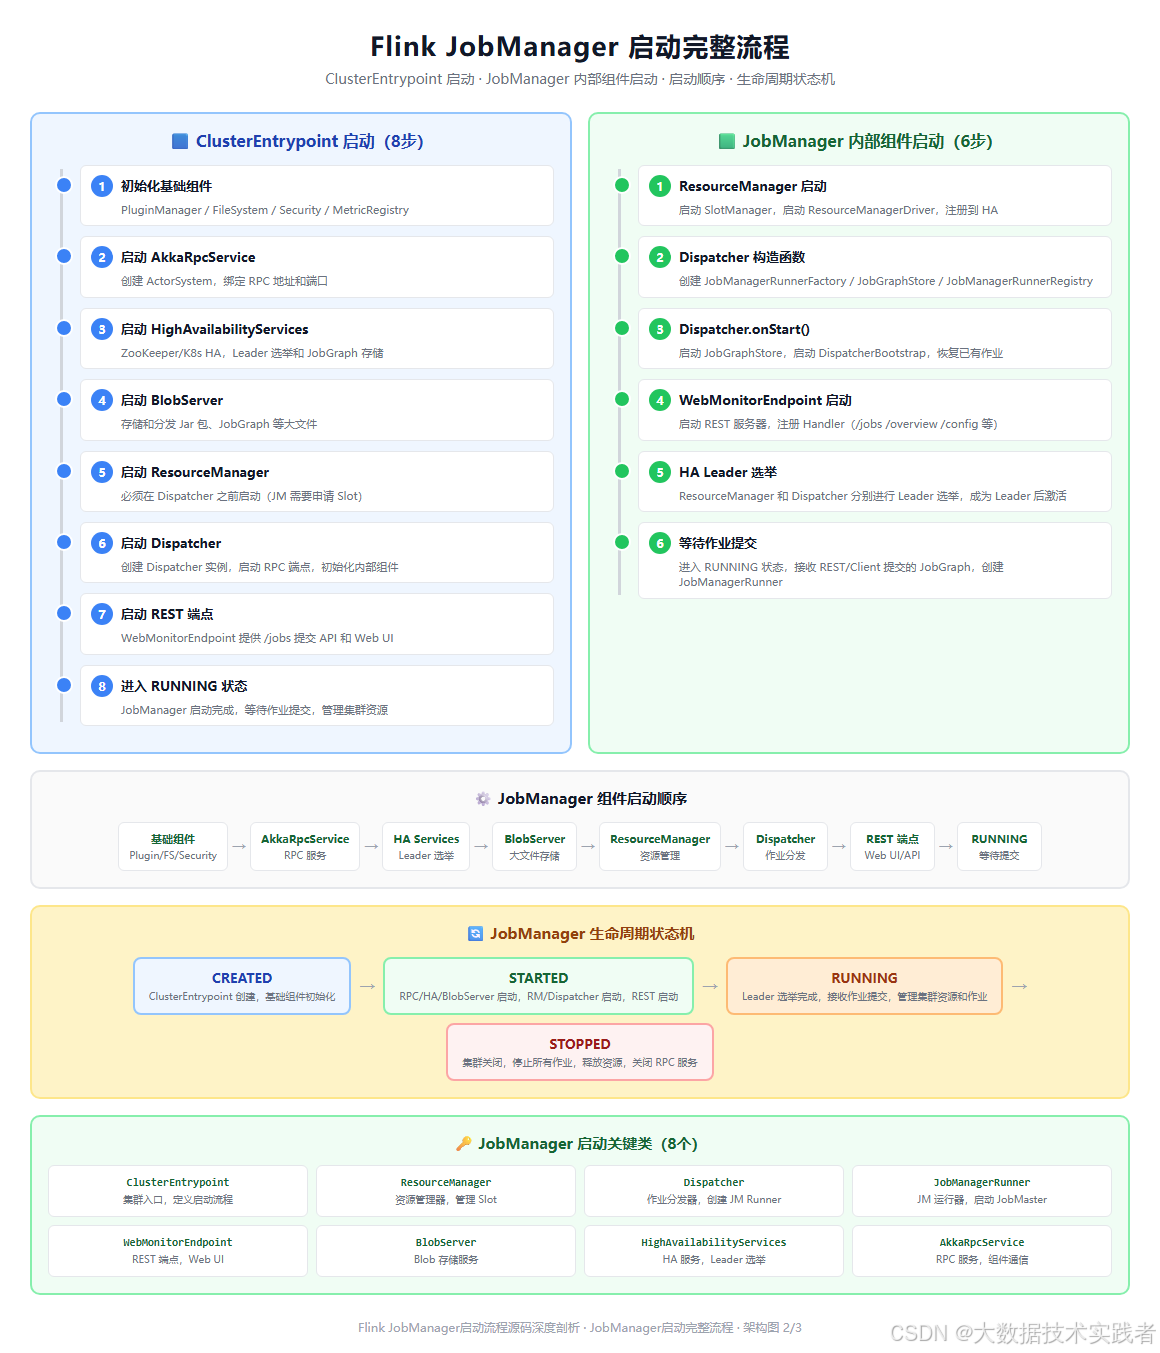
关键顺序:基础组件 → RPC → HA → BlobServer → ResourceManager → Dispatcher → REST → RUNNING。
为什么 ResourceManager 必须在 Dispatcher 之前启动?因为 Dispatcher 启动 JobManagerRunner 后,JobMaster 需要向 ResourceManager 申请 Slot。如果 RM 还没启动,JM 的 Slot 请求就会失败。所以启动顺序是严格的:先有资源管理者,再有作业分发者,最后有 REST 接口。
2.2 具体 ClusterEntrypoint 实现
不同部署模式有不同的 ClusterEntrypoint 实现:
// YARN Session 模式
public class YarnSessionClusterEntrypoint extends SessionClusterEntrypoint {
@Override
protected ResourceManager createResourceManager(...) {
return new ActiveResourceManager(...); // YARN ActiveResourceManager
}
}
// YARN Application 模式
public class YarnApplicationClusterEntrypoint extends ApplicationClusterEntrypoint {
@Override
protected Dispatcher createDispatcher(...) {
return new ApplicationDispatcher(...); // ApplicationDispatcher
}
}
// Standalone 模式
public class StandaloneSessionClusterEntrypoint extends SessionClusterEntrypoint {
@Override
protected ResourceManager createResourceManager(...) {
return new StandaloneResourceManager(...); // StandaloneResourceManager
}
}
三种模式的差异主要在 ResourceManager(Active vs Standalone)和 Dispatcher(Application vs Standalone)的实现上,启动流程完全复用 ClusterEntrypoint 的标准八步。
三、JobManager 内部组件启动流程
下面这张图是 JobManager 启动完整流程,包括 ClusterEntrypoint 启动8步、JobManager 内部组件启动6步、启动顺序横条、生命周期状态机和8个关键类。
3.1 ResourceManager 启动
ResourceManager 是第一个启动的核心服务:
public class ResourceManagerImpl<WorkerType extends ResourceIDRetrievable>
extends FencedRpcEndpoint<ResourceManagerId>
implements ResourceManager<WorkerType> {
@Override
public void onStart() throws Exception {
try {
// 1. 启动 SlotManager
slotManager.start();
// 2. 启动 ResourceManagerDriver
resourceManagerDriver.initialize();
// 3. 启动 Leader 选举
leaderElectionService.start(this);
// 4. 启动心跳服务
taskManagerHeartbeatManager = HeartbeatManagerImplImpl(...);
jobManagerHeartbeatManager = HeartbeatManagerImplImpl(...);
} catch (Exception e) {
throw new ResourceManagerException("Could not start the ResourceManager.", e);
}
}
@Override
public void grantLeadership(UUID newLeaderSessionID) {
// 成为 Leader 后激活,开始接收 TaskManager 注册和 Slot 请求
leaderSessionID = newLeaderSessionID;
registerMetrics();
}
}
ResourceManager 启动后进行 Leader 选举,成为 Leader 后激活。SlotManager 负责 Slot 的分配和回收,ResourceManagerDriver 负责与 YARN/K8s 交互申请容器。
3.2 Dispatcher 启动
Dispatcher 在 ResourceManager 之后启动:
public abstract class Dispatcher extends FencedRpcEndpoint<DispatcherId>
implements DispatcherGateway {
@Override
public void onStart() throws Exception {
try {
// 1. 启动 JobGraphStore
jobGraphStore.start(new JobGraphStoreListener() {
@Override
public void onAddedJobGraph(JobID jobId) {
runRecoveredJob(jobId); // HA 恢复
}
});
// 2. 启动 DispatcherBootstrap
dispatcherBootstrap.initialize(...); // Application 模式执行用户 main
// 3. 恢复已有作业
recoverJobs(); // 从 JobGraphStore 恢复已提交作业
} catch (Exception e) {
throw new DispatcherException("Could not start the Dispatcher.", e);
}
}
}
Dispatcher 启动后初始化 JobGraphStore、DispatcherBootstrap,恢复已有作业。Application 模式下 DispatcherBootstrap 会执行用户 main 方法,构建 JobGraph 并直接提交。
3.3 WebMonitorEndpoint 启动
WebMonitorEndpoint 是最后启动的核心服务:
public class WebMonitorEndpoint<T extends RestfulGateway>
extends RestServerEndpoint
implements LeaderRetrievalListener {
@Override
public void start() throws Exception {
// 1. 启动 REST 服务器
super.start();
// 2. 注册 Handler
// /jobs – 提交作业
// /jobs/:jobid – 作业详情
// /jobs/overview – 作业概览
// /taskmanagers – TaskManager 列表
// /config – 集群配置
// /metrics – 指标查询
// 3. 启动 Leader 检索
leaderRetrievalService.start(this);
}
}
WebMonitorEndpoint 启动后,JobManager 就可以接收客户端的 REST 请求了。客户端通过 POST /jobs 提交 JobGraph,通过 GET /jobs/overview 查询作业状态。
四、JobMaster 启动流程源码
下面这张图是 JobMaster 启动流程与执行架构,包括 JobMaster 启动6步直线流程、内部6个核心组件、ExecutionGraph 构建流程、关键配置和常见问题。
4.1 JobManagerRunner 创建与 Leader 选举
JobMaster 的启动始于 JobManagerRunner 的创建:
public class JobManagerRunnerImpl implements JobManagerRunner {
private final JobGraph jobGraph;
private final Configuration configuration;
private final HighAvailabilityServices haServices;
private final LeaderElectionService leaderElectionService;
private JobMaster jobMaster;
public JobManagerRunnerImpl(
JobGraph jobGraph,
Configuration configuration,
HighAvailabilityServices haServices,
...) throws Exception {
this.jobGraph = jobGraph;
this.configuration = configuration;
this.haServices = haServices;
// 创建 Leader 选举服务
this.leaderElectionService = haServices.getJobManagerLeaderElectionService(jobGraph.getJobID());
}
@Override
public void start() throws Exception {
// 启动 Leader 选举
leaderElectionService.start(this);
}
@Override
public void grantLeadership(UUID leaderSessionID) {
// 成为 Leader 后启动 JobMaster
try {
jobMaster = new JobMaster(...);
jobMaster.start();
} catch (Exception e) {
handleJobManagerRunnerError(e);
}
}
}
JobManagerRunner 启动后进行 Leader 选举,成为 Leader 后(grantLeadership 回调)创建并启动 JobMaster。HA 模式下可能有多个 JobManagerRunner 实例(Standby),只有一个能成为 Leader 并启动 JobMaster。
4.2 JobMaster 启动与 ExecutionGraph 构建
JobMaster 启动后构建 ExecutionGraph:
public class JobMaster extends FencedRpcEndpoint<JobMasterId>
implements JobMasterGateway {
private final JobGraph jobGraph;
private ExecutionGraph executionGraph;
private SchedulerNG schedulerNG;
private SlotPool slotPool;
private CheckpointCoordinator checkpointCoordinator;
@Override
public void onStart() throws Exception {
try {
// 1. 启动 SlotPool
slotPool.start();
// 2. 构建 ExecutionGraph
executionGraph = buildExecutionGraph();
// 3. 创建调度器
schedulerNG = createScheduler(executionGraph);
// 4. 启动 CheckpointCoordinator
checkpointCoordinator = executionGraph.getCheckpointCoordinator();
checkpointCoordinator.start();
// 5. 启动调度
schedulerNG.start();
} catch (Exception e) {
throw new JobMasterException("Could not start the JobMaster.", e);
}
}
private ExecutionGraph buildExecutionGraph() throws Exception {
// JobGraph → ExecutionGraph 转换
return ExecutionGraphBuilder.buildGraph(
null,
jobGraph,
configuration,
...);
}
}
JobMaster 启动后依次:启动 SlotPool → 构建 ExecutionGraph → 创建 SchedulerNG → 启动 CheckpointCoordinator → 启动调度。调度器启动后,作业就开始申请 Slot、部署 Task、执行计算。
4.3 ExecutionGraph 构建流程
ExecutionGraph 的构建是 JobMaster 最核心的工作之一:
public class ExecutionGraphBuilder {
public static ExecutionGraph buildGraph(...) throws Exception {
// 1. 创建 ExecutionGraph
ExecutionGraph executionGraph = new ExecutionGraph(...);
// 2. 遍历 JobGraph 的 JobVertex
for (JobVertex jobVertex : jobGraph.getVertices()) {
// 3. 为每个 JobVertex 创建 ExecutionJobVertex
ExecutionJobVertex ejv = new ExecutionJobVertex(
executionGraph,
jobVertex,
jobVertex.getParallelism(),
...);
// 4. ExecutionJobVertex 按并行度展开为 ExecutionVertex
ejv.connectToPredecessors(...); // 连接上游
}
// 5. 完成拓扑连接
executionGraph.attachJobGraph(...);
return executionGraph;
}
}
ExecutionGraph 的构建是逐层展开的:
- JobGraph:逻辑作业图,由 JobVertex 和 JobEdge 组成
- JobVertex:逻辑算子节点,包含并行度、配置
- ExecutionJobVertex:执行作业顶点,对应一个 JobVertex
- ExecutionVertex:执行顶点,对应一个并行子任务(并行度决定数量)
- Execution:执行实例,一次具体的 Task 执行尝试(重试会创建多个)
4.4 调度与 Slot 申请
SchedulerNG 启动后开始调度:
public class DefaultScheduler extends SchedulerNG {
@Override
public void startScheduling() {
// 1. 计算调度拓扑(PipelinedRegion)
schedulingTopology = buildSchedulingTopology();
// 2. 按区域调度
for (SchedulingPipelinedRegion region : schedulingTopology.getAllPipelinedRegions()) {
// 3. 为区域内的 Execution 申请 Slot
allocateSlotsAndDeploy(region.getVertices());
}
}
private void allocateSlotsAndDeploy(Collection<ExecutionVertex> vertices) {
// 向 SlotPool 申请 Slot
for (ExecutionVertex vertex : vertices) {
Execution execution = vertex.getCurrentExecutionAttempt();
slotPool.allocateSlot(...).thenAccept(slot -> {
// Slot 分配后部署 Task
execution.deployToSlot(slot);
});
}
}
}
调度器按 PipelinedRegion(流水线区域)调度,每个区域内的 Task 必须同时部署(因为它们之间是流水线连接)。SlotPool 向 ResourceManager 申请 Slot,Slot 分配后 ExecutionDeployer 将 Task 部署到对应的 TaskManager 上执行。
五、核心类源码剖析
5.1 ClusterEntrypoint
ClusterEntrypoint 是 JobManager 启动的入口,定义了标准的八步启动流程。它是抽象类,由具体的部署模式实现(YarnSessionClusterEntrypoint、YarnApplicationClusterEntrypoint、StandaloneSessionClusterEntrypoint 等)。核心方法是 startCluster(),按顺序初始化基础组件、RPC、HA、BlobServer、ResourceManager、Dispatcher、REST 端点。
5.2 JobManagerRunnerImpl
JobManagerRunnerImpl 是 JobManagerRunner 的默认实现,负责单个作业的 Leader 选举和 JobMaster 启动。每个作业对应一个 JobManagerRunnerImpl 实例。核心流程:start() 启动 Leader 选举 → grantLeadership() 成为 Leader → 创建并启动 JobMaster。HA 模式下多个 Standby 实例竞争 Leader,只有一个能启动 JobMaster。
5.3 JobMaster
JobMaster 是作业的主节点,负责作业的调度执行。每个作业对应一个 JobMaster 实例。核心组件:ExecutionGraph(执行图)、SchedulerNG(调度器)、SlotPool(Slot 池)、CheckpointCoordinator(Checkpoint 协调器)、ExecutionDeployer(执行部署器)、JobMasterService(RPC 服务)。核心流程:onStart() → 启动 SlotPool → 构建 ExecutionGraph → 创建 SchedulerNG → 启动 CheckpointCoordinator → 启动调度。
5.4 ExecutionGraph
ExecutionGraph 是作业的物理执行拓扑,由 JobGraph 转换而来。三层结构:ExecutionJobVertex(对应 JobVertex)→ ExecutionVertex(对应并行子任务)→ Execution(对应一次执行尝试)。ExecutionGraph 管理所有 Execution 的状态转换(CREATED → SCHEDULED → DEPLOYING → RUNNING → FINISHED/FAILED),是调度和监控的核心数据结构。
5.5 SchedulerNG
SchedulerNG 是调度器接口,默认实现是 DefaultScheduler。负责将 Execution 分配到 Slot 并部署。核心概念是 PipelinedRegion(流水线区域),区域内的 Task 必须同时部署。核心流程:startScheduling() → 构建调度拓扑 → 按区域调度 → 申请 Slot → 部署 Task。调度策略支持 EAGER(所有 Task 同时部署)和 LAZY_FROM_SOURCES(从 Source 开始逐步部署)。
5.6 SlotPool
SlotPool 是 Slot 池,管理从 ResourceManager 申请的 Slot。核心功能:向 ResourceManager 申请 Slot、提供 Slot 给调度器使用、维护 Slot 的可用性和生命周期、释放空闲 Slot。SlotPool 启动后向 ResourceManager 注册,调度器需要 Slot 时调用 allocateSlot(),SlotPool 优先使用已有 Slot,不足时向 RM 申请。
六、关键配置参数
# 故障恢复策略(region:只重启受影响区域;full:重启整个作业)
jobmanager.execution.failover-strategy: region
# 调度器类型(adaptive:自适应调度;default:默认调度)
jobmanager.scheduler: adaptive
# Checkpoint 间隔(毫秒,0 表示禁用)
execution.checkpointing.interval: 60000
# JobManager 进程总内存(包含 JVM 堆、堆外、JVM 元空间等)
jobmanager.memory.process.size: 1600m
# 重启策略(fixed-delay:固定延迟重启;failure-rate:失败率重启)
restart-strategy.type: fixed–delay
# JobManager RPC 地址(自动获取)
jobmanager.rpc.address: auto
# JobManager RPC 端口
jobmanager.rpc.port: 6123
# REST API 端口
rest.port: 8081
关键配置说明:
- jobmanager.execution.failover-strategy:故障恢复策略,region 只重启受影响区域,生产环境用 region
- jobmanager.scheduler:调度器类型,adaptive 支持动态调整并行度,生产环境推荐
- execution.checkpointing.interval:Checkpoint 间隔,根据业务需求配置,流式作业建议开启
- jobmanager.memory.process.size:JobManager 进程总内存,大作业或高并发时需要调大
- restart-strategy.type:重启策略,fixed-delay 固定延迟重启,生产环境建议配置
- rest.port:REST API 端口,生产环境建议配置端口范围避免冲突
七、常见问题与最佳实践
7.1 常见问题
问题1:JobManager 启动失败(端口冲突)
- 原因:RPC 端口 6123 或 REST 端口 8081 被占用,多实例部署时端口冲突
- 解决:配置 jobmanager.rpc.port 和 rest.bind-port 为端口范围(如 6123-6130),检查端口占用
问题2:JobMaster 启动失败(Leader 选举超时)
- 原因:ZooKeeper/K8s HA 配置错误,Leader 选举服务异常,网络不通
- 解决:检查 HA 配置(high-availability.type、high-availability.zookeeper.quorum),确认 ZooKeeper 集群正常,查看选举日志
问题3:ExecutionGraph 构建失败
- 原因:JobGraph 无效,算子缺少 UID,并行度配置错误,类加载冲突
- 解决:为所有算子指定 UID,检查并行度配置,使用 maven-shade 打包依赖,查看 JM 日志
问题4:Slot 申请失败(资源不足)
- 原因:TaskManager 数量不足,Slot 总数不够,ResourceManager 异常
- 解决:增加 TaskManager 数量或 Slot 数,检查 ResourceManager 状态,调整作业并行度
7.2 最佳实践
1. 为所有算子指定 UID:生产环境必须为所有算子指定 uid(),确保 JobGraph 序列化和 Savepoint 恢复时算子状态正确映射。缺少 UID 可能导致 ExecutionGraph 构建失败或状态恢复错误。
2. 配置 HA 高可用:生产环境必须配置 ZooKeeper 或 K8s HA,设置 high-availability.storageDir,确保 JobManager 故障后作业可自动恢复。Leader 选举是 JobMaster 启动的前提。
3. 合理配置 JobManager 内存:JobManager 内存根据作业规模和并发数配置。大作业的 ExecutionGraph 占用内存较多,高并发时 CheckpointCoordinator 也需要更多内存。建议 jobmanager.memory.process.size 不低于 1600m,大作业适当调大。
4. 使用 region 故障恢复策略:生产环境使用 jobmanager.execution.failover-strategy: region,只重启受影响的 PipelinedRegion,避免整个作业重启。这可以大幅减少故障恢复时间,提高作业可用性。
5. 监控 JobManager 指标:关注 JobManager 的堆内存使用、GC 时间、作业数、Slot 使用率、Checkpoint 耗时和成功率。配置 Prometheus 指标上报和告警,及时发现内存溢出、Checkpoint 失败等问题。
6. 优化调度策略:根据作业类型选择调度策略。流式作业使用 LAZY_FROM_SOURCES(从 Source 开始逐步部署),批处理作业使用 EAGER(所有 Task 同时部署)。adaptive 调度器支持动态调整并行度,适合资源波动场景。
八、总结
Flink JobManager 启动流程源码深度剖析要点回顾:
第一,JobManager 整体架构是理解的基础。JobManager 是 Flink 集群的主节点,进程内运行多个核心服务:ResourceManager(集群资源管理,Slot 分配)、Dispatcher(作业分发,创建 JobManagerRunner)、JobManagerRunner(作业级运行器,Leader 选举)、JobMaster(作业主节点,调度执行)、WebMonitorEndpoint(REST API 和 Web UI)。JobMaster 内部6个核心组件:ExecutionGraph、SchedulerNG、SlotPool、CheckpointCoordinator、ExecutionDeployer、JobMasterService。
第二,ClusterEntrypoint 启动流程是标准八步:基础组件 → RPC → HA → BlobServer → ResourceManager → Dispatcher → REST → RUNNING。ResourceManager 必须在 Dispatcher 之前启动,因为 JobMaster 启动后需要向 RM 申请 Slot。不同部署模式(YARN Session / YARN Application / Standalone)有不同的 ClusterEntrypoint 实现,但启动流程完全复用。
第三,JobManager 内部组件启动是三步核心服务依次启动:ResourceManager(启动 SlotManager、ResourceManagerDriver、Leader 选举)→ Dispatcher(启动 JobGraphStore、DispatcherBootstrap、恢复作业)→ WebMonitorEndpoint(启动 REST 服务器、注册 Handler)。每个服务都有独立的 Leader 选举和生命周期管理。
第四,JobMaster 启动流程是六步:JobManagerRunner 创建 → Leader 选举 → JobMaster 启动 → 构建 ExecutionGraph → 申请 Slot 并调度 → 作业运行与监控。ExecutionGraph 构建是逐层展开的:JobGraph → JobVertex → ExecutionJobVertex → ExecutionVertex → Execution。调度器按 PipelinedRegion 调度,SlotPool 向 RM 申请 Slot,ExecutionDeployer 部署 Task 到 TaskManager。
第五,核心类源码是理解实现的关键。ClusterEntrypoint 定义标准启动流程,JobManagerRunnerImpl 负责作业级 Leader 选举和 JobMaster 启动,JobMaster 负责作业调度执行,ExecutionGraph 是物理执行拓扑,SchedulerNG 负责 Slot 分配和 Task 调度,SlotPool 管理 Slot 资源。
理解 Flink JobManager 的启动流程,不仅能帮助排查 JobManager 启动失败、Leader 选举超时、ExecutionGraph 构建失败、Slot 申请失败等常见问题,更能体会到 Flink 集群管理的分层设计——ClusterEntrypoint 负责进程启动,ResourceManager 负责集群资源,Dispatcher 负责作业分发,JobManagerRunner 负责作业级 Leader 选举,JobMaster 负责作业调度执行。五者通过 JobGraph 和 Slot 机制协作,构成了 Flink 集群完整的启动和执行体系。