文章目录
-
- 1. 先把问题讲清楚:预算固定时,模型越大不一定越划算
- 2. 训练计算量的粗略公式怎么读
- 3. 什么是 compute-optimal
- 4. 用预算反推参数和 token
- 5. “最优参数/数据比”不要机械理解
- 6. 训练最优不等于推理最优
- 7. 数据质量会改变预算结论
- 8. 对持续预训练的启发
- 9. 对企业模型选型的启发
- 10. 一个训练预算评审清单
- 11. 常见误区
- 12. 小结
- 大模型视角
- 下一篇
摘要:Chinchilla Law 讨论的是一个很现实的预算问题:固定训练算力下,应该训练更大的模型,还是让较小模型看更多 token?它的重要启发不是“小模型一定更好”,而是参数量和训练 token 数要匹配,很多模型如果参数很大但训练数据不足,会处在“欠训练”状态。本文会用开发者能理解的方式解释 compute-optimal 的直觉、粗略计算公式、预算估算代码、训练最优与推理最优的差别,以及它对持续预训练和企业选型的影响。
- 前置知识:专栏一Scaling Law、交叉熵、优化器;专栏二预训练流程
- 阅读时间:45-55 分钟
- 代码环境:Python 3.10+,示例只依赖标准库
- 读完目标:能解释为什么不能只堆参数,能用粗略公式估算训练计算量,能判断“数据不够时继续训练大模型”为什么可能不划算
1. 先把问题讲清楚:预算固定时,模型越大不一定越划算
很多人看到大模型,会本能地认为参数越多越强。这个判断在很多场景下有道理:如果训练数据、算力、工程能力和推理预算都跟得上,更大模型通常有更高能力上限。
但预训练不是免费扩展。模型越大,每处理一个 token 的计算成本越高。如果训练预算固定,参数量变大,往往意味着能训练的 token 数变少。于是会出现一个问题:模型很大,但看过的数据不够,参数还没有被充分训练。
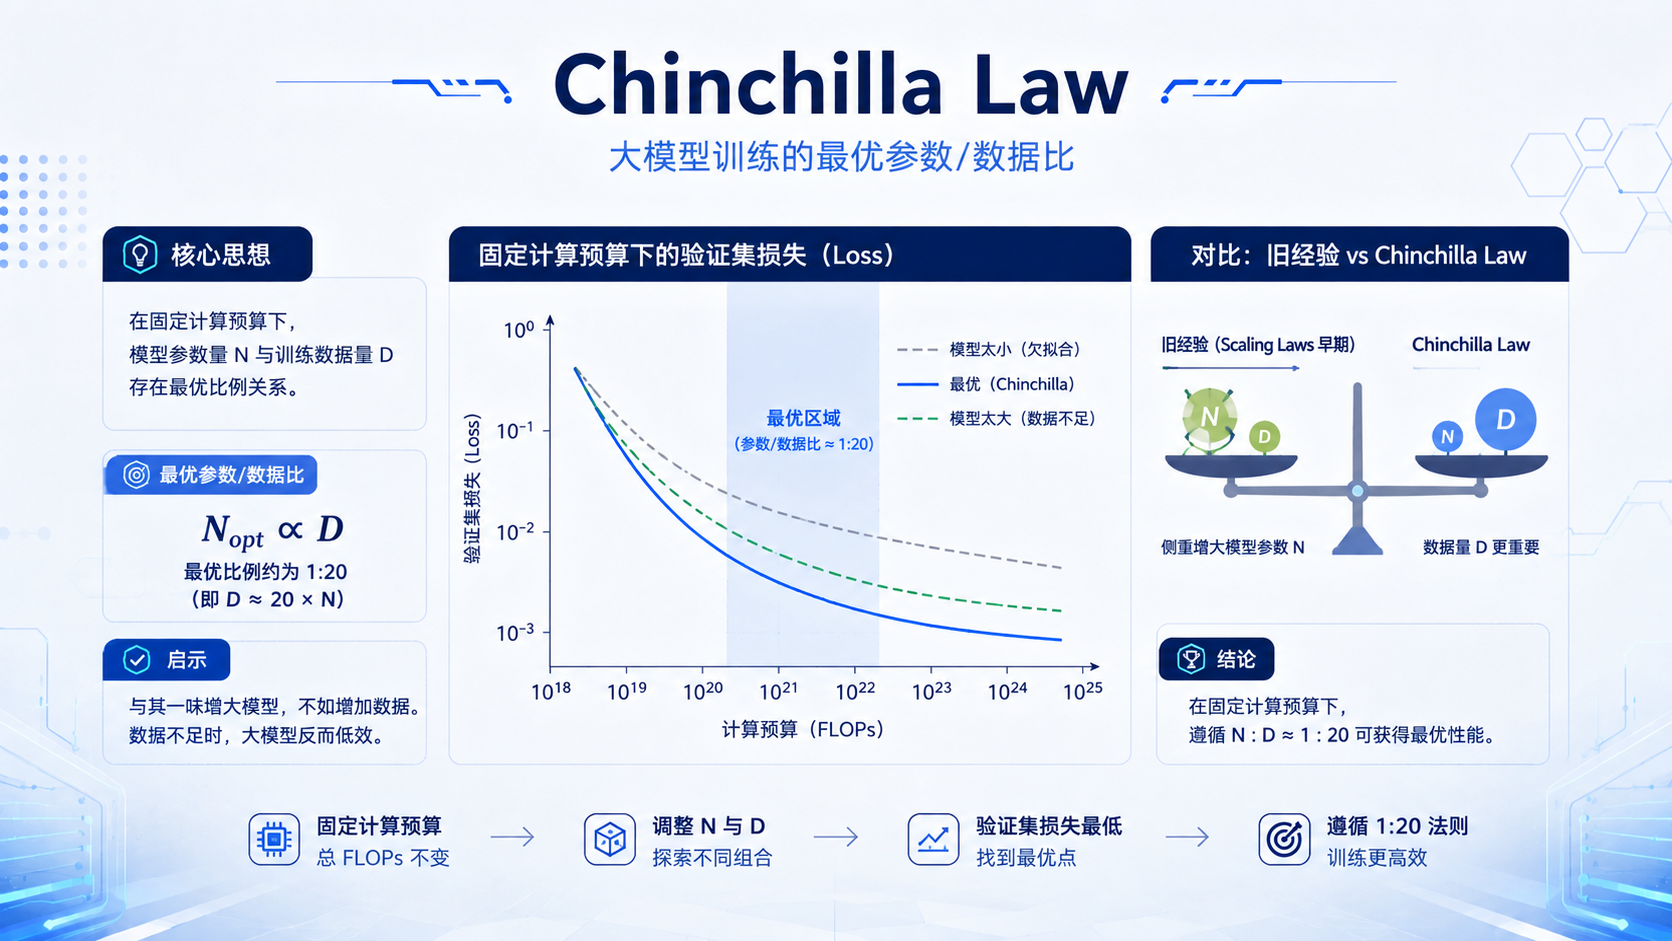
Chinchilla Law 的核心启发可以压缩成一句话:
在固定训练算力下,参数量 N 和训练 token 数 D 要匹配,不要只追求更大的 N。
用生活类比:培养一个学生,不是只给他一个更大的大脑就行,还要给足够多、足够好的练习题。如果大脑很大但题做得少,他可能潜力高但没训练充分;如果题很多但能力容量太小,也可能装不下复杂规律。训练预算就是你能安排的总学习时间。
2. 训练计算量的粗略公式怎么读
Decoder-Only Transformer 预训练的计算量常用一个粗略公式估算:
C
≈
6
N
D
C \\approx 6ND
C≈6ND
先不要把它当成精确报价。它的用途是建立预算直觉。
逐项解释:
-
C
C
C:训练计算量,通常用 FLOPs 表示; -
N
N
N:模型参数量; -
D
D
D:训练 token 数; - 系数 6:对 Transformer 前向和反向计算的粗略近似。
这行公式告诉我们:参数量翻倍,在同样 token 数下计算量大约翻倍;训练 token 数翻倍,在同样参数量下计算量也大约翻倍。
下面用代码看几个方案的相对计算量:
# Python 3.10+
def relative_compute(params_billion, tokens_billion):
return 6 * params_billion * tokens_billion
plans = [
{"name": "small_more_data", "params_b": 7, "tokens_b": 1000},
{"name": "medium", "params_b": 13, "tokens_b": 600},
{"name": "large_less_data", "params_b": 70, "tokens_b": 100},
]
for p in plans:
c = relative_compute(p["params_b"], p["tokens_b"])
print(f"{p['name']:16s} N={p['params_b']}B D={p['tokens_b']}B -> relative C={c:.0f}")
你会发现,不同参数和 token 组合可能消耗相近计算量。问题就变成:哪种组合在目标能力上更划算?这就是 compute-optimal 思考方式。
3. 什么是 compute-optimal
compute-optimal 可以理解为:在固定训练计算量
C
C
C 下,选择合适的参数量
N
N
N 和训练 token 数
D
D
D,让模型 loss 尽量低。
早期一些大模型路线更偏向“参数很大,但训练 token 相对不足”。Chinchilla 相关研究的重要启发是:在相同算力下,适当减小模型、增加训练 token,可能得到更低 loss 和更好泛化。
这不是说小模型永远优于大模型,而是在说:参数量和数据量要一起扩展。 如果只扩参数,不增加足够训练 token,模型会欠训练;如果只堆 token,不增加模型容量,模型可能容量不足。
可以把几种状态这样理解:
| 参数大、token 少 | 模型容量高,但训练不足 | 欠训练,成本浪费 |
| 参数小、token 多 | 训练充分,但容量有限 | 上限不足 |
| 参数和 token 匹配 | 训练预算利用更均衡 | 更接近 compute-optimal |
| token 多但质量差 | 看似训练充分 | 噪声损害能力 |
compute-optimal 是训练 loss 视角下的最优,不自动等于产品最优。后面会展开这个差别。
4. 用预算反推参数和 token
假设你有一个相对训练预算
C
C
C,想比较不同模型大小下还能训练多少 token。由公式:
C
≈
6
N
D
C \\approx 6ND
C≈6ND
可以反推:
D
≈
C
6
N
D \\approx \\frac{C}{6N}
D≈6NC
意思是:预算固定时,参数量
N
N
N 越大,可训练 token 数
D
D
D 越少。
写个小工具:
# Python 3.10+
def tokens_under_budget(compute_budget, params_billion):
# 这里 compute_budget 用相对单位,不是实际 FLOPs
return compute_budget / (6 * params_billion)
budget = 6 * 7 * 1000 # 假设足够训练 7B 模型 1000B tokens
for n in [3, 7, 13, 30, 70]:
d = tokens_under_budget(budget, n)
print(f"N={n:>2}B -> D≈{d:,.0f}B tokens under same budget")
这个实验的意义不是告诉你 7B 一定要训 1000B tokens,而是让你看到预算约束:把模型从 7B 换到 70B,在相同预算下 token 数会大幅下降。如果这些 token 不足以训练好 70B,最终不一定比 7B 方案划算。
5. “最优参数/数据比”不要机械理解
很多人会把 Chinchilla Law 简化成某个固定比例,比如“每个参数对应多少 token”。这种说法有帮助,但容易误导。
原因有几个:
更稳妥的理解是:Chinchilla Law 提供一种预算检查方式。它提醒我们不要只问“模型多少 B”,还要问:
1. 训练了多少高质量 token?
2. 这些 token 是否足以支撑参数规模?
3. 如果用更小模型训练更多 token,会不会更好?
4. 推理成本是否能接受?
5. 数据质量是否值得继续增加 token?
6. 训练最优不等于推理最优
compute-optimal 关注训练预算下的 loss。但产品上线还要考虑推理成本。一个更大的模型即使训练 loss 更好,也可能因为延迟、吞吐和成本无法部署。
训练和推理的目标不同:
| 成本 | 总 FLOPs、训练时间、GPU 集群 | 每次请求成本、吞吐、延迟 |
| 模型大小 | 是否能训练、是否充分训练 | 是否能部署、显存是否够 |
| token 数 | 训练覆盖多少数据 | 上下文长度和输出长度 |
| 最优目标 | 降低预训练 loss | 满足用户任务和 SLA |
因此有时企业会选择较小但训练充分的模型,而不是更大但推理昂贵的模型。尤其是高并发、低延迟、边缘部署、私有化部署场景,小模型加 RAG、工具调用和 SFT 可能更实用。
这也是为什么第 40 篇的小语言模型和专栏三的量化、vLLM 技术重要:训练出强模型只是第一步,把模型稳定便宜地服务出来是另一套问题。
7. 数据质量会改变预算结论
公式里的
D
D
D 是 token 数,但 token 不是等价的。1B 高质量教材、代码和专业问答,与 1B 重复广告、乱码网页的价值完全不同。
如果数据质量低,增加 token 可能只是增加噪声。此时“更多数据”不一定改善模型,甚至会拖累能力。
预算评审里应该把 token 分成几类看:
| 高质量长文 | 通常价值高,但要注意版权和覆盖 |
| 代码数据 | 对代码能力重要,但许可证和重复风险高 |
| 数学推理 | 对推理结构有帮助,但要防污染 |
| 领域文档 | 对垂直领域有用,但易过拟合和过期 |
| 合成数据 | 可补短板,但要防模板化和错误继承 |
| 低质网页 | 可能提供多样性,但噪声高 |
所以更准确的问题不是“有多少 token”,而是“有多少可训练、去重、低污染、高价值 token”。第 42、43 篇讲的数据处理和配比,正是 Chinchilla Law 在工程中能否成立的前提。
8. 对持续预训练的启发
持续预训练(CPT/DAPT)是在已有基础模型上继续训练领域语料。Chinchilla 思想对 CPT 很有提醒意义:领域数据量必须和训练强度匹配。
假设你有一个 7B 基础模型,只有 5000 万 token 的领域文档。如果你用较大学习率、训练很多 epoch,模型很可能过拟合领域文本,并损害通用能力。此时更好的方案可能是 RAG 或 SFT,而不是重度 CPT。
可以用“预期重复轮数”做一个简单检查:
# Python 3.10+
def expected_epochs(train_tokens, dataset_tokens):
return train_tokens / dataset_tokens
cases = [
{"dataset": "small_domain", "dataset_tokens": 50_000_000, "train_tokens": 500_000_000},
{"dataset": "medium_domain", "dataset_tokens": 5_000_000_000, "train_tokens": 10_000_000_000},
]
for c in cases:
e = expected_epochs(c["train_tokens"], c["dataset_tokens"])
print(c["dataset"], f"expected epochs={e:.1f}")
如果领域数据被反复训练很多轮,就要警惕记忆和遗忘。CPT 通常需要:
1. 更小学习率;
2. 通用数据 replay;
3. 多 checkpoint 对比;
4. 领域和通用评估同时看;
5. 必要时改用 RAG/SFT。
第 47 篇会专门展开持续预训练。
9. 对企业模型选型的启发
即使你不从零训练模型,Chinchilla Law 也能帮你做选型判断。
当你比较两个模型时,不要只看参数量。还要看:
1. 模型是否充分训练?是否公开训练 token 量或训练策略?
2. 数据质量和领域覆盖是否符合你的任务?
3. 模型大小带来的推理成本是否可接受?
4. 小模型经过 RAG/SFT 是否已经满足需求?
5. 大模型的额外能力是否能覆盖额外成本?
6. 你的评估集是否真实反映业务任务?
有些场景下,70B 模型零样本能力更强;另一些场景下,7B 或 14B 模型加高质量 RAG、SFT 和工具调用更划算。Chinchilla 思想不是让你总选小模型,而是让你把“参数规模崇拜”转成“预算和目标匹配”。
10. 一个训练预算评审清单
如果团队提出一个预训练或持续预训练计划,可以按下面清单评审:
模型规模:
1. 为什么选择这个参数量?
2. 是否比较过更小模型 + 更多 token 的方案?
3. 推理部署是否能承受这个规模?
数据:
1. 总 token 数是多少?去重后是多少?
2. 高质量 token 占比是多少?
3. 领域数据是否足够,重复轮数是多少?
4. 是否做过污染检测和 PII 处理?
训练:
1. 训练计算预算如何估算?
2. global batch、seq_len、step 数是多少?
3. 学习率和稳定性策略是什么?
4. 是否有小规模 scaling 实验?
评估:
1. 是否只看 validation loss?
2. 是否有分领域评估?
3. 是否评估通用能力回归?
4. 是否有人工样例和线上日志回放?
这份清单比“我们要不要训一个更大的模型”更接近工程决策。
11. 常见误区
误区一:Chinchilla Law 说明小模型一定比大模型好。 不是。它说固定算力下要平衡参数和 token。算力、数据和推理预算增加后,大模型仍可能更强。
误区二:只要 token 数够,质量不重要。 低质量 token 会浪费计算,甚至损害模型。公式里的
D
D
D 不能脱离数据质量理解。
误区三:训练最优等于产品最优。 预训练 loss 更低不代表上线成本、延迟、安全和业务体验更好。
误区四:存在一个永久固定的最优比例。 架构、数据、训练方法和目标任务变化后,最优点也会变。
误区五:持续预训练只要把领域数据多训几轮。 领域数据少时,多训几轮可能导致过拟合和灾难性遗忘。
12. 小结
Chinchilla Law 的价值不是给出一个可以机械套用的神奇比例,而是提供一种预算思维:训练效果来自参数量、训练 token 数、数据质量和计算预算的匹配。在固定算力下,盲目增大参数可能导致训练不足;适当减小模型并增加高质量 token,可能更接近 compute-optimal。但真实工程还要考虑推理成本、部署约束、数据质量、后训练和业务评估。
对开发者来说,理解这篇的关键是:不要只问“模型多大”,还要问“它看过多少高质量 token,是否训练充分,是否适合我的成本和任务”。
大模型视角
从大模型技术主线看,Chinchilla Law 改变了行业对“大”的理解:模型能力来自参数和数据的匹配,而不是参数的单纯堆叠。后来出现的“训练更充分的小模型”路线,包括第 40 篇讲的 SLM,都能追溯到这种预算思维。
下一篇
下一篇会讲持续预训练。它把 Chinchilla 的预算思想带到垂直领域:当我们拿已有基础模型继续训练行业数据时,怎么判断数据够不够、学习率该多保守、怎样避免通用能力被训练坏。