简介:围绕天气数据采集到存储的完整链路,资源包内整理了一个可运行示例项目,适合正在学习大数据实时处理、希望打通数据采集与入库流程的初中级开发者。内容覆盖天气爬虫编写、Kafka消息队列分发、Flume消费并导入HBase,之后还通过Hive建立外部映射并用Superset做可视化分析,相当于一套小型大数据平台实践参考。
包体共17个文件,核心是11个Java源码文件,对应爬虫、Kafka生产者/消费者、Flume配置等主体逻辑;另含1个XML配置、1个Markdown说明文档和3张流程图/效果图,可辅助理解整体架构与运行结果;压缩包整体约985KB,体积小、便于下载后直接阅读。当前已有152人学习,适合作为课堂项目或毕业设计的起步模板。
读者可借此明确从数据源到存储、分析展示的实现路径,获得Kafka与Flume组合使用的关键配置思路,以及Hive与HBase映射操作和Superset对接的实际写法;相比零散教程,包内文件把主干代码、配置和说明集中在一起,能显著节省环境搭建和代码调试时间。
1. 天氣爬蟲採集,Kafka 實時分發,Flume 收集數據導入 HBase:這條鏈路能落地嗎
很多人第一眼看到「天氣爬蟲採集,kafka實時分發,flume 收集數據導入到 Hbase」這個資源包,以為重點是爬蟲代碼。其實真正難的,是讓一條從 HTTP 請求發出的天氣數據,穩定地流進 Kafka、寫入 HBase、再被 Hive 查出來、最後在 Superset 上畫成圖。這份 weather-mrs-master 項目恰好把整條鏈路串起來了:爬蟲抓數據,Kafka 做實時中轉,Flume 消費 Kafka 並寫入 HBase,Hive 與 HBase 建映射,Superset 做分析展示。你想在本地復現一個大數據實時處理項目,拿它當骨架是比較順手的選擇。適合正在學 Kafka、Flume、HBase 的開發者,也適合給簡歷補一個完整項目經驗的從業者。
2. 爬蟲採集模塊拆解:從 HTTP 請求到 Kafka 生產者,先解決數據從哪來
2.1 先看項目的 Maven 骨架:採集、配置、啟動三塊怎麼分工
打開資源包,根部是 pom.xml 、 README.md 、 src/main 。這說明整個項目用 Maven 管理,主體代碼在 Java 裡,不是 Python 腳本拼出來的。我一般會先看 pom.xml 裡依賴了哪些庫,能快速判斷作者意圖:有 httpclient 或 okhttp,說明採集用 HTTP 客戶端;有 jackson-databind,說明 JSON 解析走 Jackson;有 kafka-clients,說明生產者和消費者都走原聲 Kafka API。 src/main/java 下通常會拆成 collector 、 producer 、 config 、 util 幾個包, resources 裡放接口配置、topic 名稱這些可變參數。這個拆法比較樸素,但對於一個工程項目來說夠用。
天氣數據的來源,常見的是各地天氣服務商提供的 JSON 接口,比如按城市名查詢實時天氣,返回溫度、濕度、風向、天氣現象。有的免費接口每天有調用次數限制,有的需要申請 key。項目代碼一般把接口地址和 key 放在配置裡,不建議寫死在類裡,否則換數據源時要改代碼重新編譯。我在復現時會先在 README 裡確認作者默認用的哪個接口,再看 resources 下的配置文件。如果原項目沒有給具體接口,自己換一個能訪問的天氣 API 就行,爬蟲模塊的核心邏輯不受影響。
選數據源有一個原則:優先選返回結構簡單、字段穩定的 JSON 接口,不要選那種返回 HTML 還需要正則清洗的頁面。原因是後面鏈路很長,只要採集端多一個解析依賴,整個數據管道就多一個脆弱點。天氣接口的字段不多,溫度、濕度、天氣描述、更新時間,足以構成 HBase 一張表的列。如果要採集多個城市,還需要一個城市列表配置,代碼裡循環調用接口即可。項目的入口類一般就是一個帶 main 方法的啟動類,定時或手動觸發全量採集。
2.2 爬蟲抓取代碼:HttpClient 拉數據,Jackson 解析 JSON
採集模塊的核心是一個 HTTP 客戶端加一個 JSON 解析。用 HttpClient 發 GET 請求,拿到字符串後用 Jackson 轉成 JsonNode ,再逐字段取值。下面是一段我在類似項目裡常用的寫法,讀者可以直接對照資源裡的 WeatherFetcher 類看。
package com.weather.collector;
import org.apache.http.client.methods.HttpGet;
import org.apache.http.impl.client.CloseableHttpClient;
import org.apache.http.impl.client.HttpClients;
import org.apache.http.util.EntityUtils;
import org.jetbrains.annotations.NotNull;
import java.nio.charset.StandardCharsets;
import java.util.concurrent.TimeUnit;
public class WeatherFetcher {
private final CloseableHttpClient httpClient;
public WeatherFetcher() {
this.httpClient = HttpClients.custom()
.setConnectionTimeToLive(30, TimeUnit.SECONDS)
.setMaxConnPerRoute(20)
.build();
}
public String fetch(@NotNull String apiUrl) throws Exception {
HttpGet request = new HttpGet(apiUrl);
request.setHeader("User-Agent", "Mozilla/5.0 (weather-collector)");
request.setHeader("Accept", "application/json");
// 接口通常需要 1~3 秒響應,超時設太短會被對方誤判為攻擊
request.setConfig(RequestConfig.custom()
.setConnectTimeout(5000)
.setSocketTimeout(5000)
.build());
try (CloseableHttpResponse response = httpClient.execute(request)) {
int code = response.getStatusLine().getStatusCode();
if (code != 200) {
throw new RuntimeException("HTTP request failed, code=" + code);
}
return EntityUtils.toString(response.getEntity(), StandardCharsets.UTF_8);
}
}
}
這段代碼裡有兩個容易忽略的點:一個是 CloseableHttpClient 要複用,不要在每個請求裡 new 一個實例,否則連接池等於沒用,高頻採集時會出現大量 TIME_WAIT 連接,最終把本地端口耗盡。另一個是超時設置,天氣接口在早晚高峰時會抖動,5 秒超時比較合適。如果設置成 1 秒,稍微一慢就報異常,整個循環直接中斷;如果設置成 30 秒,一個接口掛了會把後續城市全部阻塞。這個「超時設多少」本身就是個坑,後面避坑章節會再提。
拿到 JSON 字符串後,用 Jackson 解析時要養成用 path() 而不是 get() 的習慣。 get() 遇到字段不存在會拋異常, path() 則返回一個空節點,這樣某個字段偶爾缺失不至於讓整個採集程序崩掉。
import com.fasterxml.jackson.databind.JsonNode;
import com.fasterxml.jackson.databind.ObjectMapper;
import java.util.HashMap;
import java.util.Map;
public class WeatherParser {
private final ObjectMapper mapper = new ObjectMapper();
public Map<String, String> parse(String json, String city) throws Exception {
JsonNode root = mapper.readTree(json);
Map<String, String> record = new HashMap<>();
record.put("city", city);
// path 取值,缺失時返回 null,不會拋異常
record.put("temperature", root.path("now").path("temp").asText(""));
record.put("humidity", root.path("now").path("humidity").asText(""));
record.put("weather", root.path("now").path("text").asText(""));
record.put("wind", root.path("now").path("windDir").asText(""));
record.put("updateTime", root.path("updateTime").asText(""));
return record;
}
}
ObjectMapper 也要複用,它是線程安全的,每次 new 會增加無謂的開銷。 parse 方法把 JSON 轉成 Map<String, String> ,這樣後面無論是發 Kafka 還是寫 HBase,字段結構都統一了。這裡沒有把數據直接寫到文件或庫裡,因為這套項目的設計思路是「採集只負責產出數據」,後續交給 Kafka 和 Flume。這樣做的好處是採集模塊變得很純粹,換接口、加城市都不會影響下游鏈路。
2.3 發送 Kafka 的生產者參數:acks、batch.size、linger.ms 背後的取捨
採集到數據後,下一步是發給 Kafka。天氣數據量不算誇張,一個城市幾百字節,但如果你採 300 個城市、每分鐘一輪,壓力還是有的。生產者的參數能不能調好,直接決定 Kafka 會不會成為鏈路瓶頸。下面是一份生產者配置,參考的是 KafkaProducer 的標準寫法。
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.serialization.StringSerializer;
import java.util.Properties;
public class WeatherProducer {
private final KafkaProducer<String, String> producer;
public WeatherProducer(String bootstrapServers) {
Properties props = new Properties();
props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServers);
props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
// 可靠性參數:acks=1 表示 leader 寫成功就返回,想要更高的可靠性用 all
props.put(ProducerConfig.ACKS_CONFIG, "1");
props.put(ProducerConfig.RETRIES_CONFIG, 3);
// 吞吐參數:積累 16KB 或等待 5ms 再批量發送
props.put(ProducerConfig.BATCH_SIZE_CONFIG, 16384);
props.put(ProducerConfig.LINGER_MS_CONFIG, 5);
props.put(ProducerConfig.BUFFER_MEMORY_CONFIG, 33554432L);
producer = new KafkaProducer<>(props);
}
public void send(String topic, String city, String json) {
producer.send(new ProducerRecord<>(topic, city, json), (metadata, e) -> {
if (e != null) {
// 異步回調裡必須留日誌,不然發送失敗完全無感知
System.err.println("send failed, topic=" + topic + ", city=" + city, e);
}
});
}
}
參數要理解著調,不要照抄。 acks=1 是性能和可靠性的折中,Kafka 的 leader 把消息寫進日誌就返回給生產者,不需要等所有副本。如果數據不能丟,改成 all ,但延遲會增加。 retries 設 3 是防止網絡抖動,但重試可能導致消息亂序,所以最好配合 enable.idempotence=true 使用,這裡沒開,因為天氣數據對順序要求不高。 batch.size 和 linger.ms 是成對出現的,前者表示批次大小,後者表示等待時間,目的都是攢一批再發。對於這種小字段 JSON,5ms 延遲完全可接受。
這裡要提一個常見誤區:很多人把發送動作寫成同步阻塞, producer.send(…).get() ,這樣每請求一次就等一次網絡往返,採集 300 個城市會明顯變慢。正確做法是用異步回調,讓生產者內部自己批量發送。上面的 send 方法就是異步的,回調裡只打日誌。對天氣採集這種實時性要求不極端的場景,異步加 5ms 積累,吞吐完全夠用。項目裡如果把生產者封裝成單例,記得在程序退出時調用 producer.close() ,否則緩衝區裡的數據可能沒發完就被強制結束,這也算一個低級但常見的翻車點。
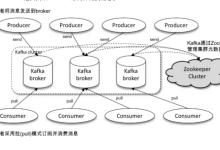
3. Kafka 實時分發鏈路:主題、分區與消費者 offset 的設計
3.1 Kafka 集群與主題創建:分區數和副本數怎麼定
數據從生產者出來,第一站是 Kafka topic。資源包裡一般不會帶集群環境,需要自己有一套 Kafka 可用。這一步我建議先在單機或三節點虛擬機上把 Kafka 起起來,然後用命令行工具創建主題。下面是最基礎的命令。
kafka-topics.sh –create \\
–bootstrap-server node01:9092,node02:9092,node03:9092 \\
–topic weather-topic \\
–partitions 6 \\
–replication-factor 1 \\
–config retention.ms=86400000
分區數設 6,是考慮到後面 Flume 可能開多個 agent 併發消費。如果只開一個 Flume agent,分區設 3 或 6 差別不大;如果打算橫向擴展多個 Consumer,分區數就是並發上限。副本數在生產環境至少 2 或 3,本地單機只能設 1,設大了會報 Replication factor: 2 larger than available brokers: 1 ,這是新手最容易撞到的報錯。 retention.ms=86400000 表示保留一天,天氣數據的時效性很強,沒必要留七天,保留時間太長反而佔磁盤。
創建完主題後,可以用 kafka-topics.sh –describe 檢查分區和副本狀態。確認 Isr 沒有異常,Leader 沒有傾斜,再繼續往下走。很多時候後面的 Flume 消費不到數據,不是 Flume 配錯,而是 topic 本身沒建好,或者生產者發到了另一個集群。先用命令把叢集狀況摸清,能省掉大量排查時間。
3.2 生產者與消費者的配置對照:別讓數據卡在上游
Kafka 的吞吐瓶頸往往不在 broker,而在生產者和消費者的配置不對。生產者要看 batch.size 、 linger.ms 、 buffer.memory ,消費者要看 fetch.min.bytes 、 max.poll.records 、 session.timeout.ms 。我把這個項目裡最值得調整的幾個參數列成對照,方便配置時參考。
| 生產者 | acks | 1 或 all | 控制消息確認級別,天氣數據可容忍少量重試 |
| 生產者 | linger.ms | 5 | 等待 5ms 攢批,減少請求次數 |
| 生產者 | batch.size | 16384 | 批次大小,字節為單位 |
| 生產者 | buffer.memory | 33554432 | 生產者緩衝區總大小,爆了會阻塞 send |
| 消費者 | fetch.min.bytes | 1 | 消費者拉取的最小數據量,調大可減少請求 |
| 消費者 | max.poll.records | 500 | 單次 poll 最大記錄數,調太大容易觸發 rebalance |
| 消費者 | session.timeout.ms | 10000 | 消費者失聯判定時間,太短容易誤判 |
| 消費者 | enable.auto.commit | false | 關閉自動提交,手動確認處理完再提交 offset |
這個表裡最關鍵的是 enable.auto.commit 。很多項目默認開自動提交,處理邏輯還沒跑完就提交了 offset,進程一掛就丟數據。Flume 消費 Kafka 時也有對應配置,後面會講。生產者的 buffer.memory 容易被忽略,如果發送速度遠大於 Kafka 處理速度,緩衝區撐滿後 send 會阻塞,表現就是採集線程卡住不動。解決方法不是無限調大 buffer,而是找上游生產速率或下游消費瓶頸。
3.3 group.id 和 offset 策略:重啟不丟數的基本功
Kafka 消費者必須有 group.id,同一個 group 裡的消費者在邏輯上共享分區。Flume 作為 Kafka Source 消費時,如果不指定 group.id,默認會生成一個隨機 group,重啟後 resume 從最新的位置開始讀,導致漏數據。所以要養成固定 group.id 的習慣,比如 flume-weather-group 。
檢查消費位置有兩個常用命令。一個看 consumer group 當前的 lag,一個手動模擬消費驗證數據格式。
kafka-consumer-groups.sh –bootstrap-server node01:9092 \\
–group flume-weather-group –describe
kafka-console-consumer.sh –bootstrap-server node01:9092 \\
–topic weather-topic –from-beginning –max-messages 5
–describe 會輸出每個分區的 current-offset 、 log-end-offset 、 lag 三列。如果 lag 一直漲,說明消費者處理不過來;如果 lag 為 0,說明消費速度跟得上生產速度。這個命令是鏈路調試的必備工具。 kafka-console-consumer 驗證數據格式時,記得加 –max-messages ,不然在生產環境會一直刷屏。如果這裡能看到爬蟲採集到的 JSON,説明 Kafka 這一段沒問題,問題大概率出在 Flume 消費端。
offset 策略裡還有一個參數 auto.offset.reset 。新 group 第一次消費一個沒有 offset 的 topic 時, earliest 表示從頭開始, latest 表示從最新開始。對天氣數據項目,我建議用 earliest ,這樣 Flume 重啟或建新 group 時能把積壓數據補上。如果業務允許丟數據,再考慮 latest 。這個選擇本身要寫清楚,不然重啟一次就會發現丟了一堆「看起來無所謂」的數據。
4. Flume 收集數據導入 HBase:從 Kafka Source 到 HBase Sink 的完整配置
4.1 為什麼選 Flume 做管道:它和 Kafka Connect 的差別
鏈路裡選 Flume 是有道理的。Flume 本來就是為日誌而生,它的 agent 可以靈活定義 source、channel、sink,尤其適合「消費 Kafka 再寫 HBase」這種場景。你可能會問,直接用 Kafka Connect 的 HBase Sink 不就行了?Kafka Connect 也是一條路,但項目裡既然用 Flume,說明作者要的是輕量、可控、易改。Flume 配置是文本文件,改完重啟 agent 就生效,不需要寫 Java 代碼;而且 Flume 對後面接 HBase 的 serializer 擴展更直接,寫自定義類也方便。
Flume 的三段式結構要理解:source 從哪拿數據,channel 暫存數據,sink 把數據送出去。這個項目裡 source 是 KafkaSource,channel 可以選 memory 或 file,sink 是 HBaseSink。用 memory channel 吞吐高,但 agent 進程掛了 channel 裡的數據會丟;用 file channel 會持久化,但性能稍差。天氣數據重啟丟幾條影響不大,不過為了穩定,我一般用 file channel。下面配置會把兩者都寫出來,你自己取捨。
4.2 flume.conf 實操配置:Kafka Source + File Channel + HBaseSink
Flume agent 的配置最怕就是屬性名拼錯。KafkaSource 的參數前綴和普通 Kafka 消費者略有不同,很多人在 kafka.bootstrap.servers 和 bootstrap.servers 之間反覆試錯。下面是一份可以直接套用的配置,把關鍵參數標出來了。
agent.sources = kafka-source
agent.channels = file-channel
agent.sinks = hbase-sink
# Kafka Source:消費 weather-topic
agent.sources.kafka-source.type = org.apache.flume.source.kafka.KafkaSource
agent.sources.kafka-source.kafka.bootstrap.servers = node01:9092,node02:9092
agent.sources.kafka-source.kafka.topics = weather-topic
agent.sources.kafka-source.kafka.consumer.group.id = flume-weather-group
agent.sources.kafka-source.kafka.consumer.auto.offset.reset = earliest
agent.sources.kafka-source.batchSize = 100
agent.sources.kafka-source.batchDurationMillis = 2000
# File Channel:防止 agent 重啟丟數據
agent.channels.file-channel.type = file
agent.channels.file-channel.checkpointDir = /data/flume/checkpoint
agent.channels.file-channel.dataDirs = /data/flume/data
agent.channels.file-channel.capacity = 100000
agent.channels.file-channel.transactionCapacity = 1000
# HBase Sink:寫入 weather 表
agent.sinks.hbase-sink.type = org.apache.flume.sink.hbase.HBaseSink
agent.sinks.hbase-sink.table = weather
agent.sinks.hbase-sink.columnFamily = cf
agent.sinks.hbase-sink.serializer = org.apache.flume.sink.hbase.RegexHbaseEventSerializer
agent.sinks.hbase-sink.serializer.regex = (.*)
agent.sinks.hbase-sink.batchSize = 200
# 串起來
agent.sources.kafka-source.channels = file-channel
agent.sinks.hbase-sink.channel = file-channel
這份配置裡有幾個值得注意的地方。KafkaSource 的 kafka.consumer.group.id 決定了消費位置,一定要和前面第 3 章說的保持一致,不要讓 Flume 每次重啟都換 group。 batchSize 是 Flume 從 Kafka 一次拉多少條, batchDurationMillis 是等待多長時間,兩個配合起來控制消費節奏。如果設太大,KafkaSource 一次 poll 會阻塞比較久,HBase 端如果寫得慢,數據會堆在 channel 裡。file channel 的 capacity 是能緩存多少事件,我設 100000,因為 Kafka 裡如果突然湧入大量積壓數據,channel 太小會把 agent 直接卡死。HBase sink 的 serializer 控制每條事件怎麼變成 HBase 的 put, RegexHbaseEventSerializer 是按正則解析 event,如果你在生產者端發的是普通 JSON 字符串,最好在項目裡自定義一個 serializer,把 JSON 字段拆成 HBase 的列。資源包的 src/main/java 裡寫的 serializer 類就是幹這個用的。
配置寫完後,啟動命令是 flume-ng agent -n agent -c conf -f flume.conf 。這裡的 -n agent 必須和配置文件裡 agent.sources 的前綴一致,否則 Flume 會報「component not defined」。這是一個非常容易踩的初級坑。啟動後重點看日誌裡有沒有出現 KafkaSource 成功訂閱、 HBaseSink 成功創建 table 這類信息,沒有的話就要用下一節的 HBase 命令驗證數據到底寫沒寫進去。
4.3 HBase 表設計與預分區:RowKey 決定寫入速度
HBase 表設計決定了這條鏈路能不能穩定寫入。天氣表不需要複雜的列族,一個 cf 就夠。但 RowKey 一定要設計,否則所有數據都往一個 region 寫,會出現熱點,寫入延遲就會飆升。常見做法是用「城市 + 時間戳」或「城市反轉 + 時間戳」。如果用 city + timestamp 做 rowkey,同一城市的數據連續寫到一個 region,查詢方便,但寫入往單點壓。用 加鹽 或 哈希前綴 可以把寫入分散到多個 region。下面是一個帶預分區的建表語句。
hbase shell <<EOF
create 'weather',
{NAME => 'cf', VERSIONS => 1, TTL => 86400},
{SPLITS => ['a', 'g', 'm', 's']}
EOF
SPLITS 按 rowkey 首字母分了 5 個區間,寫入時只要 rowkey 首字母分佈均勻,請求就會分散到不同 region。如果數據量不大,可以不預分區,但一旦 Flume 批量寫入,單 region 的壓力會立刻暴露。TTL 設 86400 秒,也就是一天,天氣歷史數據如果沒有分析價值,沒必要長期留著。 VERSIONS => 1 表示每個 cell 只保留一個版本,避免 HBase 默認存多版本浪費空間。
建完表後,可以用 count 'weather' 或 scan 'weather', {LIMIT => 10} 驗證數據。 scan 能看到 rowkey 和列值,如果 scan 出來是空的但 Kafka 裡有數據,說明 Flume 的 serializer 沒匹配上,或者 HBase 表名、列族寫錯了。這類問題的排查方法,下一章會單獨展開。總之,Flume 到 HBase 這一段能不能通,最終看 scan 結果,不要只看 Flume 進程還在跑就以為成功。
5. 排查與避坑:Hive 映射 HBase 與 Superset 展示的常見問題
5.1 Hive 建 HBase 映射表的正確姿勢
數據落到 HBase 之後,直接查 HBase Shell 不方便做聚合分析,所以要用 Hive 把 HBase 表映射成一張外部表。Hive 的 HBaseStorageHandler 能讓 Hive 查 HBase 裡的數據,但映射關係必須完全對準。下面是一條實際可執行的建表語句。
CREATE EXTERNAL TABLE weather_hbase (
city STRING,
temperature DOUBLE,
humidity INT,
weather STRING,
wind STRING
)
STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler'
WITH SERDEPROPERTIES (
"hbase.columns.mapping" = ":key, cf:temperature, cf:humidity, cf:weather, cf:wind"
)
TBLPROPERTIES (
"hbase.table.name" = "weather"
);
hbase.columns.mapping 必須從 :key 開始,表示 HBase 的 rowkey 對應 Hive 的第一個字段 city 。後面每一列都要寫完整格式 列族:列名 ,順序要和 Hive 字段順序一致。這是我見過最容易翻車的地方:HBase 表的列名是 cf:temperature ,Hive 映射裡寫成 cf:temp ,查詢結果就是一片 null。另外,Hive 的 temperature 字段最好和 HBase 裡存的字符串能互轉,如果生產者發的是 Map<String, String> , temperature 是字符串 "23.5",Hive 映射 DOUBLE 時會做轉換,但遇到空字符串就會轉失敗,返回 null。建議在爬蟲端就把空值統一處理掉,不要讓髒數據流到 HBase。
建表成功後,執行一個最簡單的查詢驗證映射是不是通的,比如 SELECT city, temperature FROM weather_hbase LIMIT 5 。如果結果有值,再往下做 Superset 接入;如果查出來全 null,先回 HBase Shell 用 scan 確認數據真實存在,再用 DESCRIBE weather_hbase 檢查字段順序。很多問題其實不是 Hive 語法錯,而是 HBase 裡的列名和映射對不上。
5.2 Superset 接入 Hive 數據源:驅動和授權是兩個坑
Superset 分析展示是最後一環,也是人們最期待的環節,但接入 Hive 數據源有兩個常見攔路虎:驅動沒裝好,用戶認證失敗。Superset 通過 PyHive 連接 HiveServer2,SQLAlchemy 連接串一般寫成 hive://superset_user:password@hive-server:10000/default 。如果 Superset 所在機器沒有安裝 PyHive 依賴,點「Test Connection」會直接報 No module named pyhive 。這不是 Superset 配置問題,而是 Python 環境缺包,需要在啟動 Superset 的虛擬環境裡手動裝 pyhive[sasl] 和 thrift 。我在部署時就在這個坑上卡了半天,一度懷疑是 Hive 端口沒開。
認證方面,Hive 如果開了 LDAP 或 Kerberos,Superset 連接串就得帶上對應認證方式。簡單環境下,直接寫 hive://user@host:10000/default?auth=NOSASL 比較省事。這裡要提醒,不要把 Hive 用戶密碼寫在 Dashboard 的公開配置裡,至少用環境變量引用。Superset 接入後,數據集列表裡能看到 weather_hbase 這張表,说明 Hive 層面已經通。後續做圖表時,如果某個維度顯示不出來,先回到 SQL Lab 跑一句 SELECT * 看原始數據長什麼樣,再判斷是 Superset 的問題還是數據本身的問題。
5.3 五個高頻踩坑:現象、原因、解決
這條鏈路從爬蟲到展示,至少有五個坑是反覆出現的。每一條我都按「現象 → 原因 → 解決」拆開寫,復現的時候直接對號入座。
坑一:Flume 寫 HBase 很慢,agent 日誌出現大量重試
現象是 Flume 日誌裡有 Blocking waiting for space in channel 或 HBase 寫入超時,數據一直往 Kafka 消費,但 HBase 表行數不漲。原因通常是 HBase 表沒有預分區,所有寫請求打到同一個 region,同時 Flume sink 的 batchSize 設置太大,單次提交的 put 太多觸發服務端限流。解決方法:按 rowkey 做預分區,把 batchSize 調到 100~200,並檢查 HBase 的 region server 日誌裡是否有 GC 停頓。如果還慢,看是不是 rowkey 前綴太集中,加鹽後重新寫。
坑二:Hive 映射表查出來全是 null
現象是 SELECT * FROM weather_hbase 返回很多行,但每一列都是 NULL。原因很直接: hbase.columns.mapping 裡的列名、順序和 HBase 表實際列不一致。解決方法:先用 scan 'weather', {LIMIT => 1} 看真實列名,再和建表語句逐字段比對。特別注意 HBase 裡的列名是 cf:temperature 不是 temperature ,Hive 映射裡漏掉 cf: 前綴也會靜默失敗。
坑三:Superset 看板日期維度亂碼或查不到
現象是時間字段顯示成「2025-01-01T00:00:00.000Z」,按小時篩選不對。原因是爬蟲端把時間存成了 ISO 字符串,Superset 默認按 UTC 解析,而 Hive 裡沒有明確轉時區。解決方法:在 Hive 表裡把時間字段轉成 TIMESTAMP ,或者 Superset 的數據集字段設置裡把格式化選成對應時區。這不是 bug,是時間類型沒統一,最好在爬蟲端就存成 yyyy-MM-dd HH:mm:ss 。
坑四:Kafka 重啟後 Flume 重複消費大量數據
現象是 Kafka 重啟後,HBase 裡出現一批重複 rowkey。原因通常是 Flume 的 kafka.consumer.group.id 沒固定,重啟後新 group 從 earliest 開始重新消費。解決方法:固定 group.id,建議設置 agent.sources.kafka-source.kafka.session.timeout.ms 大一點,讓 Flume 在 Kafka 重啟期間不被踢出 group。如果想要丟數據而不是重複數據,可以把 auto.offset.reset 改成 latest ,但這要看業務接受哪種不一致。
坑五:爬蟲接口偶爾返回 403 或空數據
現象是 Kafka 裡某一時段數據明顯變少,HBase 的 count 也對應下降。原因是被採集端對高頻請求觸發了風控,或者接口超時後拋異常導致整個城市循環中斷。解決方法:在爬蟲端加 User-Agent 輪換、請求間隔控制,同時把單個城市的抓取異常 catch 住,不能讓一個城市失敗影響後面城市。超時時間也要分開設置,SocketTimeout 和 ConnectTimeout 都設成 5 秒左右最穩。這個坑看起來不起眼,但會直接造成鏈路「看似正常,數據缺一段」的假象。
6. 全鏈路驗證:用一分鐘冒煙測試檢查採集到展示是否真通
6.1 冒煙測試腳本
每次改完配置,我都會強制自己走一遍冒煙測試,而不是直接看 Superset 圖表。先確認 Kafka topic 裡有數據,再確認 HBase 能查到數據,最後在 Superset SQL Lab 執行查詢。三步都過,才說明鏈路通了。
# 第一步:從 Kafka 消費最近 3 條數據
kafka-console-consumer.sh –bootstrap-server node01:9092 \\
–topic weather-topic –max-messages 3
# 第二步:查 HBase 最新寫入的行
hbase shell -e "scan 'weather', {LIMIT => 3, REVERSED => true}"
# 第三步:Hive 裡驗證映射表
hive -e "SELECT city, temperature, humidity FROM weather_hbase LIMIT 3;"
6.2 看板製作技巧與日常檢查
Superset 裡新建圖表時,我習慣先用「表」這種最樸素的圖形驗證數據,確認行數、字段、時間範圍都對,再做柱狀圖或折線圖。天氣數據最適合做的圖是「各城市實時溫度柱狀圖」和「單個城市 24 小時溫度趨勢線」。SQL Lab 裡可以直接寫 SELECT city, MAX(temperature) FROM weather_hbase GROUP BY city 這類語句,Superset 支持結果可視化,調試效率很高。日常檢查則直接看 Kafka consumer group 的 lag,如果 lag 長時間居高不下,多半是 Flume 或 HBase 寫入出問題,而不是爬蟲停了。
6.3 一套可複用的檢查習慣
這套項目我前後跑過好幾遍,最深刻的教訓是:不要在 Flume 日誌還沒看明白的時候就去調 Superset。有一次我以為 Hive 映射表建錯了,反覆改 STORED BY ,最後發現是 Flume 的 serializer 把 JSON 當成了整個字符串存到一列裡,Hive 映射的字段根本對不上。從那以後,我每次接到類似鏈路,都會先按「Kafka 有數 → HBase 有數 → Hive 有數 → Superset 有數」的順序強制走一遍冒煙測試,哪一步斷了就在哪一步查日誌,不跨層猜。希望幫到你。
本文还有配套的精品资源,点击获取