Python后端中间件专题26:只看平均响应时间会误判——Prometheus RED 与低基数
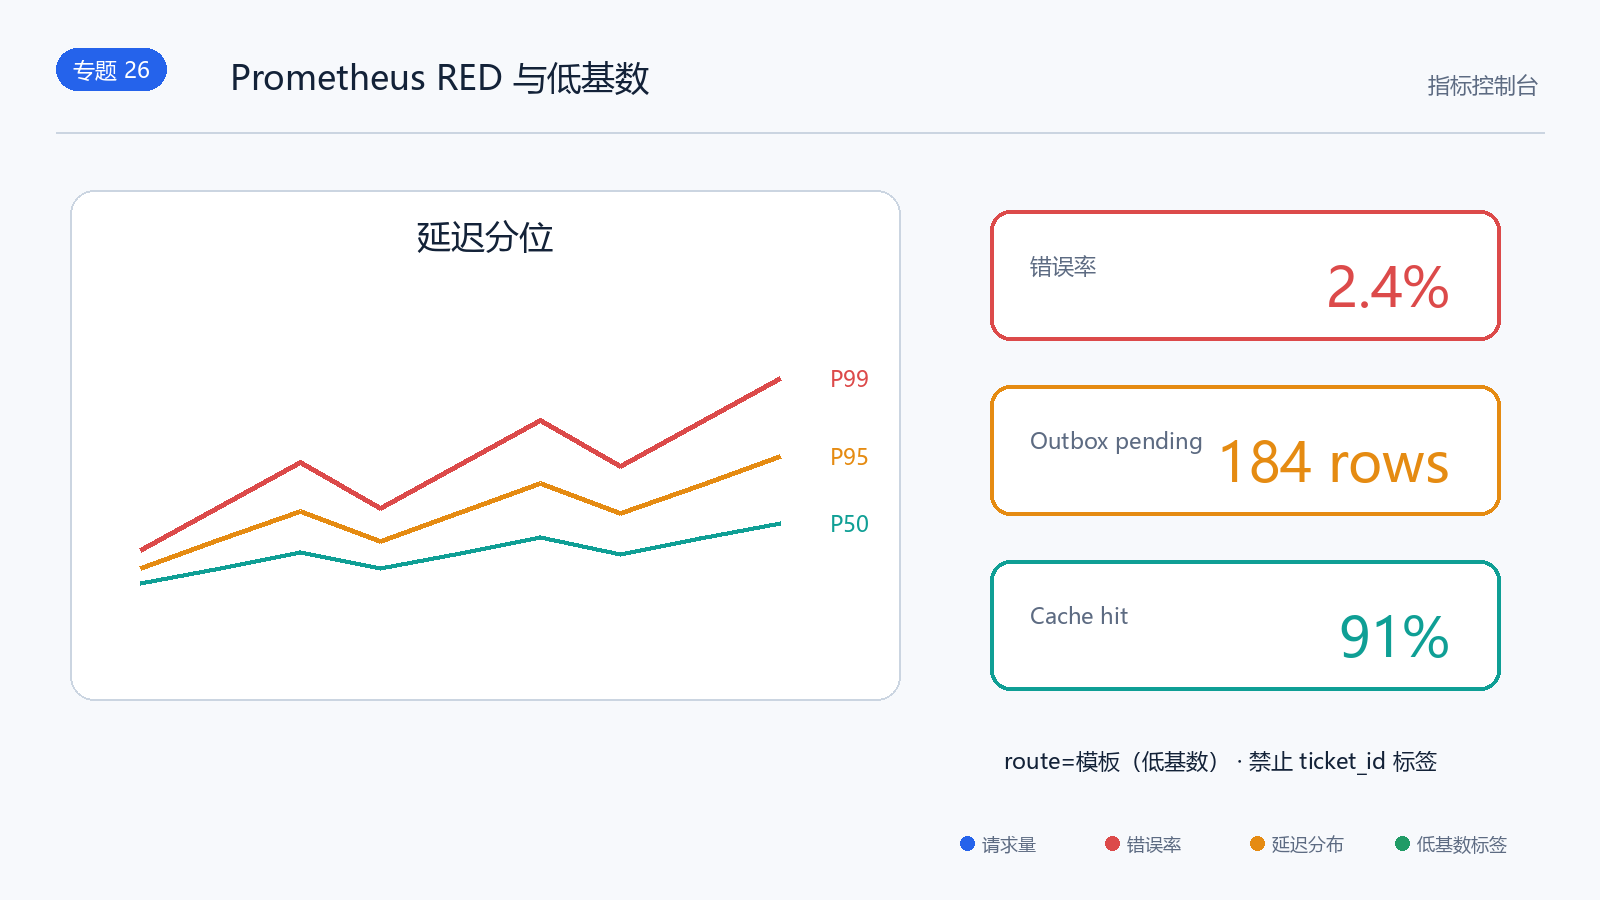
100 个请求里,99 个耗时 20 ms,一个耗时 10 s,平均约 120 ms;报一个平均数,既看不出尾部用户的十秒等待,也不知道有多少请求失败。TicketFlow 在请求完成时累计请求数、状态类别和直方图;再给 Outbox 与 Worker 加能反映异步滞后的指标。
要掌握的量与前置
本课要从 Counter/Histogram 计算 R(请求速率)、E(错误比例)、D(延迟分布),用 route 模板而非工单 ID 控制序列数量,解释 Outbox Gauge 与 broker 队列长度并非同一量。前置是 23 的单入口、25 的业务 ID 日志和 Prometheus rate() 的窗口概念。安装项目开发依赖即可运行本地 selector;真正 scrape API A/B、relay、Worker 属于远端验收。
上一课练习答案
答案 EX-25-01 [code]
在 project/ 保存为 ex25_log_probe.py:
import json
from ticketflow.observability.logging import JsonEventLogger
lines = []
logger = JsonEventLogger(lines.append)
private_fields = {
"broker_password": "rabbit-private",
"context": {"authorization": "Bearer bearer-private"},
}
logger.event(
"outbox_publish_failed",
request_id="req-25",
ticket_id="ticket-25",
**private_fields,
)
assert len(lines) == 1
event = json.loads(lines[0])
assert event["request_id"] == "req-25"
assert event["ticket_id"] == "ticket-25"
assert event["broker_password"] == "[REDACTED]"
assert event["context"]["authorization"] == "[REDACTED]"
assert "rabbit-private" not in lines[0] and "bearer-private" not in lines[0]
print(event["event"], event["ticket_id"], event["broker_password"])
运行命令:PYTHONPATH=src python ex25_log_probe.py(PowerShell:$env:PYTHONPATH="src"; python ex25_log_probe.py)。
预期输出:
outbox_publish_failed ticket-25 [REDACTED]
这是内存 sink 的脱敏合同,不是三个生产进程的日志样本。
答案 EX-25-02 [prose]
先从入口 request_id 与返回的 ticket_id 查询 SQL 工单和同事务 Outbox,拿稳定 event_id;确认 Outbox 是 pending 还是已确认发布,再看 relay 的尝试/错误、RabbitMQ 任务、Worker 的消费 receipt 与通知 fake sink。业务 ID 可在有访问控制、保留期限的日志里帮助定点查事故;若把每张工单或每租户作为指标标签,一次创建就会增加长期时间序列,存储、查询和告警都会失控,还暴露不必要的业务维度。
当前逐事件埋点已经存在:API 成功创建写 api_ticket_created;relay 成功/可重试失败分别写 outbox_event_published、outbox_event_retryable;Worker 成功、可重试失败和终止失败分别写 worker_event_handled、worker_event_retryable、worker_event_failed。本地合同已经验证这些事件的字段结构以及凭据、Authorization 等敏感字段的递归脱敏。尚未取得的是一次真实 API/relay/Worker 三进程运行中的关联日志样本;第 25 课远端 selector 对这一项仍是 PENDING,不能把本地合同写成远端链路已通过。
用可聚合的量描述请求
ticketflow_http_requests_total{method,route,status_class} 用方法、路由模板(如 /tickets/{ticket_id})和 5xx 聚合,ticketflow_http_request_duration_seconds_bucket{method,route,le} 给出直方图桶。粗略五分钟查询:
sum(rate(ticketflow_http_requests_total[5m]))
sum(rate(ticketflow_http_requests_total{status_class="5xx"}[5m])) / sum(rate(ticketflow_http_requests_total[5m]))
histogram_quantile(0.95, sum by (le) (rate(ticketflow_http_request_duration_seconds_bucket[5m])))
分母为零时 PromQL 不能定义正常错误率;看板为了避免除零采用 clamp_min(…,0.000001),低流量/无流量时数值并不能证明 SLO 达标,要同时看 request rate 与 scrape up。p95 是按桶插值得到的估计,多个服务实例要先按 le 聚合;本文的全局 p95 不保留 route,某条慢路径可能被总量遮住,需要按 route 分组进一步定位。Histogram 目前没有 status class 标签,不能从它直接拆“仅 5xx 的 p95”。
异步侧,ticketflow_outbox_pending 表示 SQL 已提交、尚未确认发布的数量,ticketflow_outbox_oldest_age_seconds 表示最老未发布事件年龄。计数可能因为吞吐量上涨而短时增加;年龄持续增大则更像 relay/broker 故障。ticketflow_worker_tasks_total{outcome}、ticketflow_outbox_publish_total{outcome}、搜索请求时延和缓存命中都有枚举 outcome,不能用异常消息、trace ID 或 tenant 当标签。Outbox pending 不等于 RabbitMQ queue depth;前者恢复为零时,Worker 仍可能积压。
TicketFlowMetrics.record_cache/record_outbox_publish/record_search/record_worker 对标签值做白名单;observe_http 本身没有检查 route 必为模板,所以安全性还依赖 API 中间件从路由对象取模板,未匹配时统一写 unmatched。若调用者改成 scope["path"],每个工单 URL 都能变成新序列;修改埋点时需测试这一点。
从单测到抓取的证据层
正式本地 selector:python tools/verify_executable_revisions.py –lesson 26 –python python,独立安装并运行 baseline 与 09–26 的全部历史合同。它检查独立 CollectorRegistry、route 模板、cache/outbox/search/worker 样本,但没验证 Prometheus 真抓到了两台 API。远端配置列出 api-a:8000、api-b:8000、relay:9101、worker:9102,需经 live target/sample 检查。Worker 的 Compose 进程采用 Celery prefork,任务在子进程记录 Counter、父进程提供 /metrics;运行时启动前清理专用 multiprocess 目录并由父进程合并子进程文件,不能用普通父进程内存 registry 代替。授权远端设置 TICKETFLOW_PROMETHEUS_URL 后运行 python scripts/run_remote_selector.py –checkpoint 26 –selector tests/integration/test_worker_metrics_scrape.py::test_running_prefork_worker_completed_task_is_scraped:创建工单、等通知完成,并要求 Prometheus 中 Worker 的 success Counter 相对基线增长;未实际运行时保持 PENDING,不能声称抓取 PASS。若 rate 为空,先看 /api/v1/targets 的健康与 scrape URL,再看 exporter /metrics、请求是否发生;若 p95 奇怪,检查桶聚合与窗口样本,不要把“无流量”报告为 0 ms 成功。
本课练习
练习 EX-26-01 [code]
在独立 CollectorRegistry 里用 TicketFlowMetrics 记录 97 个 200、3 个 503(相同 GET/路由模板),再设置 pending=7;从 sample 中读取两种状态类别的 Counter,断言分别为 97/3、没有业务 ID 标签,打印 2xx=97 5xx=3 pending=7。不要把这当真实流量。
练习 EX-26-02 [prose]
给一次“HTTP 错误率 5% 且 Outbox pending 增至 120”的事故设计排查顺序:哪张面板先看请求量和 p95,哪些指标区分 broker/relay 与 API 故障?假设业务 SLO 为 99.5% 成功率,解释它与配置的五分钟 5% 告警阈值并非一回事,以及低流量下比率的陷阱。
收尾
指标可以发现趋势,却不会自动告诉值班人员去哪一页、执行什么安全动作。27 用已 provision 的 Grafana 看板、告警规则和 runbook 走一遍事故;它也会指出静态规则与实际故障语义之间的差距。
完整核心模块:有界标签的业务指标
from __future__ import annotations
from prometheus_client import CollectorRegistry, Counter, Gauge, Histogram
class TicketFlowMetrics:
"""Own metric contracts so high-cardinality business IDs cannot become labels."""
def __init__(self, *, registry: CollectorRegistry) –> None:
self.http_requests = Counter(
"ticketflow_http_requests_total",
"Completed TicketFlow HTTP requests",
("method", "route", "status_class"),
registry=registry,
)
self.http_seconds = Histogram(
"ticketflow_http_request_duration_seconds",
"End-to-end HTTP response duration",
("method", "route"),
registry=registry,
)
self.cache_operations = Counter(
"ticketflow_cache_operations_total",
"Cache outcomes by bounded operation",
("operation", "outcome"),
registry=registry,
)
self.outbox_pending = Gauge(
"ticketflow_outbox_pending",
"Events committed in PostgreSQL but not yet confirmed by the broker",
registry=registry,
)
self.outbox_oldest_age = Gauge(
"ticketflow_outbox_oldest_age_seconds",
"Age of the oldest unpublished Outbox event",
registry=registry,
)
self.outbox_publish = Counter(
"ticketflow_outbox_publish_total",
"Outbox publish attempts by bounded outcome",
("outcome",), registry=registry,
)
self.search_requests = Counter(
"ticketflow_search_requests_total", "Search requests by outcome",
("outcome",), registry=registry,
)
self.search_seconds = Histogram(
"ticketflow_search_request_duration_seconds", "Search request latency",
("outcome",), registry=registry,
)
self.worker_tasks = Counter(
"ticketflow_worker_tasks_total", "Worker task outcomes",
("outcome",), registry=registry,
)
def observe_http(
self,
*,
method: str,
route: str,
status_code: int,
duration_seconds: float,
) –> None:
status_class = f"{status_code // 100}xx"
self.http_requests.labels(method.upper(), route, status_class).inc()
self.http_seconds.labels(method.upper(), route).observe(duration_seconds)
def record_cache(self, *, operation: str, outcome: str) –> None:
allowed_operations = {"ticket_get", "ticket_put", "ticket_invalidate"}
allowed_outcomes = {"hit", "miss", "success", "error", "degraded"}
if operation not in allowed_operations or outcome not in allowed_outcomes:
raise ValueError("cache metric labels must come from the bounded contract")
self.cache_operations.labels(operation, outcome).inc()
def set_outbox_pending(self, count: int) –> None:
if count < 0:
raise ValueError("outbox pending count cannot be negative")
self.outbox_pending.set(count)
def set_outbox_stats(self, *, pending: int, oldest_age_seconds: float) –> None:
self.set_outbox_pending(pending)
self.outbox_oldest_age.set(max(0.0, oldest_age_seconds))
def record_outbox_publish(self, outcome: str) –> None:
if outcome not in {"confirmed", "retryable", "failed"}:
raise ValueError("invalid Outbox outcome")
self.outbox_publish.labels(outcome).inc()
def record_search(self, *, outcome: str, duration_seconds: float) –> None:
if outcome not in {"success", "unavailable", "rejected"}:
raise ValueError("invalid search outcome")
self.search_requests.labels(outcome).inc()
self.search_seconds.labels(outcome).observe(duration_seconds)
def record_worker(self, outcome: str) –> None:
if outcome not in {"success", "retry", "failure", "duplicate"}:
raise ValueError("invalid worker outcome")
self.worker_tasks.labels(outcome).inc()