/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
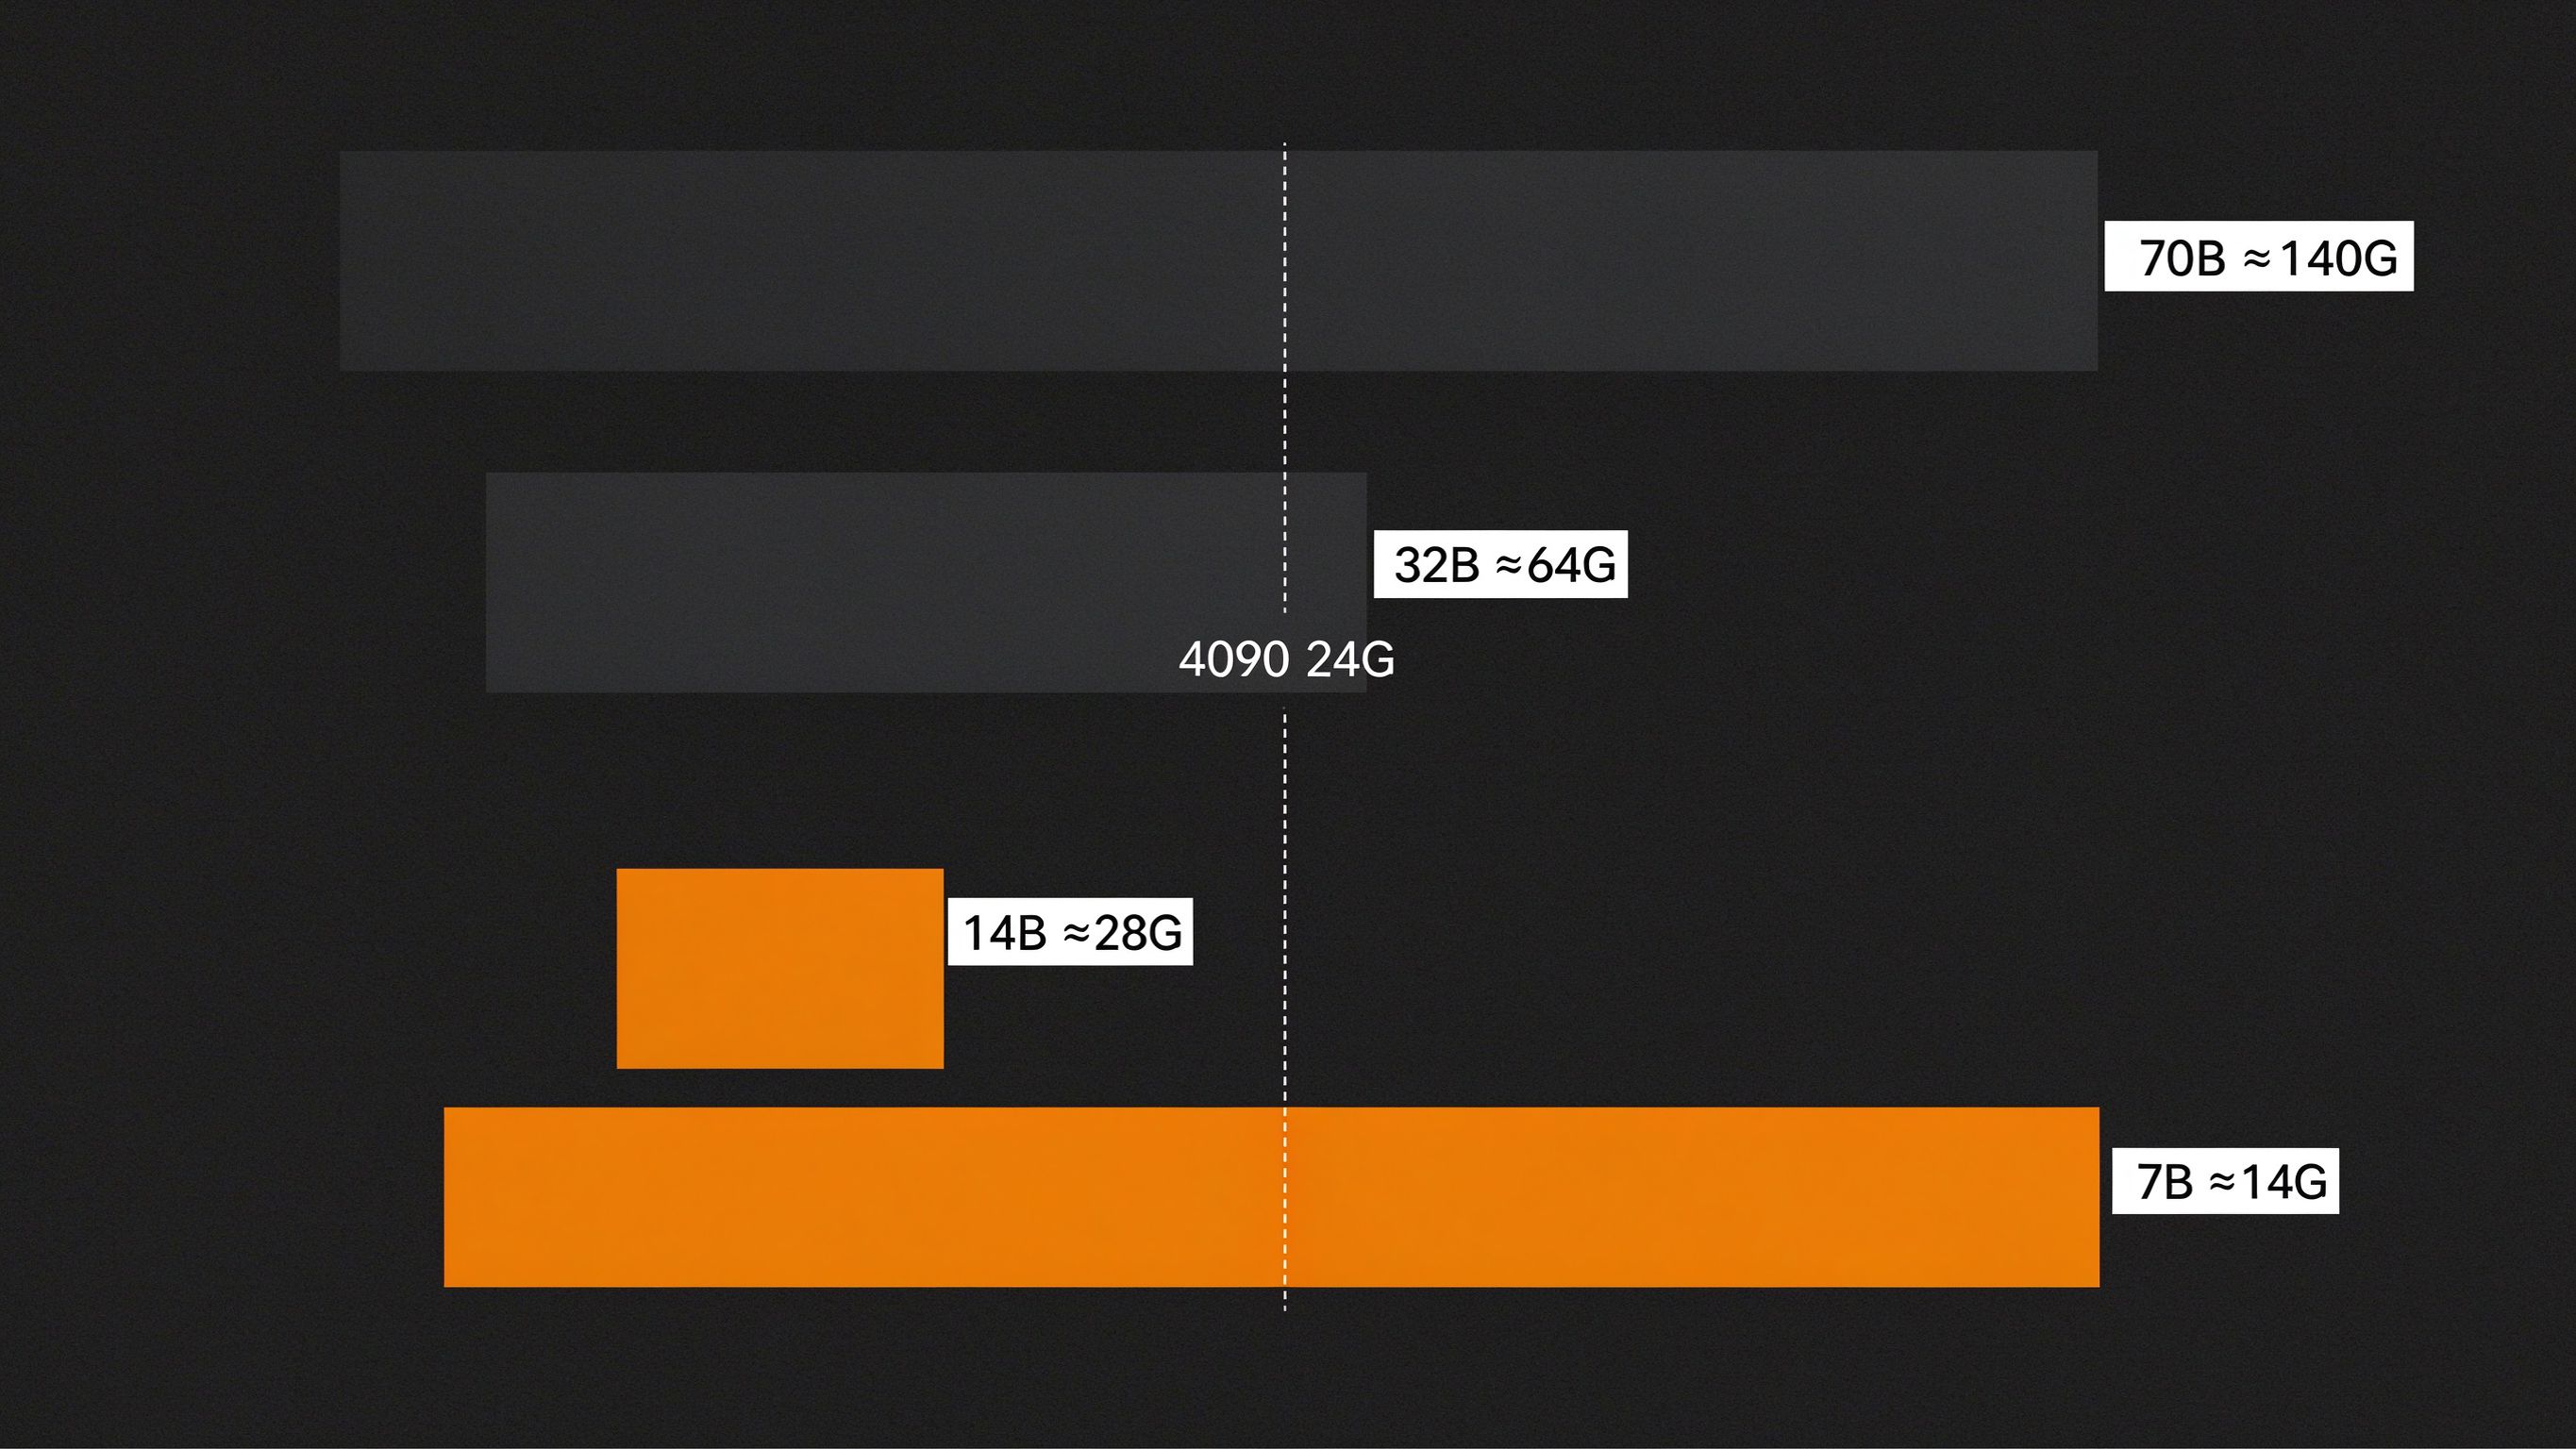
很多人问:"我只有一张 24G 显存的 4090,能不能跑 70B?"答案是:7B 随便跑、14B 要量化、32B 是极限、70B 基本扛不动。但这个边界具体在哪、为什么,很多人说不清。这篇给你一张能存下来对照的清单。
先懂一个公式:显存怎么算出来的
模型权重显存 ≈ 参数量 × 每个参数占几个字节:
| FP16 / BF16 | 2 | 满血质量,最占显存 |
| INT8 | 1 | 约一半显存,质量损失很小 |
| INT4(量化) | 0.5 | 约四分之一显存,消费卡甜点 |
此外还要留两块:KV Cache(随上下文长度和并发数涨)和框架开销(约 1–2GB)。所以"理论显存"要再留 15%–20% 余量。
核心对照表:4090(24G)能跑到哪
| 7B | Qwen2.5-7B / Llama3-8B | ✅ 轻松跑 | FP16 即可 | 2–5 并发 |
| 14B | Qwen2.5-14B | ✅ 能跑 | INT8 | 1–2 并发 |
| 32B | Qwen2.5-32B | ⚠️ 极限 | 必须 INT4 | 1 并发 |
| 70B | Qwen2.5-70B / Llama3-70B | ❌ 不推荐 | 量化后仍超显存 | — |
7B:4090 的甜点区
7B 模型 FP16 权重约 14GB,加上 KV Cache 和框架开销,稳稳落在 24G 以内,还留有富余。
这是 4090 最舒服的场景:客服机器人、代码助手、轻量 RAG、单用户对话。24G 的显存不仅装得下,还能留出余量做几个并发。如果你只是跑 7B 级别的业务,上更贵的卡就是浪费。
14B:够用,但要量化
14B 模型 FP16 权重约 28GB——直接超过 24G。但量化到 INT8 后约 14GB,就能塞进 4090 了。
INT8 的质量损失通常很小(多数 benchmark 和 FP16 差距在 1% 以内),日常业务基本无感。代价是并发要降下来,大概只能跑 1–2 个并发。
32B:极限操作
32B 模型 FP16 约 64GB,4090 完全装不下。必须量化到 INT4(约 18–20GB)才勉强塞进 24G。
能跑,但要接受两个代价:一是上下文不能开太长(KV Cache 一涨就爆显存);二是速度明显比 7B 慢,只适合低并发、对时延不敏感的场景。这是"能跑"和"好用"的分界线。
70B:4090 扛不动
70B 模型 FP16 权重约 140GB,就算量化到 INT4 也要约 35–40GB——单张 4090 的 24G 还是不够。
想跑 70B,得往上走:
- L40S(48G):量化后的 70B 能单卡跑,但并发和速度有限。
- H20(96G)/ A100(80G):70B 生产环境、多并发的正经选择。
与其用 4090 硬塞 70B 跑不动,不如直接租一张 48G/96G 的卡——时间和调试成本比差价贵多了。
4090 适合谁、不适合谁
| 个人开发者、小团队试错 | 跑 70B 生产环境 |
| 7B/14B 业务、低并发 | 高并发、低时延要求 |
| 本地开发、原型验证 | 稳定对外服务 |
升级路径很清楚:4090 跑 7B/14B 够用 → 要 32B 量化就将就或加卡 → 要 70B、高并发,直接上 L40S 或 H20。
你要跑什么模型、大概几个并发?评论区报一下配置,我帮你看 4090 够不够,不够该上什么卡。