模型更新很容易变成一串新名字和 benchmark 分数。DeepSeek V4.1 Flash 1017 这次更值得看的地方,是它把能力展示推进到了“直接做出一个项目”。
10 月 17 日,DeepSeek 发布 DeepSeek-V4.1-Flash-1017,并称新版本相较此前的 V4.1 Flash 有更强的基准表现、更快的任务完成速度和更短的输出。官网、App 和 API 也同步更新。
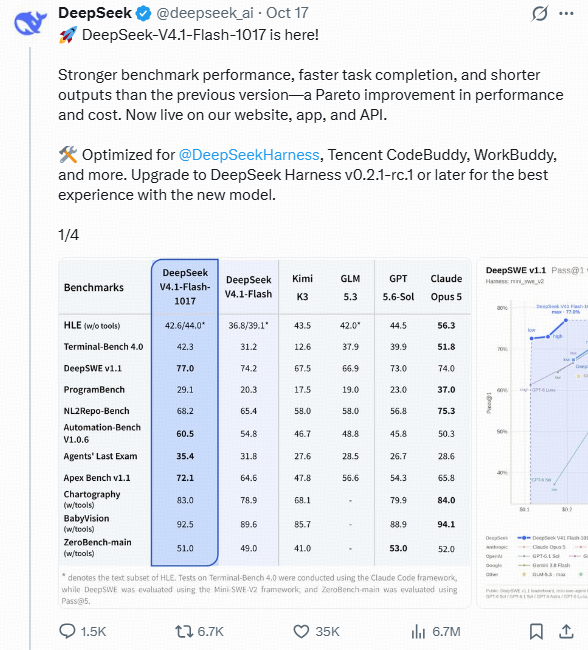 图:DeepSeek 官方发布帖与基准表,来源:DeepSeek 官方 X。
模型名多了一个 1017,只是表面变化。从官方展示的 3D 场景、网页游戏和 Agent 基准来看,DeepSeek 想让 Flash 承担的工作,已经从“回答问题、补几段代码”扩展到“围绕目标把项目做出来”。
先看结果:它开始展示完整项目
DeepSeek 在发布页里把 1017 的能力描述为端到端项目开发,并提到模型使用了带自反馈的强化学习。官方随后展示了四类结果:故宫 3D 建模、网页赛车游戏、用 Godot 复刻 Portal 2,以及一个展示时代演化的 3D 场景。
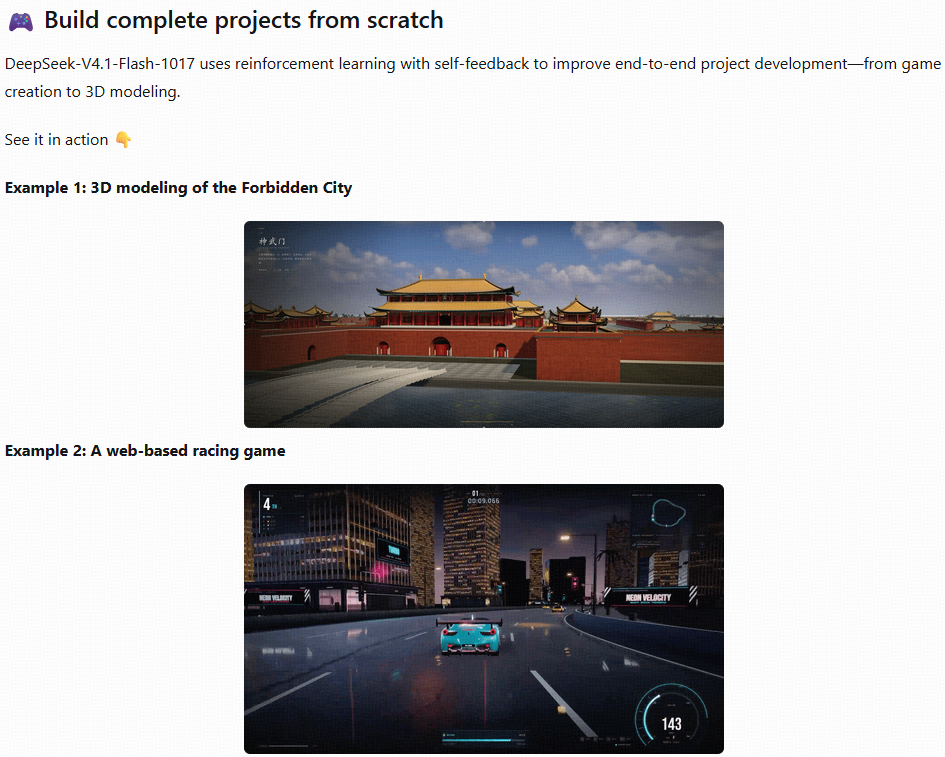 图:官方发布页展示的故宫 3D 建模和网页赛车游戏,来源:DeepSeek 1017 发布页。
这些例子有一个共同点:最终结果不止是一段聊天窗口里的文字,而是一个可以继续观察、修改和运行的项目或场景。模型需要理解目标,组织代码和资源,再把结果呈现出来。对开发者来说,这比单独看一段代码是否写得通,更接近真实的 Agent 工作方式。
当然,官方演示不能自动等于“所有项目一次生成成功”。它能证明的是,DeepSeek 正在把模型训练和展示重点放到多步骤项目开发上,单轮问答只是其中一部分。
这和普通代码生成有什么区别
如果只是生成一个函数、一个页面或一段脚本,模型输出得更快,体验就会更好。但完整项目还要处理一连串事情:理解需求、拆分任务、创建文件、反复修改、调用工具,再把中间结果组合起来。
从官方展示来看,1017 的升级主要体现在三个层面。
第一是连续执行。模型不只给出一个代码片段,而是围绕最终目标推进多个步骤。第二是工程闭环,输出不再停在“这里有一份示例代码”,而是朝着可运行的项目组织文件和资源。第三是视觉与交互结合,故宫场景和赛车游戏把代码结果变成了可以直接观察的画面。
所以 DeepSeek 把它放在“端到端项目开发”的语境里介绍。这个说法并不等于每个任务都不需要人工修改,重点在于模型能够承担更长的工作链路。
benchmark 分数,应该怎样看
官方更新日志列出的指标覆盖代码 Agent、终端任务和视觉任务。1017 的 DeepSWE v1.1 得分为 77.0,Terminal-Bench 4.0 为 42.3,Chartography 为 83.0,BabyVision 为 92.5。此前版本在同一页列出的对应分数分别是 74.2、31.2、78.9 和 89.6。
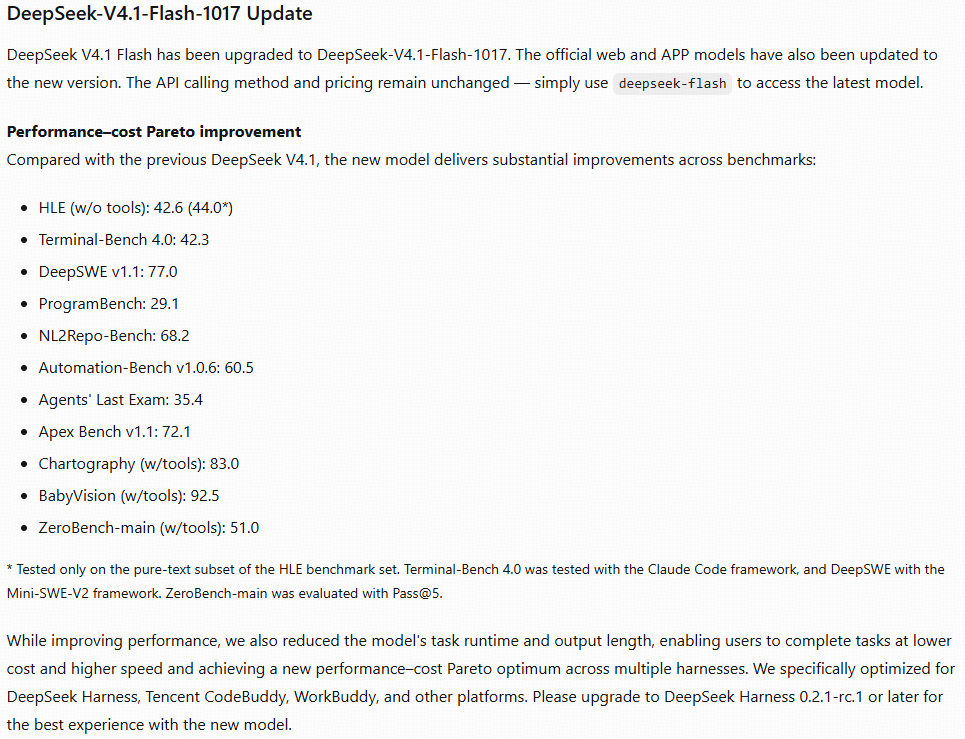 图:官方更新日志中的版本说明、基准结果和测试条件,来源:DeepSeek API Change Log。
这些数字可以说明 1017 相比上一版的能力方向:代码 Agent、终端操作和视觉任务都有提升。但它们不能被改写成“1017 在所有任务上都比所有模型强”。官方页面已经注明,Terminal-Bench 使用 Claude Code 框架,DeepSWE 使用 Mini-SWE-V2,ZeroBench 使用 Pass@5;不同框架和测试方式会影响结果。
所以,benchmark 更适合回答“这次更新把力量放在哪些任务上”,不能替开发者直接做生产选型。对这次发布来说,方向很清楚:代码 Agent、长链路任务和带视觉结果的项目,是官方最想展示的内容。
更快、更短,带来什么体验变化
1017 的另一组变化是任务完成时间和输出长度。对于需要连续调用工具的 Agent,任务更快完成意味着等待环节可能缩短;对于需要阅读或后处理的输出,内容更短也可能让流程更轻。
但“更短”只有在结果完整时才有价值。如果模型少输出了关键字段、代码文件或工具调用结果,token 变少反而会带来返工。DeepSeek 官方自己的表述是性能、成本和速度出现了新的平衡,开发者仍然需要结合具体任务理解这句话。
官方发布页还放出了一张 DeepSWE v1.1 的 Pass@1 与单任务成本曲线。图中 1017 位于较高的成功率区间,展示的是 DeepSeek 在该测试口径下对性能和成本关系的定位。
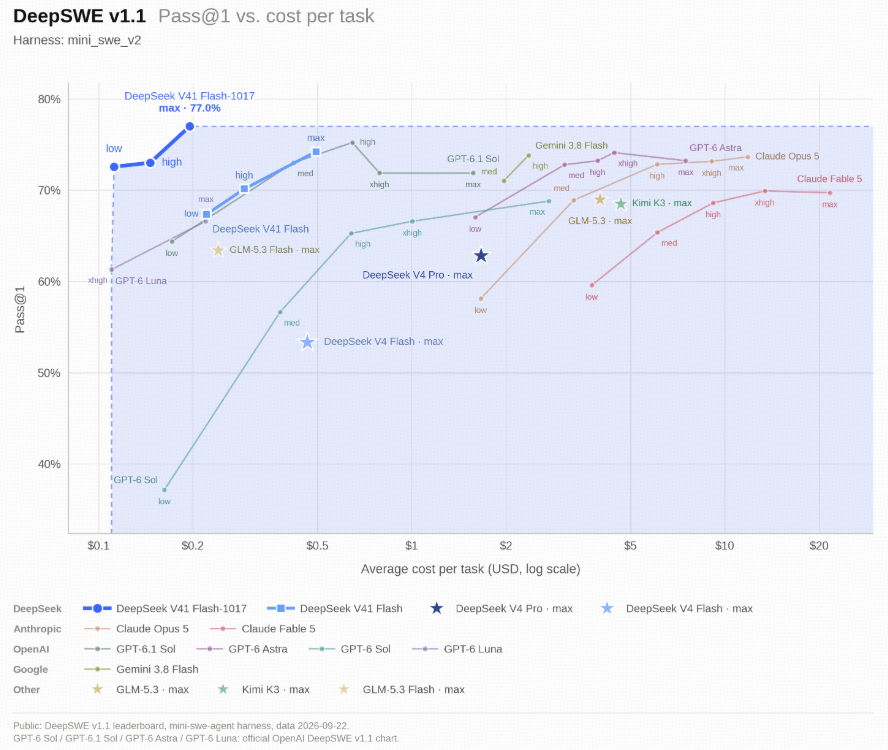 图:DeepSeek 发布页展示的 DeepSWE v1.1 Pass@1 与单任务成本关系,来源:DeepSeek 1017 发布页。
这张图适合用来理解 1017 的产品方向:它要在代码 Agent 任务里同时争取完成率、速度和成本表现,而不是只追求一个孤立的分数。
想体验,先知道这几个 API 信息
能力展示之外,1017 的接入信息也比较简单。DeepSeek 官方价格页显示,当前 API 模型名是 deepseek-flash,对应的模型版本为 DeepSeek-V4.1-Flash-1017。调用方式和价格保持不变,旧的兼容模型名也仍然可以使用并路由到新版本。
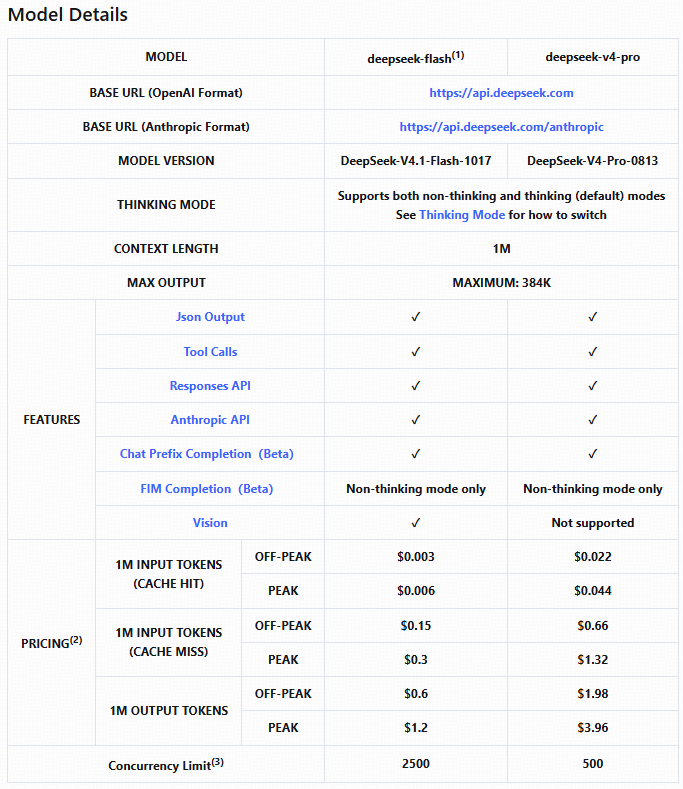 图:官方价格页中的模型版本、接口、上下文、能力和价格字段
当前官方页面列出的能力包括 1M 上下文、384K 最大输出、工具调用、Responses API、Anthropic API 和视觉输入。价格仍按 Flash 的输入、缓存命中和输出口径计算,没有因为 1017 单独变成一次降价事件。
这部分信息的作用,是让想尝试 1017 的开发者知道从哪里开始。真正决定体验好不好,还是模型能否把自己的任务完整做完。
在 OkenAI 继续查看 1017 的服务线路
如果你想把官方演示里的能力放进自己的项目,可以在 OkenAI 的模型详情页继续查看 DeepSeek V4.1 Flash 1017 的已收录服务线路。页面里可以看到线路的稳定性、模型行为、Token 消耗和价格字段,也能进入模型一致性与 Token 消耗相关的测评入口。
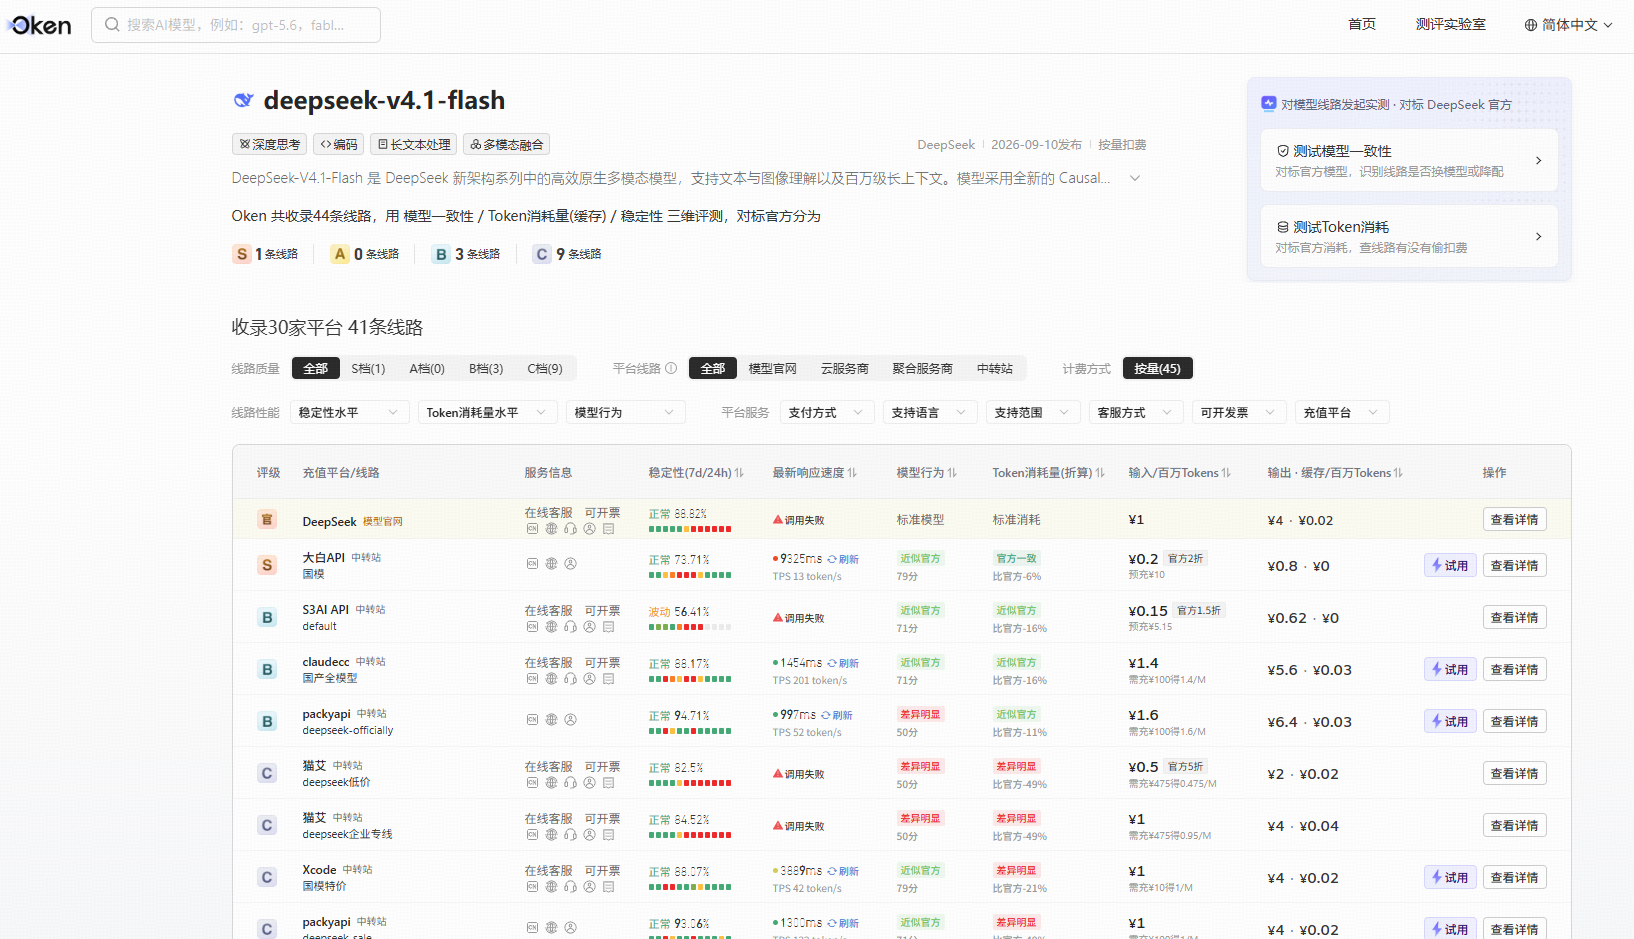 图:OkenAI 已收录的 DeepSeek V4.1 Flash 服务线路和测评入口,来源:OkenAI 模型详情页。
这样看这次更新会更完整:DeepSeek 官方负责展示 1017 想解决什么问题、能力提升在哪些方向;OkenAI 则提供继续查看服务线路和体验入口。读者可以先从官方演示理解模型,再选择合适的服务去尝试自己的任务。
结语
DeepSeek V4.1 Flash 1017 的核心看点,是它开始用完整项目来展示模型能力:3D 场景、网页游戏、代码 Agent 和视觉任务被放到了一条连续的工作链路里。
官方 benchmark 说明了能力提升的方向,演示图让这种变化更直观;API 调用方式和价格没有改变,想体验的开发者仍然可以使用 deepseek-flash。
如果你关心的不是榜单分数,而是模型能不能把一个真实项目往前推进,可以从 OkenAI 已收录的 DeepSeek V4.1 Flash 服务线路开始查看和体验。