近年来,企业把大模型接进业务流程,已经从演示项目变成日常动作。客服问答、代码审查、会议纪要、报表生成,这些过去人工干的活儿,现在有对应的AI员工可以承担。行业里这个变化很明显,不少公司上半年还在犹豫,下半年就把试点转成了常规采购。
但有个事实常被忽略。不少系统上线头几个月表现不错,半年后开始原地踏步,有的还越用越别扭。根子不在模型能力,而在大多数部署把AI当成配好就完事的工具,后续没人管,知识库慢慢和现实脱节。能够跟着业务一起生长的系统,背后通常接了一根线,叫自学习反馈闭环。
一句话说清这件事:优秀的自动化员工,是用人用出来的,不是配完就定型。它靠收集使用者的反馈,把高质量输出和人工修正沉淀回知识库与技能,形成收集反馈、人工审核和持续优化的循环,实际效果需通过评测验证。
自学习到底是什么
自学习是一套机制。系统主动收集用户对结果的反馈,再把那些高质量产出和人工改过的答案,经筛选、审核和必要测试后,可将合适的反馈沉淀为知识条目或技能优化建议,让系统随着使用次数增加,回答准确性有望逐步提升,能力逐步增强。
它和传统的规则配置不是一类东西,区别在于演进方向。规则配置由人事先写死逻辑,系统照章办事,逻辑老化了只能人去改。自学习让系统从使用痕迹里提炼新规则,专业人员只在关键节点做纠偏,系统可辅助收集和整理反馈,知识更新、规则调整及上线仍需按企业治理流程审核。
反馈怎么变成能力
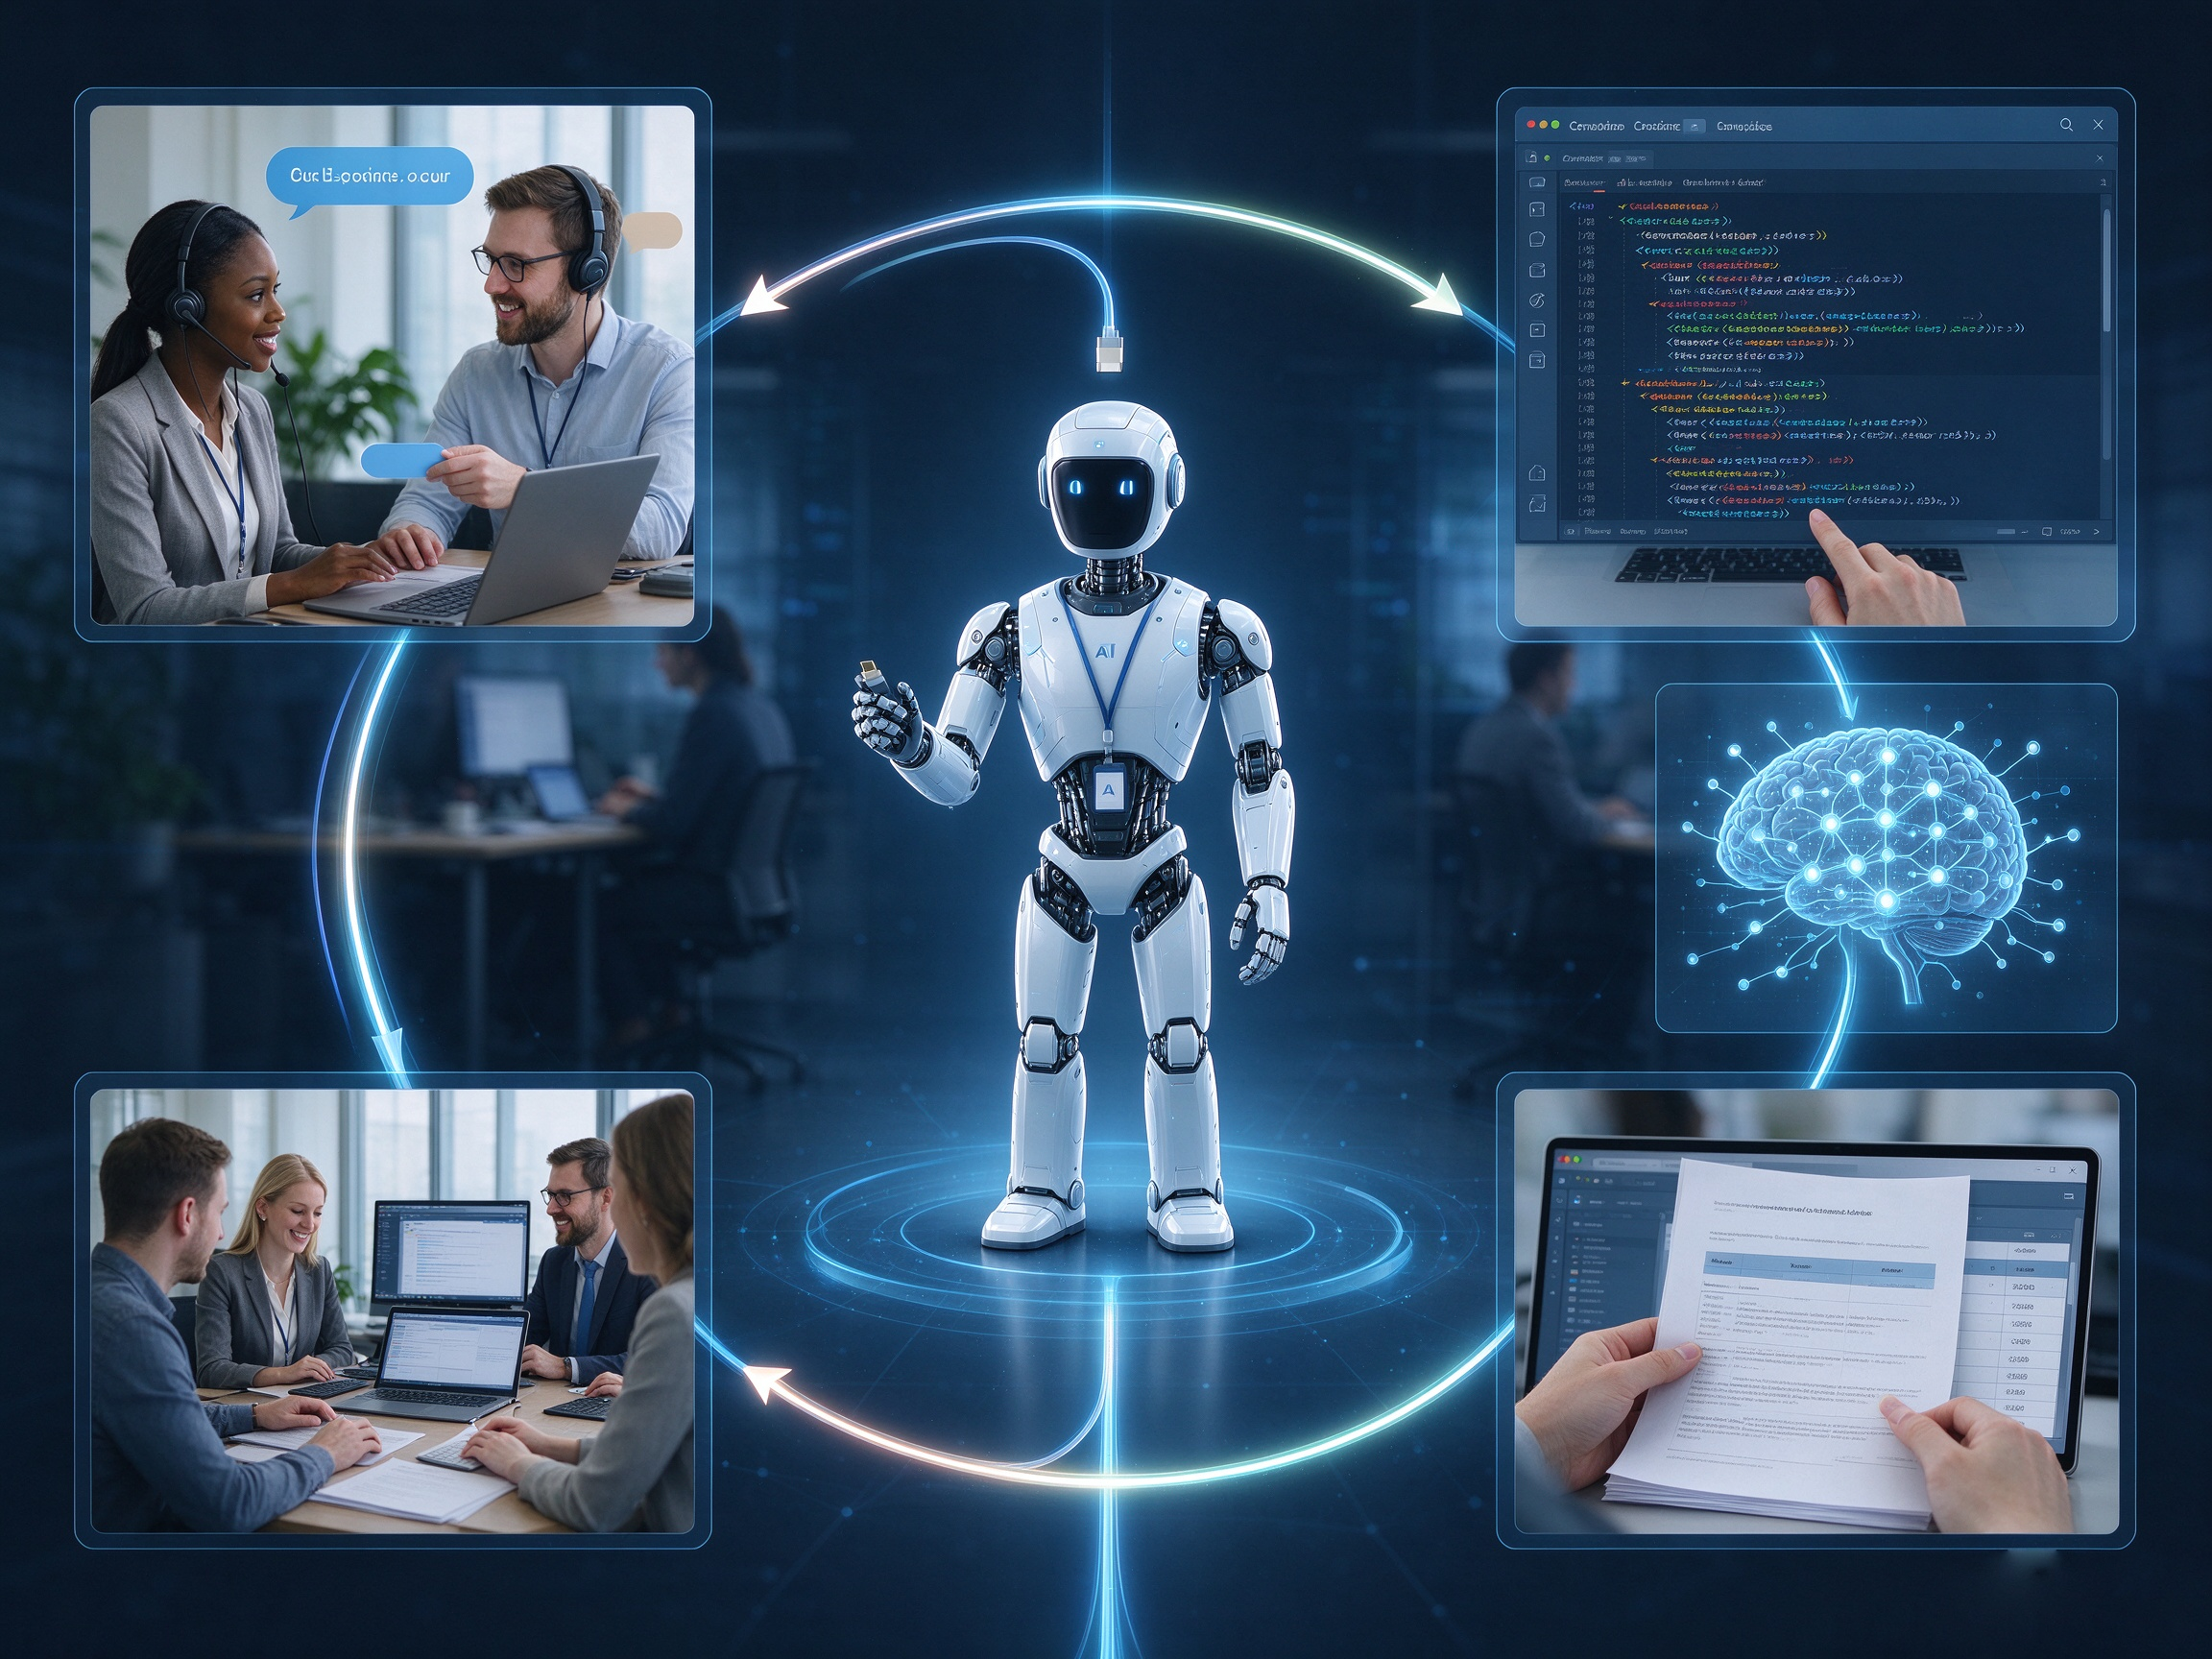
拆开看,自学习由四个动作组成。
第一步,收集信号。用户对回答点个赞或者点个踩,动作本身简单,价值在于它是一条明确的质量记录。系统把每次赞踩、每次人工修改、每次重新生成,都记成一条反馈数据。
第二步,自动入库。系统可从被点赞或采纳的问答中筛选候选条目,经专业人员审核后入库,标准化成知识库的新条目。一次偶然的好回答,借此转化为以后能反复调用的资产。
第三步,人工纠偏。AI答错时,专家直接改动,把正确答案和改动原因一起写回去。那条错误答案不删除,它进入学习循环,下次遇到相似问题,系统有助于避开此前的错误。
第四步,打分和贴标签。每一条新知识进来,系统给一个质量分,再提取几个核心关键词生成智能标签。检索时质量分高的优先推给模型,质量分低的往后排。
四步连起来,反馈才真正转成能力,不再是一堆散落的记录。
静态系统会过期
知识库和流程不是建好就一直有用。业务在变,产品参数在改,政策在调,三个月前写进知识库的一条规则,现在可能就已经不对。
靠人手动维护,可能难以完全跟上。一家中型企业的知识文档数量较多,人工团队可能难以完全跟上它的更新节奏。结果就是知识库渐渐失真,AI基于过期信息作答,准确率可能下降。
自学习反馈闭环把方向调了过来。它让系统自己长本事,使用过程可产生反馈,为知识库或流程优化提供参考;是否进行模型训练以实际方案为准。准确率有望随使用次数逐步提升,人的维护负担可能逐步降低,这是该机制的设计目标。
回到产品层面,小艾智能体把自学习机制放在RAG与技能链路之后,这个位置很关键。
它的文档处理引擎可使用 BGE-M3 将文本转换为向量存入 Milvus,检索时可结合 Elasticsearch 进行混合检索,为 RAG 提供片段。问答接口收到用户消息,回答生成之后,自学习模块可收集点赞点踩。被采纳的高质量问答,可转为新的知识条目,回流至向量库和 Neo4j 图数据库。
质量评分这一环可影响检索排序。分高的知识在下次相似问题里更有可能被优先召回,分低的排序可能靠后。小艾内置的 Skills 技能系统,比如 code_review、meeting_minutes,生成的产物可进入这套反馈循环,专家在人工修正工作流里改过的技能输出,可沉淀为技能自己的改进经验。
技术上,这套编排可基于 LangGraph 的 Checkpointer 实现状态持久化,长任务断点可续跑,反馈记录可保留。向量引擎可支持 IVF_FLAT、HNSW 等多种索引(具体算法来源参见相关技术文档),可按数据规模和业务需求选择索引,并通过性能测试评估检索速度。
小艾的定位是企业知识加工厂,也是自动化员工。优秀的自动化员工,是用出来的,不是配完就定型。反馈收集、自动入库、人工纠偏、质量评分,四步都较为重要。企业部署AI,图的是企业可通过反馈机制探索降低部分维护工作量、改善回答质量,实际效果应结合评测结果判断。