一、为什么是 Physis-Lang?
视频世界模型现在的问题,很少出在画质上。4K、电影级光影、以假乱真的材质,这些已经不難。难的是物理:黄油受热后像颜料一样摊开而不是熔化塌陷,积木在碰撞瞬间相互穿模,布料下落时没有重量。这些错误的共同点是,画面本身是清楚的,错的是过程——模型学会了“看起来像”,但没学会“为什么会这样”。此前的主流解法隐含一个共同假设——自然语言不足以承载物理知识,因此需要引入额外的视觉、潜变量、数值或规划信号(PhiZero 的离散“物理语言”、PhyGDPO 的偏好优化、NewtonGen 的神经动力学方程)。
Physis-Lang(NVIDIA + MIT + Oxford,2026-09-30 发布论文)反转了这个假设:问题不是语言不行,而是语言还没被用好。 它把物理语言当作一个"共享且可优化"的表征,贯穿数据筛选 → 模型训练 → 推理生成全流程,并以自进化 agent 持续改进这套语言本身。
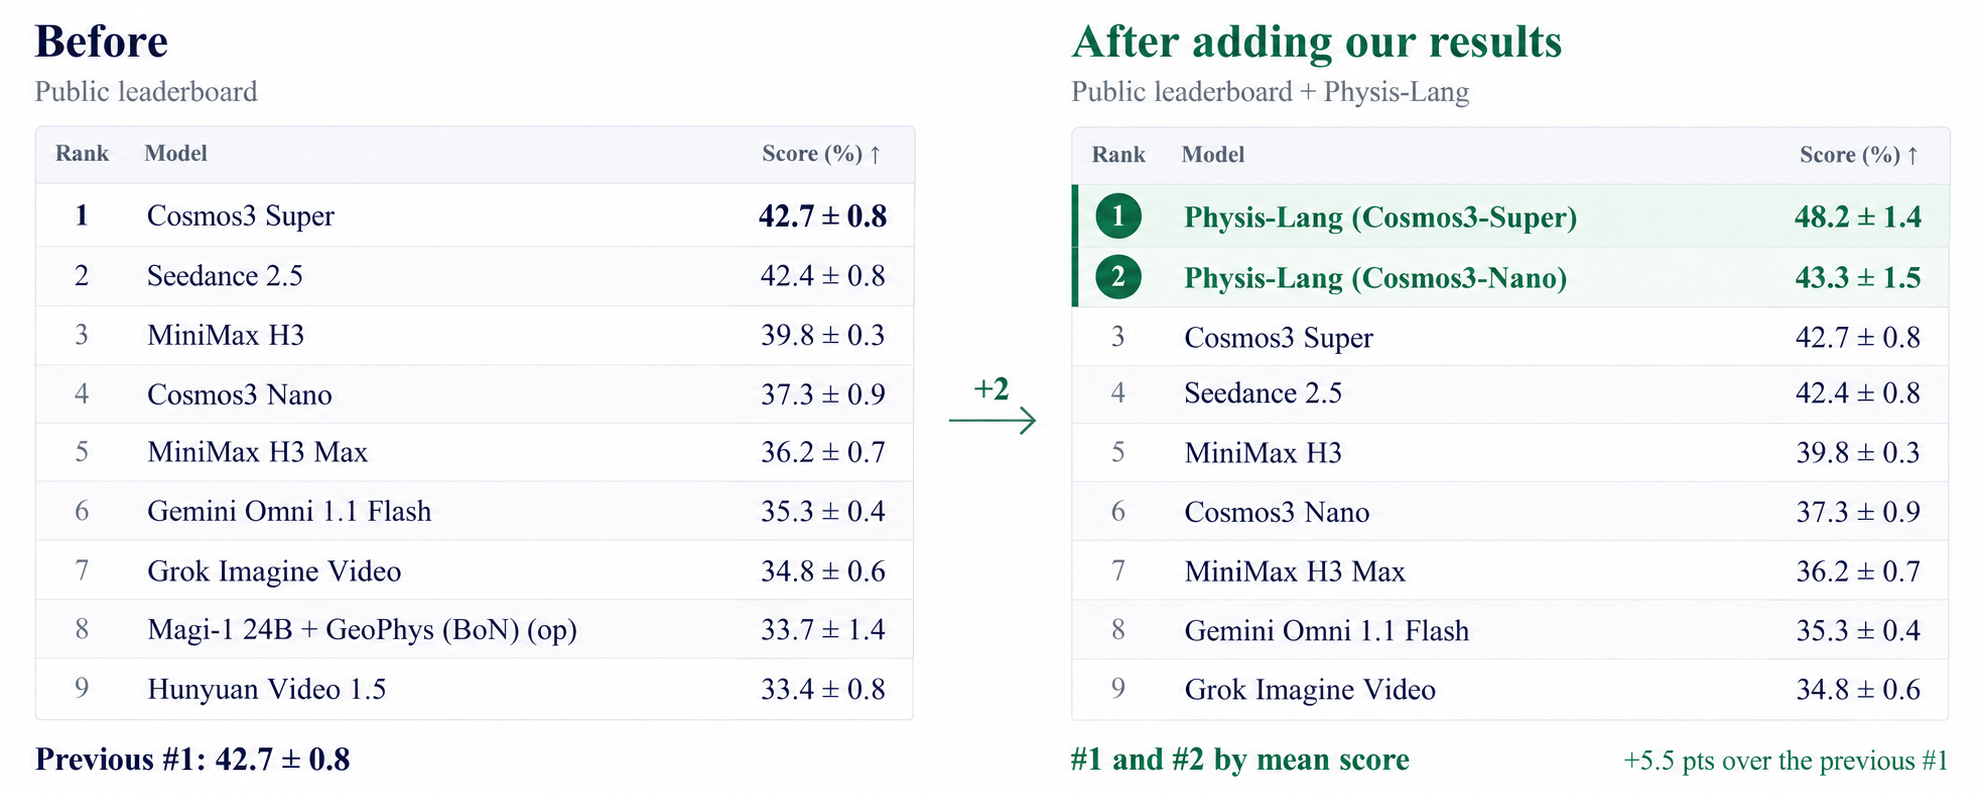
关于"登顶"需要说三层实话:
二、表示层创新:从"发生了什么"到"为什么发生"
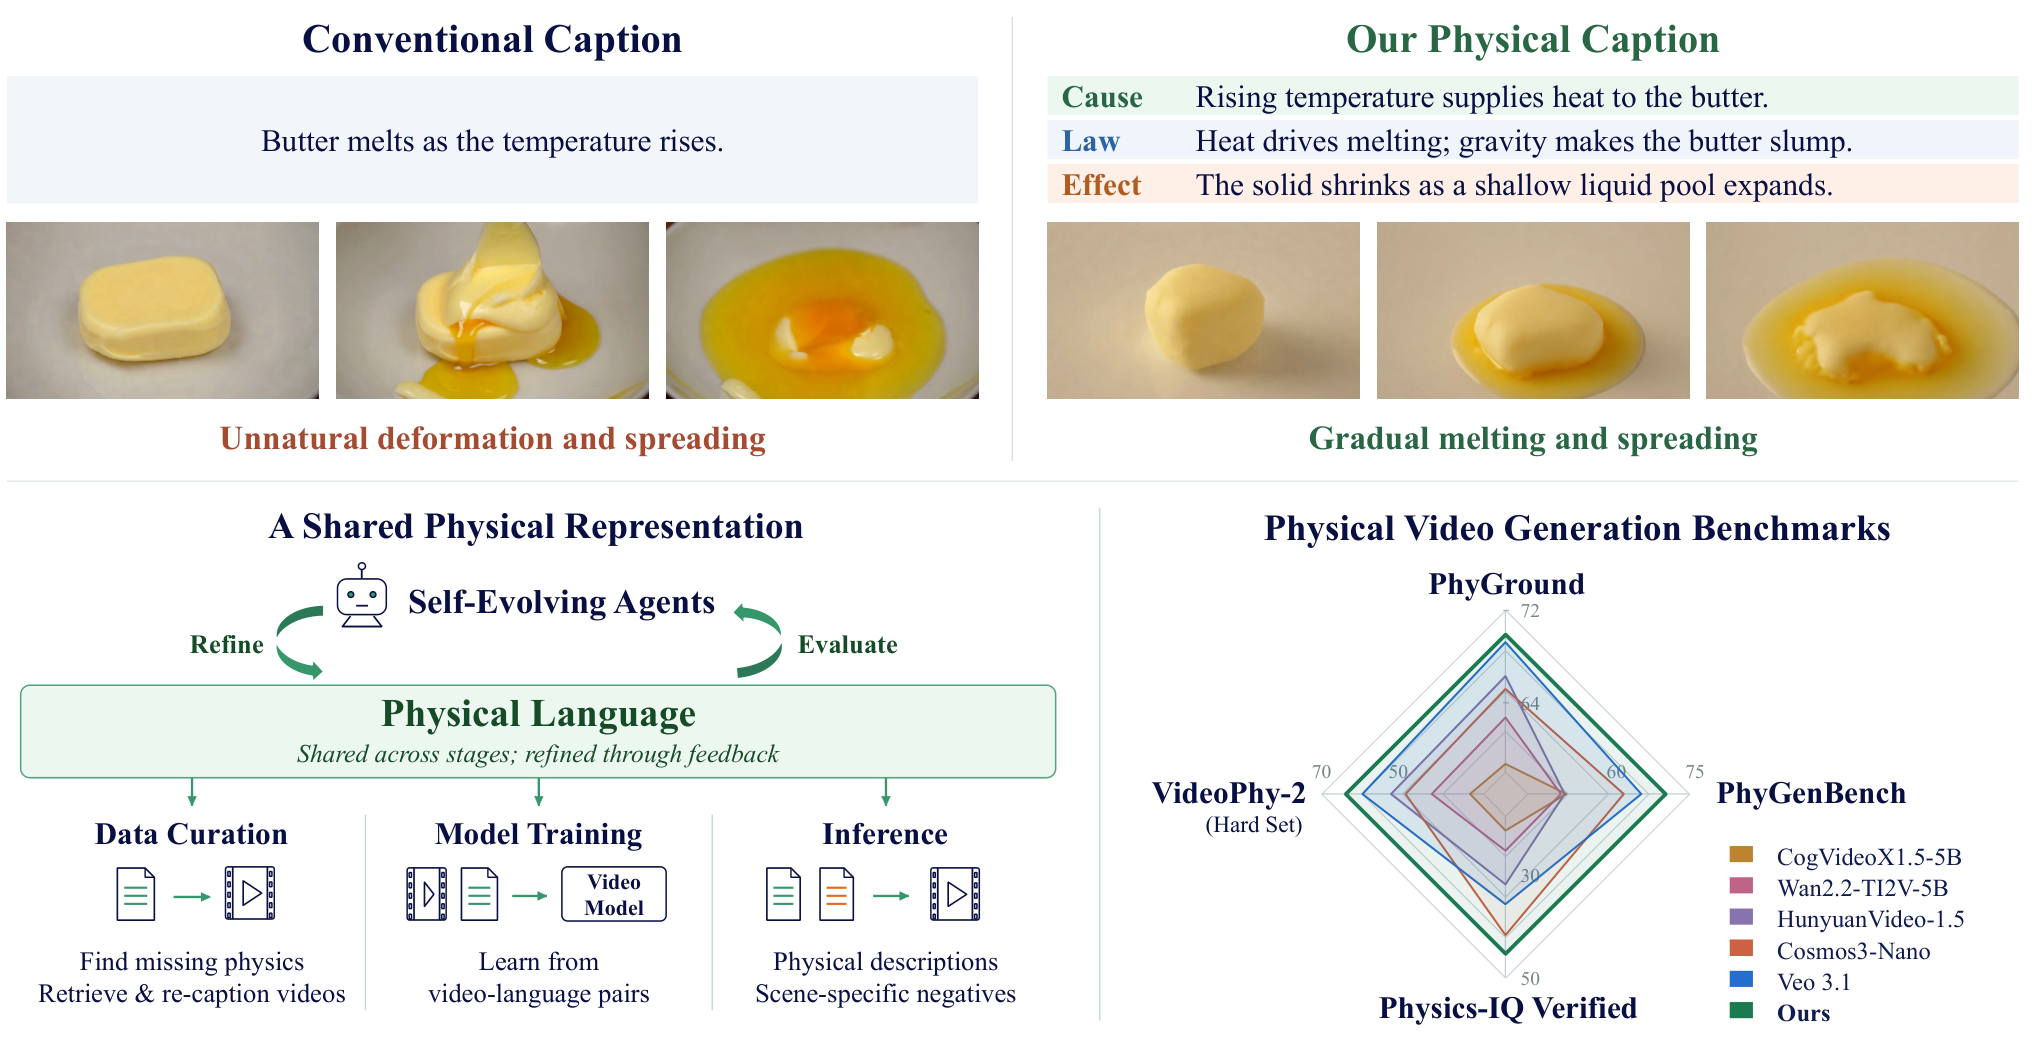
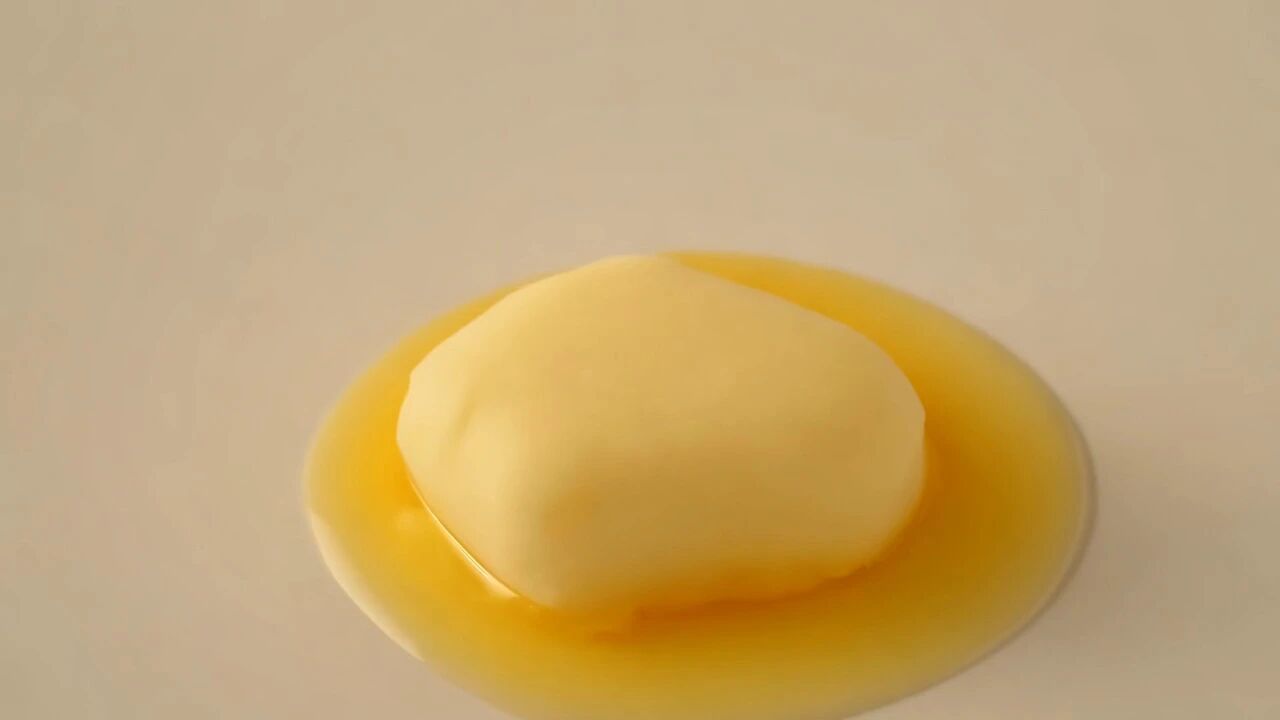
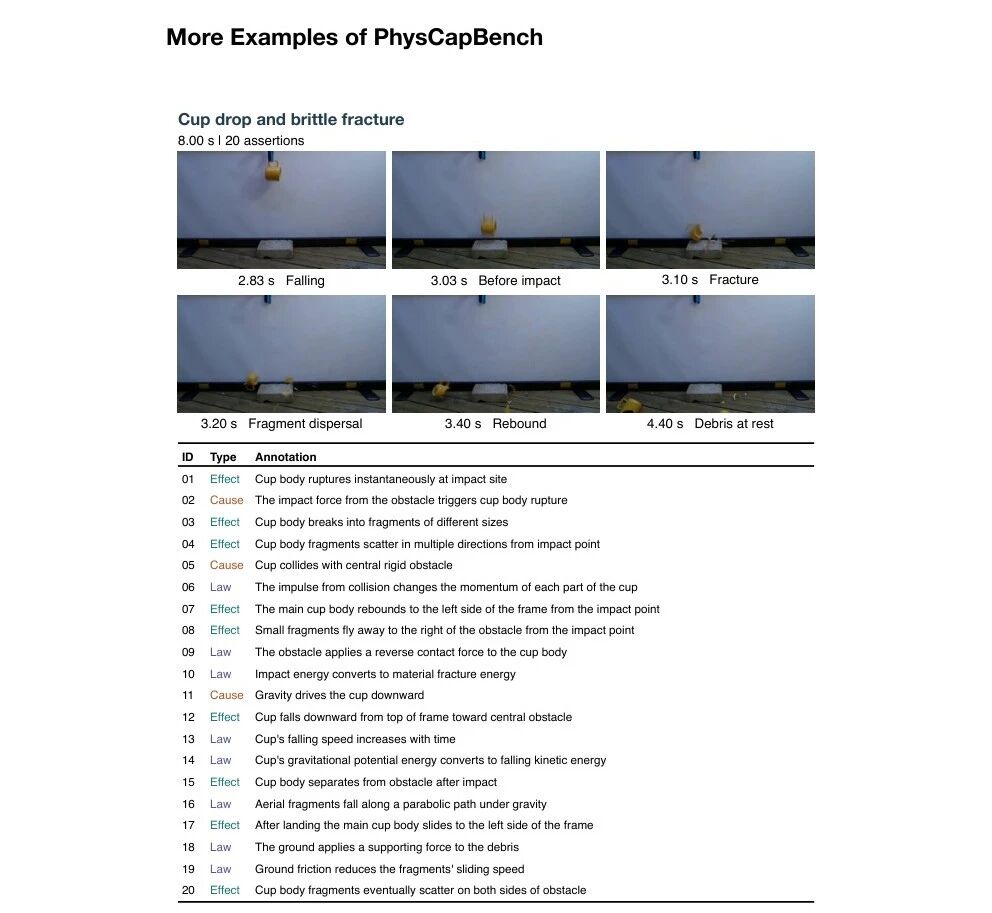
传统视频描述(caption):"Butter melts as the temperature rises." —— 只给事件,不给过程。Physis-Lang 将物理描述结构化为:
- Cause:升高的温度向黄油供热
- Physical law:热量驱动熔化;重力使黄油塌落
- Effect:固体缩小,浅层液池扩张
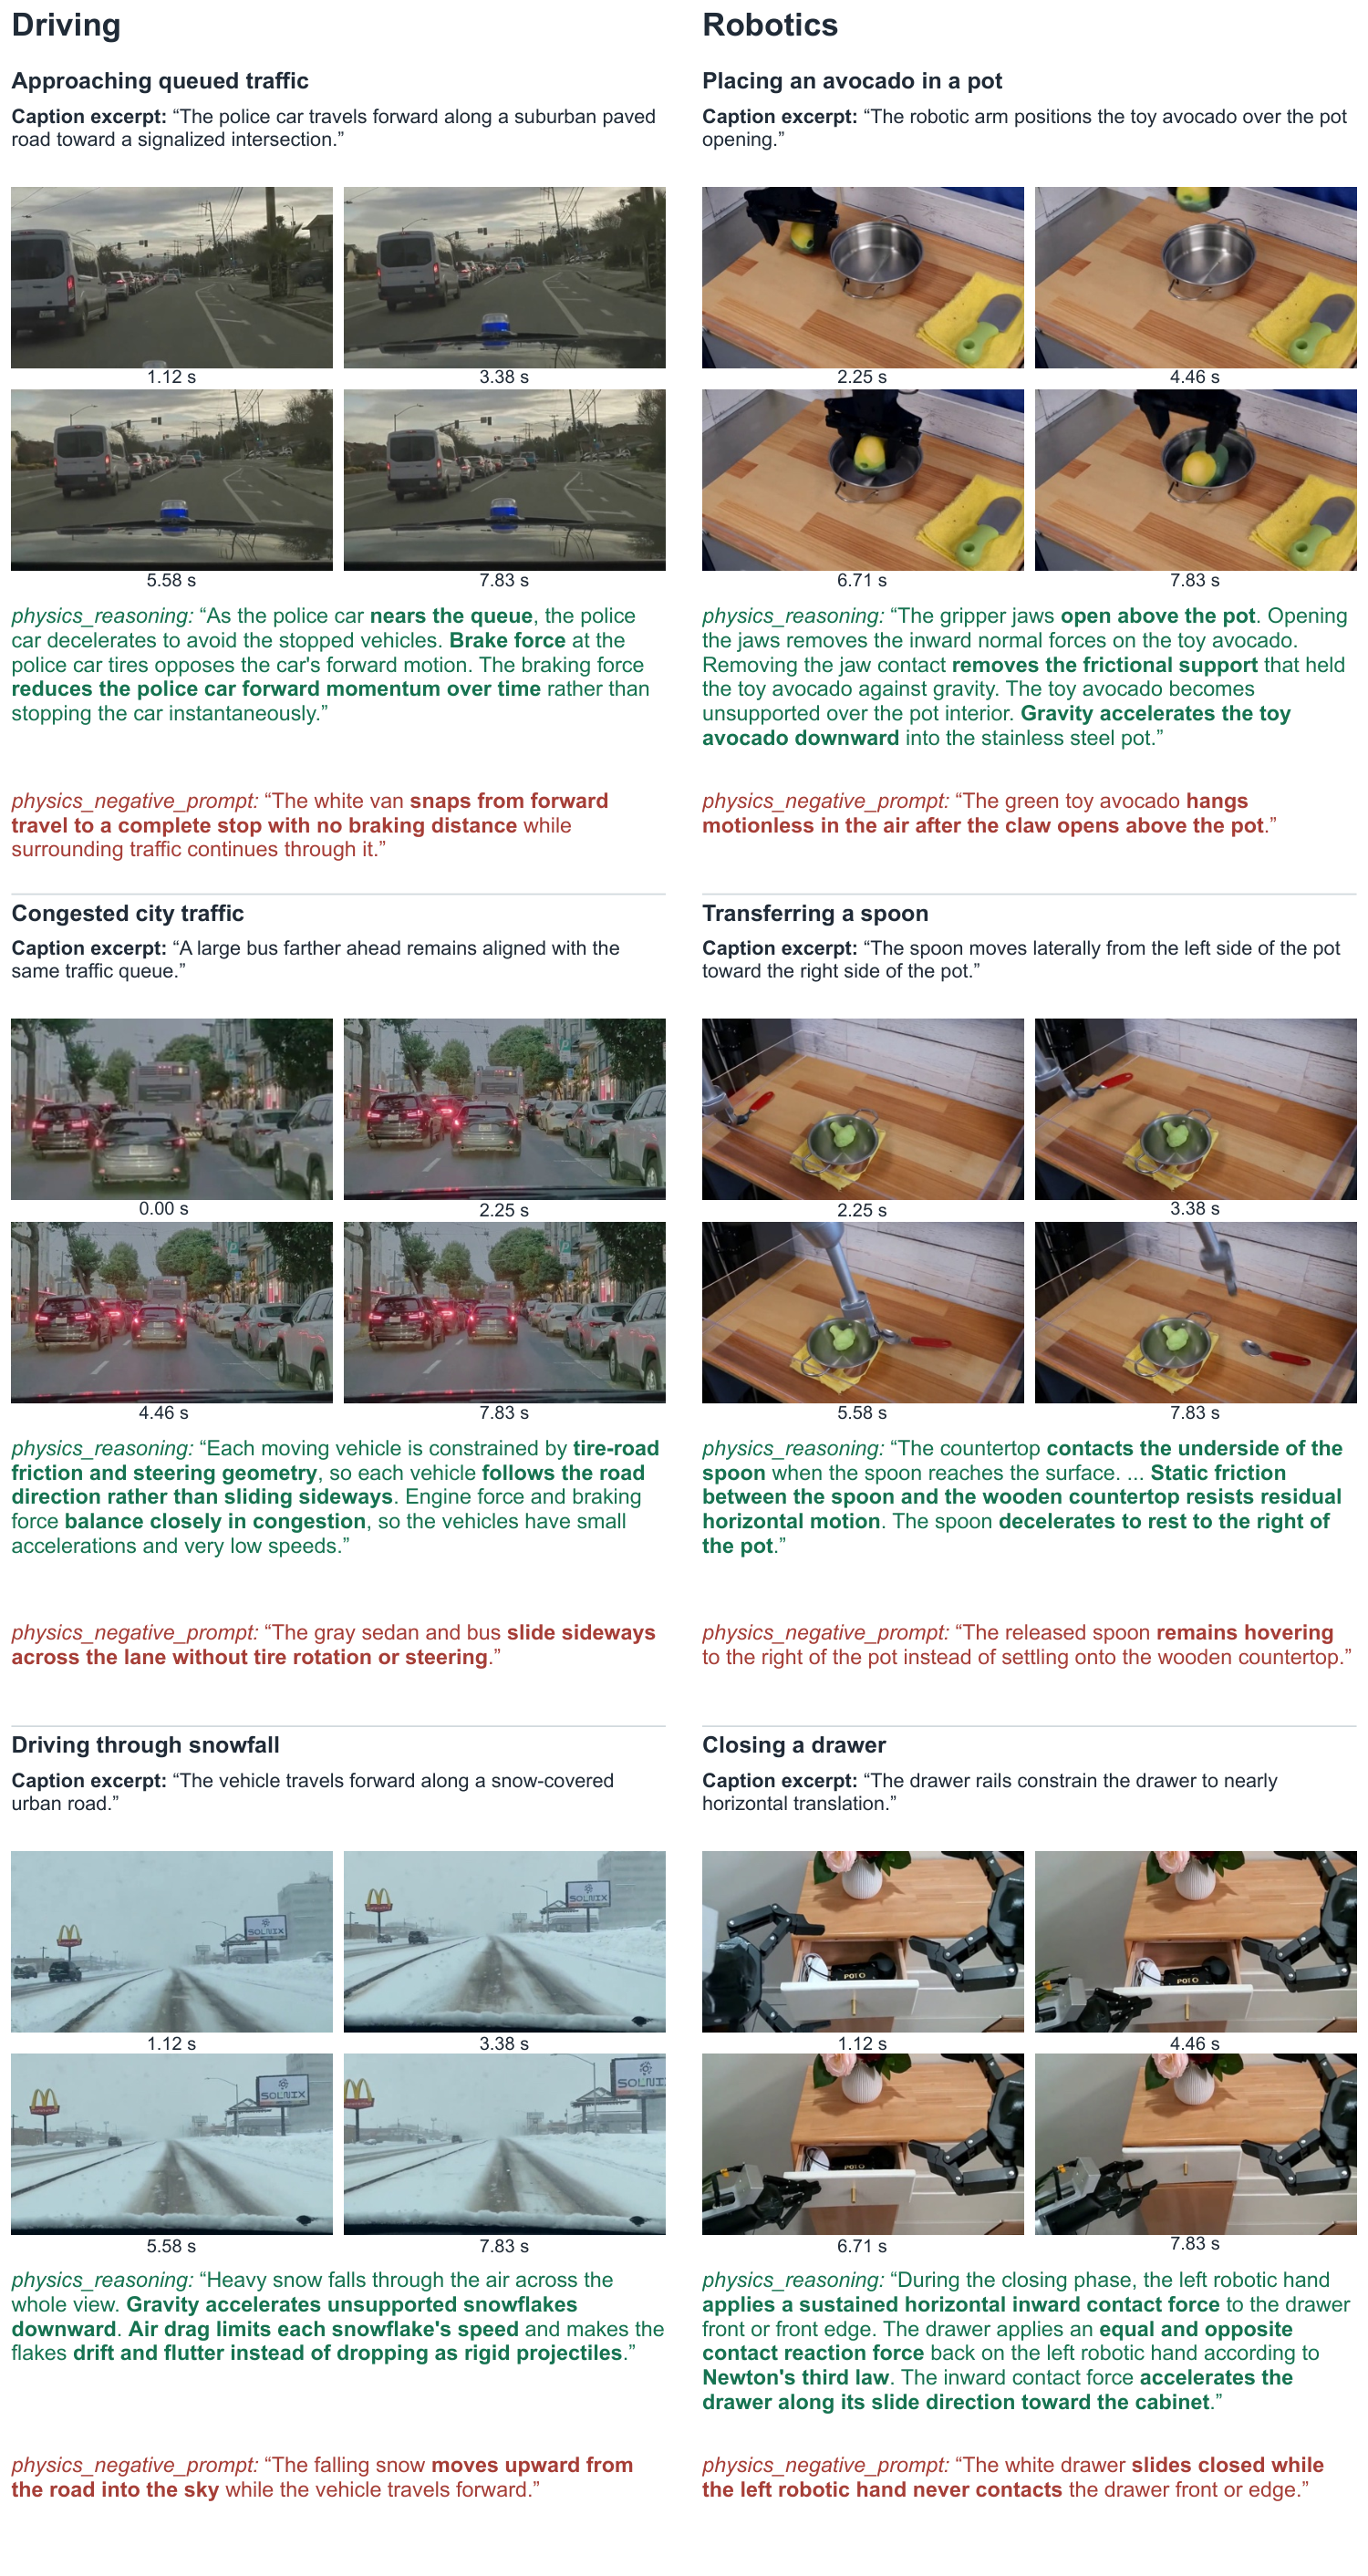
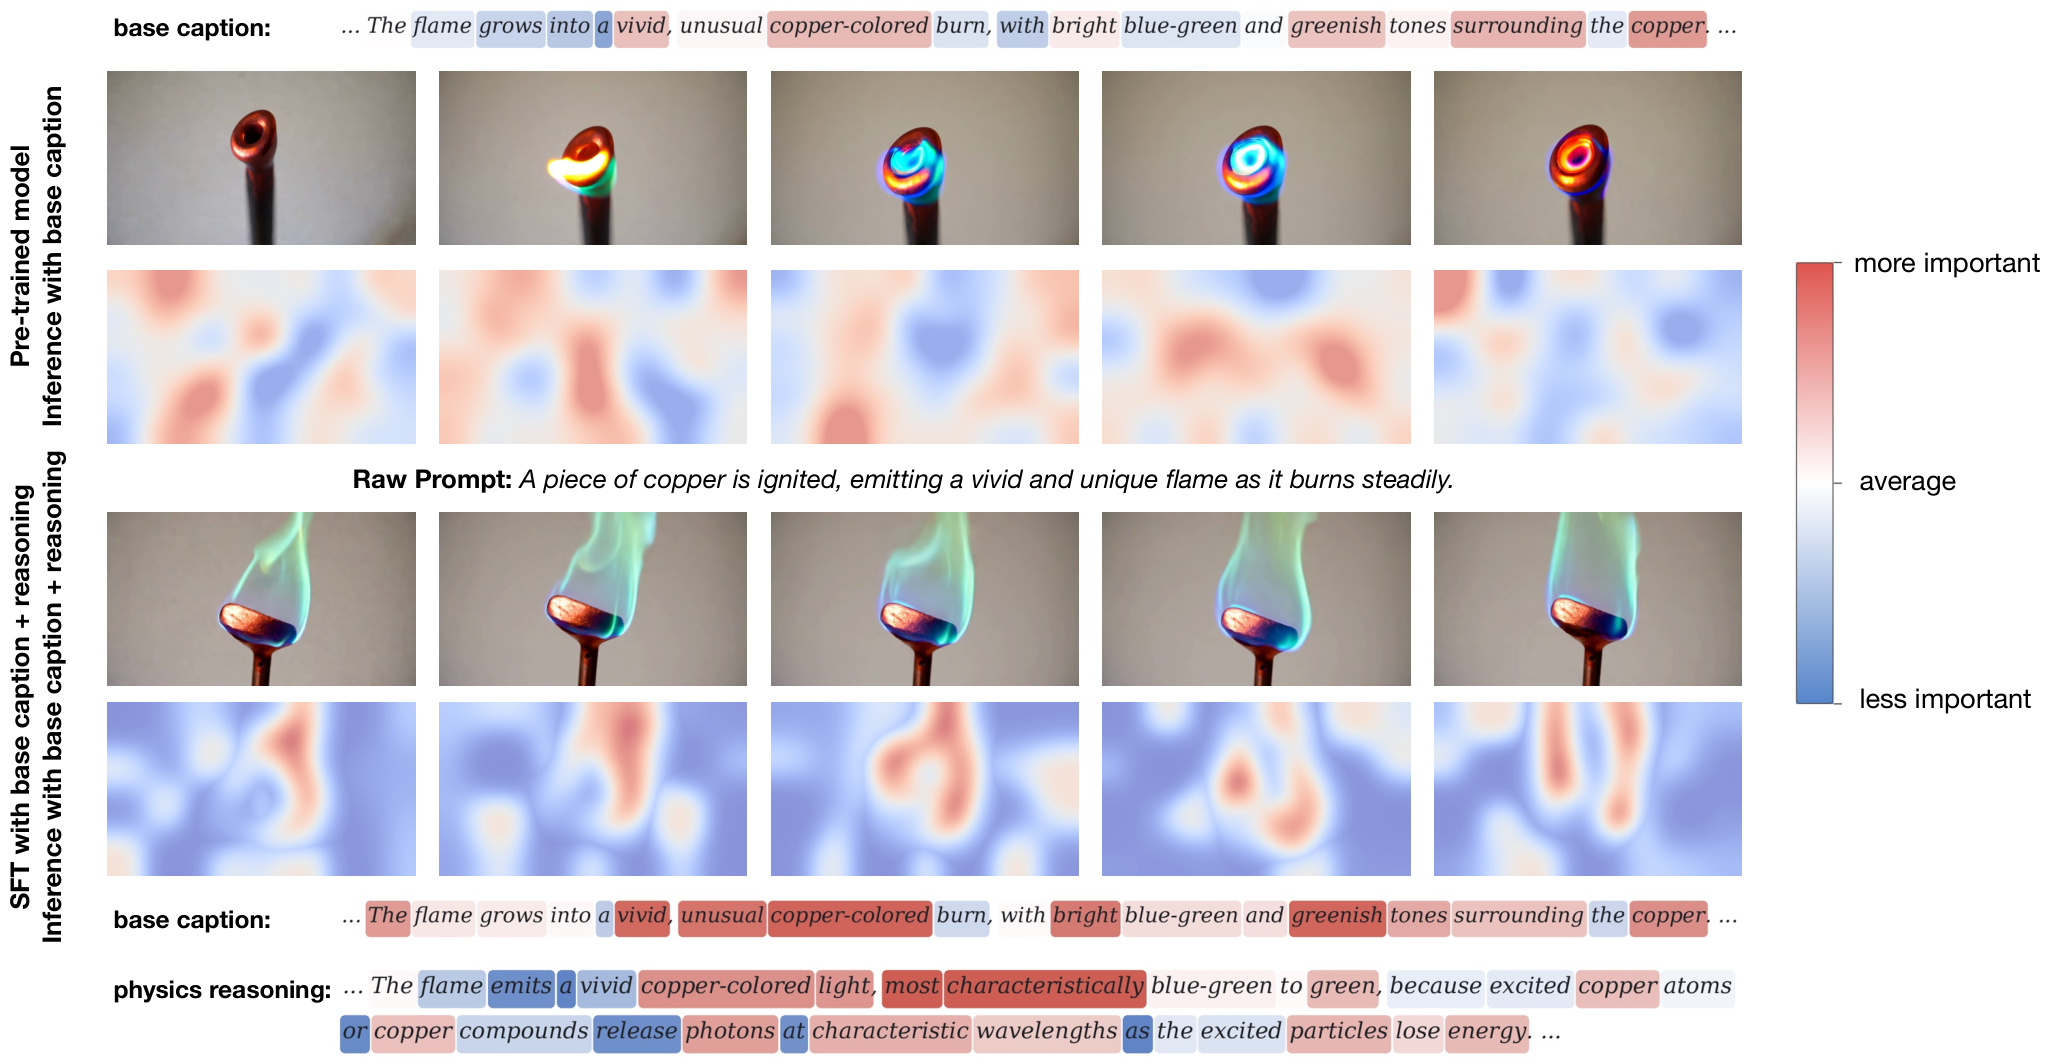
这种"实体—原因—交互—物理定律—时序演化—结果"的描述,使视频-文本训练能提供对动态过程的显式监督;推理时同一表征还用于 prompt 扩展与场景特定的负向描述(physics_negative_prompt)。
三、方法三阶段(论文核心逻辑链)
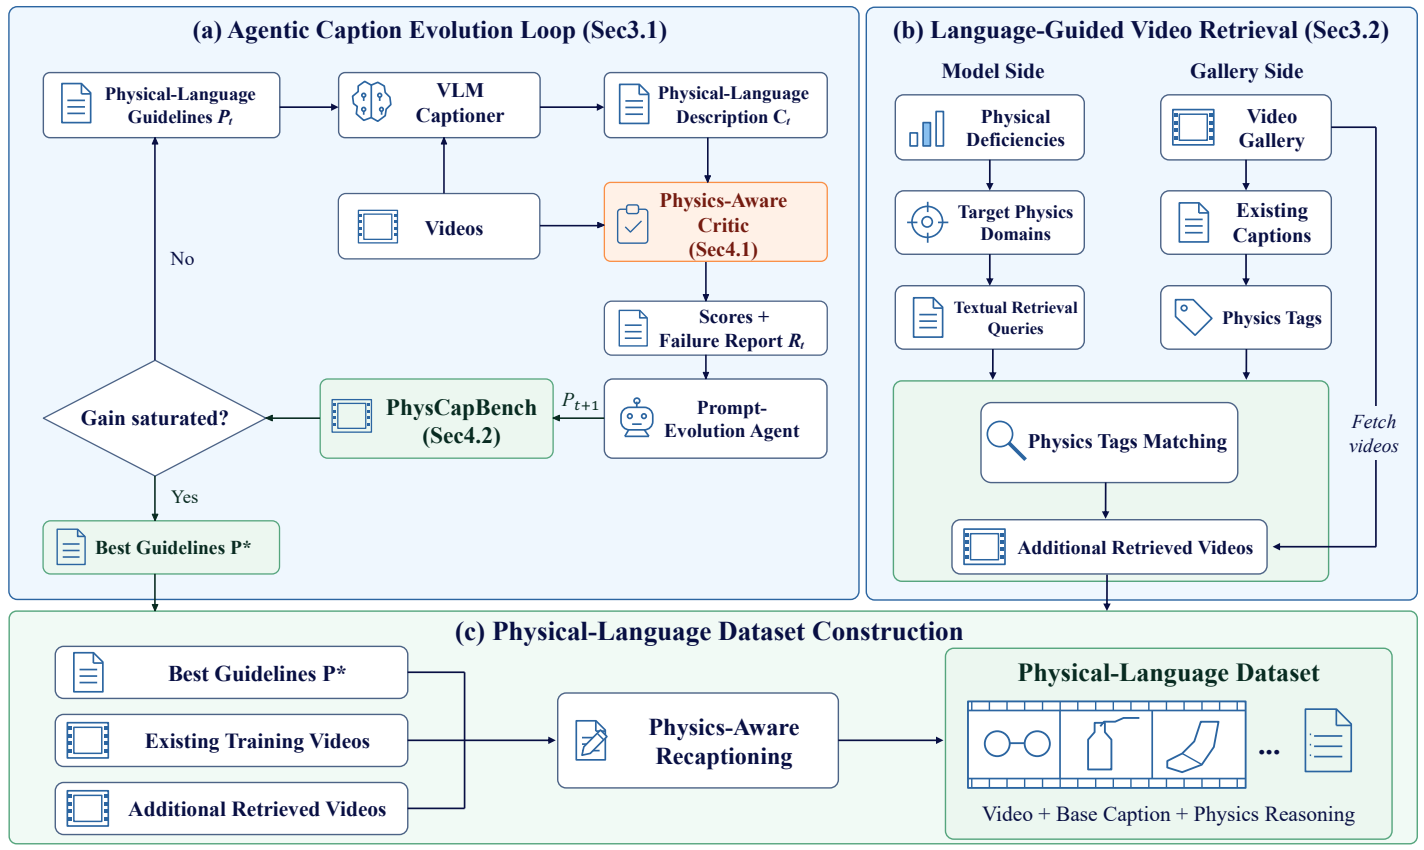
3.1 自进化 Caption 循环(Agentic Caption Evolution Loop)
关键设计:冻结 captioner 权重,只进化指令(prompt)。
- 固定 captioner(GPT-5.5)在 20 段开发集视频上用当前指令 P_t 生成描述 C_t;
- Physics-Aware Critic(Gemini-3.1-Pro 担任)从 precision 与 recall 两个维度打分并生成失败报告 R_t;
- Evolution Agent 依据 R_t 重写指令为 P_{t+1};
- 在 PhysCapBench 上验证,收益饱和即停止,选最优指令 P* 重新标注全部训练语料。
进化轨迹并非单调:F1 从迭代 1 的 78.64 → 迭代 2 反而跌至 76.28(过度保守)→ 迭代 9 达 87.82——"物理语言越多越好"不成立,可度量、可反馈的进化才是关键。下游联动:冻结 Cosmos3-Nano 权重、只换不同迭代指令生成的 caption,PhyGenBench 从 64.17 经 65.63、65.83 升至 67.29——这条"冻结权重 + 仅换 caption"的实验线与完整管线的微调成绩(61.67 → 71.04)分属不同设置,第四节有更详细的对照解读。

读这张折线图的两个要点:其一,左图的 F1 非单调(迭代 2 一度跌至 76.28)——说明"物理语言越多越好"不成立,进化需要可度量的反馈来纠偏;其二,右图证明 caption 质量与生成质量存在因果链——模型权重完全不动,仅换 caption 就带来 +3.12 的 PhyGenBench 增益,这是"语言作为有效表征"最直接的证据。
3.2 语言引导的数据检索(Language-Guided Retrieval)
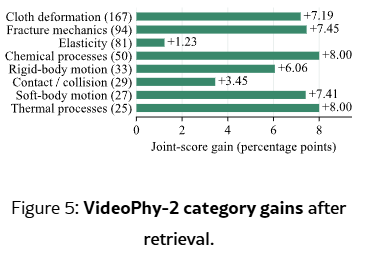
把模型失败转化为文本物理查询:诊断 agent 将生成失败归类到物理域(刚体、碰撞/流体、热过程等),形成"缺陷画像";视频库中的每条视频带物理域标签,按物理内容而非视觉相似度匹配检索,补齐训练分布短板。数据引擎最终构建 183K 物理增强视频-语言数据集(71K 来自 WISA-80K 筛选 + 112K 检索补充),检索带来的平均增益为 +3.01 分。
分类分解显示:增益最大的恰是热过程(+8.00)与化学过程(+8.00)——这两类都是"部分可观测"过程,检索数据补的正是模型从未见过的机制证据。
3.3 PhysThinker:从商业 API 到全本地蒸馏
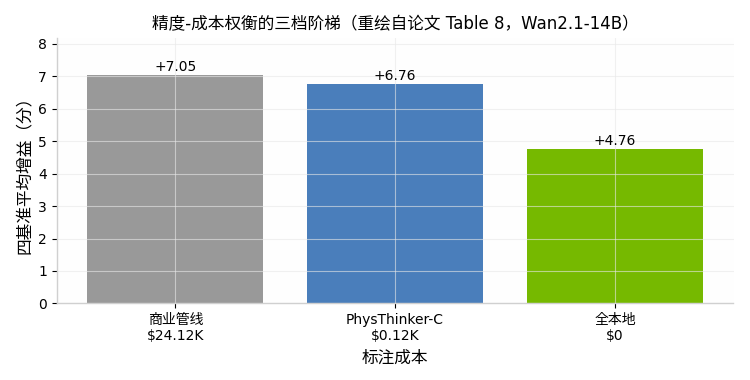
将 GPT 管线蒸馏为两个 Qwen3-VL-4B 模型:PhysThinker-C(物理 captioner)+ PhysThinker-U(prompt 扩展器),在 Wan2.1-14B 上分别对应 +7.05(约 24.12KAPI成本)→+6.76(24.12K API 成本)→ +6.76(0.12K)→ +4.76($0)三档精度-成本权衡。
工程账本:LoRA 只微调注意力投影矩阵、不改架构与训练目标,但这不等于"轻量"——整条管线依赖 GPT-5.5(caption/扩展/诊断)与 Gemini-3.1-Pro(critic)两个商业 API,标注阶段花费约 $24.12K,蒸馏后才实现成本归零。这是重工程系统,只是恰好以"语言"为界面。
四、实验结果与指标解读(数据层)
4.1 基准与子指标的物理语义:它们各自在度量什么
Physis-Lang 在四个物理基准上评测,两两分工:
- VideoPhy-2 / PhyGenBench(T2V):前者评"物理常识"(动作后果是否合理,SA 空间属性 + PC 物理常识两项 1–5 分制),后者按 Force / Light / Heat / Material 四类物理正确性评测;
- PhyGround / Physics-IQ Verified(I2V):前者评生成视频与输入图像的物理 adherence,后者将模型生成视频与真实物理实验录像对比打分。
Physics-IQ Verified 的 Final 分由四个子指标合成,各有物理含义:
|
ST(Spatiotemporal) |
物理事件的时序一致性:事件是否按正确因果顺序发生 |
29.38 → 33.59(+4.21,增幅最大) |
|
S(Spatial) |
终帧的空间合理性:物体位置、形态是否符合物理 |
51.76 → 55.38(+3.62) |
|
WS(Weighted Spatial) |
加权空间指标 |
38.92 → 42.45(+3.53) |
|
MSE |
MSE 子指标得分:物理变异归一化的逆比(r_MSE / v_MSE),方向已调为越高越好 |
40.87 → 42.23(+1.36) |
(子指标数据来源:论文 Table 1 的 Cosmos3-Nano 与 Ours 两行;MSE 列为方向归一化后的子指标分数而非原始误差,故提升为正值)
值得注意的模式:增益最大的子指标是 ST(时序一致性),最小的是 MSE(像素级保真)。语言描述恰好擅长表达"先因后果"这类事件序与因果断言,而不直接约束像素值——指标分解与"语言作为表征"的机制是自洽的,这是比总分更有信息量的证据。
4.2 PhysCapBench 的评判公式
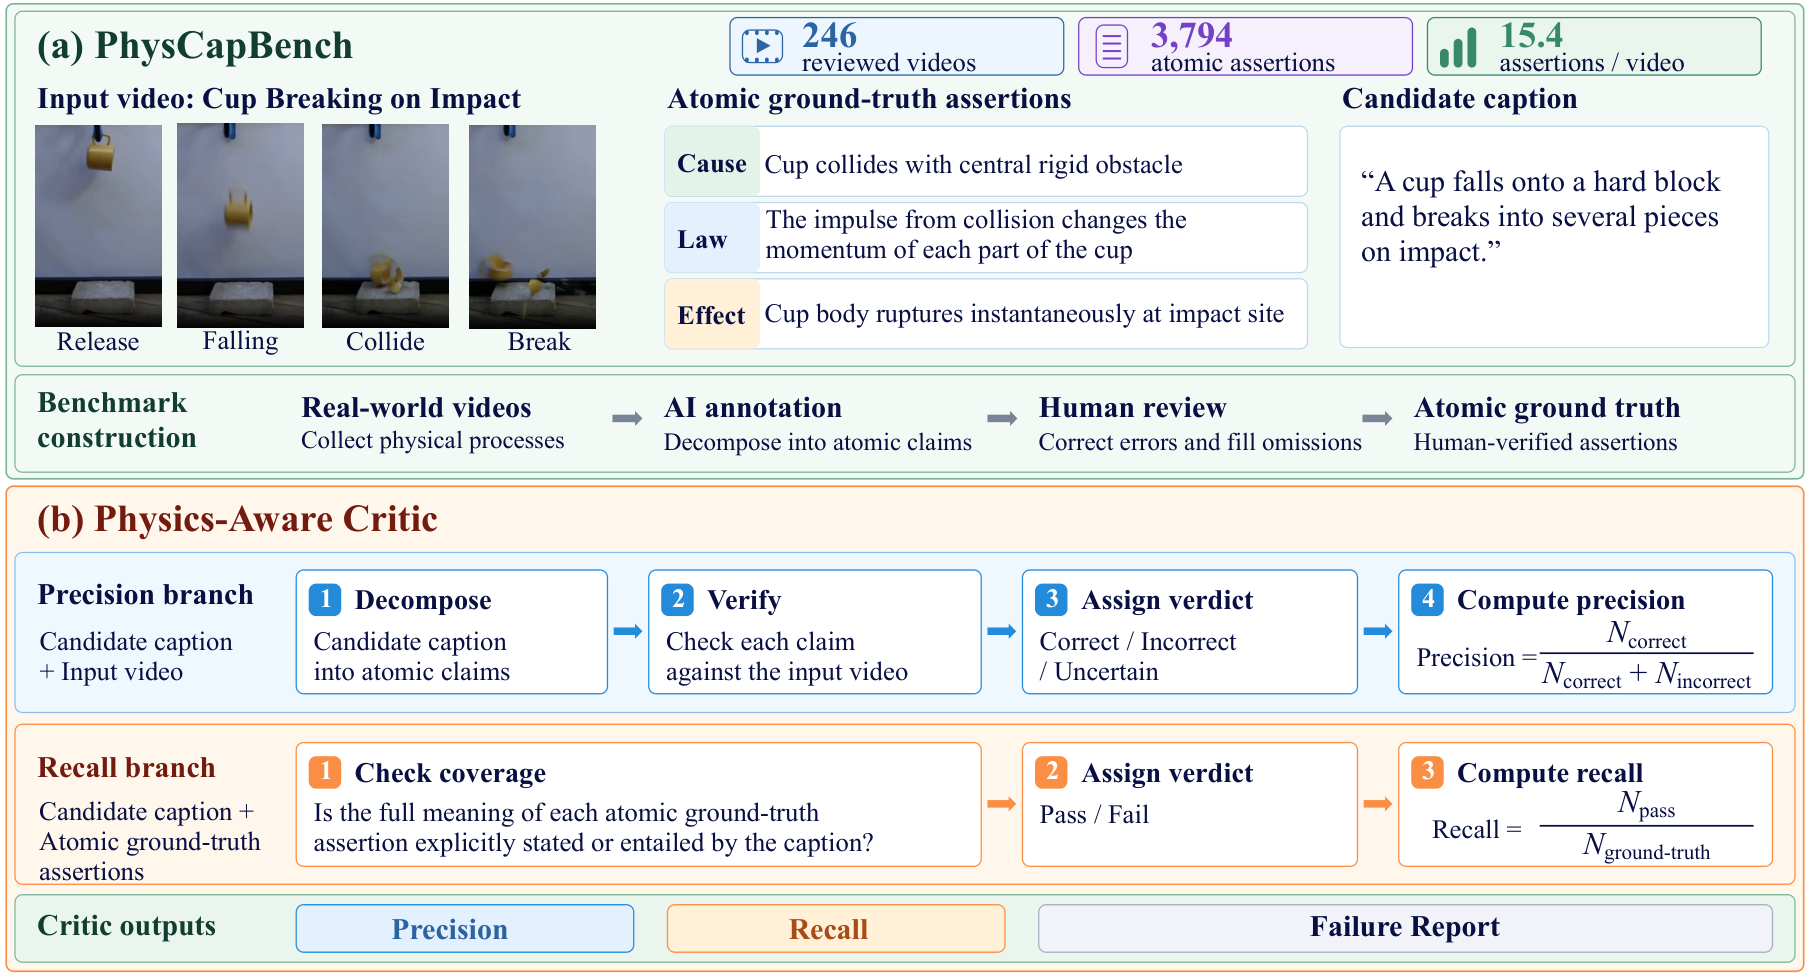
Physics-Aware Critic 的两个分支各自对应一个可计算的公式:
- 精确率(Precision)= N_correct / (N_correct + N_incorrect) —— 将候选描述分解为原子断言,逐条对照视频判定 correct / incorrect / uncertain。回答的问题是:"说的都对吗?"
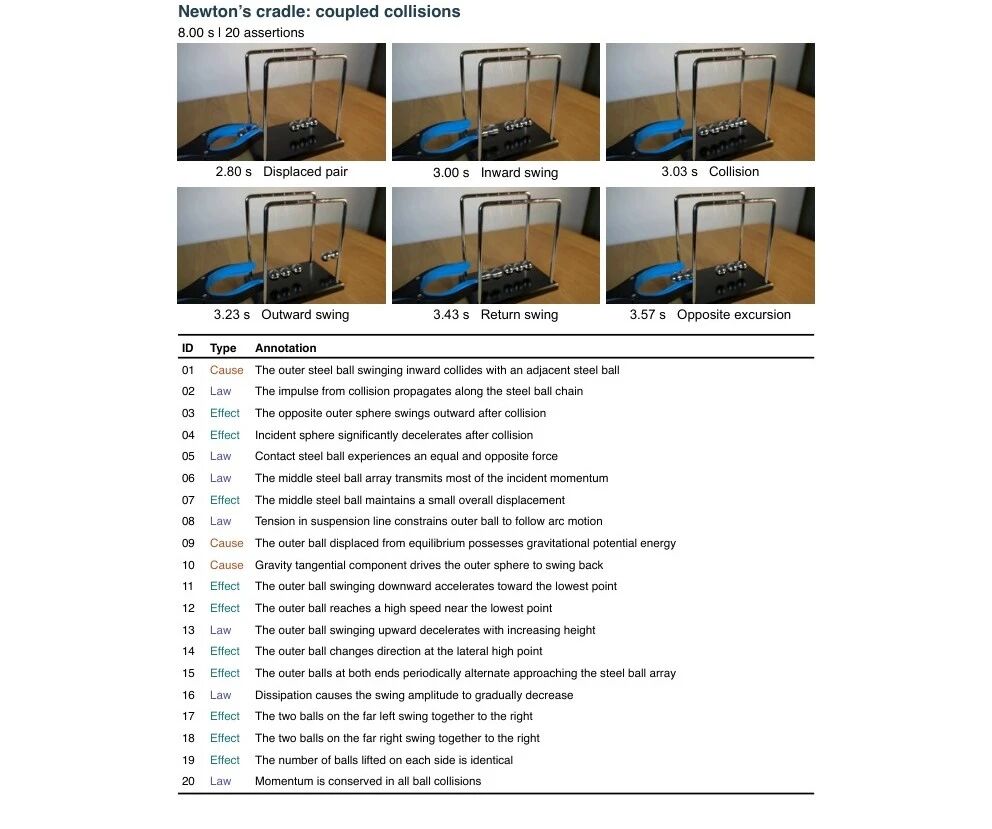
- 召回率(Recall)= N_pass / N_ground-truth —— 将候选描述与人工整理的物理断言集(每段视频平均 15.4 条,含 Cause / Law / Effect 三类)比对。回答的问题是:"该说的物理机制都说了吗?"
- F1 = 2·P·R / (P + R) —— 两者的调和平均,作为进化循环的停止准则与选优标准。
这组公式的设计哲学是用"断言覆盖率"替代传统的"caption 相似度":一个描述即使措辞与参考完全不同,只要物理含义被显式陈述或蕴含(entailed),召回就得分;反过来,再流畅的抒情只要包含一条视频不支持的主张,精确率就扣分。进化和评测因此有了共同的货币。
PhyGenBench 的分项透露了更尖锐的机制信息:Heat(热过程)一项,Cosmos3-Nano 基座与 Veo 3.1 同为 57.78(论文 Table 3),而 Physis-Lang 将其提升至 75.56(+17.78,四个分项中最大)。也就是说,热过程不是“所有模型都差、只是 Physis-Lang 稍好”,而是 Veo 3.1 与 16B 开源基座共同停滞的弱项,被 Physis-Lang 转变成了显著强项。热传导、熔化、沸腾是典型的“部分可观测”过程——画面只显示结果,机制必须靠语言补足,这正是显式因果描述的强区。
Cosmos3-Nano (16B) 总表(100 分制,GPT-5.5 统一评测):
|
PhyGenBench |
61.67 |
65.63 |
71.04 |
|
Physics-IQ Verified |
40.23 |
34.99 |
43.41 |
|
VideoPhy-2 All/Hard |
60.41/48.31 |
68.87/58.43 |
68.02/62.36 |
|
PhyGround |
65.18 |
69.24 |
69.90 |
表格注:VideoPhy-2 All 上 Veo 3.1 仍领先 0.85 分;三项领先、一项落后,不存在"全面超越"。所有分数来自 GPT-5.5 统一协议,与各模型原论文分数不可跨协议比较。且这是 16B 开源基座 + 语言工程与闭源专有模型的对比,规模与预算不对等。论文附录 G 还专门分析了评测器本身:GPT-5.5 相比原基准的离线 VLM 评测器对生成质量差异的区分度更强(下图)。
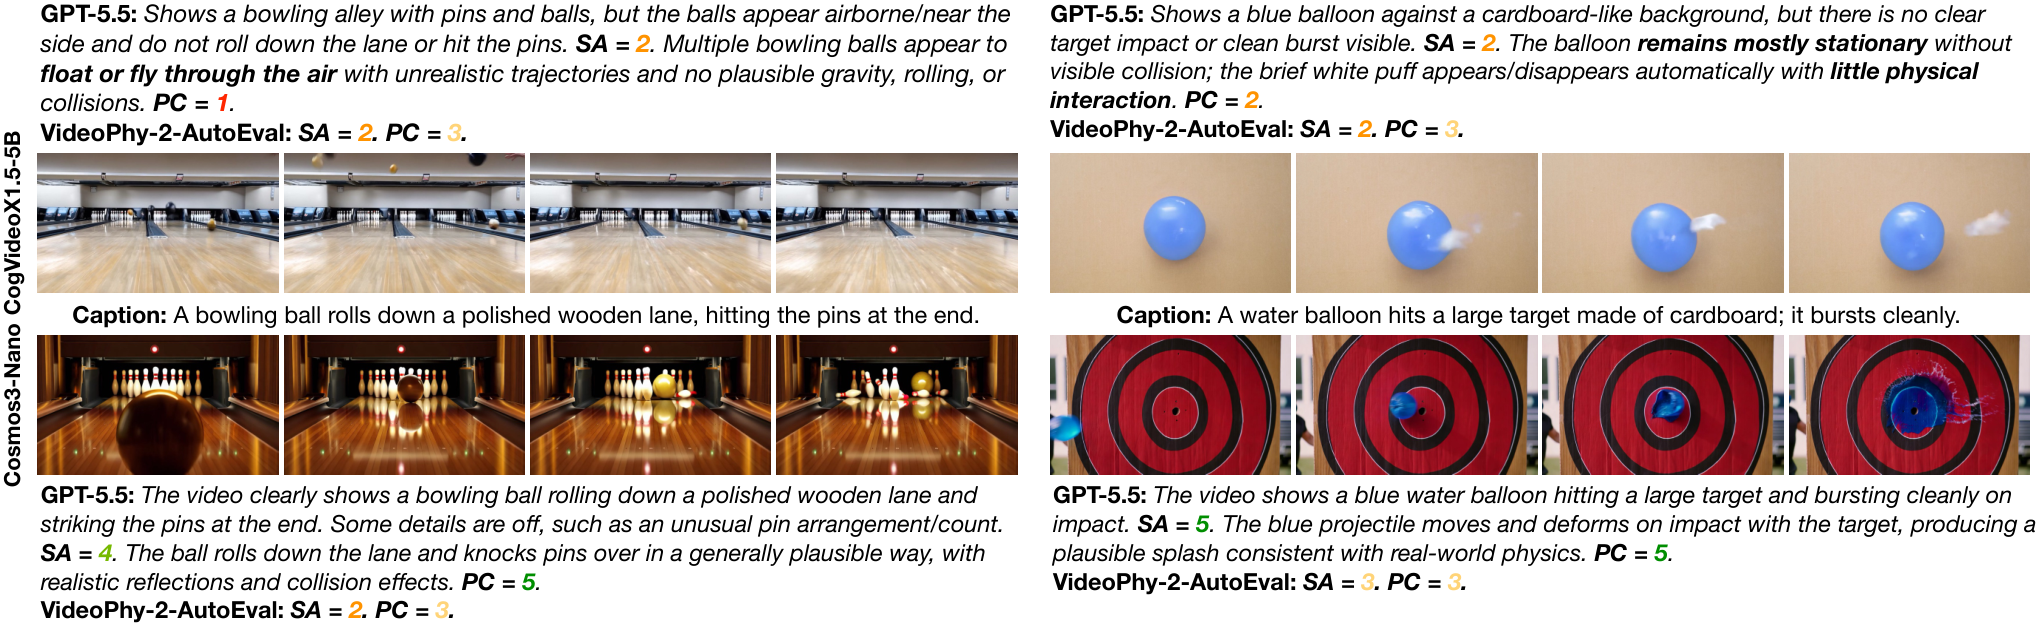
定性对比(下图,出自论文附录 C 定性示例,非正文编号图;arXiv 页面需下拉到 Appendix → C):左侧基线、右侧 Physis-Lang 在碰撞、流体、布料等典型失败场景的生成帧对比。
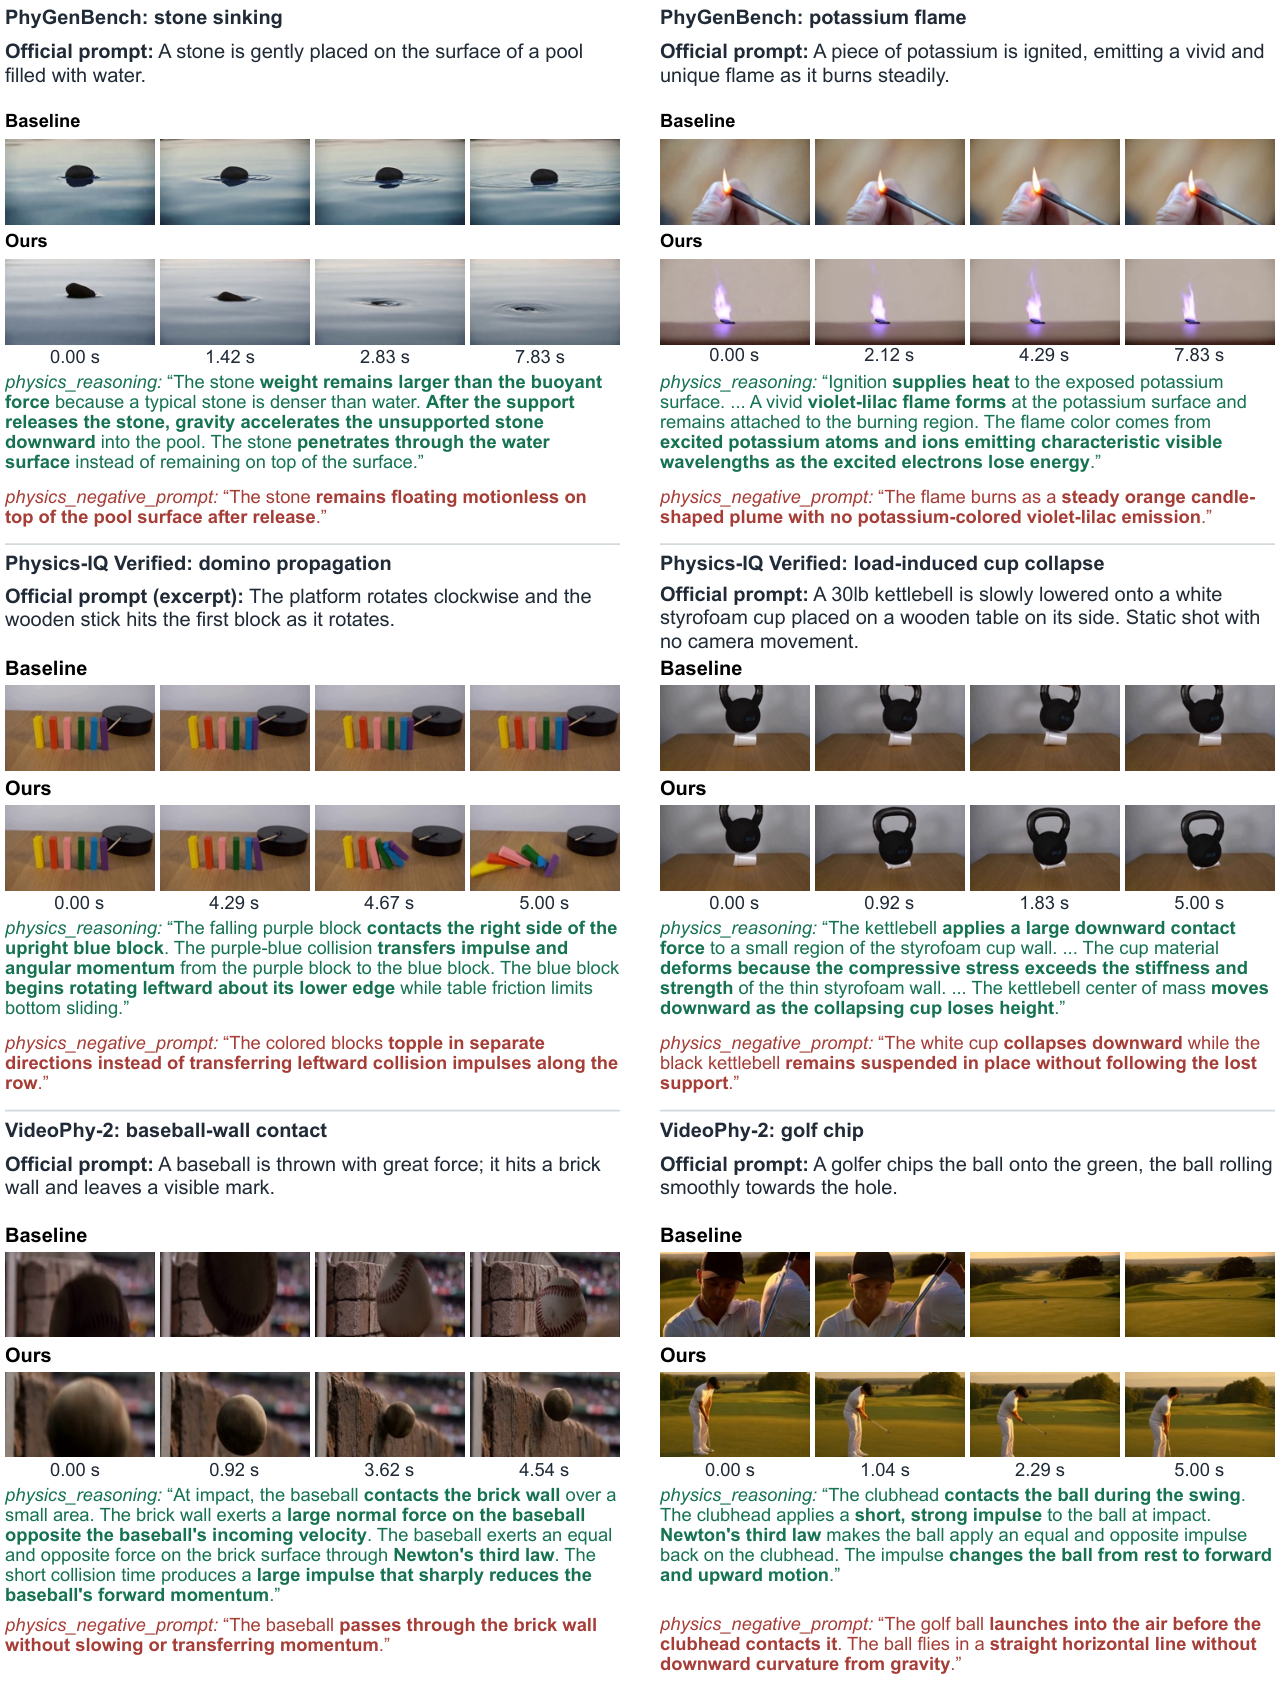
关于 3.1 节的 64.17 → 67.29:这条数字链属于"冻结权重 + 仅换 caption"的实验设置(论文 Figure 4),与本节"完整管线微调"的成绩(61.67 → 71.04)是两条不同的实验线,前者试图隔离语言质量的影响,后者报告全流程收益,两组数字不应对照阅读。
绝对值的提醒:Physics-IQ Verified 的第一名是 48.2 分——模型在受控物理实验中仍有超过一半的失败率。排名度量的是"谁更少犯错",不是"谁理解了物理"。
4.3 消融矩阵:三个组件在九格配置中的各自贡献
论文 Table 7 给出一个 3×3 的干净消融矩阵(PhyGenBench,行=微调数据,列=推理 prompt 配置):
|
无微调(零样本) |
61.67 |
63.33 |
67.29 |
|
WISA 微调 |
– |
65.62 |
68.12 |
|
WISA + 检索数据微调 |
– |
66.88 |
71.04 |
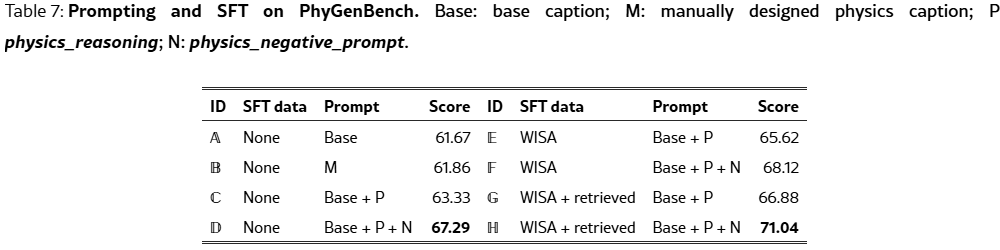
补一行论文中的对照配置:免训练 + 人工设计的物理 caption(非进化指令)得 61.86——低于进化指令的 63.33,这就是"进化优于人工设计"的直接证据。
由矩阵可直接读出三组归因:
两个交叉一致性细节值得点破:其一,免训练上限 67.29 与 Figure 4 迭代 9 caption 的分数完全吻合;其二,Table 7 的 F 行(WISA 微调 + P + N = 68.12)与 Table 6 的"WISA only"是同一个实验条件——数据检索消融里所谓"未加检索数据"的基线,就是完整消融矩阵中的 F 格,两条消融线共享同一配置,这正是多张表格之间可以交叉验证的原因。
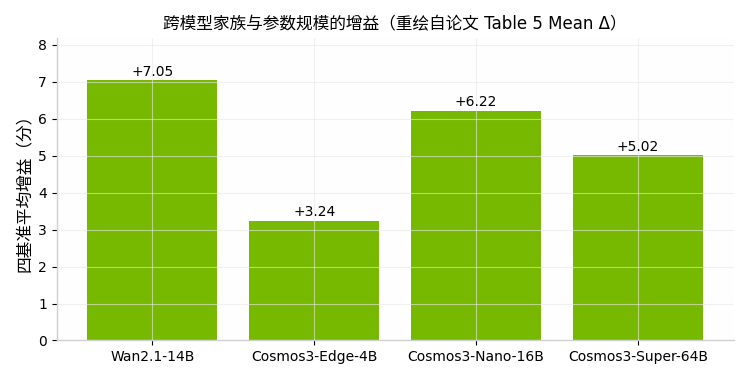
跨骨干泛化(论文 Table 5 绘制下图):Wan2.1-14B +7.05、Cosmos3-Edge-4B +3.24、Nano-16B +6.22、Super-64B +5.02——增益不随规模单调变化,16B 的 Nano 反而是 Cosmos 家族中的最大受益者,说明语言增强对"中等规模、数据饥渴"的模型边际收益最高。
成本阶梯(论文 Table 8 绘制下图):商业管线 +7.05(约 $24.12K)→ 仅蒸馏 captioner 的 PhysThinker-C 仍 +6.76(成本骤降 200 倍至 0.12K,精度仅损0.29)→全本地+4.76(0.12K,精度仅损 0.29)→ 全本地 +4.76(0,再损 2.29)。第一档的性价比拐点非常陡峭:花 $0.12K 保住 96% 的收益,是这套工程最划算的一笔。
五、争议与边界
5.1 方法论的内部边界
机制之问:物理推理,还是语义对齐? GPT-5.5 写下的"黄油因果链",本质是语言模型对常识的统计性复述——不含热传导方程,也没有流变学参数。那么增益来自哪里?至少两种解读并存:
- 物理推理假说:显式因果描述教会模型"为什么";
- 语义对齐假说:训练 caption 与测试 prompt 经同一套指令进化,分布对齐本身就能涨分。免训练 +5.62 同时支持这一假说。
论文没有设计能干净区分两者的消融,但 caption 进化实验提供了一个间接证据:迭代 1 与迭代 9 的 caption 出自同一指令家族与同一 captioner,若增益纯来自对齐,迭代 1 理应已足够,但 F1 从 78.64 涨到 87.82、下游同步从 64.17 涨到 67.29——具体物理断言产生了超出格式对齐的增量。当然,这种隔离并不完全干净(进化也可能同时改善了对齐偏好),两种假说只是被削弱、未被排除。用"物理内容相同、表述风格不同"的对照组 caption 做消融,是下一步最值得做的工作。
循环评测:LLM 裁判的固有局限。 PhysCapBench 的评分由 Gemini-3.1-Pro 判定原子断言的正确性与覆盖率——用一个大模型评判另一个大模型生成的物理描述。F1 的进化可能部分衡量的是"描述与裁判偏好的对齐"。20 段开发集的人工核验断言做了部分缓解,但裁判本身从未被独立验证。
5.2 评测基础设施的外部约束
Physics-IQ Verified 是学术第三方(慕尼黑工大等,arXiv 2606.18943,v1 提交于 2026-06-17)对原版 Physics-IQ 的审计产物。审计指出原版的三类系统性测量误差并给出三项修正(见审计论文 Figure 1):提示词质量(模板化改写消除 34.8% 的高歧义提示)、指标聚合方式(原版总分只在数据集层面定义,不同样本对总分的影响力不同;Verified 改为样本级评分——每个样本、每个子指标等权聚合,失败模式可逐样本追溯)、伪影清洗(约 30% 参考视频存在与物理现象无关的"虚假指标激活",清洗后分数才真正度量物理效应)。修正波及 57.6% 的样本,6 款模型排名变动(Kendall τ=0.46,见审计论文 Figure 2 新旧排名对比)。三点值得读者留意:审计与 Physis-Lang 发布相隔三个半月,不算"刚刚",但 Verified 作为新协议稳定性未经时间检验;它是第三方审计而非 Google 官方修订。人员与署名的事实比表面复杂:审计论文作者以慕尼黑工大、波恩大学等学术机构为主,通讯作者 Carsten T. Lüth 隶属 Google DeepMind,榜单站点页脚亦署名"ANATES LABS & DeepMind";但据社区资料(AI Wiki)转引,其提交区附有"该基准为独立第三方基准、未获 Google DeepMind 背书或验证"的声明——研究者个人参与审计与 Google 官方背书是两件事,无论声明以何种形式存在,原版的机构背书都不应自动外推到 Verified 版本;榜单收录"已评测及论文/公告中已知模型",Veo 3.1 的 34.99 分出自 Physis-Lang 论文自测而非 Google 官方提交——若头部以开源与学术提交为主,"第一"的含金量需打折看待。此外 VideoPhy-2 / PhyGenBench 换用 GPT-5.5 评测器,跨论文分数不可直接比较。
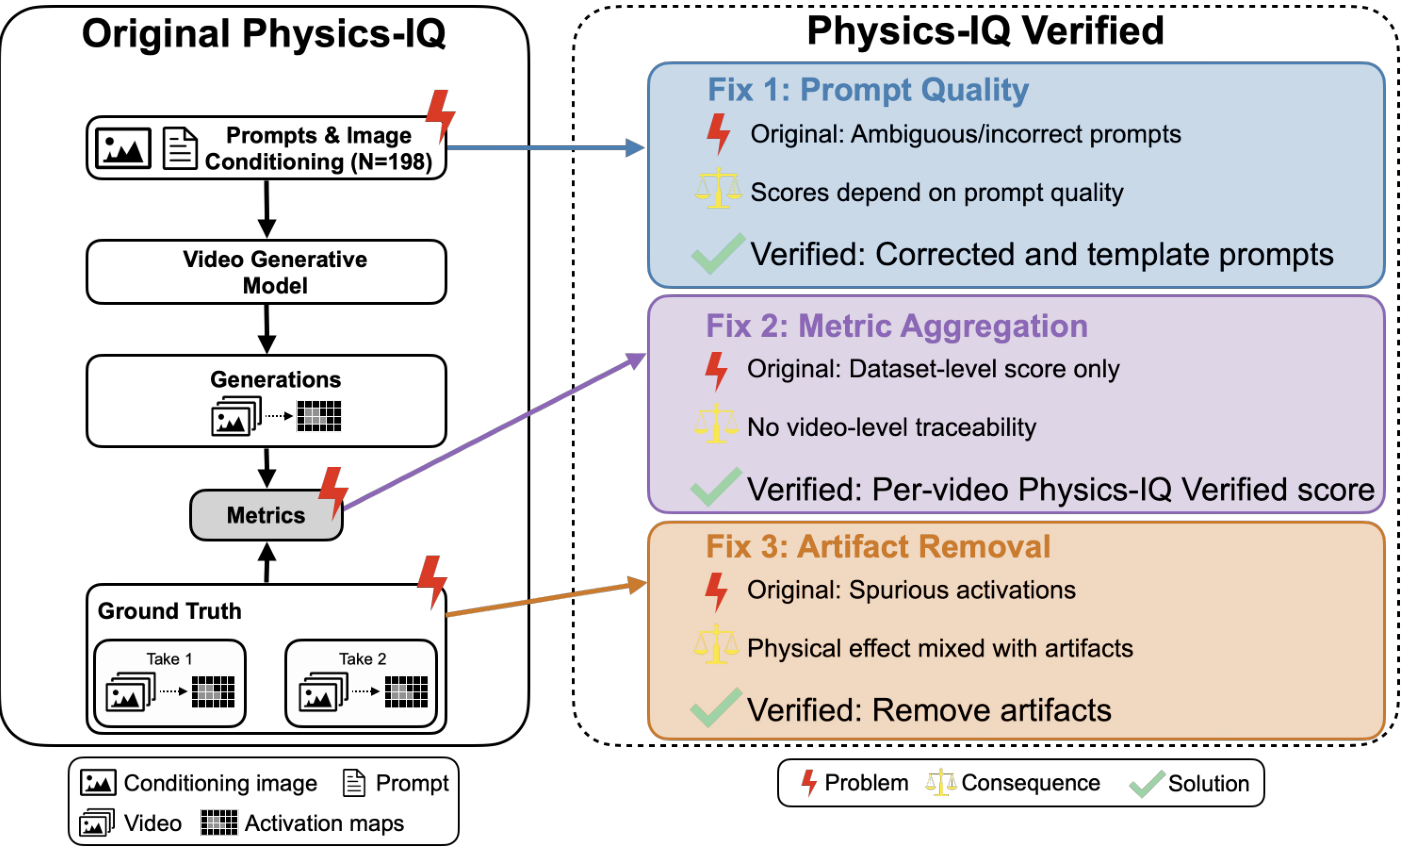

公式层面的修正本质(数据集级聚合 → 样本级等权评分)与 Figure 3/5/6 的完整解读,见文末附录:Physics-IQ Verified 的评分公式与审计细节。这里只给结论:Verified 协议让每个样本、每个子指标严格等权、失败可逐样本追溯;新旧排名差异显著(τ=0.46);"Verified 对多数模型反而是更宽松的考官"这一反转意味着——跨论文比较时,"在哪套协议上测的"比分数本身更优先需要核对。
5.3 与 PhiZero 的关系:适用边界而非胜负
PhiZero(CASIA)学习离散"物理语言" token 再接扩散解码器,其论点是自然语言太粗糙,无法承载复杂物理过渡;Physis-Lang 证明了语言在短时程、单一主导物理过程的场景中够用。但论文自己承认长时程一致性、未见物理过程泛化仍是开放问题——若语言的瓶颈恰在长时程、多体交互,那么 PhiZero 路线不是被证伪,而是被划定了适用边界。更可能的终局是层次化共存:自然语言负责全局语义与因果框架,学到的符号 token 负责语言难以精确表达的连续动力学细节。
小结:免训练增益 +5.62、完整管线 +9.37(PhyGenBench)、四项基准全部提升且跨骨干成立,这些结果足以说明"进化物理语言"是一个真实有效的工程范式;但它是排名意义上的领先,不是能力意义上的"理解物理",其机制(5.1)与评测环境(5.2)都还有未决问题。
六、结语
Physis-Lang 的贡献不是让模型"学会"了物理,而是证明:当语言被显式结构化、被可度量地进化、被贯穿到数据-训练-推理三个环节时,它作为物理知识的载体远比我们以为的更强。这是一项表征工程层面的扎实工作——它把物理合理性变成了可以"写作—评审—检索—再训练"的闭环工程问题。在"语言作为物理表征"这条具体路径上,它目前是推进得最系统的工程实践之一;它是否也是通往通用世界模拟的正确路径,取决于机制之问与表达力边界如何被未来的实验回答。
创作不易,禁止抄袭,转载请附上原文标题及其链接
附录:Physics-IQ Verified 的评分公式与审计细节
从公式看修正的本质。审计论文给出了两版评分的正式定义,符号约定:n 为样本索引(共 N 个),v_n^M 为模型生成视频与参考实拍(GT 1)在指标 M 上的取值(M ∈ {SP, ST, WS}-IoU 与 MSE),r_n^M 为"物理变异"——同一实验第二次实拍(GT 2)相对 GT 1 的基线差异,即"重拍一次真实实验"能达到的忠实度上限;c[0,1] 为截断到 [0,1] 的算子。
原版(式 1,数据集级聚合):
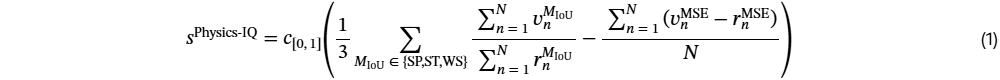
三个 IoU 指标先在全数据集上求和再相除——分母 Σ_n r_n^M 把各实验的物理变异跨样本混在了一起。由此产生两个结构性缺陷:
Verified(式 2,样本级等权):

Verified 版(式 2)改为样本级评分:每个样本内部,三项 IoU 指标各除以本样本的物理变异并截断到 [0,1],MSE 以"物理变异 / MSE"的逆比参与(保证"越大越好"方向一致),四项取 1/4 算术平均得到单样本分;总分是全部样本的算术平均。效果是每个样本、每个子指标严格等权,任何一项指标的改进都等比例反映在总分里——这正是 Physis-Lang 在 4.1 节讨论的 ST/S/WS/MSE 分项对比之所以有意义的前提:分项之间可比,才能读出"时序一致性增益最大"的机制信号。

Figure 5 传达了一个容易被忽略的反转:Verified 不是"更严的考官",对大多数模型反而是更宽松的考官——除 Wan 2.2 外所有模型换用 Verified 协议后分数上升(提示词歧义与伪影原本压低了分数),且排名发生实质重排(τ=0.46)。这意味着跨论文比较时,"在哪套 Physics-IQ 协议上测的"是比分数本身更优先需要核对的信息。

Figure 6 则量化了两类误差源各有多大:用模板化最佳实践提示词替换原版歧义提示后普遍涨分(只有 Wan 2.2 例外);而清洗伪影后所有模型的绝对分都下降、其中 weighted spatial 子指标降幅最大——原版分数中混入的"水分"有相当比例来自与物理无关的画面伪影。对 Physis-Lang 读者的一个重要推论:它的 48.2 分是在这套更干净、更难注水的协议上取得的,这在一定程度上反而增强了成绩的可信度——尽管如 5.2 开头所述,新协议自身的稳定性仍需时间检验。


参考链接
- GitHub: https://github.com/Physis-Intelligence/Physis-Lang
- Physis-Lang 论文: https://arxiv.org/abs/2609.40358
- Physics-IQ Verified 审计论文: https://arxiv.org/abs/2606.18943
- Physics-IQ Verified 榜单: https://physics-iq-verified.anates.ai/
- 项目主页: https://elemmire1.github.io/physis-lang/
- NVIDIA AI 官方推文: https://x.com/NVIDIAAI/status/2105051553845723628