三、缺点分析
缺点共 19 条,按「交付完整性 / 方法学 / 统计学 / 论证严谨性 / 可视化 / 结构编排 / 语言表述」七个层面归类。各缺点的影响度与修复成本见图 4。
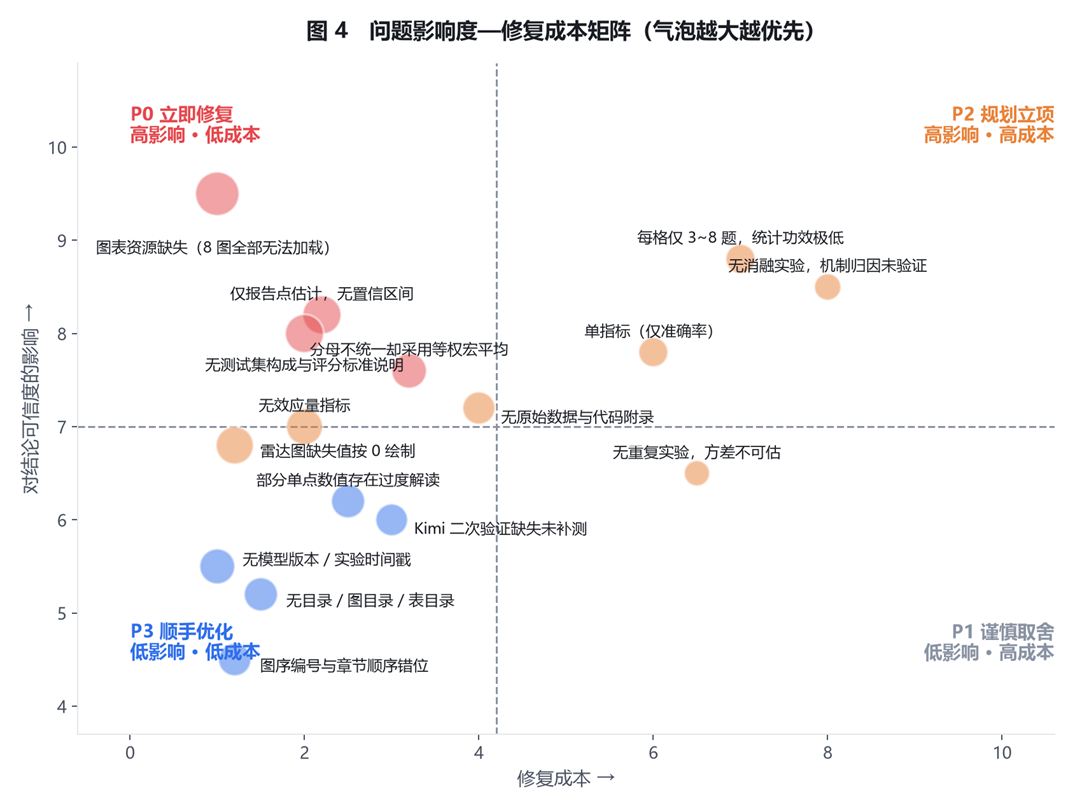
图 4 问题影响度—修复成本矩阵 (气泡越大代表越应优先处理)
3.1 交付完整性层面:存在一处硬伤
3.2 方法学层面:实验可控性缺少关键说明
缺点 2 未定义「准确率」的判定标准与测试集构成
全篇以「文献检索准确率」为核心指标,但报告从未说明:题目从何而来、每题有几个标准答案、如何判定模型返回的文献是否「正确」(严格 DOI 匹配?题录字段匹配?人工判定?)、由谁判定、判定者一致性如何。缺少这层定义,0.286 与 0.857 之间的差异就无法被读者独立检验。
缺点 3 无研究假设的事前声明,结论存在事后叙事风险
报告的所有结论都是在拿到数据之后给出的。虽然行文克制,但缺少事前假设(pre-registration)声明的情况下,「加叉验证最有效」这一结论仍存在被读者质疑为「对既有结果的合理化叙事」的空间。
缺点 4 无重复实验,模型随机性带来的方差不可估
每个条件仅测一次。大模型在同条件下存在显著输出随机性,单次测量无法区分「策略真实增益」与「采样噪声」。报告在局限中提到了这一点,但未做任何补救(如对关键单元格补做 3 次重复)。
缺点 5 无消融实验,机制归因停留在假设层
「流程机制」被作为整体评估,其内部未拆解。因此文心 X1 的 0.857 → 0.000 崩塌,报告只能给出三种并列的可能解释,无法定位到具体环节。这使最重要的发现停留在「值得进一步研究」而无法转化为工程结论。
3.3 统计学层面:缺少不确定性刻画
缺点 6 仅报告点估计,未给出任何置信区间
表 2 与表 3 给出了均值、标准差、中位数、极差、CV,但没有任何区间估计。在 n = 5 且题量仅 3~8 题的情况下,「0.820」这个数字本身的抽样不确定性可能相当大。本次评审用原数据做了 Bootstrap 重抽样(按模型重抽样 20000 次),结果显示:加叉验证增益的 95% CI 为 [+0.34, +0.81],而 prompt 工程为 [−0.13, +0.19](跨 0),流程机制为 [−0.17, +0.51](跨 0)。置信区间能一眼区分「真有效」与「等于没做」,而这正是报告目前缺失的说服力。
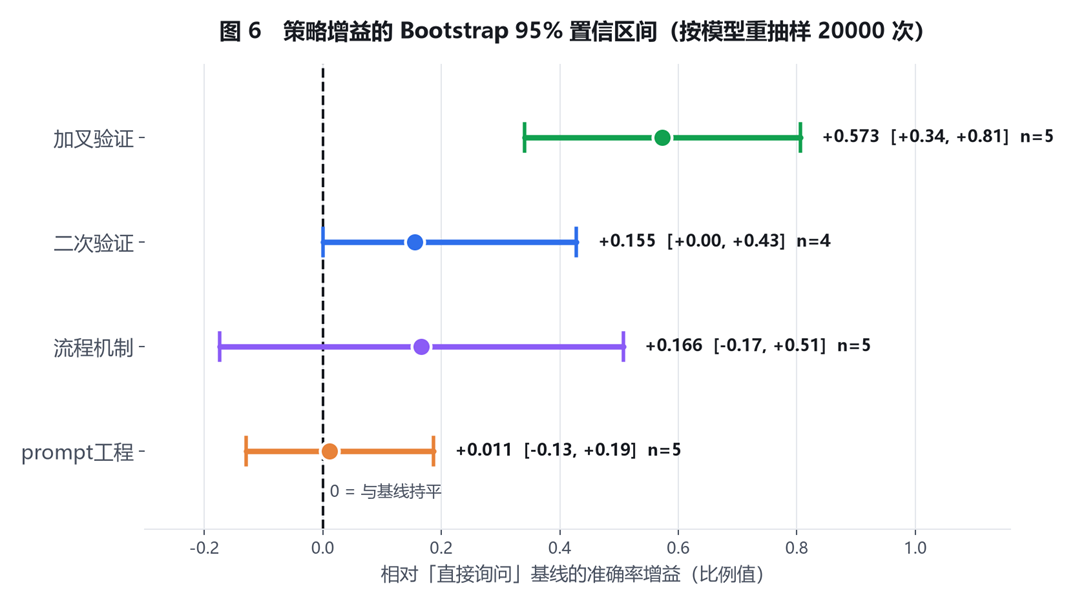
图 5 用原数据补做的 Bootstrap 95% 置信区间 (本评审补充计算,非原报告内容)
缺点 7 未报告效应量,显著性判读缺乏强度基准
符号检验只给出方向性 p 值,不含效应大小。报告虽已注明 p = 0.031 是理论下限,但没有配套的效应量指标(如配对差均值的置信区间、优势比)。结果是「显著」与「不重要」无法区分。
缺点 8 三组并行比较未做多重比较校正
报告对二次验证、流程机制、prompt 工程、加叉验证分别做了四次符号检验,但未做 Holm 或 Benjamini–Hochberg 校正。在探索性分析中这尚可接受,但结论章节使用了「显著改进」「被证伪」等强表述,理应对应校正后的显著性。
缺点 9 分母不统一的处理方式未被纳入误差讨论
报告声明采用等权宏平均,处理方式本身是透明的;但「同一格内 3 题与 8 题的估计精度不同」这一事实并未在任何误差指标中体现。标准差把 3 题格的粗估与 8 题格的细估同等对待,会系统性高估跨模型离散度。
缺点 10 「等权宏平均」与「加权平均」两套口径并存却未对照
报告同时给出了跨策略均值(行均值)与跨模型均值(列均值),并在表 3 中比较二者。但由于缺失值剔除规则不同,两套均值并非严格可比。报告未提示这一隐含不一致。
3.4 论证严谨性层面:个别表述强于证据
缺点 11 部分结论措辞的强度超过了 n = 5 的证据水平
如「prompt 工程是本实验中被证伪的干预方式」「唯一可以写进生产流程的策略」「唯一具备工程化落地条件的策略」。这些措辞隐含普遍性断言,而实际证据来自 5 个模型、每格个位数题量的单次观测。合并使用「在本实验条件下」「在本测试集上」等限定语会更严谨。
缺点 12 对个别单点数值的机制解释存在过度解读风险
例如「腾讯元宝需流程机制支撑」「文心 X1 的崩塌是结构性的机制失效」等判断,都建立在单一观测点上。报告自己也声明「不宜过度解读个位数差异」,但在机制解释部分又对单点差异给出了确定性因果解释,前后标准不完全一致。
3.5 可视化层面:图表规范不够严格
缺点 13 图序编号与章节出现顺序错位
正文中图表出现顺序为:图 1、图 2(第 2 章)→ 图 7(第 2 章)→ 图 8(第 3 章)→ 图 6(第 3 章)→ 图 4(第 4 章)→ 图 3(第 4 章)→ 图 5(第 5 章)。编号与出现顺序不匹配,读者按图号查找时会产生跳转困惑。图注本身标注的章节归属是正确的,说明是编号排序时未按章节重排。
缺点 14 雷达图对缺失值按 0 绘制,视觉上放大劣势
图 6 的雷达图将 Kimi 缺失的「二次验证」按 0 绘制。虽然图注中有说明,但图形本身未做任何视觉区分(如虚线轴、缺口或灰化),读者第一眼接收到的仍是「Kimi 在二次验证下为 0」这一错误印象,而实际是数据缺失。
缺点 15 排名图使用标准差误差棒而非置信区间,且未标注样本量
图 2 的误差棒为标准差,反映的是「模型间离散度」而非「均值估计的不确定性」,两者含义完全不同。在 n = 5 的语境下,读者极易把长误差棒误读为「这个策略的均值不可靠」。同时图中未标注每组的 n(二次验证为 4,其余为 5)。
缺点 16 图表缺少数值标签与关键标注
图 3 轨迹图未标出峰值点与倒塌点的具体数值,图 5 热力图未在单元格内标注数值,图 4 增益图未标出正负分界统计。在软件中放大可读,但一图单独截图用于汇报时信息即不完整。
3.6 结构编排层面:缺少导航与元信息
缺点 17 无目录、无图目录、无表目录,长文档导航缺失
全文 10 个章节、约 4.3 万字节,属于中等篇幅报告,但页面顶部没有任何目录锚点。读者必须全程滚动查找。对一份希望被反复引用的分析报告而言,导航成本偏高。
缺点 18 缺少文档元信息:版本号、生成日期、作者、变更记录
页脚仅注明数据来源与统计方法,未标注报告版本、生成时间、作者与修订记录。作为可能被迭代引用的分析文档,缺少这些信息会影响后续追踪。
缺点 19 章节篇幅失衡与内容交叉
第 2 章(策略维度)与第 4 章(增益归因)在证据上高度重叠 —— 二者的核心论据都是「各策略相对基线的增益」,只是组织形式不同(排名 vs 分解)。这造成读者在第 4 章读到大量重复信息,而真正新的(符号检验、过度校正机制)被稀释。此外「局限」一章被放在「建议」之后,读者要先接受建议、再读局限,容易产生「建议已被削弱」的观感。
四、问题清单总表
下表汇总全部 19 条缺点,标注严重度(★ 越多越严重)与建议处理优先级(P0 立即修 / P1 尽快修 / P2 规划修 / P3 可择机)。
|
# |
层面 |
问题 |
严重度 |
优先级 |
|
1 |
交付完整性 |
★★★★★ |
P0 |
|
|
2 |
方法学 |
未定义准确率判定标准与测试集构成 |
★★★★ |
P1 |
|
3 |
方法学 |
无研究假设事前声明 |
★★ |
P2 |
|
4 |
方法学 |
无重复实验,随机性方差不可估 |
★★★ |
P2 |
|
5 |
方法学 |
无消融实验,机制归因无法定位 |
★★★★ |
P2 |
|
6 |
统计学 |
仅点估计,无任何置信区间 |
★★★★ |
P1 |
|
7 |
统计学 |
无效应量指标 |
★★★ |
P1 |
|
8 |
统计学 |
四次并行检验未做多重比较校正 |
★★ |
P1 |
|
9 |
统计学 |
题量差异未反映在误差尺度中 |
★★★ |
P1 |
|
10 |
统计学 |
行均值 / 列均值口径隐含不一致未提示 |
★★ |
P1 |
|
11 |
论证严谨性 |
「被证伪」「唯一」等措辞强于证据 |
★★★ |
P1 |
|
12 |
论证严谨性 |
单点数值的机制解释与自身告诫不一致 |
★★★ |
P1 |
|
13 |
可视化 |
图序编号与章节出现顺序错位 |
★★ |
P0 |
|
14 |
可视化 |
雷达图缺失值按 0 绘制且无视觉区分 |
★★★ |
P1 |
|
15 |
可视化 |
误差棒用标准差且未标注样本量 |
★★★ |
P1 |
|
16 |
可视化 |
图表缺数值标签与关键标注 |
★★ |
P2 |
|
17 |
结构编排 |
无目录 / 图目录 / 表目录 |
★★ |
P0 |
|
18 |
结构编排 |
缺版本号、日期、作者等元信息 |
★★ |
P1 |
|
19 |
结构编排 |
第 2 章与第 4 章内容重叠、局限章位置靠后 |
★★★ |
P2 |
五、数据复算验证
评审过程中对报告全部关键统计量做了独立复算,结果如下。
|
策略 |
原报告均值 |
评审复算 |
是否一致 |
原报告标准差 |
复算标准差 |
|
直接询问 |
0.247 |
0.2471 |
一致 |
0.308 |
0.3082 |
|
二次验证 |
0.464 |
0.4643 |
一致 |
0.407 |
0.4073 |
|
prompt工程 |
0.258 |
0.2583 |
一致 |
0.354 |
0.3540 |
|
加叉验证 |
0.820 |
0.8200 |
一致 |
0.249 |
0.2490 |
|
流程机制 |
0.413 |
0.4133 |
一致 |
0.296 |
0.2961 |
|
复算结论:算术无误,问题出在推断链 全部 5 个策略的均值与标准差复算结果与原报告完全一致(保留三位小数),说明报告的描述统计计算是准确、可复现的。同时也验证了 CV 的计算无误(加叉验证 CV = 0.249 / 0.820 = 0.304 ≈ 0.30)。 因此本报告的问题不在算术层面,而在推断层面:数据算得对,但从「点估计」到「结论」之间缺失了不确定性刻画、效应量与稳健性检验这三个必要环节。这正是第五章改进建议的重点方向。 |
六、总结与处置建议
6.1 优势总结
这份报告最值得肯定的是三点:
- 叙事结构能力强。它把「24 个数字」组织成了一个有主线、有转折、有反直觉发现的完整论证,而不是流水账式的结果罗列。
- 对自身局限的诚实度罕见。六条局限成表、逐条分析影响并给出改进方向,还主动为显著性结果降温,这在实验报告写作中属于高水准的学术自觉。
- 结论向工程决策的转化能力突出。「强模型做减法、弱模型做加法」这类原则,是把统计结论翻译成可执行规则的好范例。
6.2 劣势总结
核心不足可归纳为「两条短腿」:
- 第一条短腿:统计推断深度不足。只有点估计 + 方向性检验,没有区间估计、效应量和多重比较校正,使「有多可信」这一问题无法回答。
- 第二条短腿:可复现性基础设施缺失。没有题级原始数据、判定标准、代码、模型版本与时间戳,读者无法独立复现或延续这项实验。
6.3 处置建议:三类问题三种处理方式
|
类别 |
问题编号 |
处置方式 |
理由 |
|
必须立即修 |
1、13、17 |
本周内完成 |
交付级缺陷:图表不显示、编号混乱、无目录。修复成本极低,不修则严重影响专业度。 |
|
建议尽快修 |
2、6、7、8、9、11、14、15、18 |
两周内完成 |
直接决定结论可信度与图表规范性的问题,多数只需补充分析或调整呈现方式,不需要重做实验。 |
|
规划排期修 |
3、4、5、10、12、16、19 |
下阶段实验一并处理 |
涉及补做实验(消融、重复)或重排结构,宜与下一轮实验合并规划。 |
6.4 总评
|
评审结论 这份实验分析报告在「把结果讲清楚、把结论给到位、把局限认下来」三件事上做得相当出色,综合评分 7.4 / 10。它当前的主要短板集中在工程化的可交付性与统计推断的完备性上,而非研究设计或论证逻辑本身 —— 这是一个「补课」而非「重做」的评价。 若能补上图表资源、置信区间与效应量、测试集与判定标准说明这三块,本报告将具备对外正式发布(投稿、汇报、开源)的水准。 |