/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
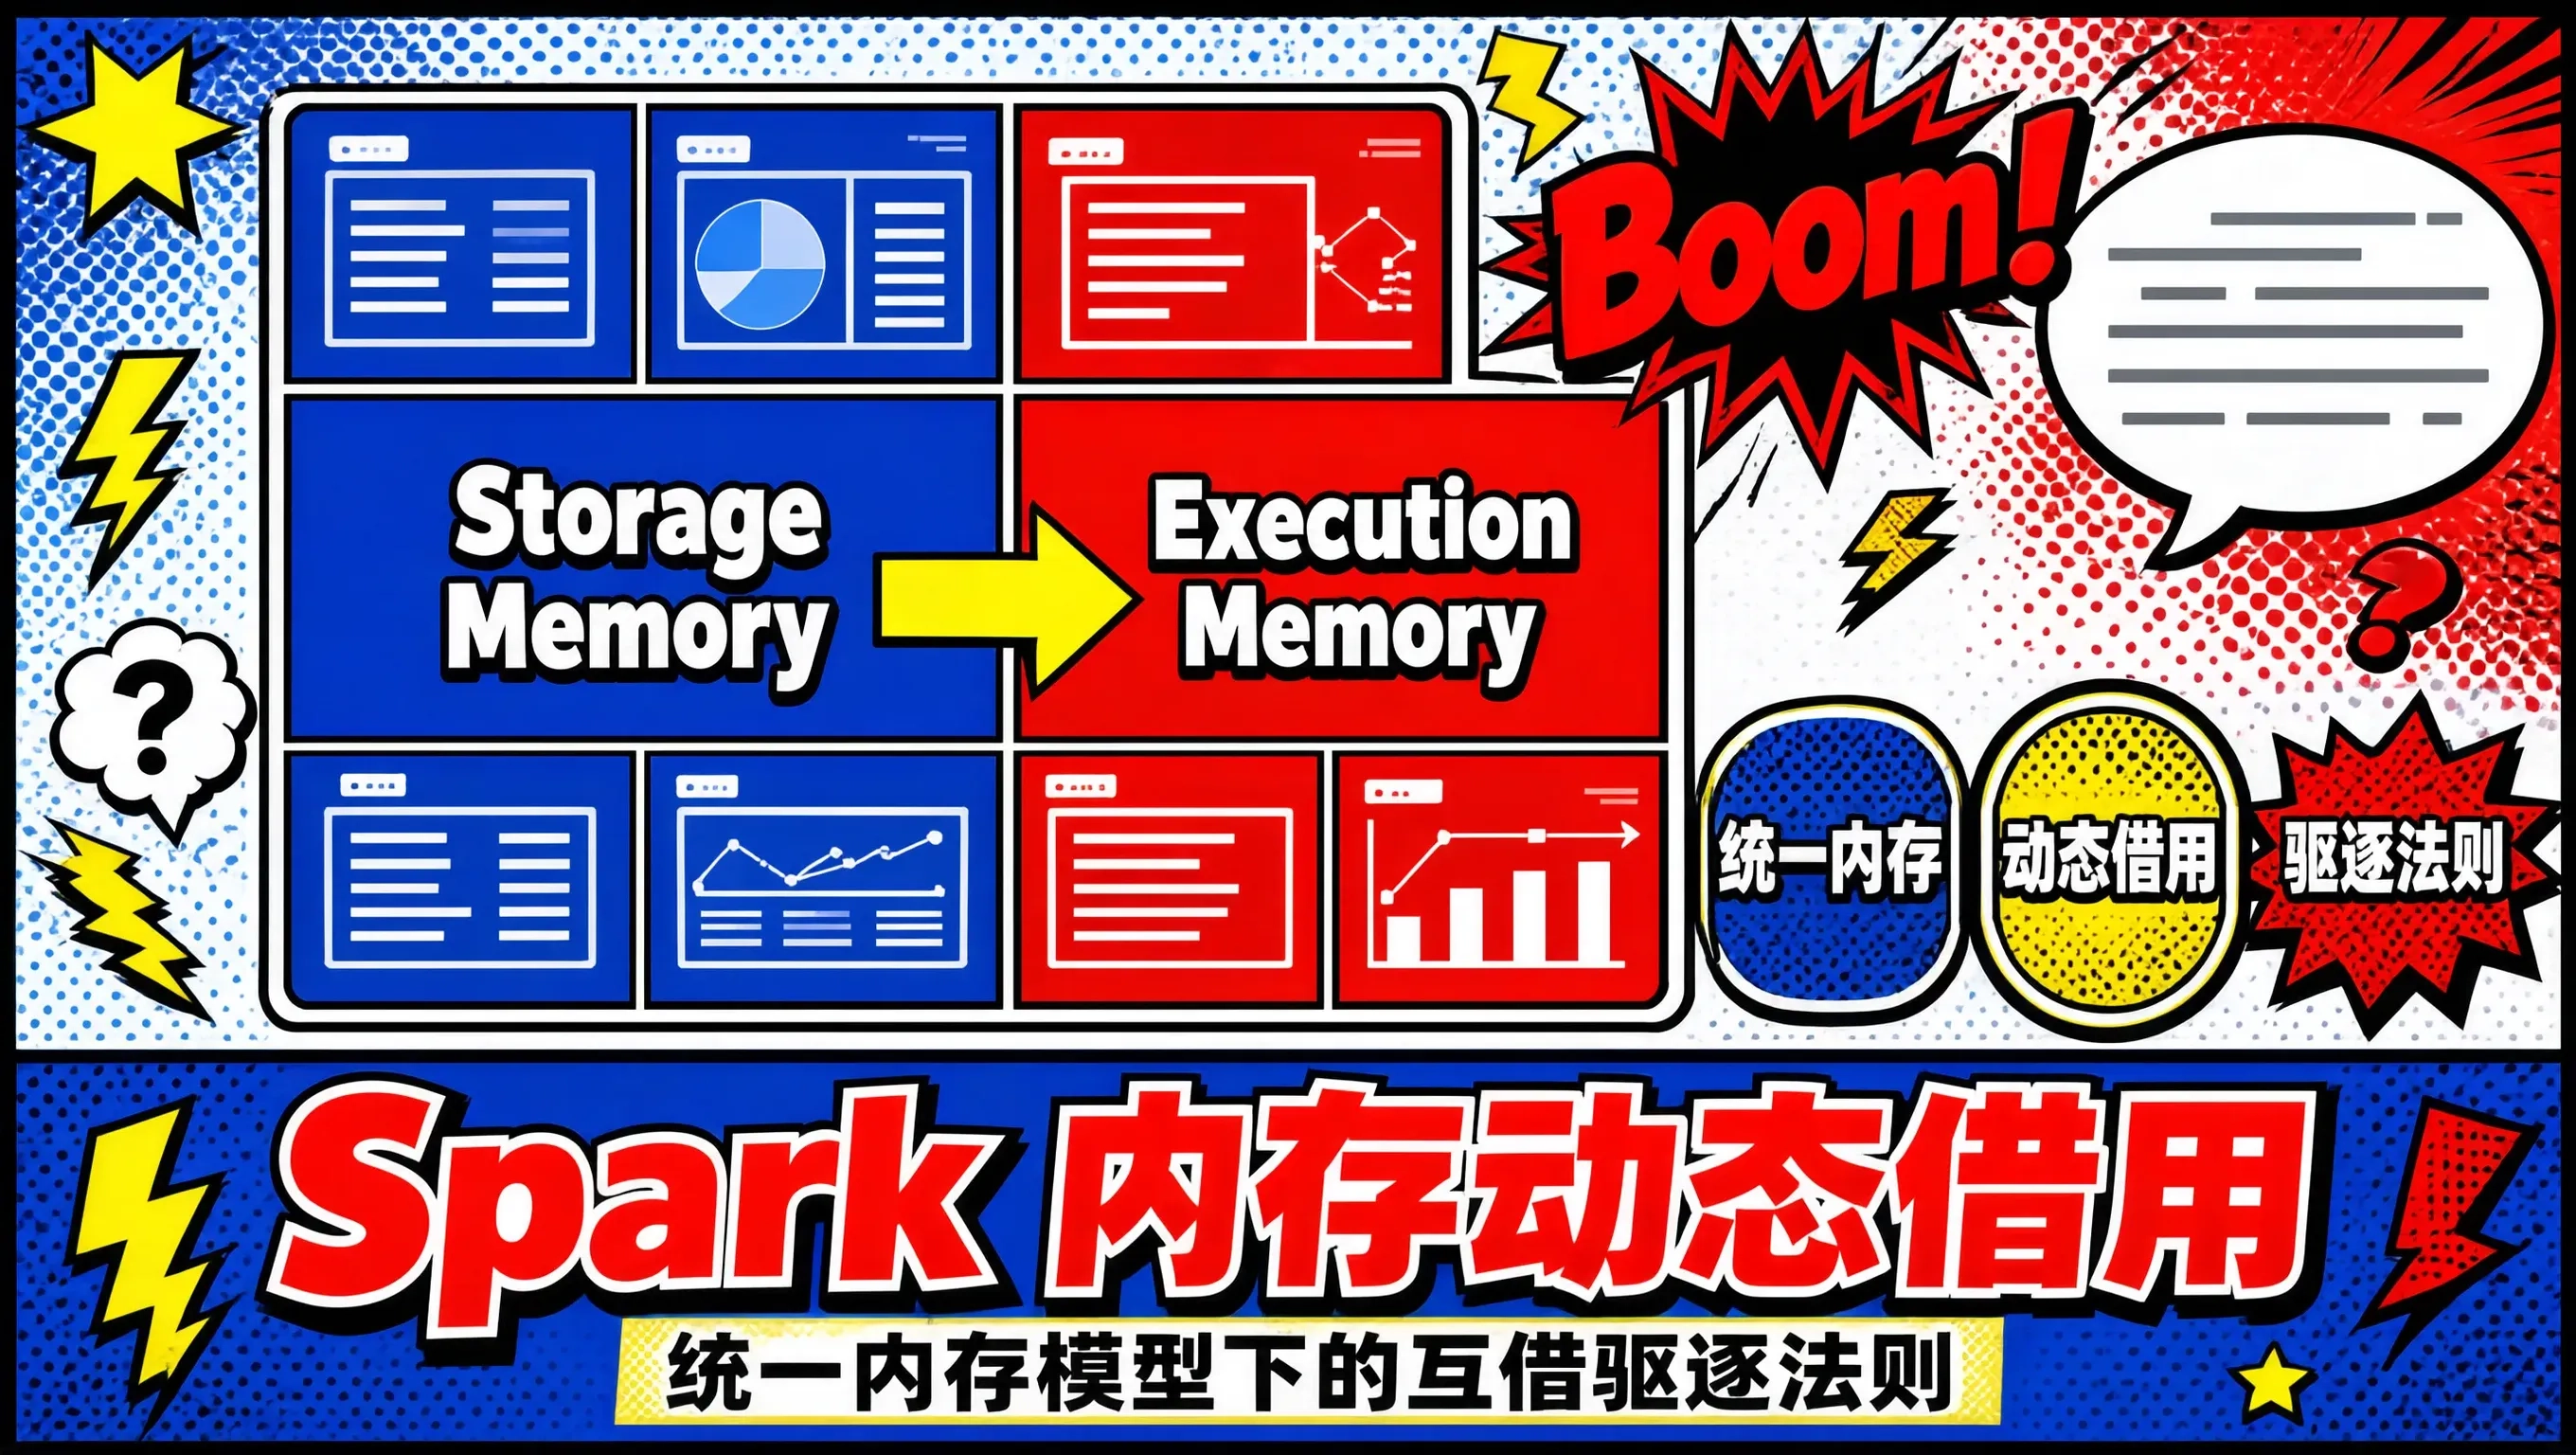
Spark 内存管理机制剖析:Storage 与 Execution 动态借用与 OOM 排障
在大数据离线计算与数仓 ETL 运维中,Spark 的内存溢出(OOM / Out of Memory)永远是出现频次最高、排查最棘手的生产事故之一。
很多工程师在遇到 Spark 任务报错 java.lang.OutOfMemoryError 时,解决问题的手段往往极其粗暴:“无脑加内存”。把 Executor 内存从 4G 改成 8G,不行再加到 16G,甚至加到 32G。结果往往令人沮丧:内存加了 4 倍,任务跑着跑着依然在同一个地方挂掉,或者因为 JVM 堆内存过大导致 Full GC 停顿长达数分钟,最终触发心跳超时被 YARN 强制 Kill。
盲目加内存只是在饮鸩止渴。解决 Spark 内存瓶颈的前提,是必须透彻理解 Spark 统一内存管理模型(Unified Memory Manager)中 存储内存(Storage Memory) 与 执行内存(Execution Memory) 的物理划分与动态借用机制。
今天我们深入解构 Spark 内存的底层分配公式,并给出五大高频 OOM 场景的针对性排障手册。
Spark 统一内存管理模型(Unified Memory Architecture)
在 Spark 1.6+ 之后的统一内存模型中,一个 Executor 的物理 JVM 堆内存被严密划分为四大区域:
+—————————————————————————————————-+
| 【 Executor JVM 总堆内存 】 |
+—————————————————————————————————-+
| 1. 预留内存 (Reserved Memory) | 固定为 300 MB (系统保留,用于防止 OOM,用户不可调配) |
+—————————————————————————————————-+
| 2. 用户内存 (User Memory) | 占比: (1 – spark.memory.fraction) (默认 40%) |
| – 存放用户代码自定义数据结构 (如 Python/Java 对象, UDF 内部变量, 广播变量元数据) |
+—————————————————————————————————-+
| 3. Spark 统一管理内存 (Spark Memory) | 占比: spark.memory.fraction (默认 60%) |
| ┌──────────────────────────────────────────────┬──────────────────────────────────────────────┐ |
| │ 3.1 存储内存 (Storage Memory, 默认占 50%) │ 3.2 执行内存 (Execution Memory, 默认占 50%) │ |
| │ – 用于 RDD Cache 缓存、Broadcast 广播变量 │ – 用于 Shuffle、Join、Sort、聚合的中间计算 │ |
| └──────────────────────────────────────────────┴──────────────────────────────────────────────┘ |
+—————————————————————————————————-+
核心机制:Storage 与 Execution 的“动态借用与驱逐法则”
在早期的静态内存模型中,Storage 和 Execution 的边界是死板固定的。而在统一内存模型下,两者共享同一片连续空间,并遵循**“互借与优先级驱逐”**规则:
+———————————————————————————————–+
| 借用规则 1:谁空闲谁借用 |
| – 如果此时没有 Shuffle 计算,Storage 可以把整块 Spark Memory 全部借走用于缓存 RDD; |
| – 如果此时没有 Cache 缓存,Execution 可以把整块内存全部用于大表 Join 排序。 |
| |
| 驱逐规则 2:计算绝对优先于存储 (Execution is King!) |
| – 当 Execution 内存紧张时,它可以【强行驱逐】Storage 借走的内存! |
| – 被驱逐的 Storage 缓存数据会被直接刷盘(Spill to Disk)或者在内存中直接丢弃(重新计算); |
| – 反过来,Storage【永远无法强行驱逐】正在参与 Shuffle 计算的 Execution 内存! |
+———————————————————————————————–+
五大高频 OOM 事故根因与精准排障方案
场景一:Driver 端 OOM (java.lang.OutOfMemoryError: Java heap space)
- 致命根因:在代码中调用了 df.collect() 或 df.toPandas(),试图把分布在 100 个节点上的数千万行数据全部拉回 Driver 端单机内存!
- 排障准则:严禁在生产代码中对大表调用 collect()!如果必须展示样例,严格使用 df.take(100) 或 df.limit(100).toPandas()。若需广播大表,适度调大 spark.driver.memory。
场景二:Executor 端 Shuffle 计算 OOM (Execution Memory OOM)
- 致命根因:单分区数据量过大,spark.sql.shuffle.partitions(默认仅 200)严重不足,单个 Task 在做 Hash 聚合或排序时,内存 Buffer 瞬间撑爆。
- 排障准则:– 将 Shuffle 分区数调大,使每个 Task 处理的数据量在 100MB ~ 200MB 之间
SET spark.sql.shuffle.partitions = 1200;
— 开启堆外内存 (Off-Heap Memory),减少 JVM GC 压力
SET spark.memory.offHeap.enabled = true;
SET spark.memory.offHeap.size = 4294967296; — 4GB 堆外内存
场景三:滥用 RDD Cache 导致的存储内存撑爆 (Storage Memory OOM)
- 致命根因:在长链条代码中对中间 DataFrame 到处调用 .cache() 或 .persist(),且在计算完成后未显式调用 .unpersist()。
- 排障准则:
- 仅对被下游 2 次以上独立 Action 算子引用的核心 DataFrame 进行 Cache;
- 优先使用序列化缓存级别 StorageLevel.MEMORY_AND_DISK_SER(相比纯内存反序列化对象,内存体积压缩 70% 以上);
- 用完后在代码末尾严格执行 df.unpersist() 释放空间。
场景四:PySpark Python Worker 内存溢出 (Container killed by YARN for exceeding memory limits)
- 致命根因:在使用 PySpark Python UDF 时,JVM 会通过管道(Pipe)将数据反序列化传递给 Python Worker 进程。Python 进程的内存开销不受 JVM 堆内存控制,当超过 YARN 的 Overhead 限制时,Container 被直接杀死!
- 排障准则:# 调大 YARN 堆外额外内存配比 (默认仅为堆内存的 10%)
spark.yarn.executor.memoryOverhead = 4096MB
# 尽量避免使用纯 Python UDF,改用 PySpark 原生 SQL 函数或 Pandas UDF (Arrow 向量化传输)
生产级 Spark 内存配置黄金模版
对于一台 64 核 256GB 内存的标准大数据计算节点,每个 Executor 的黄金配置参数如下:
# 每个 Executor 分配 4~5 个 Core (保证 I/O 吞吐且避免单 JVM 垃圾回收过慢)
spark.executor.cores=4
# 每个 Executor 分配 16GB ~ 20GB 堆内存
spark.executor.memory=16g
# 堆外额外内存
spark.executor.memoryOverhead=4g
# 统一管理内存占比
spark.memory.fraction=0.6
# 存储与执行初始占比
spark.memory.storageFraction=0.5
# 开启自适应分区合并与动态倾斜处理
spark.sql.adaptive.enabled=true
把每一块物理内存都分配在刀刃上,读懂监控指标中的 Spill(Memory)与 Spill(Disk),才能让海量批处理流水线在高并发夜间调度中稳如泰山。