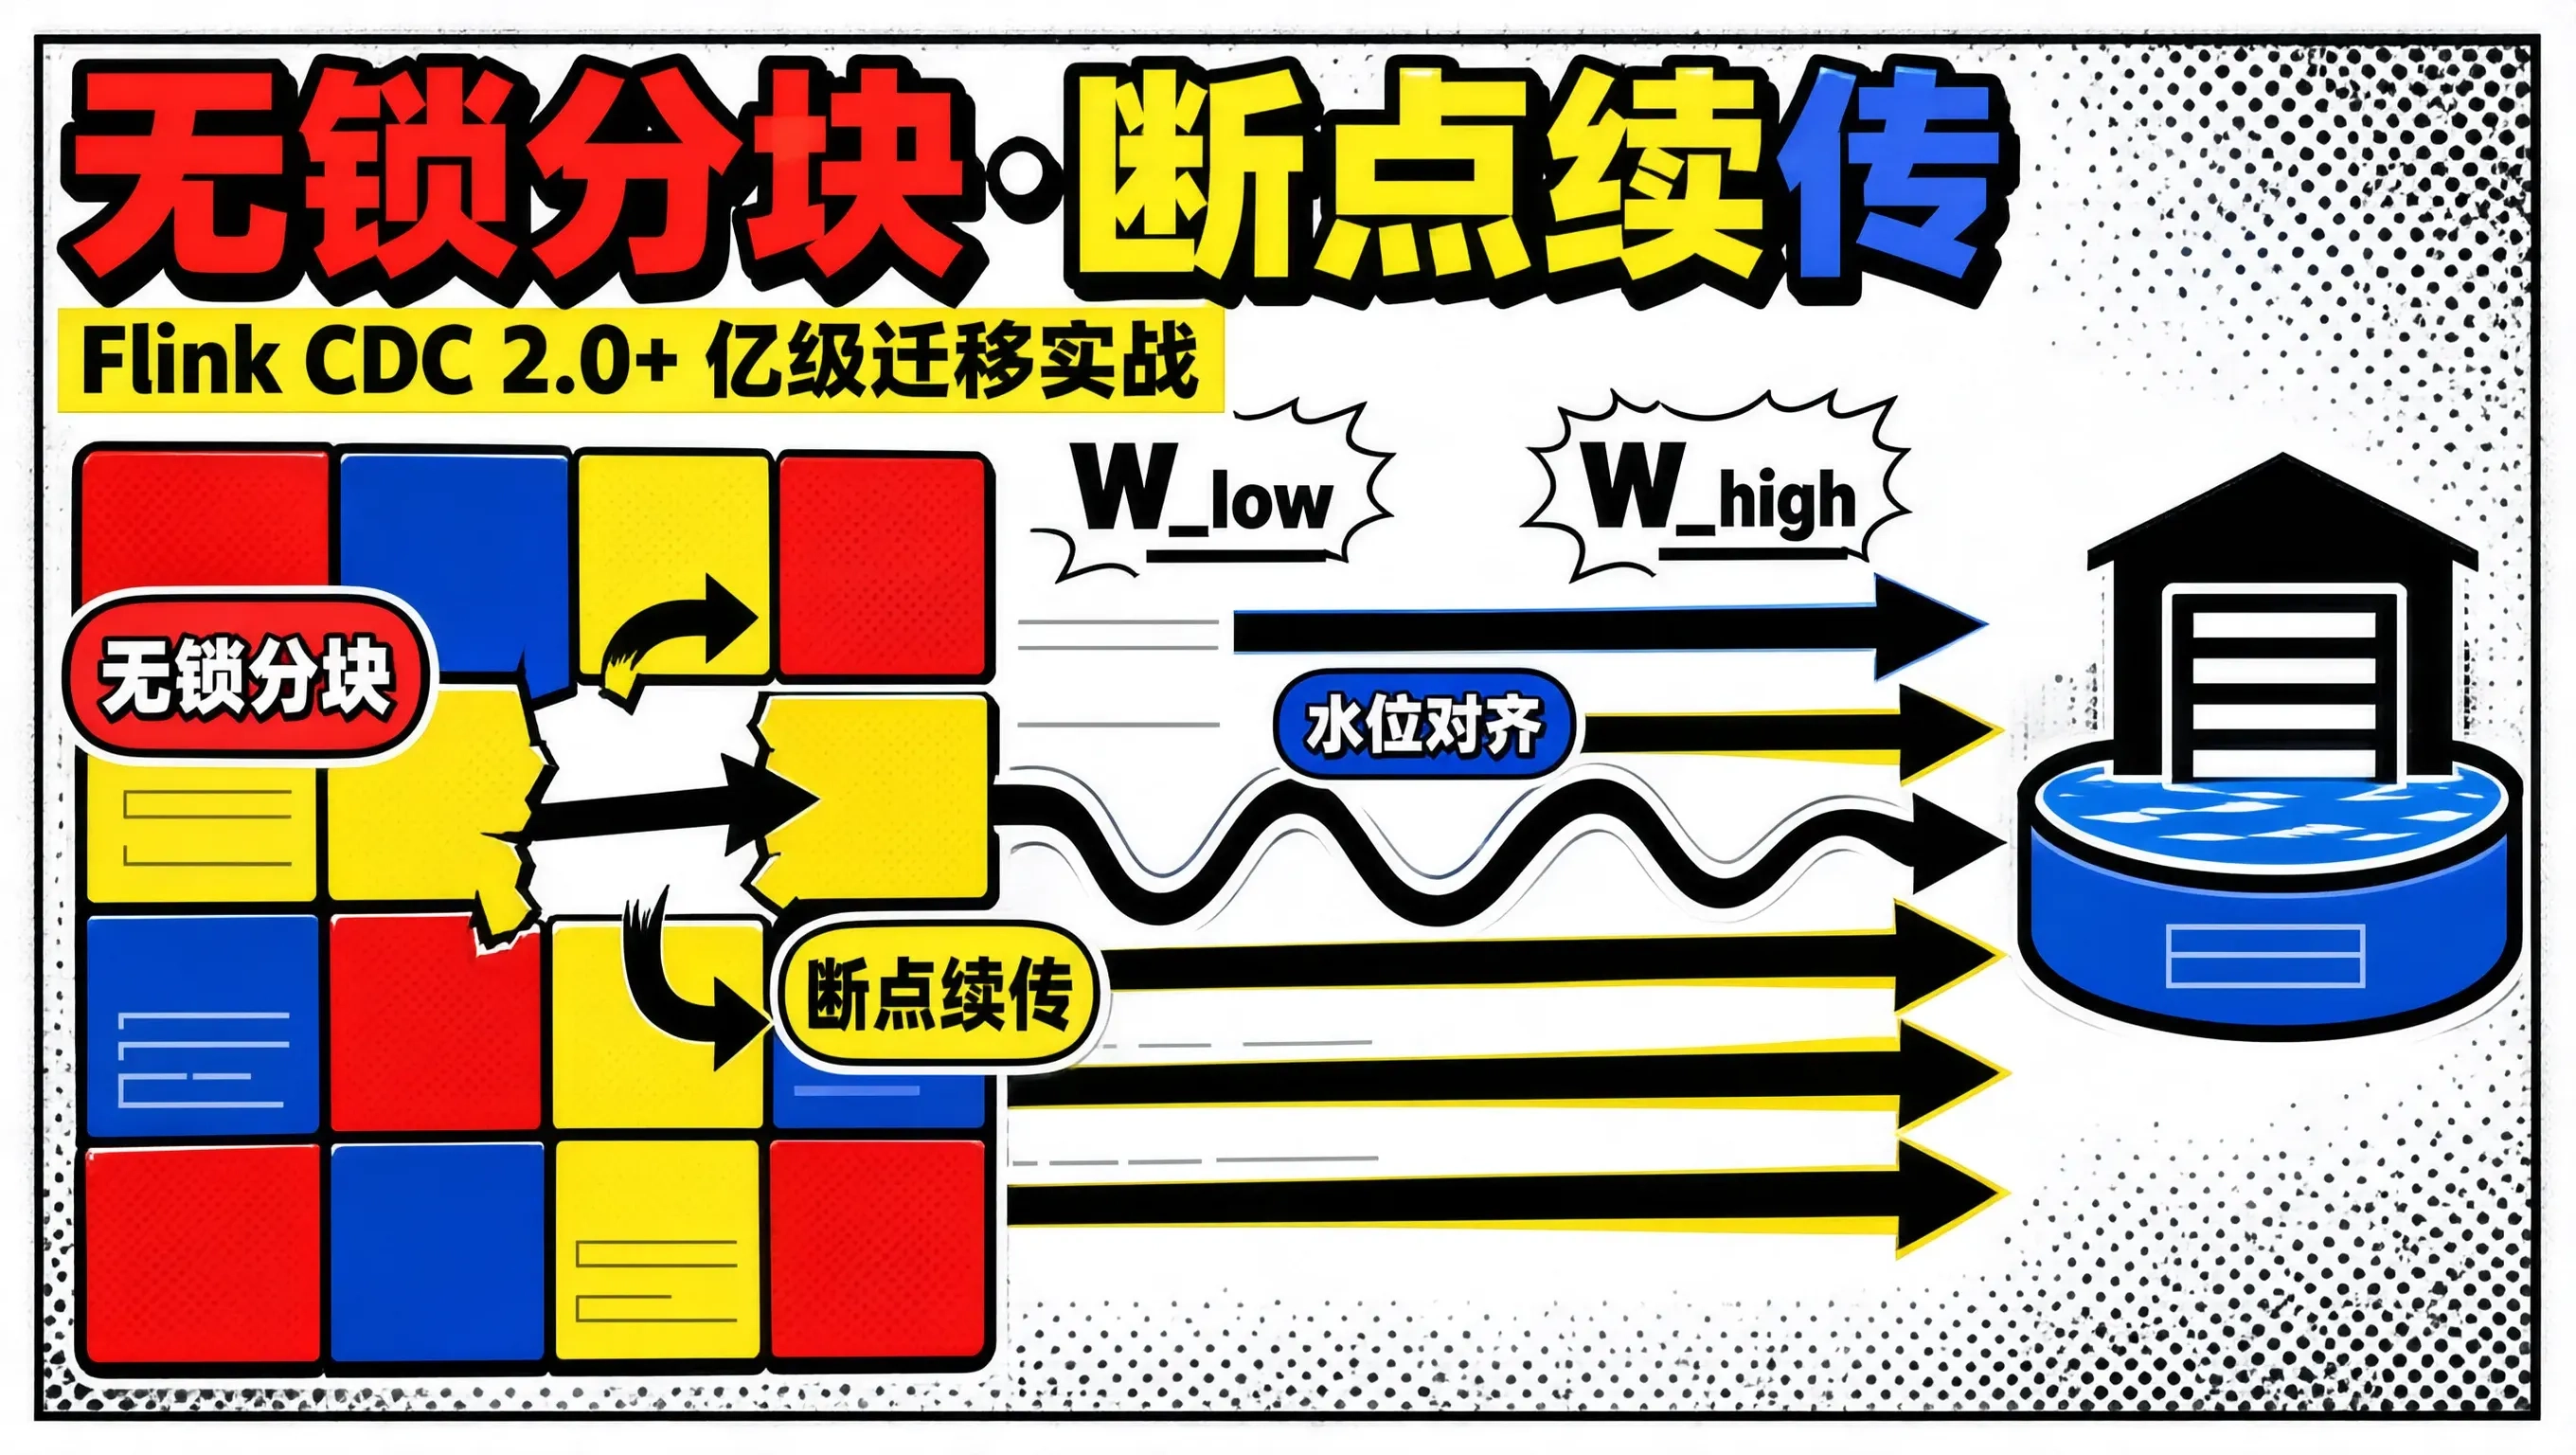
在企业构建现代实时数仓(Real-Time Data Warehouse)的过程中,将底层业务 OLTP 数据库(如 MySQL、PostgreSQL、Oracle)中的海量存量数据与增量变更实时同步至消息队列(Kafka)或数据湖仓(Iceberg/ClickHouse),是整个数据流转拓扑的基石底座。
在 Flink CDC 1.x 时代,基于传统 Debezium 封装的抽取机制在面对生产环境动辄数亿行、数千兆字节的核心大表时,暴露出两个几乎无法忍受的致命缺陷:
社区在 Flink CDC 2.0+ 中推出的 全量增量一体化框架(Incremental Snapshot Framework),凭借其里程碑式的 无锁分块读取(Chunk Splitting) 与 全流程并发断点续传 机制,彻底终结了这一噩梦。本文将深入拆解其底层算法机理与生产高并发迁移调优实践。
一、 无锁分块读取的核心算法:Watermark 算法与块切分
Flink CDC 2.0+ 究竟是如何在完全不加锁的前提下,保证全量切片数据与增量 Binlog 之间“精确一次(Exactly-Once)”一致性的?
这依赖于其经典的 分块低水位与高水位标记算法(Chunk Watermark Algorithm)。
1. 动态主键范围分块(Split Chunk)
对于一张包含数亿行记录的大表,Flink CDC 会根据表的主键(Primary Key)进行离散分片。假设主键为自增 id,算法将其划分为若干大小均匀的块(Chunk,例如每个 Chunk 默认包含 8096 行数据):
- $\\text{Chunk}_0: [\\text{min_id}, 8096]$
- $\\text{Chunk}_1: [8097, 16192]$
- $\\dots$
- $\\text{Chunk}_k: [k \\cdot \\text{size} + 1, \\dots]$
sequenceDiagram
participant Worker as Flink Snapshot Reader
participant DB as 业务 MySQL (无全局锁)
participant Binlog as MySQL Binlog 流
Note over Worker,DB: 开始处理 Chunk_i [ID_min, ID_max]
Worker->>Binlog: 1. 记录低水位位点 (Low Watermark: W_low)
Worker->>DB: 2. 执行分块快照查询 (SELECT * WHERE id >= ID_min AND id <= ID_max)
DB–>>Worker: 返回当前 Chunk 的全量记录 (存入内存/State)
Worker->>Binlog: 3. 记录高水位位点 (High Watermark: W_high)
Note over Worker: 4. 归一化对齐与回放 (Reconciliation)
Worker->>Binlog: 5. 消费区间 [W_low, W_high] 之间的所有变更
Note over Worker: 针对 Chunk 范围内的 Key,应用最新的 Binlog 变更 (覆盖旧快照)
Worker->>Worker: 6. 标记该 Chunk 完成,提交 State Checkpoint
2. 水位线归一化对齐机制(Reconciliation)
在读取某一个具体的分块时:
- 如果某一行在快照中被读取,但在 $[W_{\\text{low}}, W_{\\text{high}}]$ 中被 UPDATE,则用最新的 UPDATE 结果覆盖快照值;
- 如果某一行在快照中被读取,但随后在区间内被 DELETE,则直接从快照集合中剔除。
二、 全量并发断点续传与状态机管理
Flink CDC 2.0 引入了类似 MapReduce / Spark 的主从调度模型:
flowchart TD
subgraph JobManager
Enumerator[Source Coordinator / Chunk Enumerator]
end
subgraph TaskManager 并发 Reader
R1[Source Reader 并发 1]
R2[Source Reader 并发 2]
R3[Source Reader 并发 3]
end
Enumerator –>|动态分发 Chunk 01| R1
Enumerator –>|动态分发 Chunk 02| R2
Enumerator –>|动态分发 Chunk 03| R3
R1 –>|汇报 Chunk 01 已完成| Enumerator
R2 –>|汇报 Chunk 02 已完成| Enumerator
Enumerator –>|持久化到 Flink State 存储| Checkpoint[(RocksDB State Checkpoint)]
为什么能实现真正的断点续传?
在 Flink CDC 2.0 中,SourceCoordinator 会在 Flink 的分布式状态(RocksDB State)中维护两个核心集合:
每一次 Flink 触发全局 Checkpoint 时,已经完成同步的 Chunk 编号以及当前的 Binlog 进度都会被持久化到 HDFS/OSS 中。如果同步进程在处理第 5000 个 Chunk 时突然宕机崩溃,作业重启后,Flink 会从最近成功的 Checkpoint 状态中恢复,自动跳过前 4999 个已经完成对齐的 Chunk,直接从第 5000 个 Chunk 处继续并发拉取!千亿级存量大表的初始化再也不用害怕偶发性网络中断。
三、 生产海量全量迁移配置实战与并发调优
以下为在生产环境下进行亿级 MySQL 订单表全量与增量一体化同步的 Flink SQL 黄金配置:
CREATE TABLE mysql_source_orders (
order_id BIGINT,
user_id BIGINT,
pay_amount DECIMAL(10,2),
status INT,
update_time TIMESTAMP(3),
PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
'connector' = 'mysql-cdc',
'hostname' = '10.0.10.25',
'port' = '3306',
'username' = 'cdc_reader',
'password' = 'your_secure_password',
'database-name' = 'ecommerce_db',
'table-name' = 'orders_huge',
— 核心关键 1: 声明并行度与分块读取策略
'scan.incremental.snapshot.enabled' = 'true', — 显式开启增量快照框架
'scan.incremental.snapshot.chunk.size' = '16384', — 单个 Chunk 大小 (默认 8096)
— 核心关键 2: 快照阶段并发度控制
'scan.startup.mode' = 'initial',
— 核心关键 3: 避免业务库慢查询打满连接
'scan.snapshot.fetch.size' = '2048', — JDBC fetch 大小
'connect.timeout' = '30s',
'connection.pool.size' = '20'
);
生产必须关注的四大调优要点:
- 设得过小(如 1000):分块元数据过多,Coordinator 的内存压力大,频繁的水位线比对会增加开销;
- 设得过大(如 100,000):单次快照查询执行时间过长,区间内产生的 Binlog 增量过大,对齐阶段的重放开销和内存消耗剧增。
- 黄金推荐值:根据单行记录字节大小,通常建议保持在 8192 ~ 32768 之间。
四、 总结
Flink CDC 2.0+ 带来的无锁分块与断点续传技术,是实时流数据集成领域的一次重大工程飞跃: