/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
【爬取目标】
目标网站:无名小站电影排行榜
在影视推荐、影评分析、影片分类整理、个人观影清单构建等场景中,电影信息(电影名称、详情页链接、封面图片、主演演员)是重要的基础数据。手动浏览复制每一部电影的名称和演员信息费时费力,且翻页操作繁琐。因此本文将教你使用 Python 的 DrissionPage 自动化框架,批量爬取无名小站的电影排行榜数据并自动保存到 CSV 文件,快速搭建专属的电影资源库!
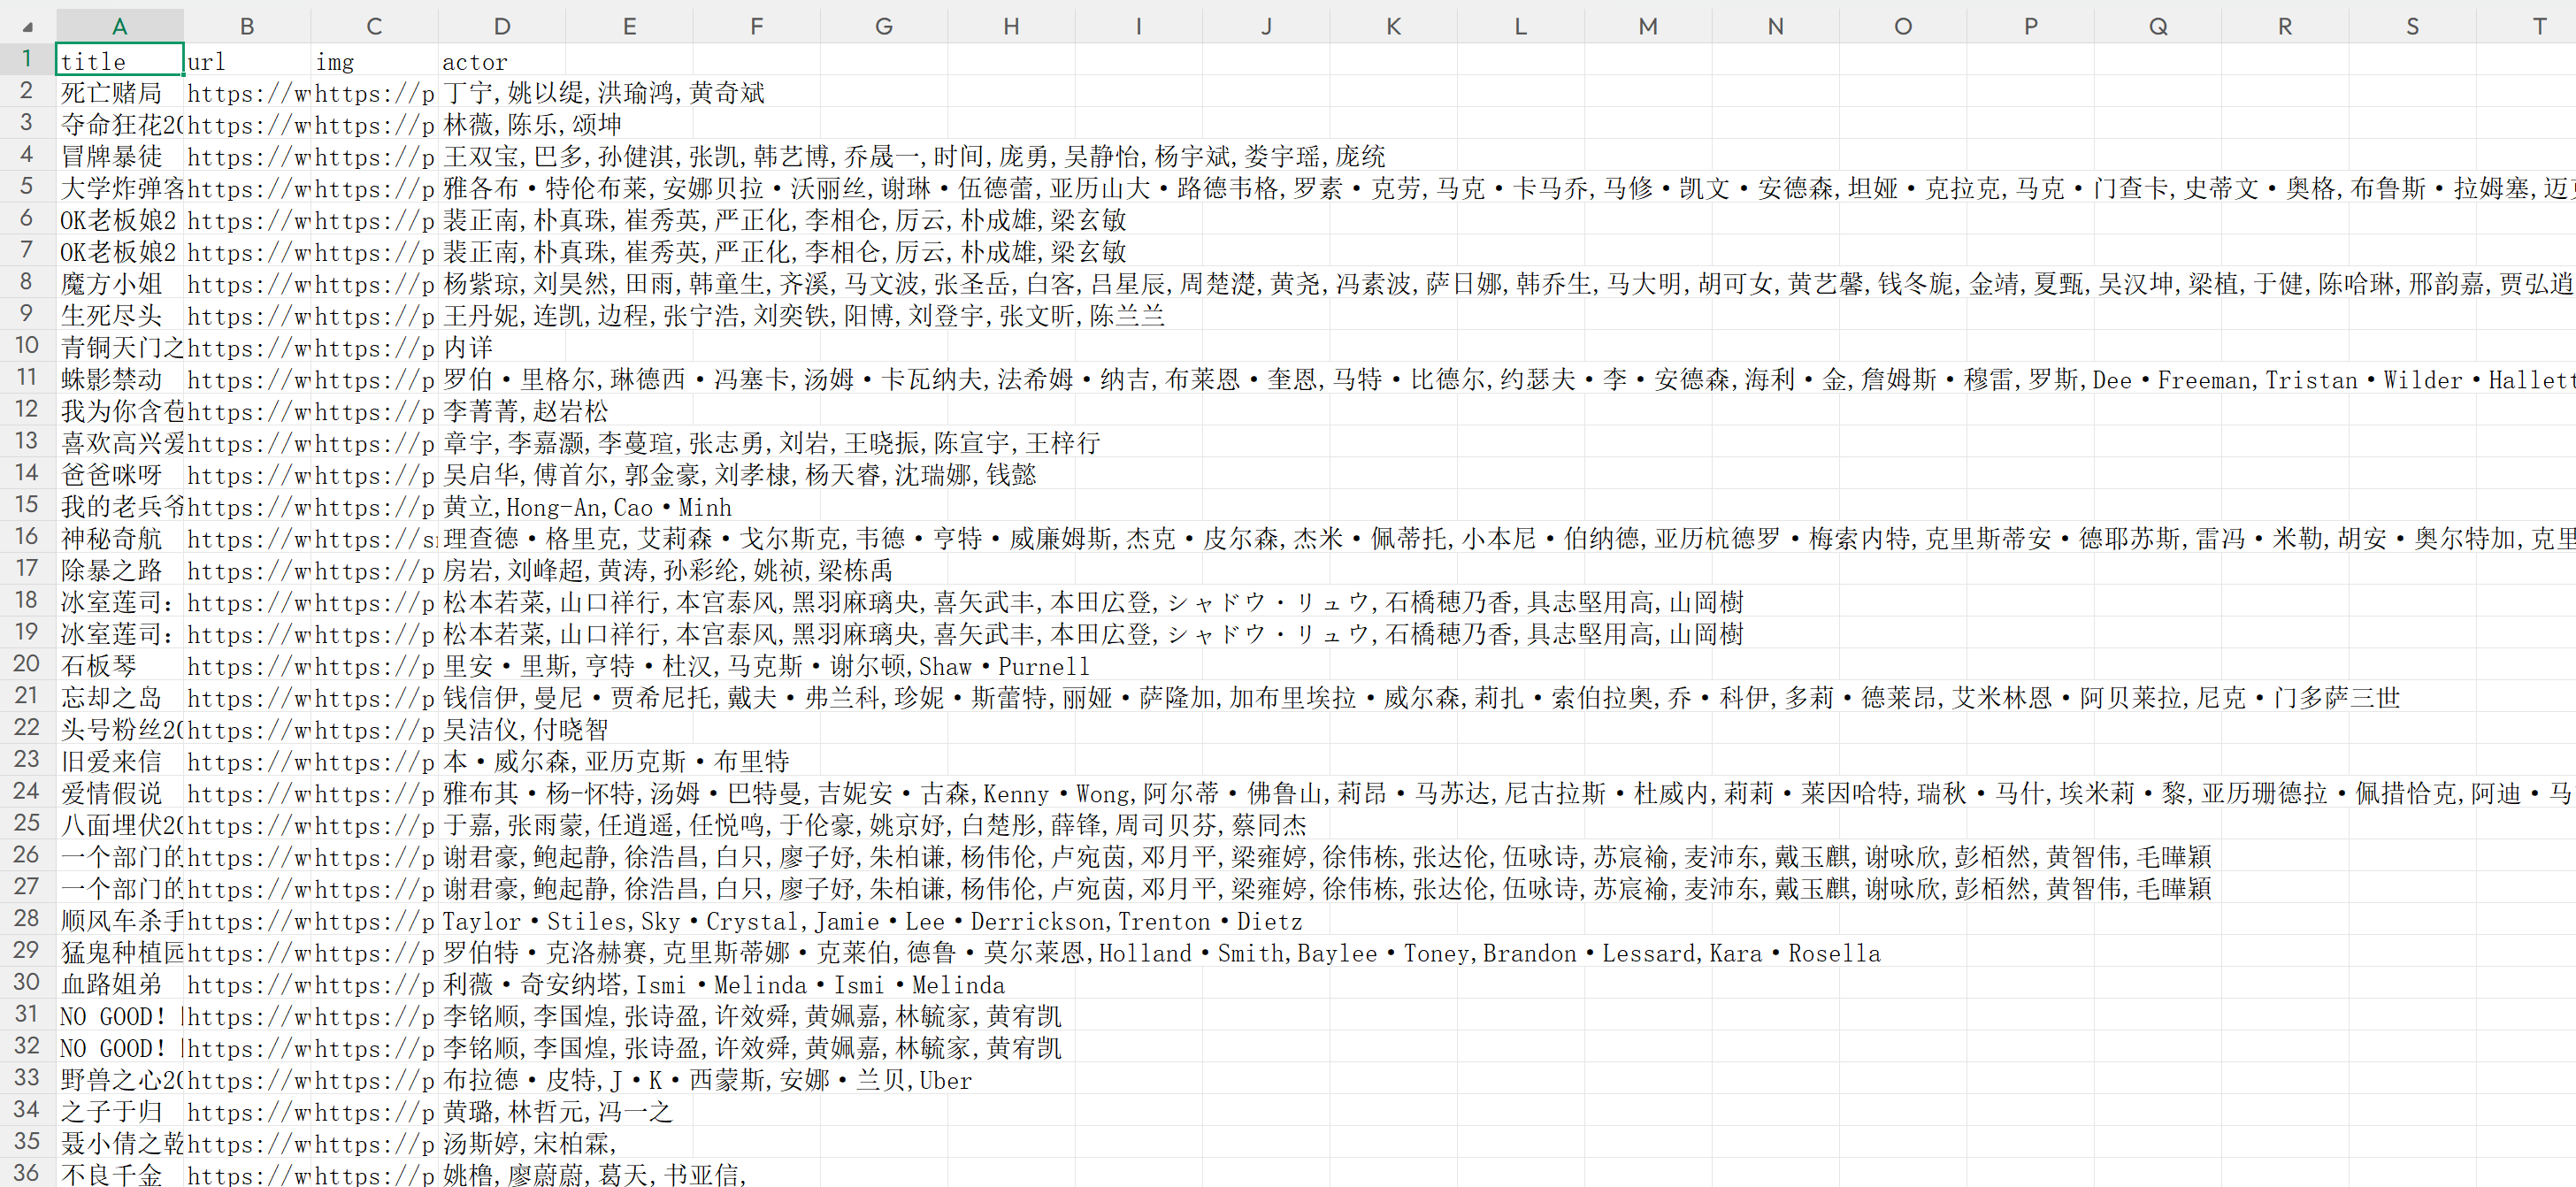
获取字段如下:电影名称、详情页链接、封面图片、演员信息,共 4 个字段,如图所示:

【实现效果】
代码使用 DrissionPage 自动打开浏览器,访问无名小站电影排行榜页面,从渲染后的 DOM 结构中批量获取每部电影卡片的信息。每个电影卡片是一个 <li> 标签,通过 XPath 定位所有卡片后,逐条提取电影名称(a 标签的 title 属性)、详情页链接(a 标签的 href 属性)、封面图片(a 标签的 data-original 属性)和演员信息(p 标签的文本内容),最终保存到结构化的 CSV 文件中。翻页通过点击「下一页」按钮实现全自动采集,默认最多翻 10 页,未满 10 页则自动停止:
文章目录
- 一、技术栈和环境版本
- 二、爬虫实战分析
-
- 2.1 导入模块
- 2.2 分析网页,定位电影卡片数据(详细抓包过程)
-
- 第一步:打开目标页面,观察页面整体结构
- 第二步:利用关键词搜索,定位电影卡片容器
- 第三步:逐字段分析 DOM 结构,确定提取方式
- 第四步:分析翻页机制
- 第五步:总结网页分析规律
- 2.3 打开浏览器并访问电影列表页面
- 2.4 解析数据,提取 4 个电影字段信息
- 2.5 保存数据到 CSV 文件
- 2.6 主函数——协调各模块完成多页自动翻页爬取
- 三、完整爬虫代码
- 四、总结
- 五、专栏说明
一、技术栈和环境版本
Python版本:3.12.x
编辑器:PyCharm / VS Code
python内置模块:
import csv # CSV文件读写,用于数据持久化
import time # 延时等待,确保动态内容渲染完成
第三方模块,自行安装:
pip install DrissionPage==4.0.0 # 浏览器自动化框架,驱动浏览器完成页面加载与元素定位