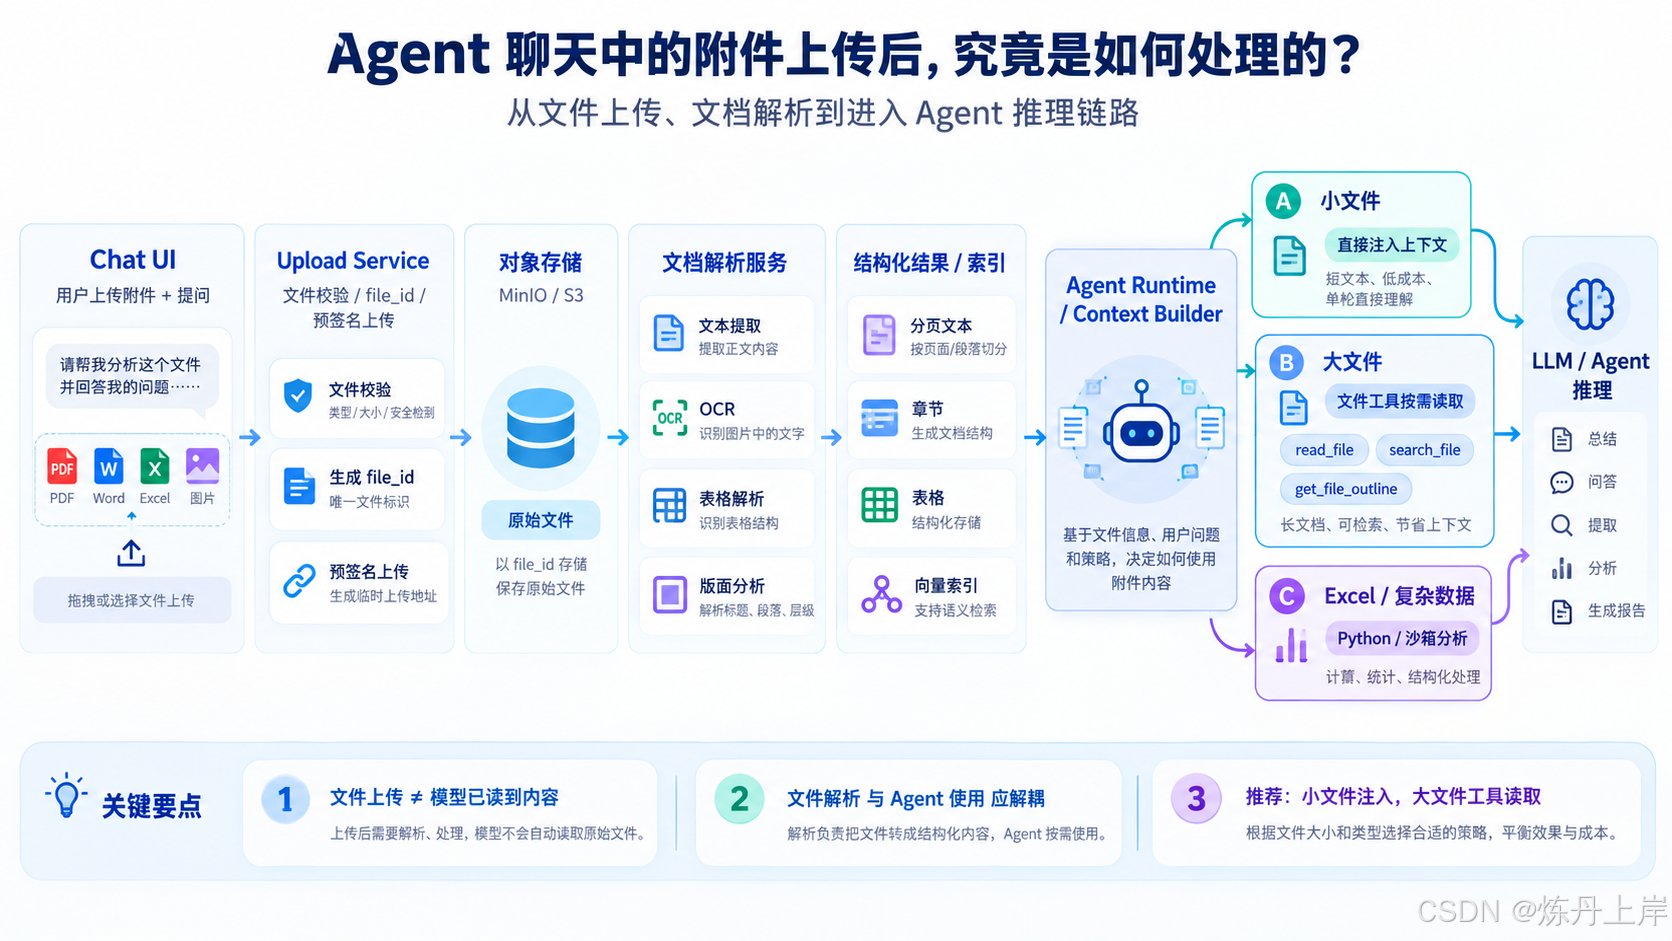
如今,大多数 Agent 产品都支持在聊天框中上传附件。用户可以上传 PDF、Word、Excel、图片,然后让 Agent 总结文档、分析数据、生成报告,甚至执行复杂的业务任务。
从用户视角来看,整个过程非常简单:上传一个文件,输入一个问题,Agent 就能基于文件回答。
但从工程实现来看,这里面其实涉及一个很关键的问题:
用户上传的文件,究竟是如何进入 Agent 的?
一种方案是,后端先解析文件,然后把解析后的文本直接注入模型上下文;另一种方案是,后端只把文件信息交给 Agent,再提供 read_file、search_file 等工具,让 Agent 自主读取。
这两种方式到底应该怎么选?如果要设计一套通用的 Agent Runtime,文件上传、解析、存储和上下文构建又应该如何组织?
本文就从这个问题出发,梳理 Agent 聊天附件背后的完整技术链路,并结合主流模型平台的公开方案,讨论一套适合实际项目落地的架构。
一、先明确:文件上传成功,不代表 Agent 已经读到文件
假设用户在聊天框中上传了一份 200 页的 PDF:
帮我分析这份招标文件,提取技术要求、商务要求和主要风险点。
用户点击发送后,系统至少需要解决三个相互独立的问题:
第一,文件存在哪里?
浏览器上传的二进制文件,通常会被保存到 MinIO、S3 等对象存储中。数据库记录文件 ID、名称、大小、类型和存储位置。
第二,文件内容如何被解析?
PDF 可能包含正文、表格、图片、扫描页,甚至多栏排版。系统可能需要 PyMuPDF、MinerU、OCR 或视觉模型将其转换成可供后续处理的内容。
第三,解析出来的内容如何进入 Agent?
这才是本文真正要讨论的重点。
大模型本身并不会因为应用数据库中存在某个 file_id,就自动拥有读取该文件的能力。
如果希望 Agent 理解这份 PDF,应用层必须通过某种机制,把文件内容送入模型,或者让模型能够通过工具获取这些内容。
因此,需要区分三个概念:
- File Upload:解决文件传输和存储。
- Document Processing:解决文件内容提取与结构化。
- Context Construction:解决文件内容如何参与 Agent 推理。
它们之间有关联,但不是一回事。
二、从上传到模型推理,一份附件经历了什么?
先来看一套常见的工程架构。
#mermaid-svg-WxPRfx2DophZF9b8{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-WxPRfx2DophZF9b8 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-WxPRfx2DophZF9b8 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-WxPRfx2DophZF9b8 .error-icon{fill:#552222;}#mermaid-svg-WxPRfx2DophZF9b8 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-WxPRfx2DophZF9b8 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-WxPRfx2DophZF9b8 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-WxPRfx2DophZF9b8 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-WxPRfx2DophZF9b8 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-WxPRfx2DophZF9b8 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-WxPRfx2DophZF9b8 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-WxPRfx2DophZF9b8 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-WxPRfx2DophZF9b8 .marker.cross{stroke:#333333;}#mermaid-svg-WxPRfx2DophZF9b8 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-WxPRfx2DophZF9b8 p{margin:0;}#mermaid-svg-WxPRfx2DophZF9b8 .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-WxPRfx2DophZF9b8 .cluster-label text{fill:#333;}#mermaid-svg-WxPRfx2DophZF9b8 .cluster-label span{color:#333;}#mermaid-svg-WxPRfx2DophZF9b8 .cluster-label span p{background-color:transparent;}#mermaid-svg-WxPRfx2DophZF9b8 .label text,#mermaid-svg-WxPRfx2DophZF9b8 span{fill:#333;color:#333;}#mermaid-svg-WxPRfx2DophZF9b8 .node rect,#mermaid-svg-WxPRfx2DophZF9b8 .node circle,#mermaid-svg-WxPRfx2DophZF9b8 .node ellipse,#mermaid-svg-WxPRfx2DophZF9b8 .node polygon,#mermaid-svg-WxPRfx2DophZF9b8 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-WxPRfx2DophZF9b8 .rough-node .label text,#mermaid-svg-WxPRfx2DophZF9b8 .node .label text,#mermaid-svg-WxPRfx2DophZF9b8 .image-shape .label,#mermaid-svg-WxPRfx2DophZF9b8 .icon-shape .label{text-anchor:middle;}#mermaid-svg-WxPRfx2DophZF9b8 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-WxPRfx2DophZF9b8 .rough-node .label,#mermaid-svg-WxPRfx2DophZF9b8 .node .label,#mermaid-svg-WxPRfx2DophZF9b8 .image-shape .label,#mermaid-svg-WxPRfx2DophZF9b8 .icon-shape .label{text-align:center;}#mermaid-svg-WxPRfx2DophZF9b8 .node.clickable{cursor:pointer;}#mermaid-svg-WxPRfx2DophZF9b8 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-WxPRfx2DophZF9b8 .arrowheadPath{fill:#333333;}#mermaid-svg-WxPRfx2DophZF9b8 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-WxPRfx2DophZF9b8 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-WxPRfx2DophZF9b8 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-WxPRfx2DophZF9b8 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-WxPRfx2DophZF9b8 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-WxPRfx2DophZF9b8 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-WxPRfx2DophZF9b8 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-WxPRfx2DophZF9b8 .cluster text{fill:#333;}#mermaid-svg-WxPRfx2DophZF9b8 .cluster span{color:#333;}#mermaid-svg-WxPRfx2DophZF9b8 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-WxPRfx2DophZF9b8 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-WxPRfx2DophZF9b8 rect.text{fill:none;stroke-width:0;}#mermaid-svg-WxPRfx2DophZF9b8 .icon-shape,#mermaid-svg-WxPRfx2DophZF9b8 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-WxPRfx2DophZF9b8 .icon-shape p,#mermaid-svg-WxPRfx2DophZF9b8 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-WxPRfx2DophZF9b8 .icon-shape .label rect,#mermaid-svg-WxPRfx2DophZF9b8 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-WxPRfx2DophZF9b8 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-WxPRfx2DophZF9b8 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-WxPRfx2DophZF9b8 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
短文本
大文档
复杂表格
视觉内容
Chat UI 上传附件
Upload Service
MinIO / S3 原始文件
File Registry 文件元数据
Document Processing
解析文本 / 页面 / 表格
结构化内容与可选检索索引
用户消息 + file_id
Agent Runtime / Context Builder
选择文件使用方式
直接注入上下文
read_file / search_file
Python / Sandbox
原生多模态输入
LLM 推理
这里有两个值得注意的设计。
首先,文件存储和 Agent 执行之间通过 File Registry 解耦。Agent 不需要关心文件实际存储在哪个 MinIO Bucket,也不应该直接操作用户提供的存储地址。
其次,文件解析不一定是模型推理的前置条件。对于支持原生 PDF 或图片输入的模型,可以直接把文件作为多模态输入;只有需要文本化、结构化检索或进一步计算时,才调用自己的解析服务。
2.1 文件上传:建立 File Resource
在一般的 Agent 产品中,可以将文件上传与消息发送设计为两个独立请求。
例如:
POST /api/files/init
服务端创建文件记录并生成上传地址:
{
"file_id": "file_123",
"upload_url": "https://storage.example.com/…",
"status": "pending_upload"
}
前端通过预签名 URL 将文件直传到 MinIO,上传完成后通知服务端校验对象是否存在、大小与类型是否符合预期。
此时数据库中可以有一条记录:
{
"id": "file_123",
"filename": "招标文件.pdf",
"mime_type": "application/pdf",
"size": 10485760,
"storage_key": "tenant_01/files/file_123.pdf",
"status": "uploaded"
}
这里的 file_id 是应用系统内部的文件资源标识,不一定等于 OpenAI、Claude 等模型平台的文件 ID。
如果后续需要通过模型供应商的 Files API 上传文件,可以单独维护 provider_file_id 映射。
这样未来切换模型供应商时,就不需要修改整个业务文件体系。
2.2 文件解析:得到可复用的结构化结果
文件上传成功后,可以异步触发解析任务,也可以等到 Agent 第一次需要文件内容时再触发。
不同格式的处理方式并不一样。
| PyMuPDF、MinerU、OCR | 页码、章节、正文、表格、图片 | |
| Word | python-docx、Docling | 标题层级、段落、表格 |
| Excel | openpyxl、pandas | Sheet、单元格、公式、数值类型 |
| PPT | python-pptx、页面渲染 | 页面、文本、图片、图表 |
| 图片 | OCR、多模态视觉模型 | 文字、视觉内容、位置 |
| CSV / JSON | 结构化解析器 | 字段、类型、数据记录 |
例如,解析一份 PDF 后,不应该只保存一整段纯文本:
第一章 项目概况……
第二章 技术要求……
第三章 商务条款……
更好的方式是同时保留章节、页码以及块级结构:
{
"file_id": "file_123",
"pages": [
{
"page": 12,
"blocks": [
{
"type": "heading",
"text": "3.2 技术要求"
},
{
"type": "paragraph",
"text": "系统应支持……"
}
]
}
]
}
这样后续不管是直接注入上下文,还是通过工具按页读取、按章节检索,都可以复用同一份解析结果。
对于 Excel,还需要保留原始文件。因为简单地把 Excel 转成 Markdown 表格,可能损失单元格公式、合并关系、数据类型以及部分格式信息,而这些信息在计算类任务中可能非常重要。
文件解析的目的,不是直接生成一个巨大的 Prompt,而是把不同格式的附件转换成可以被 Agent 按需消费的数据资源。
2.3 聊天消息:通过 file_id 关联附件
文件上传完成后,用户发送消息:
POST /api/agent/runs
{
"session_id": "session_001",
"message": "帮我分析这份招标文件",
"attachments": [
{
"file_id": "file_123"
}
]
}
后端检查文件归属和会话访问权限后,将这条消息与对应文件建立关联。
此时 Agent Runtime 收到的可能只是:
type AgentMessage = {
role: "user" | "assistant" | "tool";
content: string;
attachments?: Array<{
fileId: string;
filename: string;
mimeType: string;
}>;
};
注意,到目前为止,Agent 还没有获得那份 PDF 的正文。
attachments 只表示当前消息关联了哪些文件资源。
下一步,才是决定文件究竟如何进入模型上下文。
三、核心问题:解析后的文本直接注入,还是让 Agent 调用工具?
这两种方式都成立,区别在于:文件内容由 Runtime 主动提供,还是由 Agent 在执行过程中按需获取。
3.1 方案一:解析后直接注入上下文
假设用户上传一份两页的 Word,解析后只有 2000 Token。
用户的问题是:
帮我总结这份需求文档。
最简单的做法是,在调用模型之前,把解析后的文本直接作为本轮上下文的一部分。
用户问题:
帮我总结这份需求文档。
附件资料:
文件名:需求文档.docx
<attachment_content>
第一章 项目背景……
第二章 功能需求……
第三章 验收标准……
</attachment_content>
这里的附件内容应被视为不可信的用户资料,而非系统指令。实际应用中也可以通过模型 API 的独立内容块承载它。
这种方式最大的优点是直接。
模型第一次推理时就拥有了文件内容,不需要先判断是否使用工具,再发起一次 Tool Call。
对于短文档总结、合同条款解释、少量文本抽取,这通常已经足够。
但问题也很明显。
如果用户上传的是一份 300 页的 PDF,解析后有十几万 Token,再直接拼入上下文,就可能带来较高的 Token 成本、首 Token 延迟和上下文占用。
而且在多轮对话中,如果每次都重新携带全文,成本会进一步增加。即使模型支持很大的上下文窗口,也不意味着全文注入一定是最合理的选择。
3.2 方案二:把文件作为资源,通过 Tool 读取
另一种方式,是只向 Agent 提供文件清单和工具能力。
例如 Context Builder 为模型构建以下信息:
当前会话关联文件:
– file_id: file_123
– 文件名:招标文件.pdf
– 类型:PDF
– 页数:300
– 解析状态:ready
可用工具:
– get_file_outline:获取文件章节目录
– read_file:读取指定页或章节
– search_file:搜索文件相关内容
当用户询问:
这份招标文件对设备验收有哪些要求?
模型可以选择调用:
{
"name": "search_file",
"arguments": {
"file_id": "file_123",
"query": "设备验收标准、验收条件"
}
}
Runtime 执行工具,从之前解析的内容或检索索引中取出相关结果:
{
"file_id": "file_123",
"matches": [
{
"page": 86,
"section": "5.3 验收标准",
"content": "设备应满足……"
},
{
"page": 91,
"section": "5.5 验收流程",
"content": "验收前应提交……"
}
]
}
这些内容通过 Tool Result 返回给模型,模型再结合用户问题生成答案。
这套方案的关键价值在于:Agent 不必每次都拿到文件全文,而是根据当前任务获取需要的内容。
需要注意,read_file 和 search_file 的能力边界不同。
read_file 更像文件访问接口,可以读取指定页码、章节、行号或内容区域;search_file 则通常依赖全文检索、向量检索或混合检索来定位相关信息。
Tool 不等于 RAG。即使没有向量数据库,也完全可以实现文件读取工具。
另外,文件工具应复用已保存的解析结果,而不是每次被调用都重新解析原始 PDF。
3.3 两种方案究竟怎么选?
| 首次模型调用 | 已包含文件正文 | 通常先包含文件信息 |
| 工具调用开销 | 无 | 可能增加模型调用轮次 |
| Token 控制 | 取决于注入内容长度 | 可以按需读取 |
| 小文件总结 | 更合适 | 往往没必要 |
| 长文档定向问答 | 不够经济 | 更合适 |
| 多文件检索 | 上下文占用较大 | 更容易扩展 |
| 全文审查 | 需要分段组织上下文 | 需要系统性遍历,不能只靠 Top-K |
实际架构设计中,我更倾向于采用混合方案:
小文件直接注入,大文件通过工具读取,复杂结构化数据交给专用执行环境。
但还需要补充一点:文件长度不应该是唯一判断条件。
例如,用户让 Agent 审查整份合同是否存在遗漏,仅通过 search_file 检索几个相关 Chunk 并不能证明全文都被覆盖。此时应考虑按章节遍历、逐段审查、汇总校验。
也就是说,文件消费策略还需要结合任务类型,而不只是简单比较文件 Token 数量。
四、真正应该设计的是 Context Builder
如果要开发一套通用的 Agent Runtime,不建议把文件处理逻辑直接写进模型调用函数。
更合理的做法是引入一个独立的 Context Builder,负责决定本轮模型需要接收哪些附件内容、文件引用和可用工具。
例如:
type AttachmentMode =
| "inline"
| "tools"
| "native"
| "sandbox";
type AttachmentTask =
| "general"
| "search"
| "compute"
| "visual";
type FileAsset = {
id: string;
filename: string;
mimeType: string;
parsedReady: boolean;
estimatedTokens?: number;
};
function chooseAttachmentMode(
file: FileAsset,
task: AttachmentTask,
remainingTokens: number,
supportsNativeFile: boolean
): AttachmentMode {
const isSpreadsheet =
file.mimeType.includes("spreadsheet") ||
file.mimeType === "text/csv";
// 需要精确计算的表格任务
if (isSpreadsheet && task === "compute") {
return "sandbox";
}
// 适合原生多模态输入的文件
if (task === "visual" && supportsNativeFile) {
return "native";
}
// 短文本且解析已完成
const inlineBudget = Math.min(
4000,
Math.floor(remainingTokens * 0.25)
);
if (
task === "general" &&
file.parsedReady &&
file.estimatedTokens !== undefined &&
file.estimatedTokens <= inlineBudget
) {
return "inline";
}
return "tools";
}
这段代码展示的是策略思路,而不是完整的生产实现。文件格式支持、模型能力、具体任务以及解析状态,都还需要更细致的判断。
其中 inlineBudget 是经验性的初始阈值,可以根据真实模型能力、会话上下文预算和使用成本进行调整。
Context Builder 根据策略做不同处理:
- inline:读取解析结果并放入模型上下文。
- tools:放入文件清单,开放读取或检索工具。
- native:将文件映射成模型 API 支持的多模态内容块。
- sandbox:将文件映射到受控执行环境,允许 Agent 调用代码处理。
这种架构让 Agent Runtime 不必依赖特定文件解析库,也不必感知底层是 MinIO、S3 还是本地存储。
而且以后接入不同的 Agent Framework,只需要适配消息结构和工具接口,文件处理能力就可以复用。
五、复杂文件场景,为什么不能都交给 RAG?
很多团队在实现附件能力时,会采用一条看似通用的链路:
上传文件 → 文档解析 → Chunk → Embedding → 向量数据库 → RAG
这个方案并没有问题,但它只解决了一部分场景。
比如用户上传一份 300 页的投标文件,要求查询其中的质保条款,RAG 很合适。
但如果用户要求:
把这份文件中的所有验收要求整理成表格,一个都不能遗漏。
此时只检索 Top-K Chunk,就可能漏掉没有被召回的条款。
更合理的做法是先读取文档目录,再按章节或页码范围批量处理,最后汇总、去重并校验覆盖范围。
再看 Excel。
假设用户上传一份包含十万行订单的工作簿,要求计算每个月的订单增长率。
把 Excel 转成文本再做向量检索,显然不是好的处理方法。
Agent 应该通过专用工具让 Python 执行计算:
import pandas as pd
df = pd.read_excel(
"orders.xlsx",
sheet_name="订单明细"
)
df["日期"] = pd.to_datetime(df["日期"])
df["月份"] = df["日期"].dt.to_period("M")
monthly = (
df.groupby("月份")["订单金额"]
.sum()
.sort_index()
)
growth = monthly.pct_change() * 100
print(growth)
实际运行中还需要对数据类型、缺失值、异常日期和除零情况进行处理。
同一份附件,可能需要完全不同的使用方式:
| 总结两页 Word | 直接解析并注入 |
| 查找长 PDF 中的验收条款 | 解析 + 检索工具 |
| 全面审查 300 页合同 | 目录遍历 + 分段处理 |
| 计算 Excel 销售增长率 | Python 沙箱 |
| 解释 PDF 中的系统架构图 | 多模态模型 |
| 跨多个附件对比技术参数 | 结构化抽取 + 汇总比对 |
所以,一套通用的 Agent 文件能力,不应该只有一个 Document Extractor,更不应该让所有附件都无条件进入向量数据库。
六、主流平台的公开实践
从各家官方 API 和开发文档来看,文件使用方式并没有统一成某一种模式,而是同时存在文件输入、工具调用和检索增强等不同能力。
这里讨论的是公开的产品接口和设计机制,并非推断各家聊天产品未公开的内部架构。
OpenAI:直接文件输入与文件检索并存
OpenAI 的 Responses API 支持通过 input_file 向模型提供文件。对于支持视觉的模型,PDF 输入可以同时包含提取的文本与页面图像。
对于大型文档,可以使用 File Search,通过 Vector Store 实现语义与关键词检索。需要复杂表格计算时,官方也提供相应的代码执行能力。
这种设计说明了一个问题:文件进入模型,不一定需要先经过开发者自己实现的文档解析服务,也不一定必须做 RAG。
官方文档:File Inputs
官方文档:File Search
Anthropic Claude:Files API 管理文件引用
Claude 的 Files API 支持上传文件后获得 file_id,并在后续 Messages 请求中复用文件。
它将文件上传和模型调用解耦,同时允许不同类型的文件进入文档理解或代码执行流程。
值得注意的是,Anthropic 在文档中明确强调,应用不能直接信任用户提交的供应商文件 ID,而应该自行维护用户与文件的权限映射。
这也是企业级 Agent 文件服务必须考虑的问题。
官方文档:Claude Files API
Google Gemini:原生文件输入与 File Search
Gemini 支持通过 Files API 上传文件,再通过文件引用进行模型调用。
它也提供 File Search,可以导入、分块、索引文件,并根据用户问题检索相关内容。
这同样体现了直接使用文件和通过索引检索文件是两种不同的能力。
官方文档:Gemini File Search
Dify:附件输入和文档提取分离
Dify 提供了更直观的工作流实现方式。
用户通过输入节点上传文件,Document Extractor 节点负责提取文本,再将结果交给后续 LLM 节点使用。
这是典型的解析后注入模式。与此同时,Dify 还提供知识检索等独立节点,用于处理需要检索增强的场景。
它的参考价值在于,文件输入、内容提取和模型推理是可组合的独立环节。
官方文档:Dify Document Extractor
综合这些公开能力,可以看到一个清晰的工程方向:
文件作为可管理、可复用的资源存在,模型通过合适的输入机制、检索工具或执行环境使用这些资源。
七、生产环境中,还有几个问题必须解决
实际落地时,最容易出问题的往往不是如何读取 PDF,而是文件资源的状态、权限和复用机制。
第一,解析结果需要持久化,避免重复解析。
文件第一次解析完成后,可以保存原始文件哈希、解析器版本、结构化结果和索引状态。
当用户在第二轮继续询问同一份文件时,不需要重新执行 OCR 或 MinerU,而是直接读取已有结果。
第二,文件权限检查必须在工具执行层完成。
假设 Agent 调用:
{
"name": "read_file",
"arguments": {
"file_id": "file_456"
}
}
不能因为 file_id 存在就允许读取。工具执行器必须检查当前用户、租户或 Run 是否有权访问该资源。
模型生成的工具参数应被视为不可信输入。
第三,不能只保留解析后的纯文本。
对于需要可追溯结论的业务场景,文件内容最好携带页码、章节、Sheet、单元格等来源信息。
这样 Agent 才能在回答中说明:
根据《招标文件》第 86 页第 5.3 节,设备验收需满足……
否则即使回答正确,也很难让用户核对依据。
第四,需要管理文件解析状态。
大文件解析通常需要异步执行,例如:
uploaded
↓
validating
↓
processing
↓
ready / failed
聊天界面可以通过 SSE 或其他状态通道展示解析进度。Agent 不必在所有情况下都等待全文解析完成,但在真正读取尚未就绪的内容时,需要处理等待、失败重试或降级策略。
第五,附件不能直接改变 Agent 的系统指令。
文件内容属于外部数据,可能包含提示注入。无论是注入上下文还是作为 Tool Result 返回,都应该建立明确的数据与指令边界,并限制文件内容能够影响的工具权限。
此外,还要管理文件保留期限、索引删除、临时沙箱清理和敏感信息泄露风险。
八、最终应该采用什么架构?
如果从零设计一套企业级 Agent 文件处理能力,我更推荐将系统拆分为四个部分。
File Service 负责文件上传、存储、权限和生命周期管理。
Document Processing Service 负责不同格式的解析,以及结构化内容和检索索引的生成。
File Tools 提供 read_file、search_file、get_file_outline、analyze_spreadsheet 等统一访问能力。
Agent Runtime / Context Builder 则负责在每一轮推理前,根据任务、文件类型、文件状态和上下文预算,选择合适的文件使用方式。
这些能力之间可以独立演进。
例如以后需要替换 MinerU,不应该影响 Agent Runtime;将 Milvus 替换成其他检索系统,也不应该改变用户消息结构;新增 Excel 分析能力,则只需要扩展文件工具和路由策略。
从数据模型上,也建议区分:
- FileAsset:文件本身。
- ParsedDocument:文件的结构化解析结果。
- DocumentIndex:可选的检索索引。
- MessageAttachment:文件与消息的关联。
- AgentFileAccess:Agent Run 被授权访问的文件资源。
这样的设计不仅能支持聊天附件,也能进一步支持知识库、Skill、子 Agent 和复杂工作流复用文件资源。
结语
Agent 聊天框中的附件处理,表面上只是一个文件上传功能,实际上涉及文件系统、文档解析、上下文管理和 Agent 工具调用之间的协作。
回到最开始的问题:
解析后的文本到底应该直接注入 Agent,还是提供读取文件的工具?
我的答案是,不应该固定选择其中一种。
对于短文档,解析后直接注入可以减少工具调用、降低执行复杂度;对于大文档,通过 read_file、search_file 按需读取,更利于控制上下文和成本;对于 Excel、复杂 PDF 或其他多模态文件,则应该结合结构化执行工具或模型原生能力。
真正需要统一的,不是文件进入模型的单一方式,而是文件资源的管理与访问接口。
文件解析负责把内容变成可用资源,File Tools 负责提供访问能力,Context Builder 负责决定怎样把内容交给模型,而 Agent Runtime 负责组织整个执行过程。
把这几个职责分清楚,附件处理就不再是一个附着在聊天框上的特殊功能,而能够演进成一套可复用的 Agent 文件基础设施。