从 printf 到磁盘的完整链路
一、引言:先看几个"反直觉"的现象
在正式讲原理之前,先看几个几乎每个 C/C++ 开发者都踩过的坑:
这些现象的根因都是同一个东西——缓冲区(Buffer)。
Linux 的 I/O 缓冲不是一层,而是两层:
- 用户态缓冲区:C 标准库(glibc)维护的 stdio 缓冲区;
- 内核态缓冲区:内核维护的页缓存(Page Cache)。
本文从"为什么需要缓冲"讲起,逐层拆解这两层缓冲的结构体、工作流程、刷新时机、相关 API,最后给出性能调优、经典坑和面试题。
二、前置知识:系统调用、库函数与状态切换
2.1 两类 I/O 接口
Linux 下的 I/O 接口分两类:
|
系统调用 I/O (低级 I/O) |
open/read/write/close/lseek | 用户态 → 内核态 | 无用户态缓冲,直接操作文件描述符 fd |
|
标准 I/O (stdio,高级 I/O) |
fopen/fread/fwrite/fclose/printf | 用户态(库内封装系统调用) | 带用户态缓冲区,最终还是调用 read/write |
标准 I/O 是在系统调用外面包了一层缓冲,关系如下:
fwrite() / printf()
└── 数据先进入 glibc 的 stdio 缓冲区
└── 缓冲区满 / 刷新时,调用 write()
└── 进入内核 Page Cache
2.2 为什么用户态到内核态的切换很"贵"
调用 read/write 这类系统调用时,CPU 要从用户态(Ring 3)陷入内核态(Ring 0),需要:
- 保存用户态寄存器、程序现场;
- 切换内核栈;
- 校验参数、权限;
- 执行完再恢复现场返回。
一次系统调用的开销在几百纳秒到微秒级。
如果每次写一个字符都触发一次系统调用,性能会差到无法接受。
用户态缓冲区的核心价值,就是把成百上千次小写攒成一次 write()。
2.3 为什么需要缓冲:三个根本原因
三、缓冲区全景架构
先建立整体认知,下图是一次写操作经过的完整路径,注意 fflush 和 fsync 各自的作用边界: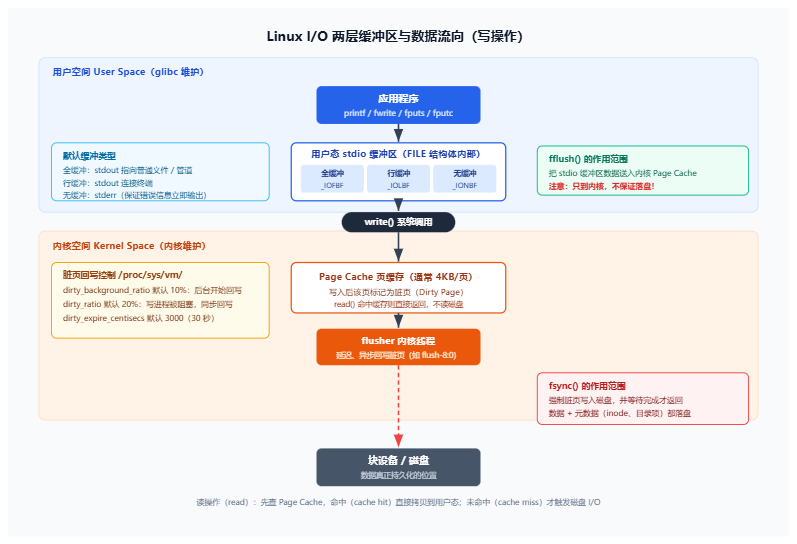
四、第一层:用户态 stdio 缓冲区
4.1 FILE 结构体内部到底有什么
fopen() 返回的 FILE *,本质是 glibc 中 struct _IO_FILE 的指针,它的核心字段如下:
struct _IO_FILE {
int _flags; // 状态标志(缓冲类型、EOF、错误等)
char* _IO_read_ptr; // 读指针:当前读到的位置
char* _IO_read_end; // 读区结束
char* _IO_read_base; // 读区起始
char* _IO_write_base; // 写区起始
char* _IO_write_ptr; // 写指针:当前写到的位置
char* _IO_write_end; // 写区结束
char* _IO_buf_base; // 缓冲区起始地址
char* _IO_buf_end; // 缓冲区结束地址
int _fileno; // 底层文件描述符 fd
…
};
可以看到,一个 FILE 里同时维护了读指针、写指针、缓冲区起止地址和底层 fd。 fwrite 就是往 _IO_write_ptr 指向的位置拷数据并移动指针,指针到达 _IO_buf_end 时触发真正的 write()。
4.2 缓冲区是"延迟分配"的
一个容易被忽略的细节:
fopen() 时并不会立刻分配缓冲区。
缓冲区是在第一次真正读写时才由库 malloc 出来的(懒分配)。
这也解释了为什么 setvbuf 必须在任何 I/O 操作之前调用——要在库自己分配缓冲区之前,把你指定的缓冲区装好。
4.3 三种缓冲类型详解
| 全缓冲 | _IOFBF | 缓冲区满、fflush、fclose、正常退出 | stdout 指向普通文件、管道、设备文件(非终端) |
| 行缓冲 | _IOLBF | 遇到 \\n、缓冲区满、fflush | stdin/stdout 连接终端(tty) |
| 无缓冲 | _IONBF | 不缓冲,数据立即通过 write 发出 | stderr |
关键结论:stdout 是行缓冲还是全缓冲,取决于它连接的是不是终端。
- 终端里直接运行:行缓冲,printf("a\\n") 立即显示;
- ./a.out > log.txt 重定向、cmd | cmd 管道、nohup、daemon:全缓冲,要攒满才输出。
而 stderr 固定无缓冲,是为了保证程序崩溃前的错误信息(比如 perror)一定能输出,不会卡在缓冲区里。
4.4 缓冲区大小
- 宏 BUFSIZ:glibc 中通常是 8192 字节,是 setbuf 使用的缓冲区大小;
- 全缓冲实际大小通常取文件系统的 st_blksize(一般 4096),glibc 也可能使用 8192;
- 可以通过 setvbuf 自定义任意大小。
4.5 stdio 缓冲区刷新(flush)时机全总结
输出缓冲区被刷新的所有情况:
注意:
_exit() / _Exit() 直接陷入内核结束进程,不经过标准库退出清理,不刷新 stdio 缓冲区。
4.6 设置缓冲的四个函数对比
void setbuf(FILE *stream, char *buf);
void setbuffer(FILE *stream, char *buf, size_t size);
void setlinebuf(FILE *stream);
int setvbuf(FILE *stream, char *buf, int mode, size_t size);
| setbuf(fp, buf) |
buf 为非 NULL:setvbuf(fp, buf, _IOFBF, BUFSIZ); 为 NULL:setvbuf(fp, NULL, _IONBF, 0) |
|
setbuffer (fp, buf, size) |
setvbuf(fp, buf, _IOFBF, size) |
| setlinebuf(fp) | setvbuf(fp, NULL, _IOLBF, 0) |
| setvbuf(…) | 最通用,可指定模式和大小,其他三个都是它的封装 |
使用示例:
#include <stdio.h>
int main() {
static char buf[BUFSIZ]; // 必须在流的生命周期内有效,用 static
setvbuf(stdout, buf, _IOFBF, BUFSIZ); // 全缓冲
// setvbuf(stdout, NULL, _IOLBF, 0); // 行缓冲
// setvbuf(stdout, NULL, _IONBF, 0); // 无缓冲
printf("hello");
getchar(); // 阻塞,观察屏幕上是否已出现 hello
return 0;
}
4.7 fflush 详解
int fflush(FILE *stream);
- fflush(fp):把输出流缓冲区中尚未送出的数据通过 write() 送入内核;
- fflush(NULL):刷新所有打开的输出流;
- fflush(stdin):C 标准中这是未定义行为,但在 glibc 上会丢弃输入缓冲区中尚未读取的数据(可用于清空 scanf 残留)。
最重要的一点:
fflush 只保证数据从用户态进入内核 Page Cache,不保证落盘。要落盘必须 fsync。
4.8 输入缓冲区(stdin)
输入同样有缓冲。
比如你用 fgetc 读一个字符,库实际上会一次性 read 一整块数据到 stdio 缓冲区,然后一个一个返回,避免每个字符都系统调用。
这也带来一个经典问题:
scanf("%d", &n) 之后,回车 \\n 会残留在输入缓冲区里,紧接着的 gets/fgets 会读到一个空行,需要手动清空:
int c;
while ((c = getchar()) != '\\n' && c != EOF); // 清空 stdin 残留
4.9 标准 I/O vs 系统调用 I/O 对比
| 用户态缓冲 | 有 | 无 |
| 系统调用次数 | 少(缓冲合并) | 每次调用都陷入内核 |
| 可移植性 | 好(C 标准) | 偏 POSIX |
| 适用场景 | 普通应用、小数据量、频繁读写 | 追求极致控制、大文件、特殊标志 |
| 标识 | FILE * | 文件描述符 int fd |
五、第二层:内核态 Page Cache
5.1 Page Cache 是什么
内核会把空闲的物理内存利用起来,以**页(Page,通常 4KB)**为单位缓存磁盘文件的内容,这就是 Page Cache。
它对所有进程共享,是 Linux 性能的核心机制之一。
5.2 Page Cache 的组织:address_space
每个被缓存的文件(inode)在内核里对应一个 address_space 结构,它内部用 xarray(旧内核是 radix tree) 管理该文件的所有缓存页,通过文件偏移就能快速找到对应页是否在缓存中。
5.3 写流程:缓冲写 / 延迟写
调用 write(fd, buf, len) 时:
这种策略叫延迟写(write-back / delayed write)。
5.4 读流程:命中、未命中与缺页
调用 read(fd, buf, len) 时:
这就是程序第一次读文件慢、第二次读飞快的原因。
5.5 预读机制(readahead)
内核检测到你在顺序读文件时,会"投机地"把后面还没请求的页也提前读进 Page Cache(预读窗口),等你真的读到时数据已经在内存里了。
随机读时预读会被收窄以避免浪费。
5.6 脏页与回写
脏页不会一直留在内存,内核会在合适时机把它们刷回磁盘。
脏页的生命周期和回写触发条件如下: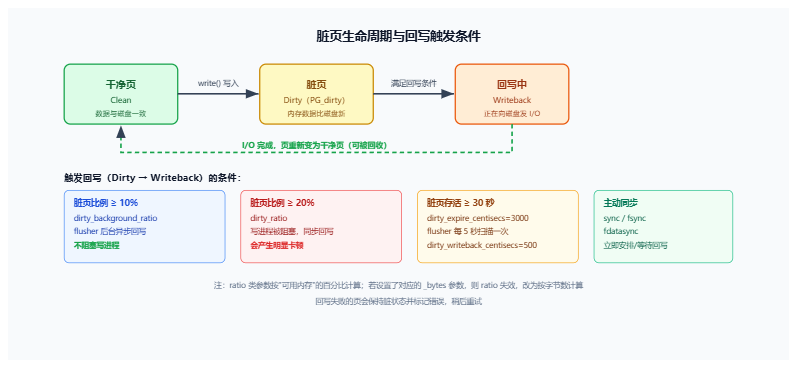
5.7 flusher 内核线程
- 早期内核(2.6 之前)使用统一的 pdflush 线程池;
- 较新内核(2.6.32 之后)为**每个块设备(backing device)**分配一个独立的 flusher 线程,名字形如 flush-8:0(8:0 是设备的主:次设备号,sda 通常就是 8:0);
- 它周期性唤醒(默认 5 秒),扫描并回写过期或超比例的脏页。
可以用 ps -ef | grep flush 看到这些线程。
5.8 回写相关参数详解
| dirty_background_ratio | 10 | 脏页占可用内存百分比达到该值,后台异步回写 |
| dirty_background_bytes | 0 | 按字节限定,非 0 时上面的 ratio 失效 |
| dirty_ratio | 20 | 达到该值,写进程被阻塞并同步回写 |
| dirty_bytes | 0 | 同上,按字节 |
| dirty_writeback_centisecs | 500 | flusher 周期性唤醒间隔(5 秒) |
| dirty_expire_centisecs | 3000 | 脏页过期时间(30 秒),过期必须回写 |
| dirtytime_expire_centisecs | 432000 | 仅因时间戳(atime/mtime)变脏的页,最长 12 小时回写 |
| laptop_mode | 0 | 笔记本模式,尽量减少磁盘转动次数 |
5.9 Buffer Cache 与 Page Cache 的关系
- 早期内核中两者独立:Page Cache 缓存文件内容(页),Buffer Cache 缓存块设备的磁盘块(元数据);
- 从 Linux 2.4 起,Buffer Cache 被合并进 Page Cache,通过 buffer_head 描述,不再是独立内存区域;
- free / /proc/meminfo 里的 Buffers 和 Cached 只是两种统计口径。
5.10 缓存回收:kswapd 与 LRU
当内存紧张时,内核需要回收 Page Cache:
- 干净页:直接丢弃即可(以后需要再从磁盘读);
- 脏页:必须先回写成干净页才能回收;
- 由 kswapd 守护进程后台执行,页面挂在 LRU 链表(active / inactive 两级)上,按活跃度淘汰;
- vm.swappiness(0-100)控制回收时"换出匿名页到 swap"与"回收文件缓存"的倾向,值越大越倾向用 swap。
5.11 内核中的其他缓存
除了 Page Cache,内核还有几类常见缓存:
- dentry cache(目录项缓存):缓存路径名到 inode 的解析结果;
- inode cache:缓存 inode 对象;
- slab 缓存:小对象(task_struct、inode、dentry 等)的对象池,slabtop 可查看。
六、同步与落盘:sync / fsync / fdatasync
6.1 三个同步函数的区别
| sync() | 把内核中所有脏页/脏 inode 安排回写;Linux 上通常会等待回写完成 |
| fsync(fd) | 该文件的数据 + 全部元数据(大小、mtime、权限、目录项等)落盘后才返回 |
| fdatasync(fd) | 数据落盘;元数据只刷"后续正确读取所必需"的部分(如文件变大必须更新的元数据),不刷 mtime 这类 |
fdatasync 比 fsync 快的原因:
像修改时间戳这种不影响读取正确性的元数据,它不要求刷盘,从而可能少一次元数据 I/O。
6.2 open 时的同步标志
| O_SYNC | 每次 write() 都等数据 + 元数据落盘(相当于每次 write 后 fsync) |
| O_DSYNC | 每次 write 等数据落盘(fdatasync 语义) |
| O_DIRECT | 绕过 Page Cache,数据在用户缓冲区和设备间直接 DMA |
| O_NOATIME | 读文件时不更新 atime,减少无谓的元数据写 |
| O_APPEND | 保证每次写都追加到文件末尾 |
6.3 O_DIRECT 的对齐要求
使用 O_DIRECT 时必须满足对齐,否则报错:
- 用户缓冲区的内存地址按逻辑块大小对齐;
- 每次读写的长度是块大小的整数倍;
- 文件偏移量按块大小对齐。
块大小通常是 512B 或 4KB。数据库(MySQL、Oracle)常用 O_DIRECT 自己管理缓存,避免与 Page Cache 双重缓存。
6.4 可靠写的代码示例
#include <fcntl.h>
#include <unistd.h>
int fd = open("data.txt", O_WRONLY | O_CREAT, 0644);
write(fd, buf, len);
fsync(fd); // 关键:确保数据真正落盘
close(fd);
七、mmap:另一种与 Page Cache 交互的方式
mmap 把文件直接映射到进程的用户地址空间,之后对这块内存的读写直接作用于 Page Cache,省去了 read/write 中"用户态 ↔ 内核态"的一次数据拷贝:
char *p = mmap(NULL, len, PROT_READ | PROT_WRITE, MAP_SHARED, fd, 0);
p[0] = 'x'; // 直接写 Page Cache,页变脏
msync(p, len, MS_SYNC); // 类似 fsync,确保落盘
munmap(p, len);
注意 MAP_PRIVATE 是写时复制(COW),修改不会写回文件;
MAP_SHARED 的修改才会进入 Page Cache 并最终落盘。
八、完整数据流总结
写路径:
printf/fwrite
→ 拷贝到用户态 stdio 缓冲区
→ 满足刷新条件(满/换行/fflush/exit)
→ write() 系统调用
→ 拷贝到内核 Page Cache,标记脏页
→ flusher 在比例/超时/主动同步时回写
→ 磁盘(数据持久化)
读路径:
fread/printf 输入
→ stdio 缓冲区有数据就直接返回
→ 否则 read() 系统调用
→ 查 Page Cache:命中直接拷贝;未命中(可能预读)从磁盘读入
→ 拷贝到用户态
九、性能调优实践
十、经典坑与代码验证
10.1 fork 后输出重复
一、完整代码
#include <stdio.h>
#include <string.h>
#include <unistd.h>
int main() {
const char *msg0 = "hello printf\\n";
const char *msg1 = "hello fwrite\\n";
const char *msg2 = "hello write\\n";
printf("%s", msg0);
fwrite(msg1, strlen(msg0), 1, stdout);
write(1, msg2, strlen(msg2));
fork();
return 0;
}
两种运行方式,结果完全不同:
./hello # 终端运行,输出 3 行
./hello > file # 重定向到文件,输出 5 行,且顺序变了
二、终端运行:stdout 是行缓冲
stdout 连接终端时为行缓冲,遇到 \\n 立即刷新:
最终输出(3 行):
hello printf
hello fwrite
hello write
三、重定向到文件:stdout 变成全缓冲
一旦 > file,stdout 指向普通文件,变成全缓冲,缓冲区没满就不刷:
最终文件内容(5 行,write 在最前):
hello write
hello printf
hello fwrite
hello printf
hello fwrite
四、两种场景缓冲区状态对比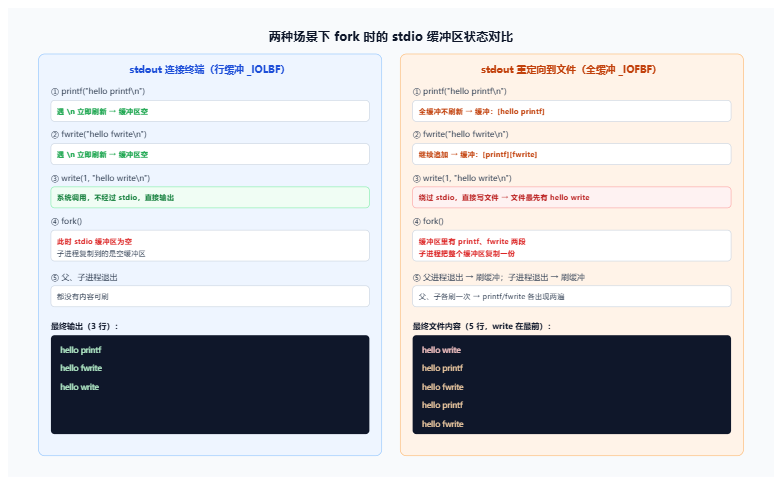
五、三个核心考点
10.2 daemon / 管道中 printf 不显示
stdout 脱离终端变成全缓冲。解决:
setvbuf(stdout, NULL, _IOLBF, 0);
10.3 fflush 后掉电仍丢数据
fflush 只到内核,要 fsync 才落盘。
10.4 _exit 导致 printf 内容消失
printf("hello");
_exit(0); // 不刷 stdio 缓冲,什么都不输出
10.5 scanf 残留换行
scanf 后 fgets 读到空行,需要清空 stdin 缓冲区。
10.6 写文件掉电后 0 字节 / 旧内容
数据还在 Page Cache 没落盘,或文件大小等元数据没刷盘,需要 fsync,且必要时对所在目录也 fsync(保证新建的目录项落盘)。
十一、调试与查看命令
# 看实际系统调用,验证 stdio 缓冲的合并效果
strace -e trace=read,write ./a.out
# 实时看脏页数量
watch -n 1 'grep -i dirty /proc/meminfo'
# 内存与缓存
free -h
cat /proc/meminfo
# I/O 与上下文切换(bi/bo 为块设备读/写)
vmstat 1
# 查看 flusher 线程
ps -ef | grep flush
# slab 缓存
slabtop -o | head -20
# 手动回写 / 释放缓存
sync
echo 3 > /proc/sys/vm/drop_caches
十二、面试题(含答案)
1. printf 的数据一定会立刻打印到屏幕吗?
不一定。stdout 连接终端时是行缓冲,遇 \\n 才刷;
重定向到文件/管道时是全缓冲,要攒满、fflush 或程序退出才输出。
2. fflush 和 fsync 的区别?
fflush 是用户态操作,把 stdio 缓冲区数据通过 write 送入内核 Page Cache;
fsync 是系统调用,强制内核把数据和元数据写到磁盘并等待完成。fflush 不保证落盘。
3. 三种缓冲类型分别是什么?默认场景?
全缓冲(_IOFBF,普通文件)、
行缓冲(_IOLBF,终端)、
无缓冲(_IONBF,stderr)。
4. 为什么 fork 后 printf 可能输出两次?怎么避免?
缓冲时 printf 的内容还在用户态缓冲区,fork 使子进程复制了该缓冲区,父子退出时各刷一次。
fork 前 fflush 即可避免。
5. write() 成功返回,数据落盘了吗?
没有。write 通常只把数据写入 Page Cache 并标记脏页就返回,由 flusher 延迟落盘。要确保落盘用 fsync。
6. free 里的 buff/cache 是内存被占用了吗?
不是。它是内核利用空闲内存做的缓存,应用需要时可立即回收。
判断内存是否够用看 available 列,而不是 free。
7. 如何保证关键数据真正写到磁盘?
调用 fsync(数据+元数据)或 fdatasync(数据+必要元数据),或用 O_SYNC/O_DSYNC 打开文件。
新建文件还需对父目录 fsync 保证目录项落盘。
8. fsync 和 fdatasync 的区别?为什么后者更快?
fsync 刷数据和全部元数据;
fdatasync 只刷数据和后续读取必需的元数据,不刷 mtime 等非必需元数据,可能少一次 I/O。
9. Page Cache 的优缺点?
优点:减少磁盘 I/O、读写加速、合并请求、预读;
缺点:掉电会丢未回写数据、脏页集中回写可能造成卡顿、占用内存(但可回收)。
10. O_DIRECT 的作用和限制?
绕过 Page Cache,直接在用户缓冲区和设备间 DMA。
要求缓冲区地址、长度、偏移按块大小对齐,数据库常用。
11. exit 和 _exit 的区别?
exit 是标准库函数,会执行 atexit 钩子、刷新 stdio 缓冲、关闭流;
_exit 直接陷入内核结束进程,不刷缓冲。
子进程通常用 _exit 避免重复刷父进程缓冲区。
12. 脏页达到多少比例会触发回写?进程什么时候会被阻塞?
默认脏页达可用内存 10%(dirty_background_ratio)时 flusher 后台异步回写;
达 20%(dirty_ratio)时写进程被阻塞,同步回写。
13. 标准 I/O 和系统调用 I/O 的区别?
标准 I/O(fread/fwrite)有用户态缓冲,系统调用次数少、可移植性好;
系统调用 I/O(read/write)无用户态缓冲、每次都陷入内核,但控制更直接。
14. mmap 写文件会经过 Page Cache 吗?
会。MAP_SHARED 下对映射内存的写直接作用于 Page Cache 并标记脏页,省掉一次用户态与内核态间的数据拷贝,用 msync 确保落盘。
15. 脏页内存紧张时怎么回收?
干净页直接丢弃;
脏页必须先回写成干净页再回收。
由 kswapd 基于 LRU 执行,swappiness 控制文件缓存回收与 swap 的倾向。
16. 读文件时什么是预读?
内核发现顺序读时,会提前把后续页读入 Page Cache,等进程请求时直接命中内存;
随机读时收窄预读。
17. 为什么 stderr 要是无缓冲?
保证错误信息(尤其崩溃前)能立即输出,不会因缓冲区未刷新而丢失。
总结
Linux 的 I/O 缓冲是一条两级漏斗:
- 用户态 stdio 缓冲由 glibc 维护,目的是减少系统调用次数,分全缓冲、行缓冲、无缓冲三种,fflush 是这一层的出口;
- 内核态 Page Cache由内核维护,目的是匹配内存与磁盘的速度差,write 进去即标记脏页,由 flusher 线程延迟异步落盘,fsync 是强制落盘的手段。