/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
一.Linux线程概念
1.1.什么是线程
概念角度(感性理解线程)
教材上:
进程 = 内核数据结构 + 代码和数据(执行流),进程会被CPU调度,也是要被CPU 执行,完成某些任务
线程是进程内部的一个执行分值(执行流)
在内核和资源角度上:
进程:承担分配系统资源的基本实体
线程:CPU调度的基本单位
进程肯定会消耗一部分CPU资源。但是进程访问的部分资源,都是通过地址空间访问的,地址空间是“窗口”,但是如果我创建一个“进程”,但是和原本的进程共享窗口——也就是地址空间,将资源分配给不同的task_struct,这样就用进程模拟出来线程了
结论:
单进程:一种特殊情况
线程的描述结构体叫做TCB
社会分配资源的基本实体是家庭(对应进程),家庭内部的具体人员对应线程,进程强调独占,部分会共享(比如通信的时候),线程强调共享,部分独占
理性角度,理解资源划分(虚拟到物理地址,页表,页表相关的概念,部分内存管理的理解)
磁盘里面有分区,分区里面还有分组,磁盘的最小存储单元是4KB,可执行程序就是文件,文件就在磁盘存储,物理内存也是按4KB、4KB进行管理的。我们一般把这个4KB的存储单元叫做页框或者页帧。4KB是操作系统划分的,在内核中描述这个4KB的结构体叫做struct page,我们就可以以此设置一个数组。
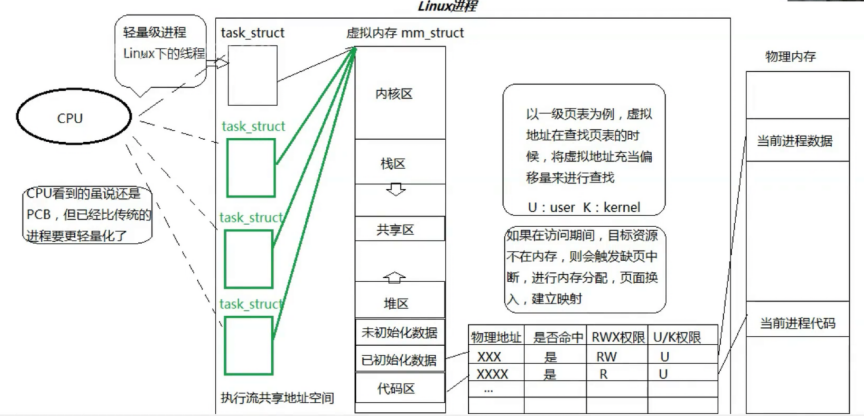
在struct file里面有一个struct address_space*mapping,address space里面有一个radix_tree_root page_tree,这个是一个数据结构,会管理内存缓冲区
在系统上使用虚拟地址是有讲究的,如果虚拟地址是32位的,一般就是前10个,中10个,后12个分别是一个单位。前10个比特位的索引是页目录,页目录存着1024个页表项(下级页表的具体地址——更像是数组下标),中间10位的是索引是页表,页表放一个个页(框)的地址(更像是数组下标),最后12位就是找到目标页(框)后,具体的第几字节。,每一个页框都是有4KB大
查页表的完整流程:1.先查到虚拟地址对应的页框 2.根据虚拟地址的第12位,作为页内便宜,访问具体字节。
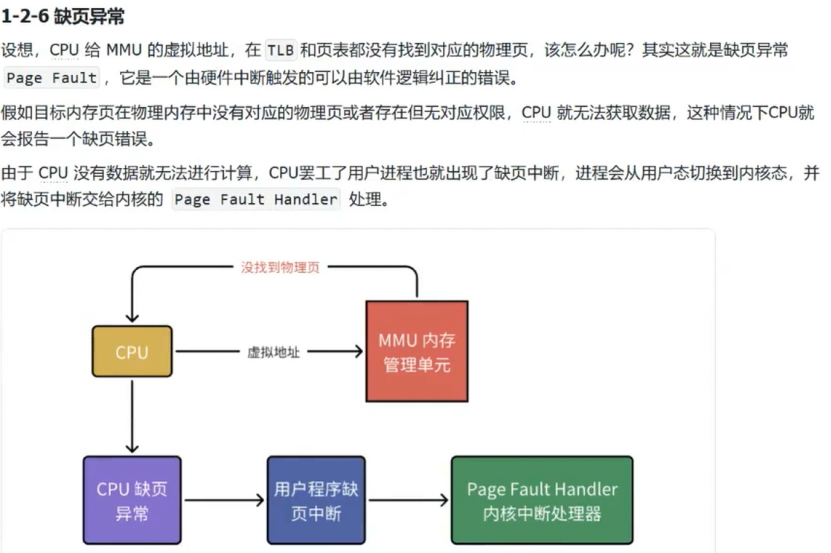
CPU内部有一个CR3寄存器,这个寄存器指向当前PCB的虚拟地址的页目录起始物理地址,CR3也叫做当前进程的硬件上下文。然后CPU还有一个MMU,负责物理和虚拟地址的转换。
细节:
进程看到的资源,本质是:在合法的情况下,你拥有多少虚拟地址,虚拟地址是资源的代表!!!虚拟地址空间mm_struct + vm_struct本质:进行资源的统计数据和整体数据,页表是一张虚拟到物理的地图
资源划分:本质就是地址空间划分,资源共享:本质就是虚拟地址的共享
线程的深刻理解
线程进行资源划分:本质是划分地址空间,获得一定范围的合法虚拟地址,就是在划分页表
线程进行资源共享:本质是对地址空间的共享,就是对页表条目的共享
1.2.分页式存储管理
首先,如果是32位地址,虚拟地址和对应的物理地址的后12位其实是一样的,都代表在一个页框内的偏移量,但是前20位不一样,这是由于物理地址和虚拟地址的编码规则不一样导致的:
物理地址就是顺序编码,而虚拟地址更像是一个树形编码
但是虚拟地址不是,首先,一个进程有一个页目录,页目录有1024个单元,每一个单元大小是32比特位,存放的是一个页表的物理基地址(不完全是物理地址,因为页表大小也是4KB,所以页表的开头的物理地址的后12位一定全是0,可以不用放,我们就可以存放属性恶化权限控制位,至于前面的20位就对应着物理地址了),虚拟地址的前10位就对应在页目录的下标。
而页表有啥,页表也有1024个单元,每一个单元被称作页表项,一个页表项大小也是32位比特位,也就是说,一个页表的大小是4*1024也就是4KB,刚好对应一个数据块。
虚拟地址的中间10位就对应着第几个页表项,一个页表存放着目标物理地址的物理基地址(因为目标物理地址的后12位和虚拟地址的后12位是一样的,所以这12位我们可以放权限控制位,至于前20位就是放目标物理地址的前20位了)
上面的结构其实就是二级页表,还有多级页表,单级页表的概念
根据上面的分析,其实我们如果拿到了一个物理地址,我们去掉后12位或者除以4096,就能找到页框号,找到页框号我们就可以找到对应的struct page,这个结构体里面存着对应的虚拟地址,我们也就能因此找到对应的虚拟地址了
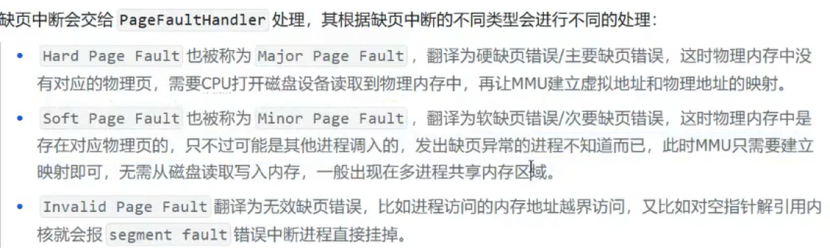
1.3.线程的优点
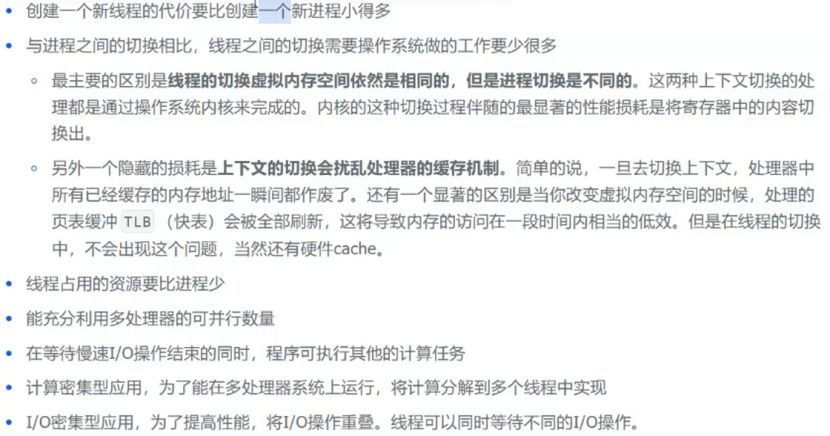
计算密集型:是指在运行过程中,系统瓶颈主要集中在 CPU 或算力芯片(如 GPU、NPU)的运算能力上,而非数据读写(I/O)或网络传输的应用。
但是线程不是越多越好,有几个CPU就创建几个线程最好
进程切换切的是硬件上下文(包括CR3等等寄存器)
在进程内的线程切换绝对是比进程低,显而易见。
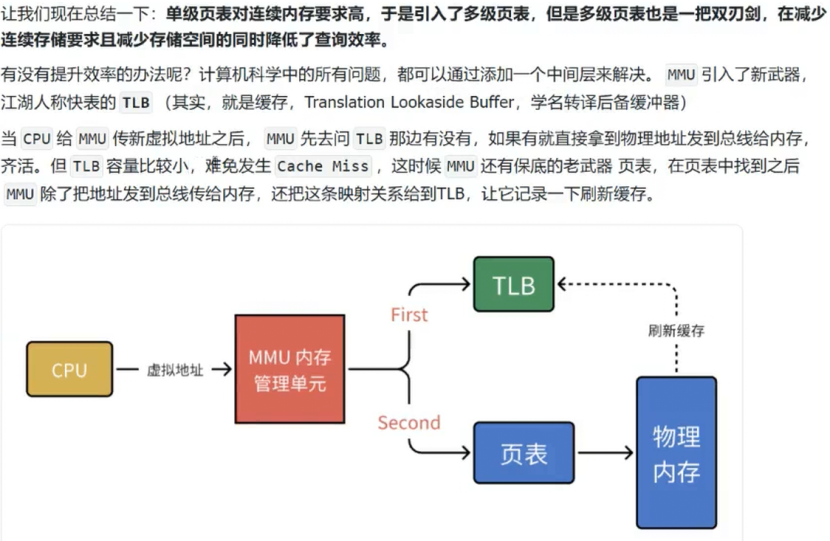
在CPU内部,针对一个特定的进程,会有两种比较大的缓存,一种是对用户数据进行cache(也称高速缓存,是一种介于快速计算单元与慢速存储介质之间的临时存储机制,其实就是读的时候会把目标周边的数据一起读到CPU里面,这样进行下一步的时候可能会更快) ,灵位一个是TLB。因此进程间切换的时候,TLB和Cache就失效了,线程切换的时候就不会出现大面积失效的问题
如果是不同进程间的线程进行切换,其实就算做进程间切换了
1.4.线程的缺点
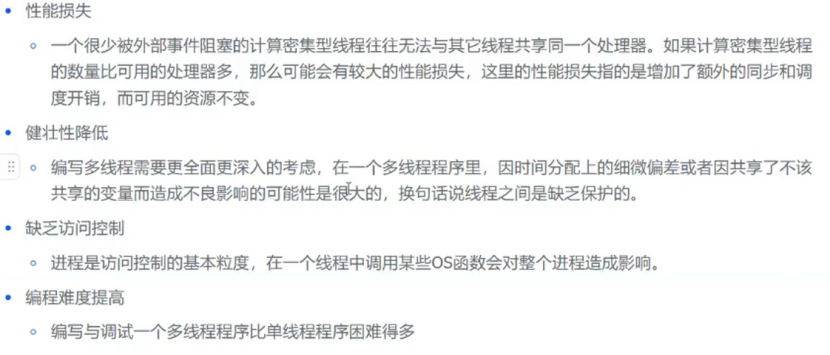
对于性能损失,其实进程和线程都是一样的
1.5.线程异常

线程出问题就是进程出问题
二. Linux进程VS线程
进程是大部分资源独占,少部分资源共享,是资源分配的基本单位,
线程是大部分资源独占,少部分资源共享,是调度的基本单位,
线程共享进程数据,但也拥有自己的一部分“私有”数据:线程ID,一组寄存器,线程的上下文数据(证明线程是可以被独立调度的),栈,errno,信号屏蔽字,调度优先级
线程共享的包括:文件描述符表,每种信号的处理方式,当前工作目录,用户id和组id
三.Linux线程控制
3.1. 验证之前的理论
1.接口
———————————————-库函数:pthread_create—————————————————
作用:创建新的线程
头文件:<pthread.h>
原型:int pthread_create(pthread_t *thread, const phread_attr_t *attr, void *(*start_routine)(void*), void *arg)
参数解释:第一个是输出型参数,是未来的线程id,第二个是线程属性,设置为NULL就可以,第三个是一个函数指针,第四个是线程名称,也是传递给第三个参数的函数里面的单数,如果有多个,需要封装成struct
注意:pthread是一个独立的库,在链接的时候还需要额外备注链接哪一个库
比如g++ -o $@ $^ -lpthread
———————————————-指令:ps -aL——————————————————-
作用:显示进程
选项解释:-a是all的意思,-L是打印线程相关信息,LWP(light weight process)的意思也是轻量级进程,但是线程的tid并不等于LWP
2.细节
CPU调度的时候看的就是lwp,是看线程的
关于调度的时间片问题:
线程会等分一个进程的时间片
线程出异常怎么办:
任何一个线程崩溃都会杀死整个进程
同一个进程的线程的消息会混杂在一起
3.2. 引入pthread线程库
Linux系统,不存在真正意义上的线程,他所谓的概念,是使用轻量级进程模拟的,但OS中只有轻量级进程,所谓模拟线程是我们的说法。Linux只提供了创建轻量级进程的系统调用,并没有提供真正创建线程的系统调用。
对于用户来说,用户只认识线程,不认识轻量级进程,因此Linux系统提供了一个pthread库,把创建轻量级进程封装起来,给用户提供一批创建线程的接口
C++也引入了线程
头文件是<thread>,在Linux系统本质上封装了pthread库,链接的时候也要链接pthread库
在Windows系统上也一样,语言的跨平台或者可移植性,就是把所有平台干一份,然后条件编译形成库
3.3.Linux线程控制的接口
函数:int pthread_create(pthread_t *thread, const pthread_attr_t *attr, void *(*star_routine) (void*), void *arg)
参数解释:第一个参数是输出型参数,是线程ID(也叫tid,不等于lwp),第二个参数是输入性参数,线程属性,设置为NULL就是默认值,第三个是一个函数指针,是新线程要执行的函数入口,第四个就是第三个参数的参数,可以写NULL
返回值:创建成功返回0,否则返回一个错误码
2. 线程等待
线程创建好之后,新线程要被主线程等待
函数:int pthread_join(pthread_t thread, void **retval)
参数解释:第一个参数是要等待的线程的ID,第二个是输出型参数,是退出码,不需要的时候设置为nullptr,在创建进程的时候,要求执行的函数返回值必须是void* ,第二个参数就是获取这个函数的返回值
这里没有异常相关,因为只要出异常,整个进程都出问题了,根本不需要
3.显示tid
tid和lwp不是一回事,要记清
函数:pthread_t pthread_self(void)
参数解释:无参数
返回值:返回当前线程的tid
4.线程传参和返回值
在多线程的场景中,main函数结束代表主线程结束,一般也代表进程结束,新线程对应的入口函数运行结束代表当前线程运行结束。
创建线程时给线程传递的参数和返回值可以是任意类型
线程终止的时候(函数里用exit())会终止进程
5.线程终止(一般不用,知道就行)
函数1:void pthread_exit(void *retval)
参数解释:这个函数就等价于直接return void*,也就是说那个参数是设置的返回值
函数2:int pthread_cancel(pthread_t thread)
参数解释:参数是要取消的线程tid
函数解释:一般是主线程取消新线程,取消的时候一定要保证即将被取消的线程已经启 动了,并且线程被取消时,返回值是-1(PTHREA_CANCELED)
6. 让新线程自己释放——设置新线程为分离状态
一个线程被创建出来,默认是需要被等待的,这种状态是joinable
如果不想让主线程等待,想让自己退出,就要把线程设置为分离状态(!joinable或者detach),线程分离相当于现实中的分家,可以主分离新,也可以新把自己分离,在Linux系统里,分离的线程依旧在进程的地址空间中,进程的所有资源,被分离的线程依旧可以访问、可以操作,主线程不再等待新线程
函数:pthread_detach(pthread_t thread)
函数参数:要被分离的线程
函数解释:主线程分离新线程
3.4.线程ID及进程地址空间布局
线程的概念是在库中维护的(内核中只有轻量级进程),因此,在库内部,就一定会存在多个被创建好的线程,库也要线程进行管理
因此,也要有一个相应的
struct tcb
{
//线程应该有的属性
//线程状态
//线程id
//线程独立的栈结构
……
}
线程的概念一部分是在内核实现,一部分是在用户(也就是库)中实现
线程在库中也需要描述,所以有了tid,就是在库中的对应的管理块的起始虚拟地址,
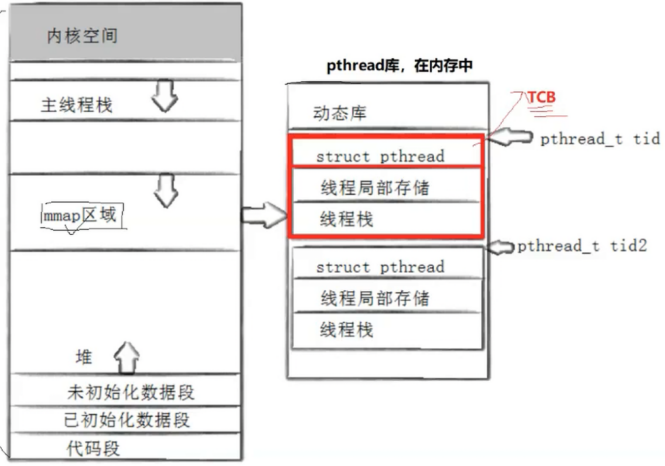
struct pthread也叫线程控制块,里面有一个属性叫做void*ret,也就是函数执行结束后对应的返回值。
在动态库里,每个新线程都有自己独立的栈空间,用于放自己的临时数据和函数栈帧,主线程是用地址空间的栈,新线程是用自己对应的线程栈。
用“带饭”的例子来对应这套流程:
你(用户):业务代码的编写者,提出需求的人。
宿舍(库,pthread 库):负责张罗跑腿、记账、分配饭盒的“生活大管家”。
室友(内核里的执行流,Linux 内核 / LWP):真正长了腿、能下楼去食堂排队出力的“干活人”。
1. 诞生联动:下楼前的准备与出发
宿舍接单并备餐盒(用户态建栈和 TCB):
你在宿舍说:“我想吃二楼的黄焖鸡,顺便帮我带一瓶可乐,先在宿舍桌上拿出一个空饭盒(线程栈,放执行逻辑和局部变量),并在旁边写好一张便利贴(TCB,记录是谁要的、什么口味、带回来给谁)。
推室友下楼(库发起系统调用 clone):
室友接令上路(内核创建 task_struct 调度实体):
室友(内核)揣着饭盒穿上鞋,在宿管系统登记了一个出门工号(LWP ID / TID),开始往食堂走。
2. 运行联动:双向交接与奔波跑腿
正常跑腿(用户态执行):
室友用你给的饭盒装菜(在用户栈里跑你的业务逻辑代码)。
遇到需要盖章/办手续(发起系统调用或内核调度):
室友到食堂发现必须刷校园卡甚至找食堂经理签字(系统调用)。室友先把饭盒放在窗口旁,掏出自己的身份证和工作日志(保存寄存器到内核栈),办完手续盖完章。室友拿回饭盒,再接着帮你夹肉、装可乐(切回用户栈继续执行)。
3. 终结联动:带饭归来与交差注销
室友回宿舍交差(线程结束,内核状态保留):
室友把装满饭菜的饭盒放在宿舍桌上,在便利贴(TCB)上写下:“饭带到了,花了 20 块”(退出码/返回值)。室友的腿脚任务彻底跑完了,直接躺倒在床上休息,不再占用走廊道路(不再参与 CPU 调度)。但他身上的“出勤登记”(内核 task_struct)还没在宿管那注销。
你来取饭并销账(pthread_join):
你(用户)回到宿舍,伸手拿起饭盒开吃,并撕下便利贴看了一眼找回的零钱(获取返回值)。宿舍(库)通知宿管:“这位室友的任务已经结清了”,宿管彻底在花名册上划掉这次出勤(内核注销 task_struct)。宿舍最后把饭盒洗干净放回柜子(栈和 TCB 内存放回缓存池或交还系统),留着下次带饭再用。
Linux所有线程都在库里面
3.5.线程栈和线程封装
一个线程就对应一个PCB(也就是task_struct)
每个线程都有自己独立的栈结构,要么是进程自己的,要么是库中创建进程是mmap出来的,主线程用的是主线程栈,主线程栈是可扩容的,子线程不能(一般默认的是8M)
每一个线程都自己的上下文是因为有独立的PCB(内核定义)+TCP(库定义)
——————————————-Thread.hpp————————————————
#ifndef _THREAD_H_
#define _THREAD_H_
//头文件……
namespace ThreadModlue
{
static uint32_t number = 1; //uint32_t是32字节的无符号整数
template<typename T>
class Thread
{
using func_t = std:: function<void(T)>;
private:
void EnableDetach()
{
std::cout << “线程被分离了” << std::endl;
_isdetach = true;
}
public:
Thread(func_t func, T data)
:_tid(0)
,_isdetach(false)
,_isrunning(false)
,res(nullptr)
,_func(func)
,_data(data)
{
_name = “thread-” + std::to_string(number++);
}
void Detach()
{
if (_isdetach)
return;
if (_isrunning)
pthread_detach(_tid);
EnableDetach();
}
void EnableRuning()
{
_isrunning = true;
}
static void *Routine(void *args) //因为如果函数是在类内的,那么第一个参数默认是this指针,所以前面要加static
{
Thread<T> *self = static_cast<Thread<T> *>(args);
self->EnableRuning();
if (self->_isdetach)
self->Detach();
self->_func(self->_data);
}
bool Start()
{
if (_isrunning)
return;
int n = pthread_create(&_tid, nullptr, Routine, this);
if (n > 0)
{
std::cerr << “create thread error” << std::endl;
return false;
}
else
cout << _name << “ create sucess” << std::endl;
return true;
}
void Stop()
{
if (_isrunning)
{
int n = pthread_cancel(_tid);
if(n != 0)
{
std::cerr << “create thread error” << streerror(n) << std::endl;
return false;
}
_isrunning = false;
}
}
void Join()
{
if (_isdetach)
{
std:: cout << “你的线程已经是分离的了,不能进行join” << std:: endl;
return;
}
int n = pthread_jion(_tid, &res);
if(n != 0)
{
std::cerr << “create thread error” << streerror(n) << std::endl;
return false;
}
}
~Thread()
{}
private:
pthread_t _tid;
std::string _name;
bool _isdetach;
bool _isrunning;
void* res;
func_t _func;
T _data;
};
}
}
3.6.线程的局部存储
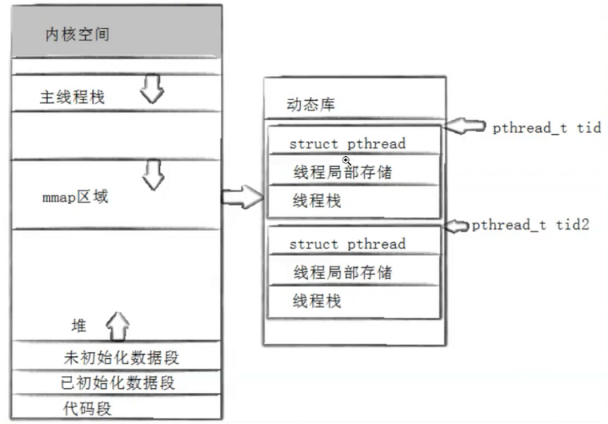
一个全局变量会被多个线程共享,但是如果在全局变量前加上__thread就会变成线程的局部存储,不会被共享
线程局部存储只能存储内置类型和部分指针
四.互斥
4.1.数据不一致问题
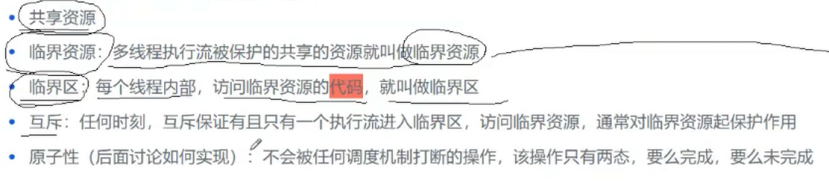
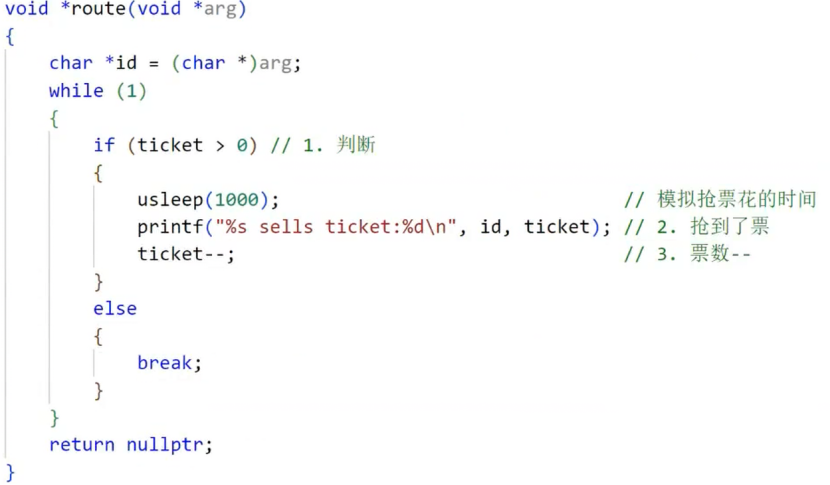
这是一个模拟买票程序,在封装中,如果是这样的代码,有可能会出现票数为负数的情况,这就是数据不一致问题
4.2.pthread锁
4.3.理解为什么数据不一致 && 认识加锁的接口
在上面的代码中,ticket–不是原子的(原子性就是只有两态),计算操作都是CPU来处理的,里面有几步:1.将数据导入CPU的某一个数据,2.CPU进行计算,3.写回内存。因此如果在执行三条指令时刚好要做线程间切换的时候,第三条指令就被保存,还没写回内存,等到他再次被执行的时候,就把这个第三条指令执行,这时就产生了数据不一致问题,但其实,这样只会使ticket多次重复,不会出现打印出负数的情况。
票数之所以会变成负数,主要矛盾是那个判断(ticket > 0),那个判断是逻辑运算,也要执行一样的三条语句,假设线程1执行ticket = 1的时候,当他刚好执行完判断,还没执行自减的时候,刚好被切,但是已经进入了循环,然后线程2、3也是这样。
等线程1再次回来的时候执行完ticket–,ticket就变成了0,然后切到线程2、3,此时这两个会重新执行一遍自减,然后ticket就变成负数了。
所以综上,全局资源没有加保护,可能就会出现并发问题,这就是线程安全并发问题
事实上,只有一条汇编语句就是原子的。
不可重入函数就是如果在执行过程中被中断,去执行其他代码后再次进入该函数(或者在信号处理函数中调用它),可能会导致数据污染、逻辑错误或死锁,就比如上面的函数就是。
4.3.2.认识互斥锁/互斥量
头文件:<pthread.h>
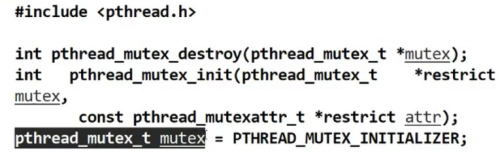
这个锁的类型就是pthread_mutex_t,有两种使用方式,
一个是直接全局定义

,这样定义的h的话就不需要释放,程序运行结束会自动释放
另一个就是局部定义但这样必须先初始化,用int pthread_mutex_init(pthread_mutex_t *restrict mutex, const pthread_mutexattr_t *restruct attr)来初始化,后一个函数可以直接设置为空,用默认值,然后也要手动释放用函数 int pthread_mutex_destroy(pthread_mutex_t *mutex)
但是上面两个使用前都要先加锁,int pthread_mutex_lock(pthread_mutex_t *mutex),多线程都得先看到锁,但是锁本身就是临界资源,因此,申请的过程必须是原子的。身亲成功了就继续向后运行,可以访问临界资源,申请失败了就会阻塞挂起申请执行流
用完之后要解锁int pthread_mutex_unlock(pthread_mutex_t *mutex)。
使用样例:
class ThreadData
{
public:
ThreadData(const std::string &n, pthread_mutex_t &lock)
:name(n)
,lockp(&lock)
{}
~ThreadData()
{}
private:
std::string name;
pthread_mutex_t *lockp;
};
void *route(void *arg)
{
ThreadData *td = static_cast<ThreadData>(arg);
while(1)
{
pthread_mutex_lock(td->lockp); //加锁
if (ticket > 0)
{
usleep(1000);
printf(“%s sells tickey:%d\\n”, td->name.c_str(), ticket);
ticket–;
pthread_mutex_unlock(td->lockp); //解锁
}
else
{
pthread_mutex_unlock(td->lockp); //解锁
break;
}
}
}
int main()
{
pthread_mutex_t lock;
pthread_mutex_init(&lock, nullptr); //初始化,如果定义在全局就不用初始化了
pthread_t t1, t2, t3. t4;
ThreadData *td1 = new ThreadData(“thread 1”, lock);
pthread_create(&t1, NULL, route, (void *)”thread 1”);
ThreadData *td2 = new ThreadData(“thread 1”, lock);
pthread_create(&t2, NULL, route, (void *)”thread 1”);
ThreadData *td3 = new ThreadData(“thread 1”, lock);
pthread_create(&t3, NULL, route, (void *)”thread 1”);
ThreadData *td4 = new ThreadData(“thread 1”, lock);
pthread_create(&t4, NULL, route, (void *)”thread 1”);
pthread_mutex_destroy(&lock); //销毁,如果定义在全局就不用初始化了
return 0;
}
4.4.理解锁
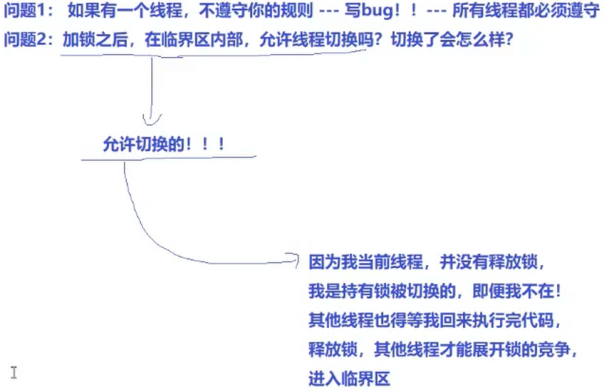
哪怕就算是切换了也诶关系,也得等线程跑完
而锁是怎么做到原子性的嫩?因为对锁外面的代码,只有两种状态有意义:要么不用锁,要么用完锁
锁的原理:
cpu的寄存器只有一套,但是里面存储的数据可以有多样性,可以是多个进程的上下文,因此如果把一个变量的内容,交换到CPU寄存器内部,本质是把该变量的内容,获取到当前执行流的硬件上下文中。
用swap、exchange将内存中的变量交换到CPU的寄存器中:本质是当前线程/进程在获取锁,因为是交换,不是拷贝。
如果是C++的,也有类似的锁,名字改了,变成了cpp_mutex,头文件是<mutex>,其他的自己ai
————————————————————mutex.hpp——————————————————
#pragma once
#include<phread.h>
#inlcude<iostream>
namesapce MutexModule
{
class Mutex
{
public:
Mutex()
{
pthread_mutex_init(&_mutex, nullptr);
}
void Lock()
{
int n = pthread_mutex_lock(&_mutex);
if() //就是简单的检查返回值判断,我在后面的代码都是省略的
}
void Unlock()
{
int n = pthread_mutex_unlock(&_mutex);
if()
}
~Mutex()
{
pthread_mutex_destroy(&_mutex);
}
pthread_mutex_t *Get()
{
return &_mutex;
}
private:
pthread_mutex_t _mutex;
};
class LockGuard()
{
public:
LockGuard(Mutex &mutex)
:_mutex(mutex)
{
_mutex.Lock();
}
~LockGuard()
{
_mutex.Unlock();
}
private:
Mutex &_mutex;
};
};
五.同步
互斥也存在一些问题:申请到锁的线程对于线程的竞争能力很强,因此如果重复的高频申请锁,其他线程都抢不过,这就叫其他线程饥饿问题,这样会产生效率和公平性的问题;
针对这个问题,产生了一个策略:线程不能立即申请第二次锁,外面的线程进行排队,一旦解锁,这个线程必须跑到队列的末尾,进行二次申请,这就叫线程同步。
5.1.条件变量
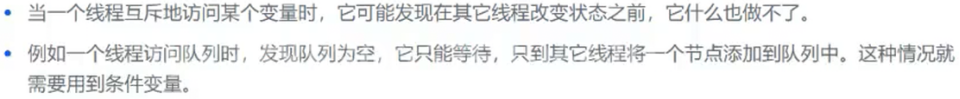
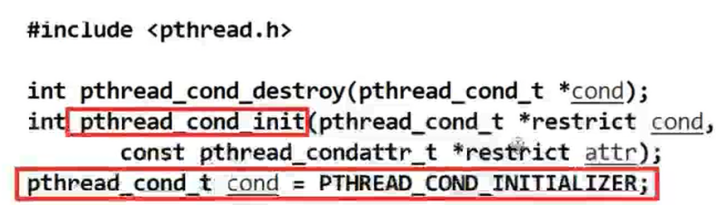
这个的使用和锁很像,可以说基本一样
定义有两种使用方法:1.全局直接pthread_cond_t cond = PTHREAD_COND_INITIALIZER
2.局部先定义,然后初始化,最后销毁,初始化的函数第一个参数是条件变量,第二个是属性,设置为nullptr就可以
条件变量是一种实现条件变量的做法,
这里有两个接口。
—————————————————函数:pthread_cond_timedwait————————————
头文件:<pthread.h>
作用:和下面几乎一样,不同的是会设置时间,如果时间到了还没人唤醒,会自动醒来
原型:int pthread_cond_timedwait(pthread_cond_t *restrict cond, pyhread_mutex_t *restrict mutex, const struct timespec *restrict abstime)
参数解释:第一个参数是指定的条件变量,第二个是指定的锁,第三个是等待时间参数
返回值:
—————————————————函数:pthread_cond_wait—————————————–
头文件:<pthread.h>
作用:1.自动把互斥锁解开 2.进入睡眠状态,释放CPU资源 3.当被唤醒后,去抢锁,没抢到就卡在锁这里,抢到了就继续往下执行
原型:int pthread_cond_wait(pthread_cond_t *restrict cond, pyhread_mutex_t *restrict mutex,)
参数解释:第一个参数是指定的条件变量,第二个是指定的锁
返回值:
—————————————————函数:pthread_cond_signal—————————————-
头文件:<pthread.h>
原型:int pthread_cond_signal(pthread_cond_t *cond)
作用:唤醒在改条件变量下等待的进程
参数解释:指定的条件变量
———————————————–函数:pthread_cond_broadcast————————————–
头文件:<pthread.h>
原型:int pthread_cond_broadcast(pthread_cond_t *cond)
作用:唤醒正在指定条件变量下等待的所有的线程
参数解释:指定
5.3.生产消费模型——很重要!!!
工厂是生产者,客户是消费者,但是工厂生产出来了东西不会一个个去找消费者,消费者也不会找工厂买东西,效率太低,这时,就需要有一个超市作为二者的纽带,这就是生产消费模型
而在这里,生产者和消费者都是一个个的线程,超市里的商品就是数据,超市的展架就是一块块内存空间,也就是临界资源,消费者和生产者都要访问的。
在生产消费模型里,有三个要素:生产者,消费者,一个交易场所(一种临界资源),生产者和生产者、消费者和消费者是竞争/互斥关系,生产者和消费者是互斥关系(有可能数据不一致)和同步关系
所以在这个模型里面要维护好三种关系、两种角色和一个交易场所
为什么要有这个模型:
基于blockqueue的生产消费模型
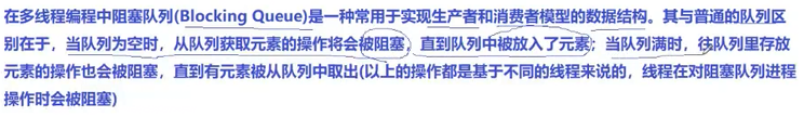
阻塞队列是一个容量有上限的队列,不满足读写条件的时候,就要进行阻塞对应的线程
———————————————BlockQueue.hpp—————————————————-
#pragma once
#include<iostream>
#include<string>
#include<pthread.h>
const int defaultcap = 5;
template <typename T>
class BlockQueue
{
private:
bool IsFull()
{
return _q.size() >= _cap;
}
bool IsEmpty()
{
return _q.size() == 0;
}
public:
BlockQueue(int cap = defaultcap)
:_cap(cap)
,_csleep_num(0)
,_psleep_num(0)
{
pthread_mutex_init(&_lock, nullptr);
pthread_cond_init(&_full_cond, nullptr);
pthread_cond_init(&_empty_cond, nullptr);
}
//生产者调用
void Equeue(const T &in)
{
pthread_mutex_lock(&_mutex);
while(IsFull()) //判定也是访问临界资源
{
//让生产者等待
//调用成功时,在挂起当前线程之前,先自动释放锁
//被唤醒的时候,默认11在临界区内唤醒,需要重新申请锁
//如果被唤醒,但是申请锁失败了就会在锁上阻塞等待
_psleep_num++;
pthread_cond_wait(&_full_cond, &_mutex);
_psleep_num–;
}
_q.push(in);
if(_csleep_num > 0)
{
pthread_cond_signal(&_empty_cond);
std::cout << “唤醒消费者” << std::endl;
}
pthread_mutex_unlock(&_mutex);
}
//消费者调用
T Pop()
{
pthread_mutex_lock(&_mutex);
while (IsEmpty())
{
_csleep_num++;
pthread_cond_wait(&_empty_cond, &_mutex);
_csleep_num–;
}
T data = _q.front();
_q.pop();
if(_psleep_num > 0)
{
pthread_cond_signal(&_full_cond);
std::cout << “唤醒生产者” << std::endl;
}
pthread_mutex_unlock(&_mutex);
return data;
}
~BlockQueue()
{
pthread_mutex_destroy(&_mutex);
pthread_cond_destroy(&_full_cond);
pthread_cond_destroy(&_empty_cond);
}
private:
std::queue<T> _q;
int _cap; //容量大小
pthread_mutex_t _lock;
pthread_cond_t _full_cond;
pthread_cond_t _empty_cond;
int csleep_num; //消费者休眠的个数
int psleep_num; //生产者休眠的个数
};
———————————————————Main.cc——————————————————
#include”BlockQueue.hpp”
#include<iostream>
#include<unistd.h>
#include”Task.h”
void *consumer(void *args)
{
BlockQueue<Task> *bq = static_cast<BlockQueue<Task>*>(args);
while(true)
{
Task t = bq->Pop();
t.Execute();
std::cout<< “消费了一个任务:” << t.X()<< ” + ” << t.Y() << “=” << t.Result()<< std::endl;
}
}
void *productor(void *args)
{
int x = 1;
int y = 1;
BlockQueue<Task> *bq = static_cast<BlockQueue<Task>*>(args);
while(true)
{
sleep(1);
bq->Equeue(data);
std::cout << “生产了一个任务:” << x << “ + ” << y << data << std::endl;
Task t(x, y);
bq->Equeue(t);
x++, y++;
}
}
int main()
{
//申请阻塞队列
BlockQueue<Task> *bq = new BlockQueue<Task>();
//消费和生产者(单消费和单生产)
pthread_t c, p;
pthread_create(&c, nullptr, consumer, bq);
pthread_create(&p, nullptr, productor, bq);
pthread_join(c, nullptr);
pthread_join(p, nullptr);
pthread_t c[2], p[3];
pthread_create(&c, nullptr, consumer, bq);
pthread_create(&c+1, nullptr, consumer, bq);
pthread_create(&c+2, nullptr, consumer, bq);
pthread_create(&p, nullptr, productor, bq);
pthread_create(&p+1, nullptr, productor, bq);
pthread_create(&p+2, nullptr, productor, bq);
pthread_join(c[0], nullptr);
pthread_join(c[1], nullptr);
pthread_join(c[2], nullptr);
pthread_join(p[0], nullptr);
pthread_join(p[1], nullptr);
pthread_join(p[2], nullptr);
return 0;
}
——————————————————-Task.hpp————————————————-
#pragma once
#include<functional>
using task_t = std::function<void()>;
void Download()
{
//……
}
class Task
{
public:
Task()
{}
Task(int x, int y)
:_x(x)
,_y(y)
{}
void Execute()
{
_result = _x + _y;
}
int X()
{
return _x;
}
int Y()
{
return _y;
}
int Result()
{
return _result;
}
private:
int _x;
int _y;
int _result;
};
————————————————–Cond.hpp—————————————————-
#pragma once
#include<iostream>
#include<pthread.h>
using namespace MutexMoudle; //这个是之前封装的
namespace CondMoudule
{
class Cond
{
public:
Cond()
{
pthread_cond_init(&_cond, nullptr);
}
void Wait(Mutex &mutex)
{
int n = pthread_cond_wait(&_cond, mutex.Get());
if()
}
void Signal()
{
int n = pthread_cond_signal(&_cond);
if()
}
void Broadcast()
{
int n = pthread_cond_broadcast(&_cond);
if
}
~Cond()
{
pthread_cond_destroy(&_cond);
}
private:
pthread_cond_t _cond;
};
};
七.POSIX信号量
7.1.回顾相关概念
信号量本质就是一个计数器,是对特定资源的预定机制
多线程使用资源,有两种场景:1.将目标资源整体使用 2.将目标资源按照不同的“块”,分批使用
所有的线程,都得先看到sem,信号量本质也是临界资源
P操作,信号量–
V操作,信号量++
7.2.CP && 基于环形队列的生产消费者模型
在一个环形队列里,假设生产者是tail,生产者生产一个,tail++,消费者为head,消费一个,head++,
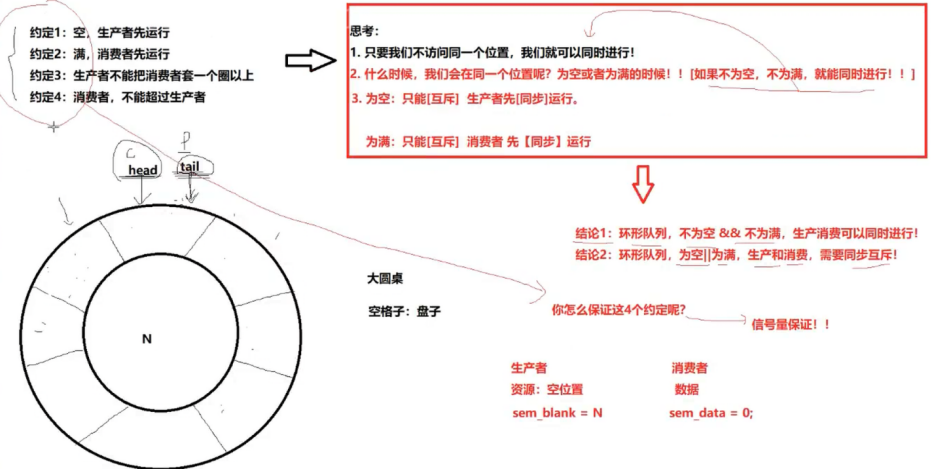
3.熟悉接口
头文件:<sempaphore.h>
初始化信号量:int sem_init(sem_t *sem, int pshared, usigned int value),使用前必须初始化,pshared:0表示线程间共享,非零表示进程间共享,value是信号量初始值,返回0成功,非0失败
销毁信号量:int sem_destroy(sem_t *sem)
等待信号量:int sem_wait(sem_t *sem),会将信号量的值减一
发布信号量:int sem_post(sem_t *sem),表示资源使用完毕,可以归还资源了,将信号量值加1
4.编写代码
—————————————Sem.hpp————————————————-
#pragma once
#include<iostream>
#include<pthread.h>
#include<pthread.h>
namespace SemMoudle
{
const int defaultvalue = 1;
class Sem
{
public:
Sem(unsigned int sem_value = defaultvalue)
{
sem_init(&_sem, 0, sem_value);
}
void P()
{
int n = sem_wait(&_sem);
if
}
void V()
{
int n = sem_post(&_sem);
if
}
~Sem()
{
sem_destroy(&_sem);
}
private:
sem_t _sem;
};
};
——————————————–Main.cpp(单生产,单消费)————————————————
#include”BlockQueue.hpp”
#include<iostream>
#include<unistd.h>
#include”Task.h”
#include”RingQueue”
void *consumer(void *args)
{
RingQueue<int> *rq = static_cast<RingQueue<int>*>(args);
while(true)
{
int t = 0;
rq->Pop(&t);
std::cout << “消费者拿到了数据:” << t << std::endl;
}
}
void *productor(void *args)
{
RingQueue<int> *rq = static_cast<RingQueue<int>*>(args);
int data = 1;
while(true)
{
std::cout << “生产了一个任务:” << data << std::endl;
rq->Equeue(data++);
}
}
int main()
{
RingQueue<int> *rq = new RingQueue<int>();
//消费和生产者(单消费和单生产)
pthread_t c, p;
pthread_create(&c, nullptr, consumer, rq);
pthread_create(&p, nullptr, productor, rq);
pthread_join(c, nullptr);
pthread_join(p, nullptr);
return 0;
}
——————————-RingQueue.hpp(但生成,单消费)—————————————————–
#pragma once
#include<vector>
#include”Sem.hpp”
using namespace SemModule;
static const int gacp = 5;
template<typename T>
class RingQueue
{
public:
RingQueue(int cap = gcap)
:_cap(cap)
,_rq(cap)
,_blank_sem(cap)
,_p_sem(0)
,_data_sem(0)
,_c_step(cap)
{}
void Equeue(const T &in)
{
//申请信号量
_blank_sem.P();
//生产
_rq[_p_step] = in;
//更新下标
++_p_step;
_p_step %= _cap;
//通知消费者
_data_sem.V();
}
void Pop(T *out)
{
//申请信号量
_data_sem.P();
//消费
*out = _rq[_c_step];
//更新下标
++_c_step;
_c_step %= _cap;
//通知生产者
_blank_sem.V();
}
~RingQueue()
{}
private:
std::vector<T> _rq;
int _cap;
Sem blank_sem; //空位置
int _p_step;
Sem data_sem; //数据
int _c_step;
};
——————————-RingQueue.hpp(多生产,多消费)—————————————————–
#pragma once
#include<vector>
#include”Sem.hpp”
using namespace MutexMoudle;
using namespace SemModule;
static const int gacp = 5;
template<typename T>
class RingQueue
{
public:
RingQueue(int cap = gcap)
:_cap(cap)
,_rq(cap)
,_blank_sem(cap)
,_p_sem(0)
,_data_sem(0)
,_c_step(cap)
{}
void Equeue(const T &in)
{
//申请信号量
_blank_sem.P();
_pmuex.Lock(); //在信号量前或者是后申请锁影响不大,但是在信号量后效率更高,让申请信号量可以多线程一起干,好比看电影,先买票再排队
//生产
_rq[_p_step] = in;
//更新下标
++_p_step;
_p_step %= _cap;
//通知消费者
_pmutex.Unlock();
_data_sem.V();
}
void Pop(T *out)
{
//申请信号量
_data_sem.P();
_cmutex.Lock();
//消费
*out = _rq[_c_step];
//更新下标
++_c_step;
_c_step %= _cap;
//通知生产者
_cmutex.Unlock();
_blank_sem.V();
}
~RingQueue()
{}
private:
std::vector<T> _rq;
int _cap;
Sem blank_sem; //空位置
int _p_step;
Sem data_sem; //数据
int _c_step;
//维护多生产,多消费
Mutex _cmutex; //维护生产者之间
Mutex _pmutex; //维护消费者之间
};
——————————————–Main.cpp(多生产,多消费)————————————————
#include”BlockQueue.hpp”
#include<iostream>
#include<unistd.h>
#include”Task.h”
#include”RingQueue”
struct threaddata
{
RingQueue<int> *rq;
std::string name;
};
void *consumer(void *args)
{
threaddata *td = static_cast<threaddata*>(args);
while(true)
{
int t = 0;
td->rq->Pop(&t);
std::cout << td->name << “-消费者拿到了数据:” << t << std::endl;
}
}
void *productor(void *args)
{
threaddata *td = static_cast<threaddata*>(args);
int data = 1;
while(true)
{
std::cout << td->name << “生产了一个任务:” << data << std::endl;
td->rq->Equeue(data++);
}
}
int main()
{
RingQueue<int> *rq = new RingQueue<int>();
threaddata *td1 = new threaddata;
td1->rq = rq;
td->name = “cthread-1”;
pthread_create(&c, nullptr, consumer, td1);
threaddata *td2 = new threaddata;
td2->rq = rq;
td->name = “cthread-2”;
pthread_create(&c, nullptr, consumer, td2);
threaddata *td3 = new threaddata;
td3->rq = rq;
td->name = “cthread-3”;
pthread_create(&c, nullptr, consumer, td3);
threaddata *td4 = new threaddata;
td4->rq = rq;
td->name = “pthread-1”;
pthread_create(&c, nullptr, productor, td4);
threaddata *td5 = new threaddata;
td5->rq = rq;
td->name = “pthread-2”;
pthread_create(&c, nullptr, productor, td5);
threaddata *td6 = new threaddata;
td6->rq = rq;
td->name = “pthread-3”;
pthread_create(&c, nullptr, productor, td6);
pthread_join(c, nullptr);
pthread_join(c[1], nullptr);
pthread_join(c[2], nullptr);
pthread_join(p, nullptr);
pthread_join(p[1], nullptr);
pthread_join(p[2], nullptr);
return 0;
}