上一篇整理了多态的使用条件和虚函数的基本规则。这次继续往下看一个问题:通过一个基类指针调用虚函数时,程序究竟是怎么找到派生类中的函数的?
例如:
Person* ptr = &student;
ptr->BuyTicket();
ptr 的类型是 Person*,但它指向的是一个 Student 对象,最终执行的却是 Student::BuyTicket()。如果只从函数调用的表面去看,很难解释这种行为。要弄明白这个过程,就得认识虚函数表和虚表指针。
一、含有虚函数的对象有什么不同?
先看一个简单的类:
class Base
{
public:
virtual void Func1()
{
cout << "Func1()" << endl;
}
protected:
int b = 1;
char ch = 'x';
};
除了 int 类型的成员 b 和 char 类型的成员 ch,这个类还有一个虚函数 Func1()。
在常见的 C++ 编译器实现中,含有虚函数的类对象通常还会带有一个虚表指针,常被叫作 vfptr 或 vptr。这个指针用于找到相应的虚函数表。
虚函数表通常简称虚表,里面保存着虚函数的地址信息。通过虚表指针,程序就有办法根据对象的实际类型找到对应的虚函数实现。
这里要注意,虚表指针和虚函数表不是 C++ 语言标准规定的对象布局细节,而是常见编译器实现多态的一种方式。学习它们主要是为了理解多态的底层原理。
1. 为什么 sizeof 可能发生变化?
假设在一个常见的 32 位编译环境下,指针占 4 字节,那么上面的对象可能包含:
- int b:4 字节;
- char ch:1 字节;
- 虚表指针:4 字节;
- 为了满足对齐要求而产生的额外空间。
在对应示例环境中,sizeof(Base) 的结果为 12。
如果只有成员变量,所需空间会更少。正是由于虚表指针和内存对齐等因素,对象大小发生了变化。
不过,不能把 12 当成所有平台下的固定答案。指针大小、对齐规则、编译器和具体类的布局都会影响 sizeof 的结果。换一个环境,结果可能不一样。
二、虚函数表是怎么帮助实现多态的?
回到买票的例子。
#include <iostream>
using namespace std;
class Person
{
public:
virtual void BuyTicket()
{
cout << "买票-全价" << endl;
}
};
class Student : public Person
{
public:
void BuyTicket() override
{
cout << "买票-打折" << endl;
}
};
class Soldier : public Person
{
public:
void BuyTicket() override
{
cout << "买票-优先" << endl;
}
};
void Func(Person* ptr)
{
ptr->BuyTicket();
}
int main()
{
Person p;
Student s;
Soldier soldier;
Func(&p);
Func(&s);
Func(&soldier);
return 0;
}
输出:
买票-全价
买票-打折
买票-优先
Func() 不需要关心传进来的是普通人、学生还是军人,它只需要使用统一的基类接口调用 BuyTicket()。
在常见的虚函数表实现中,可以这样理解:
调用 ptr->BuyTicket() 时,程序通过对象关联的虚函数表找到最终需要执行的虚函数地址。
所以,三个对象虽然都交给了同一个 Func(),但最后执行的函数不同。
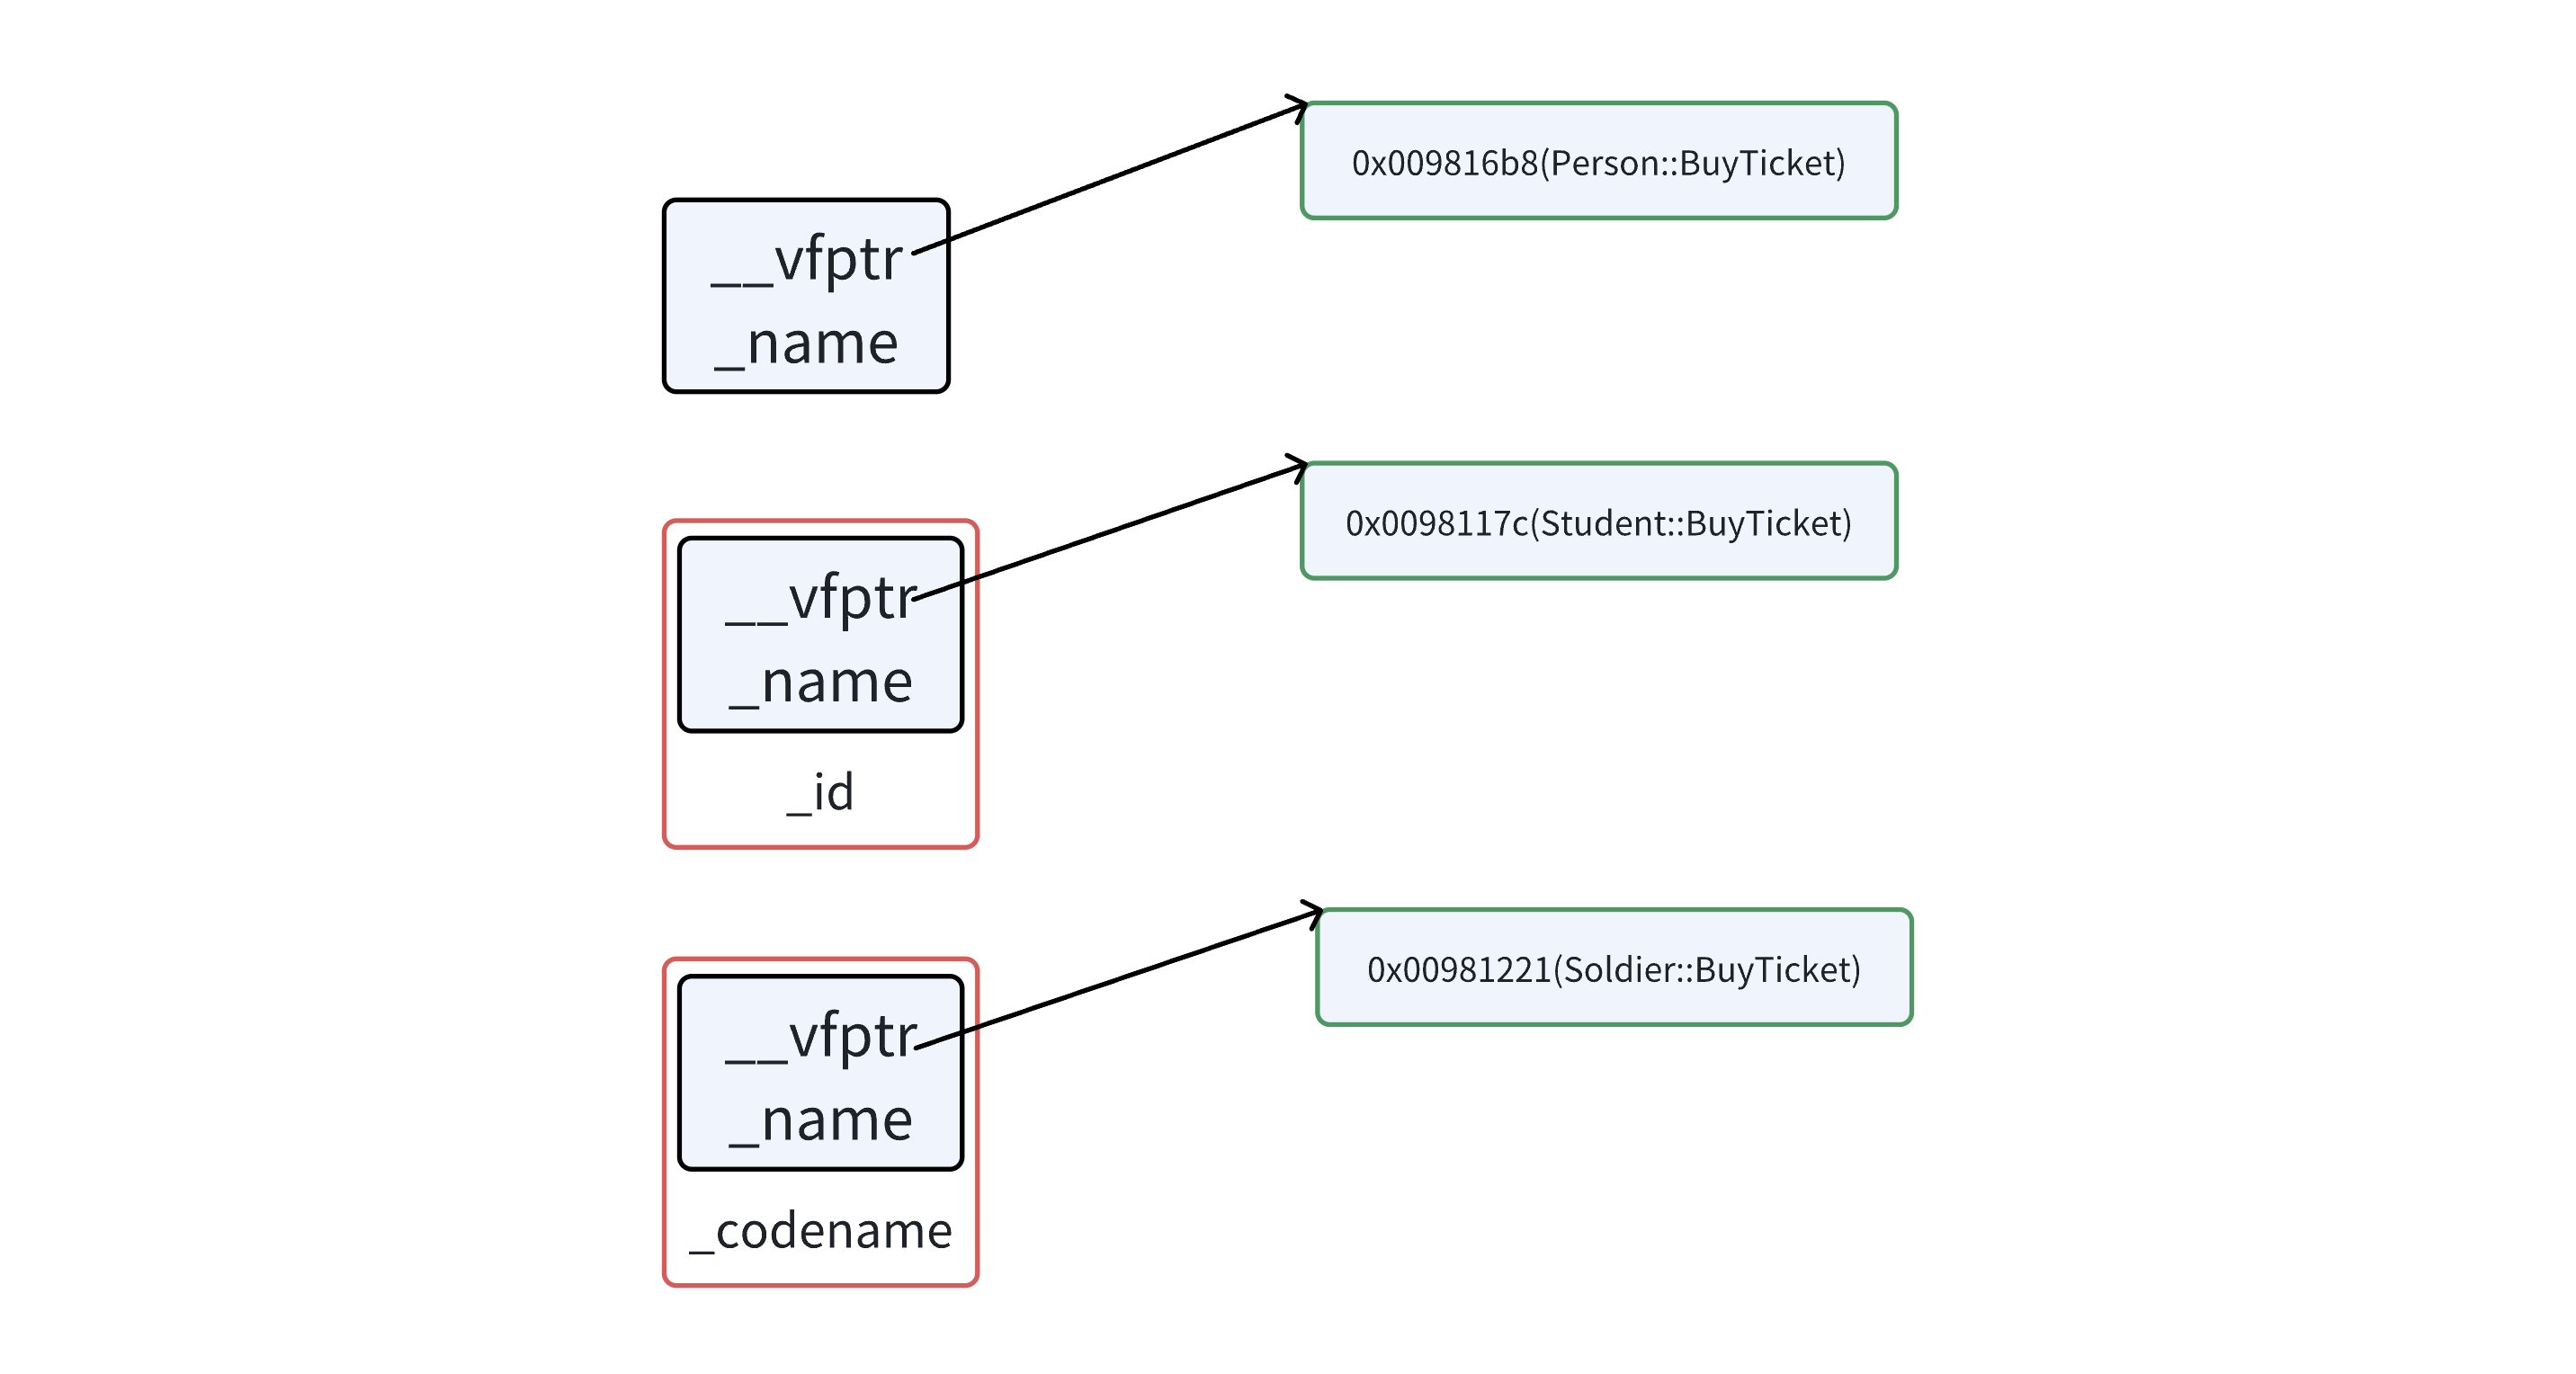
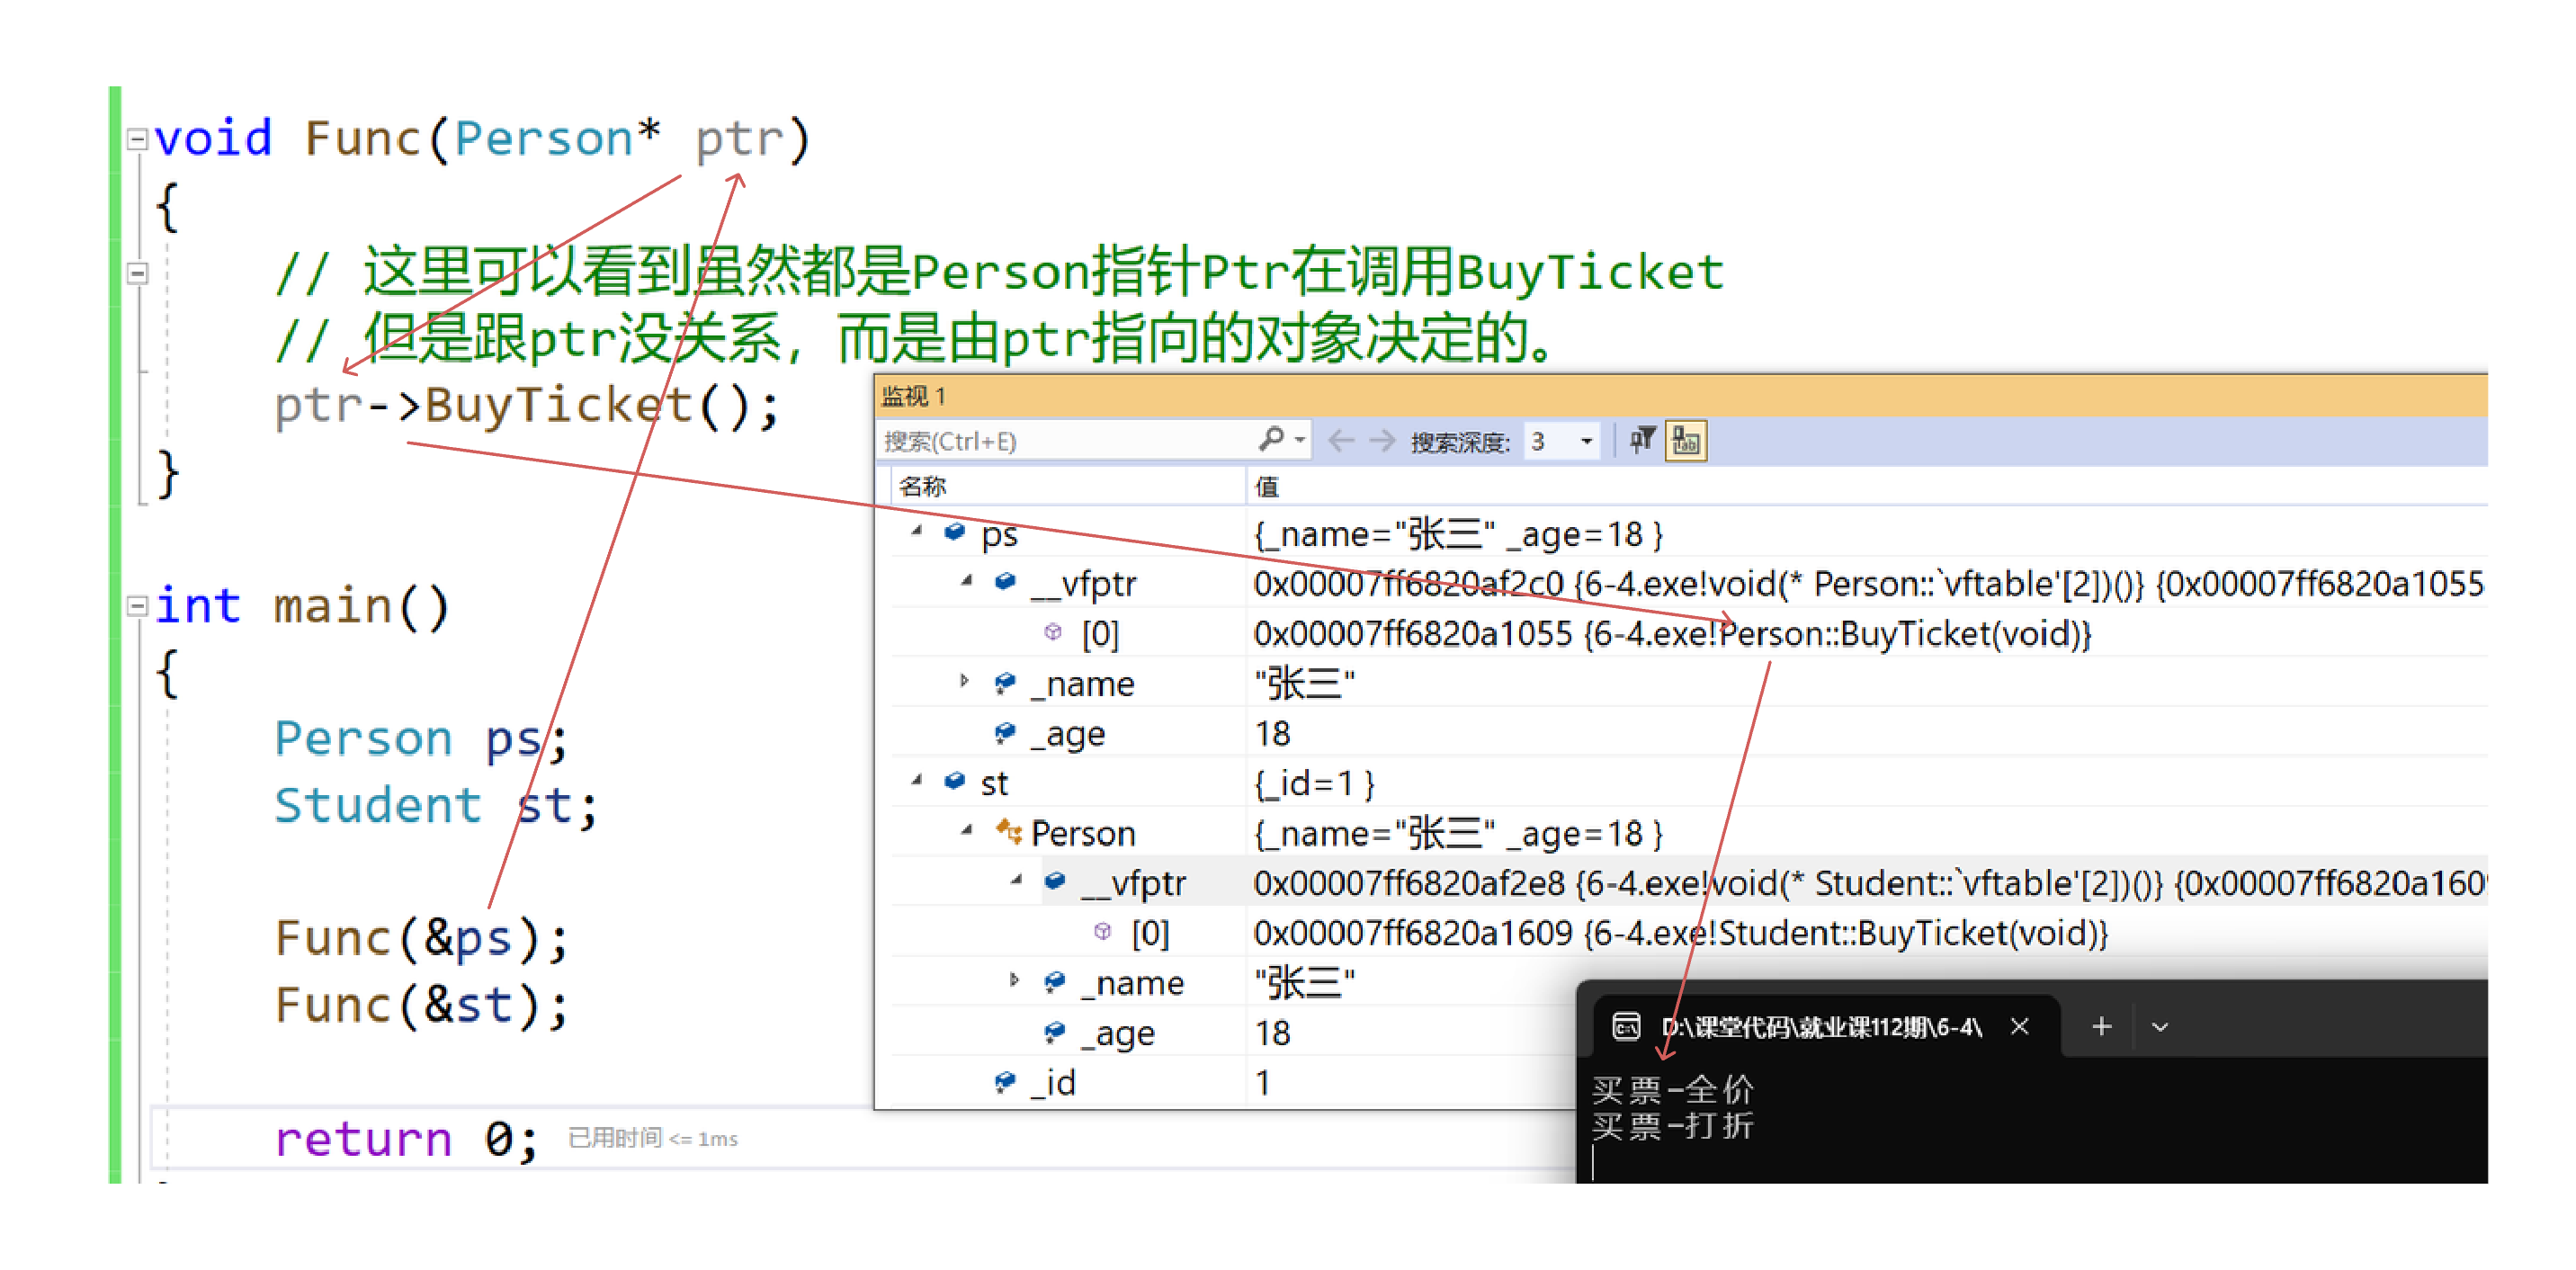
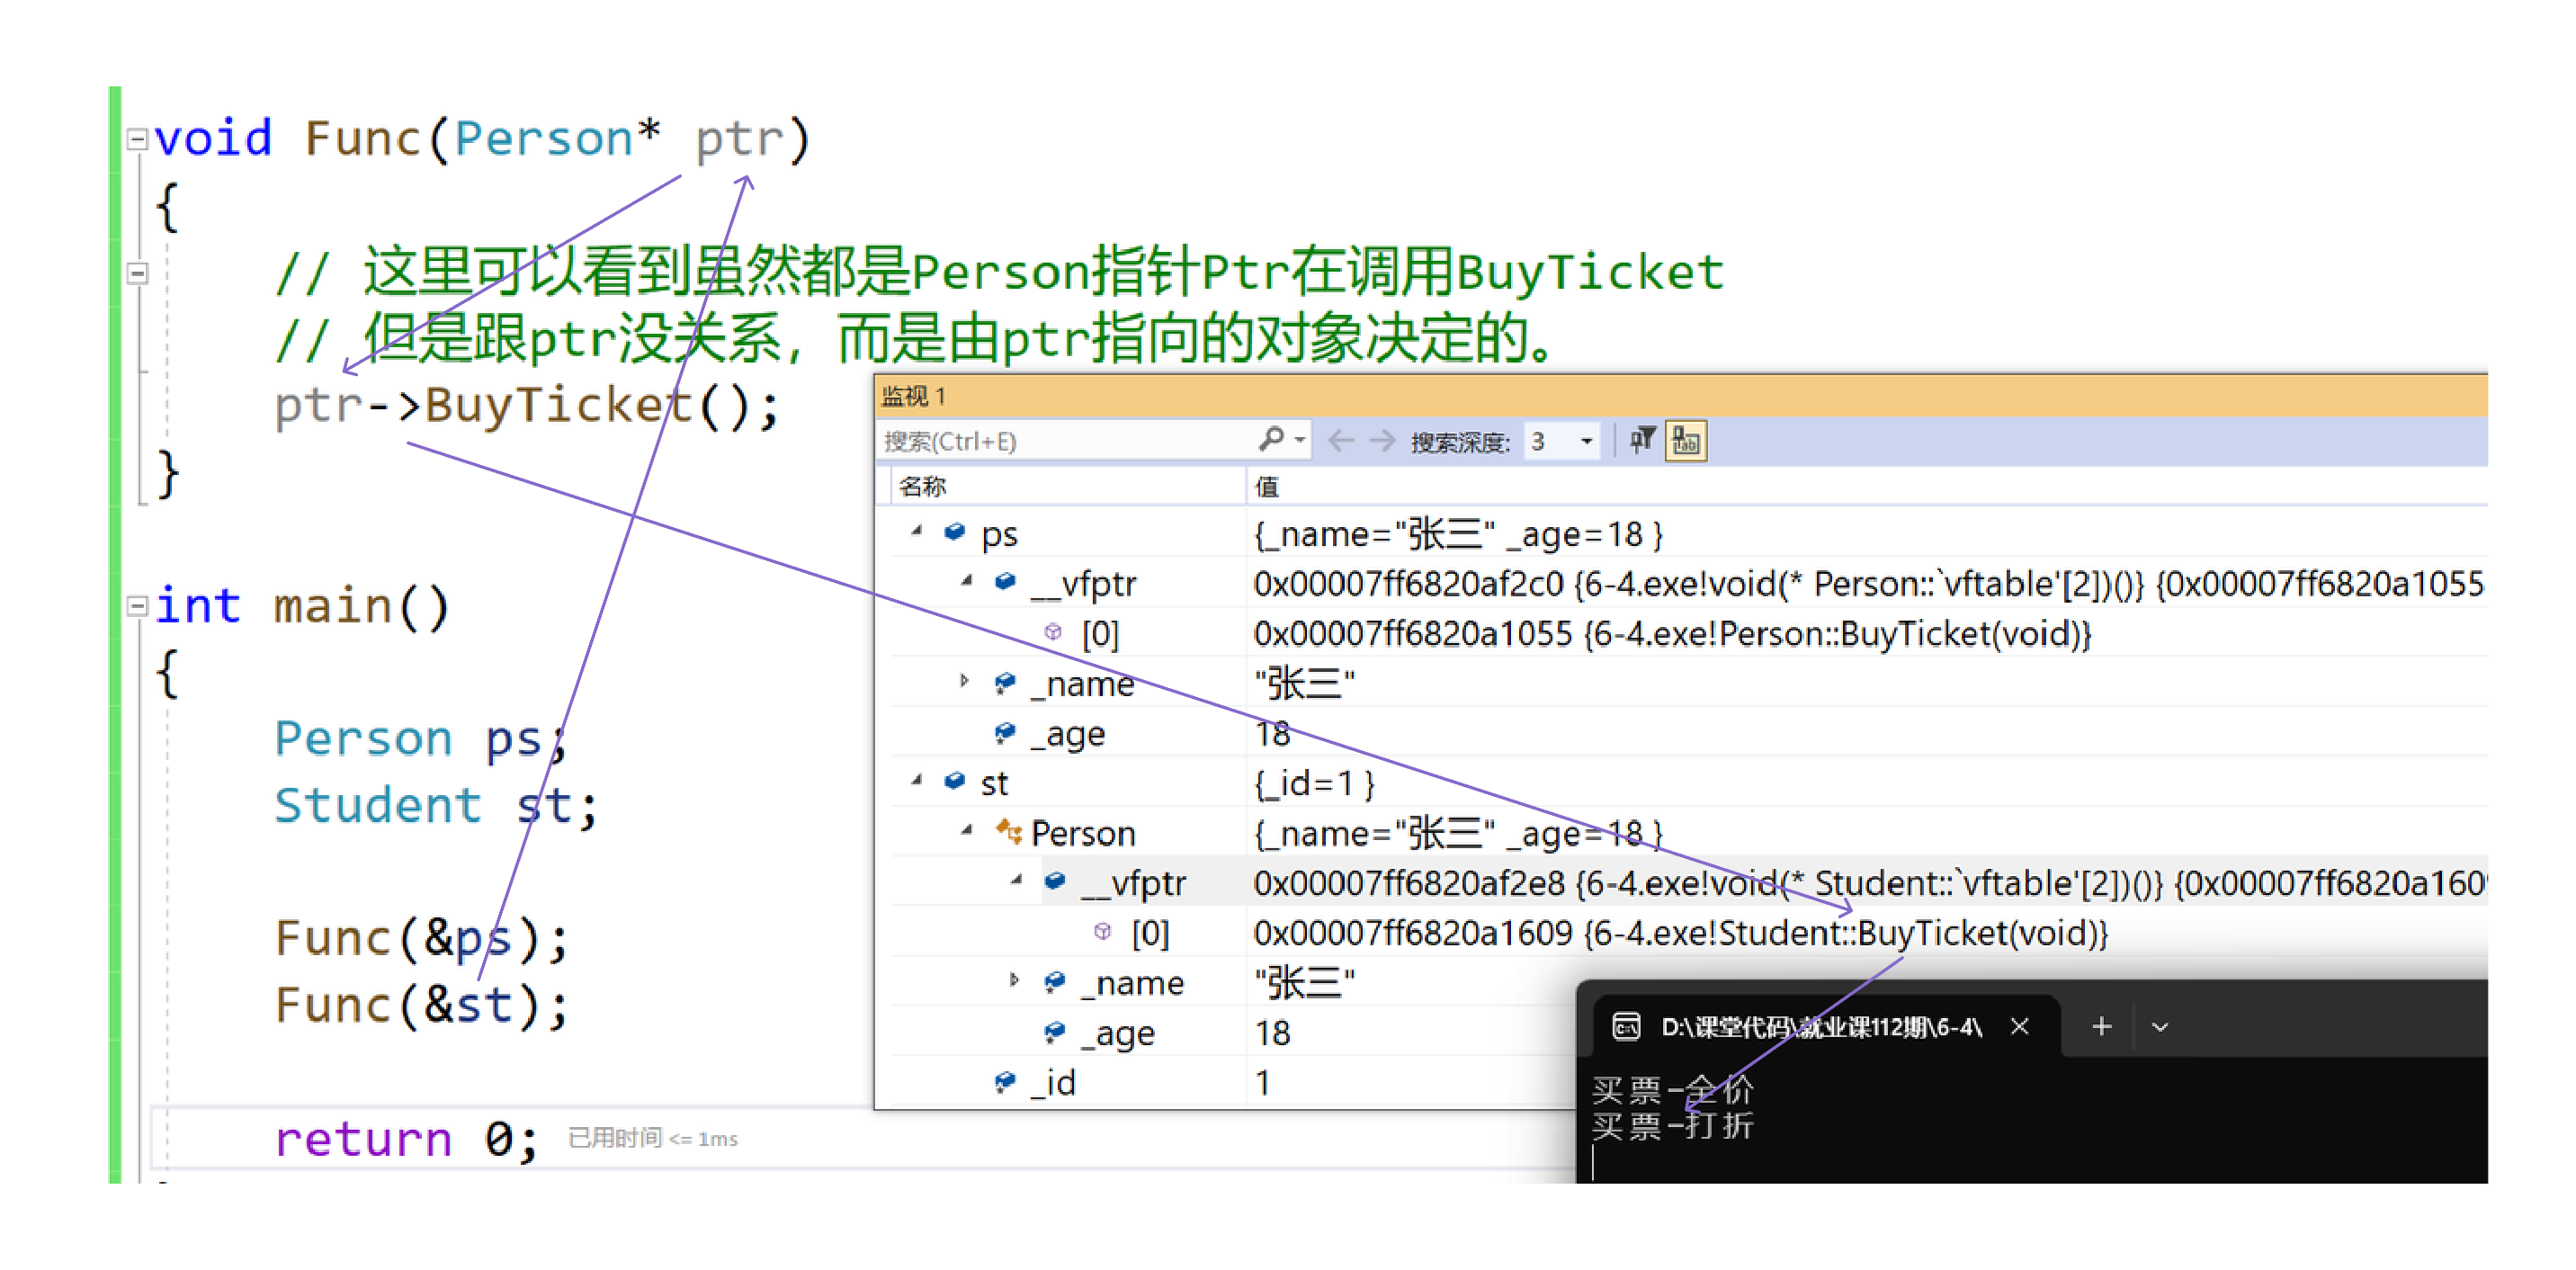
这里有一个重要认识:多态不是把基类指针变成了派生类指针,而是通过统一的基类接口,根据对象的实际类型执行对应的行为。
三、派生类的虚函数表包含什么?
继续看一个例子:
class Base
{
public:
virtual void Func1()
{
cout << "Base::Func1" << endl;
}
virtual void Func2()
{
cout << "Base::Func2" << endl;
}
void Func5()
{
cout << "Base::Func5" << endl;
}
};
class Derive : public Base
{
public:
void Func1() override
{
cout << "Derive::Func1" << endl;
}
virtual void Func3()
{
cout << "Derive::Func3" << endl;
}
};
在常见的虚函数表实现中,可以把 Derive 对象对应的表理解为包含以下几类信息:
- 从基类继承、没有被重写的虚函数,例如 Base::Func2();
- 被派生类重写后的虚函数,例如 Derive::Func1();
- 派生类自己新增的虚函数,例如 Derive::Func3()。
也就是说,重写虚函数并不是在派生类对象中简单地新增一个同名函数供虚表任选,而是让多态调用能够找到派生类对应的实现。
这里的 Func5() 是普通成员函数,不是虚函数,因此不会因为它是成员函数就自动加入虚函数表。
还要注意:虚表的具体结构、虚表指针的位置、表项的排列方式等属于编译器实现细节。上面的描述是为了理解常见实现方式,不意味着所有编译器都会以完全相同的内存布局组织它们。
四、静态绑定和动态绑定
弄明白虚函数表后,再区分静态绑定和动态绑定就容易多了。
1. 静态绑定
静态绑定是在编译阶段确定函数调用目标。普通的非虚函数调用通常属于这种情况。
class Base
{
public:
void Func()
{
cout << "Base::Func" << endl;
}
};
class Derive : public Base
{
public:
void Func()
{
cout << "Derive::Func" << endl;
}
};
int main()
{
Derive d;
Base* ptr = &d;
ptr->Func();
return 0;
}
这里输出:
Base::Func
虽然 ptr 指向的是 Derive 对象,但 Func() 是普通成员函数,不会因为对象实际属于派生类就自动发生多态调用。通过 Base* 调用时,选择的是基类的 Func()。
这也说明了:继承关系本身并不等于多态。
2. 动态绑定
如果将基类的 Func() 声明为虚函数,并由派生类重写,情况就不同了。
class Base
{
public:
virtual void Func()
{
cout << "Base::Func" << endl;
}
};
class Derive : public Base
{
public:
void Func() override
{
cout << "Derive::Func" << endl;
}
};
int main()
{
Derive d;
Base* ptr = &d;
ptr->Func();
return 0;
}
输出:
Derive::Func
这里满足了多态的调用条件。执行时会根据 ptr 指向的对象,找到相应的虚函数实现,这就是动态绑定。
因此,静态绑定和动态绑定最重要的区别是:
- 静态绑定通常在编译时确定调用目标;
- 动态绑定在运行时根据对象的实际类型选择对应的虚函数实现。
在判断一段代码是否发生多态时,不能只看它有没有指针。还要看调用的是不是虚函数,以及相关的重写关系是否成立。
五、虚函数和虚函数表在哪里?
学习多态的底层原理时,经常会遇到这样的问题:虚函数、虚函数表和虚表指针分别放在哪里?
首先,虚函数和普通函数一样,编译后都有对应的机器指令。常见实现会将虚函数的地址记录在虚函数表中,供动态绑定使用。
其次,虚表指针通常是对象布局中的一部分,它关联到对应的虚函数表。
至于虚函数表实际存放在哪个内存区域,不能简单地说所有平台都一样。C++ 标准没有规定虚函数表的具体存储位置;不同编译器、平台和构建方式可能采用不同的实现。
在特定的 Visual Studio 示例环境中,可以通过调试器的监视窗口或内存窗口观察对象中的虚表指针及其指向的区域,从而验证编译器实际采用的布局。换到其他环境时,具体地址和布局可能会变化。
六、总结
可以把多态的调用过程理解为:
基类指针或引用保存了某个对象的访问方式;当它调用符合多态条件的虚函数时,常见的 C++ 实现会利用对象关联的虚表指针查找虚函数表,再找到适合实际对象类型的虚函数实现。
例如:
Person* ptr = &student;
ptr->BuyTicket();
虽然 ptr 的声明类型是 Person*,但它指向的对象是 Student,所以最终执行的是 Student::BuyTicket()。
这也是虚函数表存在的意义之一:让程序能够通过统一的接口调用不同对象各自的实现。
学到这里,最好把两层内容分开理解。写代码时要掌握虚函数、重写以及基类指针或引用这些规则;理解底层时,再研究虚表指针、虚函数表和动态绑定。前者决定多态能否正确使用,后者帮助我们解释它为什么能够工作。