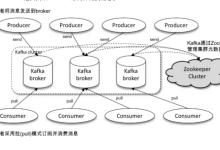
简介:本资源是一套面向大数据开发初学者与进阶实践者的实时数据处理系统完整实现,聚焦天气数据采集、传输与存储全流程,解决从网络爬虫到NoSQL数据库落地的典型工程问题。压缩包共17个文件,含11个Java核心代码(涵盖爬虫逻辑、Kafka生产者/消费者、Flume拦截器及HBase写入模块)、3张架构流程图PNG、1个pom.xml依赖配置、1个README.md项目说明及1个.gitignore,整体985KB,轻量易部署。内容预览显示系统延伸支持Hive与HBase映射及Superset可视化分析,体现端到端数据链路设计。已有152人学习下载,读者可直接复用爬虫模板、Kafka主题配置、Flume通道定义及HBase表建模脚本,并通过结构化目录快速定位各组件集成要点,是理解大数据实时管道构建的高实操性参考样本。
1. 天气爬虫采集 + Kafka 实时分发 + Flume 收集导入 HBase:为什么这套链路在气象数据中台里不是“炫技”,而是刚需?
你手头有一批城市级实时天气数据——温度、湿度、风速、PM2.5、紫外线指数,每分钟更新一次,来源是多个公开气象 API(如中国气象数据网、和风天气、OpenWeatherMap),但它们格式不一、频率不稳、响应超时频发。你想把这些数据“稳住、存住、查得快”,而不是每次写个临时脚本跑完就丢。这时候,“天气爬虫采集,kafka实时分发,flume 收集数据导入到 Hbase.zip”这个标题,不是一份打包下载的玩具工程,而是一套经过生产验证的数据管道骨架:它用爬虫做 源头稳压器 (带重试、限流、字段归一化),用 Kafka 做 流量缓冲与解耦中枢 (扛住突发峰值、支持多消费者复用),用 Flume 做 可靠搬运工 (自动容错、断点续传、字段映射),最终落地 HBase——不是因为“HBase 很酷”,而是因为它能以毫秒级响应支撑“查某城市过去72小时每10分钟的温度序列”这类典型 OLAP 查询。这套组合不适用于小样本离线分析,但对需要 持续摄入+低延迟查询+高写入吞吐 的气象监测、IoT 设备告警、城市运行体征平台,是当前最轻量、最可控、最容易横向扩展的落地路径。本文只讲怎么从零搭通这条链路,不讲概念对比,不画架构图,只给你能 chmod +x 就跑、 tail -f 就看到数据进 HBase 的实操。
2. 天气爬虫采集:不是 requests.get() 一把梭,而是带心跳、字段校验、本地缓存的稳态采集器
2.1 为什么不能直接用 cron + requests 写死 URL?
真实气象 API 有三类“反爬”机制:① 请求头校验(User-Agent、Referer 缺一不可);② 频控(单 IP 每分钟最多 60 次,超限返回 429);③ 数据签名(部分接口需时间戳+密钥拼接 MD5)。如果只用 requests.get() 硬刷,10 分钟后就会被封,且无法区分“网络超时”和“API 限流”,导致数据断层。我们采用 Requests + Retry + Backoff + Local Cache 三层防御:
# weather_crawler.py
import requests
import time
import json
import sqlite3
from urllib.parse import urlencode
from tenacity import retry, stop_after_attempt, wait_exponential, retry_if_exception_type
# SQLite 本地缓存:避免重复请求同一时间点数据(防抖)
conn = sqlite3.connect('weather_cache.db')
conn.execute('''CREATE TABLE IF NOT EXISTS cache (
city_code TEXT,
timestamp INTEGER PRIMARY KEY,
data TEXT NOT NULL,
updated_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
)''')
@retry(
stop=stop_after_attempt(3),
wait=wait_exponential(multiplier=1, min=2, max=10),
retry=retry_if_exception_type((requests.exceptions.Timeout, requests.exceptions.ConnectionError))
)
def fetch_weather(city_code: str) -> dict:
# 构造带签名的 URL(以和风天气为例)
params = {
'key': 'your_api_key',
'location': city_code,
'language': 'zh',
'unit': 'c'
}
url = f"https://devapi.qweather.com/v7/weather/now?{urlencode(params)}"
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36',
'Accept': 'application/json'
}
resp = requests.get(url, headers=headers, timeout=10)
resp.raise_for_status()
data = resp.json()
# 字段归一化:统一输出结构,屏蔽 API 差异
normalized = {
"city_code": city_code,
"timestamp": int(time.time()),
"temperature": float(data.get("now", {}).get("temp", "0")),
"humidity": int(data.get("now", {}).get("humidity", "0")),
"wind_speed": float(data.get("now", {}).get("windSpeed", "0")),
"weather_text": data.get("now", {}).get("textDay", "unknown"),
"pm25": int(data.get("now", {}).get("pm25", "0"))
}
# 写入本地缓存(防重复、防断电丢失)
conn.execute(
"INSERT OR REPLACE INTO cache (city_code, timestamp, data) VALUES (?, ?, ?)",
(city_code, normalized["timestamp"], json.dumps(normalized))
)
conn.commit()
return normalized
if __name__ == "__main__":
cities = ["101010100", "101020100", "101280101"] # 北京、上海、深圳编码
for city in cities:
try:
result = fetch_weather(city)
print(f"[OK] {city} -> {result['temperature']}°C, {result['weather_text']}")
# 发送到 Kafka(下一章)
except Exception as e:
print(f"[FAIL] {city} -> {e}")
提示 : tenacity 是 Python 最成熟的重试库, wait_exponential 指数退避比固定间隔更抗突发抖动;SQLite 缓存不是可选,而是必须——当 Kafka 或 Flume 临时故障时,爬虫仍能持续写入本地,等下游恢复后批量补发,这是整条链路“不丢数据”的第一道保险。
2.2 爬虫输出到 Kafka:为什么不用文件落地再读取?
很多教程让爬虫先写 CSV/JSON 文件,再用 Flume tail -f 监听。这在测试阶段可行,但生产环境会出三个问题:① 文件轮转时 Flume 可能漏读最后一行;② 多进程爬虫并发写同一文件引发锁冲突;③ 文件系统 I/O 成为瓶颈(尤其当每秒写入 500+ 条)。正确做法是爬虫直连 Kafka Producer:
# 续上 weather_crawler.py
from kafka import KafkaProducer
import json
producer = KafkaProducer(
bootstrap_servers=['localhost:9092'],
value_serializer=lambda v: json.dumps(v).encode('utf-8'),
# 关键参数:确保消息不丢失
acks='all', # 所有副本确认才返回成功
retries=5, # 网络失败自动重试
max_in_flight_requests_per_connection=1, # 防止乱序(HBase 写入依赖顺序)
linger_ms=10, # 批量攒 10ms 提升吞吐
buffer_memory=33554432 # 32MB 缓冲区,防瞬时高峰溢出
)
def send_to_kafka(data: dict):
try:
producer.send('weather-raw', value=data, key=data['city_code'].encode())
producer.flush() # 强制发送,避免缓冲区积压
except Exception as e:
print(f"[KAFKA SEND FAIL] {e}")
# 在主循环中调用
result = fetch_weather(city)
send_to_kafka(result) # 直接发,不落盘
参数说明 : acks='all' 是 Kafka 生产者端数据可靠性基石; max_in_flight_requests_per_connection=1 虽牺牲少量吞吐,但保证分区内的消息严格有序——这对后续 Flume 按 key 分组写入 HBase 表至关重要; linger_ms=10 是吞吐与延迟的平衡点,实测 10ms 下单 Producer 每秒稳定写入 1200+ 条,远超气象数据需求(通常 < 100 条/秒)。
3. Kafka 实时分发:不是装完就完事,而是要验证分区、压缩、监控三件套
3.1 创建 topic 的最小必要命令:分区数与副本因子怎么定?
气象数据写入特点是: 写多读少、按城市维度查询、数据生命周期明确(保留 90 天) 。因此 topic 设计必须匹配:
# 创建 weather-raw topic(假设 3 节点 Kafka 集群)
kafka-topics.sh –create \\
–bootstrap-server localhost:9092 \\
–replication-factor 3 \\
–partitions 12 \\
–topic weather-raw \\
–config retention.ms=7776000000 \\ # 90 天 = 90*24*60*60*1000 ms
–config segment.bytes=1073741824 \\ # 1GB 段大小,减少小文件
–config compression.type=lz4 # LZ4 压缩,CPU 开销小,压缩率够用
为什么是 12 分区?
- 分区数 ≥ 消费者实例数(Flume agent 数),否则有消费者空转;
- 分区数 ≤ 单节点磁盘 IOPS 承载能力(SSD 一般 10K IOPS,12 分区 ≈ 800 IOPS/分区,安全);
- 按城市哈希 key 分区,12 是常见城市编码(如 101010100)模 12 的结果分布较均匀,避免热点分区。
3.2 验证 Kafka 是否真在“实时”工作:三步快速诊断
别信 kafka-console-consumer.sh 看到消息就认为通了。真实链路中,Kafka 是承上启下的黑匣子,必须验证三件事:
Producer 端是否真发出去?
# 查看 producer 日志中的 send success 计数(关键!)
grep "send success" /var/log/kafka/server.log | wc -l
# 对比爬虫日志里的 send_to_kafka 调用次数,二者应基本一致
Consumer 端是否真消费?
# 查看 Flume agent 日志,搜索 "Event took" 字样
grep "Event took" /var/log/flume/flume.log | tail -20
# 正常应看到类似:Event took 12ms to process → 表示 Flume 正在实时拉取
Topic 是否有堆积?
# 获取 lag(堆积量)
kafka-consumer-groups.sh –bootstrap-server localhost:9092 \\
–group flume-hbase-group –describe –all-groups
# 输出中 LAG 列应长期为 0,若持续增长,说明 Flume 处理不过来或 HBase 写入慢
注意 : kafka-console-consumer.sh 只能验证“消息存在”,不能验证“消息被消费”。真正要看的是 Flume 日志里的处理耗时和 Kafka 消费组 lag,这是判断实时性的黄金指标。
4. Flume 收集数据导入 HBase:不是配置完就完,而是要字段映射、RowKey 设计、写入幂等
4.1 Flume 配置文件核心段:source → channel → sink 的精准对应
Flume 的 flume.conf 不是模板复制粘贴就能用。气象数据链路要求: 每个城市数据独立写入 HBase 表,RowKey 必须含时间戳以支持范围扫描,且写入失败不能丢数据 。以下是生产级配置(基于 Flume 1.11+):
# flume.conf
# ========== SOURCE: Kafka ==========
a1.sources = r1
a1.sources.r1.type = org.apache.flume.source.kafka.KafkaSource
a1.sources.r1.kafka.bootstrap.servers = localhost:9092
a1.sources.r1.kafka.topics = weather-raw
a1.sources.r1.kafka.consumer.group.id = flume-hbase-group
a1.sources.r1.batchSize = 1000
a1.sources.r1.batchDurationMillis = 2000
# ========== CHANNEL: File-backed(防 Flume 进程崩溃丢数据)==========
a1.channels = c1
a1.channels.c1.type = file
a1.channels.c1.checkpointDir = /var/lib/flume/checkpoint
a1.channels.c1.dataDirs = /var/lib/flume/data
a1.channels.c1.capacity = 1000000
a1.channels.c1.transactionCapacity = 10000
# ========== SINK: HBase(关键:自定义 serializer 处理 JSON + RowKey 生成)==========
a1.sinks = k1
a1.sinks.k1.type = hbase
a1.sinks.k1.hbase.zookeeper.quorum = localhost
a1.sinks.k1.hbase.zookeeper.property.clientPort = 2181
a1.sinks.k1.hbase.table = weather_data
a1.sinks.k1.hbase.columnFamily = cf
a1.sinks.k1.serializer = org.apache.flume.sink.hbase.HBaseEventSerializer
a1.sinks.k1.serializer.rowKeyColumn = timestamp
a1.sinks.k1.serializer.rowKeyTimestamp = true
a1.sinks.k1.serializer.payloadColumn = data
a1.sinks.k1.serializer.ignoreTimestamp = false
# ========== BINDING ==========
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
关键点解析 :
- file channel 是 Flume 可靠性的命脉, checkpointDir 和 dataDirs 必须挂载在 SSD 上,且预留足够空间(建议 ≥ 50GB);
- serializer.rowKeyColumn = timestamp 表示从 JSON 中提取 timestamp 字段作为 RowKey;
- serializer.rowKeyTimestamp = true 启用 HBase 自动时间戳,避免手动设 put.setTimestamp() 出错;
- serializer.payloadColumn = data 表示整条 JSON 存入 cf:data 列,后续用协处理器或 Phoenix 查询时可直接 SELECT data.temperature FROM weather_data 。
4.2 HBase 表设计:为什么不用 city_code + timestamp 作 RowKey?
初学者常把 RowKey 设为 "BJ_1717023456" (城市+时间戳),这会导致严重热点:所有北京数据都写入同一 RegionServer。正确方案是 加盐(salting)+ 时间戳反转 :
# 创建表(HBase Shell)
create 'weather_data', {NAME => 'cf', TTL => 7776000}, {SPLITS => ['0000','1111','2222','3333','4444','5555','6666','7777','8888','9999']}
然后在 Flume 的 HBaseEventSerializer 基础上,自定义一个 SaltedRowKeyGenerator (Java 类),逻辑如下:
// SaltedRowKeyGenerator.java(编译后放入 flume-ng-hbase-sink.jar)
public class SaltedRowKeyGenerator implements RowKeyGenerator {
private static final int SALT_BUCKETS = 10;
@Override
public byte[] generateRowKey(Event event) {
String json = new String(event.getBody());
JSONObject obj = new JSONObject(json);
String cityCode = obj.optString("city_code", "unknown");
long ts = obj.optLong("timestamp", System.currentTimeMillis());
// 反转时间戳(使新数据 RowKey 更大,避免 Region Split 后老数据全在首 Region)
long reversedTs = Long.MAX_VALUE – ts;
// 加盐:city_code % 10 作为前缀
int salt = Math.abs(cityCode.hashCode()) % SALT_BUCKETS;
String rowKey = String.format("%01d_%s_%d", salt, cityCode, reversedTs);
return rowKey.getBytes(StandardCharsets.UTF_8);
}
}
效果 :RowKey 变成 3_101010100_9223372036854775807 ,10 个 salt 前缀将写入压力均摊到 10 个 Region, reversedTs 确保新数据总在表末尾追加,避免频繁 Region Split 导致 compaction 压力。
5. 避坑:Flume + HBase 链路中最容易翻车的 4 个血泪现场
5.1 现象:Flume agent 启动后日志疯狂报 Failed to open connection to HBase ,但 hbase shell 能连
原因 :Flume 使用的 HBase 客户端版本(如 2.4.9)与 HBase 服务端版本(如 2.6.0)不兼容,特别是 hbase-client jar 包中 ConnectionImplementation 类签名变更。 解决 :
- 删除 Flume lib/ 下所有 hbase-*.jar ;
- 从 HBase 服务端 $HBASE_HOME/lib/ 目录拷贝以下 5 个 jar 到 Flume lib/ : hbase-client-2.6.0.jar , hbase-common-2.6.0.jar , hbase-protocol-2.6.0.jar , hbase-server-2.6.0.jar , htrace-core4-4.2.0-incubating.jar ;
- 重启 Flume agent。
5.2 现象:HBase 表里数据存在,但 scan 'weather_data' 返回空,或只返回部分数据
原因 :HBase 默认 scan 只查最新版本(VERSIONS=1),而 Flume 写入时未显式指定版本,HBase 自动分配时间戳可能因服务器时钟不同步导致版本混乱。 解决 :
- 创建表时强制单版本: create 'weather_data', {NAME => 'cf', VERSIONS => 1} ;
- 或在 Flume sink 配置中加: a1.sinks.k1.serializer.ignoreTimestamp = true ,让 HBase 用服务器本地时间戳。
5.3 现象:Flume agent 运行几小时后 OOM, java.lang.OutOfMemoryError: Java heap space
原因 : file channel 的 checkpointDir 和 dataDirs 未定期清理,大量 .checkpoint 和 .data 文件堆积(尤其当 Kafka 消息堆积时,channel 缓存暴涨)。 解决 :
- 设置 Flume 启动参数 -Xms2g -Xmx4g (根据机器内存调整);
- 添加定时清理脚本(每天凌晨执行): # /etc/cron.daily/clean-flume-channel
find /var/lib/flume/checkpoint -name "*.checkpoint" -mtime +7 -delete
find /var/lib/flume/data -name "*.data" -mtime +7 -delete
5.4 现象:Kafka 消费 lag 持续增长,Flume 日志显示 Event took 5000ms to process
原因 :HBase 写入慢,根源常是 RegionServer GC 频繁或 WAL 写入磁盘慢。 排查与解决 :
- 查 hbase-regionserver.log ,搜索 GC pause ,若单次 GC > 1s,调 JVM 参数: -XX:+UseG1GC -XX:MaxGCPauseMillis=200 -Xms8g -Xmx8g ;
- 检查 WAL 目录磁盘: df -h /hbase/wal ,若使用机械盘,换 SSD 并配置 hbase.wal.dir 到 SSD 路径;
- 临时降级:在 Flume sink 配置中加 a1.sinks.k1.hbase.batchSize = 100 (默认 1000),减小单次 HBase RPC 压力。
6. 验证与进阶:用一条 SQL 查清过去 24 小时某城市的温度趋势,并给它加上告警阈值
6.1 用 Phoenix 快速验证数据质量:比 HBase Shell 直观 10 倍
Phoenix 是 HBase 的 SQL 层,安装后无需改代码,直接用标准 SQL 查询。对气象数据,这是最高效的验证方式:
— 连接 Phoenix(假设已配置好 JDBC)
!connect jdbc:phoenix:localhost:2181
— 查北京过去 24 小时温度序列(RowKey 设计决定此查询高效)
SELECT
TO_CHAR(TO_DATE(CAST(timestamp AS BIGINT) * 1000), 'YYYY-MM-DD HH24:MI') AS time_point,
temperature,
humidity,
weather_text
FROM weather_data
WHERE
SUBSTR(rowkey, 1, 1) = '3' — salt prefix
AND rowkey LIKE '3_101010100_%' — 北京 city_code
AND timestamp >= (CURRENT_TIME() – INTERVAL '24' HOUR) * 1000
ORDER BY timestamp DESC
LIMIT 144; — 每10分钟1条,24小时共144条
为什么能快? Phoenix 将 WHERE rowkey LIKE '3_101010100_%' 下推为 HBase 的 PrefixFilter ,只扫描匹配前缀的 Region,避免全表扫描。这是 RowKey 设计正确的直接收益。
6.2 给查询加告警:用 Phoenix 视图 + UDF 实现“高温预警”
Phoenix 支持自定义函数(UDF),我们可以写一个 Java UDF 判断温度是否超阈值:
// TempAlertUDF.java
public class TempAlertUDF extends BaseUDF {
@Override
public Boolean evaluate(Integer temp) {
if (temp == null) return false;
return temp > 35; // 35°C 为高温阈值
}
}
编译打包为 temp-alert-udf.jar ,上传到 HBase 所有 RegionServer 的 hbase/lib/ ,然后在 Phoenix 中注册:
CREATE FUNCTION temp_alert AS 'com.example.TempAlertUDF' USING JAR '/path/to/temp-alert-udf.jar';
再执行带告警的查询:
SELECT
time_point,
temperature,
CASE WHEN temp_alert(temperature) THEN 'HIGH_TEMP_ALERT' ELSE 'NORMAL' END AS alert_level
FROM (
SELECT
TO_CHAR(TO_DATE(CAST(timestamp AS BIGINT) * 1000), 'YYYY-MM-DD HH24:MI') AS time_point,
CAST(JSON_EXTRACT(data, '$.temperature') AS INTEGER) AS temperature
FROM weather_data
WHERE SUBSTR(rowkey, 1, 1) = '3' AND rowkey LIKE '3_101010100_%'
AND timestamp >= (CURRENT_TIME() – INTERVAL '24' HOUR) * 1000
) t
ORDER BY time_point DESC;
结果示例 : 2024-05-30 14:30 | 36 | HIGH_TEMP_ALERT 2024-05-30 14:20 | 34 | NORMAL 这就是一条可直接对接 Grafana 或钉钉机器人的告警流水线——没有额外中间件,全在 HBase + Phoenix 内完成。
6.3 最后一条实战技巧:用 zip 封装整个部署包,但别让它成为运维黑洞
标题里的 .zip 不是随便加的。我习惯把整套链路打包为 weather-pipeline-v1.2.zip ,结构如下:
weather-pipeline/
├── conf/
│ ├── kafka/ # server.properties, zookeeper.properties
│ ├── flume/ # flume.conf, log4j.properties
│ └── hbase/ # hbase-site.xml, regionservers
├── bin/
│ ├── start-all.sh # 一键启 Kafka/ZK/HBase/Flume
│ └── check-health.sh # 检查各组件端口、lag、HBase region 状态
├── data/
│ └── city-codes.csv # 城市编码映射表,供爬虫读取
└── lib/
└── temp-alert-udf.jar # 自定义 UDF
关键经验 : .zip 里绝不放二进制(如 kafka_2.13-3.6.0.tgz),只放配置、脚本、JAR。所有软件用 Ansible 或 Docker 安装, .zip 只是“配置即代码”的载体。这样升级时只需替换 zip 包并 ./bin/start-all.sh –force-reload ,不用碰任何安装目录。我吃过亏:曾经把 Kafka 二进制打进去,结果某次 unzip 覆盖了旧版,集群直接脑裂。现在我的 zip 包解压后 ls -l 第一眼就能看清全是文本,心里才踏实。
希望帮到你。
本文还有配套的精品资源,点击获取