/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
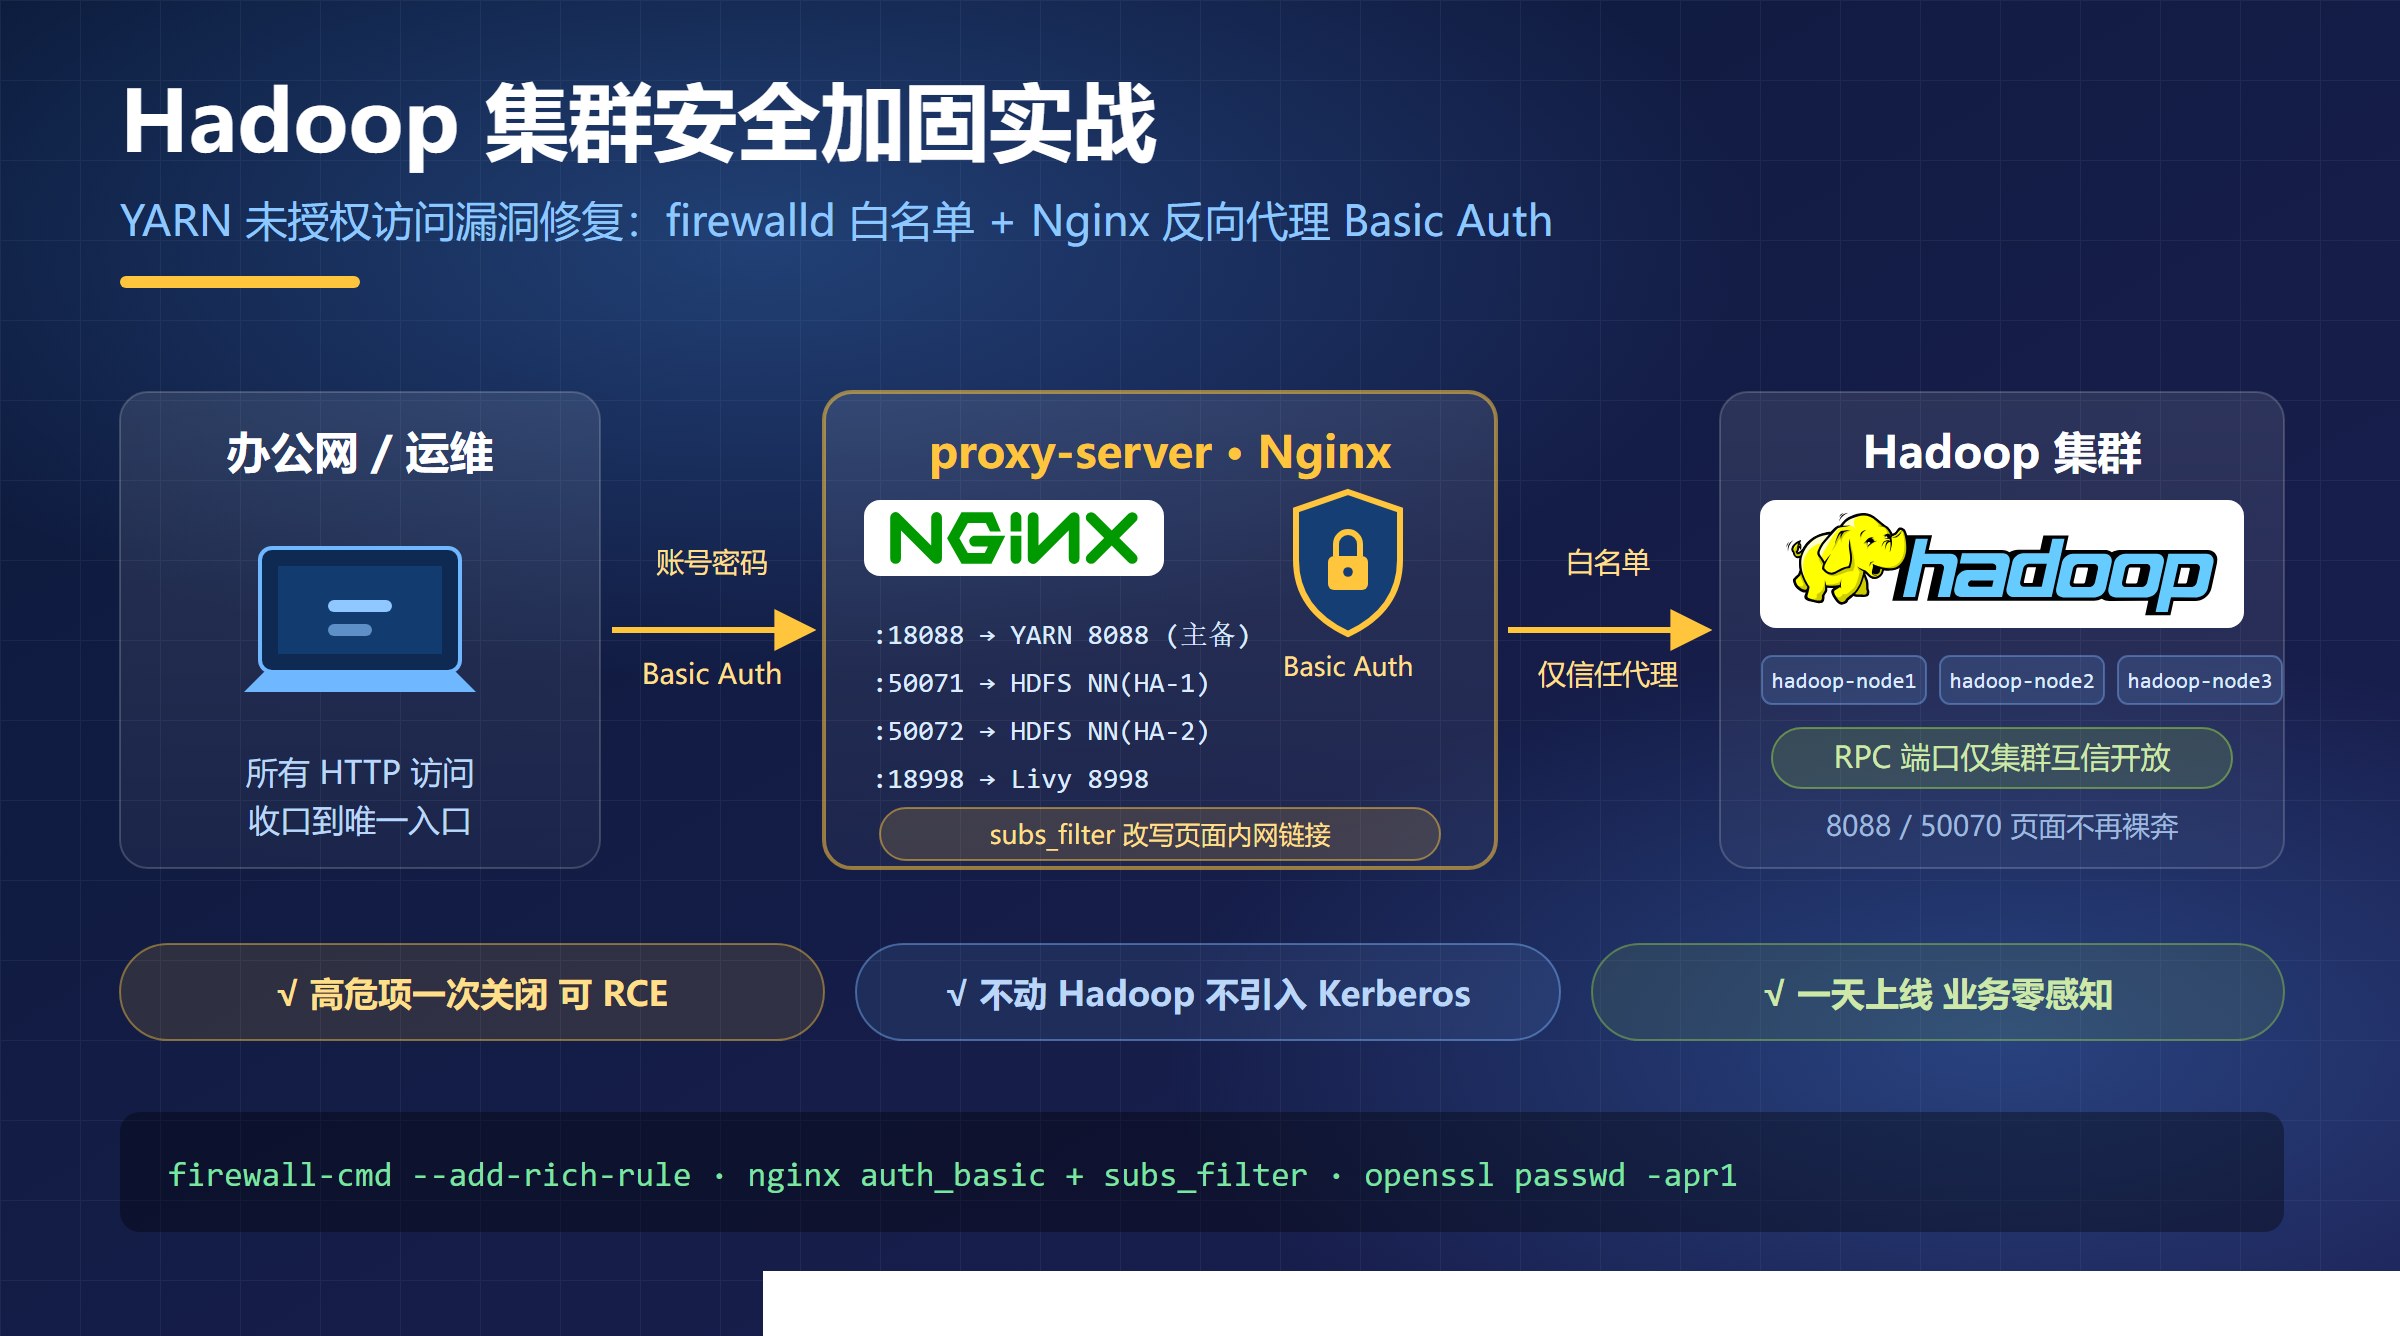
一次漏扫报告引出的 Hadoop 集群整体加固:YARN RPC 未授权访问(高危,可远程执行任意代码)、HDFS NameNode 页面与 YARN Application 页面裸奔。本文给出一条不改 Hadoop 本身、不引入 Kerberos 的落地路径——firewalld 白名单隔离 + Nginx 反向代理加 Basic Auth,附带完整的防火墙命令、nginx.conf 配置讲解和五个真实踩坑。
一、漏扫报告里的高危项:Hadoop 为什么"裸奔"
Hadoop 各组件默认不带任何认证。ResourceManager 提供的 RPC 服务默认无需认证即可访问,NameNode / NodeManager / JobHistory 的 Web 页面也是打开就能看。集群一旦暴露到办公网甚至公网,后果很直接:
- YARN RPC 未授权访问漏洞(风险等级:高危):涉及端口 50020、8031、8032、8033、8040。ResourceManager 负责资源管理和任务调度,其 RPC 服务默认无需认证,远程攻击者可利用此漏洞执行任意代码——最经典的玩法就是向 RM 提交一个恶意 Container 直接拿服务器权限;
- HDFS Web 页面无授权访问:Hadoop 2.x 的 NameNode UI 在 50070(3.x 是 9870),文件目录、HDFS 容量、配置一览无余;
- YARN Application 页面无授权访问:ResourceManager UI 在 8088,谁都能看任务列表,也能看到任务日志里的敏感信息。
官方给的解决方案是开启 Kerberos 认证。但 Kerberos 的实施成本摆在那里:要搭 KDC、发 keytab、改全链路配置,对一套已经在跑业务、版本偏老(我们是 Hadoop 2.10.2)的集群来说,风险和人力都不允许一次到位。于是我们选了一条更务实的路线。
二、方案选型:为什么是"防火墙白名单 + Nginx 反向代理"
两条主流路线对比:
| 安全强度 | 高(协议级认证) | 中高(网络隔离 + 页面级口令) |
| 改动范围 | Hadoop 全组件配置 + KDC 建设 | 不动 Hadoop,只加防火墙规则和一台 Nginx |
| 实施风险 | 高,需全集群滚动重启、排障复杂 | 低,规则可灰度、可秒级回滚 |
| 工期 | 以周计 | 以天计 |
结论:先解决"暴露面",把未授权访问漏洞修掉;Kerberos 作为二期演进。
防火墙白名单隔离之后立刻出现一个新问题:集群与外界隔绝了,运维怎么访问 HDFS、YARN 的监控页面?三种做法:
最终采用方案 3(叠加方案 2 的白名单):白名单只信任 Nginx 机器,所有对集群的 HTTP 访问以 Nginx 为唯一入口,页面访问需要口令。
三、目标架构与端口规划
三台 Hadoop 节点 + 一台 Nginx/Web 服务器(IP 均为示例,替换成自己的):
| hadoop-node1 | 192.168.10.11 | NameNode(HA-1) / ResourceManager(Active) |
| hadoop-node2 | 192.168.10.12 | NameNode(HA-2) / ResourceManager(Standby) |
| hadoop-node3 | 192.168.10.13 | DataNode / NodeManager |
| proxy-server | 192.168.10.15 | Nginx + 管理 Web 应用 |
┌──────────────────────────────┐
办公网/运维 ──HTTP──▶│ proxy-server (Nginx) │
(需账号密码) │ :18088 ─▶ RM 8088 (HA上游) │
│ :50071 ─▶ NN1 50070 │
│ :50072 ─▶ NN2 50070 │
│ :18998 ─▶ Livy 8998 │
└──────────┬───────────────────┘
│ 白名单仅信任 192.168.10.15
┌─────────────────┼─────────────────┐
hadoop-node1 hadoop-node2 hadoop-node3
192.168.10.11 192.168.10.12 192.168.10.13
(RPC端口仅集群互信开放,Web端口仅对proxy开放)
设计要点:
Hadoop 3.x 集群只需把 NameNode 的 50070 换成 9870,其余思路完全一致。
四、第一步:firewalld 白名单隔离
先说最容易翻车的一条:操作防火墙前,务必先把 SSH 端口开放给当前操作的机器,否则规则一生效,你的终端就断了,只能去机房。如果集群 SSH 不是默认 22 端口(比如改成了 22438),–add-port 时就写实际端口。
4.1 启动防火墙并开放 SSH
# 查看防火墙状态
systemctl status firewalld
# 启动防火墙
systemctl start firewalld.service
# 开放 SSH 端口(按实际端口修改)
firewall-cmd –permanent –add-port=22/tcp
4.2 集群互信白名单
四台机器(3 台 Hadoop + 1 台 Nginx)两两互信。以 hadoop-node1(192.168.10.11)为例,把另外三台全部加进 accept 规则:
firewall-cmd –zone=public –add-rich-rule 'rule family="ipv4" source address="192.168.10.12" accept' –permanent
firewall-cmd –zone=public –add-rich-rule 'rule family="ipv4" source address="192.168.10.13" accept' –permanent
firewall-cmd –zone=public –add-rich-rule 'rule family="ipv4" source address="192.168.10.15" accept' –permanent
其余三台机器同理,每台都把另外三台的 IP 加进来。rich-rule 白名单是"源 IP 放行所有端口",集群内部 RPC、数据端口复制全靠它,不用逐个开端口。
4.3 Nginx 服务器只开代理端口
在 proxy-server(192.168.10.15)上,对办公网只暴露代理端口:
firewall-cmd –permanent –add-port=18088/tcp # YARN 代理入口
firewall-cmd –permanent –add-port=50071/tcp # HDFS NameNode(HA-1) 代理
firewall-cmd –permanent –add-port=50072/tcp # HDFS NameNode(HA-2) 代理
firewall-cmd –permanent –add-port=18998/tcp # Livy 代理
4.4 生效与验证
# 重新载入(修改规则后使其生效)
firewall-cmd –reload
# 查看白名单规则
firewall-cmd –list-rich-rules
# 查看所有打开的端口
firewall-cmd –zone=public –list-ports
验证方法:在办公网机器上 curl -m 3 http://192.168.10.11:8088 应当超时(RM 页面已不可直达),curl -m 3 http://192.168.10.15:18088 应当返回 401(交给 Nginx 的 Basic Auth 接管)。
五、第二步:Nginx 反向代理 + Basic Auth
5.1 安装
上传 nginx 安装包到 proxy-server,解压并授权(路径以 /opt/bigdata 为例,用户按现场实际):
tar -zxvf nginx-1.20.2.tar.gz -C /opt/bigdata/
chown -R hadoop:hadoop /opt/bigdata/nginx/
5.2 核心配置逐段讲解
nginx.conf 是整个方案的核心,有几个关键设计,先看 YARN 的部分:
# 用 root 启动 worker(若安装属主是 root 则设 root),
# 否则 Nginx 读不到 conf 目录下的密码文件,页面会一直弹 401 复现
user root;
# YARN 用 upstream 做主备:Active 挂了自动切 Standby
upstream yarnApplication {
server hadoop-node1:8088;
server hadoop-node2:8088 backup;
}
server {
listen 18088;
server_name localhost;
charset utf-8;
location / {
# 代理缓冲调大,防止监控页面大表格渲染报错、白屏
proxy_buffer_size 1024k;
proxy_buffers 16 1024k;
proxy_busy_buffers_size 2048k;
proxy_temp_file_write_size 2048k;
# Basic Auth:这两行就是"加密码"的全部
auth_basic "please input user and passwd";
auth_basic_user_file ../conf/yarn.h;
proxy_pass http://yarnApplication;
# 把页面里指向各 NodeManager 8042 的链接改写成走本代理
subs_filter_types text/html text/css text/xml;
subs_filter '<a href=http://hadoop-node1:8042' '<a href=http://192.168.10.15:18088/app01';
subs_filter '<a href=http://hadoop-node2:8042' '<a href=http://192.168.10.15:18088/app02';
subs_filter '<a href=http://hadoop-node3:8042' '<a href=http://192.168.10.15:18088/app03';
subs_filter '<a href=http://hadoop-node1:8088' '<a href=http://192.168.10.15:18088/apphost01';
}
# 静态资源直连 Active RM
location /static/ {
proxy_buffer_size 1024k;
proxy_buffers 16 1024k;
proxy_busy_buffers_size 2048k;
proxy_temp_file_write_size 2048k;
proxy_pass http://hadoop-node1:8088;
}
# 三个 NodeManager 的页面分别映射成 /app01 /app02 /app03
location /app01/ {
proxy_buffer_size 1024k;
proxy_buffers 16 1024k;
proxy_busy_buffers_size 2048k;
proxy_temp_file_write_size 2048k;
proxy_pass http://hadoop-node1:8042/;
}
# /app02/ → hadoop-node2:8042,/app03/ → hadoop-node3:8042 同理
# JobHistory 页面
location /jobhistory/ {
proxy_buffer_size 1024k;
proxy_buffers 16 1024k;
proxy_busy_buffers_size 2048k;
proxy_temp_file_write_size 2048k;
proxy_pass http://hadoop-node1:19888;
}
# RM 上点击具体应用时走 /proxy/(RM 内置代理跳转到 NM)
location /proxy/ {
proxy_buffer_size 1024k;
proxy_buffers 16 1024k;
proxy_busy_buffers_size 2048k;
proxy_temp_file_write_size 2048k;
# 关掉上游压缩,subs_filter 才能改写内容
proxy_set_header Accept-Encoding "";
proxy_pass http://hadoop-node1:8088;
subs_filter_types application/json text/html text/css text/xml;
subs_filter 'http://hadoop-node1:8042' 'http://192.168.10.15:18088/app01';
subs_filter 'http://hadoop-node2:8042' 'http://192.168.10.15:18088/app02';
subs_filter 'http://hadoop-node3:8042' 'http://192.168.10.15:18088/app03';
}
# RM 页面里 host 级跳转入口
location /apphost01/ {
proxy_buffer_size 1024k;
proxy_buffers 16 1024k;
proxy_busy_buffers_size 2048k;
proxy_temp_file_write_size 2048k;
proxy_pass http://hadoop-node1:8088;
}
}
再补上 HDFS 两个 NameNode 的代理(HA 双入口):
# HDFS NameNode HA-1
server {
listen 50071;
charset utf-8;
location / {
proxy_buffer_size 1024k;
proxy_buffers 16 1024k;
proxy_busy_buffers_size 2048k;
proxy_temp_file_write_size 2048k;
proxy_set_header Accept-Encoding "";
auth_basic "please input user and passwd";
auth_basic_user_file ../conf/hdfs.h;
proxy_pass http://hadoop-node1:50070;
subs_filter_types application/json text/html text/css text/xml;
}
}
# HDFS NameNode HA-2
server {
listen 50072;
charset utf-8;
location / {
proxy_buffer_size 1024k;
proxy_buffers 16 1024k;
proxy_busy_buffers_size 2048k;
proxy_temp_file_write_size 2048k;
proxy_set_header Accept-Encoding "";
auth_basic "please input user and passwd";
auth_basic_user_file ../conf/hdfs.h;
proxy_pass http://hadoop-node2:50070;
subs_filter_types application/json text/html text/css text/xml;
}
}
# Livy(如有)
server {
listen 18998;
server_name localhost;
location / {
proxy_buffer_size 1024k;
proxy_buffers 16 1024k;
proxy_busy_buffers_size 2048k;
proxy_temp_file_write_size 2048k;
auth_basic "please input user and passwd";
auth_basic_user_file ../conf/livy.h;
proxy_pass http://hadoop-node1:8998;
}
}
三个配置要点单独说一下:
5.3 生成 Basic Auth 的账号密码文件
用 openssl passwd -apr1 生成加密口令,追加到密码文件:
cd /opt/bigdata/nginx/conf
# 生成 yarn 用户名(占位符替换成实际用户名)
echo -n 'yarn_user:' > yarn.h
# 设置 yarn 密码(会提示输入两次,输出追加到文件)
openssl passwd -apr1 >> yarn.h
# hdfs / livy 同理
echo -n 'hdfs_user:' > hdfs.h
openssl passwd -apr1 >> hdfs.h
echo -n 'livy_user:' > livy.h
openssl passwd -apr1 >> livy.h
注意 >> 是追加语义:修改老账号时必须先删掉对应 .h 文件再执行,否则文件里会留多个旧行,旧口令继续有效,等于白改。
5.4 启动与重载
# 指定 prefix 启动,避免迁移导致的安装路径不一致问题
cd /opt/bigdata/nginx/sbin/
./nginx -p /opt/bigdata/nginx
# 改完配置后重载
./nginx -p /opt/bigdata/nginx -s reload
5.5 验证
浏览器访问 http://192.168.10.15:18088,应弹出 Basic Auth 认证框,输入账号密码后能看到 YARN ResourceManager 页面;点击具体 Application 进入日志页、点击节点进入 NodeManager 页面,链接应已被改写为 …/app01/、…/proxy/ 形式且正常打开。HDFS 的 50071/50072、Livy 的 18998 同样验证一遍。
六、踩坑实录
踩坑 1:先动防火墙,SSH 被自己锁在门外。 防火墙规则一旦 reload,未放行的源 IP 立即断连。一定要先 –add-port 放行 SSH 再加白名单规则,并且在本机保留一个已连接的会话作为"后悔药"。
踩坑 2:Nginx 启动报缺 libssl.so.10。 老版本 nginx 二进制依赖 openssl 1.0,新系统(CentOS 8+)没有预装。两种解法:
# 解法一:装兼容包(推荐)
wget https://vault.centos.org/centos/8/AppStream/x86_64/os/Packages/compat-openssl10-1.0.2o-3.el8.x86_64.rpm
rpm -ivh compat-openssl10-1.0.2o-3.el8.x86_64.rpm
# 解法二:从其他机器拷 libcrypto.so.1.0.2k 建软链
rm -f /lib64/libssl.so.10
ln -s /lib64/libcrypto.so.1.0.2k /lib64/libssl.so.10
(解法二里 rm 报"不是软链接"可以忽略。)
踩坑 3:subs_filter 指令不识别,Nginx 起不来。 报 unknown directive "subs_filter" 说明编译时没带 ngx_http_substitutions_filter 模块。要么源码编译时 –add-module 加上,要么改用官方原生的 sub_filter(原生版不支持正则、一条 location 只能一条,页面链接改写会麻烦不少)。
踩坑 4:页面能打开,但点 NodeManager 链接 404。 RM 页面里所有节点链接都指向 http://hadoop-nodeX:8042,办公网根本访问不到集群 IP。这就是 subs_filter 三条改写规则 + /app01/~/app03/ 三个 location 存在的意义:把页面里所有集群内网链接都改写到代理端口上。Accept-Encoding "" 不加,改写会静默失效(坑 3 的孪生坑)。
踩坑 5:页面大表格渲染白屏或 502。 YARN 应用列表、HDFS 文件浏览的响应体不小,Nginx 默认缓冲(几 KB)不够用,proxy_buffer_size/proxy_buffers 调到 1M 级别即可解决——配置里每个 location 都带这四行不是冗余。
踩坑 6:改了密码但旧密码还能用。 见 5.3,openssl passwd -apr1 >> 是追加;改密码前先删 .h 文件。
七、收尾:这套路子的边界
这套"白名单 + 反代"解决的是暴露面收敛:RPC 端口只对互信机器开放,Web 页面统一入口且需要口令,漏扫报告里的未授权访问项全部关闭。但它不是终点:
- Basic Auth 是 HTTP 层口令,不适合长期当唯一防线,口令要定期轮换(配合 CI 定时重生成 .h 文件 + nginx -s reload 很容易);
- 集群内部仍然是互信明文,根治要上 Kerberos——把 core-site.xml/hdfs-site.xml/yarn-site.xml 的认证链路逐步建起来,前期可以只对新增节点启用;
- Nginx 机器本身成为新的关键资产,SSH 改端口 + 密钥登录 + fail2ban 这些基础加固别忘了。
整体实施一天内完成,业务零感知。对同类"老集群来不及上 Kerberos、但漏扫整改等不了"的场景,这是性价比最高的一刀。
相关阅读: Hadoop YARN 任务全部挂掉排查实录:ResourceManager 双 Standby 根因定位与 ZooKeeper 调优 Kafka 安全加固姊妹篇:内置 ZooKeeper 集群添加 SASL 认证全流程
你们团队的 Hadoop 集群还"裸奔"吗?漏扫报告下来你是选择硬上 Kerberos,还是先网络层收敛?评论区聊聊你的方案。
结语
安全整改从来不是单点技术问题,而是"整改成本 × 业务风险 × 工期"的权衡。firewalld 白名单 + Nginx Basic Auth 这套组合的好处是:不动 Hadoop 本身、可灰度可回滚、一天上线,先把高危漏洞的口子扎住,再从容规划 Kerberos 二期。文中全部命令和配置都来自真实整改过程,IP 与主机名已做脱敏替换,拿来即可套用。
如果这篇文章帮到了你,点赞收藏支持一下;对方案有疑问或有自己的实践,欢迎评论区交流。